
Перевести PDF с английского на русский можно двумя принципиально различными путями: обработать файл целиком или сперва получить из него редактируемый текст. Выбор зависит не от расширения .pdf как такового, а от устройства конкретного документа: в одном файле есть полноценный текстовый слой, второй фактически состоит из сканов, третий сочетает таблицы, подписи на изображениях, сложную верстку и встроенные шрифты. По этой причине самый быстрый метод начинается не с кнопки перевода, а с короткой диагностики исходника. На Xeon Live есть отдельный разбор перевода PDF с английского на русский; ниже собрана расширенная рабочая схема с акцентом на сохранность структуры, распознавание сканов, проверку терминологии и контроль итога.
Почему один PDF переводится за минуту, а другой приходится сперва распознавать
PDF — контейнер фиксированной страницы. Внутри могут лежать текстовые объекты, изображения, векторная графика, формы, аннотации и шрифты. Внешне два документа выглядят одинаково, но для переводчика они принципиально различаются. Если курсор выделяет отдельные слова и предложения, сервис обычно получает текст напрямую. Если выделяется вся страница как единая картинка или ничего не выделяется, необходим OCR — оптическое распознавание символов. В гибридных файлах часть страниц уже включает текст, а часть остаётся изображениями; именно такие документы чаще всего дают пропуски после автоматической обработки.
Перед началом полезно понимать как устроен формат PDF и не путать визуальное отображение страницы с наличием текста. Документ может выглядеть идеально и одновременно не содержать ни одного редактируемого символа. Обратная ситуация тоже встречается: под сканом уже лежит невидимый OCR-слой, но в нём есть ошибки, лишние переносы или перепутанные колонки. Переводчик применяет именно этот скрытый слой, по этой причине итог зависит от качества распознавания.
Быстрая диагностика исходника перед переводом
- Выделите одно предложение мышью. Если выделяются отдельные строки и слова, перед вами текстовый или гибридный PDF. Если выделяется прямоугольник страницы либо ничего не происходит, для этой страницы необходим OCR.
- Скопируйте фрагмент в простой текстовый редактор. Проверьте порядок слов, переносы, цифры, дефисы и спецсимволы. Так быстро обнаруживаются ошибки скрытого OCR-слоя.
- Посмотрите на таблицы и колонки. Чем сложнее порядок чтения, тем выше риск, что после конвертации строки поменяются местами или ячейки сольются.
- Отметьте подписи, встроенные в изображения. Обычный перевод текстового слоя их не затрагивает; для них необходим отдельный OCR или ручная работа.
- Проверьте защиту документа. Ограничение на копирование, шифрование или пароль могут помешать извлечению текста и работе облачных сервисов.
- Определите, что необходимо получить на выходе. Для чтения достаточно понятного русского текста; для договора, отчёта или презентационного материала важна ещё и воспроизводимая верстка.
Если текст не копируется, сперва разберитесь с причиной: Xeon Live подробно описывает ситуации, когда текст из PDF не удаётся скопировать. Не стоит сразу считать файл повреждённым. Чаще проблема связана со сканом, ограничениями документа, отсутствующим текстовым слоем или некорректным распознаванием.
Как подготовить PDF к переводу и не потерять важные данные
Подготовка занимает меньше времени, чем исправление испорченного итога. Сохраните исходник отдельно и работайте с копией. Если документ входит в цепочку согласования, дайте копии понятное рабочее имя и не перезаписывайте оригинал до финальной сверки. Для корпоративных материалов заблаговременно решите, разрешена ли загрузка файла во внешний облачный сервис: политика организации и договорные обязательства важнее удобства конкретного инструмента.
Дальше определите минимально нужный объём. Для ответа клиенту часто достаточно перевести две страницы или несколько абзацев; для исследования необходим весь документ; для договора могут потребоваться основной текст, приложения, сноски и подписи к схемам. Чем меньше ненужного материала отправляется на обработку, тем легче контролировать полноту, конфиденциальность и итоговую верстку.
Подготовьте терминологию до запуска автоматического перевода
В маркетинговом, юридическом и техническом документе одна и та же английская формулировка должна переводиться одинаково во всех разделах. Составьте короткий перечень терминов, наименований продуктов, должностей, метрик и сокращений, которые нельзя интерпретировать свободно. Для брендовых наименований отдельно укажите, что остаётся без перевода. Для многозначных слов добавьте контекст: к примеру, conversion в отчёте о рекламе и conversion при преобразовании файлов — различные понятия.
- наименования брендов, продуктов и юридических лиц;
- наименования рекламных каналов, метрик и аналитических показателей;
- единицы измерения, валюты, даты и формат чисел;
- должности, подразделения и устойчивые формулировки компании;
- термины из договора, технического задания или отраслевого стандарта;
- аббревиатуры, которые должны сохраняться в исходном виде или раскрываться при первом употреблении.
Сделайте эталонную выборку для проверки качества
До обработки всего файла выберите несколько репрезентативных фрагментов: обычный абзац, список, таблицу, подпись к рисунку, сноску и страницу со сложной компоновкой. Переведите их первым методом, который собираетесь применять, и сопоставьте итог с исходником. Это не лабораторная оценка точности, а практический приём контроля: он показывает, где именно ломается ваш документ — в распознавании, переводе или верстке.
Для команды полезно заблаговременно зафиксировать критерии приёмки. К примеру: не осталось английских абзацев, числа и единицы не изменились, наименования брендов сохранены, таблицы читаются, заголовки не перепутаны с обычным текстом, ссылки и примечания находятся на своих местах. Такой перечень превращает субъективное впечатление от перевода в воспроизводимую проверку.
Как перевести PDF: 6 рабочих методов
Ниже методы идут от сценария с локальной подготовкой скана к полностью браузерной обработке файла. Первый вариант предназначен в первую очередь для Windows и полезен, когда PDF необходимо сперва распознать, почистить или перевести только отчасти. Дальше идут решения для Windows и macOS, затем браузерные варианты. Один и тот же документ не нужно прогонять через все сервисы: выберите маршрут по типу исходника и требуемому итогу.
Windows: локальная подготовка и перевод
PDF Commander + Яндекс Переводчик: распознать или извлечь текст, затем перевести
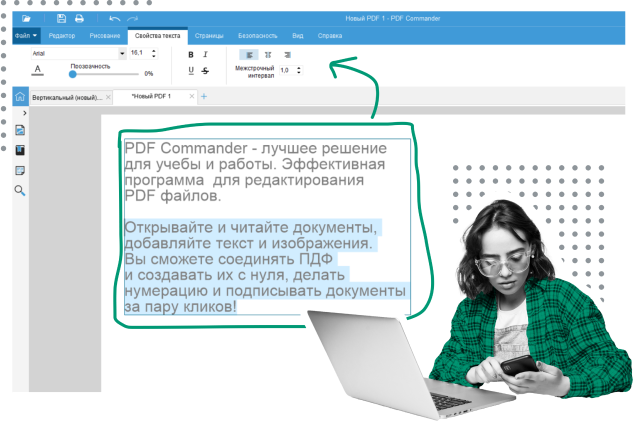
PDF Commander ставим первым для сценария, в котором PDF необходимо подготовить перед переводом: выделить текст, распознать скан, извлечь содержимое нужных страниц или ручным способом заменить отдельные фрагменты. Встроенного перевода в текущей версии PDF Commander нет. Связка работает в два этапа — сперва программа получает корректный текст из PDF, затем этот текст или подготовленный документ переводится отдельным переводчиком.
Для обычного текстового PDF откройте файл и проверьте, выделяется ли нужный абзац. В Windows текст можно перевести выборочно: скопировать фрагмент, обработать его в переводчике и заменить содержимое в рабочей копии PDF. Такой маршрут удобен для писем, предложений, брифов и коротких приложений, где не требуется автоматическая перестройка всего документа.
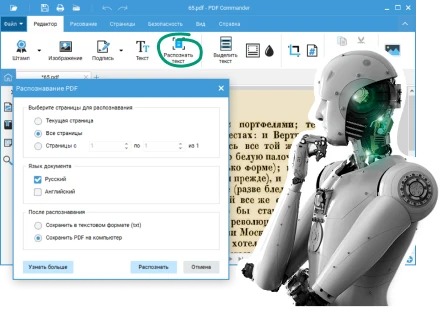
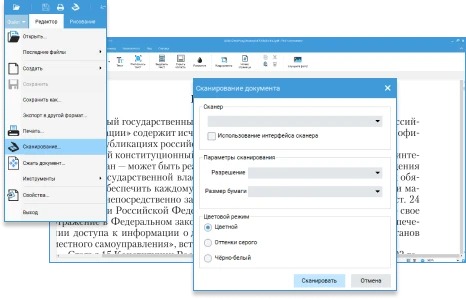
Для скана сперва запустите OCR. В интерфейсе PDF Commander откройте раздел Распознавание и выберите Распознать текст. Укажите текущую страницу, весь документ или диапазон, затем режим распознавания и язык. Для итога доступны два полезных варианта: Извлечь текст с сохранением в новый файл или Добавить невидимый слой текста, чтобы в исходной странице заработали поиск и копирование. После окончания обязательно просмотрите несколько мест с числами, наименованиями и переносами строк.
Если исходник сложный, пригодится отдельный гайд по распознаванию текста в PDF. Качество OCR проверяется до перевода: если программа прочитала слово неверно, автоматический перевод уже не сможет восстановить исходный смысл. В особенности внимательно смотрите на похожие символы, десятичные разделители, артикулы, адреса веб-страниц, формулы и сокращения.
Пошагово: короткий фрагмент
- Откройте рабочую копию PDF в PDF Commander.
- Выделите нужный текст. Если он не выделяется, выполните OCR через раздел «Распознавание».
- Скопируйте распознанный или исходный английский фрагмент.
- Откройте Яндекс Переводчик, задайте английский как исходный язык и русский как целевой, потом вставьте текст.
- Сверьте терминологию и числа. Исправьте имена собственные и профессиональные термины по подготовленному списку.
- Вернитесь в рабочую копию PDF и замените нужный текст. После замены проверьте переносы, размер шрифта и границы текстового блока.
- Сохраните отдельную русскую версию и ещё раз откройте её для контроля.
Для большого документа ручная замена каждого абзаца нерациональна. В этом случае после OCR лучше получить редактируемый текст или экспортировать документ в DOCX, перевести документ целиком и уже затем сформировать новый PDF. Этот маршрут отдаёт приоритет качеству текста и управляемости, а не пиксельному совпадению с исходником.
Пошагово: многостраничный скан
- Создайте копию исходного PDF и убедитесь, что все страницы расположены в правильном порядке.
- В PDF Commander выберите распознавание всех страниц либо конкретного диапазона и укажите английский язык.
- Извлеките текст в новый файл. Для дальнейшей работы со структурой применяйте экспорт в редактируемый документ, когда это оправдано версткой.
- Просмотрите начало, середину и конец распознанного текста; отдельно проверьте таблицы, колонки, подписи и места со слабыми сканами.
- Переведите подготовленный текст или редактируемый документ. Яндекс Переводчик в режиме документов принимает PDF и офисные файлы; для веб-режима указан предел 5 МБ.
- Соберите русскую версию, восстановите заголовки и списки, потом сопоставьте с оригиналом по страницам.
- Перед публикацией или отправкой проведите терминологическую и числовую сверку.
Плюсы
- Можно сперва исправить проблему со сканом и получить текстовый слой, а уже потом переводить.
- Подходит для выборочного перевода нескольких страниц или фрагментов без обработки всего документа.
- Позволяет контролировать OCR до отправки текста в переводчик.
- В Windows можно ручным способом вернуть переведённый текст в рабочую копию PDF и поправить локальную верстку.
Минусы
- Встроенного перевода текста в PDF Commander нет, по этой причине необходим отдельный переводчик.
- Для длинного документа ручная замена абзацев занимает много времени.
- После OCR и экспорта сложные таблицы, колонки и подписи требуют отдельной сверки.
- Прямое редактирование текста внутри PDF относится к Windows-версии; этот сценарий не переносится на macOS.
Кому подойдёт
Этот метод рассчитан на пользователей Windows, которым важно сперва привести PDF в рабочее состояние: распознать скан, извлечь только нужные страницы, проверить текст и затем перевести его. Для отдела маркетинга это удобный маршрут для брифов, коммерческих материалов, исследований и приложений, где содержимое важнее полного автоматического сохранения исходной верстки.
Windows и macOS: перевод через настольные программы
Adobe Acrobat: перевести PDF через Adobe Express
Adobe Acrobat Pro предлагает прямой маршрут из открытого PDF. В актуальном интерфейсе команда находится в глобальном разделе Convert: выберите Translate this PDF, после чего документ открывается в Adobe Express. Дальше задаётся язык перевода и объём — весь документ, одна страница или выбранный текст. После обработки итог можно заранее просмотреть и выгрузить обратно как PDF.
Этот метод в особенности логичен для PDF, который уже нормально читается как текст. Он сокращает количество промежуточных конвертаций и сохраняет документ в привычной PDF-цепочке. Adobe отдельно предупреждает, что перевод может быть пропущен для сканированных, защищённых, больших или сложных PDF, а также для файлов с неподдерживаемыми шрифтами или языками. По этой причине скан сперва проверяют на текстовый слой, а защищённый документ — на разрешённые операции.
- Откройте PDF в Acrobat и сохраните исходник отдельно.
- Выберите Convert, затем Translate this PDF.
- В Adobe Express укажите русский язык как целевой.
- Выберите весь документ, одну страницу или конкретный текст.
- Запустите перевод и просмотрите итог до экспорта.
- Сохраните переведённый PDF на устройство и сопоставьте его с оригиналом по страницам.
- Проверьте числа, таблицы, имена, ссылки, подписи и места, где строки стали длиннее.
Русский текст часто занимает больше горизонтального места, чем короткие английские формулировки. Даже при сохранённом дизайне после перевода стоит проверить кнопочные подписи в макетах, узкие колонки, таблицы, выноски и подписи под диаграммами. Если абзац вышел за границы блока, исправлять необходимо не смысл перевода ради длины, а верстку или утверждённую редакционную формулировку.
Плюсы
- Перевод запускается из открытого PDF без обязательного ручного копирования текста.
- Можно обработать весь файл, одну страницу или отдельный фрагмент.
- После перевода документ остаётся в PDF-ориентированном рабочем процессе.
- Есть предварительный просмотр перед выгрузкой итоговой версии.
Минусы
- Сканированные и сложные PDF могут быть обработаны не полностью.
- Защищённые документы и неподдерживаемые шрифты создают добавочные ограничения.
- Обработка переводом проходит через Adobe Express, по этой причине для конфиденциального файла необходимо заблаговременно проверить корпоративные правила передачи данных.
- Сложная верстка всё равно требует ручной постпроверки.
Кому подойдёт
Acrobat удобен командам, которые уже получают и согласуют документы в PDF и хотят минимизировать промежуточные форматы. Подходящий сценарий — текстовые отчёты, исследования, презентационные приложения и материалы с умеренной сложностью верстки, которые после перевода можно за короткое время сопоставить с оригиналом.
Microsoft Word: преобразовать PDF, перевести документ и вновь сохранить в PDF
Microsoft Word решает задачу через промежуточное преобразование. Когда PDF открывается в Word, программа создаёт копию и конвертирует её в редактируемый документ, стараясь повторить исходную разметку. Затем перевод всего файла запускается через Review → Translate → Translate Document. Word открывает переведённую копию в отдельном окне; её можно отредактировать и сохранить в PDF.
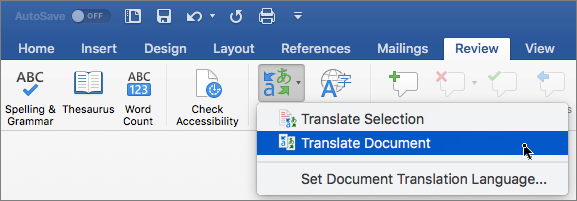
Microsoft подчёркивает, что преобразование лучше всего работает с файлами, где преобладает обычный текст. PDF с большим количеством графики может превратиться в набор изображений, а отдельные элементы — сноски, колонки, таблицы, границы и сложное форматирование — могут расположиться иначе. По этой причине Word стоит выбирать, когда после перевода необходим именно редактируемый русский документ и команда готова проверить компоновку.
- Откройте PDF в Word и подтвердите создание редактируемой копии.
- Сразу сохраните получившийся документ как отдельный DOCX, чтобы исходный PDF оставался неизменным.
- Проверьте, не превратились ли страницы в изображения, правильно ли распознаны таблицы и сноски.
- Откройте Review → Translate → Translate Document.
- Выберите русский язык и запустите перевод; новая копия откроется отдельно.
- Пройдите по документу от заголовков к основному тексту, потом проверьте таблицы, подписи, колонтитулы и сноски.
- После редактуры сохраните итоговую версию как PDF и сопоставьте её с исходным файлом.
Если преобразование PDF в Word само по себе вызывает вопросы, применяйте отдельную инструкцию по конвертации PDF в Word. Главная идея — не считать конвертацию прозрачной операцией. Это реконструкция структуры страницы, по этой причине сравнение до и после обязательно.
Плюсы
- После преобразования получается обычный редактируемый документ, удобный для вычитки и совместных правок.
- Перевод всего документа встроен в рабочий процесс Word.
- Можно отдельно править стили, заголовки, таблицы и терминологию перед повторным экспортом в PDF.
- Исходный PDF не перезаписывается: Word работает с копией.
Минусы
- Сложная PDF-верстка после конвертации может заметно отличаться от оригинала.
- Страницы с преобладанием графики порой открываются как изображения без редактируемого текста.
- Для функции перевода необходим интернет и включённые подключённые возможности Office.
- При строгих требованиях к печатному макету придётся ручным способом восстанавливать часть компоновки.
Кому подойдёт
Word подходит для договоров, отчётов, аналитических материалов, технических описаний и других преимущественно текстовых PDF, когда после машинного перевода требуется серьёзная редактура. Это хороший выбор для документов, которые всё равно должны пройти через автора, юриста, редактора или владельца терминологии до возврата в PDF.
В браузере: перевод PDF без предварительного ручного копирования
Google Translate: загрузить PDF целиком
Google Translate на компьютере умеет переводить документы во вкладке Documents. Для PDF действует ограничение: файл должен быть не больше 10 МБ и содержать не более 300 страниц. Сервис тоже принимает DOCX, PPTX и XLSX. После обработки доступна загрузка переведённой версии.
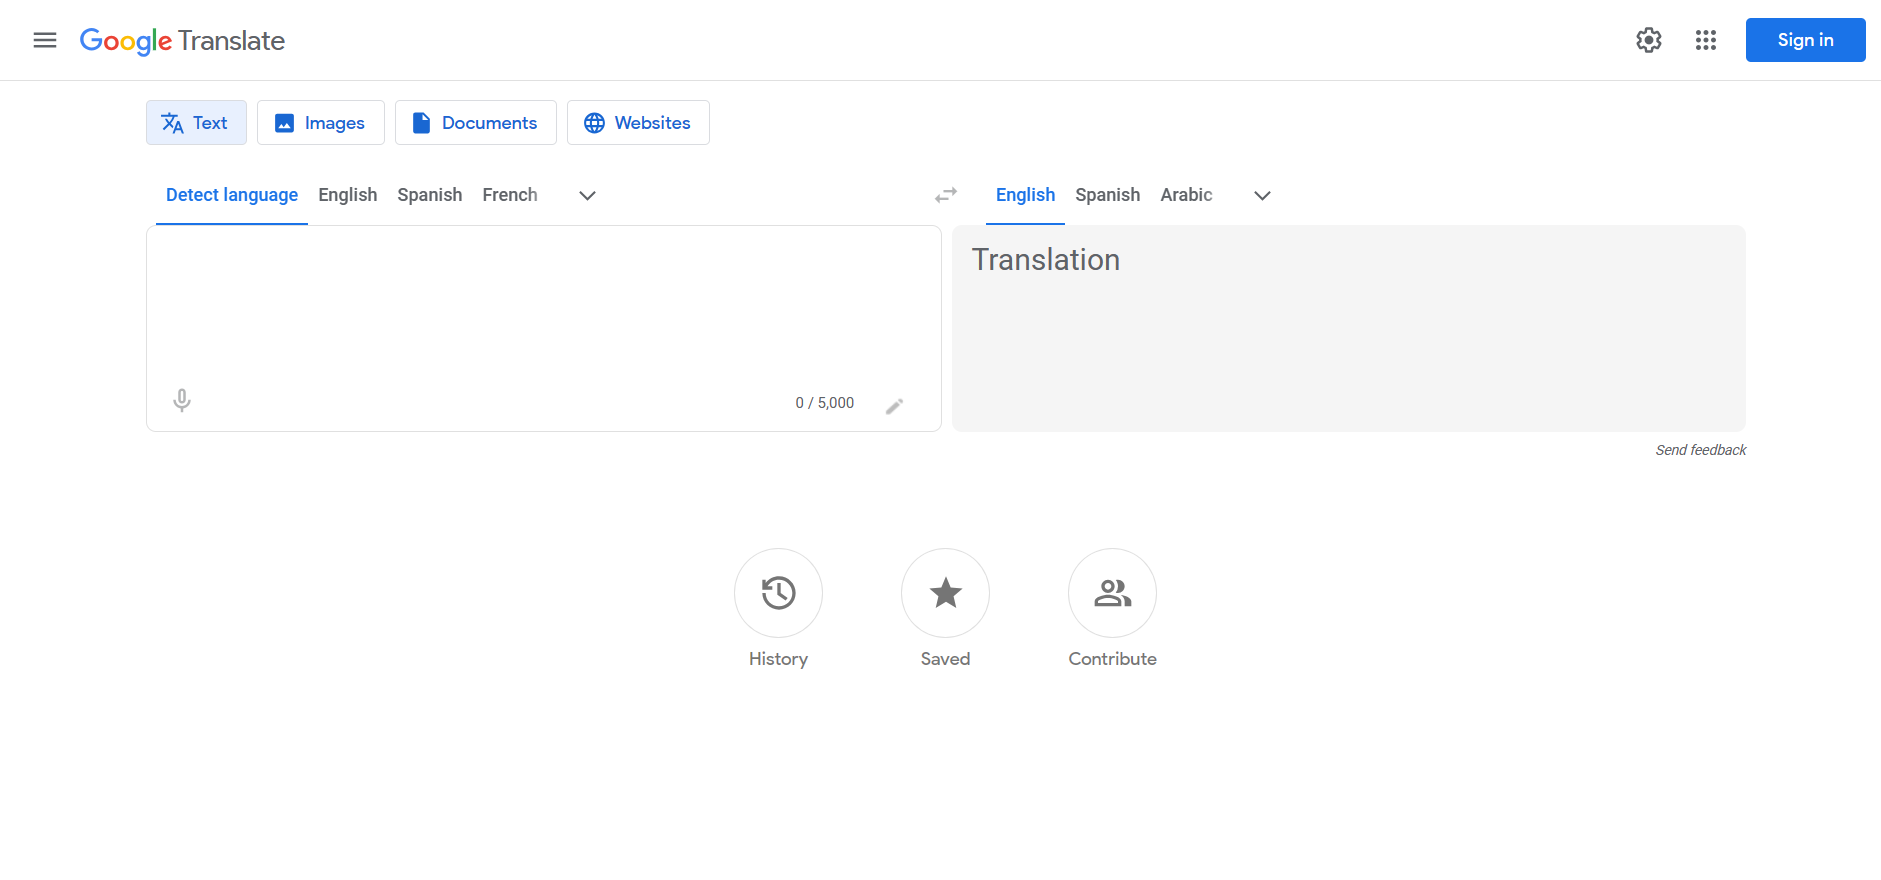
У этого метода есть критичное ограничение для сканов: текст, находящийся внутри изображений и сканированных PDF-страниц, может присутствовать в выходном документе, но не переводится. По этой причине перед загрузкой обязательно выполните простую проверку выделением. Если страница состоит из картинки, сперва необходим OCR — иначе часть английского содержимого сохранится без перевода.
- На компьютере откройте Google Translate и переключитесь в Documents.
- Выберите английский как исходный язык или автоматическое определение, русский — как целевой.
- Загрузите PDF с компьютера.
- Запустите перевод и дождитесь окончания обработки.
- Сохраните переведённый документ на устройство.
- Сопоставьте число страниц, заголовки и таблицы с исходником.
- Поиск по итоговому файлу поможет быстро отыскать оставшиеся английские слова и проверить, не пропущены ли отдельные блоки.
Режим документов Google Translate не предназначен для небольших экранов и мобильных устройств. Для целого PDF планируйте работу с компьютера. На смартфоне проще переводить отдельный текст или изображения другими средствами, но это уже другой процесс и он не заменяет полноценную обработку файла.
Плюсы
- PDF загружается целиком, без предварительного копирования каждого абзаца.
- Поддерживаются тоже распространённые офисные форматы.
- После обработки можно сохранить переведённый документ на устройство.
- Подходит для быстрого ознакомления с обычными текстовыми PDF.
Минусы
- Сканированный текст внутри изображения не переводится в режиме документа.
- Есть ограничения по размеру PDF и числу страниц.
- Полноценный перевод документов ориентирован на компьютер, а не на маленький экран телефона.
- Для сложной верстки и ответственной терминологии необходима отдельная проверка.
Кому подойдёт
Google Translate удобен, когда необходимо быстро понять содержание текстового отчёта, исследования, инструкции, медиаплана или презентационного приложения без глубокой редакторской обработки. Для документа, который будет публиковаться, отправляться клиенту или подписываться, после автоматического перевода необходим полноценный контроль текста и верстки.
DeepL: перевести PDF как файл
DeepL поддерживает перевод PDF через режим файлов на веб-платформе и в настольных приложениях; для функции требуется учётная запись. Пользователь выбирает PDF, задаёт язык и запускает перевод файла. Для части вариантов сервиса доступен выбор формата итога, включая сохранение PDF или получение DOCX.
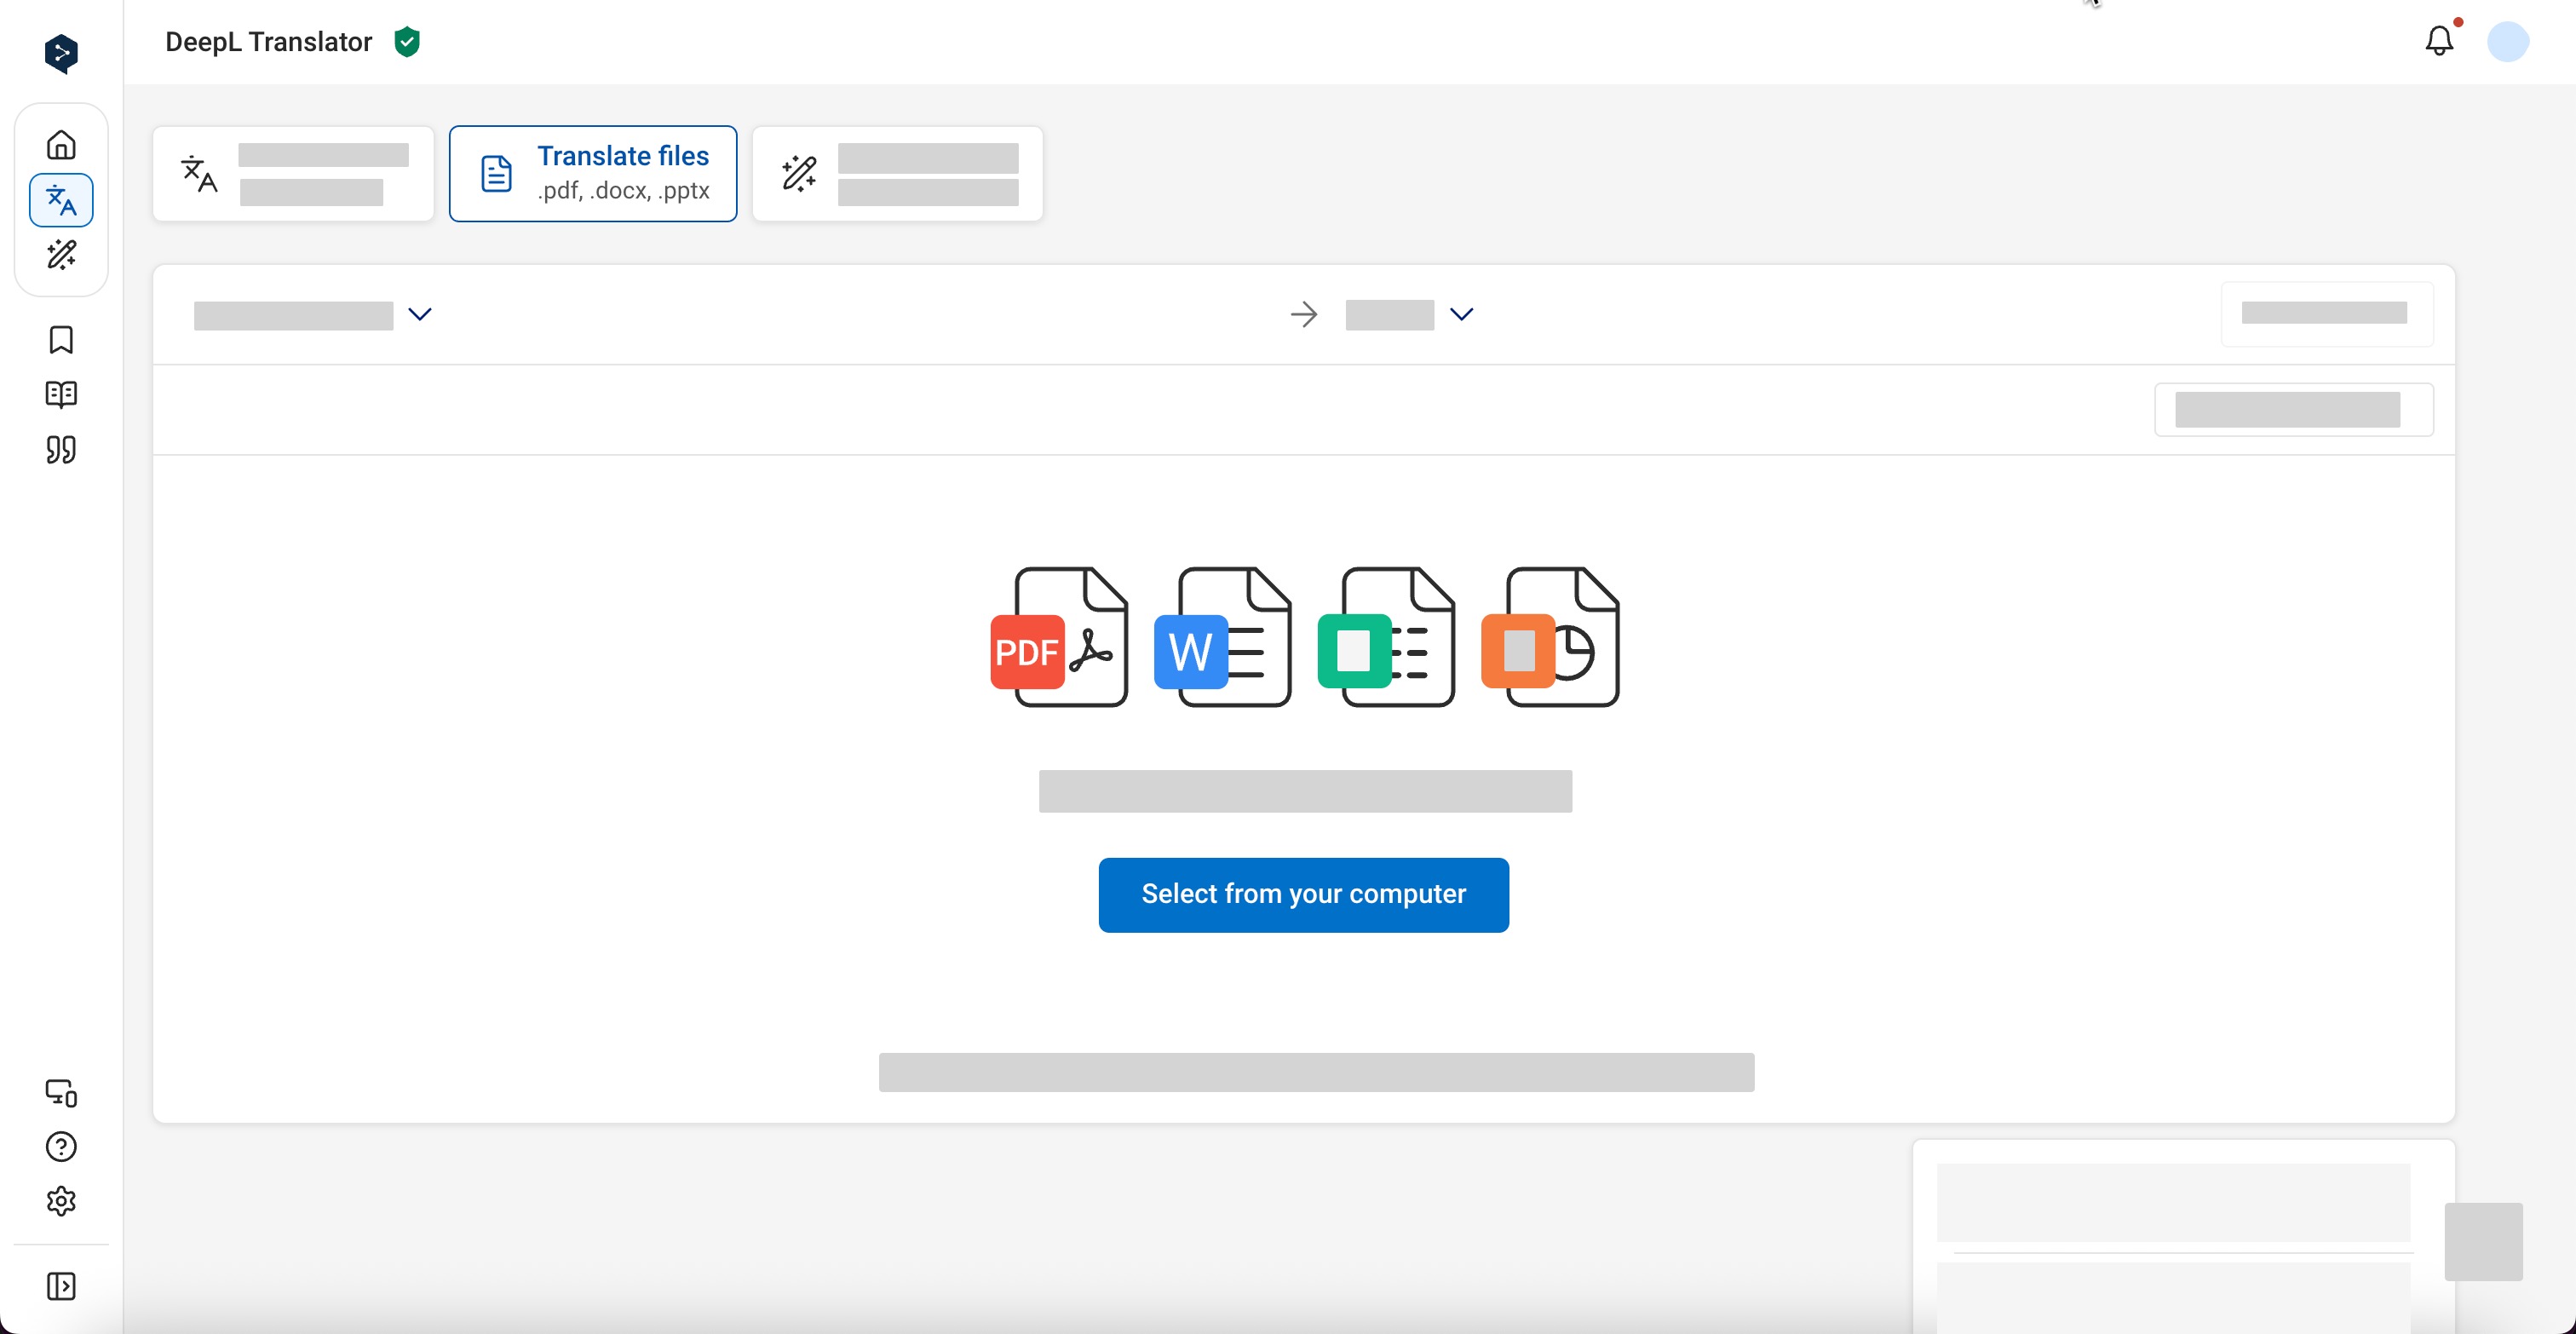
Для сканов DeepL прямо связывает качество перевода с качеством исходного изображения. Большие изображения и нестандартные шрифты тоже способны ухудшить итог. PDF, экспортированные из CAD-систем, к примеру планы, в режиме перевода файлов не поддерживаются. Это важное разграничение: файл с чертежом лучше не воспринимать как обычный текстовый PDF.
- Откройте режим перевода файлов и выберите PDF.
- Укажите английский как исходный язык и русский как целевой.
- Запустите перевод и дождитесь создания итога.
- Если доступен выбор выходного формата и документ необходимо править, применяйте редактируемый вариант; для чтения сохраняйте PDF.
- Сопоставьте заголовки, списки, таблицы и подписи со страницами оригинала.
- Для сканированного исходника отдельно проверьте фрагменты с мелким шрифтом, низким контрастом и нестандартными гарнитурами.
- Перед распространением проведите терминологическую вычитку и контроль чисел.
DeepL удобно применять как один из вариантов для профессиональной черновой обработки, но качество машинного перевода нельзя оценивать по гладкости русской фразы. Даже естественно звучащее предложение необходимо сверять с исходным смыслом, в особенности в условиях договора, технических требованиях, финансовых показателях и заявлениях, которые могут трактоваться юридически.
Плюсы
- Переводится весь PDF как файл, без ручного переноса абзацев.
- Доступен на веб-платформе и в настольных приложениях.
- В рабочем процессе можно получить итог в PDF, а в поддерживаемых вариантах — в редактируемом формате.
- Подходит для длинных текстовых документов, которые затем проходят редакторскую вычитку.
Минусы
- Для перевода PDF необходима учётная запись.
- Качество скана напрямую влияет на качество итога.
- PDF из CAD-систем не поддерживаются в режиме перевода файлов.
- Сложные шрифты и крупные изображения требуют добавочной проверки.
Кому подойдёт
DeepL логичен для исследований, аналитических записок, корпоративной документации и материалов, где команда хочет получить цельную русскую версию и затем провести редактуру. Для сканов и дизайнерских макетов сперва оцените техническое состояние файла, чтобы не путать ошибки распознавания с ошибками перевода.
Google Drive + Google Docs: распознать скан и перевести документ
Связка Google Docs и Google Drive полезна, когда исходный PDF — небольшой скан и сперва необходим текст. В Drive PDF можно открыть через Google Docs: сервис извлечёт текст из страниц и создаст редактируемый документ. Затем в Google Docs на компьютере применяется Tools → Translate document, после чего создаётся отдельная переведённая копия.
Для OCR в Google Drive справка рекомендует небольшой исходник: PDF или изображение до 2 МБ, текст высотой не менее 10 пикселей, правильную ориентацию, резкое изображение и хороший контраст. Форматирование переносится ограниченно: таблицы, колонки, сноски и концевые примечания распознаются непредсказуемо. По этой причине этот путь стоит выбирать ради текста, а не ради сохранения сложной верстки.
- Загрузите PDF в Google Drive с компьютера.
- Щёлкните по файлу правой кнопкой и откройте его через Google Docs.
- Проверьте распознанный английский текст: порядок строк, абзацы, цифры и специальные символы.
- Исправьте очевидные ошибки OCR до перевода.
- В Google Docs выберите Tools → Translate document, задайте русский язык и имя новой копии.
- Откройте переведённую копию и проведите редактуру.
- При необходимости вернитесь к страничному режиму, восстановите структуру и экспортируйте документ в PDF.
Xeon Live отдельно показывает, как открыть PDF в Google Документах. Этот маршрут в особенности полезен для старых сканов, писем и небольших приложений, где важнее быстро получить редактируемый текст. Для каталога с десятками сложных многостраничных PDF лучше применять инструмент, рассчитанный на контролируемый OCR и последующую проверку.
Плюсы
- Позволяет получить редактируемый текст из небольшого сканированного PDF.
- Перевод создаётся как отдельная копия Google Docs, исходник в Drive остаётся доступен.
- Удобно последовательно исправить OCR, перевести и отредактировать текст.
- Подходит для совместной вычитки несколькими участниками.
Минусы
- Для OCR Google Drive рекомендует небольшой размер исходного файла.
- Таблицы, колонки и сложная верстка после распознавания часто требуют ручного восстановления.
- Команда Translate document для полноценного перевода документа применяется на компьютере.
- Файл обрабатывается в облачной среде, по этой причине конфиденциальность необходимо сверять с правилами организации.
Кому подойдёт
Этот метод подходит для небольших сканов, архивных писем, справочных материалов и приложений, где исходная верстка вторична. Он тоже удобен редакционной команде, когда распознанный и переведённый текст необходимо совместно вычитать, прокомментировать и подготовить к новой верстке.
Как выбрать метод под конкретный PDF
Ни один инструмент не выигрывает во всех сценариях. Рациональный выбор начинается с трёх вопросов: есть ли в документе нормальный текстовый слой, необходимо ли сохранить исходную верстку и можно ли передавать файл в облачный сервис. Дальше учитываются объём, наличие таблиц, конфиденциальность и требование к финальному формату.
Если PDF обычный текстовый
- Необходимо быстро прочитать содержание. Подойдут Google Translate или DeepL с загрузкой файла целиком.
- Необходима PDF-цепочка без перехода в DOCX. Рассмотрите Acrobat с переводом через Adobe Express и обязательным просмотром итога.
- Необходима серьёзная редактура русского текста. Откройте PDF в Word, переведите документ и работайте с редактируемой копией.
- Необходим только фрагмент. Извлеките конкретный текст в PDF Commander и переведите его отдельно, не отправляя весь документ.
Если PDF — скан
- Сперва OCR, потом перевод. Для Windows PDF Commander позволяет распознать страницы и извлечь текст; для небольшого файла можно применять Google Drive + Google Docs.
- Не полагайтесь на внешний вид страницы. После OCR скопируйте несколько фрагментов и проверьте порядок слов, цифры и знаки.
- Исправляйте OCR до перевода. Ошибка в распознавании превращается в смысловую ошибку, которую переводчик уже не отличит от исходного текста.
- Сложную верстку планируйте восстановить отдельно. OCR решает задачу извлечения текста, а не гарантирует точную реконструкцию таблиц и колонок.
Если в PDF много таблиц, диаграмм и сложных колонок
Сперва определите, что важнее: получить русский текст или сохранить внешний вид. Для анализа данных можно вынести текст и таблицы в редактируемый формат, перевести и затем привести структуру в порядок. Для брендбука, отчёта с инфографикой или презентационного приложения порой эффективнее переводить отдельные текстовые области и оставлять дизайн под контролем верстальщика. Полностью автоматический перенос сложной страницы часто создаёт больше ручной работы, чем заблаговременно выбранный структурированный процесс.
Схемы и диаграммы требуют отдельного контроля. Текст внутри изображения не всегда входит в основной текстовый слой PDF. Сопоставьте каждый визуальный объект с исходником и отметьте, какие подписи остались на английском. Если файл пойдёт клиенту, это часть содержания, а не косметическая мелочь.
Если документ конфиденциальный
Не начинайте с загрузки полного файла в первый удобный сервис. Сперва проверьте внутреннюю политику компании, договор с клиентом, правила работы с персональными данными и список разрешённых облачных инструментов. Для закрытого материала разумно минимизировать объём передаваемых данных: переводить только нужные фрагменты, обезличивать рабочую копию там, где это допускает процесс, или применять утверждённый корпоративный канал.
Сам факт наличия защищённого соединения в браузере не заменяет организационные требования к хранению и передаче документа. Ответственность за выбор сервиса зависит от характера данных и внутренних правил. В статье намеренно не даётся универсальное обещание конфиденциальности для внешних переводчиков: такую гарантию необходимо получать из конкретных договорных условий и настроек вашей организации.
Как проверить качество перевода PDF
Итоговый контроль состоит из трёх независимых слоёв: полнота, смысл и верстка. Если проверять только русский текст, легко пропустить целый непереведённый блок. Если смотреть только страницы, можно не заметить смысловую подмену в термине или числе. По этой причине проверка идёт в одном порядке для всех инструментов.
1. Полнота
- Сопоставьте число страниц исходника и итога.
- Просмотрите заголовки, подзаголовки, списки, сноски, колонтитулы и подписи к изображениям.
- Отыщите оставшиеся английские слова поиском по документу и ручным способом проверьте, относятся ли они к брендам, именам и допустимым терминам.
- Убедитесь, что таблицы не потеряли строки и столбцы, а нумерация пунктов не сбилась.
- Проверьте ссылки, номера рисунков, ссылки на разделы и упоминания приложений.
2. Смысл
Сверяйте не каждое слово подряд, а места с высоким риском ошибки: отрицания, условия, ограничения, проценты, сроки, сравнительные формулировки, наименования ролей, обязательства сторон, единицы измерения и профессиональные термины. Для маркетингового документа отдельно проверьте метрики и наименования этапов воронки; для исследования — методологию, подписи к графикам и выводы; для договора — модальность фраз и юридически значимые формулировки.
- цифры, проценты, диапазоны и знаки плюс/минус;
- даты и порядок день–месяц–год;
- десятичные разделители и единицы измерения;
- имена, фамилии, наименования компаний и продуктов;
- термины из заблаговременно подготовленного словаря;
- слова, меняющие обязательность: must, may, should, required, prohibited;
- отрицания и исключения: not, except, unless, without;
- ссылки на таблицы, разделы, приложения и рисунки.
3. Верстка
Русские слова имеют другую среднюю длину, по этой причине даже корректный перевод меняет плотность страницы. Проверьте переполнение текстовых блоков, переносы, отступы, высоту строк и границы таблиц. В презентационных материалах убедитесь, что подпись не заехала на диаграмму, а в бланках и формах — что текст не перекрывает поля для заполнения.
Если итог требует ручных правок уже в PDF, пригодится инструкция по редактированию PDF. Для итогового файла не следует менять шрифт или размер текста наугад только ради того, чтобы всё поместилось. Сперва проверьте редакционную формулировку, затем применяйте согласованные параметры верстки.
Практические метрики для командной приёмки
Для регулярного перевода документов полезно считать несколько внутренних показателей. Это не универсальный стандарт качества и не оценка конкретного сервиса; это управленческий метод понять, сколько ручной работы остаётся после автоматизации. Набор метрик должен быть одинаковым для сравниваемых процессов и применяться к сопоставимым документам.
- Доля непереведённых сегментов. Количество пропущенных смысловых блоков делится на общее число проверенных блоков в выборке.
- Доля терминологических исправлений. Сколько утверждённых терминов пришлось заменить после машинной обработки.
- Число критичных числовых расхождений. Любое изменённое число, дата, процент или единица учитываются отдельно, поскольку даже одна такая ошибка способна сделать документ непригодным.
- Время постредактуры на страницу. Считайте только фактическую вычитку и исправления после получения перевода; это помогает сопоставить маршруты по трудозатратам.
- Число страниц с заметной перестройкой верстки. Фиксируйте страницы, где пришлось ручным способом восстанавливать таблицу, блоки, колонки или подписи.
- Повторяемость терминов. Проверяйте, одинаково ли переведён один утверждённый термин в различных разделах.
Для пилота достаточно взять один типичный документ и прогнать два подходящих маршрута. Важно не смешивать различные исходники: скан с таблицами и чистый текстовый отчёт нельзя сопоставлять напрямую. После приёмки команда видит, где экономится время, а где автоматический перевод просто переносит работу на этап исправления верстки.
Типичные ошибки и как их исправить
Ошибка 1. Отправить скан как обычный PDF
Когда PDF состоит из изображений, переводчик не получает полноценный текст. В Google Translate это в особенности важно: текст в сканированных страницах не переводится в режиме документов. Исправление простое — сперва OCR, затем проверка распознанного текста и лишь после этого перевод.
Ошибка 2. Считать удачную фразу доказательством точности всего файла
Машинный перевод может звучать гладко и вместе с этим неверно передавать условие, термин или цифру. Не оценивайте документ по первой странице. Проверяйте места с отрицаниями, ограничениями, метриками и профессиональной лексикой, а затем делайте выборочный контроль середины и конца файла.
Ошибка 3. Переводить до исправления OCR
Неверно распознанное английское слово становится входными данными для переводчика. На выходе получается грамматически правильная, но бессмысленная русская фраза. Сперва исправляйте распознавание, в особенности в наименованиях, артикулах, числах и аббревиатурах.
Ошибка 4. Ожидать от Word пиксельного совпадения с PDF
Word реконструирует редактируемую копию и старается повторить исходный макет, но не обещает идентичный вид. Если документ содержит много графики, часть страницы способна стать изображением. Планируйте проверку структуры непосредственно после открытия PDF, до перевода.
Ошибка 5. Забыть текст внутри изображений
Инфографика, скриншоты, диаграммы и рекламные макеты часто содержат важные подписи, не связанные с текстовым слоем PDF. Создайте отдельный список таких элементов и проверьте их по каждой странице. Для публикации клиенту оставшийся английский текст в диаграмме выглядит как незавершённая работа.
Ошибка 6. Перезаписать исходник
Перевод всегда делайте на копии. Даже если инструмент создаёт новый файл автоматически, храните оригинал отдельно до финальной приёмки. Это позволяет восстановить пропавший фрагмент, сопоставить таблицу, проверить число или ещё раз собрать страницу без поиска исходной версии в почте.
Ошибка 7. Загружать чувствительный документ без проверки политики
Для договора, кадрового файла, внутреннего отчёта или клиентского брифа сперва определите, разрешён ли выбранный сервис. Если правила запрещают внешний облачный перевод, применяйте утверждённый процесс или передавайте только разрешённые фрагменты. Удобство не отменяет требований к данным.
Что делать со сканированным PDF: отдельный рабочий процесс
Скан — это не особая разновидность перевода, а добавочный технологический этап перед ним. Чем чище текст после OCR, тем меньше смысловых и версточных ошибок дальше. Если страницы перекошены, размыты или сняты с тенями, сперва улучшите оригинальное изображение либо пересканируйте документ. Для OCR важнее читаемость символов, чем внешняя красота страницы.
Шаг 1. Привести страницы в правильную ориентацию
Проверьте, что все страницы повернуты одинаково и читаются сверху вниз. Автоматический поворот помогает не всегда, в особенности в смешанном файле с альбомными таблицами. Если отдельная таблица должна остаться горизонтальной, не разворачивайте её только ради единообразия — лучше проверить, как её видит выбранный OCR.
Шаг 2. Распознать английский текст
Выберите английский язык явно, когда это доступно. Для двуязычного документа задайте оба языка либо применяйте режим, который рассчитан на смешанный текст. После OCR не переходите сразу к переводу: скопируйте абзац из начала, середины и конца, потом сопоставьте с изображением.
Шаг 3. Исправить структуру
Уберите переносы, появившиеся в середине слов, восстановите абзацы, проверьте порядок колонок и границы таблиц. Если таблица распозналась как последовательность строк, решите, необходима ли её реконструкция до перевода или после. Для смысловой работы сперва важнее правильно связать ячейки и подписи, чем повторить толщину линий.
Шаг 4. Перевести и вычитать
После очистки текст можно отправлять в выбранный переводчик. Применяйте заблаговременно подготовленную терминологию и не исправляйте все спорные места в процессе чтения хаотично. Лучше пройти документ отдельными кругами: сперва смысл, затем числа и термины, затем верстка.
Шаг 5. Собрать финальный PDF
Если документ необходим лишь для внутреннего ознакомления, достаточно аккуратной редактируемой копии с экспортом в PDF. Для внешней публикации восстановите заголовки, таблицы, нумерацию и подписи. После экспорта откройте именно финальный PDF и убедитесь, что шрифты встроились правильно, страницы не обрезаны и поиск отыскивает русский текст.
Как работать с таблицами, диаграммами и многоязычными страницами
Таблица одновременно несёт текст и структуру. Перевод слов без сохранения связи между строкой и столбцом может полностью изменить смысл. Перед обработкой определите заголовки, единицы измерения и примечания. После перевода сверяйте таблицу не построчно сверху вниз, а по ячейкам: наименование показателя, период, значение и единица должны оставаться одной логической записью.
Для диаграммы сохраните числовые данные без изменений, а текстовые подписи проверяйте отдельно. Если подписи встроены в растровое изображение, обычный перевод PDF их не заменит. В этом случае подготовьте русскую версию визуала в исходном редакторе или обработайте изображение по согласованному процессу; не пытайтесь закрывать английские подписи случайными текстовыми плашками прямо в финальном PDF.
На двуязычных страницах заблаговременно решите, какой текст считается исходным. К примеру, в международном договоре английская и вторая языковая колонка могут уже иметь юридически заданный приоритет. Автоматическое смешивание двух колонок создаёт риск, что фразы объединятся. Для таких документов лучше переводить конкретный языковой слой или отдельные области страницы.
Бизнес-сценарии: какой итог считать достаточным
Исследование рынка или аналитический отчёт
Цель — быстро извлечь смысл, методологию, выводы и данные. Сохранение каждой декоративной детали вторично. Сперва переведите текстовый файл целиком, затем отдельно проверьте методологические ограничения, наименования метрик, подписи к графикам и источники данных. Итог можно принимать по полноте разделов, отсутствию изменённых чисел и единообразию терминологии.
Клиентский бриф и коммерческий материал
Тут важны и смысл, и тон, и структура. Машинный итог применяйте как черновик, затем редактор приводит формулировки к нормальному русскому языку без добавления обещаний, которых не было в оригинале. В конце сопоставляют требования, сроки, роли, формат итога и все числовые параметры.
Договор или юридически значимое приложение
Автоматическая обработка помогает быстрее разобраться в тексте, но итоговая версия, на которую будут опираться решения или подписи, требует профильной проверки. Контролируйте модальность, отрицания, сроки, суммы, определения сторон и ссылки на пункты. Если существует утверждённый перевод или корпоративная терминология, он имеет приоритет над стилистической гладкостью машины.
Презентационный PDF, брендбук или дизайн-гайд
Тут большая часть трудозатрат появляется после перевода: русский текст меняет длину строк и нарушает композицию. Выгоднее сперва получить качественный текстовый перевод, а затем перенести его в исходный макет с участием дизайнера. Проверяйте не только слова, но и то, как изменились акценты, переносы, размер подписи и баланс страницы.
Техническая инструкция
В инструкции опасны неуклюжие, но понятные фразы меньше, чем неправильные команды, единицы и предупреждения. Перед публикацией сверяйте наименования кнопок с реальным интерфейсом продукта, не переводите зарегистрированные наименования произвольно и сохраняйте последовательность шагов. Если интерфейс локализован на русский, применяйте его фактические подписи, а не буквальный перевод английских команд.
Как организовать перевод в команде
Для единичной задачи один человек может пройти весь процесс самостоятельно. Для регулярных материалов лучше разделить роли: владелец документа отвечает за актуальный исходник, технический исполнитель — за OCR и конвертацию, редактор — за русский текст, профильный специалист — за термины и критичные утверждения. Так меньше шансов, что один человек одновременно исправит смысл, числа и верстку и пропустит ошибку.
- До перевода: зафиксируйте исходный файл, язык, объём, конфиденциальность, терминологию и ожидаемый формат итога.
- После OCR: проверьте читаемость текста и структуру, не смешивая этот этап с редактурой русского языка.
- После машинного перевода: выполните смысловую вычитку и терминологическую сверку.
- После верстки: сопоставьте финальный PDF с исходником по страницам и визуальным объектам.
- Перед отправкой: откройте файл на ином устройстве или в другом просмотрщике, проверьте поиск, ссылки, шрифты и отсутствие повреждённых страниц.
Как не потерять ссылки, закладки и служебные элементы
PDF может содержать больше, чем видимый текст. Внутренние ссылки, закладки, формы, комментарии и вложения не всегда переживают конвертацию в редактируемый документ. Если эти элементы важны, составьте их список до перевода и проверьте после сборки. Для отчёта достаточно сохранить переходы из оглавления; для формы важнее работоспособность полей; для инструкции — кликабельные ссылки и закладки.
Не переносите в русскую версию старые комментарии и скрытые служебные пометки автоматически, если они предназначались лишь для внутренней работы. Перед передачей внешнему получателю проверьте свойства документа, аннотации и вложенные файлы. Перевод текста не является очисткой метаданных или истории работы.
Когда необходимо разделить большой PDF на части
Разделение помогает, когда сервис ограничивает размер файла, когда обработка всей книги занимает слишком много времени или когда различные разделы переводят различные специалисты. Делите документ по логическим границам: главам, приложениям или большим разделам. Не разрывайте таблицу посередине и не отделяйте сноски от страницы, к которой они относятся.
Перед разделением сохраните карту страниц: диапазон исходника, имя части и будущий порядок сборки. После перевода проверьте, что ни одна часть не пропущена и не продублирована. В собранной версии восстановите нумерацию, оглавление и перекрёстные ссылки, если они применялись.
Для уменьшения технического размера без изменения содержания можно изучить способы сжатия PDF, но сжатие не должно ухудшить скан настолько, чтобы OCR начал ошибаться. Если документ предстоит распознавать, читаемость текста важнее минимального веса файла.
Что делать, если перевод получился плохо
Сперва определите источник дефекта. Если русский текст бессмысленный уже из-за неправильных английских слов, проблема в OCR. Если исходный английский прочитан верно, но термин переведён неудачно, исправляется перевод или словарь. Если смысл хороший, а таблица развалилась, проблема в конвертации и верстке. Разделение ошибок по этапам экономит время и не заставляет переделывать весь документ.
Проблема в OCR
- отыщите более качественный исходник или пересканируйте страницу;
- выправьте ориентацию и контраст;
- укажите правильный язык распознавания;
- распознавайте сложную страницу отдельно;
- после OCR исправьте текст до запуска перевода.
Проблема в переводе
- уточните исходный и целевой язык;
- добавьте контекст многозначному термину;
- проверьте профессиональные термины по утверждённому словарю;
- разбейте чрезмерно длинный или плохо структурированный фрагмент;
- для критичного документа передайте спорные места профильному специалисту.
Проблема в верстке
- перейдите в редактируемый формат и восстановите стили;
- сократите только редакционно допустимые русские формулировки, не теряя смысл;
- расширьте текстовые блоки или пересоберите таблицу;
- перенесите перевод в исходный дизайн-макет вместо попытки исправить сложный PDF постфактум;
- после каждого большого изменения заново экспортируйте PDF и проверяйте итоговый файл.
Чек-лист перед отправкой переведённого PDF
- Исходный файл сохранён отдельно и не перезаписан.
- Все нужные страницы присутствуют в итоговом документе.
- В файле не осталось случайных английских абзацев и подписей.
- Бренды, имена и профессиональные термины оформлены единообразно.
- Числа, проценты, даты и единицы совпадают с оригиналом.
- Таблицы сохранили связь заголовков, строк и значений.
- Сноски, ссылки, номера рисунков и приложения находятся на своих местах.
- Русский текст не выходит за границы блоков и не перекрывает графику.
- PDF открывается ещё раз после сохранения, текст ищется и копируется там, где это требуется.
- Для конфиденциального документа соблюдён утверждённый процесс передачи и хранения.
- Файл вычитан не только исполнителем перевода, но и владельцем содержания, если документ влияет на внешние коммуникации или решения.
Частые вопросы
Можно ли перевести PDF целиком без конвертации?
Да. Текстовый PDF можно загрузить целиком в Google Translate или DeepL; Acrobat переводит PDF через Adobe Express. Перед обработкой проверьте, что нужные страницы в самом деле содержат текстовый слой. Для скана сперва необходим OCR.
Что делать, если PDF состоит из сканов?
Сперва распознайте текст. На Windows это можно сделать в PDF Commander, а небольшой скан — через Google Drive и Google Docs. После OCR обязательно проверьте английский текст и исправьте ошибки до перевода.
Почему после перевода съехала верстка?
Русский текст отличается по длине, а конвертеры реконструируют фиксированную PDF-страницу по своим правилам. В особенности часто меняются колонки, таблицы, сноски и подписи. Финальный PDF необходимо сопоставить с оригиналом по страницам.
Можно ли перевести только несколько страниц?
Да. В Acrobat можно выбрать объём перевода, а в PDF Commander — распознать или извлечь конкретный диапазон и перевести только нужный текст. Для большого файла это уменьшает объём лишней обработки и упрощает контроль.
Как поступать с конфиденциальными документами?
Сперва примените правила организации и условия договора с владельцем данных. Не загружайте закрытый файл во внешний сервис только из-за удобства. Применяйте разрешённый канал или обрабатывайте только допустимые фрагменты.
Как понять, что перевод готов к отправке?
Проверьте полноту, смысл и верстку отдельно: отсутствие пропусков, точность терминов и чисел, затем таблицы, подписи, ссылки и переносы. После этого ещё раз откройте именно финальный PDF и проверьте его как получатель.
Итог: какой метод выбрать
Для сканированного PDF на Windows начинайте с PDF Commander: распознайте текст, проверьте OCR и передайте подготовленный материал в переводчик. Для обычного PDF, который необходимо сохранить в PDF-цепочке, подойдёт Acrobat с Adobe Express. Если после перевода предстоит серьёзная редактура, удобнее открыть документ в Word, получить переведённую копию и только потом вернуться к PDF. Для быстрого чтения текстового файла применяйте Google Translate или DeepL; для небольшого скана без локального OCR можно связать Google Drive и Google Docs.
Главный критерий качества — не наименование инструмента, а управляемый процесс: определить тип PDF, получить корректный исходный текст, перевести, проверить смысл, сверить числа и восстановить верстку. Так автоматизация в самом деле сокращает время, а не переносит ошибки из английского исходника в русский финал.