
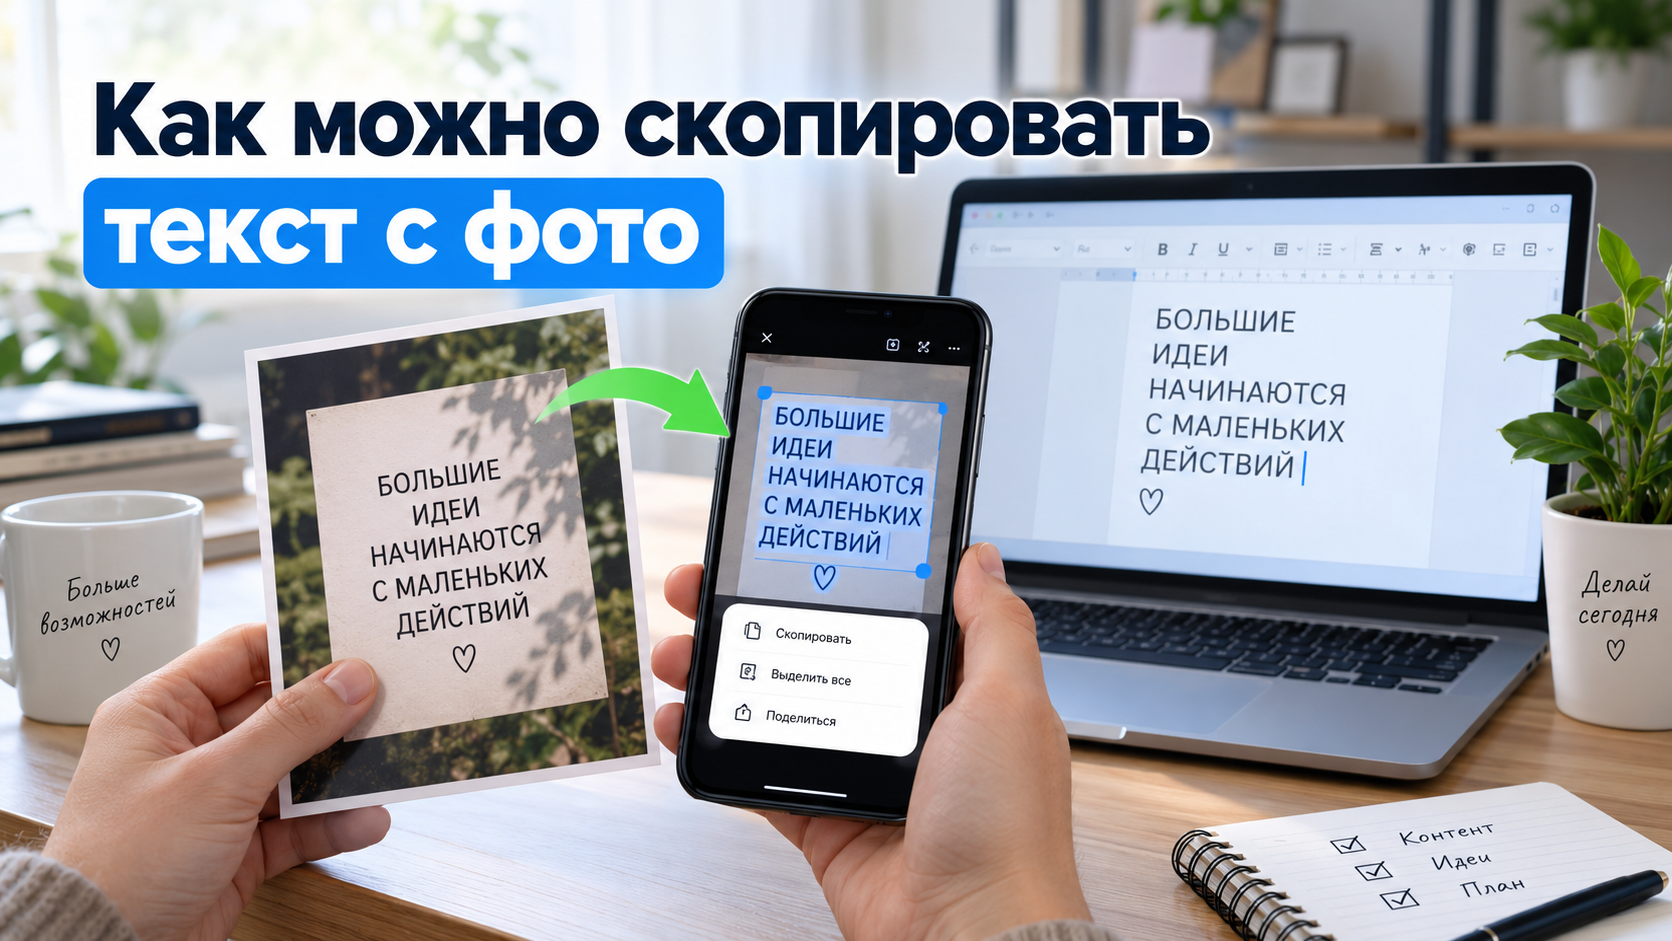
Текст на фотографии выглядит обычным текстом лишь для человека. Для компьютера снимок — набор пикселей, по этой причине выделить абзац курсором и нажать Ctrl+C обычно нельзя. Задачу решает оптическое распознавание символов — OCR: программа отыскивает строки и знаки на изображении, превращает их в редактируемые символы и отдаёт итог в буфер обмена или новый документ. На практике важен не сам факт распознавания, а весь путь от исходного кадра до проверенного текста: подготовить изображение, выбрать подходящий инструмент, распознать нужную область и сверить итог с оригиналом.
В рабочих коммуникациях такой сценарий встречается постоянно: необходимо забрать формулировку со слайда презентации, перенести реквизиты со скана, собрать цитату из фотографии печатного отчёта, переписать подписи с макета, извлечь текст с рекламного носителя или быстро сделать редактируемой заметку, полученную в мессенджере как картинка. Детальный разбор извлечения текста из картинки и скриншота на Xeon Live дополняет эту инструкцию более широким набором программ; тут акцент сделан на восьми практических маршрутах, которые закрывают Windows, смартфоны и браузер.
Ни один OCR не стоит воспринимать как финального редактора. После автоматического распознавания в особенности тщательно проверяют числа, даты, артикулы, фамилии, наименования брендов, ссылки, сокращения и сочетания похожих символов. Ошибка в обычном слове заметна при чтении, а замена 0 на O, 1 на I или кириллической С на латинскую C может остаться незаметной и испортить отчёт, карточку товара или внутренний документ. По этой причине в конце материала есть отдельная методика контроля качества и метрики, которыми удобно измерять экономию времени без самообмана.
Сперва определите, какой итог необходим
Метод лучше выбирать не по популярности приложения, а по форме исходника и тому, что должно получиться на выходе. Одно дело — скопировать две строки со скриншота, другое — превратить фотографию страницы договора в документ, где текст можно искать и редактировать. Третья ситуация — мобильная: сотрудник снимает вывеску, ценник или лист на встрече и сразу переносит фрагмент в заметки. Четвёртая — браузерная, когда установка программы запрещена политикой компании или работа идёт на чужом компьютере.
- Необходим текст из фотографии или скана как часть документа. Выбирайте редактор документов PDF (Portable Document Format) с OCR: такой путь сохраняет связь между изображением, страницами и распознанным слоем.
- Необходимо забрать несколько строк с уже открытого экрана. Быстрее работают «Ножницы» Windows или Text Extractor из PowerToys: файл даже не обязательно отдельно открывать в OCR-программе.
- Изображение уже вставлено в рабочие заметки. В OneNote текст копируется непосредственно из картинки через контекстное меню.
- Фото находится на iPhone или iPad. Live Text позволяет выделять надпись так же, как обычный текст в приложении «Фото».
- Фото хранится на Android или синхронизировано с Google Фото. Google Lens распознаёт надпись и отдаёт выбранный фрагмент в буфер обмена.
- Нельзя устанавливать программу. Google Drive с Google Docs и i2OCR выполняют OCR в браузере, но такой метод требует осознанно относиться к передаче файлов во внешний сервис.
Для конфиденциальных материалов критерий выбора меняется: важнее не скорость, а контроль над тем, куда попадает файл. Паспортные данные, закрытые договоры, внутренние финансовые формы, клиентские базы и медицинские документы не стоит отправлять в случайный веб-сервис только ради пары скопированных строк. Для таких задач предпочтительна локальная обработка на управляемом компьютере или корпоративный облачный сервис, который уже разрешён политикой информационной безопасности.
Как подготовить фото к распознаванию
Качество OCR начинается до нажатия кнопки «Распознать». Алгоритму проще работать с ровной, резкой и контрастной страницей, чем с кадром под острым углом, бликами и лишним фоном. Это не означает, что снимок необходимо агрессивно улучшать фильтрами: чрезмерная резкость, сильное подавление шума и пересвет способны разрушить тонкие элементы букв. Задача подготовки — сделать символы различимыми и геометрию страницы предсказуемой, а не превратить документ в эффектную фотографию.
- Выпрямите перспективу. Камеру держат максимально параллельно листу. Трапециевидная страница усложняет разбиение текста на строки и в особенности мешает таблицам.
- Уберите блики. Глянцевую бумагу лучше снимать при боковом рассеянном свете. Яркое пятно, закрывающее несколько букв, OCR восстановить надёжно не сможет.
- Обрежьте лишнее. Стол, пальцы, соседние страницы, декоративная рамка и элементы интерфейса не несут полезной информации, но добавляют области для анализа.
- Не уменьшайте исходник без причины. Для мелкого шрифта важны реальные пиксели. Сперва распознают исходную фотографию, а сжимают копию уже после получения текста.
- Поверните страницу правильно. Даже сервис с автоопределением ориентации работает стабильнее, когда строки изначально идут горизонтально.
- Укажите язык, когда инструмент предлагает выбор. Это в особенности важно для смешанных кириллических и латинских текстов, имён собственных и технических обозначений.
- Разделяйте сложные макеты. Две колонки, подпись под фотографией и боковая врезка легче проверяются по отдельным областям, чем единым потоком.
- Сохраните оригинал. Кадр после обрезки и коррекции не должен быть единственной копией: исходник необходим для повторной сверки спорных символов.
Для контент-команды полезно заблаговременно договориться о минимальном стандарте входных изображений. К примеру, сотрудник перед распознаванием проверяет резкость при масштабе 100%, обрезает пустые поля и подтверждает, что критичные цифры читаются глазами без увеличения. Такая дисциплина сокращает последующую ручную правку сильнее, чем бесконечная смена сервисов: многие ошибки появляются не на этапе OCR, а в момент съёмки.
С рукописью требования ещё строже. Печатные буквы, ровные интервалы и контрастная ручка распознаются заметно предсказуемее, чем связный почерк с наложением строк. Для важных рукописных заметок разумный рабочий процесс состоит из двух шагов: OCR применяют как черновую расшифровку, затем человек сопоставляет каждое предложение с фото. Автоматический итог не подменяет вычитку.
Как скопировать текст с фото в Windows
1. PDF Commander: фото превращается в рабочий документ
Первый метод — PDF Commander. Он уместен, когда фотография страницы — не одноразовая картинка, а часть дальнейшего документооборота: текст необходимо не только забрать в буфер обмена, но и сохранить рядом с исходной страницей, сделать PDF с поиском, собрать несколько фотографий в один файл или позднее отредактировать документ. В актуальном модуле распознавания доступны быстрое OCR и отдельный режим на основе искусственного интеллекта (AI); для обычной печатной страницы достаточно начать с быстрого варианта и уже затем переходить к добавочным инструментам, когда исходник сложный.
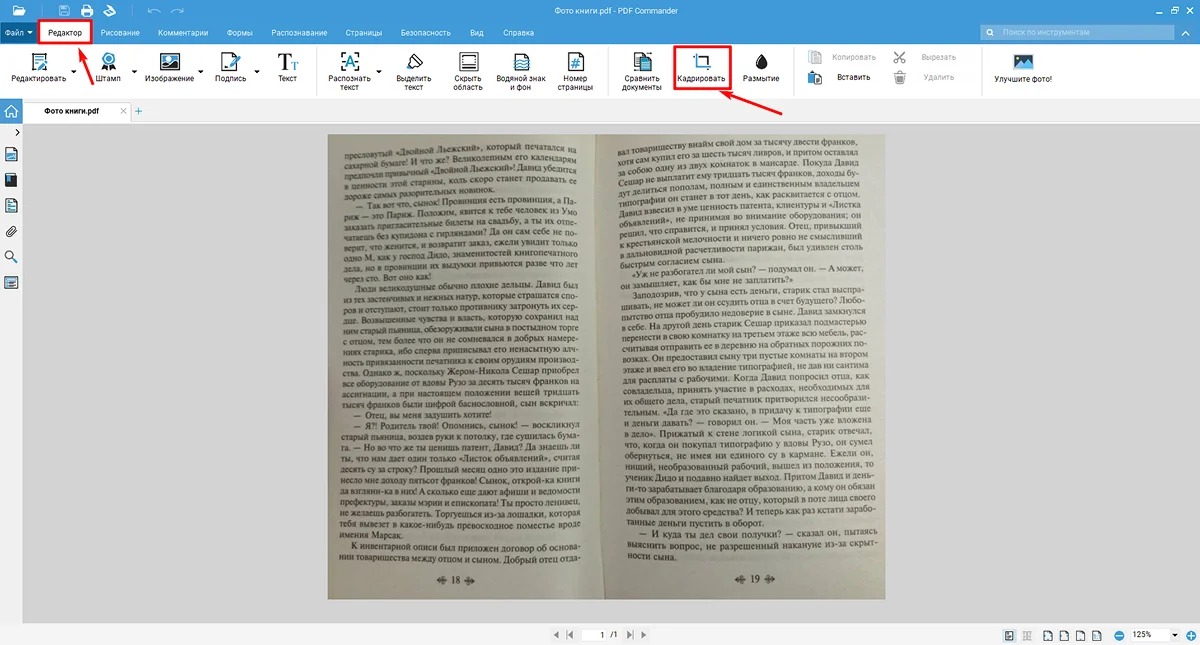
Рабочий маршрут начинается с импорта фотографии. Одиночный снимок можно открыть через функцию создания PDF из изображения, а несколько кадров — собрать в один документ. Перед OCR полезно привести страницы к одному направлению, обрезать лишние поля и проверить, что текст не размыт. Это в особенности важно для фотографий книг: изгиб у корешка и тень между страницами часто дают больше ошибок, чем сам шрифт.
Пошагово
- Добавьте фотографию в PDF Commander и сформируйте из неё PDF-страницу. При серии снимков сперва расположите страницы в правильном порядке.
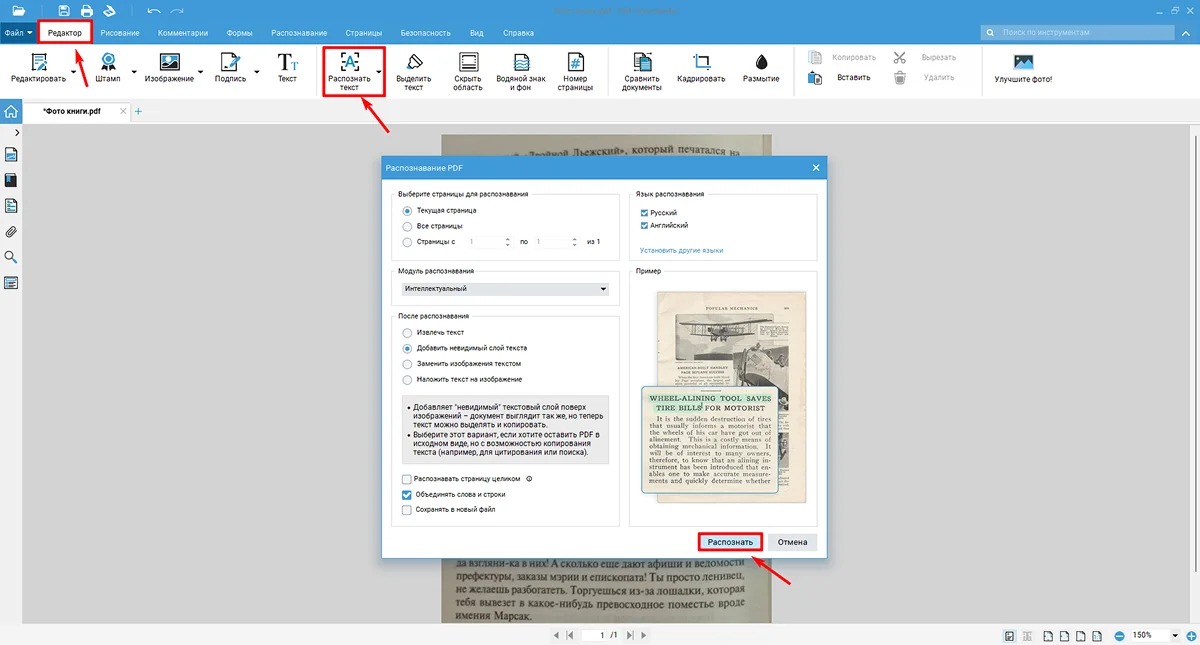
- Откройте раздел «Распознавание» и выберите команду «Распознать текст». Для обычного документа задайте текущую страницу, весь файл или нужный диапазон.
- В типе распознавания выберите «Быстрый». Потом укажите, что необходимо сделать с итогом: извлечь текст, сохранить его в новый файл или добавить невидимый текстовый слой к исходным страницам.
- Укажите язык распознавания. Для смешанного документа проверьте, что нужные языки в самом деле выбраны перед запуском.
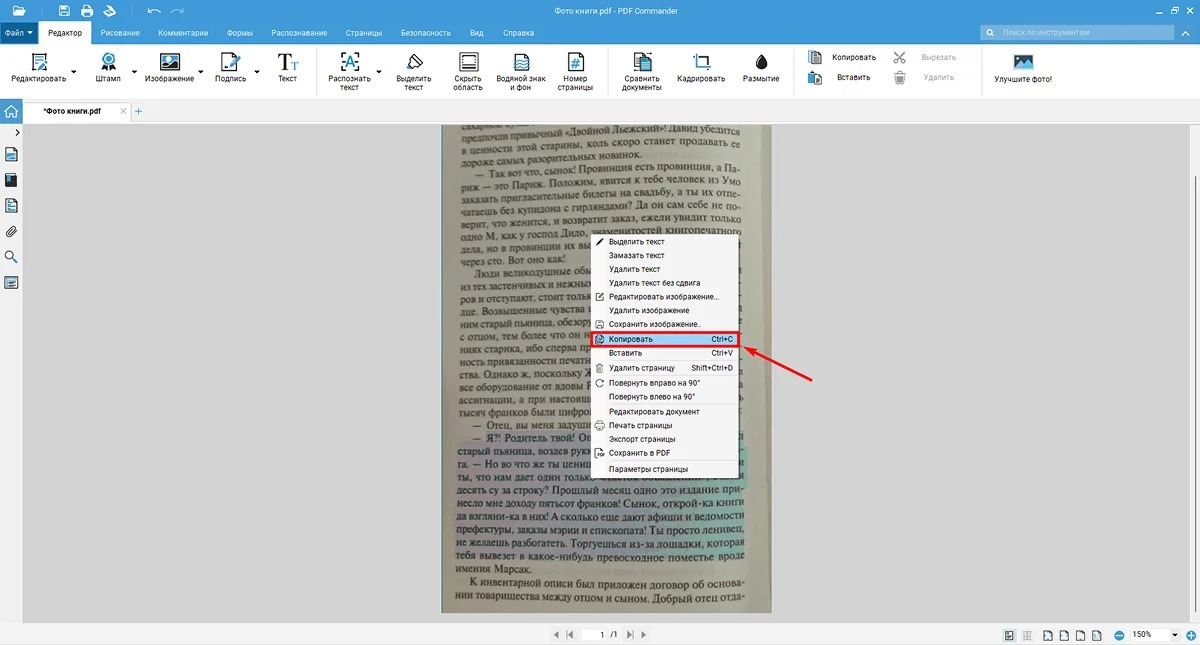
- Нажмите «Распознать» и дождитесь обработки. После окончания выделите нужный текст и перенесите его в буфер обмена либо сохраните документ с распознанным слоем.
- Сразу сопоставьте критичные места с фотографией: номера документов, даты, суммы, имена, домены и сокращения. Исправления вносят до того, как текст уйдёт в письмо, презентацию или систему учёта.
Режим с невидимым текстовым слоем полезен для архива: на экране остаётся исходная фотография страницы, но документ становится доступным для поиска и выделения. Это отличается от простого копирования пары строк: итог можно сохранить как единый рабочий файл и вернуться к нему позднее. Для отдела маркетинга такой подход удобен при оцифровке печатных исследований, буклетов, старых медиапланов и материалов с мероприятий, где важно не потерять оригинальный визуальный контекст.
AI-распознавание имеет смысл оставлять как второй маршрут, а не запускать автоматически для любой страницы. На хорошем прямом скане быстрее и проще обычный OCR; более сложный режим необходим там, где исходник плохо читается, имеет нестандартную геометрию или смешанную структуру. После обработки критерий качества остаётся тем же: совпадение с оригиналом, а не красивый внешний вид итога.
Сильная сторона PDF-подхода — контролируемый документный цикл. Пользователь видит страницу, может обрезать её, распознать, проверить и сохранить в одном проекте. Ограничение тоже очевидно: для двух слов из уже открытого браузера запуск отдельного редактора избыточен. В такой ситуации «Ножницы» или PowerToys дают итог быстрее.
Плюсы
- Подходит для фотографий страниц, сканов и многостраничных документов, где OCR является частью дальнейшей работы с PDF.
- Можно сохранить распознанный слой вместе с исходным изображением и потом искать текст внутри документа.
- Есть настройка диапазона страниц и языка, по этой причине не требуется обрабатывать весь файл целиком.
- Кадрирование и организация страниц выполняются в том же рабочем документе.
Минусы
- Для одной короткой фразы с экрана отдельный PDF-процесс занимает больше действий, чем системный OCR.
- Сложные фотографии всё равно требуют ручной проверки: распознавание не отменяет вычитку чисел, имён и специальных символов.
Кому подойдёт
PDF Commander подходит тем, кто систематически превращает фотографии документов в рабочие PDF: сотрудникам бэк-офиса, маркетологам, исследователям, редакторам и специалистам, которым важно сохранить исходную страницу вместе с доступным для поиска и копирования текстом.
2. «Ножницы» Windows: текст из того, что уже видно на экране
«Ножницы» подходят для самой короткой дистанции между изображением и буфером обмена. Снимок создаётся комбинацией Win+Shift+S, после чего в окне приложения доступна команда «Действия с текстом» — Text actions. Она распознаёт надписи на захваченном фрагменте и позволяет скопировать весь найденный текст или только нужную часть. Тут не нужно заблаговременно сохранять фото в отдельный файл или формировать документ.
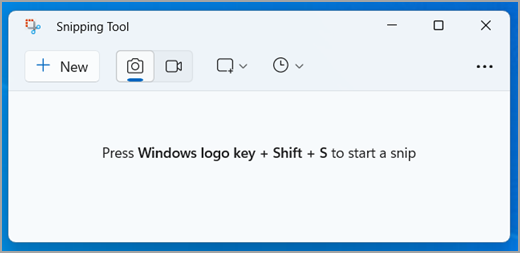
Пошагово
- Откройте фотографию, скриншот, слайд, PDF-страницу или другое изображение так, чтобы нужный текст был читаем на экране.
- Нажмите Win+Shift+S и обведите прямоугольником только область с нужной надписью. Чем меньше посторонних элементов попадает в кадр, тем легче проверять итог.
- Откройте созданный снимок в «Ножницах» и нажмите «Действия с текстом» / Text actions.
- Выберите весь распознанный текст или выделите конкретный фрагмент, потом скопируйте его.
- Вставьте текст в документ, письмо, таблицу или систему управления контентом и сопоставьте итог со снимком.
Этот метод в особенности удобен для визуальных материалов, которые неудобно скачивать: кадр из видеозвонка, слайд вебинара, диаграмма в онлайн-презентации, подпись на изображении внутри сайта. OCR работает по самому снимку экрана, по этой причине путь не зависит от формата исходного файла. Одновременно это и главное ограничение: «Ножницы» не создают многостраничный распознанный архив и не сохраняют структуру большого документа.
В командной работе полезно не снимать весь монитор. Когда в кадре остаются меню, боковые панели, комментарии и другие надписи, OCR честно пытается распознать и их. Узкая область вокруг нужного абзаца уменьшает количество мусора, а заодно уменьшает риск случайно скопировать текст из соседнего окна. Для слайда с несколькими колонками лучше сделать два последовательных фрагмента и вставить их в нужном порядке.
«Ножницы» тоже удобны как контрольный инструмент. Когда другой OCR выдал сомнительный номер или слово, увеличьте спорную область на экране и распознайте её отдельно. Независимое повторное распознавание небольшого фрагмента не доказывает правильность автоматически, но помогает быстро увидеть расхождение и вернуться к оригиналу.
Плюсы
- Минимум действий для короткого текста с экрана: снимок и Text actions находятся в одном системном приложении.
- Не зависит от исходного формата: можно захватить фрагмент браузера, видео, PDF или программы.
- Позволяет ограничить OCR ровно нужной областью и не тянуть в итог лишние подписи.
Минусы
- Не предназначен для пакетной обработки десятков страниц и построения поискового слоя в документе.
- Итог приходится ручным способом собирать, когда нужный текст разбит по нескольким экранам или колонкам.
Кому подойдёт
«Ножницы» — основной вариант для коротких рабочих фрагментов: подписи со слайдов, текст из интерфейса, несколько строк со скриншота, карточки товара или изображения в браузере.
3. PowerToys Text Extractor: OCR поверх любого окна
В Microsoft PowerToys модуль Text Extractor решает похожую задачу, но работает как отдельная системная надстройка. Актуальная комбинация запуска — Win+Shift+T. После нажатия экран переходит в режим выбора области: пользователь обводит текст, а распознанный итог попадает в буфер обмена. Это важно уточнить, потому что в старых инструкциях встречается другая комбинация; для текущего Text Extractor ориентируются на Win+Shift+T из документации Microsoft Learn.
Пошагово
- Убедитесь, что PowerToys запущен и Text Extractor включён в настройках набора утилит.
- Откройте источник на экране: фотографию, кадр видео, презентацию, PDF, удалённый рабочий стол или окно программы.
- Нажмите Win+Shift+T. Курсор переключится в режим выделения области для распознавания.
- Обведите только нужный текст. После окончания выделения распознанная строка копируется в буфер обмена.
- Вставьте итог в целевое приложение и проверьте переносы, пробелы, цифры и символы, которых не было в оригинале.
Text Extractor в особенности хорош там, где постоянно приходится забирать по несколько фрагментов из различных окон. Не нужно создавать отдельные скриншоты и складывать их в папку: OCR вызывается поверх текущего интерфейса. В исследовании рекламных материалов это ускоряет перенос слоганов, подписей к графикам, данных со старых презентаций и коротких цитат, когда исходные файлы недоступны для обычного копирования.
У модуля есть языковое ограничение: он применяет OCR-языки, установленные в Windows. По этой причине при неожиданно слабом итоге первым делом проверяют не только качество изображения, но и языковые пакеты системы. Смешанный текст с латиницей, кириллицей и цифрами требует в особенности внимательной сверки. Microsoft отдельно позиционирует Text Extractor не как замену полноценному документному OCR; для обычной работы со скриншотами в Windows у «Ножниц» есть собственные Text actions.
С точки зрения безопасности Text Extractor удобен ещё и тем, что вы не загружаете изображение в случайный веб-сервис ради распознавания. Это не отменяет требований организации к самому компьютеру и установленным программам, но снижает число внешних точек передачи файла. Для закрытых макетов и внутренних презентаций такой критерий часто важнее пары секунд разницы в скорости.
Плюсы
- Запускается поверх любого окна и сразу отдаёт выделенный фрагмент в буфер обмена.
- Удобен при повторяющемся OCR небольших областей из различных приложений.
- Не требует превращать оригинальное изображение в отдельный PDF или загружать его в веб-сервис.
Минусы
- Качество и доступные языки зависят от OCR-компонентов Windows и самого исходного изображения.
- Для многостраничных документов нет организации страниц, пакетной вычитки и сохранения поискового слоя.
Кому подойдёт
PowerToys Text Extractor подходит специалистам Windows, которым на протяжении дня необходимо много раз копировать небольшие фрагменты из презентаций, браузера, видеоматериалов и программ без отдельного экспорта исходников.
4. OneNote: копирование текста из уже вставленного изображения
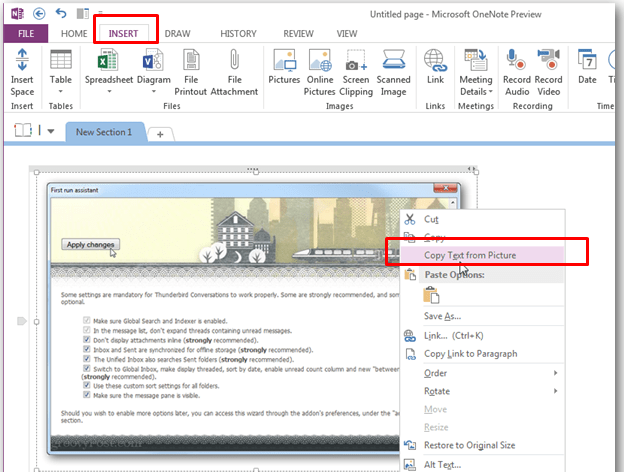
Настольный Microsoft OneNote полезен, когда изображения и так живут в заметках проекта. OCR встроен в работу с картинкой: достаточно вызвать её контекстное меню и выбрать Copy Text from Picture. После распознавания содержимое попадает в буфер обмена и вставляется в OneNote, Word, Outlook или иной редактор. Для многостраничной распечатки OneNote умеет копировать текст с текущей страницы либо со всех страниц printout.
Пошагово
- Создайте страницу OneNote и вставьте фотографию через вставку изображения либо обычное копирование из буфера.
- Щёлкните изображение правой кнопкой мыши. В настольной версии выберите Copy Text from Picture.
- Для распечатки многостраничного файла применяйте команду копирования текста с текущей страницы или со всех страниц распечатки, когда она доступна.
- Поставьте курсор в заметку, документ или письмо и вставьте содержимое буфера обмена.
- Сверьте распознанный текст с картинкой. В особенности внимательно проверьте сложное форматирование, таблицы, декоративные шрифты и мелкий текст.
У OneNote есть важная особенность: распознавание может завершаться не мгновенно. Microsoft предупреждает, что команда Copy Text from Picture иногда появляется с задержкой, когда сервис ещё обрабатывает изображение. По этой причине OneNote лучше воспринимать как OCR внутри системы заметок, а не как инструмент, где каждая фотография гарантированно даёт итог в ту же секунду. Когда текст необходим без промедления, «Ножницы» или PowerToys предсказуемее по рабочему ритму.
Веб-версия OneNote не является эквивалентом настольного приложения для этой операции. Рабочий сценарий статьи относится к десктопной версии, где контекстная команда OCR подтверждена документацией Microsoft. Это хороший пример, почему нельзя переносить инструкцию между платформами только по одинаковому наименованию сервиса: у облачного и настольного интерфейсов набор действий различается.
OneNote в особенности полезен исследователям и контент-командам, которые собирают референсы. В одну страницу можно положить фотографию упаковки, снимок наружной рекламы, скриншот сайта и комментарии коллег, а затем извлечь только те подписи, которые необходимы для тезисов. OCR не заменяет структуру базы знаний, но убирает ручную перепечатку при подготовке заметок.
Плюсы
- Распознавание встроено в уже знакомую среду заметок и не требует отдельного экспортного файла.
- Текст можно сразу вставить рядом с изображением и оставить визуальный первоисточник для проверки.
- Поддерживается извлечение текста из изображений многостраничной распечатки.
Минусы
- Команда OCR иногда становится доступна не сразу, по этой причине OneNote неудобен для срочной разовой операции.
- Веб-версия не повторяет весь настольный OCR-сценарий; рабочие действия необходимо выполнять в поддерживаемом десктопном приложении.
Кому подойдёт
OneNote подходит командам, которые уже ведут там исследования, протоколы встреч, референсы и рабочие заметки и хотят превращать текст на вложенных изображениях в редактируемые записи без смены среды.
Как скопировать текст с фото на телефоне
На смартфоне OCR в особенности ценен тем, что камера, фотография и буфер обмена находятся в одном устройстве. Это сокращает путь от бумажного носителя до заметки: не нужно пересылать снимок на компьютер, открывать отдельный редактор и возвращать текст обратно в мессенджер. Но мобильная скорость не отменяет проверки. Фотография под углом и автоматическое выделение всего кадра способны добавить в итог подписи, номера страниц и соседние элементы, которые пользователь не собирался копировать.
5. Live Text на iPhone и iPad
Live Text — системная функция Apple, которая распознаёт надписи в фотографиях, изображениях и, на поддерживаемых системах, видео. В приложении «Фото» текст становится интерактивным: слово можно удержать пальцем, расширить выделение маркерами и нажать Copy. Для всей видимой надписи доступно Select All. С точки зрения пользователя это самый естественный сценарий: изображение остаётся фотографией, но с текстом можно обращаться практически как с фрагментом веб-страницы.

Пошагово
- Откройте нужную фотографию в приложении «Фото». Для видео остановите кадр на моменте, где надпись хорошо читается.
- Нажмите и удерживайте слово. Когда появятся маркеры выделения, растяните их на нужную фразу или абзац.
- Нажмите Copy. Для выбора всего распознанного текста применяйте Select All или системную кнопку Live Text на изображении.
- Перейдите в заметки, письмо, документ или рабочий чат и вставьте текст.
- Вернитесь к фотографии и проверьте критичные символы. Для длинного фрагмента удобнее сверять по предложениям, а не читать исходник и итог целиком по памяти.
Live Text хорошо подходит для ситуативного контента: фотография визитки, подпись на слайде, инструкция на упаковке, стенд конференции, меню, постер или распечатка. В маркетинговой работе функция полезна не только для копирования: распознанную фразу проще сразу отправить в заметку вместе с контекстом, а затем применять при разборе мероприятия или мониторинге офлайн-коммуникаций.
Системный OCR в особенности удобен для приватных бытовых снимков, потому что пользователю не приходится отдельно загружать фотографию в неизвестный конвертер. Вместе с этим конкретный режим обработки зависит от возможностей устройства и сервисов Apple; конфиденциальные корпоративные документы всё равно обрабатывают по внутренним правилам компании, а не только исходя из удобства интерфейса.
Когда текст занимает маленькую часть кадра, сперва увеличьте фотографию или применяйте более крупный исходный снимок. Распознавание длинной страницы целиком на экране телефона не всегда удобно для ручной вычитки: в таких случаях мобильный Live Text лучше применять для фрагментов, а полный документ передать в настольный OCR с постраничной проверкой.
Плюсы
- Текст выделяется прямо в приложении «Фото» без отдельного конвертера и промежуточного файла.
- Удобен для коротких фрагментов, снятых камерой во время встречи, поездки или работы с печатными материалами.
- Итог сразу доступен системному буферу обмена и вставляется в любое совместимое приложение.
Минусы
- Длинные многостраничные материалы неудобно проверять и собирать на небольшом экране.
- Сложная вёрстка, таблицы и мелкий текст требуют добавочной ручной сверки или настольного OCR.
Кому подойдёт
Live Text подойдёт владельцам iPhone и iPad, которым необходимо быстро переносить отдельные надписи и абзацы из фотографий в заметки, письма, документы и рабочие чаты непосредственно на устройстве.
6. Google Lens в Google Фото: OCR на Android и не только
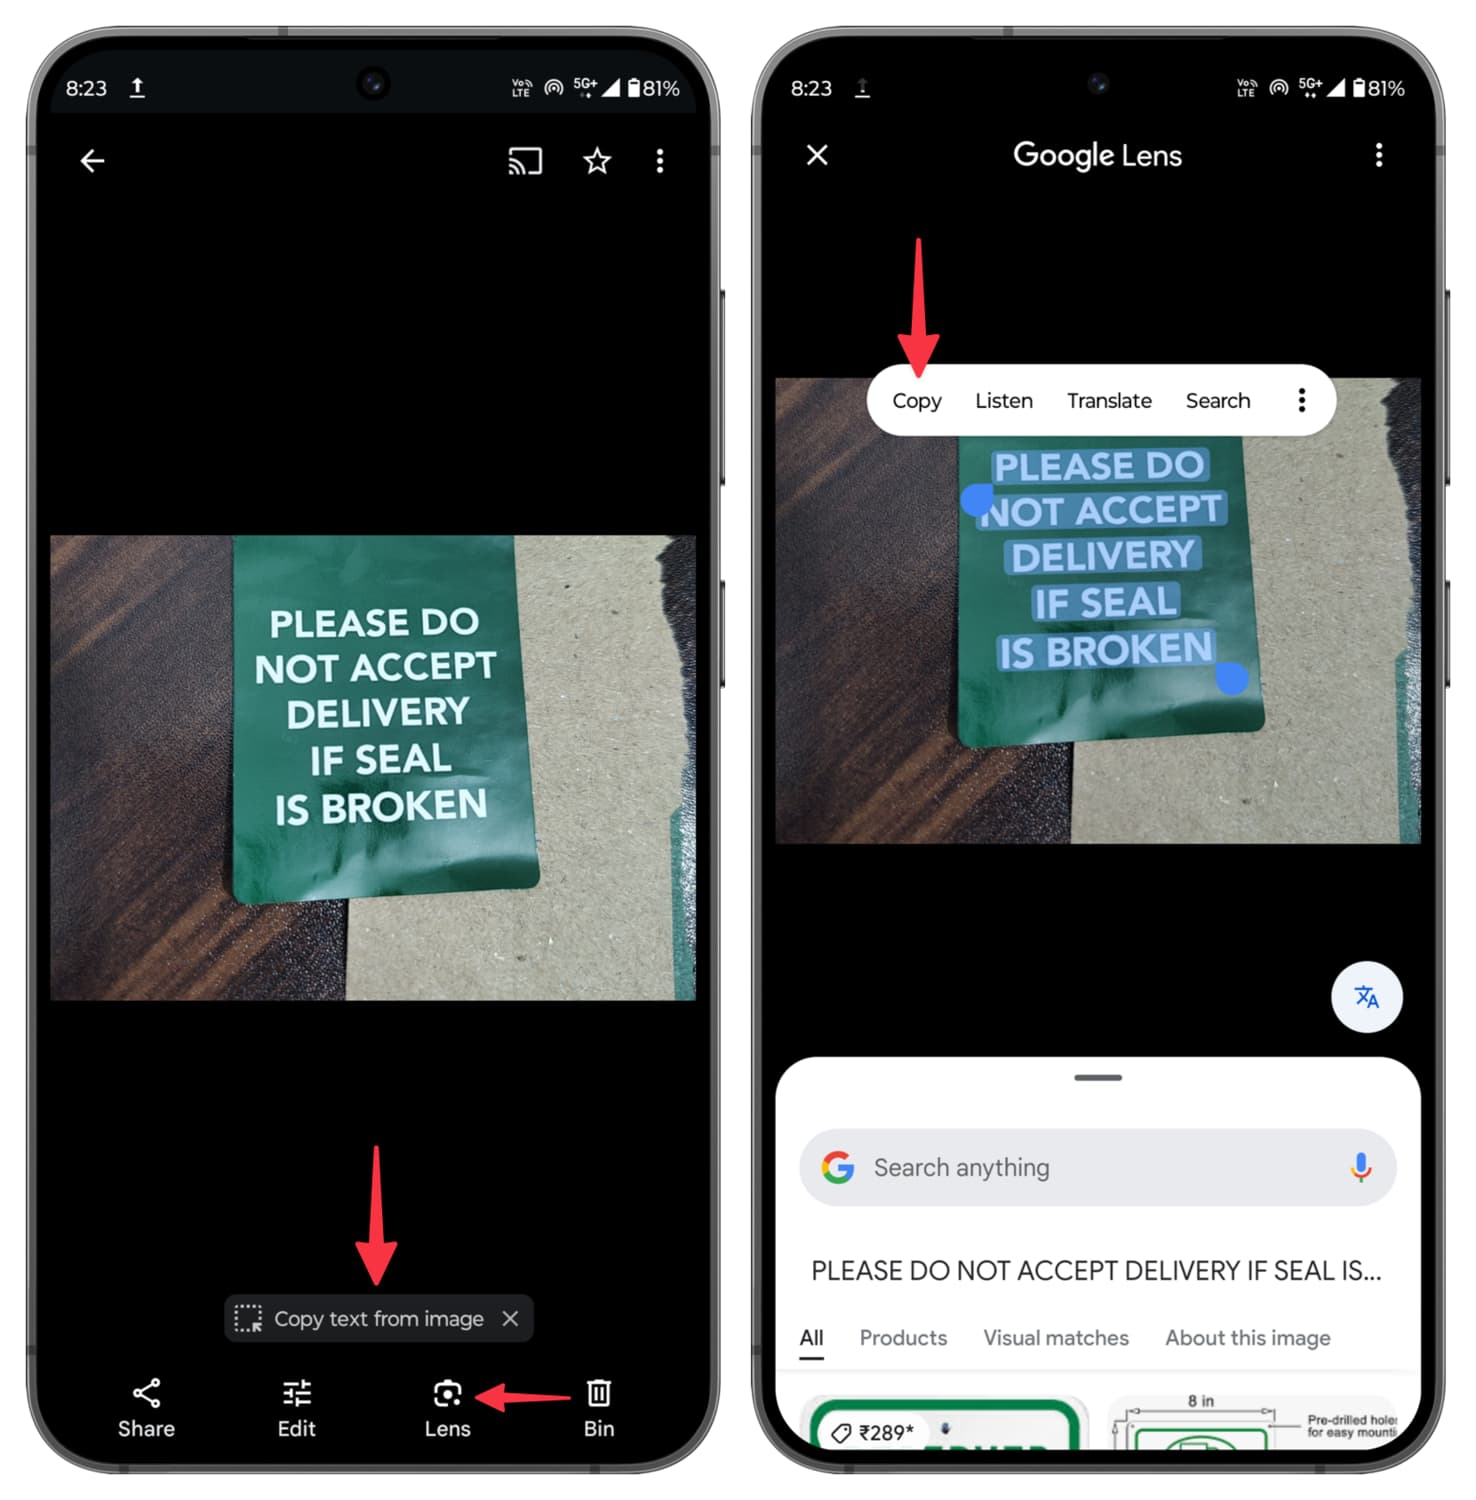
Google Lens доступен через несколько точек входа, а для уже сохранённой фотографии удобнее всего открыть Lens из Google Фото или приложения Google. В Google Фото у изображения с распознаваемой надписью может появиться действие Copy text from image; оно переводит пользователя в интерфейс Lens, где текст выделяется маркерами и копируется. Для кадра с несколькими объектами лучше сперва сузить область до нужной надписи.
Пошагово
- Откройте фотографию в Google Фото. При наличии готового действия Copy text from image нажмите его; в другом варианте откройте Lens для текущего изображения.
- Переключитесь в режим работы с текстом, когда он не выбран автоматически.
- Коснитесь распознанной строки и настройте границы выделения. Для длинного документа не копируйте всё подряд: сперва отделите нужный абзац от подписей и служебных элементов.
- Нажмите Copy и вставьте фрагмент в целевое приложение.
- Проверьте итог по фотографии, отдельно сравнивая цифры, смешанную латиницу и кириллицу, имена, артикулы и сокращения.
Lens полезен тем, что сочетает OCR с визуальным поиском и переводом, но в этой статье нас интересует именно копирование текста. Добавочные функции не должны отвлекать от проверки итога. К примеру, найденная на упаковке модель товара может одновременно стать поисковым объектом; для внутренней базы лучше сперва получить точную строку с этикетки и только затем запускать поиск, чтобы не смешивать распознанный текст с автоматически предложенными данными.
На Android интерфейс Lens встречается в приложении Google, Google Фото, Chrome и на части устройств в камере. Наименования точек входа могут различаться, по этой причине инструкция привязана к стабильной операции: открыть изображение, перейти к Lens, выделить распознанный текст и нажать Copy. Этот подход сохраняет смысл даже при перестановке кнопки в конкретной оболочке телефона.
Для облачного OCR действует простое правило: не отправляйте в сервис изображение, которое по рабочей политике не разрешено передавать внешней платформе. В публичном контенте — афишах, вывесках, упаковках, открытых презентациях — такого ограничения обычно нет; в закрытом договоре или клиентском документе оно становится решающим. Сперва классифицируют материал, затем выбирают удобство.
Плюсы
- Работает с фотографиями, которые уже находятся в Google Фото, без предварительной конвертации в документ.
- Позволяет быстро выделить конкретный фрагмент, а не переписывать всю надпись ручным способом.
- Доступен на мобильных устройствах через знакомые приложения Google и хорошо подходит для повседневных визуальных задач.
Минусы
- Обработка связана с облачным сервисом, по этой причине закрытые документы требуют проверки корпоративных правил передачи данных.
- Lens не предназначен для пакетной оцифровки многостраничного архива с единым контролем структуры и форматирования.
Кому подойдёт
Google Lens подходит для Android-сценариев, мобильного мониторинга визуальных материалов, работы с упаковкой, вывесками, слайдами и фотографиями документов, когда необходим быстрый отрывок текста, а не полноценный архивный OCR.
Как извлечь текст из фото в браузере
Браузерные методы помогают на компьютере без установки отдельного OCR-приложения. Их удобно применять на временном рабочем месте, Chromebook, корпоративной машине с ограниченными правами или в ситуации, когда итог необходим один раз. Цена удобства — передача файла внешнему сервису и меньший контроль над тем, как выглядит многостраничный документ после распознавания. По этой причине браузерный путь выбирают осознанно: сперва оценивают чувствительность данных, затем формат итога.
7. Google Drive и Google Docs: изображение превращается в документ
Google Drive умеет преобразовывать загруженные изображения и PDF в текст через Google Docs. На компьютере файл загружают в Drive, вызывают контекстное меню и выбирают Open with → Google Docs. Создаётся документ, в котором оригинальное изображение располагается вместе с распознанным текстом. На Xeon Live есть отдельная инструкция о том, как открыть PDF в Google Документах; для фотографии принцип тот же — исходник открывается через Google Docs как объект для распознавания.
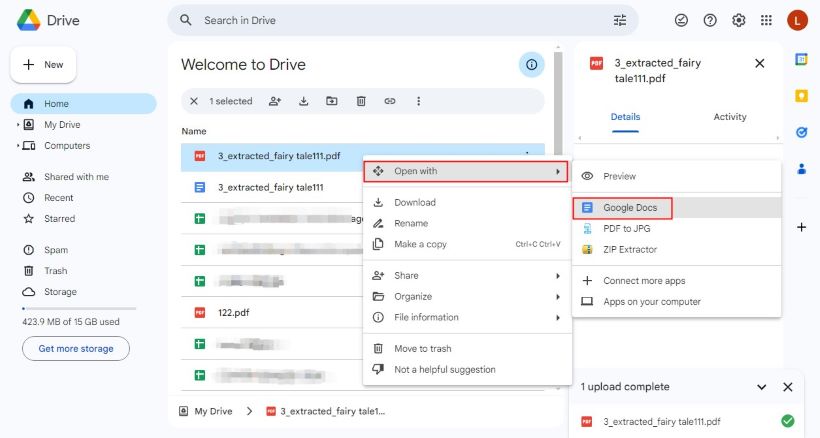
Пошагово
- На компьютере загрузите фотографию в Google Drive и дождитесь появления файла в списке.
- Щёлкните файл правой кнопкой мыши и выберите Open with → Google Docs.
- Дождитесь создания нового документа. Изображение останется в нём, а распознанный текст появится как редактируемое содержимое.
- Скопируйте нужный фрагмент в рабочий документ или отредактируйте текст непосредственно в Google Docs.
- Сопоставьте структуру и символы с оригиналом. Отдельно проверьте таблицы, колонки, сноски и переносы: Google предупреждает, что сложная разметка сохраняется хуже обычных абзацев.
Справка Google даёт конкретные ориентиры для хорошего итога: изображение должно быть резким, с ровным освещением и контрастом; документ — правильно ориентирован. Для этого метода поддерживаются распространённые форматы изображений и PDF. Google отдельно рекомендует небольшие файлы и достаточно крупный текст; при проблемах с распознаванием сперва имеет смысл подготовить исходник, а не многократно открывать одну и ту же слабую фотографию.
Drive удобен, когда OCR является частью совместной работы в Google Workspace. Распознанный текст можно сразу комментировать, редактировать и переносить в общий документ. Но этот же плюс превращается в ограничение для закрытых материалов: файл попадает в облачное хранилище. Команда должна применять только разрешённый корпоративный аккаунт и правила доступа, а не личное хранилище сотрудника.
Этот метод не стоит применять как точную реконструкцию дизайна. Google прямо предупреждает, что списки, таблицы, колонки, сноски и концевые сноски определяются хуже, чем базовое начертание и переносы строк. По этой причине для контента важнее сперва получить достоверный текст, а визуальную структуру восстановить ручным способом по фотографии, чем без проверки копировать автоматически собранную вёрстку.
Плюсы
- Не требует отдельной OCR-программы на компьютере и работает через привычный Drive.
- Итог сразу становится редактируемым документом Google Docs и подходит для совместной работы.
- Оригинальное изображение остаётся рядом с текстом, что облегчает ручную сверку.
Минусы
- Файл передаётся в облако Google, по этой причине метод не подходит для материалов, которые нельзя загружать во внешние сервисы.
- Сложная вёрстка — колонки, таблицы и сноски — переносится непредсказуемо и требует ручного восстановления.
Кому подойдёт
Google Drive с Google Docs подходит командам, которые уже работают в Google Workspace и хотят быстро превратить отдельную фотографию или PDF в редактируемый совместный документ без установки настольного OCR.
8. i2OCR: быстрый веб-OCR для разовой фотографии
i2OCR — специализированный веб-сервис: пользователь выбирает язык, загружает изображение, запускает OCR и получает извлечённый текст рядом с исходником. На Xeon Live есть отдельная карточка i2OCR с описанием его роли как браузерного инструмента. Сервис поддерживает распространённые графические форматы и несколько вариантов вывода, по этой причине подходит для единичной задачи, когда не нужно устанавливать программу или сохранять распознанный слой внутри PDF.
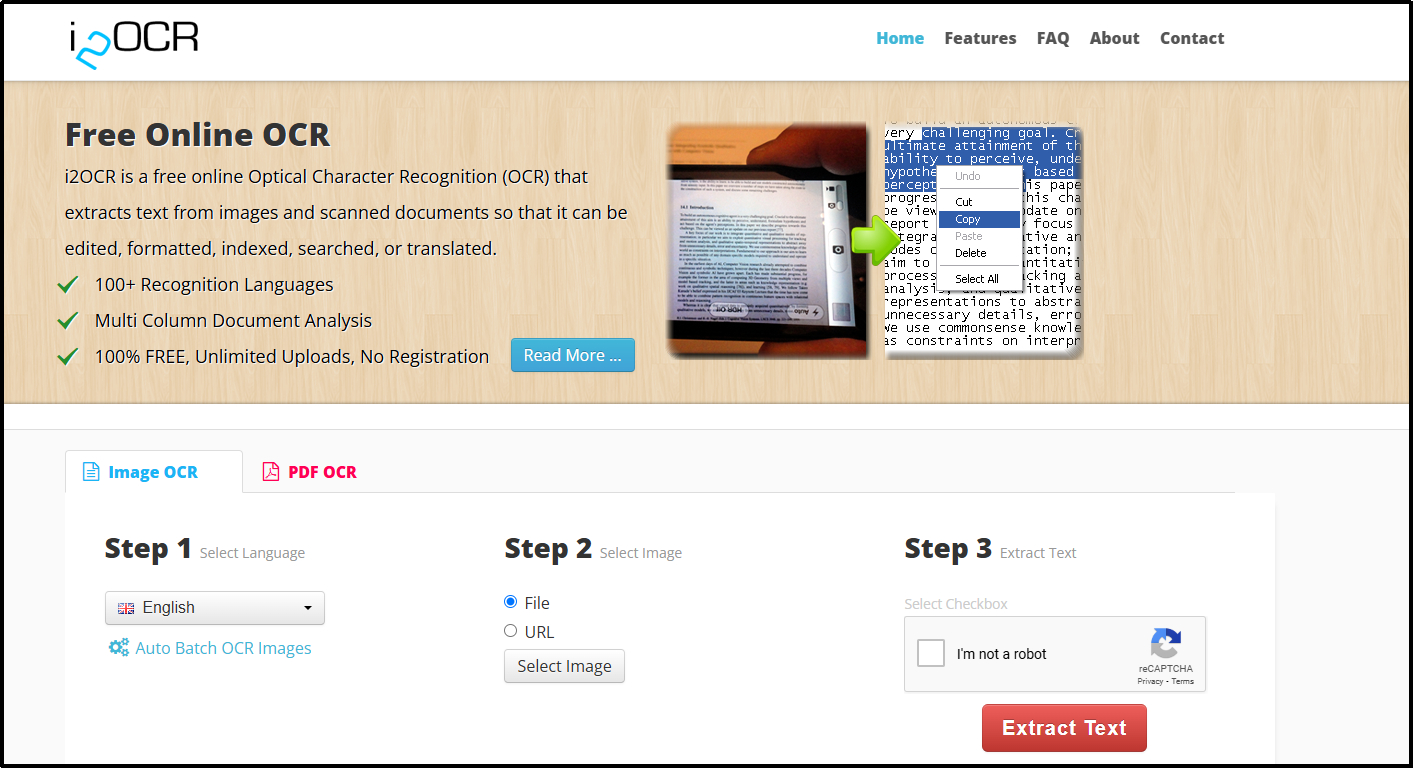
Пошагово
- Откройте i2OCR и выберите режим распознавания изображения либо PDF в зависимости от исходника.
- Задайте язык текста. Для русскоязычной страницы ручным способом выберите Russian, чтобы не полагаться на случайное определение по короткой фразе.
- Загрузите изображение и запустите Extract Text.
- Сопоставьте исходник и распознанный текст в параллельном просмотре, исправьте очевидные ошибки.
- Скопируйте готовый фрагмент или сохраните его в подходящем формате, затем повторно проверьте критичные данные в целевом документе.
Сильная сторона i2OCR — узкая специализация. Интерфейс не смешивает OCR с редактированием фотографий, заметками или визуальным поиском: задача сводится к загрузке и извлечению текста. Это удобно для редкого пользовательского сценария. Для регулярной работы сотнями страниц отсутствие общего документного процесса, ролей доступа и единой системы проверки быстро становится заметным ограничением.
Разработчик i2OCR указывает поддержку распространённых форматов изображений, а распознанный текст можно получить в нескольких форматах. Тоже сервис показывает исходник и итог рядом, что полезно для вычитки. Эти возможности не отменяют базового правила безопасности: загрузка в публичный веб-инструмент подходит для открытых и нечувствительных материалов; закрытые документы обрабатывают в разрешённой среде.
Не пытайтесь компенсировать плохой кадр многократной отправкой одной и той же фотографии. Сперва вернитесь к исходнику: поверните страницу, обрежьте фон, сделайте более резкий снимок, выберите правильный язык. Технически это тот же файл, но для OCR он превращается в значительно более простой набор строк и символов.
Плюсы
- Работает в браузере и не требует установки настольной программы.
- Сфокусирован именно на OCR: выбор языка, загрузка, распознавание и получение текста находятся в одном коротком процессе.
- Параллельный просмотр исходника и итога облегчает ручную проверку.
Минусы
- Файл передаётся внешнему веб-сервису, по этой причине конфиденциальные материалы требуют другого процесса.
- Для постоянной многостраничной оцифровки не хватает единой документной среды, контроля версий и организованной вычитки.
Кому подойдёт
i2OCR подходит для разовых открытых изображений и сканов, когда на компьютере нельзя или не хочется устанавливать программу, а итог необходим как обычный редактируемый текст.
Как выбрать метод под рабочую задачу
Разница между инструментами лучше всего видна не в списке функций, а в реальном процессе. Системный OCR экономит время на коротком фрагменте, PDF-редактор выигрывает на документе, мобильная функция — в момент съёмки, а браузерный сервис — при отсутствии права на установку программы. По этой причине перед стартом полезно задать четыре вопроса: где находится изображение, сколько страниц необходимо обработать, насколько чувствительны данные и необходим ли итог лишь в буфере обмена или как самостоятельный документ.
- Один абзац со слайда или сайта. Начните с «Ножниц». Их преимущество — минимальная дистанция от видимого фрагмента до буфера обмена.
- Много коротких фрагментов в различных окнах Windows. PowerToys Text Extractor удобнее постоянно повторяемой операции благодаря системной комбинации Win+Shift+T.
- Фотографии страниц, которые необходимо сохранить и искать позднее. PDF Commander лучше соответствует документному сценарию: страницы остаются единым файлом, а OCR становится частью PDF.
- Референсы уже собраны в заметке. OneNote позволяет извлекать текст непосредственно из вставленных изображений, не ломая структуру исследовательской страницы.
- Съёмка в дороге на iPhone или iPad. Live Text даёт самый короткий путь от камеры к буферу обмена.
- Android и Google Фото. Google Lens удобен для уже сохранённого снимка и короткого фрагмента.
- Совместная работа в Google Workspace. Google Drive + Google Docs превращают фото в общий редактируемый документ.
- Разовая открытая фотография на чужом компьютере. i2OCR решает задачу без установки, когда передача файла публичному веб-сервису допустима.
Для постоянного процесса полезно закрепить не один «любимый» инструмент, а стандарт по классам задач. К примеру: системный OCR — для кратких фрагментов, PDF-редактор — для архивных страниц, мобильный OCR — для полевых материалов, облачный — лишь для разрешённых данных. Тогда сотрудник не тратит время на сравнение десяти сервисов всякий раз и не отправляет чувствительные документы туда, где им не место.
Как проверить качество распознавания и не пропустить критичную ошибку
Проверка OCR должна быть короткой, но формализованной. Простое чтение итога «на глаз» плохо ловит ошибки в строках, которые человек ожидает увидеть. Эффективнее разделить контроль на несколько классов данных и сопоставлять каждый с оригиналом. Для редакционной и маркетинговой работы это в особенности важно: одна неверная цифра в исследовании или буква в наименовании бренда способна попасть в публичный материал и размножиться дальше по каналам.
Проверка № 1: содержание
- Сверьте начало и конец каждого абзаца: OCR порой объединяет соседние строки или пропускает крайний фрагмент.
- Проверьте заголовки и подписи отдельно от основного текста. Большой кегль обычно распознаётся хорошо, но нестандартный шрифт и цветной фон дают неожиданные замены.
- Сопоставьте порядок колонок. Для буклета или отчёта важно убедиться, что строки из правой колонки не вклинились в левую.
- Для таблиц проверьте связь значения с заголовком столбца. Даже правильные цифры бесполезны, когда они попали в соседнюю колонку.
Проверка № 2: символы повышенного риска
- Числа, проценты, валюты, даты и время сверяйте посимвольно.
- Собственные имена, бренды, домены и артикулы сопоставляйте с оригиналом, а не с автокоррекцией редактора.
- Похожие знаки проверяйте отдельно: 0/O, 1/I/l, B/В, C/С, P/Р, X/Х и другие пары латиницы и кириллицы.
- Тире, дефисы, кавычки, дроби и знаки математических операций приводите к нужному формату лишь после сверки смысла.
- Ссылки и адреса электронной почты не переносите в публикацию автоматически: один ошибочный символ меняет адрес назначения.
Проверка № 3: форматирование
OCR необходим в первую очередь для текста, по этой причине форматирование оценивают отдельно от точности символов. Сперва добейтесь правильного содержания, затем восстановите абзацы, списки, выделения и таблицы. Попытка одновременно чинить буквы и дизайн увеличивает число пропусков: редактор начинает смотреть на отступы и перестаёт замечать неверную цифру. Для большого документа удобно делать два прохода — фактический и визуальный.
При передаче итога другому сотруднику сохраняйте рядом оригинальное изображение или ссылку на утверждённый источник внутри корпоративной системы. Тогда спорный фрагмент можно проверить без повторного поиска фотографии. Для PDF удобен вариант с поисковым слоем поверх исходной страницы: визуал остаётся доказательной основой, а текст можно быстро находить и копировать.
Типовые ошибки и методы исправления
- OCR вернул бессвязный набор символов. Проверьте ориентацию, резкость и язык. Сперва поверните страницу, потом обрежьте лишнее и повторите распознавание на исходном разрешении.
- Русские слова содержат латинские буквы. Включите русский язык в настройках OCR и всё равно проверьте бренды, коды и имена, где смешение алфавитов встречается естественно.
- Таблица превратилась в строки. Не тратьте время на автоматическое восстановление любой ценой. Скопируйте данные по блокам и соберите структуру ручным способом либо применяйте специализированный документный OCR.
- Две колонки перемешались. Распознавайте левую и правую области отдельно или применяйте сегментацию документа, когда она доступна.
- Мелкий текст пропускается. Вернитесь к исходной фотографии, не к сжатой копии из мессенджера. Увеличение маленького файла не возвращает потерянные детали.
- На глянцевой странице исчезают слова. Переснимите лист при боковом свете так, чтобы блик не пересекал строки.
- Распознался текст интерфейса вокруг картинки. Сузьте область захвата. Это в особенности важно для «Ножниц» и Text Extractor.
- В OneNote нет Copy Text from Picture. Дайте настольному приложению закончить OCR и повторите контекстное меню; для срочной операции применяйте иной метод.
- Google Docs сохранил слова, но разрушил таблицу. Применяйте распознанный текст как источник содержания, а визуальную структуру восстановите по изображению.
- Онлайн-сервис не подходит по политике безопасности. Не ищите другой публичный конвертер. Перенесите задачу в локальный или уже утверждённый корпоративный инструмент.
Как встроить OCR в процесс маркетинга и контента
Ценность OCR появляется не в момент, когда сотрудник один раз избежал перепечатки, а когда команда перестаёт повторять ручную работу системно. Пример — мониторинг офлайн-рекламы. Полевой сотрудник фотографирует носитель, сохраняет оригинал с датой и проектом, распознаёт слоган и обязательные подписи, затем кладёт проверенный текст в базу наблюдений. Аналитик получает не только фото, но и поиск по формулировкам. Редактор видит источник рядом и может быстро подтвердить цитату.
В исследовании презентаций похожий процесс строится вокруг коротких фрагментов. Слайды не нужно целиком превращать в новый документ: через «Ножницы» или Text Extractor извлекают только тезисы и подписи к диаграммам. В карточке исследования сохраняют ссылку на исходный файл и номер слайда. Это уменьшает объём мусора и делает проверку выводов быстрее.
При оцифровке печатного архива логика другая. Фотографии страниц сперва приводят к единому порядку, затем распознают в PDF-редакторе и сохраняют поисковый слой. После этого выборочно проверяют страницы с таблицами, мелким кеглем и плохой печатью. Такой процесс дороже разового копирования, но даёт ещё раз используемый актив: архив становится доступен поиску, а не остаётся папкой картинок.
Для работы с пользовательским контентом (user-generated content, UGC), упаковками и наружной рекламой мобильный OCR помогает быстро переносить текст в карточку мониторинга. Тут важны права и контекст: распознанная надпись сама по себе не доказывает дату публикации, авторство изображения или юридический статус утверждения. OCR решает только задачу чтения текста. Фактологическая проверка, атрибуция и оценка прав остаются отдельными редакционными этапами.
Как измерить эффект: четыре метрики вместо субъективного «стало быстрее»
Процесс OCR легко улучшать, когда команда считает не абстрактную точность, а операционные показатели. Для этого не нужны сложные исследования: достаточно взять типовой поток за неделю или месяц и фиксировать однотипные значения. Метрики ниже — внутренняя методика контроля процесса, а не внешние отраслевые нормативы.
- Время до готового текста. Засекайте путь от открытия фотографии до проверенного фрагмента в целевой системе. Сопоставляйте одинаковые классы задач: один слайд с одним слайдом, страницу договора со страницей договора.
- Количество исправлений на 1000 знаков. После вычитки считайте фактические правки OCR. Показатель помогает понять, портится ли качество при смене камеры, сервиса или шаблона документа.
- Доля материалов без повторного распознавания. Если фотографию приходится обрабатывать второй раз из-за блика, поворота или неверного языка, проблема часто лежит во входном стандарте, а не в движке OCR.
- Доля критичных ошибок, найденных на контроле. Отдельно помечайте неверные суммы, даты, имена, ссылки и артикулы. Даже при небольшом общем числе ошибок именно эта категория определяет редакционный риск.
Для сравнения инструментов проведите маленький внутренний тест на одинаковом наборе изображений. Включите прямой скан, фотографию под небольшим углом, страницу с двумя колонками, мелкий текст и смешение русского с английским. Потом измерьте время и количество исправлений по одной методике. Победителем становится не сервис с самым громким описанием, а процесс, который даёт проверяемый итог с минимальными затратами на вашу реальную выборку.
После внедрения OCR полезно сохранить контрольную выборку и повторять тест после крупных изменений рабочего места: перехода на другую камеру, нового шаблона документов, обновления системы или смены основного инструмента. Это не постоянный аудит программ, а проверка собственного процесса. Если число правок выросло, команда видит проблему ранее, чем ошибочные данные попадут в публичный материал.
Краткий чек-лист перед вставкой распознанного текста в рабочий документ
- Оригинальная фотография сохранена и доступна для сверки.
- Страница повёрнута правильно, а нужная область не закрыта бликом или тенью.
- Выбран подходящий язык распознавания.
- Проверены числа, даты, суммы, проценты, имена, бренды, домены и артикулы.
- Для таблиц подтверждена связь значений со строками и столбцами.
- Не перепутаны латинские и кириллические символы одинакового начертания.
- В текст не попали меню, подписи интерфейса и соседние элементы изображения.
- Файл не загружался во внешний сервис вопреки правилам конфиденциальности.
- Форматирование восстановлено лишь после проверки содержания.
- В целевой системе сохранён контекст: источник, страница или оригинальное изображение.
Частые вопросы
Можно ли скопировать текст с размытой фотографии?
OCR работает с теми деталями, которые реально сохранились в изображении. Сильное размытие нельзя надёжно компенсировать увеличением. Лучший путь — отыскать исходный файл, переснять страницу с устойчивой камерой или распознать более крупный фрагмент; итог обязательно сверяют ручным способом.
Какой метод лучше для одной строки со скриншота?
На Windows быстрее всего начать с «Ножниц» и «Действий с текстом»; при регулярном копировании из различных окон удобен PowerToys Text Extractor. Отдельный PDF-редактор для одной строки обычно добавляет лишние действия.
Что применять для многостраничных фотографий документов?
Документный процесс удобнее строить в PDF-редакторе: страницы собираются в единый файл, распознаются диапазоном и сохраняются с поисковым текстовым слоем. Мобильные и экранные инструменты оставляют для отдельных фрагментов и контрольной проверки.
Можно ли доверять OCR цифрам и реквизитам без проверки?
Нет. Числа, даты, суммы, артикулы, имена и похожие символы проверяют по оригиналу посимвольно. Автоматическое распознавание сокращает ручной ввод, но не переносит ответственность за точность данных на программу.
Что делать с таблицей или двумя колонками?
Разделите страницу на логические области либо применяйте OCR с сегментацией. После распознавания сперва проверяют содержимое ячеек и порядок чтения, а затем восстанавливают визуальную структуру. Для критичных таблиц ручная сверка обязательна.
Безопасно ли загружать договор или паспорт в онлайн-OCR?
Публичный веб-OCR применяют лишь для материалов, которые разрешено передавать внешнему сервису. Закрытые документы, персональные данные и внутренние материалы обрабатывают в локальной или утверждённой корпоративной среде по правилам организации.
Итог
Скопировать текст с фотографии можно без ручной перепечатки практически в любом рабочем сценарии, но оптимальный инструмент зависит от формы задачи. PDF Commander логичен для фотографий документов и дальнейшей работы с PDF; «Ножницы» — для мгновенного фрагмента с экрана; PowerToys — для повторяющегося OCR поверх различных окон; OneNote — для изображений внутри заметок; Live Text и Google Lens — для мобильной работы; Google Drive и i2OCR — для браузерного маршрута без установки программы.
Главное правило одинаково для всех восьми методов: OCR создаёт черновой машиночитаемый текст, а качество публикации или документа обеспечивает проверка по оригиналу. Резкий исходник, правильная область, осознанный выбор языка, контроль конфиденциальности и короткая вычитка критичных символов дают больше практической пользы, чем попытка отыскать инструмент, который якобы никогда не ошибается. Для системной работы имеет смысл закрепить стандарт по классам задач и измерять время, количество исправлений и повторные распознавания на собственном потоке материалов.