
PDF удобен как итоговая версия документа: страница сохраняет заданное расположение текста, изображений и служебных элементов. Но как только договор, бриф, отчёт, пресс-кит или инструкция возвращаются в работу, необходим редактируемый формат. Конвертация в DOCX решает задачу только тогда, когда выбран метод, подходящий именно к типу исходного файла. Текстовый PDF, скан и дизайнерский макет требуют различных подходов. Ниже — детальная схема: от быстрой диагностики до восьми рабочих методов и проверки готового Word-документа.
Для ориентира полезно держать рядом инструкцию Xeon Live по преобразованию PDF в Word: в ней разобраны основные платформы. Тут акцент сделан на рабочем процессе для бизнеса и команд, которым важно не просто получить DOCX, а сохранить смысл, структуру, таблицы, цифры и возможность дальнейшего согласования.
Что именно меняется при переводе PDF в Word
Главное различие связано не с расширением файла, а с моделью документа. PDF хранит страницу как фиксированную композицию: текст и графика привязаны к координатам, а просмотрщик воспроизводит уже собранный лист. Word строит документ как редактируемый поток: абзацы переносятся, таблицы пересчитываются, изображения привязываются к тексту, а разрывы страниц зависят от шрифтов, полей и параметров печати. По этой причине идеальное внешнее совпадение и полная свобода редактирования одновременно достижимы не для каждого исходника.
При конвертации программа должна заново понять структуру страницы: где абзац, где заголовок, где таблица, где подпись к рисунку, а где просто текст, нарисованный поверх изображения. Чем проще исходная структура, тем меньше реконструкции требуется. На обычном текстовом отчёте итог часто получается близким к исходнику. В буклете с несколькими колонками, плавающими блоками, диаграммами и сложными колонтитулами после экспорта приходится ручным способом восстанавливать часть верстки.
Отдельная категория — скан. В нём страница существует как изображение, по этой причине прямой экспорт без распознавания оставляет картинку внутри DOCX либо даёт мало редактируемого текста. Тут необходим OCR — оптическое распознавание символов. Оно превращает видимые буквы в текстовый слой, но не отменяет проверку: цифры, инициалы, артикулы, ссылки и короткие подписи в особенности чувствительны к качеству скана.
Три типа исходного PDF, которые важно различать
- Текстовый PDF. Текст выделяется мышью, копируется и находится через поиск. Это наиболее простой исходник для Word, PDF Commander, Acrobat и браузерных конвертеров.
- Сканированный PDF. Выделяется вся страница как одно изображение либо текст не выделяется вообще. Перед экспортом требуется OCR и выбор правильного языка распознавания.
- Сложный макет. Колонки, врезки, таблицы, подписи, диаграммы, формы и декоративные объекты расположены независимо. Тут важнее качество реконструкции и последующая сверка, чем скорость получения DOCX.
Проверка занимает меньше минуты. Откройте документ, попробуйте выделить одно слово, отыщите характерную фразу через поиск и щёлкните по таблице или изображению. Эти три действия сразу показывают, есть ли текстовый слой и насколько страница похожа на обычный документ. Такой мини-аудит экономит время: не приходится несколько раз конвертировать один и тот же файл неподходящим инструментом.
Как выбрать метод до начала конвертации
Для рабочего документа важны четыре критерия: конфиденциальность, качество верстки, наличие сканов и дальнейший сценарий редактирования. Настольная программа обрабатывает исходник локально и подходит для внутренних материалов, которые не следует отправлять в сторонний веб-сервис. Онлайн-инструмент удобен для разовой операции на чужом компьютере или в браузере, но файл передаётся на сервер сервиса. Word в особенности рационален, когда документ в основном текстовый, а Google Docs — когда после извлечения текста необходима совместная работа.
Короткая матрица выбора
- Необходимо быстро исправить текстовый PDF на Windows. Начинайте с PDF Commander или Microsoft Word.
- Необходимо распознать скан и сохранить структуру. Применяйте PDF Commander с OCR либо ABBYY FineReader PDF; после экспорта обязательно сверяйте критичные поля.
- Важна сложная верстка и профессиональная PDF-обработка. Подходит Adobe Acrobat, в особенности когда экспорт — лишь один этап работы с исходным PDF.
- Необходим DOCX без установки программы. Подойдут Google Docs, Smallpdf или iLovePDF; для конфиденциальных материалов сперва оцените допустимость облачной обработки.
- Работа идёт на Android. Отдельное приложение-конвертер удобно для короткого мобильного сценария, когда файл уже находится на телефоне.
- Необходима совместная редактура. Google Docs удобен после преобразования, потому что документ сразу оказывается в общей рабочей среде.
Что подготовить перед экспортом
- Сохраните исходный PDF отдельно и не перезаписывайте его в процессе проверки.
- Определите страницы, которые в самом деле необходимы в Word. Лишние приложения и обложки увеличивают объём ручной проверки.
- Для сканов выровняйте перевёрнутые страницы и убедитесь, что текст читается без сильного размытия и теней.
- Зафиксируйте элементы, которые нельзя потерять: номера договоров, суммы, даты, имена, подписи к графикам, нумерацию страниц, ссылки и таблицы.
- Решите, что важнее: максимально похожий внешний вид или свободное редактирование. Эти цели порой требуют различных режимов сохранения.
- Для командного документа договоритесь о наименовании итога и версии до конвертации, чтобы не создавать цепочку из практически одинаковых DOCX.
Windows и macOS: локальные программы
Локальный метод удобен для регулярной работы и документов, которые нежелательно отправлять на внешний сервер. Начнём с PDF Commander: он закрывает типовой Windows-сценарий — открыть PDF, при необходимости распознать текст и экспортировать в DOCX. Далее идут Word, ABBYY FineReader PDF и Adobe Acrobat; часть этих программ тоже работает на macOS, а поддерживаемые платформы оговорены внутри карточек.
PDF Commander: основной метод на Windows
PDF Commander объединяет просмотр, редактирование, распознавание и экспорт PDF. Для конвертации в Word применяется команда экспорта в другой формат; для сканов перед сохранением можно включить распознавание текста и таблиц. Такой порядок удобен, когда исходник сперва необходимо привести в порядок, а уже потом передать в редактируемый DOCX.
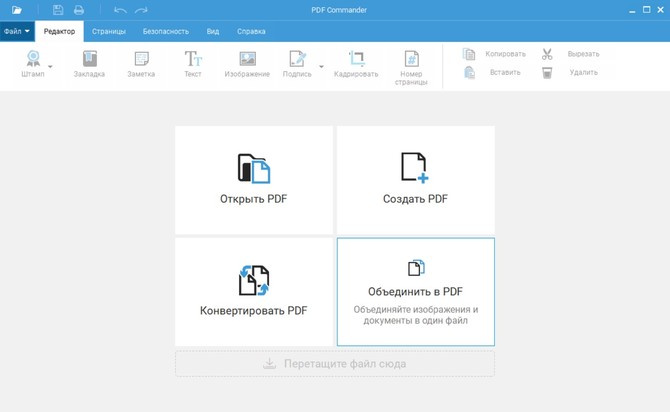
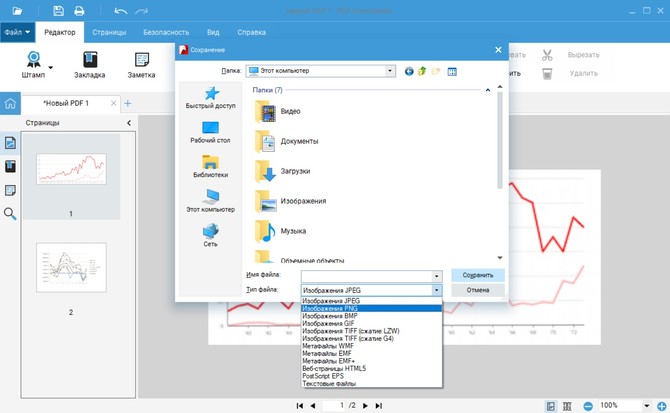
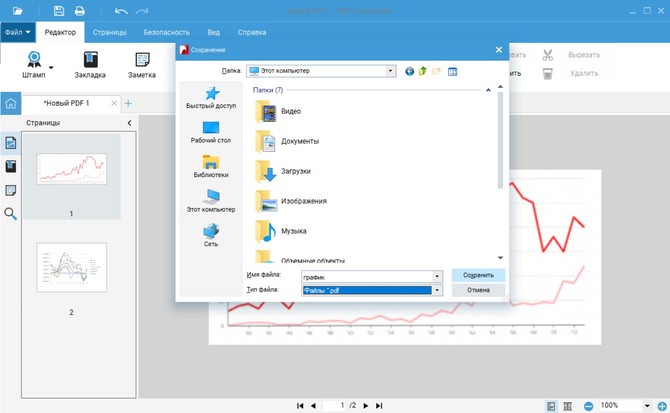
Порядок действий: откройте исходный PDF в программе. Перейдите в меню Файл, выберите Экспорт в другой формат и укажите DOCX. Задайте папку и имя итога. В параметрах экспорта настройте распознавание текста и таблиц, когда документ содержит сканы или сложные табличные блоки. Подтвердите операцию и дождитесь создания DOCX.
Для обычного текстового PDF разумно сперва сделать экспорт без лишней обработки и посмотреть на итог. OCR необходим не по привычке, а когда текстового слоя нет или он повреждён. Повторное распознавание уже корректного текста может добавить лишние ошибки. Для скана, напротив, главный контроль начинается до экспорта: язык распознавания должен соответствовать документу, а страницы — быть ровными и достаточно контрастными.
После получения DOCX откройте его в Word или другом совместимом редакторе и пройдите документ сверху вниз. Сперва проверяйте структуру: количество страниц, порядок разделов, заголовки и таблицы. Затем — критичные значения. Для договора это даты, номера и реквизиты документа; для медиаплана — наименования каналов и показатели; для пресс-кита — имена, должности и подписи к изображениям. Такой порядок быстрее, чем пытаться сопоставлять каждую строку сразу.
Для маркетинговых материалов PDF Commander полезен в ситуации, когда в команду приходит утверждённый PDF, но требуется быстро сделать редактируемую версию: обновить формулировки брифа, подготовить выдержки для презентации, перенести таблицу условий в рабочий документ, переработать старый гайд. Вместе с этим исходный PDF остаётся отдельным эталоном, а DOCX становится рабочей копией.
Плюсы
- Локальная работа с документом без обязательной загрузки PDF в браузер.
- Экспорт в DOCX встроен в общий рабочий процесс PDF-редактора.
- OCR помогает подготовить сканированный PDF к редактированию.
- Можно сперва привести страницы в порядок, а затем выполнять конвертацию.
Минусы
- Основной сценарий этой инструкции ориентирован на Windows.
- Сложные журнальные макеты и многоуровневые таблицы после конвертации всё равно требуют ручной сверки.
- OCR не отменяет проверки цифр, имён и коротких служебных строк.
Кому подойдёт
Подойдёт тем, кто систематически работает с PDF на Windows и хочет сперва проверить или поправить исходник, а затем получить DOCX. В особенности уместен для внутренних документов, когда локальная обработка предпочтительнее браузерного сервиса.
Microsoft Word: открыть PDF как редактируемую копию
Microsoft Word умеет открывать PDF напрямую. Программа не редактирует внутреннюю структуру PDF на месте: она создаёт копию и преобразует содержимое в модель Word. Microsoft отдельно предупреждает, что этот путь лучше всего работает с документами, где преобладает обычный текст. Сложная графика, нестандартные таблицы и насыщенная верстка могут преобразоваться иначе, чем выглядит оригинал.
Порядок действий в настольном Word: откройте Файл → Открыть, выберите PDF и подтвердите предупреждение о преобразовании. Дождитесь, пока Word соберёт редактируемую копию. Потом откройте Файл → Сохранить как и выберите Документ Word (*.docx). Исходный PDF вместе с этим не меняется, по этой причине его удобно держать рядом для сравнения.
Word в особенности эффективен для инструкций, писем, простых договоров, текстовых отчётов и заметок, которые изначально были экспортированы из офисного редактора. В таких файлах абзацы и заголовки обычно восстанавливаются логичнее, чем в буклетах или презентационных макетах. Если документ состоит главным образом из страниц-изображений, Word не стоит применять как полноценную OCR-систему: сперва распознайте скан специализированным инструментом.
После открытия обратите внимание на абзацы, которые неожиданно разбились на отдельные текстовые блоки, на колонтитулы, превратившиеся в обычный текст, и на таблицы. Microsoft прямо перечисляет элементы, которые могут преобразовываться хуже: таблицы с нестандартными интервалами, границы страниц, отслеживаемые изменения, сложные сноски, закладки и некоторые эффекты шрифтов. Это не ошибка файла как такового — это следствие перехода от фиксированной страницы к поточной верстке.
Для редакционной команды Word удобен, когда PDF необходимо не сохранить визуально один в один, а разобрать на редактируемый материал. К примеру, из PDF-отчёта можно получить основу для нового текста, обновить формулировки, применить корпоративные стили и собрать новую версию. В таком сценарии небольшие изменения верстки не критичны, потому что документ всё равно проходит повторное оформление.
Плюсы
- Не нужен отдельный конвертер, когда настольный Word уже входит в рабочий процесс.
- Исходный PDF остаётся неизменным, а редактирование идёт в созданной копии.
- Подходит для преимущественно текстовых PDF с простой структурой.
- После конвертации сразу доступны стили, комментарии, исправления и другие средства Word.
Минусы
- Сложная фиксированная верстка может заметно измениться.
- Графические страницы порой открываются как изображения, а не как свободно редактируемый текст.
- Для сканов и плохих фотографий документа необходим отдельный этап OCR.
Кому подойдёт
Подойдёт сотрудникам, которые уже работают в Word и получают преимущественно текстовые PDF: регламенты, отчёты, инструкции, письма и договоры без сложной полиграфической верстки.
ABBYY FineReader PDF: конвертация со ставкой на OCR
ABBYY FineReader PDF строит рабочий процесс вокруг распознавания и контроля структуры документа. На стартовом экране есть отдельная задача Convert to Microsoft Word. Перед запуском можно выбрать режим сохранения форматирования, языки OCR и параметры, связанные с изображениями, колонтитулами и другими элементами страницы.
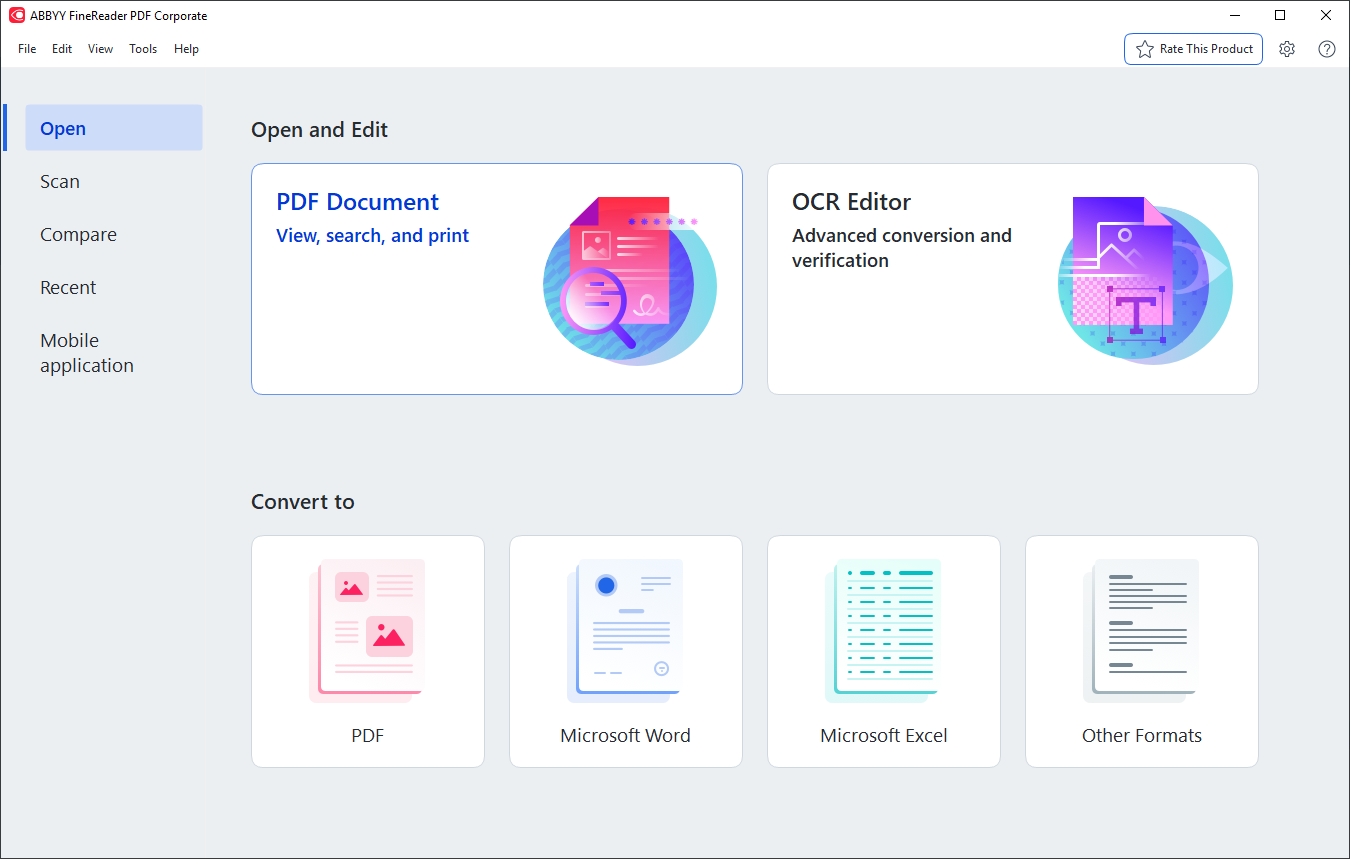
Пошагово: запустите FineReader PDF и в стартовом окне выберите Convert to Microsoft Word. Добавьте PDF. В параметрах определите, насколько важно сохранить исходный вид страницы, задайте языки распознавания и включите сохранение нужных элементов. После настройки запустите Convert to Word и сохраните DOCX. Альтернативный путь доступен из PDF Editor через File → Save As → Microsoft Word Document.
Смысл настроек форматирования — в компромиссе между визуальным сходством и редактируемостью. Режим, ориентированный на точную копию, старается удерживать исходную геометрию, но отдельные блоки могут стать менее удобными для переработки. Более свободный режим лучше подходит для текста, который дальше будут активно редактировать. Выбор необходимо делать не по принципу «чем точнее, тем лучше», а по дальнейшей задаче.
FineReader в особенности полезен на сканах, архивах и документах, где распознавание — основная проблема. После OCR проверяйте слова с похожими символами, короткие цифровые поля и языковые переключения. Для русско-английского документа важно задать оба языка, когда это поддерживает выбранный режим: так уменьшается риск, что латинские обозначения будут интерпретированы как кириллица и наоборот.
В бизнес-процессе FineReader логичен для старых договоров, оцифрованных исследований, архивных отчётов и бумажных приложений, которые должны перейти в редактируемый документооборот. Для одного простого текстового PDF такой инструмент может быть избыточным, зато на сложном скане его режимы контроля дают больше возможностей для ручной проверки итога.
Плюсы
- Сильный акцент на OCR и работе со сканированными документами.
- Отдельная задача конвертации в Microsoft Word доступна со стартового экрана.
- Можно выбирать режим сохранения форматирования и языки распознавания.
- Есть инструменты проверки распознанного текста перед финальным экспортом.
Минусы
- Количество настроек выше, чем у простых одношаговых конвертеров.
- Точная реконструкция сложной страницы требует времени на проверку областей и текста.
- Для обычного текстового PDF возможности OCR-среды могут быть избыточны.
Кому подойдёт
Подойдёт для сканов, архивных документов, сложных многостраничных материалов и задач, где качество распознавания важнее минимального количества действий.
Adobe Acrobat: экспорт PDF в DOCX внутри PDF-среды
Adobe Acrobat предлагает экспорт PDF в Microsoft Word как штатную операцию. В настольном приложении открывают документ, запускают инструмент Export PDF, выбирают Microsoft Word и формат Word Document, затем выполняют экспорт. Для сканированного текста Acrobat включает распознавание в процессе преобразования.
Рабочий порядок: откройте PDF в Acrobat, выберите Export PDF, затем Microsoft Word → Word Document и запустите экспорт. Укажите место сохранения DOCX. На сканированном документе дождитесь распознавания и лишь после этого оценивайте качество итога. Для частичного переноса порой разумнее экспортировать только нужный диапазон страниц, чтобы не тратить время на проверку всего файла.
Сильная сторона Acrobat раскрывается, когда конвертация — не единственная операция. В одном рабочем потоке можно проверить PDF, скорректировать страницы, обработать скан и затем выгрузить содержимое в DOCX. Такой подход удобен для отчётности, юридических пакетов и презентационных материалов, где сперва важно убедиться в целостности исходного PDF.
Даже при качественном экспорте сложный документ необходимо сопоставлять с оригиналом. Особого внимания требуют многоуровневые таблицы, колонки, подписи к изображениям, нестандартные шрифты и сноски. Не оценивайте качество только по первой странице: титул обычно проще внутренних разворотов. Контрольная выборка должна включать хотя бы одну обычную текстовую страницу, одну таблицу и одну страницу с графикой, когда они есть в исходнике.
Плюсы
- Экспорт в Word встроен в полноценную среду работы с PDF.
- Для сканированного текста предусмотрено распознавание в процессе преобразования.
- Подходит для документов, которые до экспорта необходимо проверить или обработать в PDF.
- Удобен при регулярной профессиональной работе с различными типами PDF.
Минусы
- Для одной разовой конвертации интерфейс и набор возможностей могут быть избыточны.
- Сложная верстка всё равно требует постпроверки в Word.
- Онлайн- и настольные сценарии Acrobat отличаются, по этой причине команды необходимо искать в соответствующей среде.
Кому подойдёт
Подойдёт командам, у которых Acrobat уже является основной средой для PDF и экспорт в Word встроен в более длинный процесс проверки, правок и подготовки документов.
В браузере: онлайн-конвертация без установки программ
Браузерный метод снимает зависимость от конкретного компьютера: достаточно открыть сервис, передать PDF и получить DOCX. Обратная сторона — обработка происходит через внешнюю инфраструктуру. Для публичных материалов, шаблонов, статей и неслужебных документов это часто приемлемо. Для договоров, внутренних отчётов, клиентских баз и документов с персональными данными сперва необходимо проверить правила организации и допустимость передачи файла внешнему сервису.
Google Drive и Google Docs: получить текст и сразу перейти к совместной работе
Google Docs применяют не как отдельный PDF-конвертер, а как связку с Google Drive. PDF загружается в Drive, затем открывается через Открыть с помощью → Google Документы. Создаётся отдельный редактируемый документ, который можно скачать как DOCX. Разбор открытия PDF в Google Документах полезен, когда требуется глубже понять, что происходит с исходником.
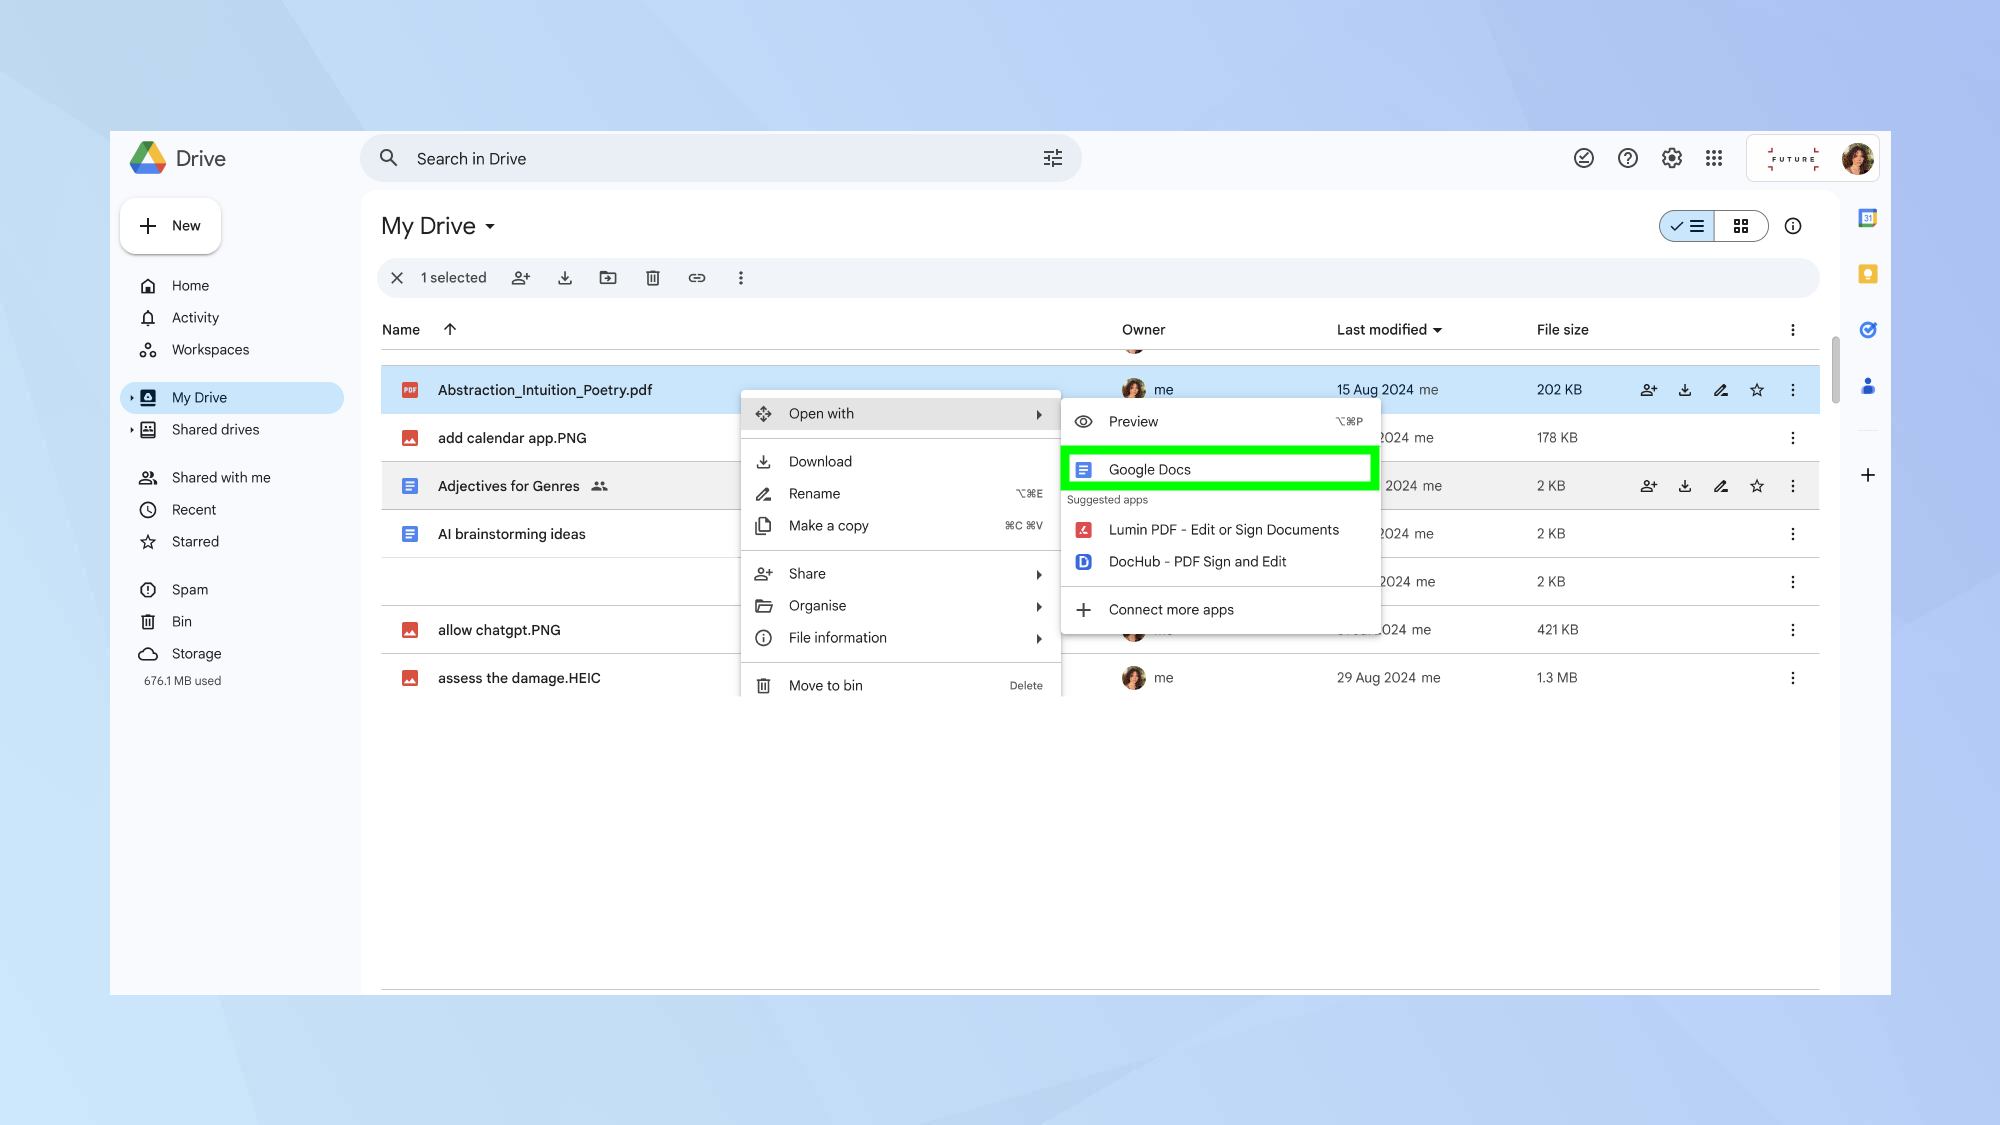
Порядок действий: загрузите PDF в Google Drive. Нажмите по файлу правой кнопкой мыши, выберите Открыть с помощью, затем Google Документы. Дождитесь создания нового документа. Проверьте текст, списки, таблицы и изображения. Для получения Word-файла откройте Файл → Скачать → Microsoft Word (.docx). Исходный PDF останется в Drive отдельно.
Google Docs лучше рассматривать как инструмент извлечения и дальнейшей коллективной редакции, а не как средство сохранения полиграфической верстки. Он полезен, когда после конвертации текст будут переписывать, комментировать, согласовывать и объединять с другими материалами. Для макета рекламного буклета, каталога или презентационного PDF, где важна геометрия каждой страницы, этот путь обычно требует заметной ручной перестройки.
Сканированные страницы Google может распознавать при открытии через Docs, но качество зависит от изображения. Для таблиц, многоязычных материалов и документов с мелким шрифтом лучше сперва сделать OCR специализированным инструментом, а в Google Docs переносить уже распознанный итог. Так легче отделить ошибки распознавания от ошибок верстки.
Плюсы
- Не требуется установка настольной программы.
- Редактируемая версия сразу доступна для совместной работы и комментариев.
- DOCX скачивается из меню Google Docs.
- Исходный PDF сохраняется отдельно в Drive.
Минусы
- Сложная верстка перестраивается сильнее, чем в специализированных PDF-конвертерах.
- Документ загружается в облачную инфраструктуру.
- Большие таблицы, колонки и сканы требуют тщательной ручной проверки.
Кому подойдёт
Подойдёт редакциям, маркетинговым и проектным командам, которые после извлечения текста сразу переходят к совместной переработке документа в браузере.
Smallpdf: быстрый PDF to Word в браузере
Smallpdf предлагает отдельный инструмент PDF to Word. Для текстового PDF достаточно загрузить файл и выбрать преобразование обычного текстового слоя. Для сканированных страниц предусмотрен OCR-режим; доступность такого режима зависит от условий сервиса, по этой причине перед обработкой скана важно посмотреть, какой вариант предлагается в текущем интерфейсе.
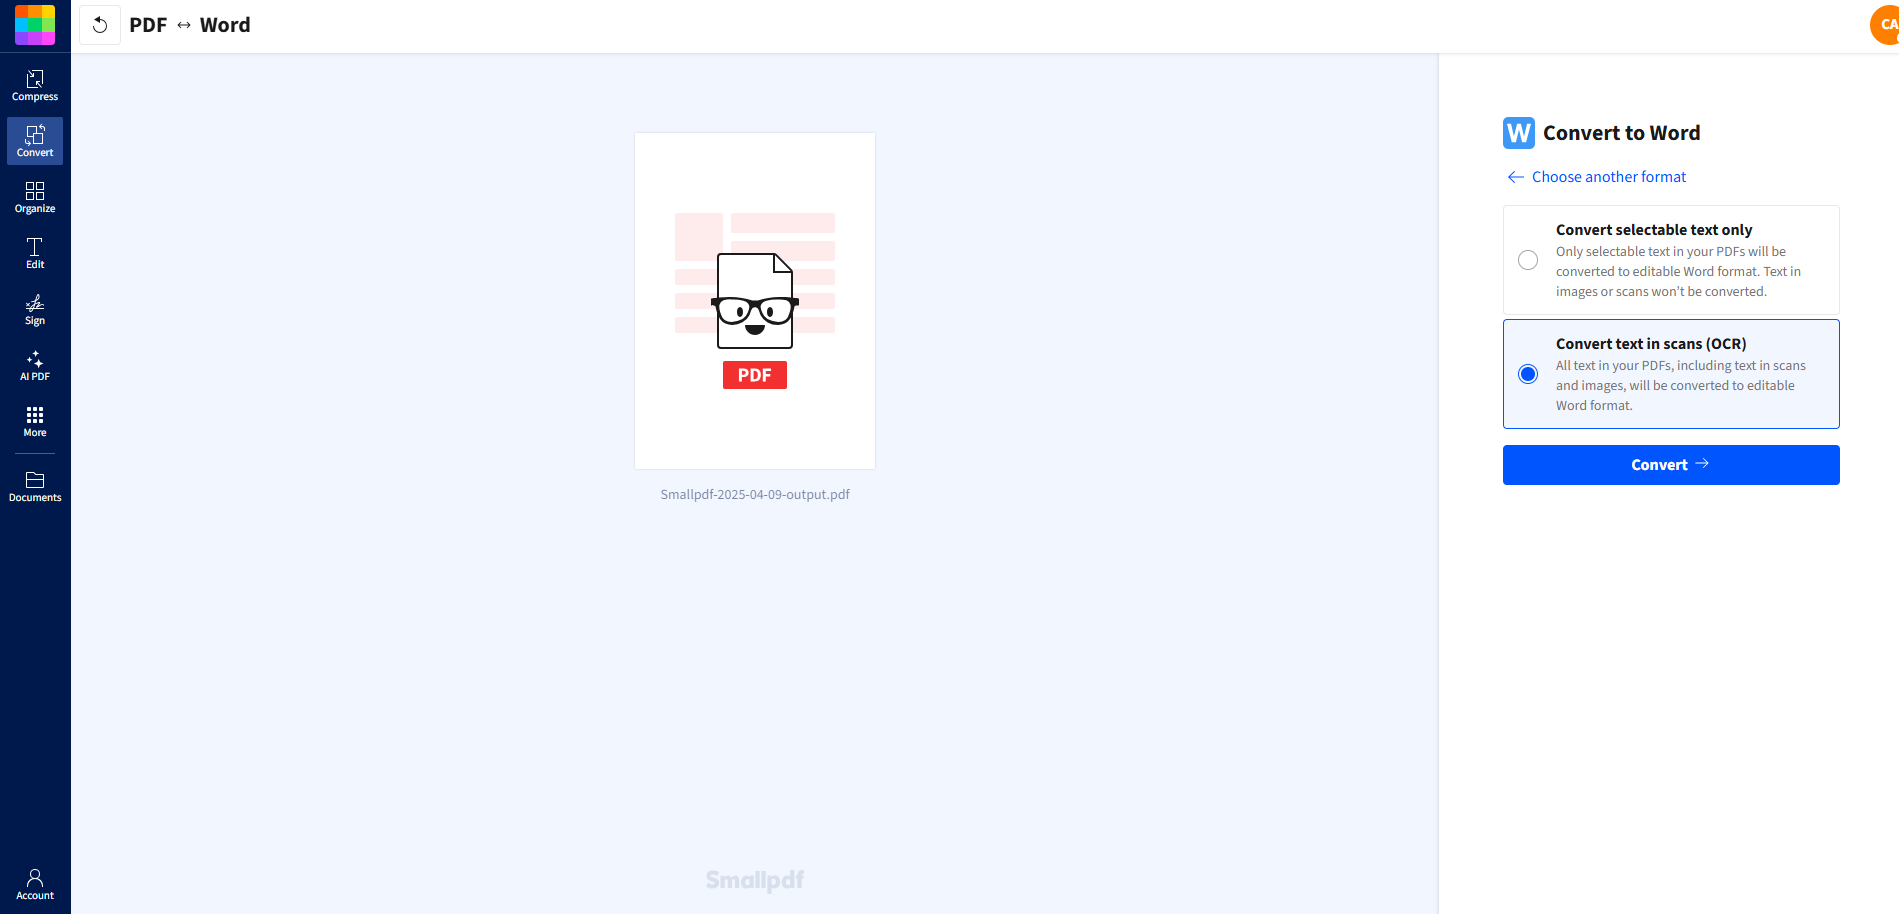
Источник изображения: Smallpdf
Порядок действий: откройте инструмент PDF to Word, добавьте PDF и дождитесь анализа. Если исходный файл содержит обычный текст, выберите вариант преобразования с существующим текстовым слоем. Для скана применяйте вариант с OCR, когда он доступен. После обработки сохраните DOCX и сразу откройте его для сверки. Не отправляйте файл дальше по рабочему процессу, пока не проверены хотя бы одна текстовая страница, таблица и страница с изображением.
Онлайн-конвертер в особенности удобен для коротких задач: получить абзацы из публичного отчёта, сделать редактируемую копию инструкции, забрать текст из пресс-релиза в PDF. Для документа с конфиденциальной информацией удобство не должно быть единственным критерием: решение о загрузке во внешний сервис принимают по правилам вашей организации и условиям обработки данных конкретного сервиса.
На сложном PDF Smallpdf, как и любой автоматический конвертер, реконструирует структуру, а не переносит её математически один в один. По этой причине оценивать итог необходимо по назначению. Если DOCX необходим как источник текста, достаточно правильных абзацев и таблиц. Если он должен визуально повторять брошюру, объём ручной доводки может оказаться чрезмерно большим, и лучше вернуться к специализированной настольной программе.
Плюсы
- Работает в браузере и не требует установки.
- Отдельный инструмент PDF to Word рассчитан на короткий понятный сценарий.
- OCR-режим предусмотрен для сканированных документов.
- Подходит для разовых несложных преобразований.
Минусы
- Файл передаётся внешнему онлайн-сервису.
- Условия доступа к OCR и другим расширенным возможностям могут отличаться от базовой конвертации.
- Сложные макеты требуют ручной доработки после экспорта.
Кому подойдёт
Подойдёт для разовых операций с несложными и несекретными PDF, когда необходимо быстро получить DOCX на компьютере без установки отдельной программы.
iLovePDF: отдельный онлайн-инструмент PDF в Word
iLovePDF содержит отдельный конвертер PDF в Word. Обычный текстовый PDF преобразуется без OCR, а для сканов сервис предлагает вариант с распознаванием. Это принципиально различные задачи: на текстовом документе добавочное распознавание не нужно, а на изображении страницы без OCR редактируемый текст не появится.
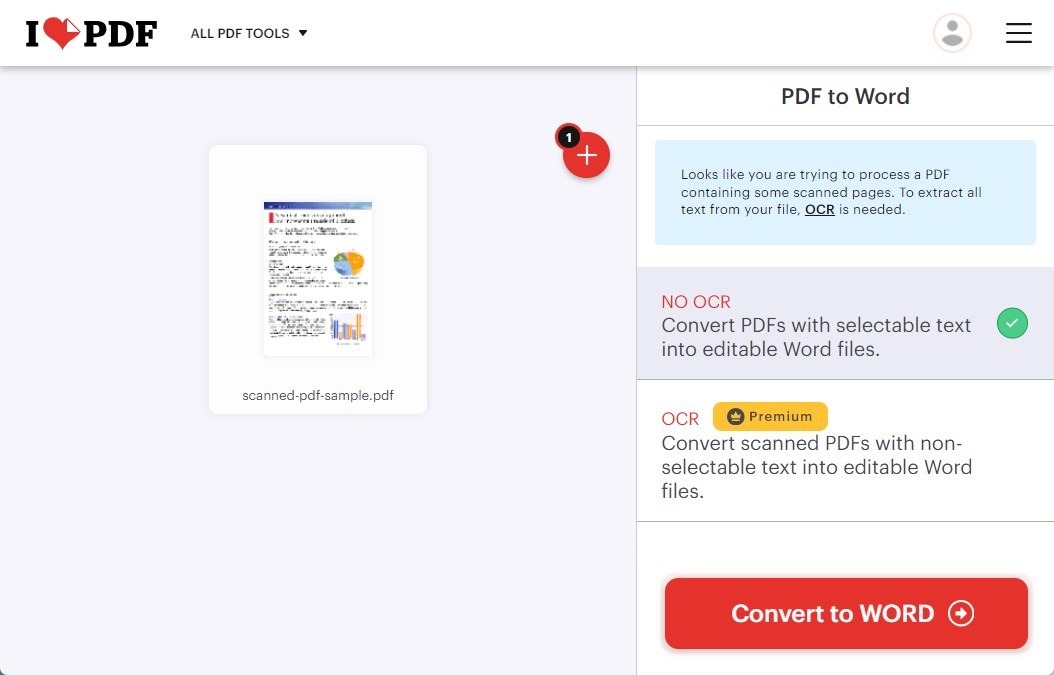
Источник изображения: PDFgear / iLovePDF
Рабочий сценарий: откройте PDF to Word, добавьте файл и дождитесь загрузки. Для PDF с текстовым слоем применяйте обычный режим. Для скана включите OCR, когда такой вариант доступен в текущем интерфейсе, и задайте подходящий язык распознавания. Запустите преобразование, сохраните DOCX и проверьте его в текстовом редакторе.
iLovePDF уместен для стандартных офисных файлов, которые необходимо быстро превратить в редактируемый документ, в особенности когда работа ведётся с различных компьютеров. Как и в Smallpdf, не следует оценивать только удобство кнопки загрузки: для чувствительных документов важна допустимость передачи файла внешней системе. Это организационное решение, а не техническая мелочь.
При проверке итога обращайте внимание не только на вид страницы. Порой документ визуально похож на оригинал, но абзац собран из отдельных строк, таблица превратилась в набор текстовых блоков, а подпись к рисунку стала обычным параграфом. Попробуйте реально редактировать несколько мест: вставить слово в середину абзаца, добавить строку таблицы и изменить заголовок. Так сразу видно, насколько DOCX пригоден для дальнейшей работы.
Плюсы
- Браузерный сценарий не требует установки.
- Есть разделение обычной конвертации и OCR для сканированных страниц.
- Подходит для быстрого получения DOCX из стандартного PDF.
- Интерфейс ориентирован на отдельные операции с документами.
Минусы
- Файл обрабатывается через внешний сервис.
- OCR относится к расширенному сценарию и требует проверки доступности в текущих условиях.
- Сложные формы, колонки и дизайнерская верстка требуют ручной правки.
Кому подойдёт
Подойдёт для быстрых браузерных конвертаций несложных PDF, когда важна доступность с любого компьютера и документ допустимо передавать онлайн-сервису.
На Android: отдельное приложение
На телефоне задача обычно проще: получить DOCX из файла, который пришёл в мессенджере, почте или хранится в памяти устройства. Для такого сценария необязательно переносить документ на компьютер. Для мобильного сценария применяется отдельное Android-приложение SmartApps38, по этой причине этот метод вынесен в самостоятельную группу, а не смешан с браузерными сервисами.
PDF to Word Converter от SmartApps38
Приложение PDF to Word Converter от SmartApps38 представлено в Google Play и RuStore. В карточке Google Play описан прямой сценарий: выбрать PDF, запустить преобразование в DOCX и получить файл на устройстве. Тоже заявлено распознавание текста для документов, где содержимое представлено изображением.
Порядок действий: откройте приложение и нажмите Select PDF. Выберите документ в памяти телефона, потом запустите Convert. Дождитесь окончания обработки и откройте полученный DOCX. В карточке приложения указана папка Phone/PDF2Word-Converter как место сохранения итога. Для скана применяйте OCR-функцию приложения и после конвертации обязательно перечитайте распознанный текст.
Мобильный метод удобен как оперативный: получить редактируемый текст перед встречей, вытащить из PDF несколько страниц для правок, подготовить черновик ответа. Для большого отчёта с десятками таблиц телефон хуже подходит для контроля качества — не из-за самого формата, а потому что сопоставлять длинный PDF и DOCX на небольшом экране неудобно. В такой ситуации мобильное приложение можно применять для первичного преобразования, а финальную проверку выполнить на компьютере.
Перед обработкой рабочего документа изучите раздел о данных в магазине приложений и правила вашей организации. В карточке Google Play есть отдельный блок Data safety; это ещё одна причина не переносить конфиденциальный документ в мобильный инструмент автоматически, только потому что он оказался под рукой.
Плюсы
- Не требуется компьютер: исходный PDF и итог остаются доступны на смартфоне.
- Рабочий сценарий сводится к выбору PDF и запуску конвертации.
- Заявлена OCR-обработка для файлов, где текст представлен изображением.
- Удобен для коротких оперативных задач вне рабочего места.
Минусы
- Длинный и сложный DOCX неудобно качественно сопоставлять с оригиналом на небольшом экране.
- Перед рабочей обработкой необходимо учитывать сведения о данных из карточки приложения и внутренние правила компании.
- Сложная верстка и таблицы после автоматического преобразования требуют проверки на компьютере.
Кому подойдёт
Подойдёт пользователям Android, которым необходимо оперативно получить DOCX из PDF на телефоне, а критичная точность макета не заменяет последующую проверку итога.
Как работать со сканированным PDF
Скан — главный источник ошибок при переводе PDF в Word. В нём необходимо решить две задачи одновременно: распознать символы и восстановить структуру страницы. Отдельное руководство Xeon Live по OCR в PDF помогает понять сам этап распознавания. Для конвертации в DOCX важно дополнить его контролем структуры: программа должна не только прочитать буквы, но и правильно определить абзацы, таблицы, колонки и подписи.
Подготовьте изображение до OCR
- Поверните страницы в нормальную ориентацию. OCR хуже работает, когда часть листов лежит боком.
- Уберите явно пустые и дублирующиеся страницы до распознавания, чтобы не проверять лишний итог.
- По возможности применяйте исходный скан, а не скриншот из мессенджера: повторное сжатие ухудшает мелкие символы.
- Проверьте края страницы. Обрезанные номера, первые буквы строк и подписи невозможно восстановить правильно только настройкой OCR.
- Для многоязычного материала задайте реальные языки документа, а не весь доступный список: это уменьшает число неоднозначных сопоставлений.
Проверяйте не только слова, но и структуру
После распознавания отыщите в DOCX пять контрольных типов данных: длинное слово, короткое имя или аббревиатуру, дату, число с разделителем и строку таблицы. Ошибки часто распределяются неравномерно. Обычный абзац может выглядеть идеально, а номер договора или сумма содержать подменённый символ. Для делового документа одна такая ошибка важнее десятка корректных абзацев.
Если после переноса появляются нечитаемые символы, полезен отдельный материал о том, почему текст из PDF превращается в иероглифы. Причина может быть не только в OCR: порой PDF содержит нестандартное кодирование, подмножество шрифта или текстовый слой, который визуально отображается правильно, но копируется неверно. В этом случае повторное распознавание страницы как изображения бывает надёжнее простого копирования.
Для документов, которые изначально были оцифрованы неудачно, сперва имеет смысл привести исходник в порядок. В инструкции по редактированию сканированных документов разобраны сценарии, где OCR дополняется исправлением страниц. Чем чище исходная геометрия и контраст, тем меньше ручной работы после экспорта в Word.
Как сохранить таблицы, колонки, изображения и колонтитулы
Сложность конвертации практически всегда растёт вместе с количеством независимых объектов на странице. Один большой абзац переносится проще, чем таблица с объединёнными ячейками, а таблица — проще, чем рекламный макет с врезками и текстом поверх изображения. По этой причине контроль необходимо строить по типам элементов, а не только по страницам.
Таблицы
Щёлкните внутри таблицы в DOCX и убедитесь, что Word распознаёт её именно как таблицу: можно выделить строку, столбец или ячейку, а при вставке текста соседние элементы не разъезжаются как независимые блоки. Проверьте объединённые ячейки, переносы длинных наименований, числа с десятичными разделителями и строки итогов. В медиапланах и коммерческих отчётах именно таблицы чаще всего содержат значения, которые нельзя исправлять по памяти.
Когда главная цель — не редактировать весь документ, а получить данные таблицы, правильнее выбрать специализированный путь и затем перенести итог в табличный редактор. В качестве следующего шага можно применять инструкцию по преобразованию PDF в Excel. Это лучше, чем заставлять Word хранить сложную аналитическую таблицу только ради последующего копирования.
Многоколоночная верстка
В газетной, журнальной и презентационной верстке порядок чтения не всегда совпадает с геометрией объектов. Конвертер должен понять, что сперва идёт верх левой колонки, затем её продолжение, и лишь после этого правая колонка. Ошибка проявляется как абзацы, переставленные местами. Проверяйте смысловую последовательность, а не только внешний вид: документ может выглядеть похожим, но текст будет читаться в неверном порядке.
Изображения и подписи
Убедитесь, что изображения не превратились в фон страницы и остаются связанными с нужными подписями. Для рабочего DOCX важно не только наличие картинки, но и её поведение при редактировании соседнего текста. Добавьте одну строку перед изображением и посмотрите, остаётся ли оно в логичном месте. Если картинка закреплена абсолютными координатами, дальнейшая переработка документа может быстро разрушить макет.
Колонтитулы и номера страниц
После конвертации колонтитул порой становится обычным текстом в верхней части страницы. Это в особенности заметно после вставки нового абзаца: номер страницы остаётся на прежнем месте или попадает в основной поток. Проверьте верхний и нижний колонтитулы в режиме редактирования Word. Если они необходимы в новой версии, лучше восстановить их как настоящие поля и элементы колонтитула, а не оставлять итог автоматической конвертации без проверки.
Почему после конвертации съезжает форматирование
Большинство проблем поясняется не поломкой файла, а различием моделей PDF и DOCX. PDF фиксирует координаты готовой страницы. Word заново рассчитывает строки и страницы с учётом доступных шрифтов, полей, интервалов, привязки изображений и правил абзацев. Небольшое изменение ширины символа в длинном документе способно сдвинуть перенос, а затем и все следующие страницы.
Шрифты
PDF может содержать встроенное подмножество шрифта, которого нет в системе. Word подбирает замену, и геометрия текста меняется. Не пытайтесь вернуть исходный вид ручной установкой случайной похожей гарнитуры. Сперва определите, требуется ли вообще визуальная копия. Для рабочего черновика лучше применить корпоративный стиль и заново выстроить абзацы, чем имитировать неизвестный шрифт.
Разрывы строк и абзацев
Конвертер может принять каждую строку PDF за отдельный абзац. В Word это видно по тому, что текст плохо перетекает после вставки одного слова. В таком документе сперва включите отображение непечатаемых знаков и оцените структуру. Массово удалять переносы стоит лишь после создания копии: реальные разрывы абзацев, списков и адресных блоков тоже могут исчезнуть.
Формы, подписи и интерактивные элементы
PDF-форма, электронная подпись и обычный текст — различные сущности. При экспорте в Word интерактивное поле не обязано превращаться в аналогичный элемент управления Word. Важный подписанный PDF вообще не следует воспринимать как документ, который можно конвертировать, отредактировать и считать юридически тем же самым файлом. Для рабочей переработки создавайте отдельную копию, а исходный подписанный PDF храните неизменным.
Пароль и ограничения доступа
Конвертация не должна применяться как метод обхода установленной владельцем защиты. Если PDF требует пароль для открытия или запрещает изменение по правилам доступа, работайте с документом лишь при наличии законного разрешения и нужных учётных данных. Для внутреннего документооборота лучше получить у владельца исходный DOCX или разрешённую редактируемую копию.
Как проверить DOCX после конвертации
Контроль итога — обязательная часть процесса. Ошибка конвертации опасна тем, что документ может выглядеть правдоподобно. Проверять необходимо не только наличие текста, но и его редактируемость, порядок, значения и структуру. Для командной работы полезно разделить проверку на три прохода: технический, содержательный и визуальный.
Первый проход: техническая целостность
- Откройте DOCX без сообщения о повреждении и убедитесь, что файл сохраняется ещё раз.
- Сверьте количество смысловых разделов и порядок страниц с исходным PDF.
- Проверьте, что основной текст редактируется, а не вставлен как большое изображение.
- Прокрутите документ до конца и убедитесь, что нет полностью пустых или повторённых страниц.
- Откройте несколько изображений и таблиц, чтобы понять, являются ли они отдельными объектами.
- Проверьте заголовки и списки: они должны вести себя как связанные абзацы, а не как набор случайных текстовых блоков.
Второй проход: критичные данные
- Номера договоров, счетов, заявок и документов.
- Даты, сроки и периоды.
- Суммы, проценты, коэффициенты и единицы измерения.
- Имена, должности, наименования компаний и продуктов.
- Адреса веб-страниц и адреса электронной почты, когда они есть в исходнике.
- Нумерация пунктов, приложений, рисунков и таблиц.
- Формулы, индексы, специальные символы и знаки валют в деловых материалах.
Для OCR-документа такой проход важнее визуального сходства. Ошибочная буква в обычном слове заметна редактору, а подмена нуля на букву O в коде или номере может пройти незамеченной. Сверяйте критичные поля с PDF, а не с памятью и не с соседним документом.
Третий проход: пригодность к дальнейшему редактированию
Сделайте три тестовых правки: добавьте предложение в обычный абзац, вставьте строку в таблицу и измените один заголовок. После каждой операции посмотрите, остаётся ли документ управляемым. Если одно слово разрушает половину страницы, автоматическая верстка слишком жёсткая. Тогда выгоднее извлечь текст и заново оформить документ, чем часами чинить каждую абсолютную привязку.
Мини-метрики качества, которые можно применять в команде
- Число критических расхождений. Сколько ошибок найдено в датах, суммах, именах, номерах и других контролируемых полях.
- Число разрушенных структурных элементов. Отдельно считайте таблицы, списки, колонтитулы и подписи, которые пришлось восстанавливать ручным способом.
- Доля страниц без ручной переверстки. Простая внутренняя метрика: сколько страниц можно редактировать сразу и сколько пришлось пересобирать.
- Время до готового рабочего DOCX. Считайте не продолжительность самой конвертации, а полный цикл до документа, который прошёл сверку и пригоден для редактирования.
- Количество повторных конвертаций. Если один и тот же исходник приходится прогонять несколько раз, метод выбран неудачно или настройки не соответствуют типу PDF.
Эти метрики не нужны для каждого бытового файла, но полезны для повторяющегося процесса. К примеру, отдел коммуникаций систематически получает PDF-отчёты от подрядчиков. После нескольких документов становится видно, какой инструмент лучше справляется с конкретным шаблоном и где появляется основная ручная работа. Решение тогда принимается на фактах рабочего процесса, а не на субъективном впечатлении от интерфейса.
Практический сценарий: переработать PDF-отчёт для новой версии
Рассмотрим типичную задачу маркетинговой или PR-команды. Есть утверждённый PDF-отчёт за прошлый период. Необходимо подготовить новую редакцию: сохранить структуру разделов, обновить факты, переписать выводы, заменить несколько таблиц и передать документ на согласование в Word. Копирование текста ручным способом создаёт лишние переносы и теряет структуру, по этой причине разумнее получить рабочий DOCX целиком.
Шаг 1. Зафиксируйте эталон
Сохраните PDF как неизменяемый оригинал и присвойте будущему DOCX отдельное имя. Не начинайте редактирование в единственном экземпляре. Это важно не только для безопасности: во время проверки всегда должен быть файл, с которым можно сопоставить спорное место.
Шаг 2. Определите тип страниц
Просмотрите титул, одну обычную текстовую страницу, одну таблицу и страницу с графикой. Попробуйте выделить текст. Если основная часть документа текстовая, начинайте с PDF Commander или Word. Если значительная часть — сканы, выбирайте PDF Commander с OCR или ABBYY FineReader PDF. Если PDF уже обрабатывается в Acrobat, логичнее применять встроенный экспорт там же.
Шаг 3. Сделайте контрольную конвертацию
Не редактируйте полученный DOCX сразу. Сперва сопоставьте несколько репрезентативных страниц. Если таблица распалась, порядок колонок перепутан или каждый абзац собран из десятков независимых блоков, остановитесь и смените режим или инструмент. Десять минут ранней проверки экономят гораздо больше времени, чем исправление неподходящей структуры в конце.
Шаг 4. Нормализуйте документ
После удачного экспорта примените стили Word к заголовкам, приведите интервалы и списки к единому виду, восстановите настоящие колонтитулы и таблицы там, где автоматическая структура получилась неудобной. Это отделяет техническое наследие PDF от новой рабочей версии. Чем ранее документ станет нормальным DOCX, тем легче дальнейшее согласование.
Шаг 5. Проведите содержательную сверку
Сопоставьте критичные значения с оригинальным PDF. Для отчёта это наименования периодов, проценты, суммы, подписи к графикам, источники данных и нумерация приложений. Для пресс-кита — имена, должности, даты событий, наименования продуктов и утверждённые формулировки. OCR и конвертация не должны становиться новым источником фактических ошибок.
Шаг 6. Передайте на совместное редактирование
Лишь после технической нормализации включайте рецензирование, комментарии или облачное соавторство. Иначе коллеги начнут обсуждать содержание в документе, который ещё меняет структуру от каждого исправления. Для Google Docs можно загрузить уже очищенный DOCX и применять режим предложений; для Word — включить исправления и хранить рабочую версию в утверждённом корпоративном хранилище.
Типичные ошибки и методы исправить их
Текст превратился в картинку
Так бывает со сканами и с графическими страницами. Проверьте, есть ли в исходном PDF текстовый слой. Если его нет, выполните OCR в PDF Commander, FineReader, Acrobat либо другом инструменте, который поддерживает распознавание, и только потом экспортируйте в DOCX. Простое повторение той же конвертации без OCR не изменит природу страницы.
После переноса появились непонятные символы
Не пытайтесь исправлять сотни символов ручным способом. Сперва сопоставьте копирование из PDF в простой текстовый редактор. Если и там символы неправильные, проблема находится в текстовом слое или кодировании. Для такого файла разумнее распознать вид страницы заново как изображение. Для короткого фрагмента можно тоже воспользоваться инструкцией по копированию текста из PDF и выбрать подходящий метод извлечения.
Каждая строка стала отдельным абзацем
Это признак того, что конвертер восстановил визуальные строки, а не логическую структуру. Для небольшого текста можно объединить абзацы ручным способом. Для длинного документа лучше повторить конвертацию в режиме, ориентированном на редактируемый текст, либо применять OCR-инструмент с настройкой структуры. Перед массовой заменой переносов сохраните копию, чтобы не склеить настоящие абзацы и списки.
Таблица выглядит правильно, но её нельзя редактировать
Щёлкните внутри предполагаемой таблицы. Если Word не показывает инструменты таблицы, скорее всего, это изображение или набор текстовых блоков. Для важной таблицы лучше ещё раз извлечь данные подходящим инструментом и вставить настоящую таблицу. Чем дольше документ будет жить и обновляться, тем важнее нормальная структура вместо визуальной имитации.
Пропали шрифты или изменились переносы
Не все шрифты из PDF доступны в системе как обычные устанавливаемые гарнитуры. Подберите корпоративный шрифт и заново примените стили, если новая версия предназначена для редактирования. Попытка добиться пиксельного совпадения ценой десятков ручных переносов делает DOCX хрупким: следующая правка снова всё сдвинет.
Документ стал заметно длиннее или короче
Проверьте поля, размер страницы, межстрочные интервалы, размер шрифта и колонтитулы. Даже при том же тексте изменение этих параметров меняет пагинацию. Сопоставлять только число страниц бессмысленно: важнее наличие всех разделов и логический порядок. Количество страниц становится критичным лишь там, где ссылки и приложения завязаны на конкретную нумерацию.
В DOCX пропали ссылки
Автоматический экспорт не всегда восстанавливает гиперссылку как активный объект, в особенности когда в PDF виден только текст адреса или ссылка была частью сложного графического блока. После конвертации пройдите все элементы, которые должны быть кликабельными, и восстановите ссылки ручным способом в Word. Для публикационных материалов это отдельный пункт финальной проверки.
Онлайн-сервис обработал файл, но итог неудобен
Не нужно последовательно загружать документ во все браузерные конвертеры. Сперва определите характер проблемы. Если нет текста — необходим OCR. Если разрушены таблицы — необходим инструмент, лучше понимающий структуру. Если важна точная геометрия — применяйте PDF-среду или пересоберите макет. Диагностика причины эффективнее случайного перебора сервисов.
Безопасность и конфиденциальность в рабочем процессе
Технически любой онлайн-конвертер удобен: загрузил PDF, получил DOCX. Но в корпоративной среде вопрос начинается ранее — имеет ли сотрудник право передавать этот документ внешней системе. Внутренний отчёт, договор с ограничением распространения, выгрузка клиентских данных или документ с персональными данными может требовать локального инструмента или утверждённого корпоративного сервиса.
Для локальной программы риск передачи внешнему конвертеру уменьшается, но остаются обычные требования к рабочей станции: доступ к файлам, резервное копирование, защита учётной записи, актуальность системы. Нельзя считать любой настольный инструмент автоматически безопасным только потому, что он установлен на компьютере. Важен весь путь документа — от получения PDF до хранения итогового DOCX.
Перед онлайн-конвертацией проверяйте, что именно отправляется: порой в PDF остаются лишние страницы, скрытые приложения или персональные данные, которые не нужны для задачи. Лучше подготовить минимальную рабочую копию и обрабатывать только нужный фрагмент. Это одновременно уменьшает объём данных и сокращает последующую проверку.
Какой метод выбрать для конкретной задачи
Для простого текстового PDF
Начните с PDF Commander или Microsoft Word. Первый удобнее, когда PDF необходимо сперва проверить, отредактировать или распознать, второй — когда документ практически целиком состоит из обычных абзацев и дальше будет жить как Word-файл. Если нельзя устанавливать программы, применяйте Google Docs, Smallpdf или iLovePDF.
Для скана договора, акта или исследования
Выбирайте инструмент с OCR и возможностью контролировать распознавание: PDF Commander или ABBYY FineReader PDF. Acrobat подходит, когда документ уже находится в его рабочем процессе. После экспорта сверяйте поля, где ошибка имеет смысловое значение: номера, даты, суммы, фамилии, наименования и ссылки.
Для дизайнерского PDF, каталога или презентационного макета
Сперва решите, необходим ли в самом деле DOCX. Word плохо подходит как точная замена полиграфической верстки. Если цель — извлечь текст для новой версии, делайте конвертацию и затем оформляйте документ заново. Если цель — сохранить макет практически без изменений, разумнее редактировать исходный PDF в профильной программе или работать с исходным файлом верстки.
Для совместного текста в команде
Google Drive и Google Docs удобны, когда главное — быстро получить редактируемый текст и перейти к комментариям, предложениям и совместной переработке. Для чувствительного документа сперва сделайте локальную конвертацию, проверьте DOCX, а затем загружайте уже разрешённую рабочую версию в корпоративно утверждённое хранилище.
Для работы только со смартфона
На Android подойдёт отдельный PDF to Word Converter, когда документ короткий и итог можно за короткое время проверить. Большие отчёты и сложные таблицы лучше лишь заранее конвертировать на телефоне, а финальную сверку проводить на большом экране.
Что делать после окончания правок в Word
Конвертация PDF в Word обычно является промежуточным этапом. После редактирования документ часто снова требуется отправить в фиксированном виде. Для этого применяйте штатный экспорт Word и отдельную инструкцию по преобразованию Word обратно в PDF. Перед финальным экспортом обновите оглавление и поля, проверьте разрывы страниц, таблицы, изображения, колонтитулы, комментарии и режим исправлений.
Не заменяйте исходный PDF новой версией до окончательного согласования. Храните три уровня: исходный эталон, рабочий DOCX и финальный PDF после утверждения. Такая структура упрощает аудит изменений и позволяет за короткое время понять, где появилась ошибка — в исходнике, при конвертации или уже во время редактирования.
Финальный чек-лист перед передачей DOCX
- Исходный PDF сохранён отдельно и не изменён.
- В DOCX присутствуют все нужные разделы и приложения.
- Текст в самом деле редактируется, а не лежит одной картинкой.
- Заголовки, списки и абзацы имеют нормальную структуру.
- Таблицы проверены на объединённые ячейки, числа и строки итогов.
- Изображения стоят рядом с правильными подписями и не ломают текст при редактировании.
- Колонтитулы и номера страниц восстановлены как управляемые элементы, когда это требуется.
- Даты, суммы, имена, номера и другие критичные поля сверены с PDF.
- После OCR проверены похожие символы и многоязычные фрагменты.
- Гиперссылки, которые должны работать, в самом деле активны.
- В документе нет случайных пустых страниц и повторённых фрагментов.
- Тестовая правка абзаца, заголовка и таблицы не разрушает верстку.
- Файл сохраняется без ошибок и открывается ещё раз.
- Рабочая версия имеет понятное имя и не смешана с финальным PDF.
- Для онлайн-конвертации соблюдены внутренние правила обработки документов.
Ответы на частые вопросы
Можно ли любой PDF превратить в полностью редактируемый Word?
Нет универсального преобразования, которое одинаково восстанавливает все PDF. Текстовый документ с простыми абзацами обычно переносится хорошо. Скан сперва требует OCR, а сложный дизайнерский макет часто нуждается в ручной пересборке. Оценивайте не только внешний вид, но и то, насколько абзацы, таблицы и изображения реально редактируются.
Необходим ли OCR, если текст уже выделяется?
Обычно нет. Если текст в PDF правильно выделяется, копируется и находится поиском, у документа уже есть текстовый слой. Повторное распознавание добавляет лишний этап и способно внести ошибки. OCR необходим для сканов, фотографий страниц и повреждённого текстового слоя.
Почему Word меняет расположение элементов?
PDF фиксирует готовую страницу, а Word пересчитывает поток текста с учётом шрифтов, полей, интервалов и привязки объектов. По этой причине колонки, таблицы, сноски и графические блоки реконструируются, а не переносятся как исходная редактируемая модель.
Какой метод выбрать для конфиденциального документа?
Применяйте утверждённый локальный инструмент или корпоративный сервис, соответствующий правилам вашей организации. Браузерный конвертер получает файл для удалённой обработки, по этой причине его нельзя выбирать только по удобству интерфейса.
Что важнее после OCR: визуальное сходство или проверка текста?
Для делового документа первичны критичные данные и структура. Сперва сверяйте номера, даты, суммы, имена, таблицы и порядок разделов. После этого приводите в порядок шрифты, интервалы и внешний вид.
Когда лучше не конвертировать PDF в Word вообще?
Не делайте DOCX целью само по себе. Если необходимо изменить одну подпись, переставить страницы или сохранить точную полиграфическую геометрию, рациональнее редактировать сам PDF. Если необходима только таблица, применяйте специализированное извлечение данных. Word необходим тогда, когда дальнейшая работа в самом деле будет текстовой и структурной.
Итог: рабочая схема без лишних повторов
Для большинства задач порядок выбора прост. Сперва определите тип PDF. На Windows начните с PDF Commander, в особенности когда исходник необходимо проверить, распознать или подготовить перед экспортом. Для простого текстового файла можно сразу открыть PDF в Microsoft Word. Скан и архивный документ лучше обрабатывать в среде с развитым OCR, к примеру в ABBYY FineReader PDF; Acrobat удобен, когда PDF уже проходит профессиональную обработку там же.
В браузере Google Docs подходит для перехода от PDF к совместной редактуре, а Smallpdf и iLovePDF — для короткой одношаговой конвертации. На Android отдельное приложение SmartApps38 закрывает мобильный сценарий. Во всех случаях качество определяется не тем, открылся ли DOCX, а тем, прошёл ли он проверку структуры и критичных данных. Исходный PDF остаётся эталоном до тех пор, пока новая версия не согласована и не выпущена в финальном формате.