
Скопировать текст из PDF удаётся не одинаково во всех документах. В одном файле строки выделяются как обычный текст, в другом страница фактически является изображением, а в третьем автор запретил копирование на уровне разрешений документа. По этой причине рабочий алгоритм начинается не с выбора программы, а с короткой диагностики: необходимо понять, есть ли в файле текстовый слой, сохранён ли порядок чтения и разрешено ли переносить содержимое.
Для рабочих материалов это в особенности важно: отчёты, коммерческие предложения, медиакиты, исследования, брифы и презентации часто приходят именно в PDF. Ошибка на этапе извлечения приводит к пропущенным строкам, перепутанным колонкам и неверно перенесённым числам. Ниже разобраны шесть методов для обычных файлов и сканов, а также отдельный порядок проверки итога перед применением фрагмента в документе, презентации, публикации или внутренней базе знаний.
Сперва определите, какой PDF перед вами
PDF сохраняет внешний вид страницы, но внутреннее устройство документов различается. Полезно сперва разобраться, как устроен формат PDF: визуально одинаковая страница может содержать полноценные символы, только растровое изображение или сочетание текста, иллюстраций и служебных объектов. От этого зависит, сработает ли обычное Ctrl+C или сперва потребуется оптическое распознавание текста — OCR, то есть Optical Character Recognition.
Быстрая проверка занимает меньше минуты. Откройте документ, попробуйте выделить одно слово мышью и скопировать его в простой текстовый редактор. Потом сопоставьте вставленный фрагмент с оригиналом: буквы, пробелы, переносы строк и цифры должны совпасть. Если курсор выделяет только прямоугольную область страницы или ничего не выделяет, перед вами скан либо изображение. Если выделение есть, но копирование блокируется, проверьте ограничения документа вместо попыток обходить защиту.
- Текст выделяется по словам и вставляется без искажений — применяйте обычное копирование в PDF Commander, Adobe Acrobat Reader, Google Chrome или «Просмотр».
- Страница выглядит как фотография, а курсор не цепляется за буквы — сперва выполните OCR, затем копируйте распознанный слой.
- Выделение идёт в неожиданном порядке — документ свёрстан колонками, отдельными текстовыми блоками или имеет сложный порядок чтения; лучше преобразовать его в редактируемый документ и проверить структуру.
- Копирование запрещено в свойствах безопасности — получите у владельца версию с нужными разрешениями или текстовый исходник. Защитные ограничения не следует обходить.
- После вставки появляются неверные символы — проблема связана с кодировкой, шрифтами или устройством текстового слоя; необходим другой путь извлечения и обязательная сверка с исходной страницей.
Что считать хорошим итогом
Цель — получить не просто набор символов, а пригодный к дальнейшей работе фрагмент. Для цитаты важна буквальная точность, для таблицы — соответствие строк и столбцов, для реквизитов — сохранность каждой цифры и знака, для длинного текста — правильный порядок абзацев. Форматирование можно восстановить позднее, а содержательную ошибку легко не заметить, если сразу вставить итог в презентацию или публикацию.
Перед массовым переносом возьмите контрольный фрагмент на 150–300 знаков из середины документа и сопоставьте его с оригиналом. В образце должны быть обычные слова, хотя бы одно число, знак препинания и перенос строки. Такой тест быстро показывает, как инструмент функционирует именно с этим PDF, и позволяет не тратить время на обработку десятков страниц неподходящим методом.
Шесть методов скопировать текст из PDF
Методы ниже расположены по практической логике, а не по принципу «один инструмент лучше всех». Первый вариант — PDF Commander для Windows: он позволяет работать с обычным текстом и отдельно распознавать сканы. Дальше идут Adobe Acrobat Reader, Microsoft Word, Google Диск с Google Документами, Google Chrome и встроенное приложение «Просмотр» на Mac. Выбор зависит от типа файла, объёма, требований к конфиденциальности и того, насколько важно сохранить структуру.
1. PDF Commander: обычное копирование и OCR в одном рабочем процессе
В PDF Commander текст с готовым текстовым слоем копируется через режим редактирования, а скан сперва распознаётся. Для общей схемы можно свериться с подробной инструкцией по копированию текста из PDF. Практический плюс этого подхода в том, что один и тот же документ не приходится передавать между просмотрщиком, сервисом распознавания и текстовым редактором: сперва определяется тип страницы, затем выполняется нужное действие.
Как скопировать обычный текст
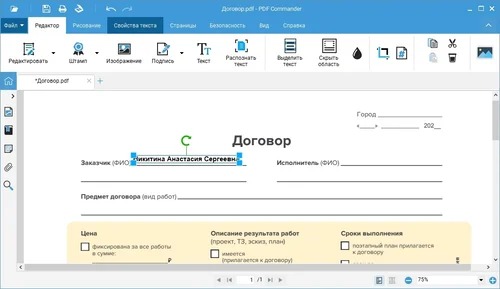
Для PDF, в котором буквы уже существуют как текстовые объекты, распознавание не нужно. Откройте файл, перейдите на вкладку «Редактор» и выберите «Редактировать». В текущей справке программы доступны режимы работы со «Страницей» и «Документом»; после перехода к редактированию дважды щёлкните по текстовому полю, выделите нужный фрагмент и вызовите команду «Копировать» в контекстном меню. На Windows тот же итог даёт Ctrl+C.
- Откройте PDF и сразу проверьте, выделяется ли конкретное слово, а не прямоугольник страницы.
- Перейдите в «Редактор» → «Редактировать» и выберите область работы — страницу или документ.
- Дважды щёлкните по нужному текстовому полю, затем протяните выделение по требуемым строкам.
- Применяйте команду «Копировать» или Ctrl+C и вставьте итог в целевое приложение.
- Сверьте первые и последние слова фрагмента, цифры, знаки и переносы. При сложной верстке проверяйте абзацы по отдельности.
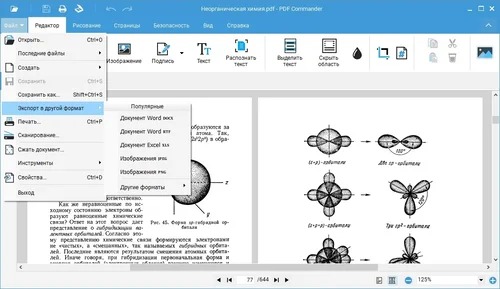
Этот путь подходит для цитат, абзацев, реквизитов и коротких разделов. При переносе большого объёма полезнее не выделять десятки страниц ручным способом, а преобразовать документ в редактируемый формат и уже там работать с цельным текстом. Так легче контролировать порядок абзацев, заголовки и списки, а также отыскать пропущенные фрагменты поиском по документу.
Как скопировать текст со скана
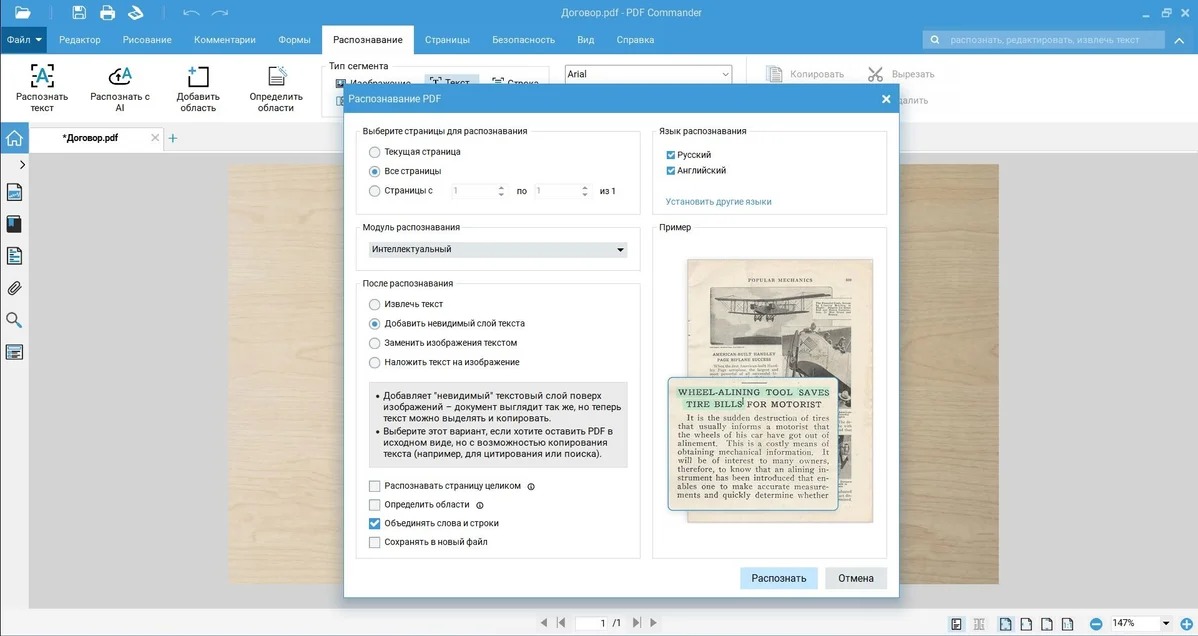
Сканированная страница включает изображение, по этой причине сперва необходим OCR. В PDF Commander откройте «Распознавание» → «Распознать текст». Для обработки можно указать текущую страницу, весь документ или диапазон. В качестве итога программа умеет извлекать текст, добавлять невидимый текстовый слой и сохранять распознанный вариант в новый файл. Подробности по этому этапу собраны тоже в материале о том, как распознать текст в PDF.
- Откройте вкладку «Распознавание» и выберите «Распознать текст».
- Установите диапазон: текущая страница, все страницы или конкретный интервал.
- Выберите язык документа. Для многоязычного материала укажите все реально присутствующие языки либо применяйте автоматическое определение в режиме AI-распознавания.
- Определите, что должно произойти после OCR: извлечь текст отдельно или добавить в PDF невидимый слой текста. Для сохранения исходного вида страницы удобен невидимый слой.
- Запускайте обработку и сохраняйте распознанный документ отдельно от исходника. После этого выделите контрольный фрагмент и проверьте его посимвольно.
- На сложной странице применяйте разметку областей распознавания: текст, колонка, строка, слово или изображение. Это уменьшает вероятность перепутанного порядка чтения.
OCR не отменяет редакторскую проверку. В особенности внимательно смотрите на похожие знаки: 0 и О, 1 и l, дефис и тире, кавычки, проценты, номера документов и десятичные разделители. В маркетинговом отчёте ошибка в одной цифре меняет вывод, а в реквизитах даже один неверный символ делает фрагмент непригодным для дальнейшего применения.
Плюсы
- Обычное копирование и распознавание сканов выполняются в одном настольном приложении.
- Можно обрабатывать текущую страницу, весь файл или заданный диапазон, по этой причине не обязательно распознавать лишние страницы.
- Невидимый текстовый слой позволяет сохранить визуальный вид скана и одновременно сделать слова доступными для выделения и поиска.
- Для сложных страниц доступна ручная разметка областей распознавания, что помогает отделять текст от изображений и колонок.
Минусы
- Прямое редактирование и копирование текстовых объектов в текущей справке относится к Windows; в Linux этот конкретный путь редактирования текста не реализован.
- После OCR требуется обязательная сверка с исходником, в особенности для чисел, таблиц, мелкого шрифта и некачественных сканов.
- При сложной много колонной верстке ручная разметка областей занимает добавочное время.
Кому подойдёт
PDF Commander рационален для Windows, когда в работе систематически встречаются и обычные PDF, и сканы: договорные приложения, отчёты, справки, анкеты, архивные страницы. Он удобен в сценариях, где исходный файл необходимо оставить локально и одновременно получить копируемый слой, не отправляя документ в облачный редактор.
2. Adobe Acrobat Reader: быстрое копирование из PDF с готовым текстовым слоем
Adobe Acrobat Reader подходит для ситуации, когда PDF уже содержит обычный текст и автор не запретил его копирование. В настольном приложении можно включить инструмент выделения, выбрать фрагмент и скопировать его через контекстное меню. Для Windows в настольной версии тоже предусмотрена команда копирования содержимого файла в буфер обмена целиком; в браузерном режиме эта команда недоступна.
Пошаговый порядок
- Откройте PDF в настольном Adobe Acrobat Reader.
- Щёлкните правой кнопкой в документе и выберите инструмент выделения текста, если обычный курсор работает в другом режиме.
- Выделите требуемый абзац или несколько строк. Следите, чтобы выделение шло по словам в правильном порядке.
- Вызовите контекстное меню и выберите Copy, потом вставьте фрагмент в целевое приложение.
- Если необходимо перенести всё текстовое содержимое и вы работаете в Reader на Windows, применяйте Edit → Copy File to Clipboard, после чего проверьте порядок текста в месте вставки.
Если текст визуально выделяется, но команда копирования недоступна, проверьте разрешения PDF. В Reader откройте свойства документа и раздел Security; в сводке ограничений видно, разрешено ли копирование. При запрете правильный рабочий путь — получить у владельца разрешённую версию или исходный документ. Сам факт того, что PDF открывается и читается, не означает, что автор разрешил извлечение содержимого.
Для скана без распознанного слоя этот метод сам по себе не решает задачу: на странице нет символов, которые можно выделить. В этом случае сперва применяйте OCR в специализированном инструменте, встроенное распознавание Chrome или преобразование через Google Документы, а потом возвращайтесь к обычному копированию уже распознанного текста.
Плюсы
- Подходит для быстрого копирования абзацев из обычных текстовых PDF без преобразования файла.
- Сводка ограничений документа помогает сразу отличить проблему разрешений от проблемы распознавания.
- На Windows настольное приложение позволяет отправить содержимое PDF в буфер обмена целиком.
Минусы
- Скан без текстового слоя требует отдельного распознавания.
- Копирование не работает, когда владелец PDF запретил это разрешениями документа.
- При сложной верстке порядок выделения может отличаться от визуального расположения блоков, по этой причине длинные фрагменты необходимо сверять.
Кому подойдёт
Adobe Acrobat Reader удобен тем, кто получает преимущественно цифровые PDF с уже готовым текстовым слоем и извлекает из них отдельные фрагменты: цитаты из исследований, условия из медиакитов, абзацы из пресс-материалов или данные из внутренних документов. Для сканов целесообразнее сразу выбрать метод с OCR.
3. Microsoft Word: когда необходим не фрагмент, а редактируемая копия документа
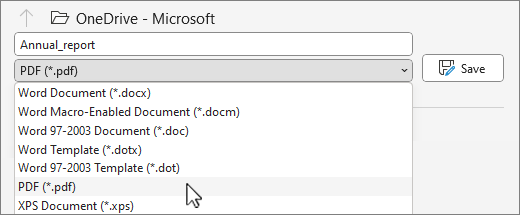
Microsoft Word открывает PDF не как исходный PDF, а создаёт его копию и преобразует содержимое в редактируемый документ. Это удобно, когда необходимо не взять одну цитату, а разобрать многостраничный материал: сделать выжимку исследования, перенести несколько разделов в бриф или подготовить текст к редактуре. Отдельная инструкция по преобразованию PDF в Word помогает заблаговременно понять, где конвертация полезнее ручного копирования.
Как открыть PDF в Word и скопировать текст
- В Word выберите «Файл» → «Открыть» и укажите нужный PDF.
- Подтвердите создание редактируемой копии. Исходный PDF вместе с этим не переписывается.
- Дождитесь преобразования и проверьте первые страницы: заголовки, абзацы, списки, сноски и изображения должны находиться в ожидаемом порядке.
- Выделяйте нужные фрагменты уже как в обычном документе Word и копируйте их стандартными командами.
- Если итог необходим для дальнейшей правки, сохраните рабочую копию в формате Word отдельно от исходного PDF.
Microsoft прямо указывает, что преобразование лучше работает с PDF, которые в основном состоят из текста. Графически насыщенная страница может открыться как изображение, и тогда слова на ней не будут редактируемыми. Часть элементов документа после преобразования тоже отображается не так, как в исходнике. По этой причине Word следует оценивать не как метод получить идеальный визуальный дубль, а как метод быстро превратить текстовую основу PDF в редактируемый материал.
Если задача — перенести таблицу, сперва проверьте, сохранились ли границы строк и столбцов. Если задача — цитирование, сопоставьте текст с PDF посимвольно. Если задача — переработка длинного отчёта, применяйте навигацию и поиск Word, чтобы убедиться, что все нужные разделы попали в преобразованную копию. Такой контроль занимает меньше времени, чем исправление уже опубликованного материала.
Плюсы
- Подходит для массовой работы с текстом, когда необходимо редактировать много абзацев, а не копировать их по одному.
- Создаёт отдельную редактируемую копию и не изменяет исходный PDF.
- Удобен для дальнейшей редакторской обработки: поиска, перестановки разделов, комментирования и подготовки черновика.
Минусы
- Сложная верстка после преобразования меняется: отдельные блоки, сноски и другие элементы могут смещаться.
- Графически насыщенные страницы порой превращаются в изображения, текст на них нельзя править как обычные символы.
- Для точных цитат, чисел и таблиц после конвертации всё равно требуется сверка с PDF.
Кому подойдёт
Word лучше выбирать для многостраничных текстовых PDF, когда итоговая цель — не разовая вставка, а дальнейшая работа с содержимым. Это практичный вариант для редактора, контент-менеджера, PR-специалиста или аналитика, которому необходимо разобрать документ на цитаты, тезисы и рабочие заметки.
4. Google Диск и Google Документы: облачное преобразование и OCR
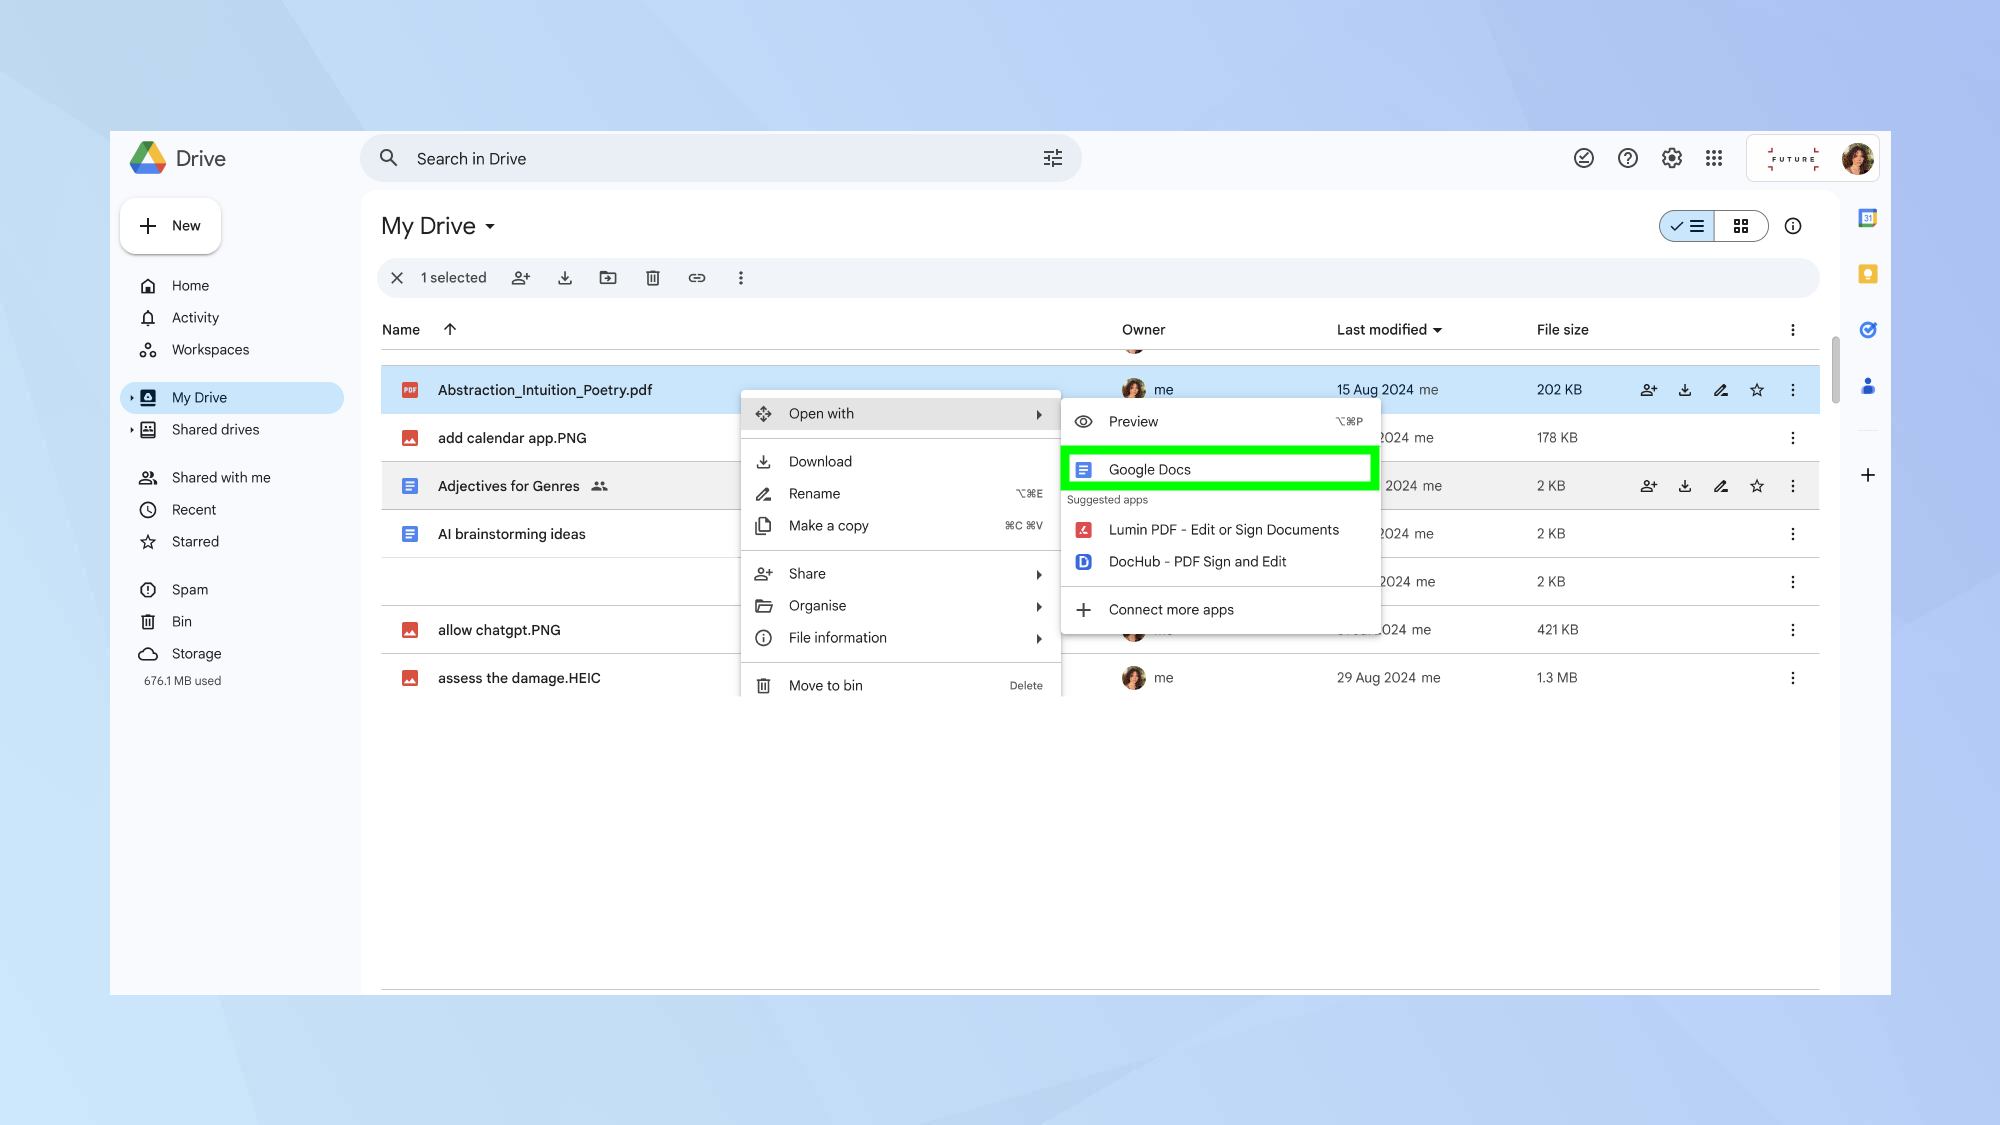
Google Диск умеет передавать PDF в Google Документы, где содержимое преобразуется в редактируемый документ. Этот путь полезен как для обычных PDF, так и для распознавания изображения с текстом. В Xeon Live есть отдельный разбор того, как открыть PDF в Google Документах; для рабочей задачи достаточно знать последовательность загрузки и ограничения распознавания.
Как выполнить преобразование
- На компьютере загрузите PDF в Google Диск.
- Щёлкните файл правой кнопкой мыши и выберите «Открыть с помощью» → «Google Документы».
- Дождитесь создания нового документа. Исходный PDF остаётся отдельным файлом в хранилище.
- Сопоставьте распознанный текст с исходной страницей, затем выделите нужный фрагмент и скопируйте его как обычный текст.
- При переносе нескольких страниц сперва проверьте порядок абзацев и лишь после этого применяйте итог в рабочем документе.
Для OCR у Google есть конкретные требования. В справке указано, что преобразуемый файл должен быть не больше 2 МБ; текст на странице должен быть достаточно крупным, изображение — ориентированным правильно, а контраст между буквами и фоном — чётким. Лучше распознаются распространённые шрифты. Форматирование сохраняется отчасти: жирное и курсив, размер и тип шрифта, переносы строк могут сохраниться, а списки, таблицы, колонки, сноски и концевые примечания распознаются заметно хуже.
Главное ограничение для бизнеса связано не с интерфейсом, а с режимом хранения: документ загружается в облако. Внутренние правила компании могут запрещать передачу договоров, персональных данных, непубличных исследований или партнёрских материалов в внешние сервисы. Для таких файлов выбирайте локальный метод. Для публичного отчёта, открытого пресс-кита или собственного документа облачный сценарий часто оказывается удобным, потому что итог сразу доступен для совместного редактирования.
Плюсы
- Не требует отдельного настольного PDF-редактора: преобразование запускается из браузера.
- Умеет извлекать текст из изображений и PDF с помощью OCR.
- Итог сразу становится редактируемым документом, который удобно комментировать и перерабатывать совместно.
Минусы
- Для OCR действует ограничение размера файла 2 МБ, указанное в справке Google Диска.
- Таблицы, колонки, сноски и сложная структура восстанавливаются ненадёжно и требуют ручной проверки.
- Документ загружается в облачную инфраструктуру, по этой причине метод не подходит для материалов, которые по внутренним правилам должны оставаться лишь на локальном устройстве.
Кому подойдёт
Google Диск и Google Документы удобны для небольших публичных или разрешённых к облачной обработке файлов: пресс-релизов, открытых исследований, методичек, презентационных материалов и сканов без сложной таблицы. Для конфиденциальной документации и больших сканов лучше выбрать локальный рабочий процесс.
5. Google Chrome: копирование прямо из браузера, в том числе из сканов
В Chrome PDF открывается во встроенном просмотрщике. Для обычного документа достаточно выделить слова мышью и скопировать их. Для сканированных PDF в настольном Chrome применяется распознавание, после которого изображённый на странице текст становится доступен для поиска, выделения, копирования и вставки. Обработка распознавания выполняется на устройстве, без отправки содержимого PDF в Google или сторонние сервисы.
Как работать с обычным PDF
- Откройте PDF в Chrome. Если браузер настроен на загрузку файлов вместо просмотра, измените поведение PDF в настройках содержимого Chrome.
- Проверьте, что курсор выделяет отдельные слова. Выберите один абзац и скопируйте его стандартной командой.
- Вставьте фрагмент в простой редактор и оцените порядок строк. Если всё правильно, переносите остальные части.
- Для длинного документа применяйте поиск внутри PDF, чтобы находить нужные слова до копирования.
Как работать со сканом
При открытии сканированного PDF Chrome автоматически запускает извлечение текста. Для многостраничного документа обработка занимает некоторое время; пока распознавание продолжается, браузер отображает сообщение о извлечении текста. После окончания можно искать по документу, выделять распознанные слова и копировать их. Это удобно для быстрого разбора скана, когда не требуется сохранять отдельную распознанную версию PDF.
Такой сценарий решает задачу чтения и копирования, но не заменяет полноценную реконструкцию верстки. Вставленный фрагмент следует проверять так же, как итог любого OCR: числа, имена, необычные термины и знаки. Если необходимо обработать много страниц с колонками, таблицами и сложной структурой, настольный OCR с настройкой областей даёт больше контроля над порядком чтения.
Плюсы
- Для обычных PDF копирование выполняется без добавочной программы — прямо во встроенном просмотрщике.
- Настольный Chrome умеет распознавать текст в сканированных PDF и делает его доступным для поиска и выделения.
- Распознавание скана выполняется на устройстве, что исключает передачу содержимого документа в облако ради этой операции.
Минусы
- Просмотрщик ориентирован на чтение и выделение, а не на восстановление сложной структуры документа.
- После OCR нет отдельного редакторского интерфейса для ручной разметки колонок и областей распознавания.
- Для многостраничных сканов необходимо дождаться окончания извлечения текста перед полной проверкой итога.
Кому подойдёт
Chrome удобен для разовых задач: быстро забрать цитату из PDF, отыскать термин в скане, перенести несколько строк из публичного документа. Для поточной обработки архива или файлов со сложной версткой лучше применять инструмент, где распознавание можно настраивать по областям и сохранять отдельный итог.
6. «Просмотр» на Mac: встроенное копирование и встраивание распознанного текста
В macOS приложение «Просмотр» копирует текст из PDF без установки добавочного редактора. Для обычного файла выберите «Инструменты» → «Выбор текста», выделите фрагмент и применяйте «Правка» → «Копировать». Для страниц, где текст представлен изображением, в приложении предусмотрена команда File → Export → Embed Text: она распознаёт содержимое и встраивает текстовый слой в экспортируемый PDF.

Копирование обычного текста
- Откройте PDF в «Просмотре».
- Выберите «Инструменты» → «Выбор текста».
- Протяните выделение по нужным словам и выберите «Правка» → «Копировать».
- Если необходимо захватить вертикальную часть текста или отдельную колонку, удерживайте Option во время выделения.
- Вставьте фрагмент в целевой документ и проверьте порядок строк.
Важно различать выбор текста и прямоугольное выделение. Прямоугольная область в «Просмотре» копируется как графика, а не как набор символов. По этой причине при задаче перенести именно слова убедитесь, что активен «Выбор текста». Это в особенности актуально для макетов с диаграммами и подписями, где курсор легко переключить на работу с изображением.
Если страница состоит из изображения
Для PDF без распознанного текста выберите экспорт и функцию Embed Text. Она появляется, когда приложение определяет, что текст на странице ещё не распознан. После экспорта откройте полученный PDF и повторите проверку выделения. Встроенный слой позволяет копировать слова и искать по документу в PDF-просмотрщиках, вместе с этим изображение страницы остаётся визуальной основой.
Плюсы
- Встроено в macOS и не требует установки отдельного приложения для обычного копирования.
- Option помогает выделять вертикальные фрагменты и отдельные колонки.
- Функция Embed Text создаёт копируемый текстовый слой для PDF, где страницы были изображениями.
Минусы
- Метод доступен лишь на Mac.
- Прямоугольное выделение копирует область как изображение, по этой причине необходимо следить за активным инструментом.
- После распознавания скана точность текста нужно проверять ручным способом, в особенности в таблицах и мелких подписях.
Кому подойдёт
«Просмотр» оптимален для владельцев Mac, которым необходимо быстро извлечь текст без установки отдельного PDF-редактора. Он закрывает как обычное копирование, так и базовый сценарий со сканом через встраивание распознанного текста.
Как выбрать метод без лишних действий
Удобнее выбирать не по привычке к конкретной программе, а по характеру файла и конечной задаче. Для одной цитаты из цифрового PDF конвертация всего документа избыточна. Для сорока страниц исследования ручное выделение абзацев, наоборот, отнимет больше времени, чем преобразование в Word. Для скана главный вопрос — где и как выполнить OCR, а для защищённого документа — какие права дал владелец.
Если необходим один абзац или несколько строк
Сперва попробуйте PDF Commander, Adobe Acrobat Reader, Chrome или «Просмотр» на Mac. Все эти варианты позволяют взять готовый текстовый слой напрямую. Выбирайте уже открытый на компьютере инструмент и обязательно сделайте короткую контрольную вставку. Если порядок слов ломается из-за колонок, переходите к преобразованию документа, а не пытайтесь ручным способом собирать предложение из отдельных блоков.
Если необходим практически весь документ
Для многостраничного текстового PDF удобнее Microsoft Word или экспорт в редактируемый формат из PDF-редактора. Полученная копия даёт поиск, навигацию и обычное выделение. Такой подход в особенности полезен при подготовке обзора, дайджеста или внутренней справки по длинному отчёту: можно сперва проверить структуру, затем работать с разделами как с обычным документом.
Если перед вами скан
Для локальной обработки применяйте OCR в PDF Commander, встроенное распознавание Chrome или Embed Text в «Просмотре» на Mac. Google Документы подходят для небольших файлов, которые разрешено загружать в облако. При сложных колонках, таблицах и смешении текста с графикой выбирайте инструмент с ручной разметкой областей, потому что именно порядок чтения чаще всего становится источником ошибок.
Если документ содержит чувствительные данные
Сперва учитывайте правила хранения и обработки информации в компании. Локальные методы не требуют загрузки документа в отдельный облачный редактор. Google Диск, напротив, предполагает загрузку файла в облако. Это не оценка качества сервиса, а различие архитектуры рабочего процесса, которое необходимо сопоставить с внутренними требованиями к данным и согласованными каналами передачи.
- Короткий текстовый фрагмент: прямое выделение в PDF Commander, Adobe Acrobat Reader, Chrome или «Просмотр».
- Длинный текстовый PDF: преобразование в Word или экспорт в редактируемый формат.
- Скан на Windows: OCR в PDF Commander либо распознавание во встроенном просмотрщике Chrome.
- Скан на Mac: Embed Text в «Просмотре», затем обычное выделение.
- Небольшой скан для совместной работы: Google Диск → Google Документы при допустимости облачной обработки.
- Запрет на копирование: получить разрешённую копию или исходный текст у владельца документа.
Что делать, если текст из PDF не копируется
Отказ копирования — это не одна проблема, а несколько различных ситуаций. В разборе причин, по которым текст из PDF не копируется, полезно разделять сканы, ограничения, повреждённый текстовый слой и ошибки преобразования. Ниже — практическая диагностика, которая помогает не менять программы наугад.
Симптом 1. Курсор не выделяет слова
Практически всегда это означает, что на странице нет доступного текстового слоя: перед вами скан, фотография страницы или графический объект. Увеличьте масштаб и попробуйте выделить одно слово. Если выделяется прямоугольник изображения либо ничего не происходит, переходите к OCR. Не тратьте время на сочетания клавиш — буфер обмена не может получить символы, которых в документе нет.
Симптом 2. Слова выделяются, но копирование запрещено
Проверьте разрешения PDF. В Adobe Acrobat Reader они отображаются в свойствах документа в разделе безопасности. Если владелец отключил копирование, рабочее решение — получить версию с подходящими разрешениями либо исходный текст. Для корпоративного процесса это тоже полезный сигнал: у команды должен быть согласованный метод обмена материалами, из которых нужно готовить цитаты, карточки, публикации или отчёты.
Симптом 3. После вставки появляются неправильные символы
Такое происходит, когда внутреннее представление текста не соответствует ожидаемым символам: мешают встроенные шрифты, нестандартная кодировка или некорректно сформированный текстовый слой. Не исправляйте десятки знаков ручным способом до проверки иного метода. Попробуйте преобразование в Word или OCR и сопоставьте итог. Добавочные причины разобраны в материале о том, почему при переносе текста из PDF появляются неверные символы.
Симптом 4. Абзацы перемешиваются
PDF хранит страницу как набор объектов, и визуальное соседство не всегда совпадает с логическим порядком чтения. Две колонки, боковые подписи, выноски и подписи к рисункам могут попадать в буфер обмена в другой последовательности. Для короткой цитаты выделяйте одну колонку. Для длинного документа применяйте преобразование в Word или OCR с разметкой колонок и проверяйте порядок по заголовкам.
Симптом 5. Таблица превращается в сплошной текст
Обычное копирование не гарантирует сохранение структуры таблицы. Сперва определите, что вам в самом деле необходимо: отдельная ячейка, несколько строк или вся таблица. Для пары значений безопаснее перенести данные ручным способом с двойной сверкой. Для большой таблицы необходим специализированный экспорт в табличный формат либо инструмент извлечения таблиц; потом проверьте количество строк, столбцов и положение итоговых значений.
Симптом 6. OCR пропускает буквы и цифры
Качество распознавания зависит от исходного изображения. Поверните страницу в нормальную ориентацию, убедитесь, что текст не слишком мелкий и контрастный, а затем задайте правильный язык. Для сложной страницы отделите текстовые области от иллюстраций. После распознавания проверяйте не только слова, но и структурные маркеры: номера пунктов, проценты, даты, десятичные значения, знаки валют и сокращения.
Как сохранить смысл и форматирование после копирования
Копирование решает только первую половину задачи. Вторая половина — правильно встроить извлечённый фрагмент в новый материал. Для бизнес-текста важно не тащить за собой случайные шрифты, межстрочные интервалы и скрытые переносы. Для цитаты важнее сохранить точную формулировку, для таблицы — структуру, для списка — иерархию пунктов, для текста из отчёта — границы абзацев и заголовков.
Сперва вставляйте без лишнего оформления
Когда формат назначения отличается от PDF, удобнее сперва вставить текст как обычный и только потом применить стили целевого документа. Это снижает количество непредсказуемых шрифтов и отступов. Исключение — случаи, где форматирование несёт смысл: к примеру, жирным выделены категории, курсивом — определения, а цветом — статусы. Тогда сперва сохраните исходный вид в промежуточном документе и лишь после сверки переносите в финальный макет.
Уберите искусственные переносы строк
В PDF строка порой заканчивается разрывом не потому, что завершился абзац, а потому, что закончилась визуальная строка. После вставки получается текст с переносом после каждых нескольких слов. Не объединяйте строки автоматически по всему документу без просмотра: реальный конец абзаца легко потерять. Обрабатывайте блоками и ориентируйтесь на смысл, пунктуацию, отступы и визуальные границы исходной страницы.
Проверьте переносы слов
Слово, разорванное дефисом на конце строки, после копирования может остаться в таком виде даже посреди нового абзаца. Исправлять необходимо только переносы, которые возникли из-за верстки. Настоящие дефисные написания сохраняйте. В особенности внимательно проверяйте наименования продуктов, фамилии, термины и адреса страниц в текстовом материале: автоматическая замена дефисов способна исказить собственные имена.
Отдельно обработайте списки
Нумерация и маркеры в PDF часто существуют как отдельные объекты. После вставки номер может отделиться от пункта, а вложенный список — потерять уровень. Сперва восстановите логическую иерархию, потом применяйте стандартные списки редактора. Это в особенности важно для требований, чек-листов, программ мероприятий и инструкций, где номер пункта применяется как ссылка в обсуждении.
Не доверяйте автоматически восстановленной таблице
Даже визуально аккуратная таблица после копирования может содержать незаметный сдвиг: значение из правого столбца окажется в соседней строке, а объединённая ячейка потеряется. Проверяйте таблицу по двум измерениям: структура и данные. Сперва посчитайте ожидаемые строки и столбцы, затем сверяйте крайние и итоговые значения, после чего делайте выборочную проверку середины.
Контроль качества: как проверить скопированный текст
Для публикаций, презентаций и клиентских материалов полезно разделять проверку на четыре уровня: полнота, точность символов, структура и соответствие контексту. Такая схема быстрее сплошного перечитывания, поскольку каждый проход ищет конкретный тип ошибки. Она в особенности полезна после OCR и преобразования многостраничного PDF.
1. Полнота
Сопоставьте начало и конец перенесённого блока с исходной страницей. Убедитесь, что не исчезла строка на границе колонок, подпись к диаграмме или последний пункт списка. Для нескольких страниц фиксируйте номера исходных страниц в рабочей заметке, чтобы можно было быстро вернуться к месту сверки. Если из отчёта берутся десятки цитат, отмечайте проверенные фрагменты по мере работы.
2. Точность символов
Выберите места, где ошибка наиболее критична: числа, проценты, даты, имена, наименования компаний, обозначения единиц, формулы и ссылки в тексте. OCR чаще требует проверки похожих знаков и мелких символов. Для значимых цифр применяйте двойную сверку: сопоставьте значение на PDF и в целевом документе отдельно, не опираясь на память.
3. Структура
Проверьте порядок абзацев, заголовков, колонок, пунктов и подпунктов. Если материал получен через Word или Google Документы, прокрутите несколько страниц и убедитесь, что блоки не поменялись местами. Для PDF с боковыми колонками полезно проверить переходы между страницами: именно там часто смешиваются основной текст, колонтитулы и подписи.
4. Контекст
Даже идеально скопированное предложение может потерять смысл вне соседнего абзаца. Перед публикацией цитаты прочитайте один абзац до и после неё. Проверьте, к какому периоду, рынку, группе респондентов или условию относится утверждение. Для исследования это защищает от переноса цифры без нужной оговорки, а для договора — от вырывания условия из связанного пункта.
Простой метод измерить качество OCR
Возьмите контрольный отрывок приблизительно на 200 знаков и ручным способом посчитайте ошибки: пропущенные, заменённые или лишние символы. Зафиксируйте итог перед обработкой всего файла. Если ошибок много именно в нужном типе данных — к примеру, в цифрах и сокращениях — смените метод распознавания или подготовьте изображение лучше. Такой пробный фрагмент даёт более полезную оценку, чем субъективное впечатление от одной красиво распознанной строки.
- Проверены первые и последние слова каждого перенесённого фрагмента.
- Все числа, даты, проценты и имена сверены с исходной страницей.
- Порядок колонок и абзацев соответствует визуальному порядку чтения.
- Переносы строк и слов не изменили смысл.
- Списки восстановлены как списки, а не как набор разрозненных номеров.
- Цитаты прочитаны в исходном контексте.
- Для OCR сделана отдельная выборочная проверка сложных символов.
Практические сценарии для маркетинга, PR, контента и бизнеса
Извлечение текста из PDF нечасто является самостоятельной целью. Обычно это промежуточный этап: после него данные попадают в презентацию, карточку, пресс-релиз, медиаплан, статью, коммерческое предложение или рабочую записку. По этой причине метод копирования стоит выбирать с учётом следующего шага. Чем точнее понятен конечный формат, тем меньше лишней ручной обработки.
Исследование рынка → тезисы для презентации
Если отчёт текстовый и состоит из десятков страниц, откройте его в Word или преобразуйте локально в редактируемый формат. Сперва отыщите нужные разделы по словам, затем переносите цитаты вместе с наименованием раздела и номером страницы в рабочую заметку. Диаграммы и таблицы не копируйте как обычный текст, если они несут структурные данные: для них необходим отдельный контроль.
В итоговой презентации отделяйте собственный вывод от дословного фрагмента исследования. При каждой значимой цифре сохраняйте в рабочем черновике контекст: период, аудиторию, географию и единицы измерения. Эти сведения не относятся к технике копирования, но именно они определяют, правильно ли использован извлечённый текст.
Медиакит → рабочая карточка площадки
Медиакиты часто сочетают обычный текст, таблицы и сложную верстку. Для контактных условий, форматов и описаний продуктов берите небольшие фрагменты с обязательной сверкой. Если документ текстовый, достаточно Reader или Chrome; если требуется разобрать много страниц, Word удобнее. Табличные параметры переносите по строкам и сразу нормализуйте единицы, не смешивая значения из различных блоков.
Пресс-релиз в PDF → цитата для новости
Для одной цитаты не нужно преобразовывать весь файл. Выделите предложение в PDF-просмотрщике, вставьте в простой текстовый редактор и сопоставьте с оригиналом. После этого перенесите в редакционный документ. Такая промежуточная вставка помогает заметить скрытые переносы строк и случайное форматирование до того, как фрагмент окажется в системе публикации.
Скан анкеты или заявления → структурированная заметка
Тут важнее OCR, чем внешний вид страницы. На Windows применяйте PDF Commander и задайте правильный язык; на Mac — встраивание текста в «Просмотре»; для разового публичного скана подойдёт Chrome. Сперва распознайте одну страницу и проверьте фамилии, даты и числовые поля. Лишь после успешной контрольной страницы переходите к остальному документу.
Партнёрская презентация → черновик совместного проекта
Презентации в PDF часто состоят из отдельных текстовых блоков. Простое Ctrl+A может собрать их в нелогичном порядке. Лучше копировать по слайдам или открыть PDF в Word и проверить, как восстановилась структура. Для каждого перенесённого тезиса сохраняйте номер страницы в черновике, чтобы во время согласования быстро вернуться к оригиналу и исключить смысловое искажение.
Брендбук → список требований к макету
Из брендбука обычно необходимы короткие правила: безопасные поля, варианты применения знака, ограничения по композиции и типографике. Копируйте каждый смысловой блок отдельно и не отделяйте формулировку от иллюстрации, если правило поясняется визуальным примером. Текстовый фрагмент должен оставаться связанным с соответствующей страницей брендбука в рабочей заметке.
Коммерческое предложение → внутреннее сравнение
Если предложения нескольких поставщиков приходят в PDF, не сводите всё к одному длинному скопированному тексту. Сперва определите одинаковые поля сравнения, затем извлекайте только соответствующие значения и пояснения. Для каждого файла проверяйте, что данные относятся к одной и той же версии предложения и периоду. Такой порядок уменьшает риск сопоставить различные сущности только потому, что они визуально стояли рядом на странице.
Архивные материалы → база знаний
Для архива важна повторяемость процесса. Сперва разделите документы на обычные PDF и сканы. Для первой группы применяйте конвертацию и поиск, для второй — пакетное OCR с сохранением распознанного слоя. В базе знаний сохраняйте не только извлечённый текст, но и ссылку на внутреннее место хранения исходного PDF и номер страницы, чтобы любое утверждение можно было быстро перепроверить.
Безопасность и работа с ограничениями документа
PDF может содержать пароль на открытие и отдельные ограничения на печать, редактирование или копирование. Это различные механизмы. Если документ открыт, но копирование запрещено, сперва проверяется разрешение владельца. Для деловой работы правильный процесс строится вокруг согласованных прав доступа: отправитель предоставляет версию, из которой разрешено извлекать данные, либо отдельно передаёт нужный текст.
Не следует применять сторонние сервисы для снятия ограничений с чужих или служебных документов. Кроме вопроса прав на содержимое, появляется риск неконтролируемой передачи файла. Если материал конфиденциальный, применяйте только те локальные или корпоративные инструменты, которые разрешены внутренними правилами. Для публичных материалов выбор шире, но контроль итога остаётся обязательным.
Когда локальный метод предпочтительнее облачного
Локальная обработка полезна, когда документ не должен покидать рабочее устройство или корпоративную среду. PDF Commander, Adobe Acrobat Reader, Word, Chrome с локальным распознаванием сканированных PDF и «Просмотр» работают на устройстве в описанных сценариях. Google Диск требует загрузки файла, по этой причине его применение должно соответствовать принятому в компании порядку работы с данными.
Когда облачный метод оправдан
Google Документы удобны, когда файл разрешено хранить в облаке, необходим совместный доступ к итогу и размер подходит под требования OCR. Публичное исследование или собственный скан без чувствительных данных можно быстро превратить в совместно редактируемый документ. После распознавания всё равно проверяйте исходник, потому что удобство совместной работы не повышает автоматически точность сложных таблиц и колонок.
Типичные ошибки и как их избежать
- Сразу копировать весь документ. Сперва протестируйте один контрольный абзац. Это показывает качество текстового слоя и экономит время при неудачном методе.
- Считать любой PDF текстовым. Скан выглядит как документ, но без OCR буквы остаются частью изображения.
- Игнорировать ограничения безопасности. Если владелец запретил копирование, получите разрешённую версию вместо попытки снять запрет.
- Считать успешное выделение доказательством точности. Порядок слов, в особенности в колонках, может отличаться от визуального.
- Не сверять цифры после OCR. Числа, даты и проценты проверяются отдельно, потому что одна ошибка меняет смысл.
- Применять облако для любого файла. Сперва сопоставьте метод с внутренними правилами обработки данных.
- Копировать таблицу как абзац. Сперва определите структуру и проверяйте строки и столбцы, а не только визуальное сходство.
- Удалять все дефисы после вставки. Часть дефисов является частью слова; исправляйте только разрывы, возникшие на границе строк.
- Оставлять случайные стили PDF. Для редакционного документа чаще удобнее чистый текст с последующим оформлением в целевом шаблоне.
- Терять связь с исходной страницей. При работе с исследованием, договорным приложением или регламентом фиксируйте страницу для быстрой перепроверки.
Пошаговый рабочий алгоритм для любого PDF
Ниже — универсальная последовательность, которая сводит тему к понятному процессу. Она не привязана к одной программе и подходит для большинства рабочих документов: сперва классификация, затем минимальная обработка, потом контроль. Такой порядок полезнее хаотичного переключения между сервисами, потому что каждая следующая операция решает уже установленную проблему.
- Шаг 1. Откройте документ и попробуйте выделить одно слово. Если слово выделяется, переходите к прямому копированию. Если нет — готовьте OCR.
- Шаг 2. Проверьте разрешения. При запрете копирования получите подходящую версию у владельца документа.
- Шаг 3. Выберите масштаб задачи. Один абзац копируйте напрямую, много страниц удобнее преобразовать в редактируемый документ.
- Шаг 4. Для скана выберите OCR по требованиям к данным. Локальный инструмент — для локальной обработки; Google Документы — для разрешённого облачного сценария.
- Шаг 5. Сделайте контрольную вставку. Сопоставьте 150–300 знаков, обязательно включая число и знак препинания.
- Шаг 6. Обработайте основной объём. Копируйте по логическим блокам или работайте в преобразованной копии.
- Шаг 7. Восстановите структуру. Проверьте абзацы, списки, таблицы, заголовки и границы колонок.
- Шаг 8. Проведите фактическую сверку. Отдельно проверьте имена, даты, проценты, числа и важные формулировки.
- Шаг 9. Очистите оформление. Уберите случайные шрифты и переносы, примените стили целевого документа.
- Шаг 10. Сохраните привязку к оригиналу. Для значимых фрагментов оставьте в рабочем черновике номер страницы или иной внутренний ориентир.
Как ускорить работу с длинными PDF без потери контроля
Длинный документ не нужно читать и копировать линейно. Сперва отыщите нужные разделы поиском. В PDF с готовым текстовым слоем это работает сразу; в скане — после OCR. Отдельный материал о том, как найти слово или фразу в PDF, полезен именно на данном этапе: поиск сокращает объём ручного просмотра и помогает построить список страниц для извлечения.
Работайте по карте разделов
Перед копированием посмотрите оглавление, закладки и заголовки. Составьте короткий перечень нужных разделов и страниц. Для исследования это могут быть методика, итоги и выводы; для медиакита — аудитория, форматы и правила размещения; для внутреннего регламента — определения, порядок действий и контроль. Когда область поиска ограничена заблаговременно, риск пропустить важный кусок снижается.
Разделяйте извлечение и редактирование
На первом проходе переносите текст максимально близко к оригиналу. На втором — сокращайте, перестраивайте и оформляйте. Если смешивать эти задачи, легко потерять границу между исходной формулировкой и своей редакцией. Для командной работы в особенности полезно хранить исходные фрагменты в отдельной заметке и уже из неё собирать готовый материал.
Сохраняйте контрольные метки
Для каждого значимого фрагмента фиксируйте страницу и короткий контекст. Это позволяет быстро отвечать на вопросы редактора, клиента или коллеги без повторного поиска по всему PDF. При большом количестве фрагментов добавьте статус «сверено» после ручной проверки. Такой простой учёт превращает копирование из технической операции в управляемый редакционный процесс.
Когда лучше не копировать, а преобразовать PDF в текстовый файл
Если необходимо получить чистый текст без сложной верстки, отдельный текстовый файл удобнее сотен операций копирования. Это актуально для расшифровки длинной инструкции, подготовки корпуса документов для внутреннего поиска или переноса материала в систему, где форматирование всё равно будет построено заново. Для такой задачи есть отдельный разбор преобразования PDF в TXT.
Но TXT не сохраняет структуру страницы: таблицы, визуальные колонки, размеры шрифтов и расположение объектов превращаются в линейный поток. По этой причине формат полезен только тогда, когда главным является содержание. Перед экспортом определите, что вы готовы потерять, а после — проверьте границы абзацев и служебные элементы, которые могли попасть в текст вместе с основным содержимым.
Чек-лист перед применением извлечённого текста
- Определён тип PDF: текстовый документ, скан или смешанный файл.
- Проверено, разрешено ли копирование содержимого.
- Для скана выбран подходящий OCR и установлен правильный язык.
- Контрольный фрагмент сверён с оригиналом до массовой обработки.
- Для длинного документа выбран метод преобразования вместо ручного копирования по страницам.
- Числа, даты, проценты, имена и наименования проверены отдельно.
- Колонки, списки и таблицы восстановлены в правильном порядке.
- Удалены только искусственные переносы строк и слов; смысловое оформление не потеряно.
- Для облачной обработки соблюдены внутренние правила работы с данными.
- У значимых цитат и фактов сохранена привязка к исходной странице.
- Перед публикацией прочитан исходный контекст вокруг цитаты.
- Финальный текст оформлен стилями целевого документа, а не случайными стилями из PDF.
Частые вопросы
Почему Ctrl+C ничего не делает в PDF?
Сперва проверьте, существует ли на странице текстовый слой. Если документ является сканом, необходим OCR. Если слова выделяются, но копирование недоступно, проверьте ограничения безопасности документа и получите у владельца версию с разрешённым копированием.
Как скопировать текст со сканированного PDF?
Выполните OCR: в PDF Commander применяйте «Распознавание» → «Распознать текст», в настольном Chrome дождитесь извлечения текста, на Mac экспортируйте PDF через Embed Text в «Просмотре». После этого выделите контрольный фрагмент и сверяйте его с изображением страницы.
Что выбрать для большого PDF на десятки страниц?
Для текстового документа удобнее создать редактируемую копию в Microsoft Word или экспортировать текст в подходящий формат. Это даёт поиск и навигацию. Для большого скана применяйте OCR по диапазону страниц и сперва проверьте качество на одной контрольной странице.
Почему после копирования ломаются абзацы и колонки?
Внутренний порядок объектов PDF не всегда совпадает с визуальным. Копируйте одну колонку за раз или преобразуйте документ в редактируемую копию. После переноса восстановите абзацы, списки и порядок чтения по исходной странице.
Можно ли копировать из защищённого PDF?
Копирование зависит от разрешений, установленных владельцем. Если операция запрещена, получите разрешённую копию или исходный текст. В деловом процессе это безопаснее и корректнее, чем пытаться снимать ограничения сторонними средствами.
Как проверить точность распознавания?
Сверьте контрольный фрагмент приблизительно на 200 знаков, включая числа и знаки препинания. Затем отдельно проверяйте имена, даты, проценты и другие чувствительные к ошибкам данные. Для длинного документа сохраняйте номера страниц у значимых фрагментов.
Итог: начинайте с диагностики, а не с конвертации
Для обычного текстового PDF чаще всего достаточно прямого выделения в PDF Commander, Adobe Acrobat Reader, Chrome или «Просмотре» на Mac. Для длинного документа удобнее Word или экспорт в редактируемый формат. Для скана необходим OCR: его можно выполнить локально в PDF Commander, средствами Chrome или «Просмотра», а небольшие разрешённые к облачной обработке файлы — через Google Документы.
Главное правило одинаково для всех шести методов: сперва проверьте один небольшой фрагмент, затем обрабатывайте основной объём и в конце сверяйте критичные данные с исходной страницей. Такой процесс даёт предсказуемый итог и уменьшает риск перенести в публикацию, презентацию или рабочий документ незаметную ошибку из текстового слоя или распознавания.