
Нейросетевой аудиопроцессинг перестал быть отдельной лабораторной технологией: сегодня он встроен в браузерные сервисы, редакторы, приложения для встреч и мобильные студии. Вместе с этим формулировка «улучшить качество» скрывает несколько различных задач. Одному проекту требуется убрать постоянный гул, другому — приглушить комнатное эхо, третьему — выровнять голос по громкости, а музыкальному материалу — довести общий баланс перед публикацией. По этой причине полезнее выбирать не по громкому обещанию «сделать студийный звук», а по типу дефекта, контролю над обработкой и методу проверки итога. На Xeon Live есть отдельный разбор нейросетей для очистки речи, видео и музыки; тут мы расширяем тему в формате рабочего рейтинга для контент-команд, маркетинга, PR, подкастов и корпоративного производства.
В рейтинге первым стоит АудиоМАСТЕР — это требуемый для материала локальный продукт из заданного списка. Он не является нейросетью и не должен восприниматься как ИИ-сервис. Его роль — понятная контрольная точка: обычный Windows-редактор показывает, какие проблемы решаются локальными инструментами эквализации, регулировки громкости, частотной фильтрации и монтажа без передачи исходника в облако. После него идут именно ИИ-инструменты, каждый со своей специализацией.
Что именно считается улучшением качества звука
В бытовом описании слово «качество» объединяет совершенно различные параметры. Для речи важнее разборчивость согласных, устойчивый уровень и отсутствие навязчивого фона. Для интервью и вебинара добавляется задача уменьшить реверберацию помещения. Для видеоролика с музыкой требуется не уничтожить фон вместе с шумом. Для песни после очистки важны тембр, динамика и пространство. Базовые принципы ручной обработки — шумоподавление, эквализация, компрессия, эффекты и экспорт — подробно разобраны в материале про основы обработки аудио на компьютере. Нейросеть не отменяет эти операции: она автоматизирует отдельные этапы или строит очищенную версию сигнала на основе обученной модели.
- Фоновый шум. Шум вентилятора, улицы, кондиционера, электрический гул и шипение маскируют речь. Тут необходимы модели отделения полезного голоса от постоянного и меняющегося фона.
- Комнатное эхо. Отражения от стен делают речь удалённой и смазанной. Для такой записи важна отдельная обработка DeReverb или модель, которая одновременно подавляет шум и реверберацию.
- Неравномерная громкость. Несколько спикеров, удалённый микрофон и смена дистанции дают скачки уровня. С этим работают автоматический левелер, нормализация, компрессия и ручная автоматика.
- Тембральная мутность. Избыток низкой середины, резкие высокие частоты и провал присутствия ухудшают читаемость. Тут уместны эквализация, AutoEQ и частотные фильтры.
- Монтажные дефекты речи. Длинные паузы, слова-паразиты, вдохи, щелчки рта и повторы относятся не к шумоподавлению, а к редактуре записи. Cleanvoice и Descript закрывают часть этой работы автоматически.
- Финальный музыкальный баланс. Мастеринг выравнивает ощущение громкости, спектральный баланс и динамику готового микса. Это другая задача, чем восстановление плохо записанного голоса.
Как мы строим рейтинг и что проверять до обработки
Универсального победителя тут нет: сервис, который радикально спасает диктофонную речь, не обязан быть удобным для созвонов в реальном времени или музыкального мастеринга. По этой причине позиции сопоставляются по одной матрице. Важны цель обработки, платформа, степень ручного контроля, работа с эхом, устойчивость тембра, возможность слышать исходник рядом с обработанной версией, пригодность для длинных материалов и место в редакционном процессе.
- Сперва диагноз. Определите главный дефект: шум, эхо, скачки уровня, глухой тембр, паузы, клиппинг или ошибки монтажа. Одновременное включение всех улучшателей без диагноза увеличивает риск артефактов.
- Сохраните исходник. Обработанная копия не заменяет оригинал. Чистый исходный файл необходим для повторного прохода другой моделью, ручной реставрации и спорных эпизодов.
- Применяйте короткий контрольный фрагмент. Участок на 20–60 секунд с речью, тишиной, сложным шумом и характерными согласными быстро показывает сильные и слабые стороны алгоритма.
- Сопоставляйте на одинаковой громкости. Более громкий вариант субъективно воспринимается убедительнее. Перед оценкой выровняйте уровень исходника и итога.
- Проверяйте на двух системах. Наушники хорошо выявляют цифровые призвуки и «пульсацию» шумоподавления, обычные динамики показывают разборчивость в реальном сценарии потребления.
- Смотрите на рабочий процесс. Для ежедневных созвонов важнее реальное время, для подкаста — пакетная обработка и монтаж, для конфиденциальной записи — локальная схема без облачной передачи.
Почему сильнее не означает лучше
Максимальная интенсивность шумоподавления часто забирает тихие окончания слов, дыхание и естественные отражения помещения. Практический ориентир — минимальная степень обработки, при которой фон перестаёт мешать содержанию.
Что делать с клиппингом
Цифровое клиппирование означает потерю формы сигнала на перегруженных пиках. ИИ способен построить правдоподобную замену части повреждённого материала, но это не восстановление исходной волны. Для важной записи приоритетом остаётся правильный уровень на входе.
Почему обработка музыки отличается от речи
Модель для изоляции голоса обычно оптимизирует разборчивость речевого центра. В музыкальном миксе такая логика разрушает пространство, фоновые партии и естественные хвосты реверберации. Для песни необходим отдельный мастеринг или аудиоредактор.
Что считать артефактом
К типичным артефактам относятся металлический призвук, нестабильные согласные, «водянистый» фон, внезапное исчезновение тихих слогов, скачки тембра между фразами и неестественно сухое окончание слов.
Как работать с конфиденциальными материалами
Записи переговоров, исследований и закрытых презентаций требуют отдельной проверки политики хранения данных. Локальный редактор сохраняет полный контроль над файлом; облачный сервис следует применять лишь в соответствии с правилами организации и договорными ограничениями.
Как понять, что итог готов
Готовая запись остаётся разборчивой на обычной громкости, не утомляет резкими верхами, не проваливает окончания слов и не меняет тембр говорящего от фразы к фразе. После технической проверки необходим быстрый прослушивающий контроль человеком.
Windows и macOS
В настольной группе собраны три принципиально различных подхода: локальный редактор без ИИ, утилита для обработки живого потока и полноценный контент-редактор с нейросетевым эффектом. Такой порядок полезен для бизнеса: он показывает, когда нейросеть в самом деле экономит время, а когда надёжнее оставить ручной инструмент и контролировать каждое изменение.
1. АудиоМАСТЕР — локальная контрольная точка без нейросетей
АудиоМАСТЕР — Windows-редактор для записи, монтажа, частотной коррекции, изменения громкости, эффектов и конвертации аудио. Важно отделить его от остальных участников: программа не выполняет нейросетевую реконструкцию речи. Она полезна как локальная база для материалов, где исходник нельзя отправлять в облако, а дефект решается обычной обработкой. Для речи тут доступны эквалайзер с пресетами, в том числе вариант подавления шума, регулировка уровня, работа с выделенным фрагментом и простое смешение дорожек.
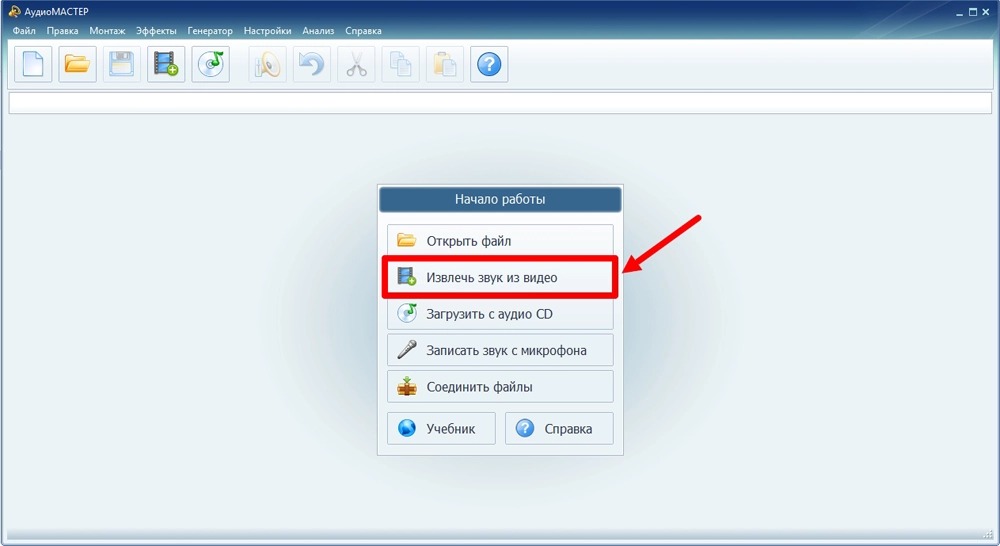
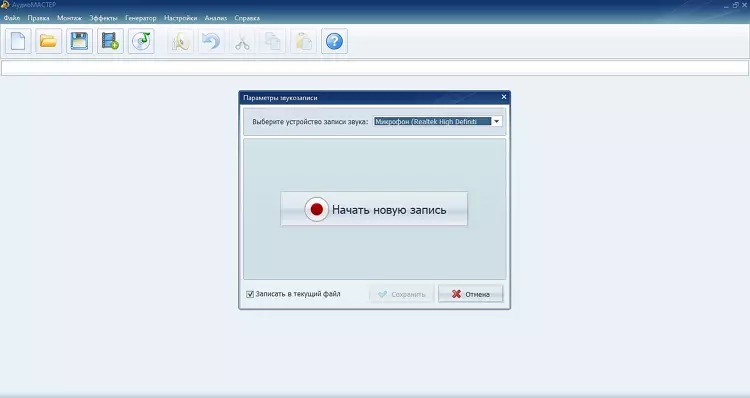
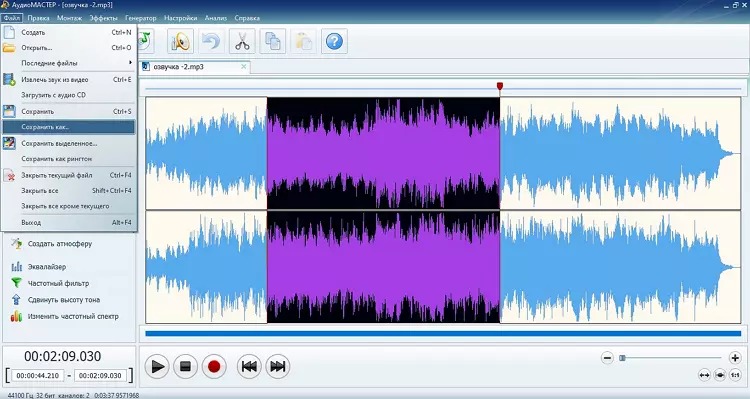
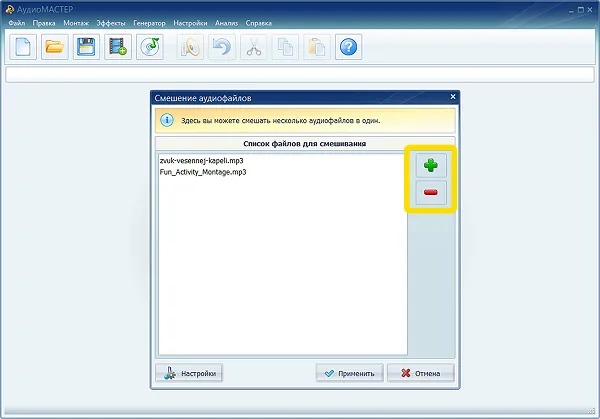
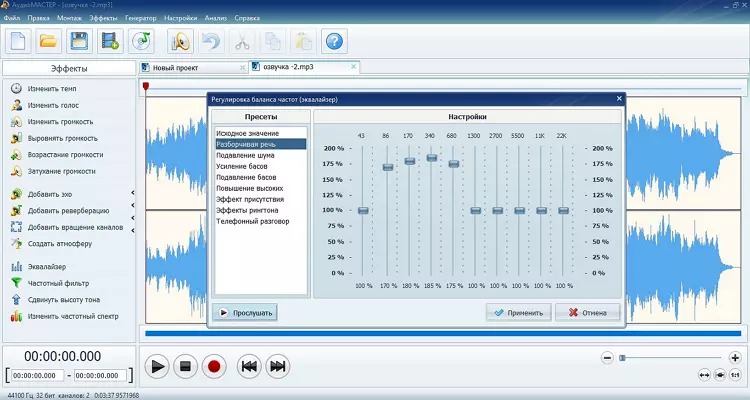
Рабочая схема проста: сперва создаётся копия исходника, затем шумная пауза и фрагмент с речью прослушиваются отдельно, после чего применяется эквализация и проверяется разборчивость. Избыточное усиление высоких частот быстро делает согласные резкими, а сильное подавление низов истончает голос, по этой причине пресет служит отправной точкой, а не финальным решением. После очистки удобно выровнять громкость и выполнить монтаж до экспорта.
Для маркетинговой команды такой подход подходит при обработке локальной озвучки презентации, короткого интервью, голосового комментария к видеоролику и коллекции диктофонных записей. Самое сильное отличие от облачных ИИ-сервисов — прозрачность процесса: оператор видит волну, выделяет участок и понимает, какая операция изменила звук. Самое заметное ограничение — отсутствие семантического отделения голоса от сложного меняющегося фона; в записи с улицей, музыкой и сильной реверберацией нейросетевые модели обычно закрывают задачу быстрее.
Плюсы
- Локальная работа с файлами в настольном Windows-редакторе.
- Понятная волновая форма, выделение фрагмента и ручной контроль обработки.
- Эквалайзер, регулировка громкости, запись, смешение файлов и эффекты собраны в одном приложении.
- Подходит как контрольная версия перед сравнением с нейросетевой очисткой.
Минусы
- Не является нейросетью и не реконструирует речь по модели.
- Основная платформа — Windows.
- Сложный непостоянный фон и сильное комнатное эхо требуют больше ручной работы.
- Нет специализированного режима для шумоподавления звонков в реальном времени.
Кому подойдёт
Редакторам, контент-менеджерам и авторам, которым необходима локальная обработка простых дефектов записи и полный контроль над исходником. Для закрытых материалов это удобная первая ступень: ручная обработка остаётся внутри рабочего компьютера, а облачный сервис подключается только к тем записям, для которых такой метод допустим.
2. Krisp — для созвонов и живой речи
Krisp решает другую задачу: шумоподавление работает в аудиотракте приложений для связи. Клиент создаёт виртуальные Krisp Microphone и Krisp Speaker, после чего пользователь выбирает их в настройках конференции. В приложении доступны отдельные переключатели для собственного и чужого шума. Для команды, которая ежедневно проводит интервью, продажи, исследования и внутренние встречи, ценность состоит в том, что обработка происходит до записи созвона, а не после него. Подробно о базовой подготовке микрофона и фоновых помехах можно прочитать в материале про шумоподавление микрофона.
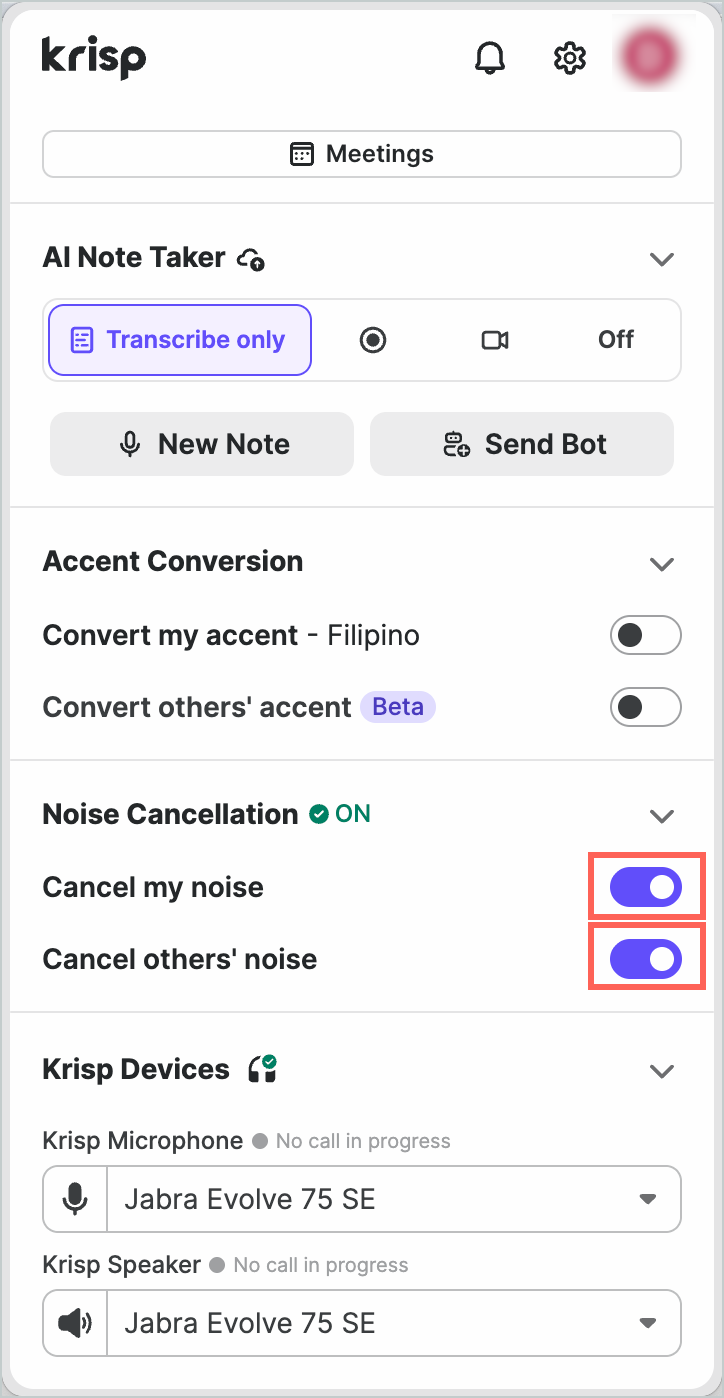
Krisp не заменяет монтажную программу. Тут нет цели собирать выпуск, резать дорожки по сценарию или выполнять музыкальный мастеринг. Зато это один из самых прямых вариантов для живой коммуникации: сотрудник настраивает физический микрофон и динамики внутри Krisp, а в рабочем приложении выбирает виртуальные устройства. Такая архитектура в особенности уместна при звонках из коворкинга, домашнего кабинета и открытого офиса.
Контроль качества проходит не по красивой волне, а по реальному разговору. Перед важной встречей полезна короткая запись с включённой и выключенной обработкой: в ней должны быть обычная речь, пауза и типичный фон помещения. Нормальный итог убирает отвлекающий шум, но сохраняет окончания слов и не превращает голос в узкополосный «телефонный» сигнал.
Плюсы
- Работа с живым аудиопотоком, а не только с готовым файлом.
- Виртуальные микрофон и динамик упрощают интеграцию с приложениями для связи.
- Раздельное управление подавлением собственного и чужого шума.
- Хорошо соответствует задачам встреч, интервью и удалённых коммуникаций.
Минусы
- Не является полноценным многодорожечным аудиоредактором.
- Не предназначен для музыкального мастеринга и творческой реставрации треков.
- Качество живой обработки необходимо проверять с конкретным микрофоном и типичным фоном рабочего места.
Кому подойдёт
Отделам продаж, поддержки, PR, исследовательским командам, ведущим вебинаров и всем, кто получает исходную запись прямо из онлайн-встречи. Тут важнее предотвратить загрязнение дорожки во время разговора, чем долго чистить её после события.
3. Descript Studio Sound — очистка внутри текстового редактора контента
Descript объединяет расшифровку, текстовый монтаж аудио и видео и эффект Studio Sound. Сам Studio Sound относится к записанной речи: он уменьшает фоновые шумы, эхо и другие отвлекающие звуки. Эффект применяется к файлу, а интенсивность регулируется отдельным ползунком. Это важный плюс для длинных интервью и подкастов: очистка живёт внутри того же проекта, где редактор сокращает фразы, удаляет повторы и собирает итоговую версию.
Studio Sound требует интернет-соединения. Документация Descript отдельно предупреждает о сложных исходниках: при очень громком фоне модель теряет способность надёжно отделять речь и способна чрезмерно подавить голос. Практическое решение — снижать интенсивность эффекта, а проблемный эпизод обрабатывать отдельно. Так сохраняется естественная окраска голоса и уменьшается риск резкого изменения тембра на границе фраз.
Для маркетинга Descript удобен в производстве интервью, обучающих видеороликов, видеоподкастов и customer story: один проект содержит медиа, текст и обработку. Это сокращает число промежуточных экспортов. Вместе с этим конфиденциальный материал требует согласованной облачной политики, а музыкальная программа с большим числом дорожек остаётся отдельным классом инструмента.
Плюсы
- Studio Sound встроен в редактор, где аудио и видео монтируются через текстовую расшифровку.
- Снижение шума и эха ориентировано на записанную речь.
- Интенсивность обработки регулируется, по этой причине естественность голоса не привязана к одному жёсткому режиму.
- Подходит для длинных разговорных форматов с последующим монтажом.
Минусы
- Для Studio Sound требуется интернет-соединение.
- Сильный фон способен привести к чрезмерному подавлению полезной речи.
- Эффект применяется на уровне файла, по этой причине сложные эпизоды порой удобнее выделять в отдельный файл или композицию.
Кому подойдёт
Подкаст-командам, видеоредакторам и маркетологам, которые уже работают с расшифровкой и хотят получать чистую речь без отдельного этапа в ином приложении. В особенности уместен формат с интервью, где после очистки сразу начинается текстовая редактура содержания.
Онлайн-сервисы
Браузерная группа удобна для готовых файлов: пользователь загружает запись, модель выполняет обработку и возвращает итог. Разница между сервисами заметна в специализации. Adobe делает акцент на речи и реконструкции голоса, Auphonic — на автоматической постобработке и уровнях, ElevenLabs — на изоляции голоса, Cleanvoice — на чистке и редактуре подкастов, LALAL.AI — на отделении голоса от фона, Riverside — на улучшении дорожек внутри собственного редактора.
4. Adobe Podcast Enhance Speech v2 — сильная очистка разговорной речи
Adobe Podcast Enhance Speech v2 — специализированный фильтр для записанной речи. Текущая версия обрабатывает шумные улицы, заметное эхо и удалённый голос; в расширенном режиме доступны отдельные регуляторы речи, музыки и окружения. Сервис принимает не только аудио, но и видеофайлы, по этой причине подходит для голосовой дорожки видеоролика без предварительного извлечения звука. При базовых дефектах полезно сверить обработку с приёмами из инструкции по удалению шума из аудио: нейросеть и классический фильтр решают похожую проблему различными методами.
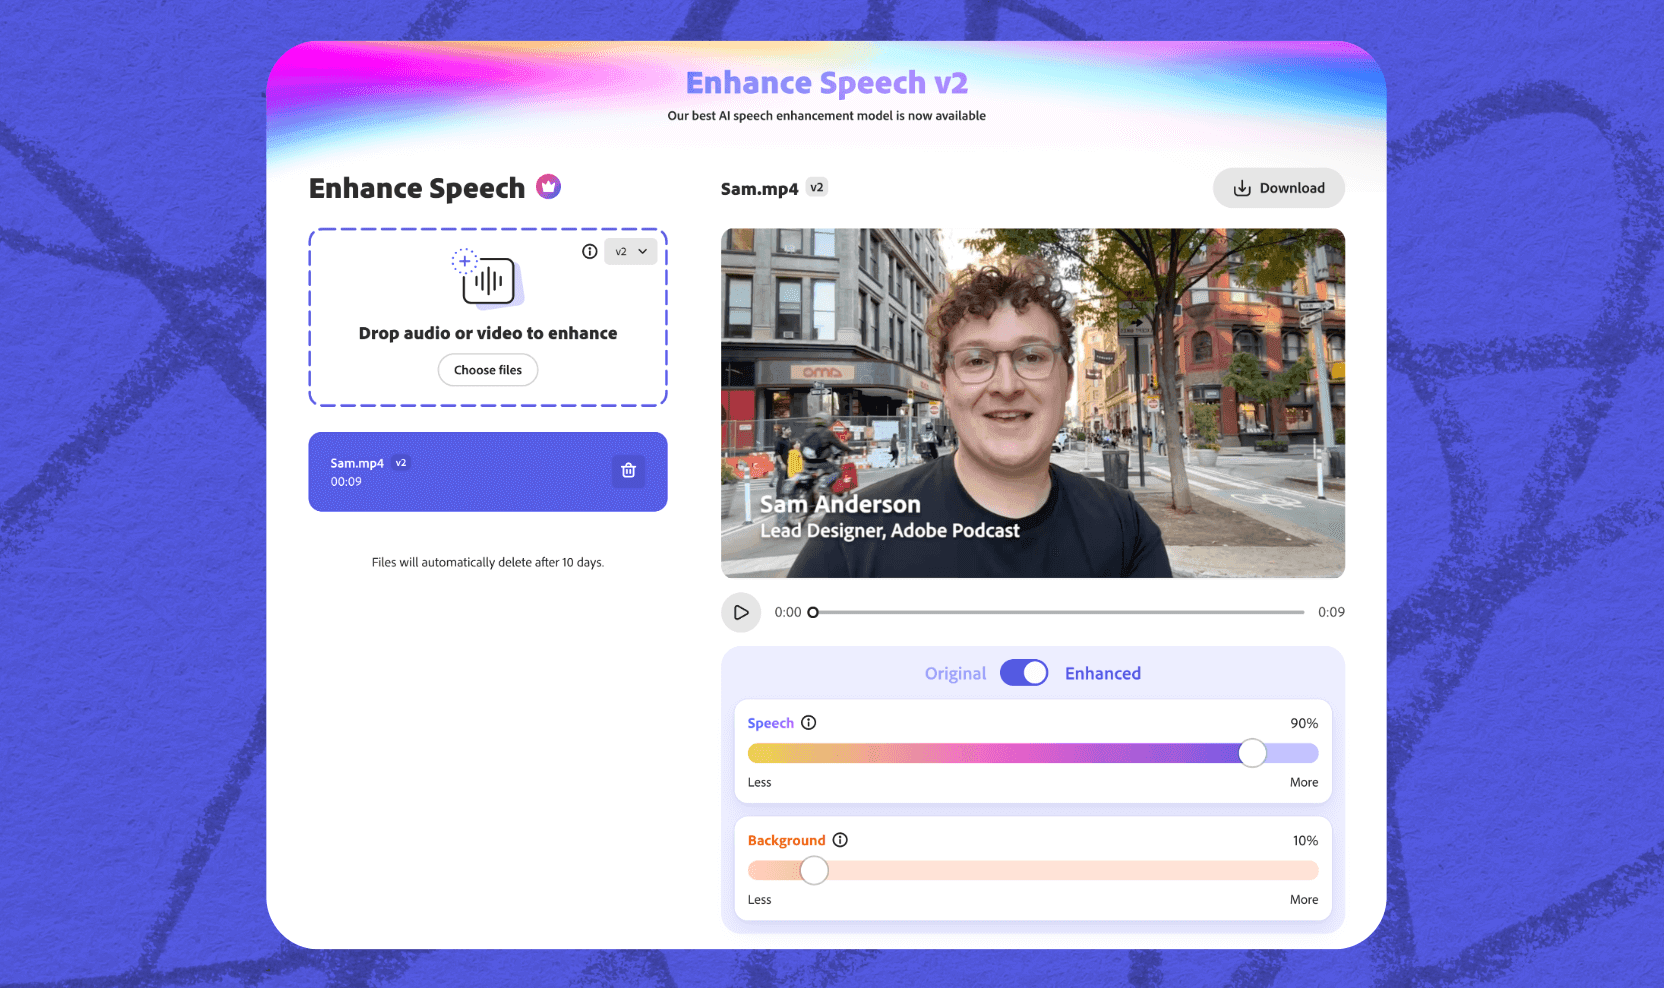
Главная практическая сила Enhance Speech — агрессивное приближение плохо записанной речи к чистому голосовому треку. Сильная сторона одновременно задаёт ограничение: модель оптимизирована под голос, а не под сохранение сложной музыкальной сцены. В видеоролике, где музыка и атмосферный фон несут смысл, итог оценивается не только по чистоте речи, но и по тому, насколько естественно сохранилось окружение.
Для корпоративного видео хорошая схема состоит из двух экспортов контрольного фрагмента: более мягкого и более сильного. Редактор сопоставляет согласные, дыхание, паузы и фон на одинаковой громкости. Отдельно проверяются имена, числа и тихие окончания слов — именно они быстрее всего выдают чрезмерную реконструкцию.
Плюсы
- Специализация на восстановлении и очистке разговорной речи.
- Работа с шумом, эхом и удалённым голосом в одном процессе.
- Поддержка видеофайлов упрощает обработку реплик из видеороликов.
- Регулировка составляющих помогает сохранить более естественный баланс голоса и окружения.
Минусы
- Обработка выполняется в облачном сервисе.
- Инструмент ориентирован в первую очередь на речь, а не на полноценный музыкальный мастеринг.
- Сильная реконструкция требует внимательной проверки тембра, согласных и тихих фраз.
Кому подойдёт
Авторам интервью, обучающих видеороликов, вебинаров, комментариев к презентациям и корпоративных видео, где ценность создаёт понятная речь. В особенности полезен материалам с хорошим содержанием и неудовлетворительной акустикой помещения.
5. Auphonic — автоматическая постобработка подкастов и длинных программ
Auphonic сочетает адаптивное выравнивание уровня, нормализацию громкости, фильтрацию, снижение шума и реверберации, а также автоматические операции с паузами и лишними речевыми фрагментами. Это не один «улучшатель», а производственный конвейер: исходник проходит несколько согласованных алгоритмов и приходит к стабильному уровню для дальнейшей публикации.
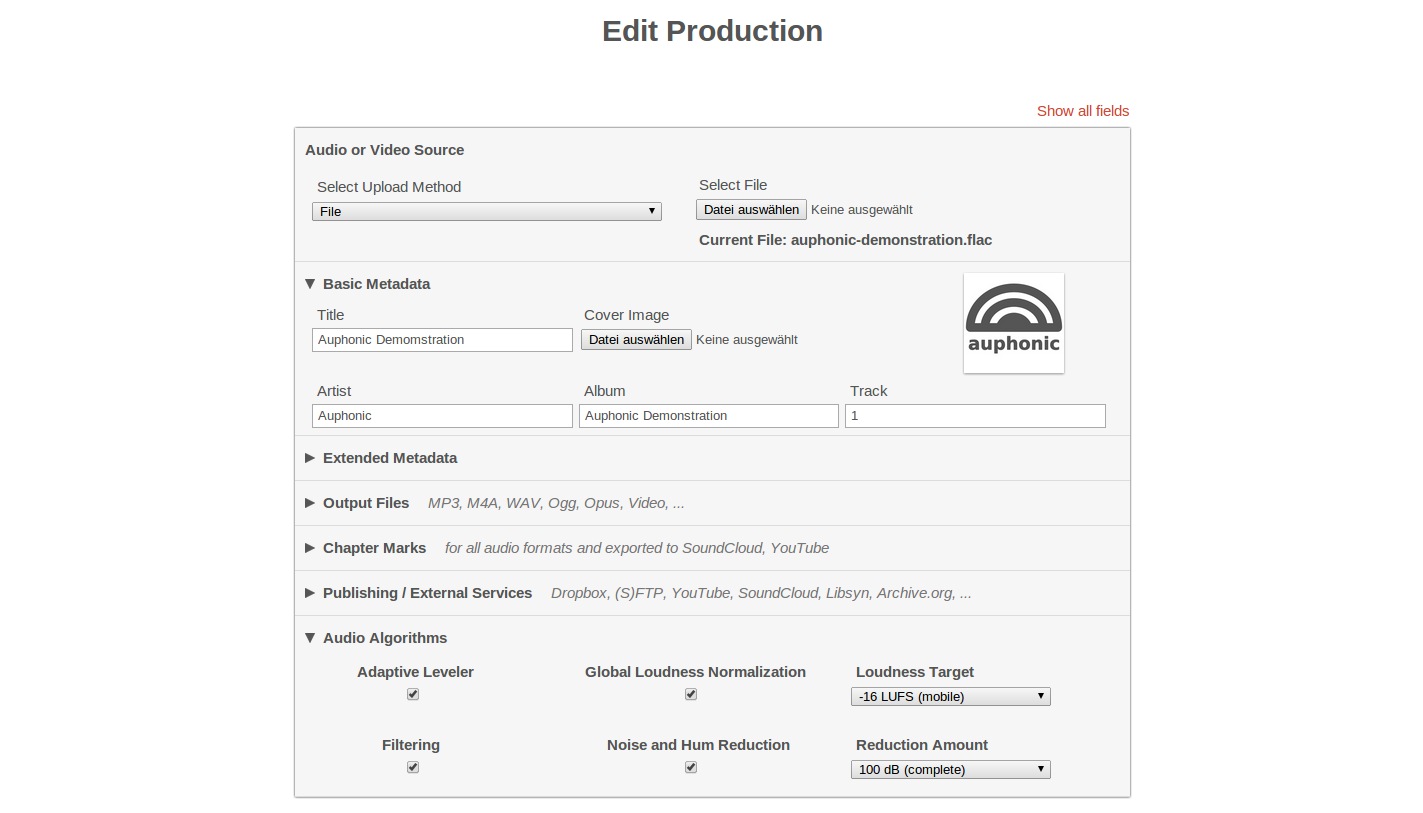
Для подкастов и серийных проектов это полезнее, чем ручная обработка каждого выпуска с нуля. Один набор правил поддерживает похожий характер громкости между эпизодами и спикерами. Вместе с этим автоматический левелер не отменяет монтаж: ошибочную фразу, неправильный дубль или содержательную паузу алгоритм не понимает как редактор. После прохода всё равно необходим контроль сюжета и прослушивание переходов.
Аuphonic в особенности логичен после монтажа и перед финальным экспортом. На данном этапе уже определена структура, а сервис занимается уровнем и технической чистотой. Для понимания разницы между левелингом и динамической обработкой полезен материал о компрессии аудио: автоматическое выравнивание и компрессор связаны с динамикой, но выполняют различные функции.
Плюсы
- Несколько этапов технической постобработки объединены в одном рабочем процессе.
- Адаптивный левелер и нормализация полезны для интервью с различной громкостью спикеров.
- Есть отдельные алгоритмы снижения шума и реверберации.
- Подходит для повторяемого выпуска подкастов, лекций и длинных разговорных форматов.
Минусы
- Автоматический конвейер не заменяет содержательный монтаж.
- Тонкая локальная реставрация отдельных спектральных дефектов остаётся задачей специализированного редактора.
- Облачная обработка требует согласованной политики для закрытых записей.
Кому подойдёт
Редакциям подкастов, образовательным проектам, агентствам и компаниям, которые систематически выпускают много разговорного аудио и хотят стандартизировать техническую постобработку между выпусками.
6. ElevenLabs Voice Isolator — отделение речи от сложного фона
ElevenLabs Voice Isolator решает узкую и понятную задачу: выделяет голос из записи с фоновой составляющей. В веб-инструмент можно загрузить файл или записать звук с микрофона; после обработки возвращается отдельная очищенная версия. Та же функция доступна через API, по этой причине её можно встроить в производственный процесс, где сотни файлов проходят одинаковую операцию.
Изоляция полезна для интервью на выставке, уличного комментария, голосовой заметки и исходника с мешающим окружением. Это не мастеринг и не монтаж. После Voice Isolator остаются задачи громкости, тембрального баланса, пауз, склеек и итогового экспорта. В ряде проектов правильная связка состоит из Voice Isolator на входе и обычного аудиоредактора на выходе.
Оценка проводится на фрагментах, где шум пересекается со спектром речи: гул голосов, транспорт, музыка, резкие события рядом с микрофоном. Хороший итог сохраняет непрерывность слов и не оставляет характерный «плавающий» шум между слогами. Самый сложный участок прослушивается отдельно, а не по среднему впечатлению от всей записи.
Плюсы
- Чёткая специализация на отделении голоса от фонового шума.
- Минимальный процесс: загрузка или запись, обработка, готовый голосовой файл.
- Есть API для автоматизации массовой обработки.
- Уместен для проблемных интервью и реплик из шумной среды.
Минусы
- Не заменяет монтаж, нормализацию и музыкальный мастеринг.
- Обрабатываемый файл передаётся в облачный сервис.
- После сильной изоляции требуется проверка натуральности тембра и непрерывности согласных.
Кому подойдёт
Медиа, PR-командам и продакшенам с большим количеством полевых интервью, комментариев с мероприятий и пользовательских записей, где главная задача — быстро получить понятный голосовой слой для дальнейшего монтажа.
7. Cleanvoice — автоматическая чистка речи и монтажных дефектов
Cleanvoice выходит за пределы обычного шумоподавления. Сервис ориентирован на подкасты и разговорный монтаж: помимо фонового шума он обрабатывает длинные паузы, слова-паразиты, дыхание, щелчки рта, запинки и другие речевые дефекты. В рабочем процессе это экономит время именно на рутинной зачистке, которая обычно требует большого числа мелких правок.
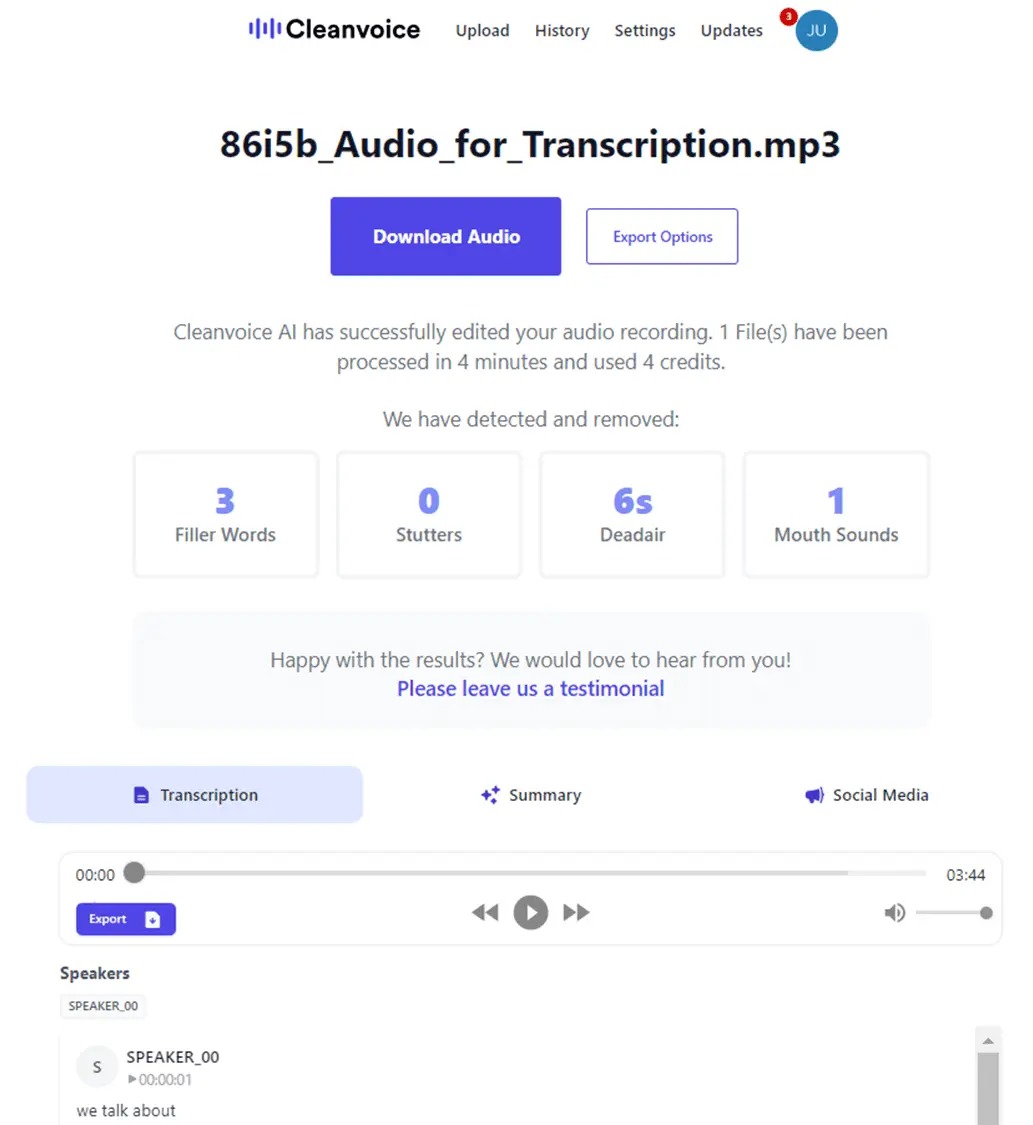
Автоматическое удаление речи всегда проходит редакторский контроль. Пауза перед важной мыслью, вдох, смех или короткая заминка порой несут интонацию и смысл. По этой причине удобнее рассматривать Cleanvoice как первый монтажный проход: сервис предлагает чистую основу, после чего человек возвращает нужные паузы и проверяет стыки. Такой подход в особенности важен для интервью, где естественный темп разговора влияет на доверие к герою.
Для агентства добавочная ценность — экспорт итогов в редактируемый рабочий процесс, а не только «запечённый» файл. Команда получает ускорение на механической части и сохраняет право изменить отдельные решения перед публикацией.
Плюсы
- Совмещает техническую очистку с автоматической редактурой разговорной записи.
- Работает с паузами, словами-паразитами, дыханием, щелчками рта и шумом.
- Подходит для длинных подкастов, интервью и голосовых материалов.
- Итог удобно воспринимать как черновой монтажный проход для дальнейшей редакторской проверки.
Минусы
- Автоматические удаления требуют прослушивания: смысловые паузы и интонационные элементы нельзя оценивать только алгоритмом.
- Сервис ориентирован на речь, а не на сложный музыкальный микс.
- Облачный процесс требует отдельного решения по закрытым и персональным материалам.
Кому подойдёт
Подкастерам, корпоративным редакциям, продюсерам интервью и командам, которые тратят много времени на удаление мелких речевых дефектов после записи.
8. LALAL.AI Voice Cleaner — отделение голоса, шума и нежелательной музыки
LALAL.AI Voice Cleaner применяет модель отделения голоса от фона. Сервис удаляет фоновый шум, нежелательную музыку, низкочастотный гул микрофона и взрывные согласные; отдельно доступна обработка эха и реверберации. Поддерживаются распространённые аудио- и видеоформаты, по этой причине инструмент удобен для интервью, видеоролика и вокальной дорожки без обязательной перекодировки исходника на первом шаге.
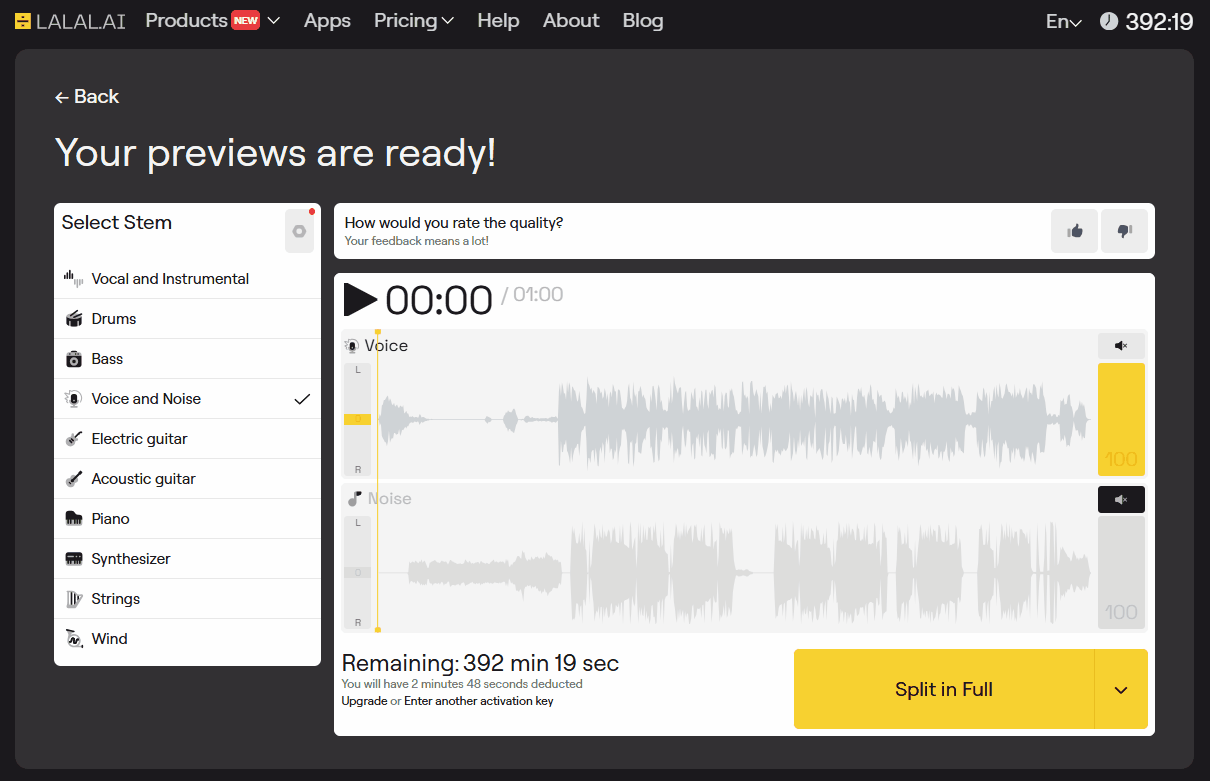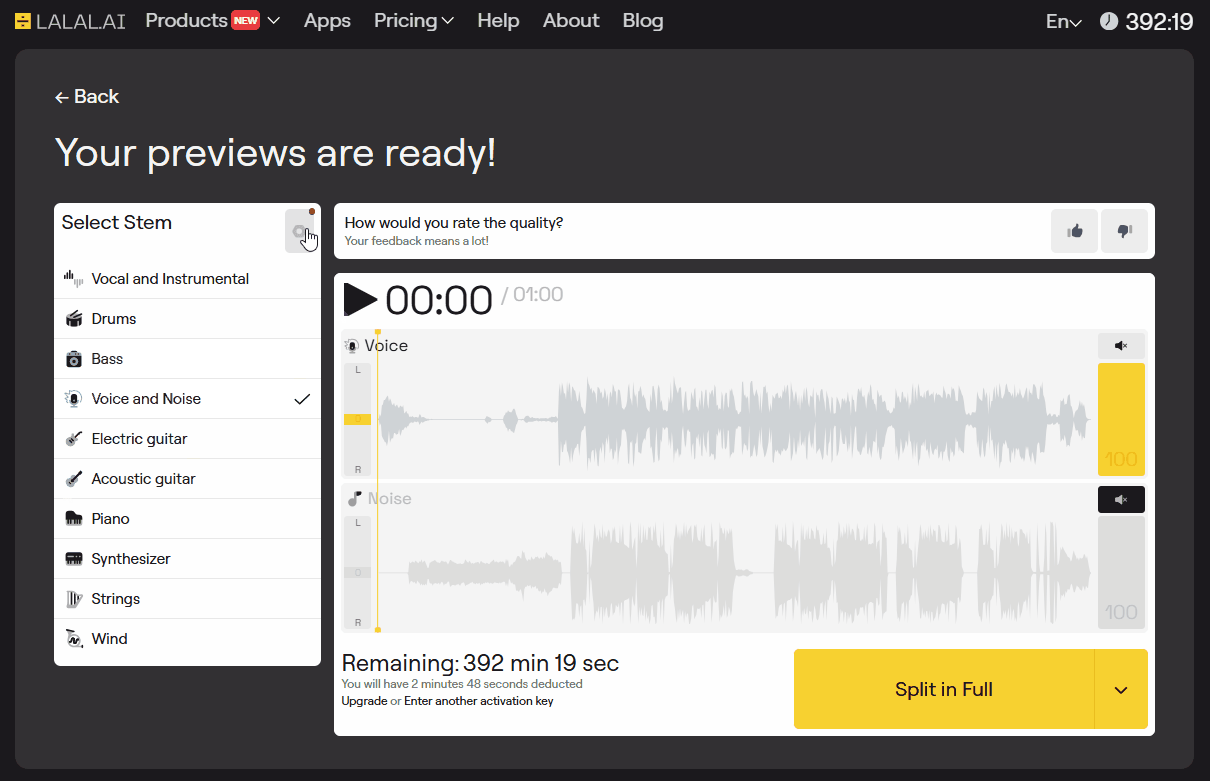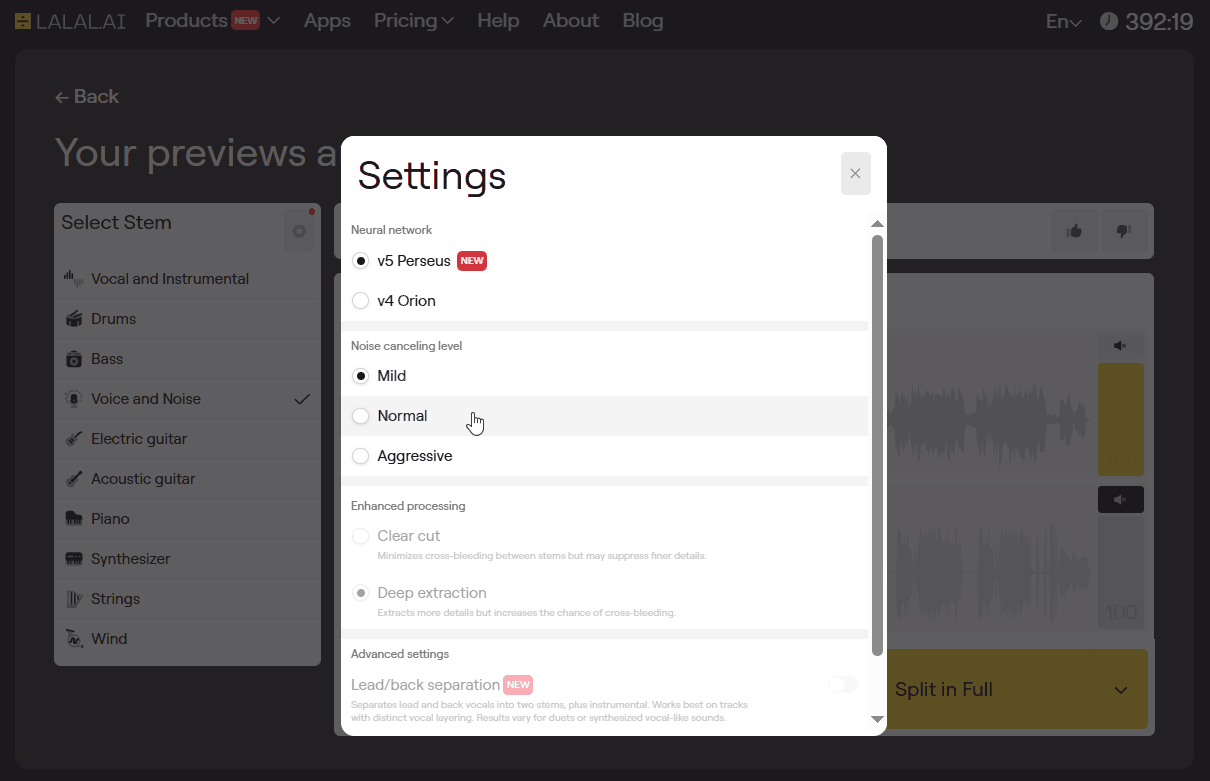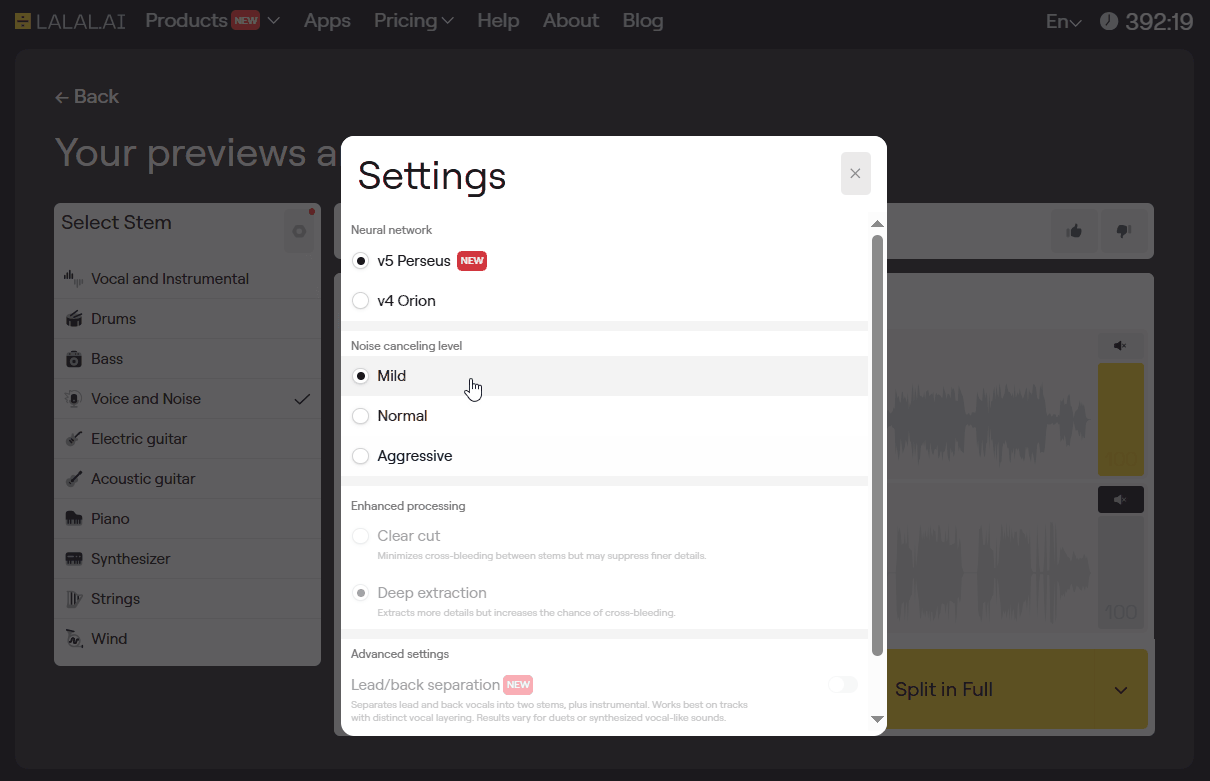
Практически важен регулятор интенсивности: высокий уровень очистки удаляет больше помех, но одновременно сильнее вмешивается в натуральную окраску голоса. Оптимальная стратегия — начать с мягкого режима и усиливать обработку лишь на тех участках, где фон остаётся в самом деле отвлекающим. Для музыкального вокала это в особенности важно: дыхание и реверберационный хвост являются частью исполнения, а не всегда дефектом.
После очистки вокала зачастую требуется обычная частотная доводка. Материал о частотной обработке и эквалайзере помогает понять, почему отдельный гул, резкость и мутность не всегда стоит решать одной нейросетью. Сперва отделяется лишний фон, затем небольшими движениями корректируется спектр.
Плюсы
- Сильная специализация на разделении голоса и нежелательного фона.
- Отдельно решаются шум, фоновая музыка, микрофонный гул и реверберация.
- Работа с аудио и видео удобна для материалов из различных каналов производства.
- Интенсивность очистки регулируется, что помогает сохранить натуральность голоса.
Минусы
- Слишком сильная интенсивность ухудшает естественность речи и вокала.
- После очистки остаются задачи монтажа, громкости и тембральной коррекции.
- Основной облачный сценарий требует учёта политики хранения рабочих файлов.
Кому подойдёт
Командам, которые получают интервью, репортажи, вокальные демо и видео с заметным окружающим звуком. В особенности полезен там, где фон состоит не из ровного шипения, а из сложной смеси музыки, помещения и внешних событий.
9. Riverside Magic Audio — улучшение дорожек внутри записи и монтажа
Riverside Magic Audio встроен в экосистему записи и редактирования Riverside. Эффект снижает фоновый шум и реверберацию, а интенсивность можно смешивать с исходной дорожкой. В редакторе Magic Audio применяется ко всем участникам либо к отдельной дорожке, что удобно для интервью: ведущий, гость и внешний файл получают независимый уровень обработки.
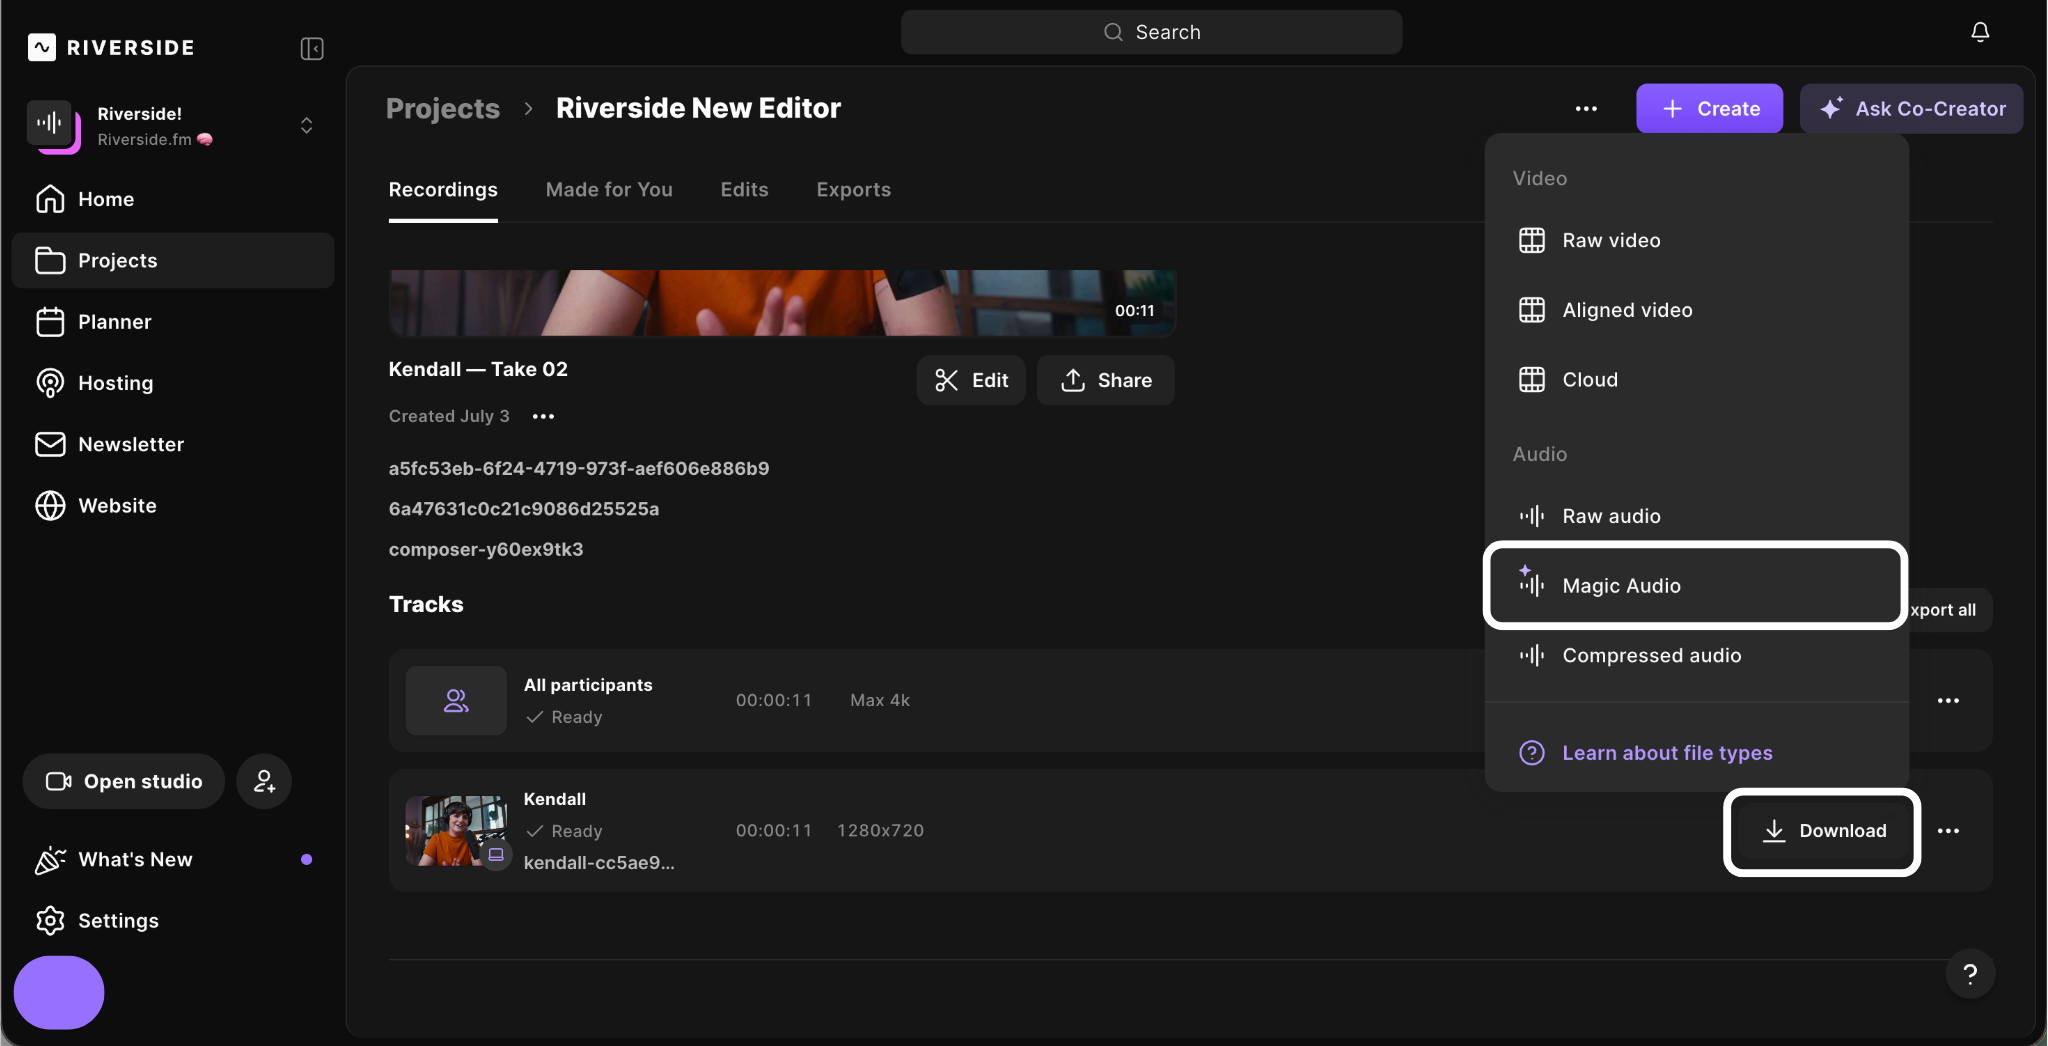
Смешивание оригинала и обработанной версии — важный контроль естественности. Вместо бинарного выбора «сырой или очищенный» редактор оставляет часть исходной акустики. Это полезно для видеоинтервью и дистанционных подкастов, где чрезмерно сухой голос звучит отдельно от изображения и помещения.
Ограничение связано с экосистемой: Magic Audio предназначен для дорожек участника и внешних загрузок внутри Riverside, а не для универсальной работы с любым многодорожечным проектом. Команда, которая уже пишет интервью в Riverside, получает обработку на месте; отдельному музыкальному продакшену логичнее применять специализированный аудиоредактор.
Плюсы
- Очистка встроена в тот же редактор, где находится исходная запись.
- Можно применять Magic Audio ко всем участникам или к отдельной дорожке.
- Интенсивность смешивает исходный и улучшенный варианты вместо жёсткой замены.
- Подходит для дистанционных интервью и видеоподкастов.
Минусы
- Инструмент привязан к производственному процессу Riverside.
- Не является полноценной системой музыкального мастеринга.
- Отдельные типы дорожек, включая screen share, не относятся к целевому сценарию Magic Audio.
Кому подойдёт
Командам, которые уже записывают интервью, вебинары и подкасты в Riverside и хотят очищать голос без добавочного экспорта в сторонний сервис.
iPhone и Android
Мобильная группа в этом рейтинге намеренно компактная. Многие веб-сервисы открываются на смартфоне, но браузерная страница не равна полноценному приложению. Для мобильной работы тут выбран BandLab: он имеет Studio на телефоне и в браузере, а Voice Cleaner относится именно к ИИ-инструментам для вокала.
10. BandLab Voice Cleaner — мобильная очистка вокала и быстрый музыкальный финиш
BandLab доступен в мобильном приложении и веб-студии. Актуальный Voice Cleaner объединяет три ИИ-функции: Noise Remover для фонового шума, DeReverb для комнатных отражений и AutoEQ для автоматической коррекции тембра. Эти модули включаются вместе или по отдельности. После очистки музыкальный проект остаётся в той же Studio, где доступен мастеринг с пресетами и регулировкой интенсивности.
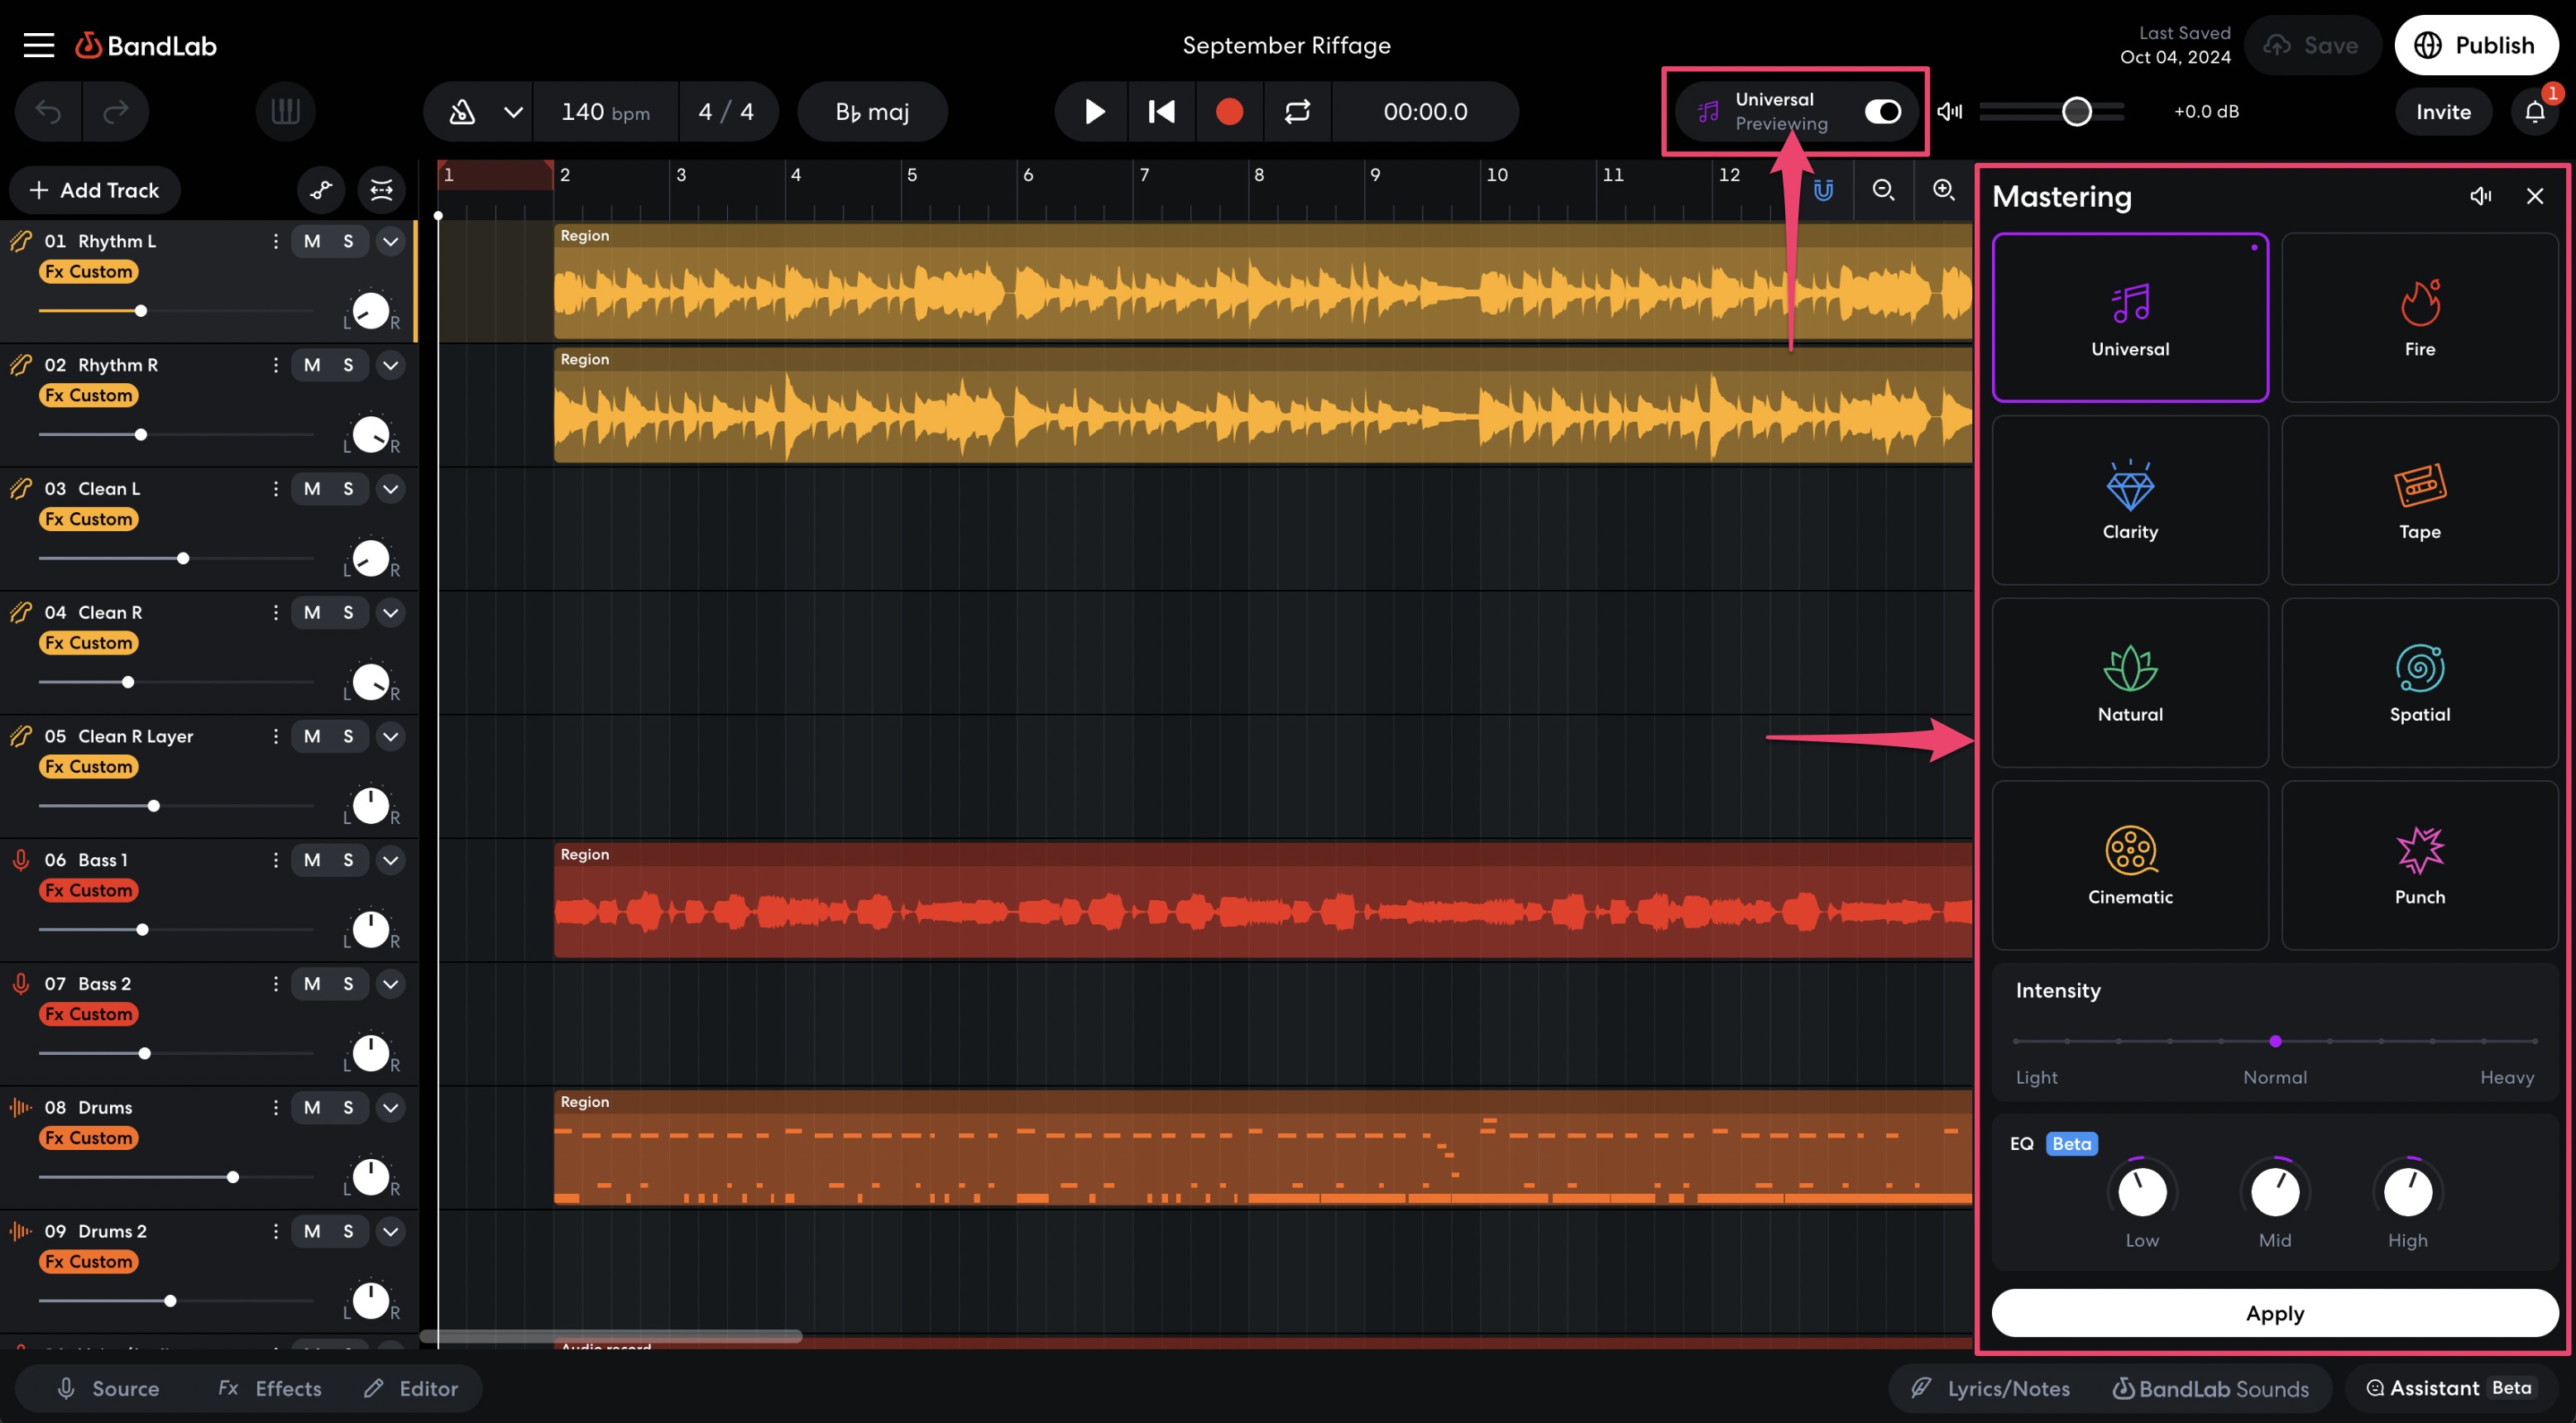
BandLab закрывает типичный мобильный сценарий: вокальный черновик записан на телефон вне студии, затем шум и помещение приводятся к более чистому состоянию, после чего партия размещается в проекте и доводится вместе с музыкой. Сервис в особенности полезен для демо, коротких джинглов, музыкального контента и быстрых идей, которые позднее переходят в полноценный продакшен.
Для деловой речи BandLab уступает специализированным решениям: Voice Cleaner ориентирован на вокальную дорожку и музыкальную Studio. Зато сочетание мобильного редактора, очистки, AutoEQ и мастеринга делает его уместным там, где итогом является не чистая расшифровка интервью, а готовый аудиоконтент.
Плюсы
- Полноценный мобильный сценарий, а не только браузерная страница.
- Voice Cleaner объединяет Noise Remover, DeReverb и AutoEQ.
- Каждый модуль можно включать отдельно для более контролируемой обработки.
- После очистки вокал остаётся в музыкальной Studio для сведения и мастеринга.
Минусы
- Основная специализация — вокал и музыкальный проект, а не деловые созвоны.
- Voice Cleaner не заменяет ручной монтаж длинного интервью.
- Одновременная обработка нескольких дорожек Voice Cleaner не относится к его рабочему сценарию.
Кому подойдёт
Музыкантам, авторам короткого аудиоконтента, SMM-командам с музыкальными видеороликами и создателям джинглов, которым необходима очистка вокала прямо на смартфоне с дальнейшим сведением в том же проекте.
Как выбрать инструмент по задаче бизнеса и контент-команды
Рейтинг становится полезным лишь после привязки к производственной задаче. Один и тот же исходник проходит различные маршруты в зависимости от того, что считается конечным продуктом: созвон для внутреннего хранения, публичное интервью, рекламный видеоролик, подкаст, презентация, исследовательская запись или музыка.
Созвоны, продажи и интервью в реальном времени
Приоритет — не допустить попадания шума в первичную запись. Krisp ставится в аудиотракт до конференции и очищает живой сигнал. Перед важной сессией создаётся тестовый звонок с тем же микрофоном и в том же помещении. Проверяются собственный фон, голос второго участника и моменты одновременной речи. Итог сохраняется как отдельная тестовая запись, чтобы настройки не менялись вслепую перед клиентом.
Подкаст, вебинар и длинное интервью после записи
Тут ценность дают Auphonic, Descript, Cleanvoice и Riverside. Descript удобен при текстовом монтаже, Cleanvoice ускоряет зачистку мелких речевых дефектов, Auphonic стабилизирует технический финиш, Riverside уменьшает число экспортов для материалов, записанных внутри его экосистемы. В одном проекте эти функции не нужно включать все подряд: каждый добавочный проход увеличивает риск повторной обработки уже исправленного сигнала.
Репортаж, выставка, улица и пользовательское видео
Самая частая проблема — не ровное шипение, а меняющийся фон: голоса, транспорт, музыка, отражения помещения. Тут логичны Adobe Enhance Speech, ElevenLabs Voice Isolator и LALAL.AI Voice Cleaner. Контрольный фрагмент обязательно включает самый сложный участок. Оценка только по тихому началу даёт ложное чувство качества, потому что модель проявляет слабые места именно во время пересечения речи и шума.
Конфиденциальное интервью и закрытая презентация
Начальная ступень — локальный редактор. АудиоМАСТЕР не является нейросетью, но позволяет провести базовую частотную коррекцию, монтаж и выравнивание без загрузки файла в облачный сервис. Облачная обработка подключается после внутреннего решения по данным. Такой порядок уменьшает риск того, что удобство автоматической очистки окажется важнее правил хранения исходников.
Музыкальный видеоролик, джингл и вокальное демо
Для вокала полезна двухэтапная схема: сперва аккуратная очистка фона, затем тембр и динамика. BandLab Voice Cleaner объединяет шум, DeReverb и AutoEQ, LALAL.AI помогает отделить голос от сложного окружения, АудиоМАСТЕР подходит для локальной ручной доводки. В более сложном миксе ориентиром служит полная обработка вокала: шумоподавление составляет только одну часть цепочки, рядом с эквализацией, динамикой и пространством.
Пошаговый процесс: от исходника до проверенного итога
Нейросетевой сервис становится предсказуемым инструментом, когда команда работает по одинаковому процессу. Ниже — схема, которая подходит для коммерческих интервью, подкастов, видеороликов и внутреннего контента. Она специально отделяет техническую обработку от субъективного выбора «нравится — не нравится».
- Шаг 1. Скопируйте мастер-файл. Оригинал остаётся неизменным. Рабочая копия получает понятное имя с датой и стадией обработки.
- Шаг 2. Зафиксируйте дефекты. Отметьте временные метки с шумом, эхом, провалами громкости, клиппингом, щелчками и неудачными склейками. Это превращает «плохой звук» в набор проверяемых проблем.
- Шаг 3. Выберите один главный процессор. Для живого разговора — Krisp; для облачной очистки речи — Adobe, ElevenLabs или LALAL.AI; для длинной постобработки — Auphonic, Descript, Cleanvoice или Riverside; для локальной ручной версии — АудиоМАСТЕР; для мобильного вокала — BandLab.
- Шаг 4. Обработайте контрольный фрагмент. Не запускайте часовой файл до оценки сложного отрезка. Короткий проход быстрее показывает, какие согласные и фон модель изменяет сильнее всего.
- Шаг 5. Сопоставьте на одинаковой громкости. Выравнивание уровня исключает эффект «громче значит качественнее». Сравнение выполняется быстрым переключением между исходником и итогом.
- Шаг 6. Проверьте смысловые места. Имена, цифры, термины, тихие реплики и перебивания не должны исчезать или превращаться в новый звук. Это в особенности важно для интервью и юридически значимых формулировок.
- Шаг 7. Выполните ручную доводку. После нейросети остаются монтаж, частотная коррекция, де-эссинг, уровни и финальные паузы. Повторная тяжёлая очистка поверх уже очищенного сигнала не является обязательным этапом.
- Шаг 8. Экспортируйте отдельную итоговую копию. Мастер, рабочая версия и публикационный файл хранятся раздельно. Такой порядок упрощает повторную редактуру и замену спорного фрагмента.
Как измерять качество без дорогой лаборатории
Для рабочего контента достаточно воспроизводимого протокола. Он сочетает слуховую проверку и несколько наблюдаемых признаков. Главная цель — не получить максимально «стерильный» файл, а повысить понятность и стабильность без заметного разрушения голоса.
Разборчивость
Возьмите фразу с шипящими, взрывными согласными, тихими окончаниями и именем собственным. После обработки каждое слово должно считываться без увеличения громкости. Пропавшие окончания, смазанные согласные и заменённые фонемы считаются ухудшением даже при практически полной тишине между словами.
Остаточный фон
Слушайте паузы между фразами. Нормальное шумоподавление делает фон менее отвлекающим и сохраняет его стабильность. Пульсация, «подводный» звук и резкие провалы тишины указывают на слишком сильную обработку или неудачную модель для конкретного типа шума.
Стабильность тембра
Голос одного человека должен сохранять узнаваемую окраску на протяжении всего фрагмента. Резкий переход от тёплого к металлическому тембру, различные уровни «воздуха» между соседними предложениями и внезапно срезанный низ воспринимаются как монтажная ошибка, даже когда шум формально исчез.
Динамика и пики
После очистки уровень часто меняется: модель делает голос плотнее или тише. Финальная доводка выполняется отдельно. Для понимания динамики пригодится материал о компрессоре, а для резких свистящих согласных — разбор де-эссера. Эти процессы не стоит смешивать с шумоподавлением в одно действие: так легче понять причину каждого изменения.
Проверка в реальном канале публикации
Файл прослушивается не только в монтажных наушниках. Для видеоролика необходим просмотр на ноутбуке и телефоне, для подкаста — обычные наушники и небольшой динамик, для презентации — типичная переговорная система. Ошибка, незаметная на студийной гарнитуре, зачастую становится очевидной на компактном динамике из-за ограниченного диапазона.
Мини-протокол A/B для команды
- Сделайте два файла одинаковой длины: исходник и обработанную версию.
- Выровняйте субъективную громкость, чтобы один вариант не выигрывал только уровнем.
- Перемешайте порядок и дайте двум коллегам оценить разборчивость, натуральность и утомляемость по пятибалльной шкале.
- Зафиксируйте спорные временные метки, а не общие впечатления.
- Выберите режим по повторяющимся замечаниям и сохраните его описание в карточке проекта.
- Для следующего выпуска повторите процедуру на новом исходнике, а не переносите настройки автоматически на другой микрофон и помещение.
Типичные ошибки при работе с нейросетевой очисткой
Большинство неудач происходит не потому, что модель «плохая», а из-за неверного места в цепочке. Один и тот же сервис звучит убедительно на голосовой заметке и разрушительно на музыкальном миксе, потому что это различные исходные задачи.
Обработка мастера вместо отдельной речевой дорожки
В видео с музыкой и эффектами сперва отделяют голосовую дорожку или работают с исходной записью спикера. Очистка уже собранного мастера заставляет модель считать музыку частью шума. Итог теряет пространство, а музыкальные атаки начинают «дышать» вместе с речью.
Максимальная интенсивность с первого прохода
Сильная очистка выглядит привлекательной в короткой паузе, но на длинной речи быстро проявляет потерю естественного дыхания и окончаний слов. Начальный проход выполняется в умеренном режиме. Усиление требуется лишь на явно проблемных участках.
Несколько нейросетей подряд без причины
Adobe поверх LALAL.AI, затем Cleanvoice Studio Sound и ещё один мастеринг дают четыре независимых вмешательства. Каждый процессор принимает уже изменённый сигнал за исходный и способен усилить артефакты предыдущего. Рабочая цепочка содержит один основной инструмент очистки и отдельные операции лишь для оставшихся дефектов.
Оценка только по тишине
Полностью исчезнувший фон в паузе не доказывает качество. Главная проверка происходит во время речи, в особенности на тихих согласных, быстрых фразах и одновременном фоне. Чистая пауза при повреждённых словах — плохой итог.
Экспорт с лишним перекодированием
Каждая промежуточная компрессия с потерями добавляет собственные искажения. Для этапов монтажа рационально держать рабочий мастер в несжатом или lossless-формате, а итоговый файл готовить под конкретную площадку. Базовые свойства несжатого формата разобраны в материале о WAV, а роль частоты дискретизации — в руководстве по семплированию звука.
Попытка исправить плохую запись только постобработкой
Нейросеть не отменяет микрофонную технику. Слишком высокий входной уровень приводит к необратимому клиппингу, слишком большое расстояние увеличивает долю комнаты, а сильный ветер создаёт низкочастотные удары. Чистая запись на входе всегда оставляет модели больше полезной информации и требует меньше вмешательства.
Практические сценарии для маркетинга, PR и бизнеса
Интервью с экспертом для статьи и соцсетей
Запись ведётся с резервной локальной дорожкой. После интервью выбирается проблемный фрагмент с шумом и фрагмент с чистой речью. Для постобработки подойдут Adobe Enhance Speech, Descript или ElevenLabs Voice Isolator. Текстовый монтаж удобнее делать после технической очистки: распознавание речи получает более чистый сигнал, а редактор меньше времени тратит на переслушивание неразборчивых мест. Финальное видео проверяется на телефоне, потому что именно там аудитория чаще замечает тонкий металлический призвук.
Вебинар и запись онлайн-мероприятия
До эфира полезен Krisp для живого потока, после эфира — Auphonic или Riverside для выравнивания длинных дорожек. Спикеров не стоит сводить в один файл до проверки уровня: независимые дорожки дают возможность по-разному обработать ведущего и гостя. В презентационном видео важна стабильность между речью и системным звуком, по этой причине музыка и демонстрационные видеоролики не проходят через голосовой изолятор.
Customer story и кейс клиента
Тут натуральность важнее стерильности. Голос героя должен оставаться узнаваемым, а небольшая акустика пространства поддерживает ощущение реального интервью. Magic Audio с регулируемой интенсивностью, Descript Studio Sound с уменьшенной силой или мягкий режим LALAL.AI позволяют оставить часть исходного окружения. Тяжёлая реконструкция применяется лишь на фрагментах, где шум мешает смыслу.
Подкаст бренда
Подкаст выигрывает от повторяемой схемы. Входная очистка выполняется одним инструментом, монтаж — в Descript или ином редакторе, затем Auphonic выравнивает технический финиш. Cleanvoice добавляется в проекты с большим количеством слов-паразитов и длинных пауз. Для каждого выпуска команда хранит настройки и один контрольный фрагмент, чтобы звук не менялся случайным образом от эпизода к эпизоду.
Короткий рекламный видеоролик с озвучкой
Сперва обрабатывается чистая голосовая дорожка, затем она возвращается в монтаж и смешивается с музыкой. Такой порядок сохраняет музыкальные атаки и атмосферу. Для локальной озвучки АудиоМАСТЕР подходит как ручной вариант, Adobe и ElevenLabs — как быстрые инструменты восстановления сложной речи, BandLab — для мобильной вокальной или музыкальной задачи.
Полевое исследование и пользовательские интервью
Содержание записи ценнее её эстетики, по этой причине основной критерий — разборчивость без потери слов. Сперва сохраняется неизменный оригинал, затем создаётся очищенная копия. Имена, числа, наименования продуктов и короткие ответы проверяются ручным способом. Конфиденциальность согласуется до загрузки в облачный сервис, а локальная базовая версия остаётся доступной вне зависимости от внешней платформы.
Короткая матрица выбора
- Необходим полностью локальный ручной контроль на Windows: АудиоМАСТЕР. Это не ИИ, а настольный редактор и контрольная точка для обычной обработки.
- Необходим чистый звук во время звонка: Krisp.
- Необходимы очистка и текстовый монтаж одного проекта: Descript Studio Sound.
- Необходимо агрессивно спасти плохо записанную речь: Adobe Podcast Enhance Speech v2.
- Необходим автоматический технический финиш длинного выпуска: Auphonic.
- Необходимо отделить голос от сложного фона: ElevenLabs Voice Isolator.
- Необходимо автоматически убрать паузы и речевые дефекты: Cleanvoice.
- Необходимы изоляция голоса, фоновой музыки и реверберации: LALAL.AI Voice Cleaner.
- Материал уже записан в Riverside: Magic Audio сохраняет обработку внутри того же проекта.
- Необходима мобильная очистка вокала с дальнейшим музыкальным продакшеном: BandLab Voice Cleaner.
Что изменилось в инструментах к 2026 году
Рынок заметно сместился от простой кнопки «убрать шум» к раздельным моделям. Adobe Enhance Speech v2 даёт отдельную работу с речью, музыкой и окружением. BandLab Voice Cleaner объединяет Noise Remover, DeReverb и AutoEQ. Riverside позволяет смешивать исходную и обработанную версии. LALAL.AI развивает отдельные модели для изоляции голоса и локального разделения аудиосигналов. Auphonic добавляет новые голосовые модели в уже зрелый производственный конвейер. Это делает выбор точнее: вместо одного абстрактного улучшателя редактор выбирает модуль под конкретный дефект.
Одновременно растёт роль контроля. Чем сильнее модель умеет реконструировать речь, тем важнее сравнение с исходником. Для бизнес-контента смысловая точность выше косметической чистоты: изменённая фамилия, тихо пропавшее отрицание или сглаженная цифра наносят больше вреда, чем оставшийся слабый фон.
Итог
Для большинства разговорных задач разумная последовательность выглядит так: определить главный дефект, сохранить оригинал, обработать короткий сложный фрагмент одним подходящим инструментом, сопоставить версии на одинаковой громкости, ручным способом проверить смысловые места и только затем запускать длинный материал. Такой процесс превращает нейросеть из «волшебной кнопки» в контролируемый этап производства.
АудиоМАСТЕР остаётся первым пунктом рейтинга как локальная контрольная точка без нейросетей. Для живых созвонов наиболее специализирован Krisp; для сложной речи — Adobe Enhance Speech, ElevenLabs и LALAL.AI; для длинной постобработки — Auphonic, Descript, Cleanvoice и Riverside; для мобильного вокала — BandLab. Выбор определяется не наименованием модели, а дефектом исходника, требованиями к данным и тем, как команда проверяет итог перед публикацией.