
Veryfi OCR API — облачный сервис для извлечения структурированных данных из чеков, счетов, банковских и других деловых документов. На странице Xeon Live можно скачать Veryfi OCR API бесплатно: в данном случае это переход к веб-сервису и доступу к API, а не установка локального EXE или DMG. Ниже разобран рабочий путь от первого файла в Inbox до надёжного JSON-конвейера с проверкой качества, вебхуками и обработкой ошибок.
Что такое Veryfi OCR API и как устроен рабочий процесс
Veryfi OCR API необходим не для редактирования страниц PDF, а для превращения документов в данные, которые можно сразу передавать в бухгалтерию, систему расходов, программу лояльности, CRM или собственный бэкенд. Сервис принимает документ, выполняет OCR, выделяет семантические поля и возвращает JSON. Для чеков и счетов это реквизиты поставщика, дата, валюта, суммы, налоги и массив line_items; для других типов документов применяются отдельные профильные endpoint-ы со своей схемой.
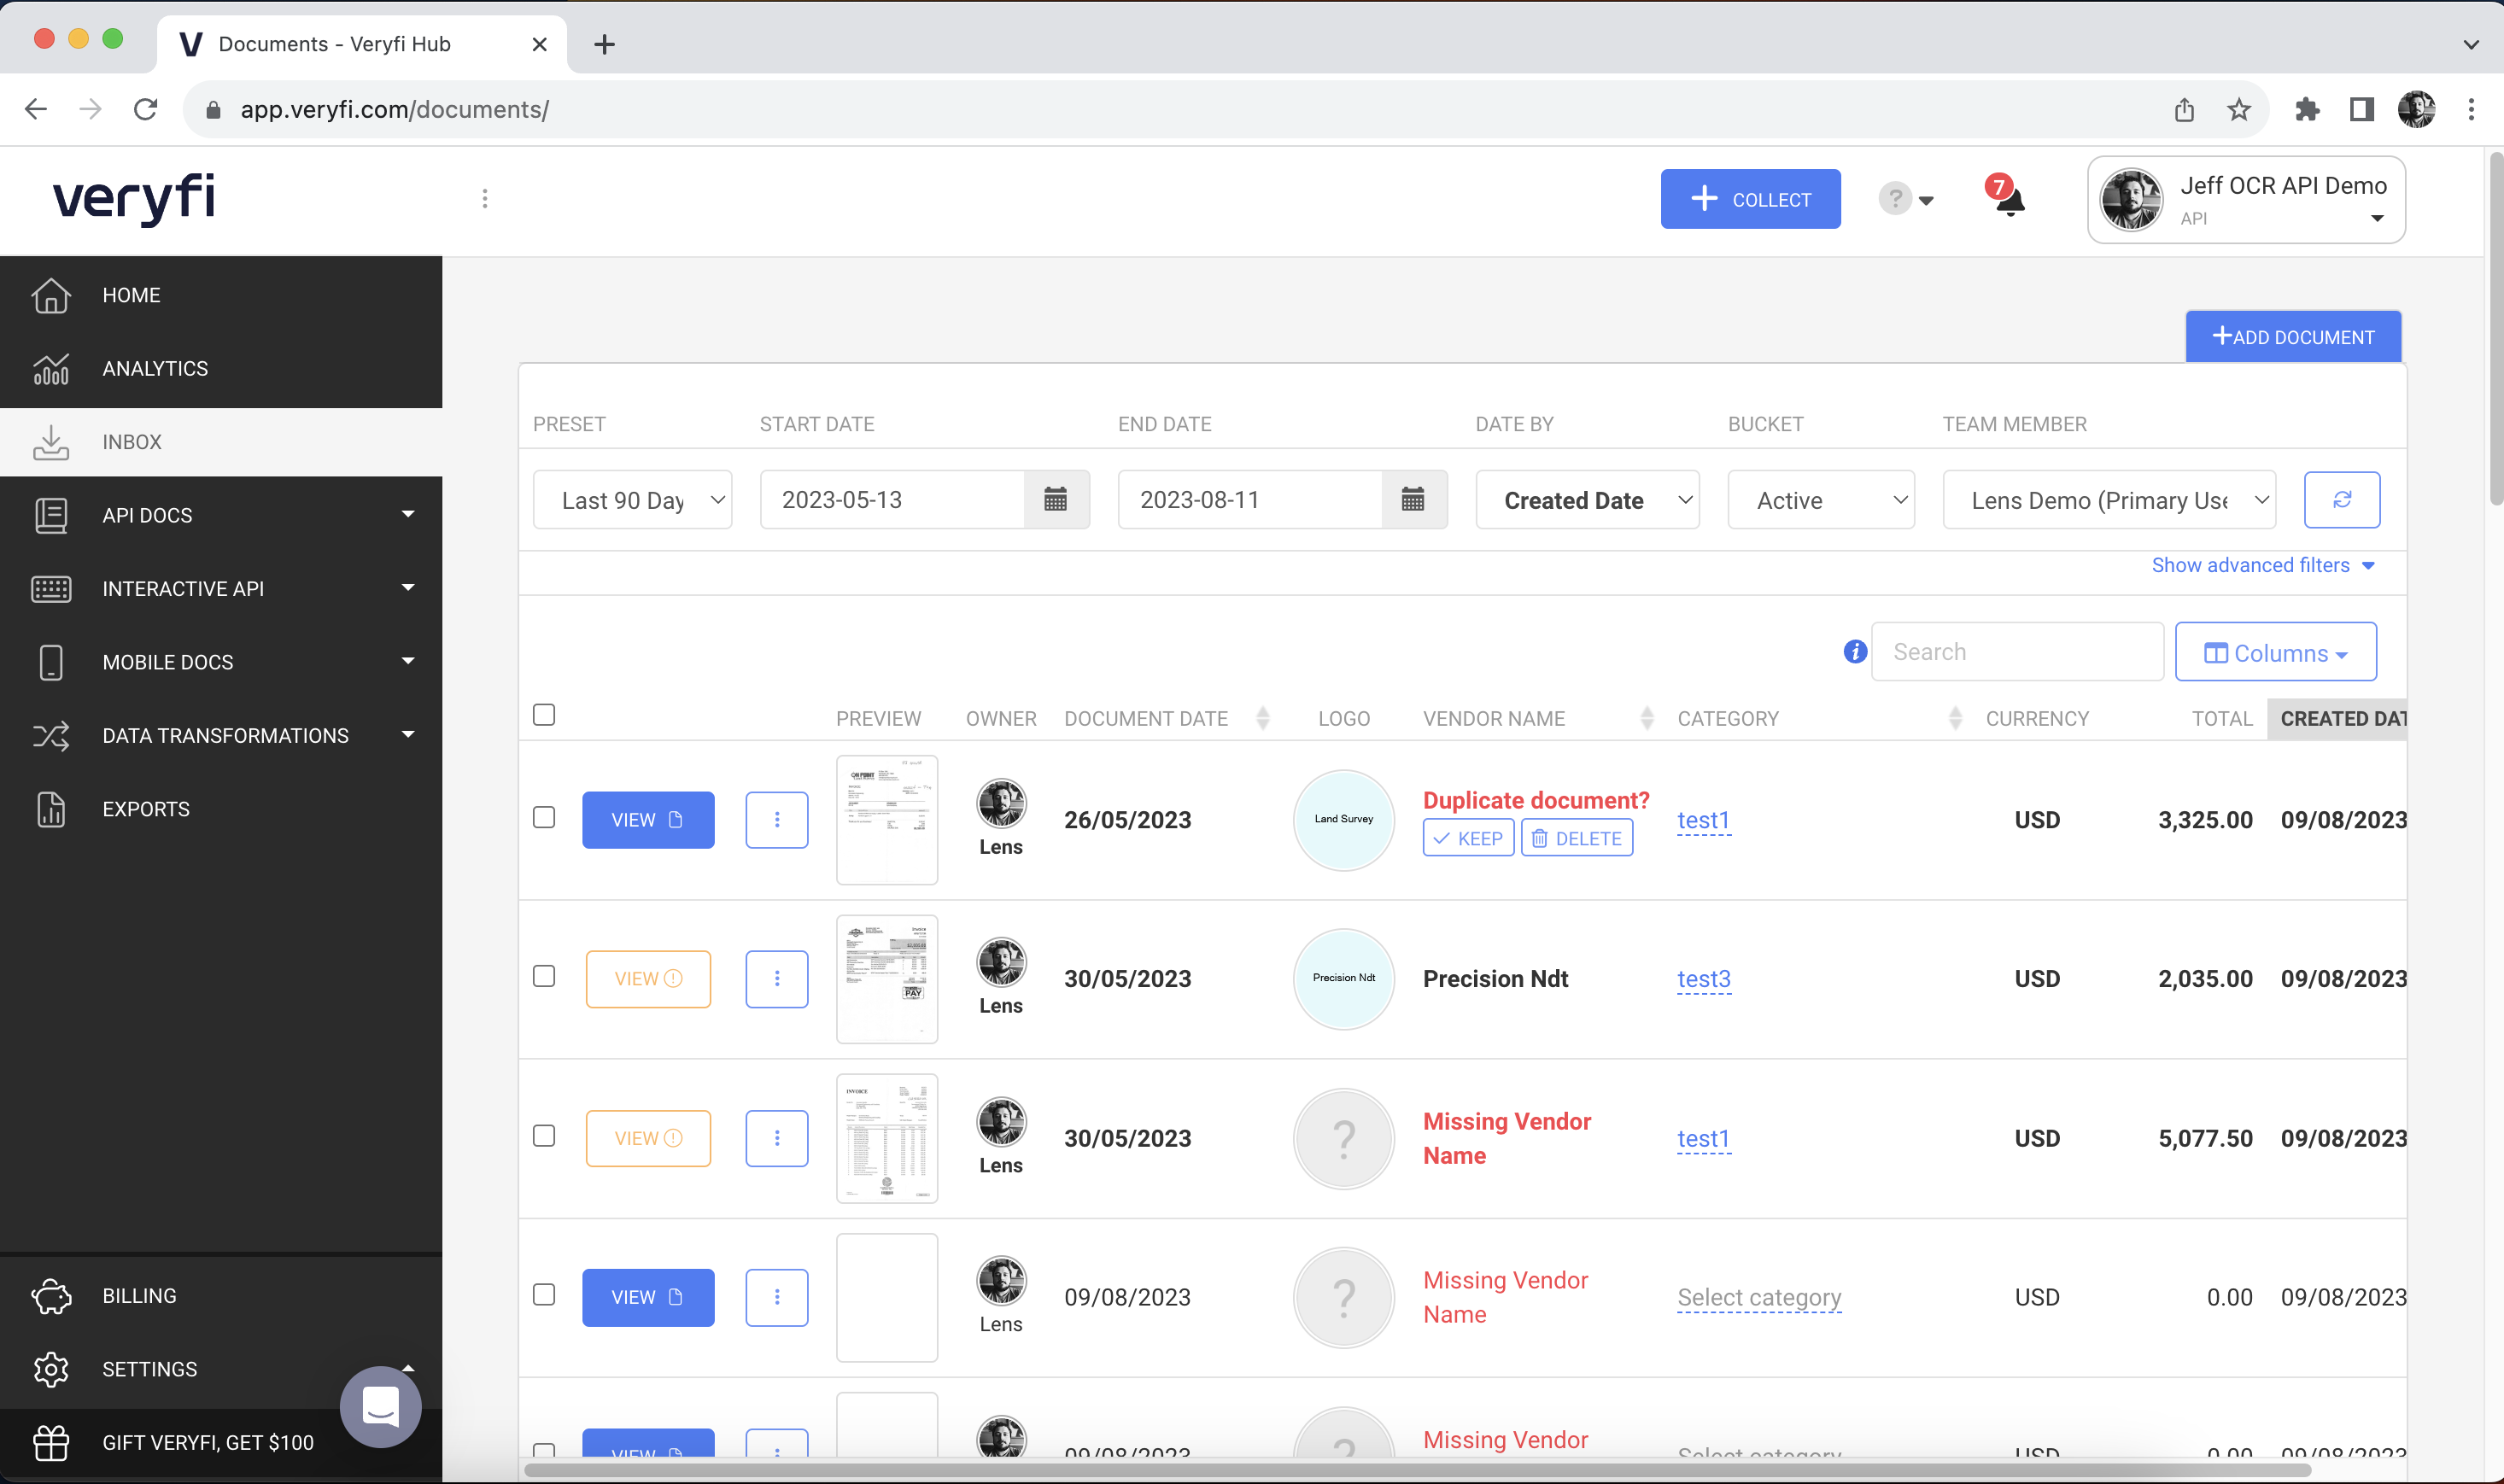
Рабочая часть разделена на два слоя. API Hub закрывает ручную проверку: Inbox показывает документы, карточка — исходник и извлечённые поля, API Docs — описание endpoint-ов, Analytics — измерение качества. REST API закрывает массовый поток: приложение отправляет файл, получает идентификатор и JSON, а затем применяет собственные правила. Такая архитектура удобна именно для автоматизации: оператору не приходится перепечатывать чек, а разработчик получает данные в типизированной структуре.
Для PDF полезно заблаговременно понимать разницу между текстовым слоем и изображением страницы. Veryfi обрабатывает и изображения, и PDF, но качество OCR всё равно зависит от читаемости исходника. Для общего понимания формата можно применять материал Xeon Live о том, как устроен PDF и чем отличается просмотр, редактирование и конвертация. Veryfi в этой цепочке отвечает за извлечение данных, а не за визуальную правку документа.
По состоянию на 16 сентября 2026 endpoint Receipts & Invoices работает на /api/v8/partner/documents. Для него в справке указаны максимальный размер 20 МБ, минимальный размер 250 байт, до 15 страниц за один вызов по стандартному лимиту и до 60 вызовов в секунду. Форматы включают PDF, JPEG/JPG, PNG, WEBP, AVIF, BMP, HEIC/HEIF, GIF, ZIP и ряд офисных и текстовых файлов. Для отдельных методов набор форматов и частота отличаются, по этой причине интеграция должна опираться на справку конкретного endpoint-а, а не на общий список.
Как подготовить API Hub и учётные данные
Карта API Hub: где искать Inbox, API Docs и Settings
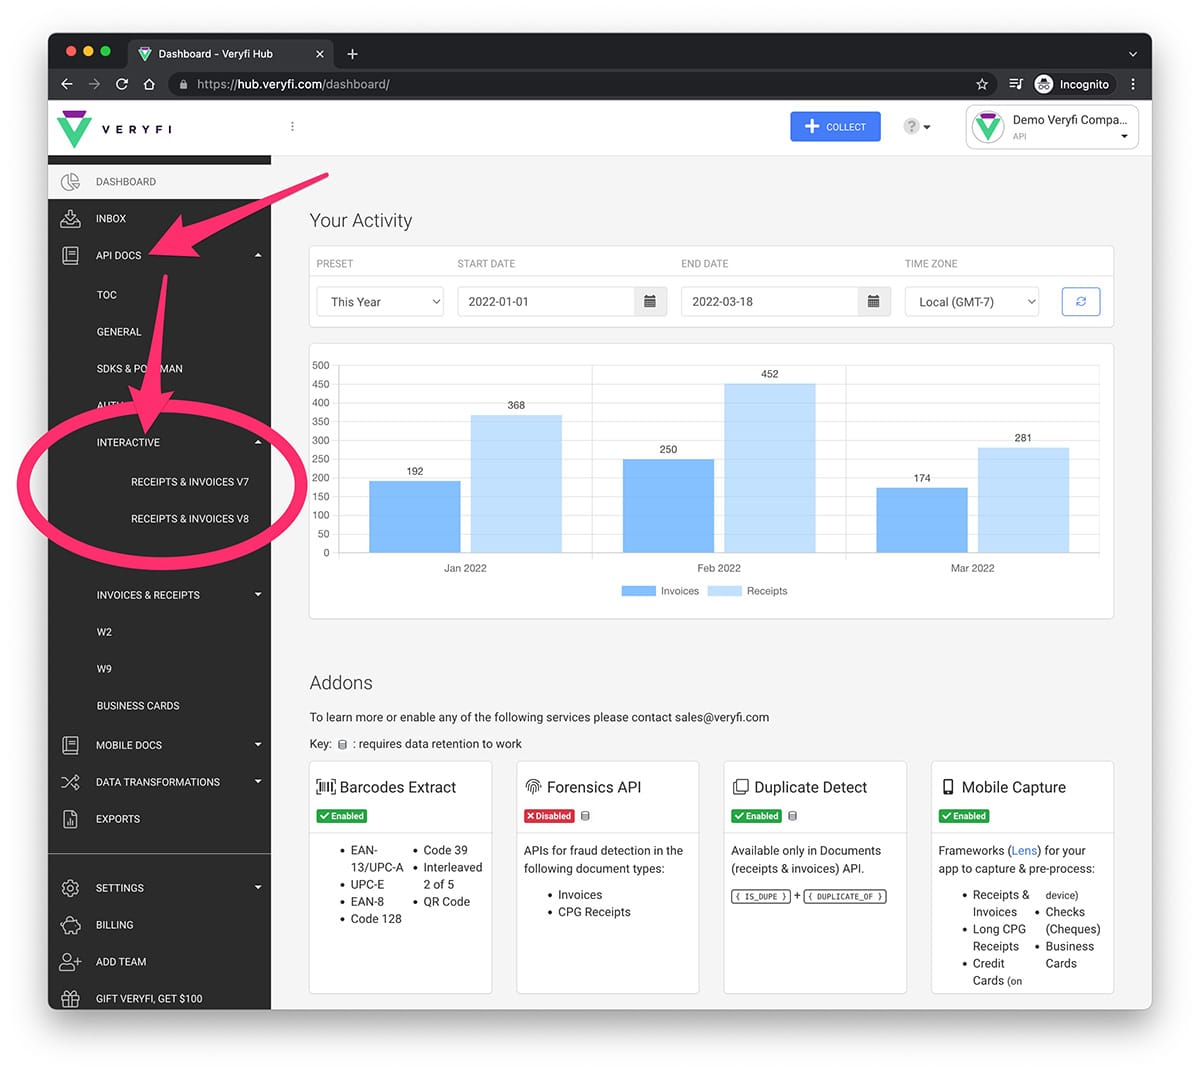
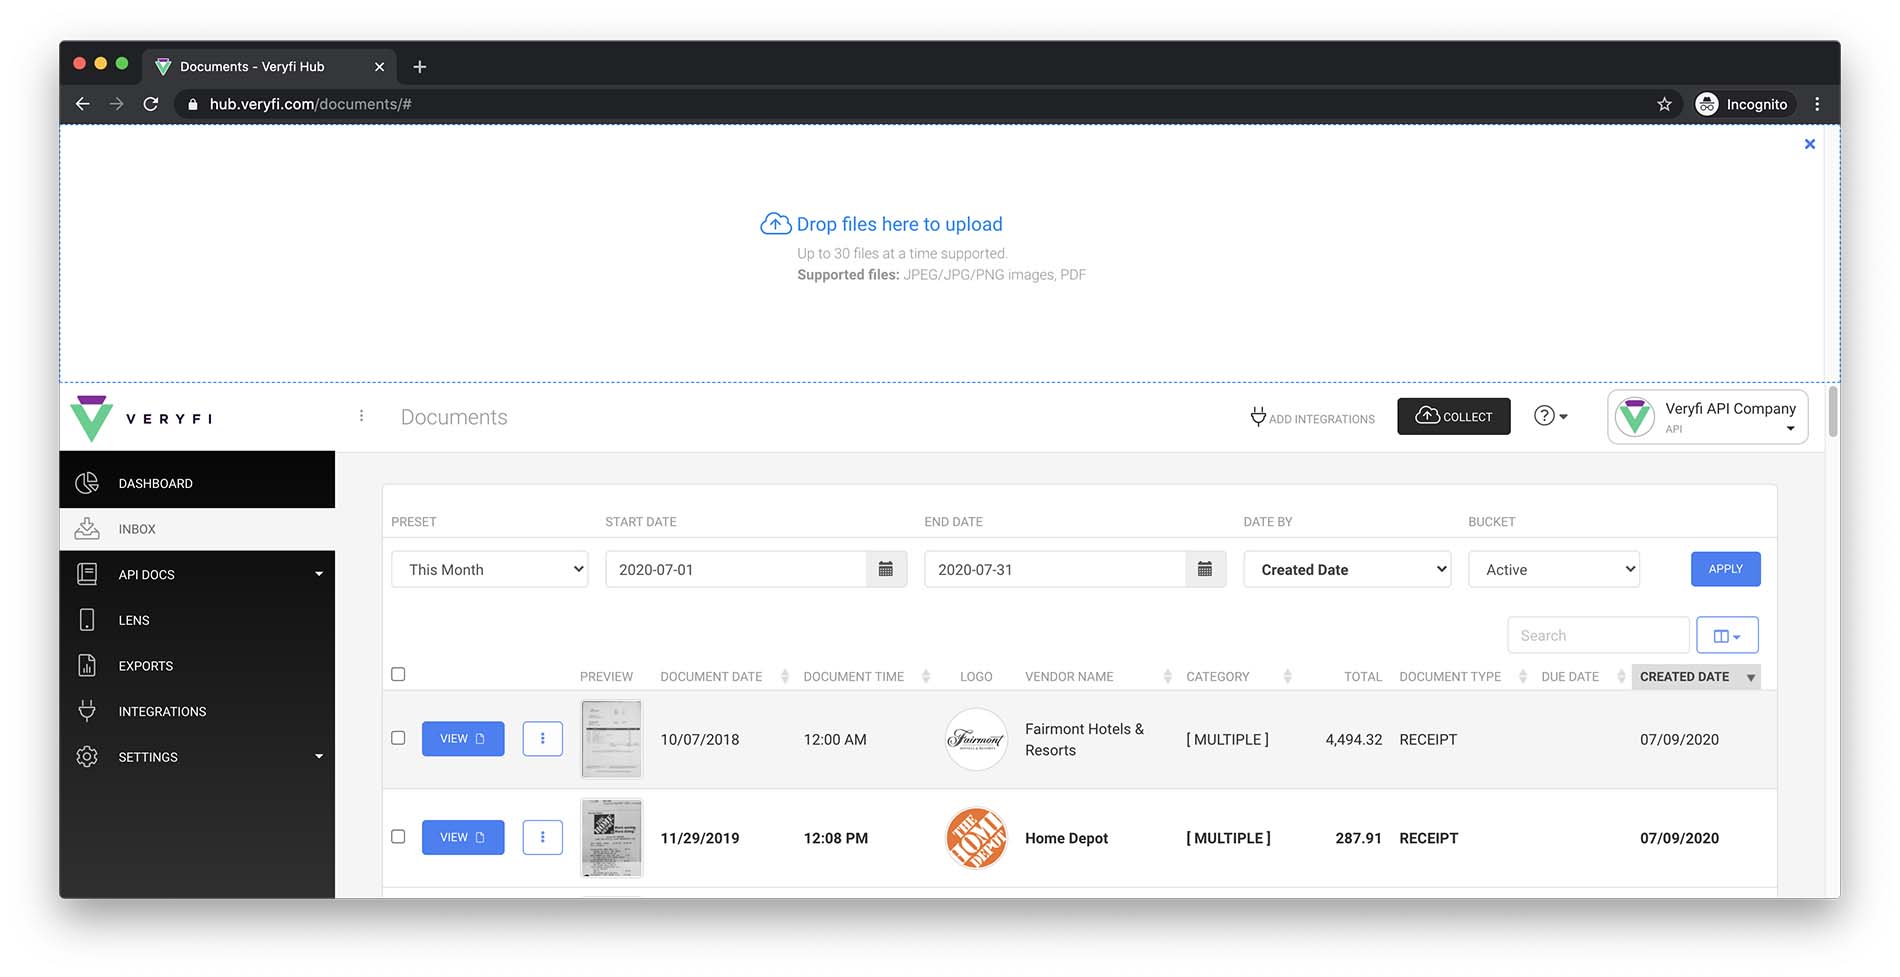
Начинать удобнее с кабинета: он позволяет увидеть итог до написания кода и сразу понять, какие поля в самом деле необходимы вашему процессу. После входа откройте левую навигацию. Inbox применяется как очередь документов; API Docs содержит публичное описание и интерактивный режим; Settings хранит учётные данные и параметры доступа; Analytics содержит Accuracy Reports. Этот порядок полезен и для команды: разработчик работает с API Docs и учётными данными, оператор — с Inbox, владелец процесса — с метриками качества.
- Откройте Inbox и убедитесь, что перечень документов доступен. Тут позднее появятся файлы, отправленные ручным способом и через API.
- Перейдите в API Docs → Interactive. Выберите v8 для Receipts & Invoices, чтобы работать с тем же поколением endpoint-ов, которое описано в текущей справке.
- Откройте Settings → Keys. Учётные данные видят только администраторы с разрешением API Keys; обычным операторам этот доступ не нужен.
- Сразу определите, какие данные будут считаться обязательными: к примеру, vendor, date, currency_code, total, invoice_number и line_items. Это упростит последующую проверку JSON.
- Для тестовой и рабочей интеграции применяйте различные секреты и отдельные переменные окружения. Значения не размещайте в клиентском JavaScript, мобильном приложении или репозитории.
API Hub обновляется, по этой причине отдельные подписи и расположение элементов менялись между поколениями интерфейса. Рабочие разделы Inbox, API Docs, Interactive API и Settings → Keys сохраняются в актуальной документации 2026 года. Для инструкции важно ориентироваться на назначение раздела, а не на цвет или точное положение кнопки.
Как получить учётные данные и проверить авторизацию без собственного кода
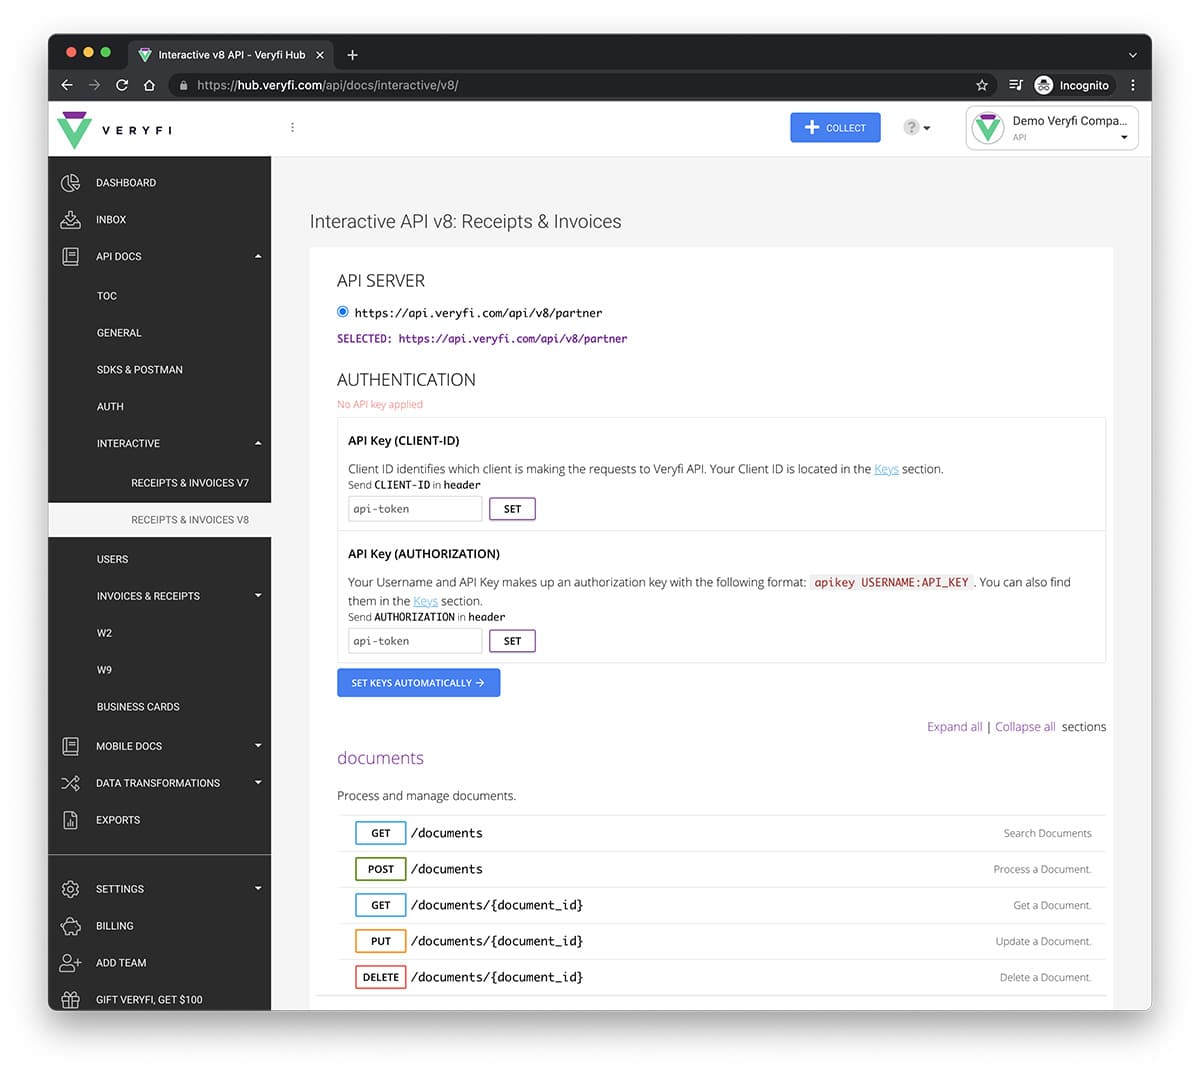
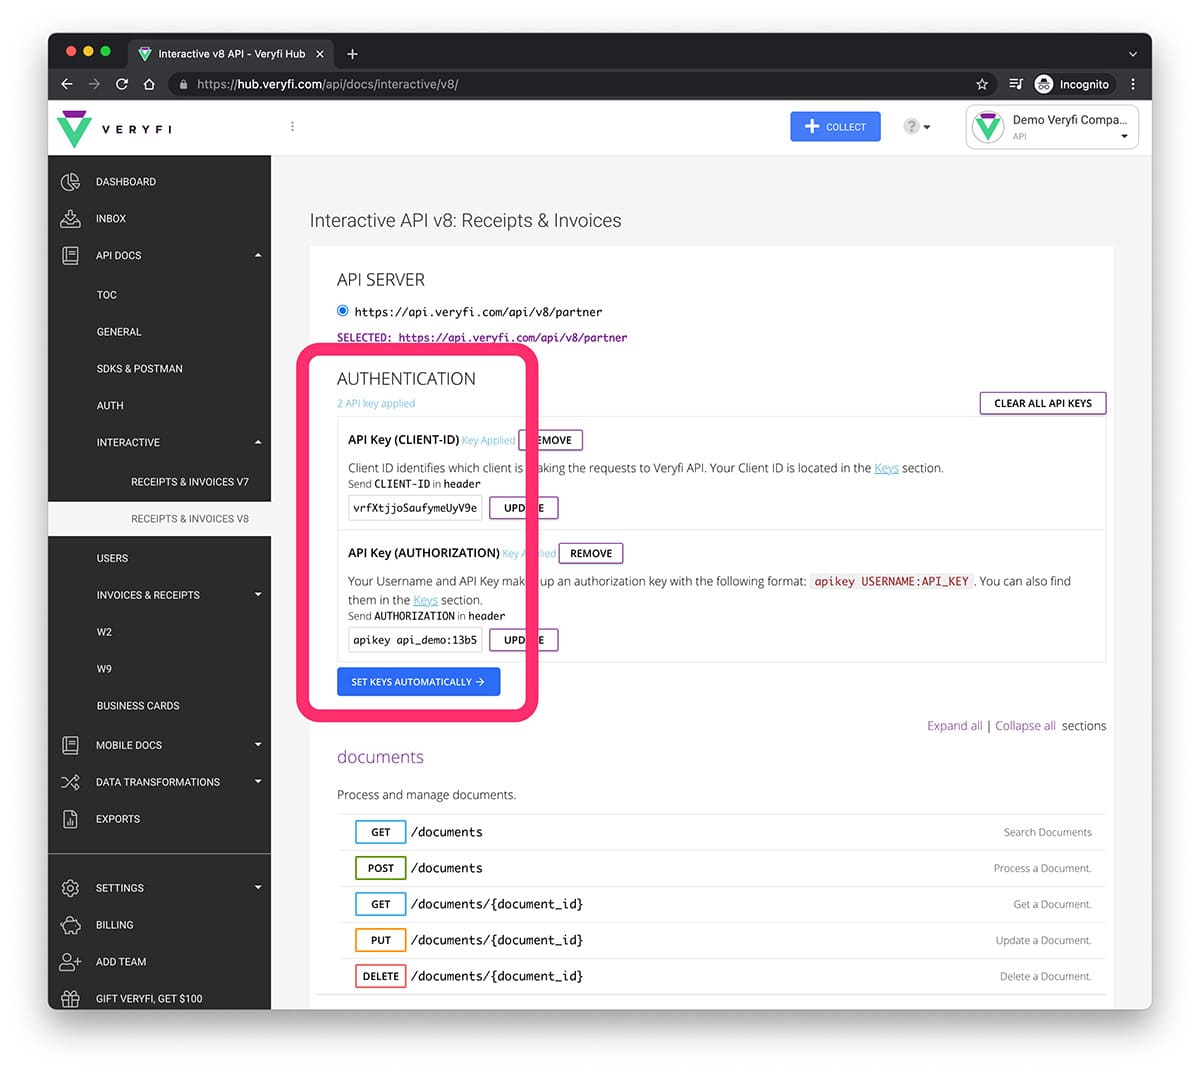
Для любого вызова требуется CLIENT-ID и заголовок AUTHORIZATION. Standard API key применяет формат apikey USERNAME:API_KEY и остаётся полностью поддерживаемым. Документация тоже описывает Bearer Full Access и Scoped учётные данные; в FAQ от 10 августа 2026 они отмечены как beta, а основной раздел аутентификации рекомендует Bearer для новых интеграций. Для первого универсального теста удобно применять Standard key, а Scoped Bearer применять там, где этот режим включён в аккаунте и требуется минимизация прав.
- В Settings → Keys скопируйте CLIENT_ID. Он передаётся отдельным HTTP-заголовком CLIENT-ID в каждом вызове.
- Для Standard key скопируйте Username и API Key. Соберите значение AUTHORIZATION в виде apikey USERNAME:API_KEY без кавычек и лишних пробелов.
- Откройте API Docs → Interactive → Receipts & Invoices v8. Вставьте CLIENT-ID и AUTHORIZATION либо применяйте встроенное применение учётных данных из активной сессии.
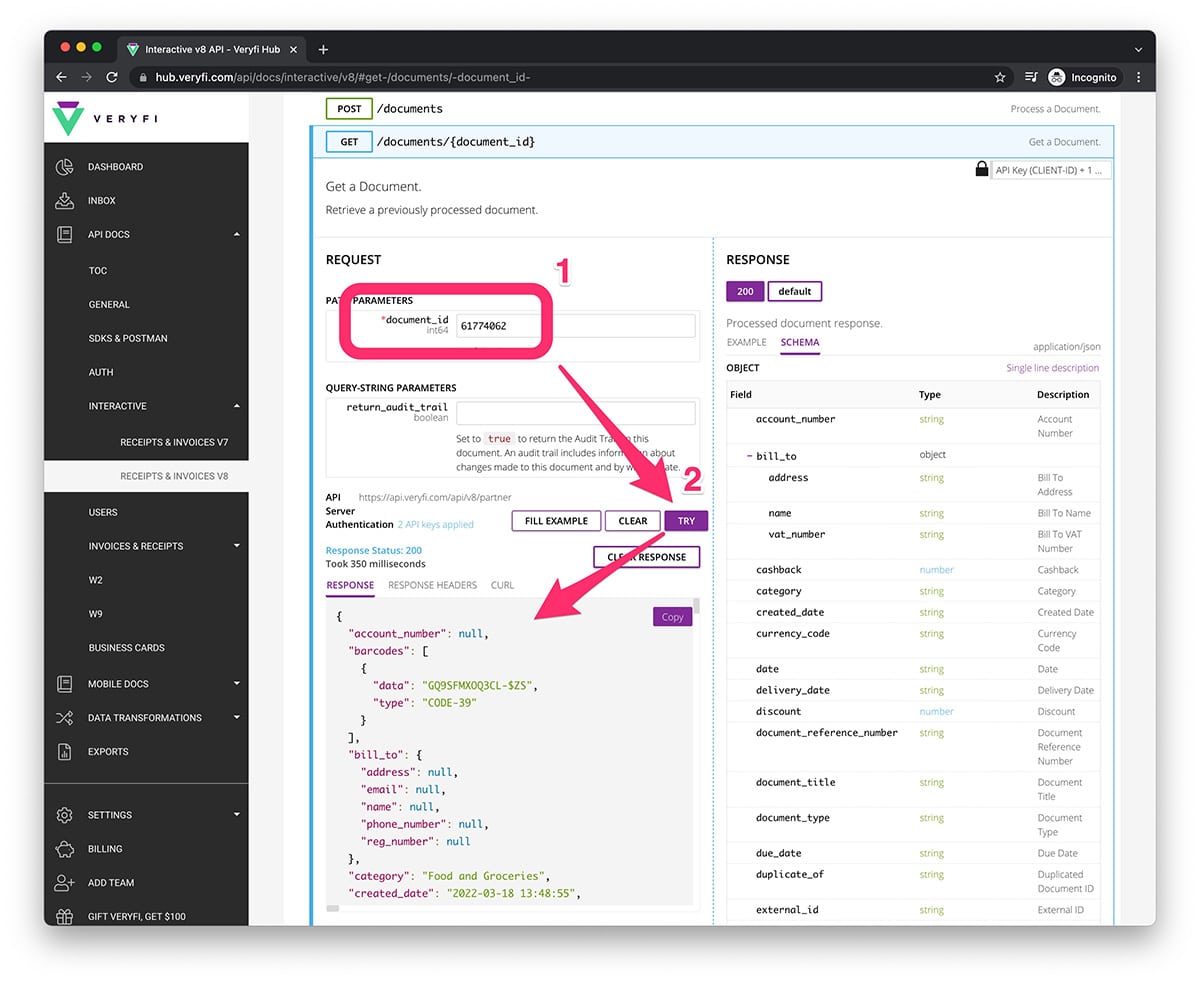
- Раскройте простой GET-метод перечня документов или GET документа по идентификатору и выполните тестовый вызов. Успешный ответ подтверждает, что заголовки и окружение настроены правильно.
- После проверки перенесите секреты в менеджер секретов или переменные окружения. В логах фиксируйте только факт наличия заголовка и технический идентификатор вызова, но не содержимое секрета.
Подпись X-Veryfi-Request-Signature строится с CLIENT_SECRET по HMAC-SHA256 и сопровождается X-Veryfi-Request-Timestamp. Официальные SDK умеют формировать подпись при переданном CLIENT_SECRET. Подписание не заменяет обычную авторизацию: CLIENT-ID и AUTHORIZATION всё равно остаются частью вызова.
Как ручным способом загрузить документ и проверить распознавание в Inbox
Загрузка контрольного файла через Inbox
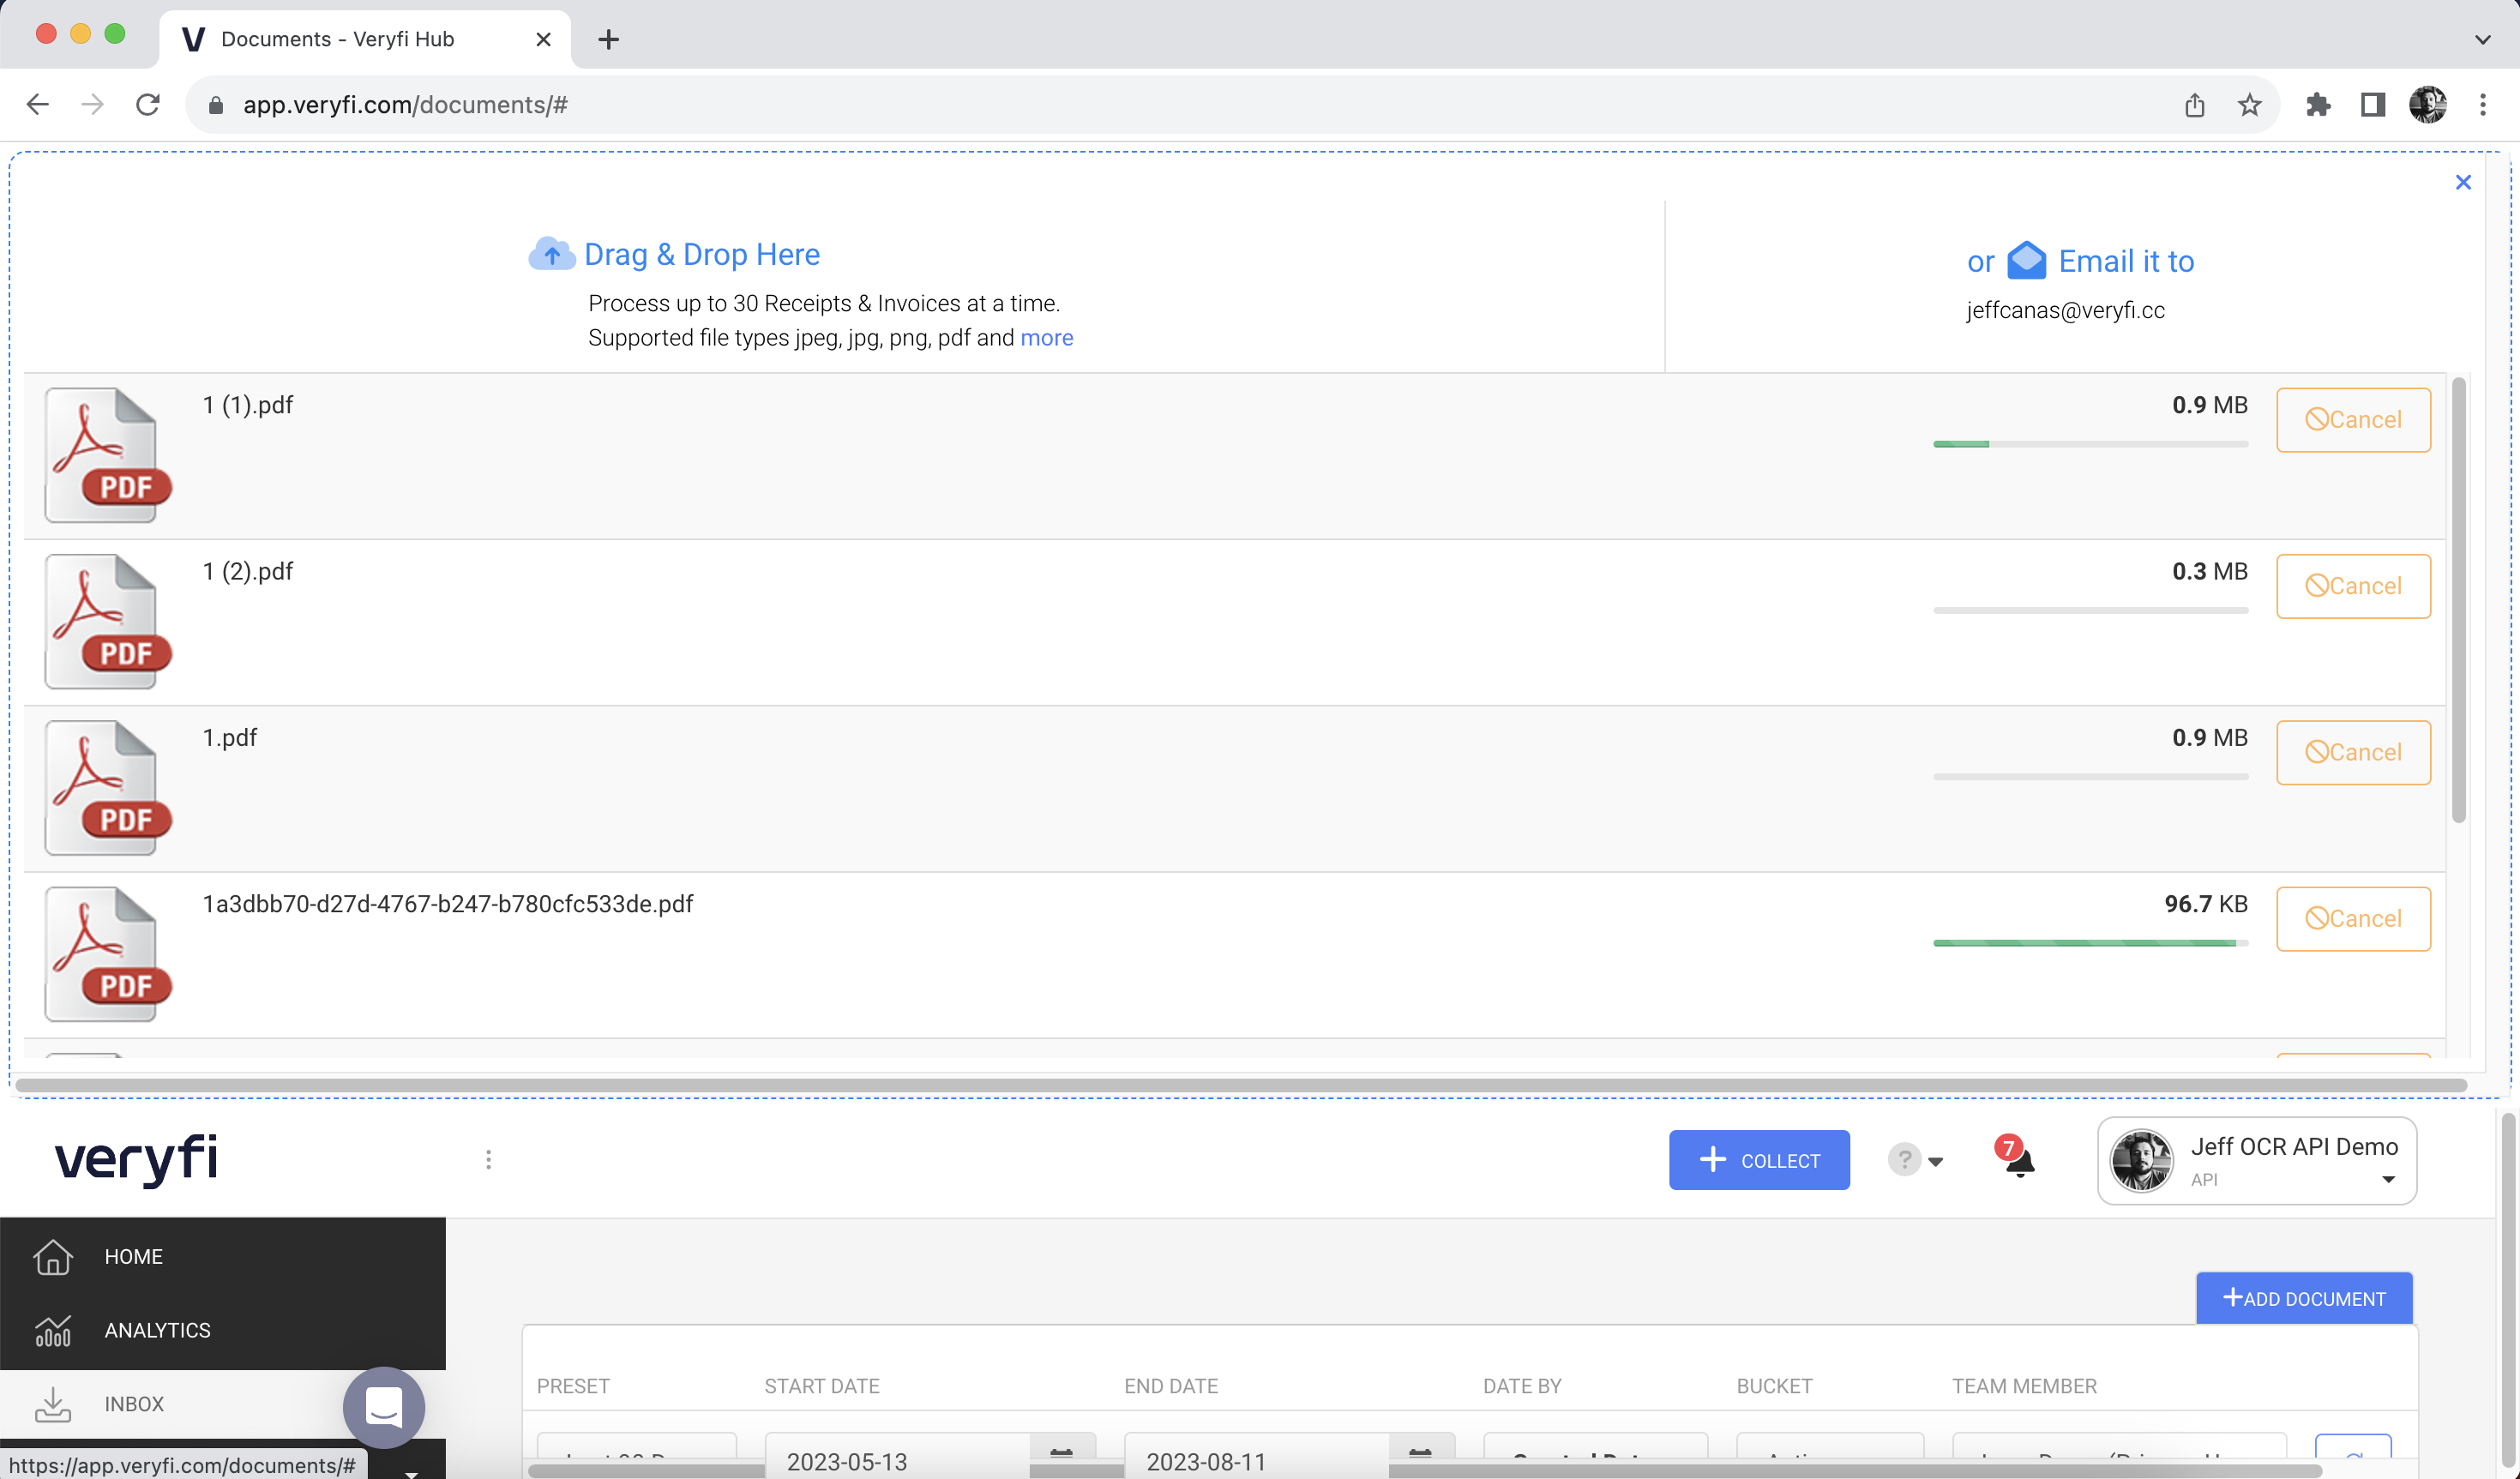
Ручная загрузка необходима не для производственного потока, а для настройки. Возьмите один типичный документ и один сложный: к примеру, чистый PDF счёта и фотографию чека со складкой или бликом. До отправки проверьте, что документ в самом деле открывается и читается. Для сканов полезно соблюдать базовые правила из инструкции Xeon Live о том, как сканировать документ без потери читаемости: заполнить кадр страницей, не срезать края, избегать бликов и держать достаточное разрешение для мелких цифр.
- В Inbox нажмите кнопку добавления документа или Collect и откройте область Drag & Drop.
- Перетащите один JPEG, PNG, PDF, HEIC или HEIF. Веб-загрузчик принимает более узкий набор форматов, чем API, по этой причине офисные документы и ZIP для теста лучше отправлять через API.
- Дождитесь окончания передачи. Не закрывайте вкладку до появления документа в очереди и не отправляйте тот же файл ещё раз только потому, что индикатор визуально задержался.
- Отыщите документ в Inbox по времени, поставщику или имени. Откройте его кнопкой View.
- Сперва сопоставьте итоговую сумму и дату, затем поставщика и номер документа, после этого переходите к line_items. Такой порядок быстро обнаруживает грубую ошибку маршрутизации или неверный тип документа.
Для снимков с плохим освещением повторная съёмка обычно полезнее агрессивной постобработки. Размытие удаляет информацию о штрихах символов, а сильный пересвет полностью стирает слабую термопечать. Резкость и контраст не восстанавливают отсутствующие пиксели. Для PDF больше 20 МБ сперва удалите пустые страницы и лишние вложения, потом примените аккуратное сжатие PDF без потери читаемости.
Проверка карточки: Data, OCR Text и JSON
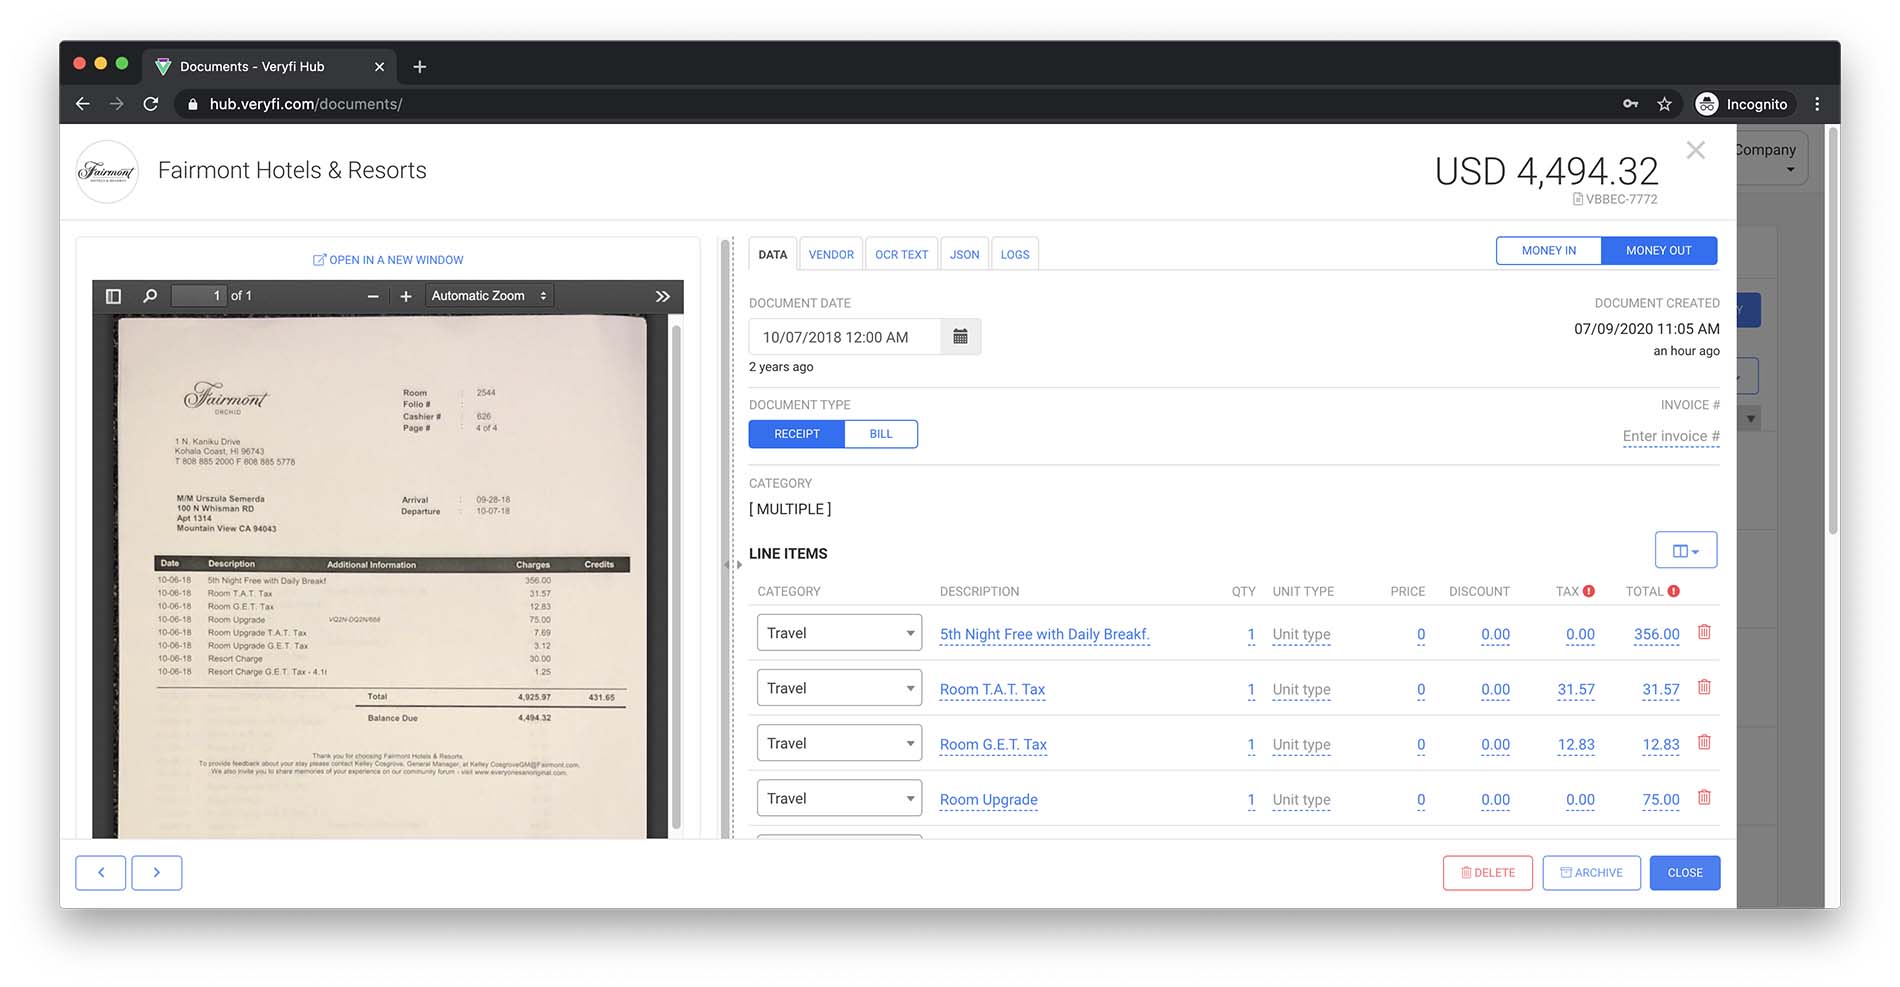
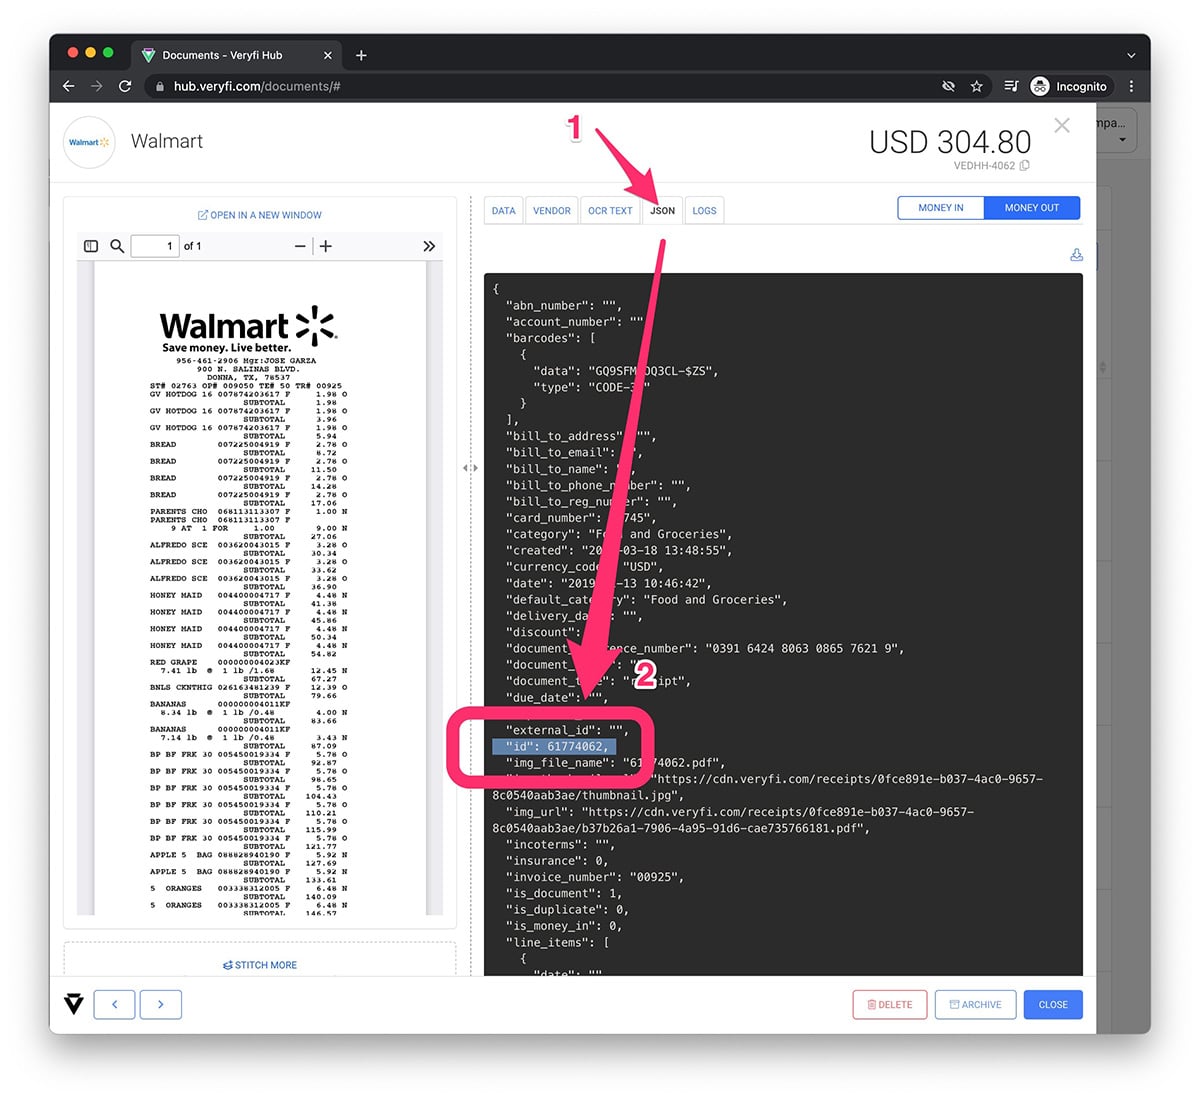
Карточка документа — главный экран проверки. Слева видна страница, справа — структурированные поля. Сперва сверяйте значение с изображением, а затем смотрите, в какое поле оно попало. Правильная цифра в неправильном узле всё равно является ошибкой для интеграции: к примеру, subtotal и total могут визуально совпасть на простом документе, но имеют различный смысл в бухгалтерском процессе.
- На вкладке Data проверьте document_type, vendor, date, currency_code, subtotal, tax и total. Для счёта отдельно проверьте invoice_number, due_date и сторону-получателя.
- Откройте line_items и сопоставьте число позиций, описание, количество, цену и итог каждой строки. Сумма строк должна согласовываться с итогами документа с учётом налогов, скидок и сборов.
- Перейдите на OCR Text. Тут полезно искать реквизит, который не попал в стандартное поле. Наличие текста при пустом структурированном поле показывает, что OCR увидел символы, но семантическая модель не собрала нужный атрибут.
- Откройте JSON. Отыщите id документа и поля, которые будет читать приложение. Сопоставьте их с визуальной карточкой, в особенности после ручной корректировки.
- Зафиксируйте несколько эталонных документов и ожидаемые значения. Не сопоставляйте весь JSON побайтно: служебные идентификаторы и временные ссылки меняются. Сопоставляйте бизнес-поля и типы данных.
Когда задача состоит лишь в распознавании текста, а не в извлечении финансовой схемы, полезно отдельно сверить подходы в материале Xeon Live про распознавание текста в PDF. Veryfi ценен именно тем, что добавляет к OCR нормализованные поля и товарные строки, но для нестандартного документа профильный JSON не всегда заменяет общий текст.
Как отправить документ через API и получить пригодный JSON
Первый POST и три метода передачи файла
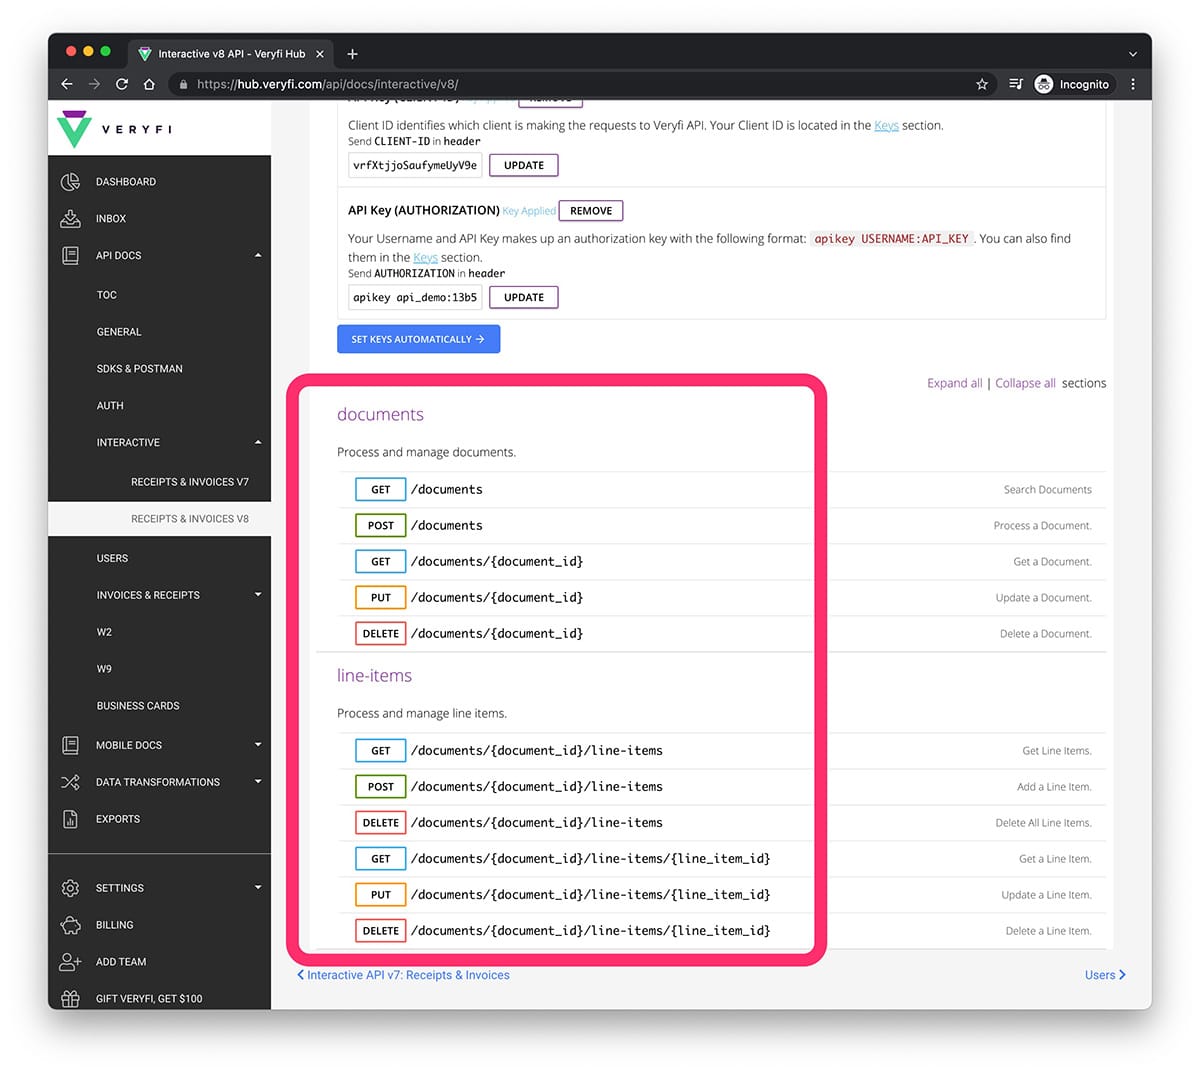
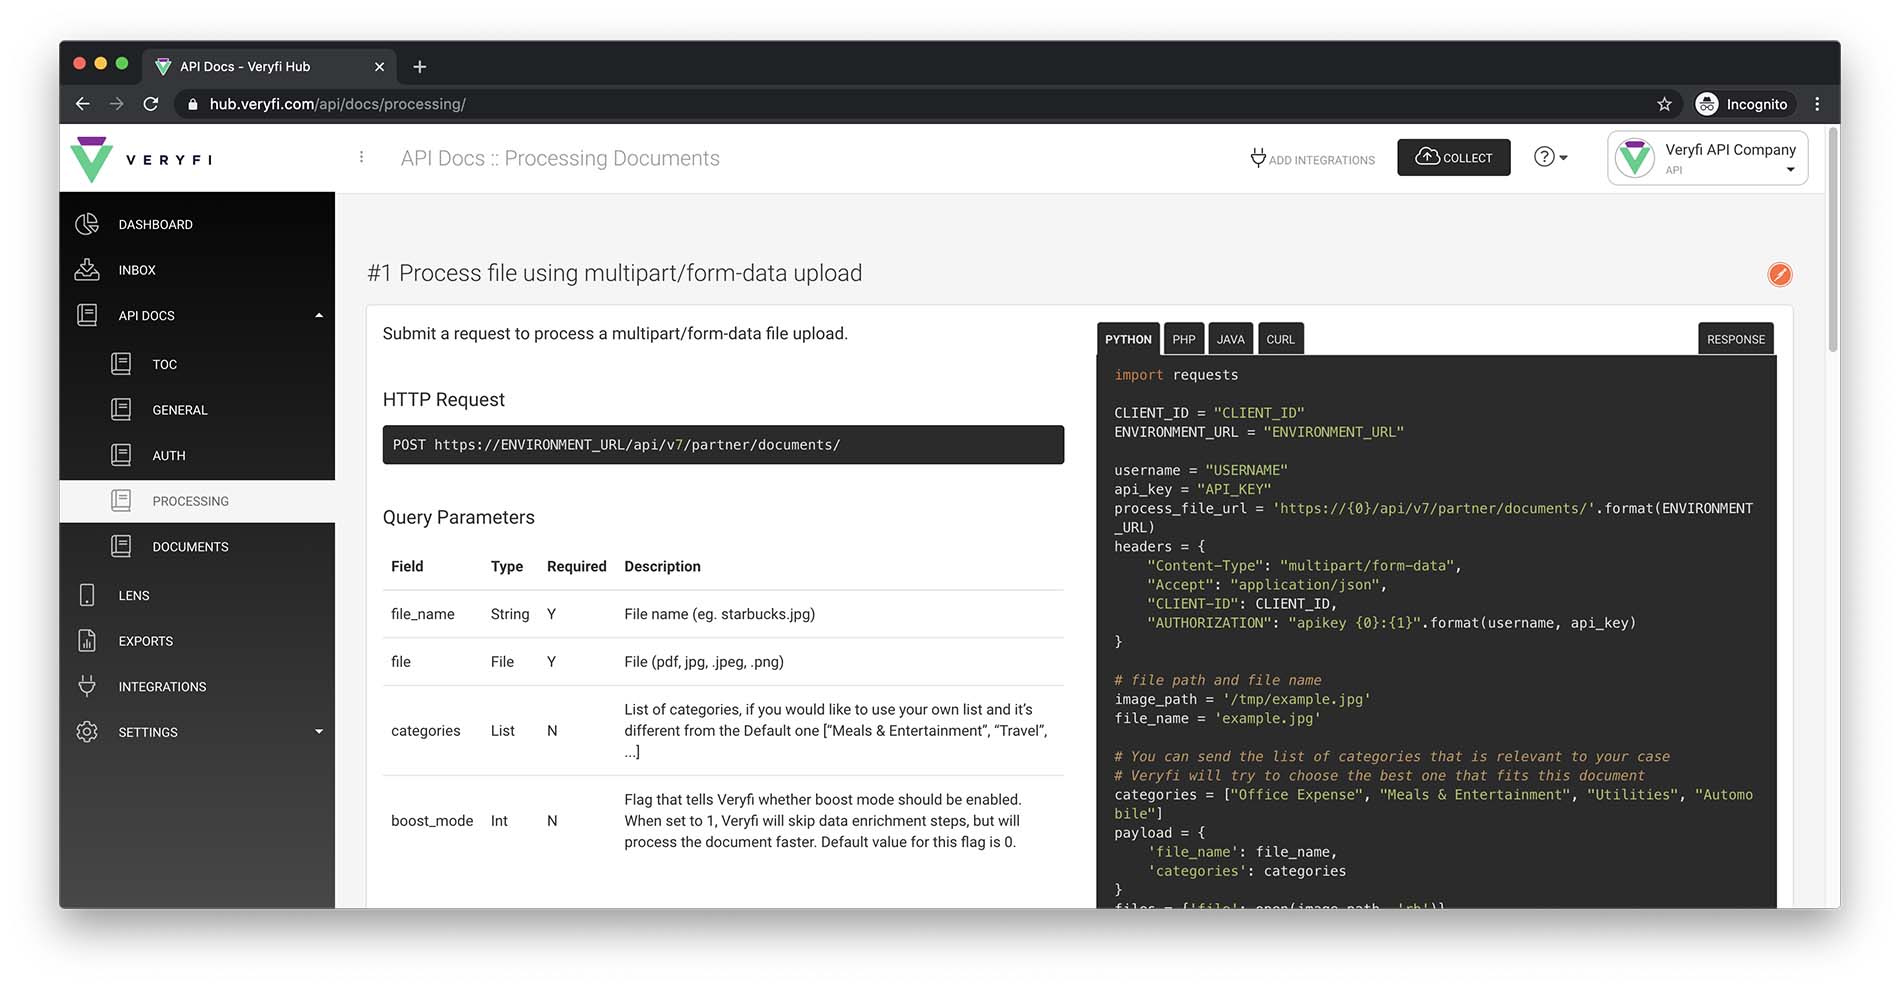
Для чеков и счетов основной вызов — POST /api/v8/partner/documents. На практике сперва стоит повторить его в Interactive API, а затем перенести те же параметры в код. Транспорт поддерживает multipart/form-data и JSON. Для локального файла проще multipart, для объекта в публичном или подписанном хранилище — file_url, для данных уже в памяти — file_data в Base64.
- Сформируйте заголовок CLIENT-ID из значения CLIENT_ID. Добавьте AUTHORIZATION в формате выбранного типа секрета.
- Для multipart/form-data приложите файл полем file. Не переименовывайте PNG в JPG без реальной конвертации: сервер ориентируется не только на суффикс, но и на содержимое.
- Добавьте external_id. Это ваш идентификатор связи с заказом, сотрудником, обращением или записью в базе. Он упрощает поиск после сетевого тайм-аута и делает повтор безопаснее.
- При надобности добавьте meta.tags. Применяйте стабильные машинные значения вроде source_email, travel_expense или ap_invoice, а не свободные варианты с различным регистром.
- Отправьте вызов и сохраните id из ответа до дальнейшей обработки. Этот идентификатор необходим для повторного GET, ручной проверки и асинхронного сценария.
- Проверьте status-код до чтения полей. При успешном ответе потом проверяйте наличие обязательных узлов и типы данных, а не обращайтесь к total или line_items вслепую.
В file_url передавайте адрес, который возвращает байты файла без интерактивного входа. Проверяйте Content-Type и срок жизни подписанной ссылки. HTML-страница ошибки с кодом 200 выглядит как успешная загрузка на уровне сети, но не является документом. Base64 увеличивает размер тела и усложняет трассировку, по этой причине его стоит применять только там, где транспорт уже работает с JSON и бинарный multipart неудобен.
ZIP применяется для нескольких файлов, составляющих один логический документ. В FAQ Veryfi указано, что порядок файлов в ZIP определяется именами по алфавиту, по этой причине страницы необходимо называть так, чтобы сортировка совпадала с реальным порядком. ZIP с независимыми счетами не заменяет PDF Splitter и не должен превращаться в один искусственный документ.
Какие поля JSON проверять и как включить координаты с confidence
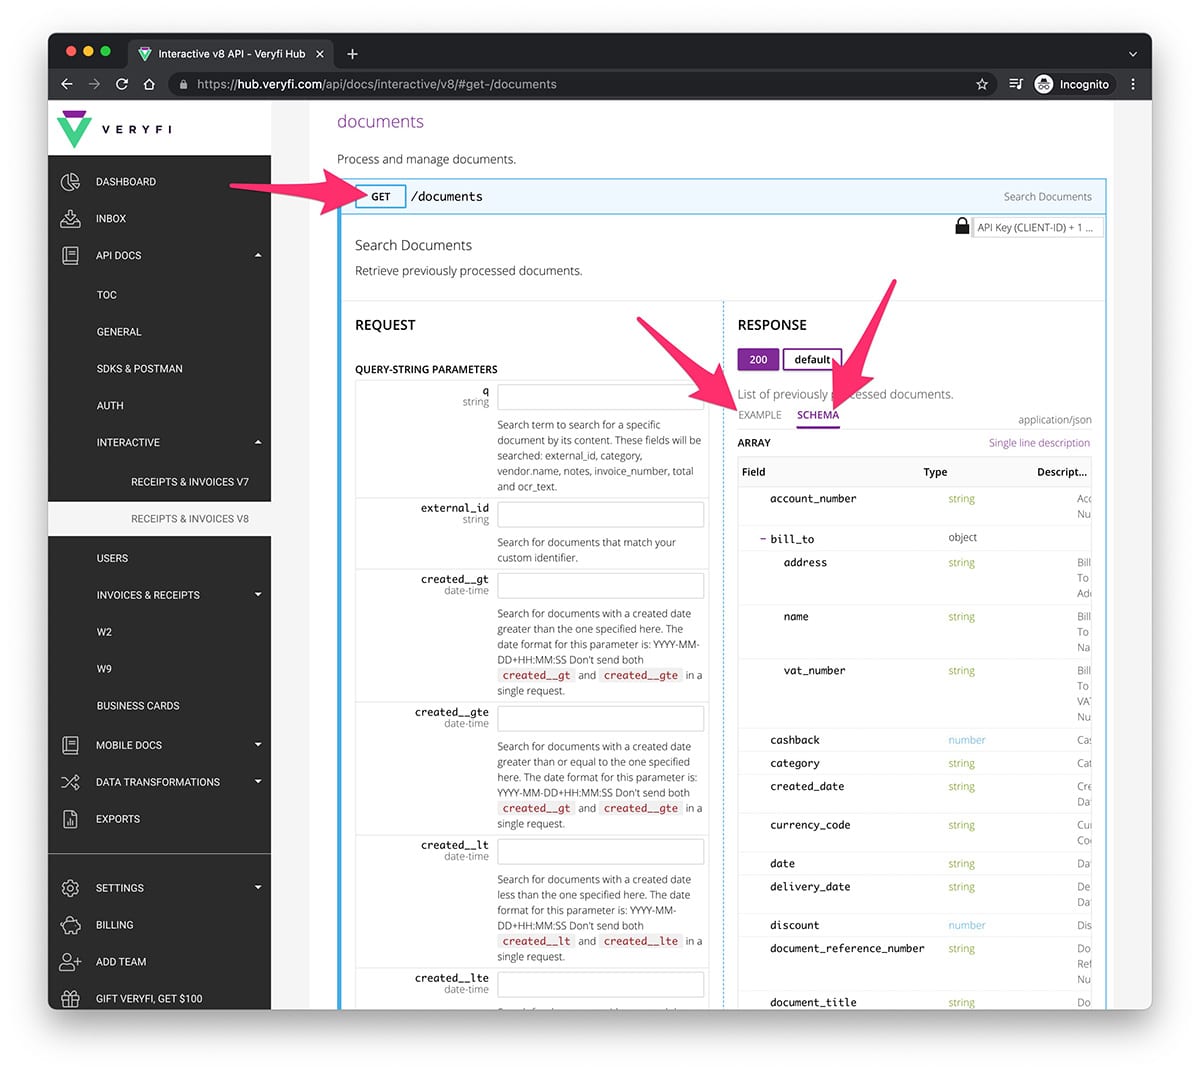
Структура ответа богаче визуальной карточки. Для интеграции важны id, document_type, vendor, даты, валюты, финансовые поля и line_items. Отдельные значения закономерно бывают null. Пустой tip не равен нулевому чаевому, отсутствующий due_date не должен превращаться в дату по умолчанию, а номер счёта лучше хранить строкой, чтобы не потерять ведущие нули и дефисы.
- Включите bounding_boxes там, где интерфейсу ручной проверки необходимы координаты источника поля. Масштабируйте координаты вместе с изображением и учитывайте поворот страницы.
- Включите confidence_details для критичных полей. Оценка уверенности полезна для маршрутизации на ручную проверку, но не заменяет арифметическую сверку и справочник поставщиков.
- Храните деньги десятичным типом. Для каждой суммы сохраняйте валюту и не применяйте двоичный float как единственный источник для проводки.
- Проверяйте даты в контексте бизнес-периода. Нормализованная дата может быть формально распознана, но короткая запись 03/04/26 остаётся неоднозначной без страны и контекста поставщика.
- Сохраняйте исходный OCR Text для аудита и резервного извлечения. Он полезен, когда нужного реквизита нет в стандартной схеме.
- После ручной правки документа выполняйте GET по id заново. Старый JSON в журнале вызова отражает состояние до корректировки и не должен считаться финальным.
Параметры необходимо включать осознанно. bounding_boxes увеличивает объём ответа и необходим в первую очередь для визуальной подсветки; confidence_details необходим для правил качества. Для простого архивного импорта без ручного интерфейса можно хранить исходник, document_id и минимальный набор полей, а расширенный ответ включать на этапах контроля и отладки.
Как настроить асинхронную обработку, вебхуки, ретраи и PDF
Асинхронный поток: webhook → GET документа → бизнес-проверка
Синхронный вызов удобен для одиночного чека, но пакетная очередь должна отделять приём документа от дальнейшего решения. Асинхронный endpoint возвращает идентификатор ранее, а событие готовности приходит на webhook. Документация Veryfi отдельно указывает, что webhook является сигналом, а полный документ необходимо получать по id. Это позволяет держать собственную схему данных стабильной и ещё раз читать документ после коррекции.
- Создайте публичный HTTPS webhook. Veryfi не принимает localhost, loopback и закрытые внутренние адреса для регистрации webhook.
- Во время регистрации обработайте проверочный POST и подтвердите secret через соответствующий endpoint. Не начинайте производственную обработку до успешного подтверждения.
- На входе webhook быстро проверьте структуру, запишите event и document id, потом поставьте задачу во внутреннюю очередь. Тяжёлые сверки не выполняйте до ответа HTTP.
- По document id выполните GET /api/v8/partner/documents/{document_id}. Включите confidence_details и bounding_boxes только там, где они необходимы downstream-системе.
- После GET примените собственную валидацию: обязательные поля, арифметика, дубликаты, поставщик, дата и допустимый статус.
- Сделайте обработчик идемпотентным по паре document_id + event. Повторный webhook не должен создавать вторую проводку или начисление.
- Добавьте сверяющую задачу: она периодически ищет документы, которые долго остаются без итога, и запрашивает их по id. Это закрывает потерянные уведомления и временные сетевые сбои.
Для Bearer-аутентификации Veryfi описывает отдельный webhook URL на уровне конкретной Bearer-учётной записи; он переопределяет общий webhook для вызовов, выполненных с этими учётными данными. Это удобно для изоляции интеграций, но требует дисциплины: при расследовании сперва проверьте настройки конкретного секрета, затем общий webhook аккаунта.
Идемпотентность, 429, 504 и многостраничные PDF
Производственный клиент должен считать сетевой тайм-аут неопределённым состоянием, а не доказательством провала. В справке Process a Document указано, что вызов, идущий дольше 120 секунд, может быть оборван балансировщиком с 504 без тела, хотя загрузка на стороне сервиса уже завершилась. Для повторов предусмотрен Idempotency-Key: одно и то же значение Idempotency-Key необходимо ещё раз отправлять для того же логического файла, чтобы получить исходный документ вместо дубля.
- Перед отправкой вычислите контрольную сумму исходника и создайте внешний идентификатор. Сохраните их вместе с Idempotency-Key и параметрами вызова.
- При 429 уменьшите параллельность и поставьте документ в очередь на повтор. Применяйте экспоненциальную задержку со случайным разбросом и учитывайте Retry-After, когда он присутствует.
- При 500 или 503 повторяйте вызов ограниченное количество раз. После исчерпания попыток переводите документ в очередь ручной проверки, не теряя файл и внешний идентификатор.
- При 504 сперва ищите документ по external_id или сохранённому id, затем повторяйте вызов с тем же Idempotency-Key. Новое значение Idempotency-Key создаёт риск отдельной записи.
- Для PDF заблаговременно считайте страницы. Стандартный лимит Process a Document — 15 страниц за вызов; параметр max_pages_to_process ограничивает объём обработки. Длинный файл разбивайте на логические документы.
- Когда один PDF содержит несколько независимых чеков или счетов, применяйте PDF Splitter, а не механическое деление по каждой странице. Один счёт может занимать несколько листов и потерять связь шапки с позициями при неправильном разбиении.
Крупный поток ограничивайте до обращения к API. Очередь и семафор дают предсказуемую конкуренцию и не допускают лавину повторов после краткого сбоя. Отдельные очереди для коротких изображений и длинных PDF помогают не блокировать быстрые задачи тяжёлыми файлами. Метрику задержки считайте от приёма исходника до валидированного итога, а не только по продолжительности HTTP-вызова.
401 Unauthorized
Проверьте CLIENT-ID, формат AUTHORIZATION, состояние секрета и отсутствие лишних пробелов. Standard key применяет apikey USERNAME:API_KEY, Bearer — Bearer API_KEY.
403 Forbidden лишь на части методов
Для Scoped Bearer это признак отсутствующего разрешения на конкретный route. Проверьте scope секрета и не расширяйте права сильнее, чем требуется интеграции.
429 Too Many Requests
Уменьшите параллельность, поставьте вызов в очередь и повторите позднее с backoff. Увеличение HTTP timeout не устраняет лимит частоты.
504 без тела ответа
Сперва проверьте, создался ли документ. Повтор выполняйте с тем же Idempotency-Key, чтобы не создавать дубль.
Документ принят, но поля пустые
Сверьте тип endpoint-а, читаемость исходника, OCR Text и число обработанных страниц. Текст при пустых бизнес-полях указывает на несоответствие специализированной схемы макету документа.
PDF обработан не полностью
Сопоставьте реальное количество страниц с max_pages_to_process и лимитом метода. Разделите длинный файл или примените PDF Splitter для пакета независимых документов.
Как проверить качество, настроить ручной контроль и измерять точность
Accuracy Reports: baseline, Run Trial и разбор расхождений
Accuracy Reports находится в Analytics → Accuracy Reports и предназначен для регрессионного тестирования на собственном наборе. Baseline — это ground truth: документы, в которых проверяемые поля ручным способом подтверждены и исправлены. Официальная инструкция рекомендует 50–100 документов для устойчивого набора, допускает старт с 5–20 и указывает максимум 150 для одного baseline. Ценность инструмента в повторяемости: одна и та же выборка прогоняется после изменений модели, а итог сопоставляется по конкретным полям.
- Соберите типичные документы, сложные макеты и пограничное качество. Не формируйте baseline только из идеальных чеков одного поставщика.
- Отметьте набор единым тегом и отфильтруйте его в Inbox. Перед созданием отчёта откройте каждый документ и исправьте все поля, которые будут участвовать в метрике.
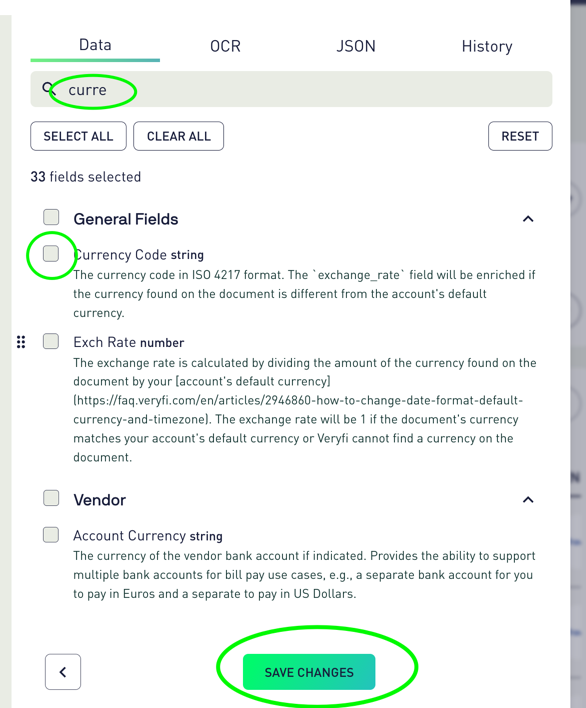
- Создайте Accuracy Report, выберите тип документа и только значимые поля. Для AP это обычно номер счёта, даты, поставщик, валюта, суммы и line_items; для лояльности — магазин, дата, позиции и идентификаторы товаров.
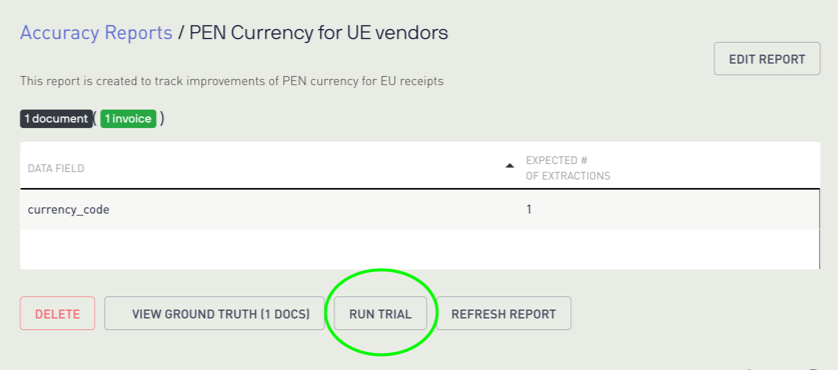
- Добавьте документы из baseline и запустите Run Trial. Система ещё раз обрабатывает их на выбранной модели и сопоставляет итог с ground truth.
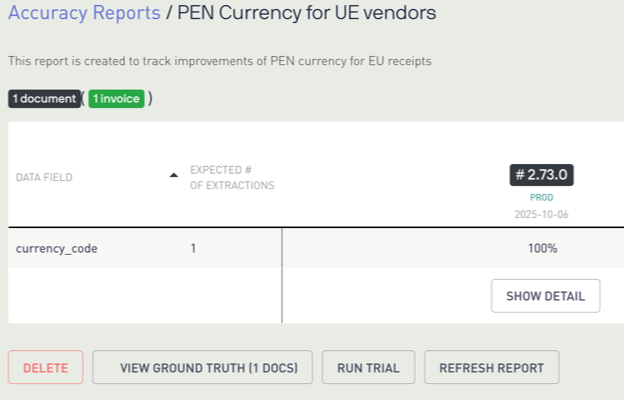
- Откройте Show Details для расхождений. Смотрите одновременно на извлечённое значение, baseline и исходную страницу, чтобы отделить ошибку модели от ошибки эталона.
- Храните дату, состав baseline и выбранные поля рядом с итогом. Процент двух прогонов нельзя напрямую сопоставлять после изменения набора документов.
Не сводите качество к одной средней цифре. Точность vendor_name и category может быть высокой, но ошибка total всё равно делает автоматическую выплату опасной. Поля необходимо группировать по стоимости ошибки: финансовые суммы и банковские реквизиты получают строгий контроль, аналитические категории — мягкий. Для line_items отдельно полезно считать полноту строк, правильность количества и числовых столбцов.
Бизнес-валидация: как принять документ без слепого доверия confidence
Confidence — это сигнал модели, а не бухгалтерское решение. Высокая уверенность встречается и при систематической ошибке макета. По этой причине автоматическое принятие строится слоями. Первый слой проверяет наличие обязательных полей; второй — арифметику и справочники; третий — дубликаты и риск. Только документ, прошедший все нужные слои, можно передавать дальше без участия оператора.
- Определите минимальный набор полей для каждого процесса. Для расхода это поставщик, дата, валюта и итог; для счёта добавляются номер и стороны; для банковского документа набор другой.
- Сверьте total с subtotal, налогом, скидкой, доставкой и line_items. Допускайте только заблаговременно описанную погрешность округления.
- Сопоставьте поставщика со справочником по нескольким признакам. Нормализованное наименование удобно для аналитики, но юридическое лицо подтверждается реквизитами, а не брендом.
- Проверьте дату относительно допустимого периода и бизнес-события. Счёт из будущего или слишком старый чек может быть распознан правильно, но нарушать политику процесса.
- Проверьте дубликаты по document id, external_id, хэшу, поставщику, времени, сумме и товарным строкам. Один признак не должен автоматически удалять запись.
- Низкую уверенность критичного поля направляйте оператору вместе с фрагментом исходника. Исправление должно сохранять историю, чтобы метрики различали исходное извлечение и ручную правку.
Хороший производственный запуск начинается с теневого режима. Veryfi извлекает данные и ваша логика принимает решение, но сотрудник некоторое время продолжает текущий процесс. Расхождения записываются по причинам. После этого автоматизация включается по типам документов и поставщикам, для которых контрольный набор показал стабильный итог. Такой порядок уменьшает риск незаметно автоматизировать не распознавание, а ошибочную интерпретацию.
Преимущества, недостатки, альтернативы и кому подходит Veryfi OCR API
Veryfi OCR API в особенности уместен там, где необходим не просто распознанный текст, а готовые финансовые поля, line_items, веб-интерфейс проверки и API для массового потока. Сервис не заменяет редактор PDF и не решает бизнес-политику за компанию. Он занимает промежуточный слой между входящим документом и учётной системой: извлекает данные, а приложение проверяет и применяет их по собственным правилам.
Плюсы
- Готовый JSON для чеков, счетов и других профильных типов документов вместо одного сырого OCR-текста.
- Line items с отдельными позициями, ценами и добавочными атрибутами, полезные для расходов, закупок и программ лояльности.
- API Hub с Inbox, карточкой документа, OCR Text, JSON и инструментами ручной проверки.
- Синхронная и асинхронная схемы, webhook и повторное получение документа по id.
- Координаты полей и confidence_details для собственного интерфейса проверки.
- Accuracy Reports для измерения качества на фиксированном baseline, а не по отдельным удачным примерам.
- Поддержка file upload, file_url, Base64, ZIP и многостраничного PDF в пределах ограничений конкретного endpoint-а.
Минусы
- Сервис требует серверной интеграции и дисциплины вокруг учётных данных, очередей, повторов и схемы данных.
- Ограничение 20 МБ и стандартный лимит 15 страниц у основного endpoint-а требуют подготовки крупных пакетов.
- Это не PDF-редактор: перестановка страниц, визуальное редактирование текста, подпись и подготовка к печати выполняются другими инструментами.
- Confidence нельзя применять как единственный критерий автоматического принятия — бизнес-валидация остаётся обязательной.
- Веб-загрузчик поддерживает меньше форматов, чем API, по этой причине часть файлов тестируется только программно.
- Некоторые актуальные функции учётных данных Bearer/Scoped на 2026 год находятся в beta и зависят от включения в аккаунте.
Кому подойдёт
- Финтех- и бухгалтерским продуктам, которые массово извлекают реквизиты из счетов и чеков.
- Системам расходов сотрудников, где важно заранее заполнить отчёт и отправлять спорные поля на проверку.
- Программам лояльности и CPG-сценариям, где необходимы товарные строки и защита от повторной подачи одного документа.
- Командам, которым необходим кабинет оператора рядом с API и возможность измерять точность на своей выборке.
Кому не подойдёт
- Пользователю, которому необходимо ручным способом открыть и отредактировать один PDF на компьютере без интеграции.
- Проекту, где достаточно полнотекстового OCR огромного архива без извлечения бизнес-полей: поверх такого потока всё равно понадобятся хранилище и поисковый индекс.
- Процессу с очень большими многостраничными пакетами, которые нельзя заблаговременно разделить на логические документы.
- Сценарию, где итог автоматически вызывает финансовое действие без независимой проверки критичных реквизитов.
Среди облачных альтернатив Google Cloud Document AI предлагает отдельные OCR- и Invoice Parser-процессоры, а Amazon Textract — AnalyzeExpense и асинхронную обработку многостраничных PDF/TIFF. Azure AI Document Intelligence содержит предобученные модели invoice и receipt. Эти платформы тесно связаны со своими облачными экосистемами. Veryfi отличается фокусом на документных бизнес-полях, line_items, операторском Inbox и готовых инструментах контроля качества. Для локальной работы без API полезнее настольный OCR/PDF-инструмент; на Xeon Live, к примеру, есть Cisdem PDF Converter OCR. Для другого облачного API можно посмотреть Cloudmersive OCR API.
Практический выбор строится от итога. Для счетов, чеков, товарных строк и операционного контроля Veryfi закрывает значительную часть конвейера готовой схемой. Для универсального OCR и тесной интеграции с GCP, AWS или Azure соответствующие облачные сервисы дают естественную инфраструктурную связку. Для одиночной ручной работы с PDF разумнее локальное приложение. В любом варианте качество стоит оценивать на собственном наборе документов, потому что макеты, языки, валюты и условия съёмки сильнее влияют на реальный процесс, чем демонстрационный пример.
Итоговая рабочая схема для Veryfi выглядит так: качественный исходник → корректный профиль документа → уникальный external_id и идемпотентный вызов → JSON с типизированными полями → арифметическая и справочная проверка → ручной контроль спорных значений → передача в целевую систему. Именно такая последовательность превращает OCR из удобного демо в предсказуемый этап документооборота.