
unpaper — консольный инструмент для подготовки растровых сканов: он очищает крупные тёмные поля и точечный мусор, помогает отыскать полезную область, исправляет небольшой перекос и приводит страницы к повторяемой геометрии. На Xeon Live можно скачать unpaper бесплатно; дальше важнее всего сперва подобрать безопасный профиль на нескольких различных листах, а уже потом запускать длинную серию.
Программа не заменяет сканер, OCR-систему или редактор PDF. Её сильная сторона — промежуточный этап между получением изображений и последующей сборкой документа: одни и те же параметры можно воспроизводимо применить к сотням однотипных страниц. Разнородные книги лучше делить на несколько профилей, чем усиливать фильтры для всех файлов одновременно.
Что делает unpaper и где он полезен
Источник иллюстрации: unpaper / Xeon Live
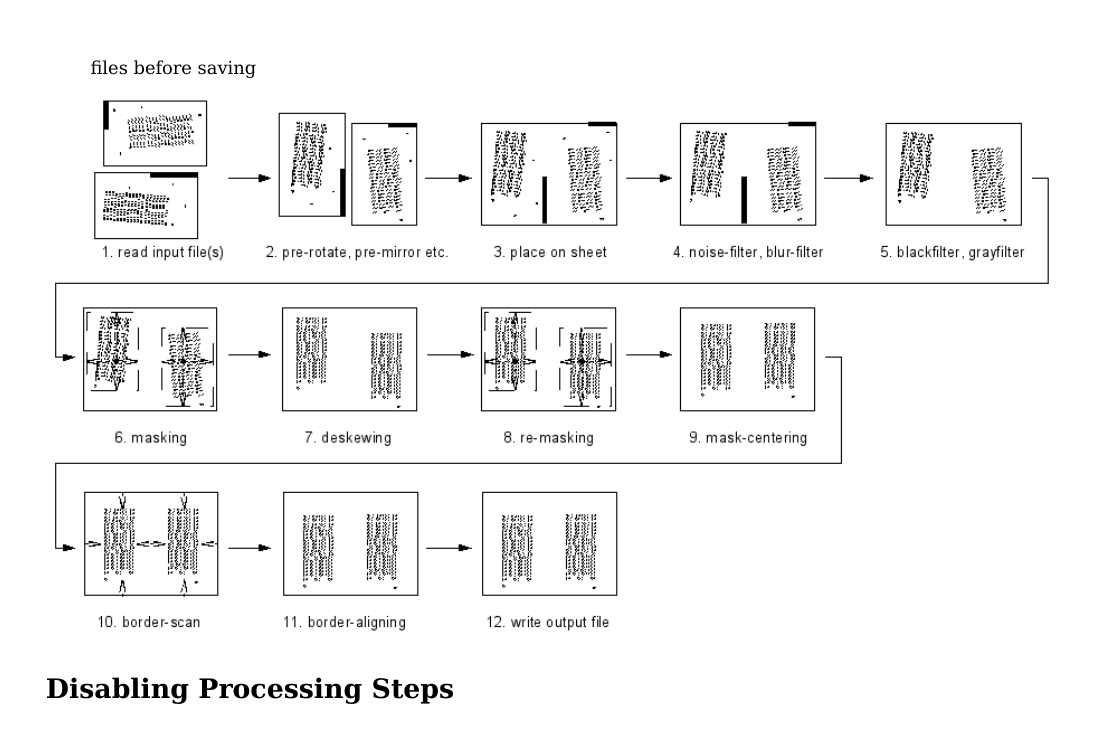
unpaper работает как пакетный препроцессор сканов. Входной файл помещается на виртуальный лист, после чего программа в фиксированном порядке применяет ранние фильтры, ищет маски содержимого, оценивает небольшой угол наклона, ещё раз уточняет маски, центрирует их, определяет границы и сохраняет итог. Порядок этих этапов не меняется от перестановки аргументов, по этой причине диагностику удобно вести слева направо по конвейеру: сперва чтение и исходная геометрия, потом очистка, затем маски, deskew и поля.
У unpaper нет интерактивного окна с ползунками и предпросмотром. Все параметры задаются в командной строке, а итог оценивается во внешнем просмотрщике. Для небольшой коллекции уникальных страниц такой метод может оказаться медленнее визуального редактора, зато на одинаковых сканах он хорошо воспроизводится в сценариях автоматизации, в ночной пакетной обработке и в конвейерах подготовки архива.
Лучший исходный материал — кадры с одинаковым разрешением, ориентацией и близким положением бумаги. Если процесс получения сканов ещё не стабилизирован, сперва стоит выстроить этот этап; отдельная инструкция по сканированию документов в PDF помогает организовать захват страниц. unpaper хорошо исправляет тёмные рамки, фоновые дефекты и небольшой общий наклон, но не предназначен для сильной перспективы снимка с камеры и сложного распрямления выгнутых строк у корешка.
Как unpaper понимает sheet и page
Источник иллюстрации: unpaper / Xeon Live
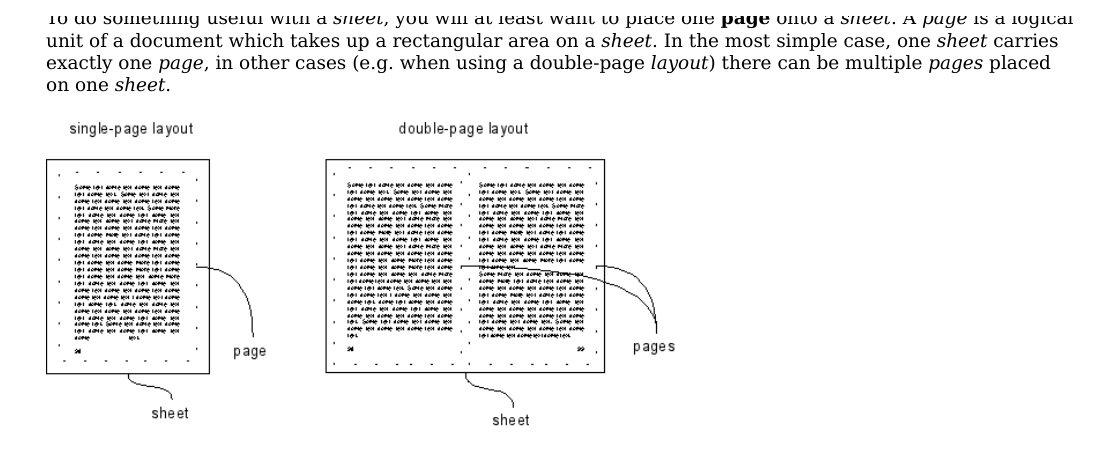
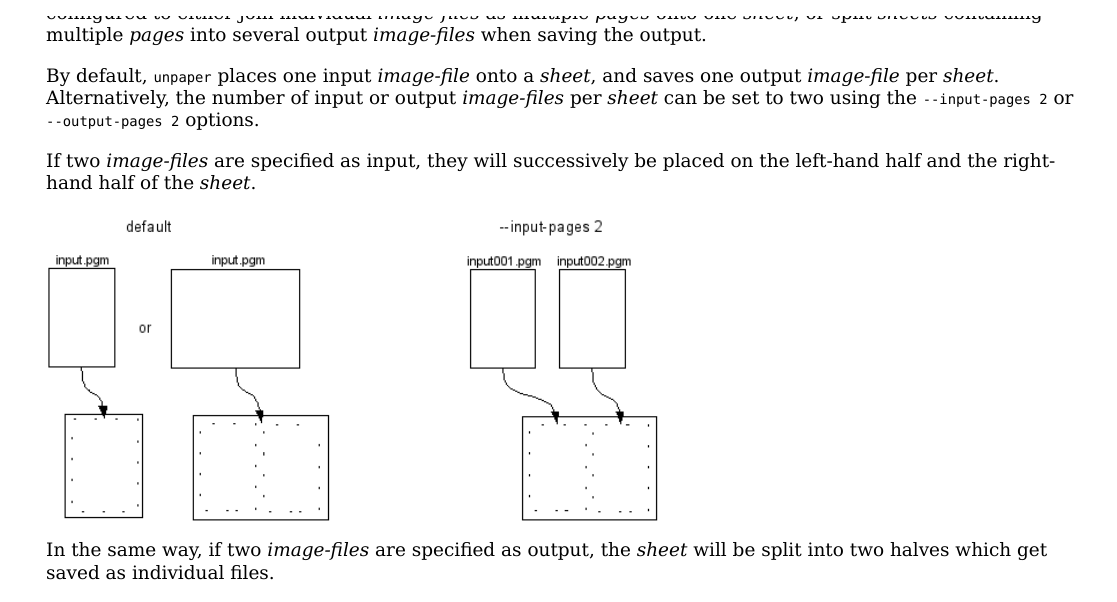
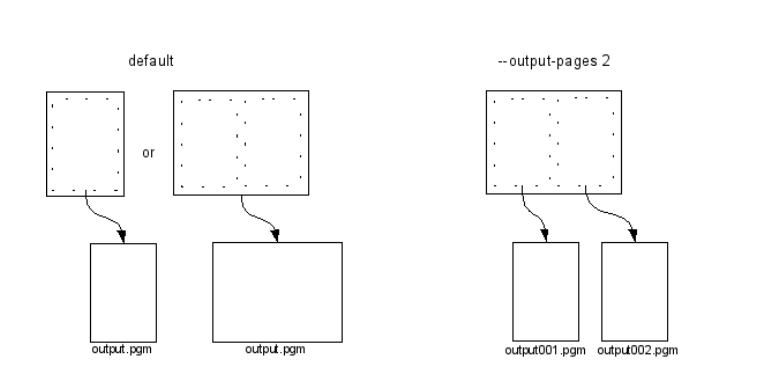
В терминологии программы sheet — рабочий лист в памяти, а page — прямоугольная логическая область документа на этом листе. По умолчанию один входной файл формирует один sheet и даёт один выходной файл. Параметр --input-pages 2 помещает два последовательных изображения на один лист, а --output-pages 2 делит готовый лист на две части при сохранении. Эти режимы независимы от --layout: layout описывает расположение полезных областей, а input-pages и output-pages — число файлов чтения и записи на один sheet.
Разделение понятий в особенности важно для книг. Один файл с разворотом можно обработать как sheet с layout double и вывести двумя файлами. Две отдельно отсканированные страницы можно, наоборот, собрать на один sheet через input-pages 2. Неверное сочетание параметров часто даёт не явную ошибку, а неправильную маску, смещённый текст или неожиданную нумерацию, по этой причине схему входов и выходов лучше записать до пакетного запуска.
Для форматов полезно держаться простого правила. Документация unpaper описывает PNM как наиболее предсказуемый рабочий набор: PBM — двухцветный растр, PGM — восьмибитный серый, PPM — RGB. Чтение реализовано через FFmpeg, но поддержка сложных TIFF и отдельных пиксельных форматов зависит от библиотек. Вывод ориентирован на PNM, а PDF, PNG или TIFF создаёт следующий инструмент. Для обычной текстовой книги чаще всего практичен PGM: он сохраняет полутона и тонкие штрихи, но заметно экономнее PPM.
Источник иллюстрации: unpaper / Xeon Live
Источник иллюстрации: unpaper / Xeon Live
Источник иллюстрации: unpaper / Xeon Live
Источник иллюстрации: unpaper / Xeon Live
Как подготовить первый безопасный запуск
Источник иллюстрации: unpaper / Xeon Live
Первую рабочую команду строят от контролируемого минимума. Цель — убедиться, что файл читается, размер листа понятен, путь вывода не пересекается с исходником и лишь после этого включать очистку. Берите не самый красивый кадр, а типичный: обычная плотность текста, средние поля и характерные для серии дефекты. Исходник храните отдельно и никогда не применяйте обработанный файл как единственную копию.
- Шаг 1. Приведите тестовый кадр к понятному формату. Для чёрно-белой книги оставьте серый PGM, для цветной страницы с важными печатями или иллюстрациями применяйте PPM. Размер изображения на данном этапе не меняйте.
- Шаг 2. Проверьте чтение и запись без фильтров: unpaper --no-processing --no-multi-pages input.pgm output-baseline.pgm. Откройте итог и сопоставьте размеры с исходником.
- Шаг 3. Проведите анализ без записи: unpaper -vv --test-only --no-multi-pages input.pgm output-test.pgm. Детальный вывод показывает активные параметры, размеры и логику обработки.
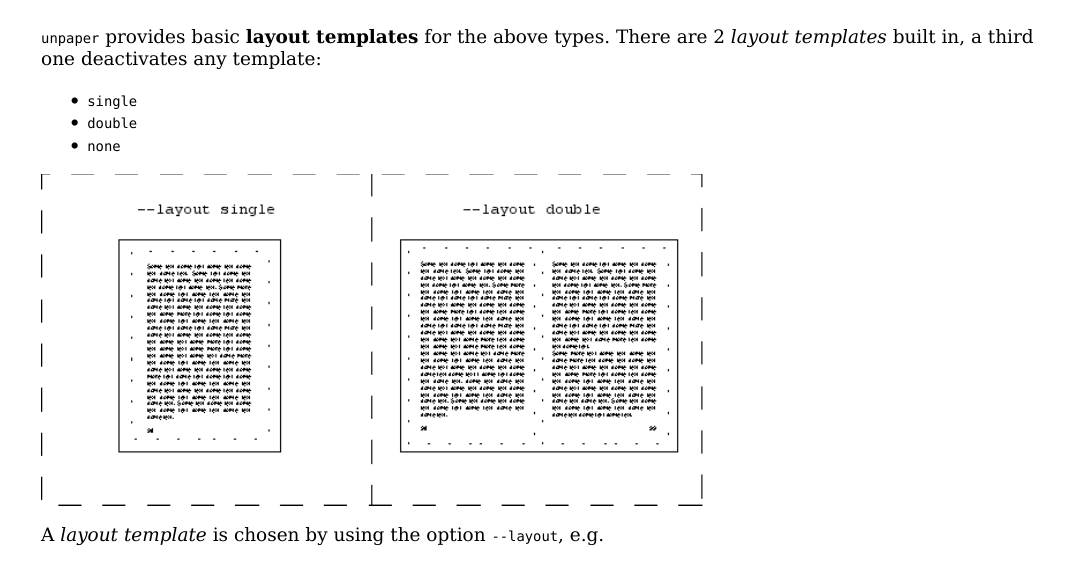
- Шаг 4. Для одиночной страницы явно задайте --layout single. Для разворота применяйте --layout double. --layout none оставляют для ручной геометрии и нетипичных масок.
- Шаг 5. Во время настройки не добавляйте --overwrite автоматически. Записывайте каждый эксперимент в отдельный файл, чтобы не потерять удачный вариант и иметь исходный итог для сравнения.
- Шаг 6. После каждого изменения проверяйте мелкий текст, точки, запятые, номера страниц, тонкие линии таблиц, края иллюстраций и внутреннее поле при увеличении 100–200 процентов.
Порядок аргументов важен там, где один параметр разворачивается в набор других настроек. --layout подставляет шаблон масок и связанных значений, по этой причине индивидуальные переопределения ставят после layout. То же относится к --dpi: разрешение задают до размеров в физических единицах, потому что программа переводит такие размеры в пиксели во время разбора аргументов.
Если неизвестно, какой этап портит страницу, включайте или отключайте обработку последовательно. Начните с --no-processing. Затем вернитесь к обычному проходу и по одному проверяйте --no-noisefilter, --no-blurfilter, --no-blackfilter, --no-grayfilter, --no-mask-scan, --no-deskew и --no-border. В результате вы не угадываете порог, а отыскиваете конкретный этап, после которого исчезает нужная деталь.
Сохраняйте полную команду и вывод -vv рядом с контрольным сканом. Один профиль должен однозначно описывать формат входа, DPI, layout, фильтры, маски, deskew, границы и схему имён. На дату проверки ветка 7.0.0 доступна в пакетных каталогах Debian, Homebrew и MSYS2; метод установки отличается по системе, но после установки всегда полезно сперва проверить unpaper --version в том же окружении, где будет работать пакетный сценарий.
Одиночная страница: очистка, маска, deskew и поля
Источник иллюстрации: unpaper / Xeon Live
Для обычной книжной страницы или офисного листа настройку удобно вести в порядке реального конвейера. Не добивайтесь максимально белого фона на первом проходе: сперва сохраните всё значимое содержимое, потом уменьшайте мусор. Базой служит команда с layout single и одним выходом, а остальные параметры добавляются по одному после визуальной проверки.
- Шаг 1. Исправьте грубую ориентацию. Если лист повернут на 90 градусов, применяйте --pre-rotate 90 или --pre-rotate -90. Deskew предназначен для небольшого остаточного угла и не должен исправлять четверть оборота.
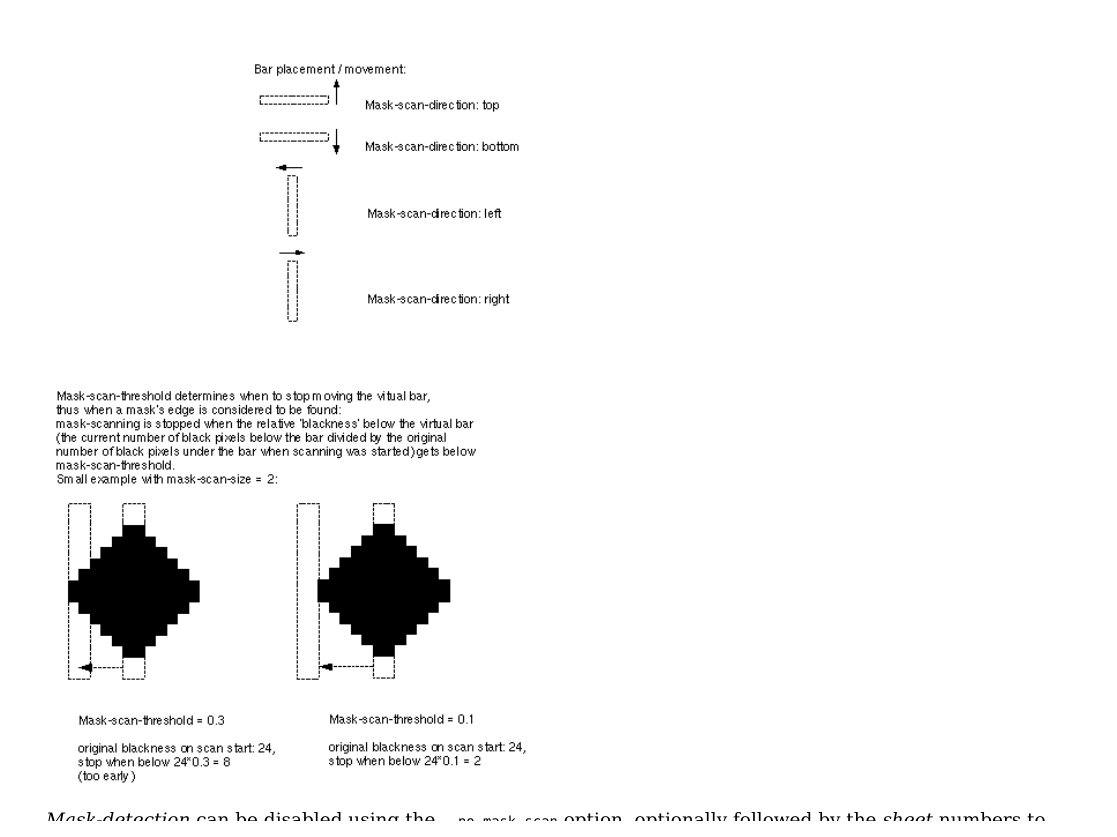
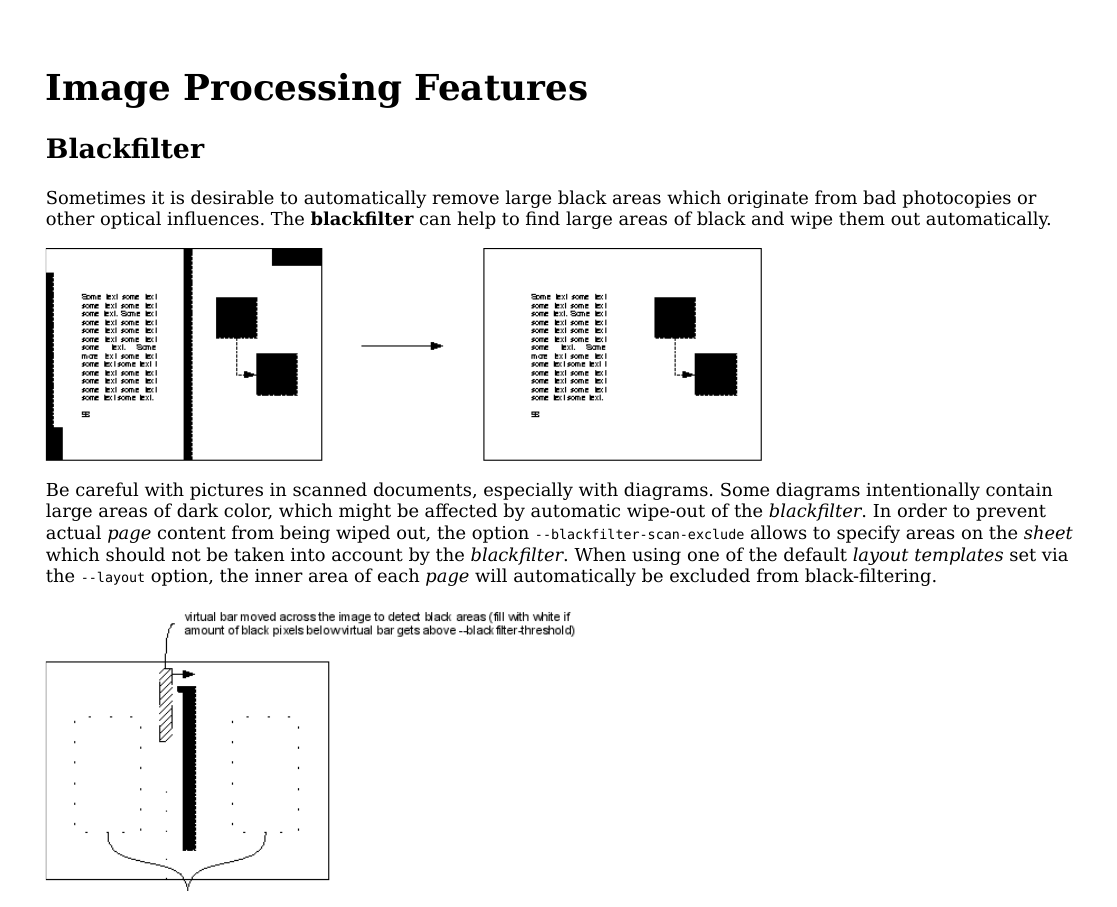
- Шаг 2. Проверьте blackfilter. Оставляйте его лишь при реальных чёрных полях, тенях у корешка или тёмном фоне вокруг бумаги. Сперва ограничьте направление и глубину поиска, потом меняйте порог. Плотную иллюстрацию у края защищайте через --blackfilter-scan-exclude или отдельный профиль.
- Шаг 3. Настройте noisefilter. Повышайте --noisefilter-intensity постепенно. После каждого прохода смотрите точки над буквами, знаки препинания, нижние индексы и мелкие сноски. Когда пыль сравнима по размеру с пунктуацией, часть шума лучше сохранить.
- Шаг 4. Оцените blurfilter и grayfilter. Они помогают против мягких теней и серого фона, но опасны для фотографий, водяных знаков, цветных печатей и тонкой серой сетки. На таких страницах начните с --no-blurfilter и --no-grayfilter.
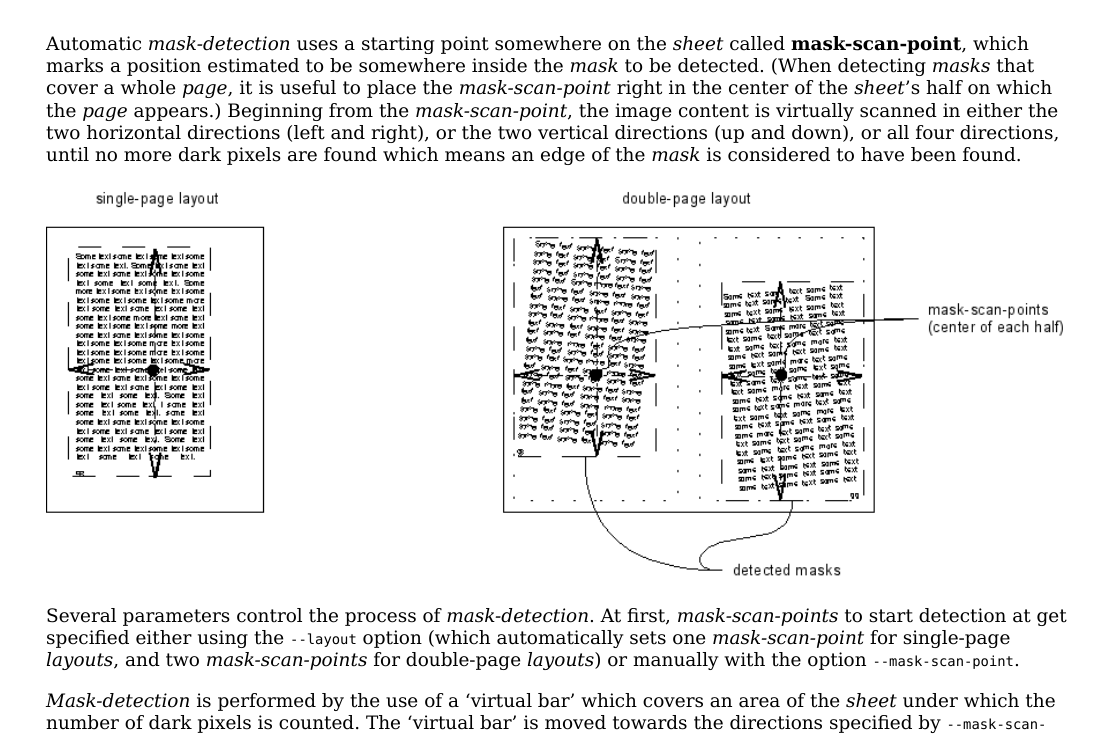
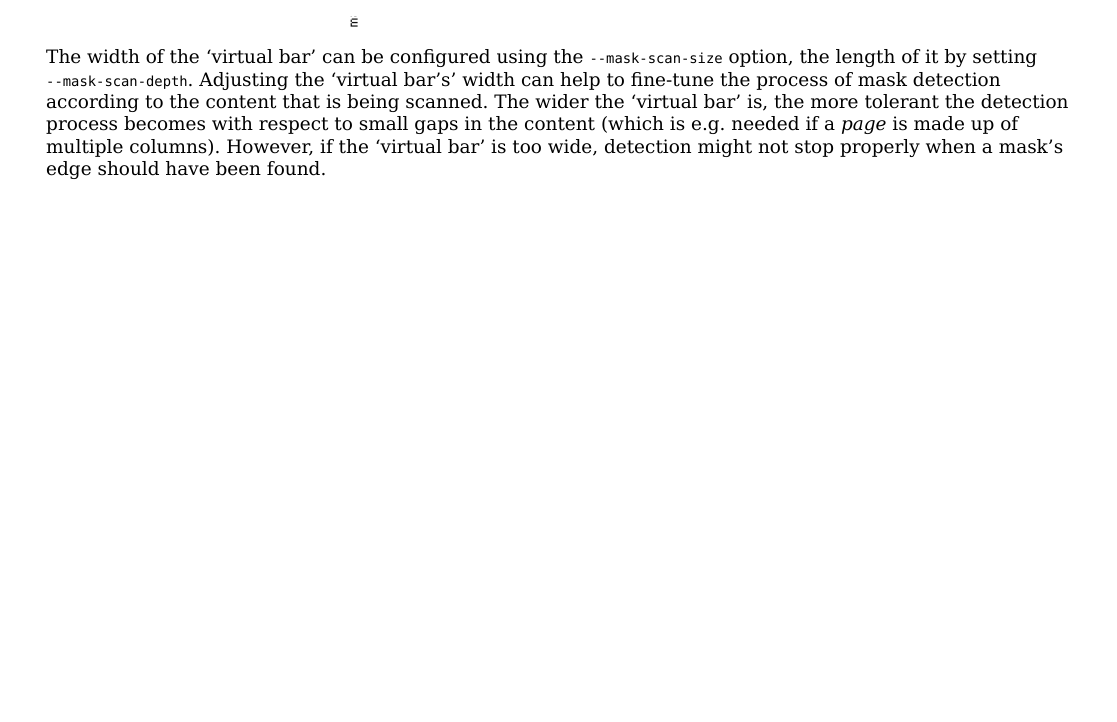
- Шаг 5. Отыщите полезную область. Автоматическая маска расширяется от --mask-scan-point. Для сканера с постоянным положением бумаги ручной --mask часто стабильнее. Номер страницы, подпись и печать должны оставаться внутри области.
- Шаг 6. Выполните deskew. Начинайте с узкого --deskew-scan-range и направлений left,right. Уменьшение --deskew-scan-step повышает точность и время. Если угол определяется по корешку или диагональной графике, сперва исправьте маску.
- Шаг 7. Настройте границы. Border-scan удобен на чистом поле; при нестабильном фоне ручной --border надёжнее. --border-align перемещает содержимое к выбранной стороне, а --border-margin добавляет одинаковый отступ без растяжения букв.
- Шаг 8. Выберите тип итога. Для серого текста применяйте PGM, для цвета PPM, для проверенного бинарного документа PBM. При повороте nearest сохраняет жёсткие края, а linear и cubic создают промежуточные оттенки.
- Шаг 9. Проверьте итог. Сопоставьте исходник и выход на одинаковом масштабе. Контролируйте не только фон, но и форму символов, толщину штрихов, рамки таблиц, подписи, печати, края картинок и симметрию полей.
Как подбирать фильтры и маски без потери деталей
Источник иллюстрации: unpaper / Xeon Live
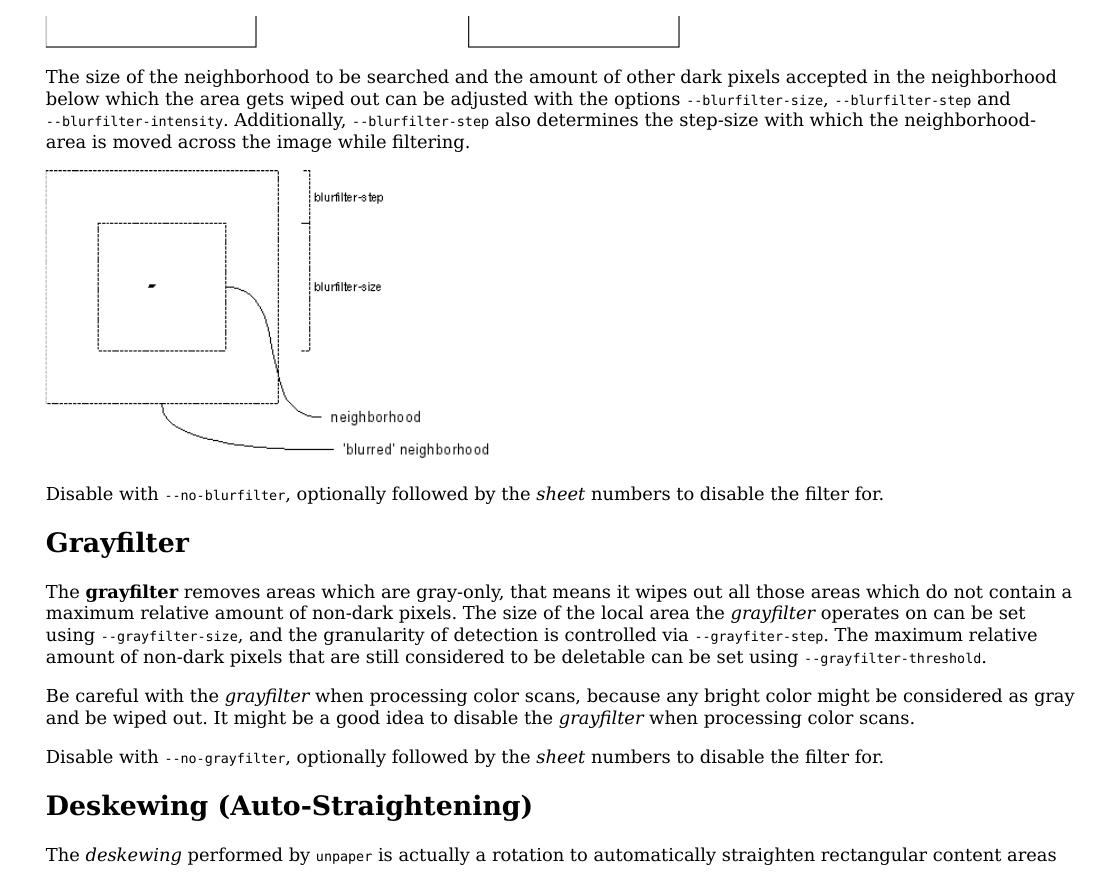
Каждый фильтр принимает решение по геометрии и яркости, а не по смыслу документа. Blackfilter ищет крупные тёмные области, noisefilter — небольшие изолированные кластеры, blurfilter — локальные фрагменты с редкими тёмными соседями, grayfilter — участки, похожие на серый фон. Для алгоритма точка в букве, пылинка и маленькая печать — всего лишь различные группы пикселей, по этой причине абсолютного безопасного порога для всех страниц не существует.
Подбирайте параметры методом одного изменения. Сперва сопоставьте несколько значений noisefilter-intensity при неизменной геометрии. Затем вернитесь к лучшему варианту и отдельно проверьте grayfilter-threshold. Имена выходов делайте говорящими, к примеру noise-soft, noise-mid, gray-soft. Так видно причинную связь между параметром и итогом, а не эффект случайной комбинации.
С масками действуйте так же. Проверьте автоматическую область на странице с узкими полями, на листе с номером далеко от основного текста и на странице с иллюстрацией у края. Если границы скачут, увеличьте запас или задайте ручной прямоугольник. --no-mask-center необходим, когда важно сохранить исходное положение текста на листе. Deskew настраивают лишь после устойчивой маски, поскольку угол оценивается по её краям.
Для цветных страниц безопасная отправная точка — сохранить PPM и отключить grayfilter. На фотографиях blurfilter тоже лучше отключить, пока его польза не подтверждена сравнением. Если цвет имеет смысловую или юридическую ценность, не переводите страницу в PGM до окончания контролируемой очистки: потерянный цвет последующие этапы не восстановят.
Как разделить книжный разворот на две страницы
Источник иллюстрации: unpaper / Xeon Live
Разворот — один из базовых сценариев unpaper. Исходный кадр содержит левую и правую страницу, тёмный сгиб и часто различную яркость половин. Тут необходимо связать две независимые настройки: --layout double создаёт две логические области, а --output-pages 2 записывает две картинки. Путать их нельзя: layout не гарантирует два файла, а output-pages не определяет, где находится содержимое.
- Шаг 1. Нормализуйте разворот в PGM или PPM и убедитесь, что сгиб приблизительно вертикальный. Поворот на 90 градусов исправьте через --pre-rotate до поиска масок.
- Шаг 2. Выполните короткий тест: unpaper --layout double --output-pages 2 --no-multi-pages spread001.pgm page%03d.pgm. Должны появиться две страницы в правильном порядке.
- Шаг 3. Откройте обе половины и оцените внутреннее поле. Если центральная тень остаётся, измерьте максимальную ширину сгиба на нескольких разворотах и лишь после этого задавайте --middle-wipe.
- Шаг 4. Не расширяйте middle-wipe ради одного тяжёлого кадра. Когда буквы подходят близко к сгибу, безопаснее оставить немного тени или выделить этот разворот в отдельный профиль.
- Шаг 5. Проверьте deskew обеих логических страниц. Маски должны охватывать левый и правый текстовые блоки отдельно; общий анализ по диагональному корешку даёт неверный угол.
- Шаг 6. При заметно различной яркости половин сперва разделите разворот с минимальной очисткой, а затем обработайте чётную и нечётную последовательности своими профилями.
- Шаг 7. Запустите тестовую серию из нескольких разворотов и сверяйте нумерацию. При output-pages 2 счётчик выходных файлов растёт вдвое быстрее числа sheet.
unpaper исправляет общий небольшой наклон, маски и поля, но не распрямляет дугообразные строки у корешка. Для такого дефекта необходим dewarp. Расширение диапазона deskew не решает проблему кривизны и может сделать угол менее устойчивым. Если большая часть книги снята камерой с перспективой, сперва корректируют перспективу и освещение, затем уже применяют unpaper как этап очистки.
Развороты с цветными вклейками лучше разделять щадящим профилем. Не пытайтесь сделать обе половины одинаково белыми ценой потери рисунка. После разделения цветные страницы можно оставить в PPM и ограничить обработку поворотом, маской и границами, а текстовые половины провести через отдельный серый профиль.
Пакетная обработка: шаблоны имён, диапазоны и профили
Источник иллюстрации: unpaper / Xeon Live
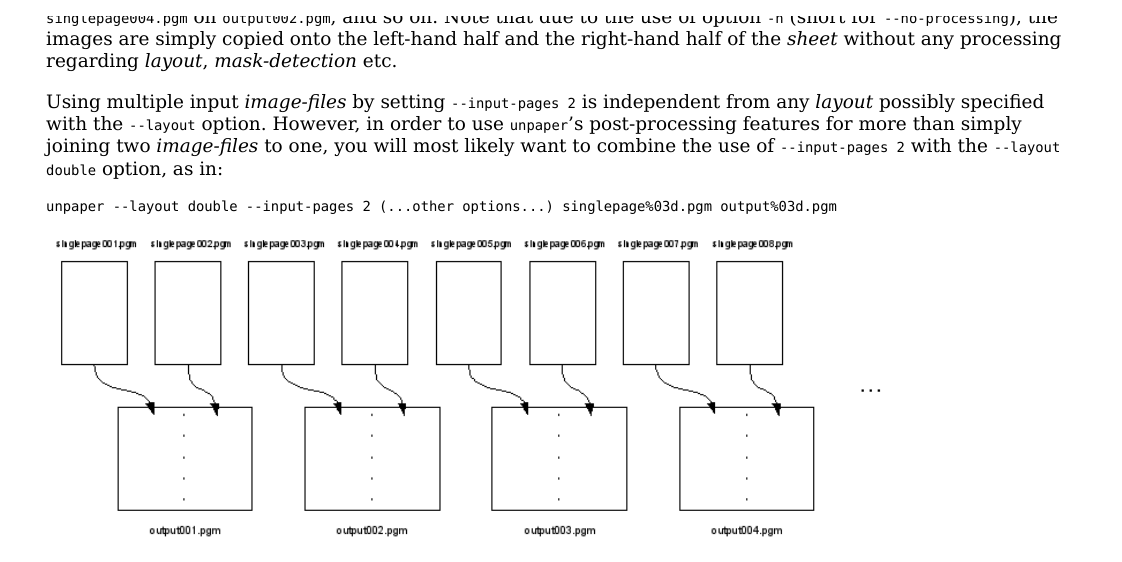
После настройки одного кадра главная ценность unpaper раскрывается в серии. Программа применяет шаблоны имени в стиле printf: %03d превращается в 001, 002, 003 и далее. Входной и выходной счётчики независимы, а номер sheet — третья величина. Это в особенности заметно в схемах два-к-одному и один-к-двум. Перед обработкой книги полезно на бумаге или в заметке выписать ожидаемое соответствие первых четырёх входов и выходов.
- Шаг 1. Организуйте каталоги. Держите raw для неизменных сканов, normalized для PGM/PPM одного типа, cleaned для итога unpaper, final для PNG/TIFF/PDF, profiles для команд и logs для журналов.
- Шаг 2. Проверьте шаблон на одном sheet. Включите --no-multi-pages, убедитесь, что подстановка %03d даёт ожидаемое имя, а вход и выход не указывают в один каталог.
- Шаг 3. Ограничьте короткий диапазон. Применяйте --start-sheet и --end-sheet на нескольких листах. Если необходимо ещё раз обработать конкретные страницы, примените --sheet; для исключений применяйте --exclude.
- Шаг 4. Отделите счётчики файлов от номера sheet. При --input-pages 2 входы 001 и 002 относятся к первому sheet, 003 и 004 — ко второму. При --output-pages 2 аналогично быстрее растёт номер выходного файла.
- Шаг 5. Сохраняйте пагинацию. --insert-blank и --replace-blank пригодны, когда отсутствует кадр или необходимо оставить пустую позицию без сдвига последующих номеров.
- Шаг 6. Делите серию на профили. Отдельно обрабатывайте обычные текстовые страницы, развороты, цветные вставки и исключения. Профиль должен называться по назначению, к примеру single-text, double-gutter или color-insert.
- Шаг 7. Запустите контрольную выборку. Включите первую и последнюю страницу, самый светлый и самый тёмный скан, лист с иллюстрацией, минимальными полями и выраженной тенью. Лишь после этого запускайте всю серию.
- Шаг 8. Проверяйте итог скриптом. Сверяйте код окончания, число файлов, ненулевой размер и ожидаемую геометрию. Автоматическая проверка не заменяет просмотр, но быстро ловит пропуски и ошибки нумерации.
Продолжать обработку удобно через --start-input и --start-output, когда готовые итоги уже пронумерованы и переименовывать их нежелательно. Эти параметры изменяют подстановку в имени, но не номер sheet. Перед возобновлением серии сопоставьте последние успешно созданные файлы с журналом, иначе легко ещё раз обработать лист или, наоборот, пропустить пару входов.
Не запускайте слишком много процессов параллельно без измерения памяти и диска. PGM и в особенности PPM — несжатые промежуточные форматы, по этой причине тысячи страниц занимают значительный объём. Для текстовой книги PGM обычно экономнее PPM, а последовательная обработка проще для диагностики. Освободить место лучше удалением воспроизводимых normalized-файлов после окончания проекта, но raw и профиль команды должны сохраниться.
После полной серии создайте контактный лист или хотя бы просмотр миниатюр. На нём быстро заметны белые страницы, неразделённые развороты, скачки полей и неверный поворот. Подозрительные кадры затем открывают в полном разрешении. Это быстрее сплошного просмотра каждого листа и всё же сохраняет визуальный контроль, которого автоматическая очистка не отменяет.
Подготовка к OCR и сборка финального PDF
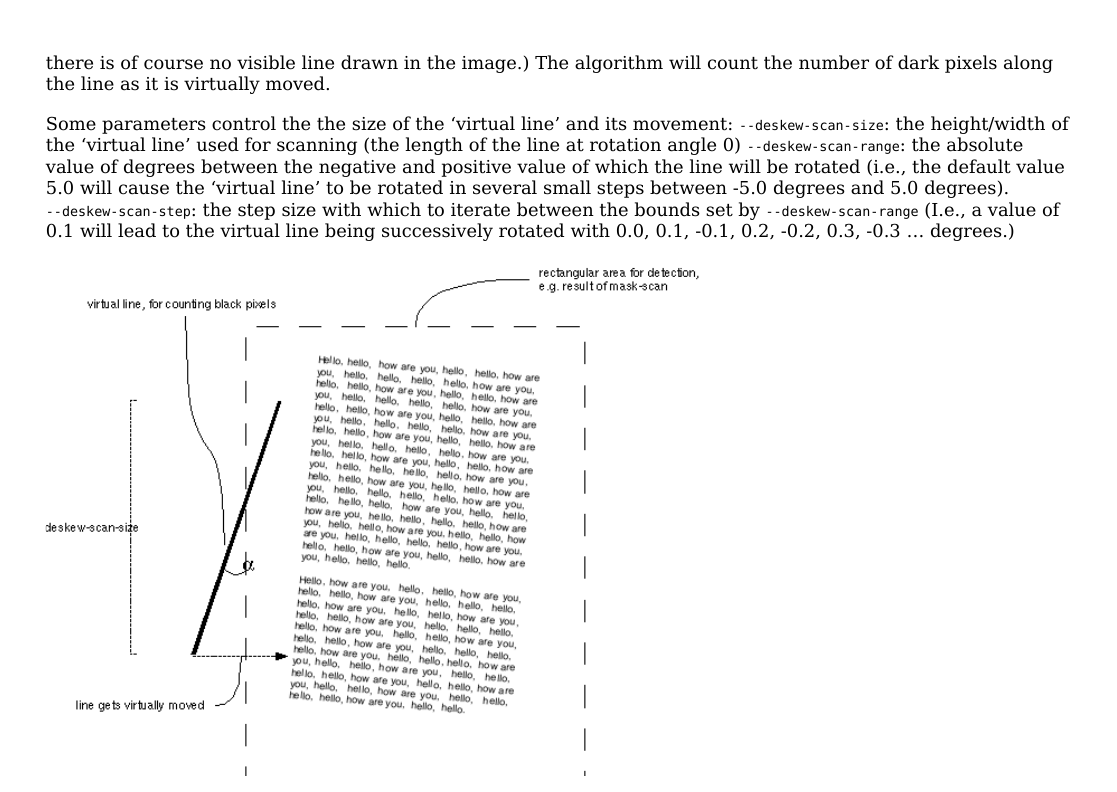
Источник иллюстрации: unpaper / Xeon Live
Перед OCR цель unpaper — не сделать страницу максимально белой, а сохранить форму символов и убрать помехи, которые мешают сегментации. Ровные строки и чистые поля помогают распознаванию, но удалённые точки, слитые штрихи и чрезмерная бинаризация ухудшают итог. По этой причине контрольный набор должен включать мелкий кегль, диакритику, цифры, таблицы и слабую печать, а качество OCR сопоставляют по реальному тексту, а не только по внешнему виду страницы.
- Шаг 1. Если исходник уже PDF со сканированными страницами, растрируйте только нужные страницы с заблаговременно выбранным DPI. Не превращайте в растр PDF с полноценным векторным текстом без необходимости.
- Шаг 2. Нормализуйте изображения в PGM или PPM. Для чёрно-белого текста PGM обычно даёт удобный баланс качества и объёма.
- Шаг 3. Примените проверенный профиль unpaper. Deskew и маски настраивайте на сохранение символов; noisefilter держите умеренным.
- Шаг 4. Проведите OCR на нескольких контрольных страницах и сопоставьте ошибки до и после очистки. Если пропали точки или тонкие буквы, вернитесь к исходному растру и ослабьте фильтр.
- Шаг 5. При применении OCRmyPDF начните с --clean, когда очищенная копия необходима в основном для распознавания. --clean-final помещает обработанный растр в итоговый документ и требует более тщательной визуальной проверки.
- Шаг 6. Для нестандартных параметров OCRmyPDF передаёт их через --unpaper-args. Не добавляйте туда имена файлов: OCRmyPDF сам формирует промежуточный вход и выход. Режимы, создающие два выхода, несовместимы с ожиданием OCRmyPDF один-вход-один-выход.
- Шаг 7. После OCR соберите PDF из проверенных растров и текстового слоя. Сверьте порядок страниц, ориентацию, поля, качество картинок и возможность поиска по тексту.
Если задача — именно распознавание, пригодится пошаговый материал по OCR в PDF. Он дополняет unpaper, потому что сама программа текст не распознаёт и поисковый слой не создаёт. Язык, сегментация, словарь и качество текстового слоя относятся уже к OCR-движку.
Финальный PDF формируют после контроля растров, а не ранее. unpaper не пишет PDF напрямую; итог PNM переводят в PNG/TIFF либо передают инструменту сборки документа. Отдельная инструкция по преобразованию скана в PDF помогает разнести роли: unpaper отвечает за подготовку растра, следующий этап — за контейнер, порядок страниц и сжатие.
Сохраняйте cleaned-изображения хотя бы до окончания OCR и финальной проверки. Тогда при смене параметров распознавания или сжатия не придётся снова применять необратимые фильтры. Raw остаётся неизменным всегда; normalized можно пересоздать; cleaned позволяет повторить OCR; final — уже публикационный или архивный документ.
Диагностика ошибок и контроль качества
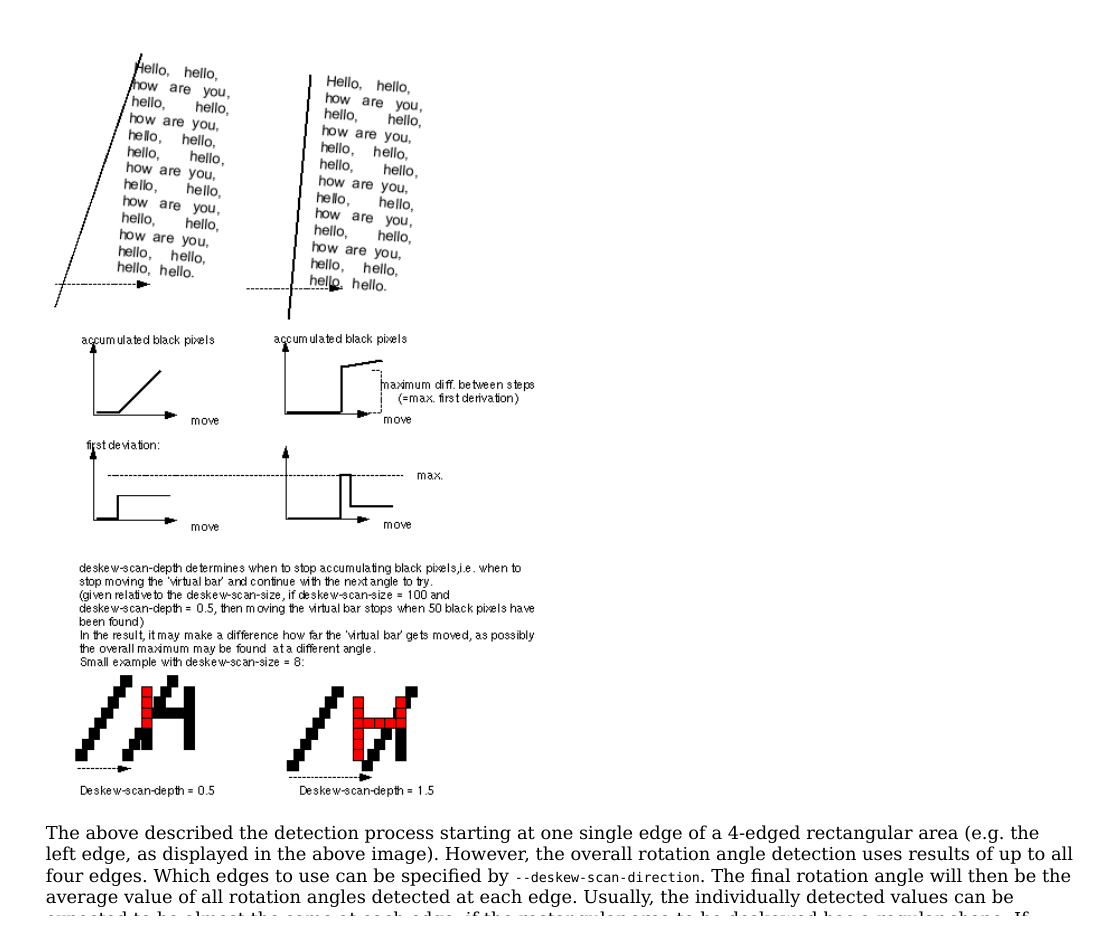
Источник иллюстрации: unpaper / Xeon Live
Большинство проблем удобнее разбирать не по сообщению об ошибке, а по месту в конвейере. Сперва докажите, что файл читается и записывается через --no-processing. Потом проверьте ранние фильтры, потом маски, deskew и лишь после этого границы. Если итог уже испорчен на раннем этапе, поздняя настройка margin или align не вернёт удалённые пиксели.
- Файл не открывается или появляется unsupported pixel format. Перекодируйте исходник в простой PGM либо PPM и повторите проход. Если он работает, проблема была в контейнере, разрядности или пиксельном формате, а не в масках.
- Получился пустой или практически белый лист. Запустите --no-processing, потом отключите grayfilter и blackfilter. Проверьте white-threshold, black-threshold и координаты маски. Автоматическая область могла стартовать в пустом поле.
- Пропали точки, запятые или тонкие линии. Уменьшите noisefilter-intensity либо полностью отключите noisefilter. Если дефект и пунктуация одинакового размера, надёжно разделить их автоматически невозможно.
- Страница повернулась неверно. Уменьшите --deskew-scan-range, проверьте направления поиска и маску. Поворот на 90 градусов делайте через pre-rotate, а не через deskew.
- Граница скачет от листа к листу. Стабилизируйте размер и фон входов, уменьшите шаг border-scan или задайте ручной border. На сканере с постоянным положением бумаги ручные значения часто надёжнее.
- Программа не хочет перезаписывать итог. Сперва убедитесь, что выход не совпадает с исходником. Удалите тестовый файл или осознанно добавьте --overwrite лишь в воспроизводимый сценарий с раздельными каталогами.
- Не хватает памяти или диска. Для текстовых страниц применяйте PGM вместо PPM, запускайте меньше параллельных процессов и не увеличивайте sheet-size без необходимости. Несжатые промежуточные файлы занимают много места.
- После output-pages 2 не хватает второй страницы. Проверьте шаблон имени с %03d, количество выходов и наличие корректного double-макета. Сперва воспроизведите ошибку на одном sheet через --no-multi-pages.
Контроль после пакетного запуска должен быть формальным. Сверьте число входов и выходов с учётом input-pages/output-pages, проверьте ненулевой размер каждого итога и возможность открыть изображение декодером. Потом сопоставьте размеры листов и тип PBM/PGM/PPM. Неожиданная смена формата, пустой файл или иной размер — повод остановить дальнейшую сборку PDF.
Визуально просмотрите равномерную выборку и все крайние случаи: минимальный и максимальный размер файла, самую светлую и тёмную страницу, разворот, иллюстрацию, страницу с подписью и лист с узкими полями. Особое внимание — мелким символам и внешним элементам, которые автоматическая маска может принять за мусор. Для длинной книги контактный лист помогает быстро увидеть общую геометрию.
Можно ли передать PDF напрямую?
Для контролируемого процесса сперва растрируйте нужные страницы с заданным DPI, обработайте изображения, затем соберите новый PDF. У скана с векторным текстом лишнее растрирование нежелательно.
Как сохранить цветную печать?
Применяйте PPM, отключите или ослабьте grayfilter и проверьте фон маски. Не переводите страницу в PGM, пока цвет несёт смысловую информацию.
Как не потерять точки и диакритику?
Снижайте noisefilter-intensity или отключайте noisefilter. Проверяйте самый мелкий текст; при одинаковом размере пыли и пунктуации автоматическая очистка имеет естественный предел.
Почему после deskew появились серые края букв?
Поворот требует интерполяции. Linear и cubic создают промежуточные оттенки; nearest сохраняет более жёсткий бинарный край. Для архива удобнее выполнять геометрию в PGM и бинаризацию позднее.
Как сохранить исходное положение текста?
Отключите mask-center и border-align и применяйте фиксированный размер sheet. При deskew ограничивающий прямоугольник всё равно меняется, по этой причине полное геометрическое тождество несовместимо с поворотом.
Как проверить команду без запуска всей книги?
Применяйте --test-only для анализа, --no-multi-pages для одного прохода и короткий диапазон start-sheet/end-sheet. Полную серию запускайте лишь после проверки количества файлов и качества выборки.
Преимущества, недостатки, альтернативы и выбор сценария
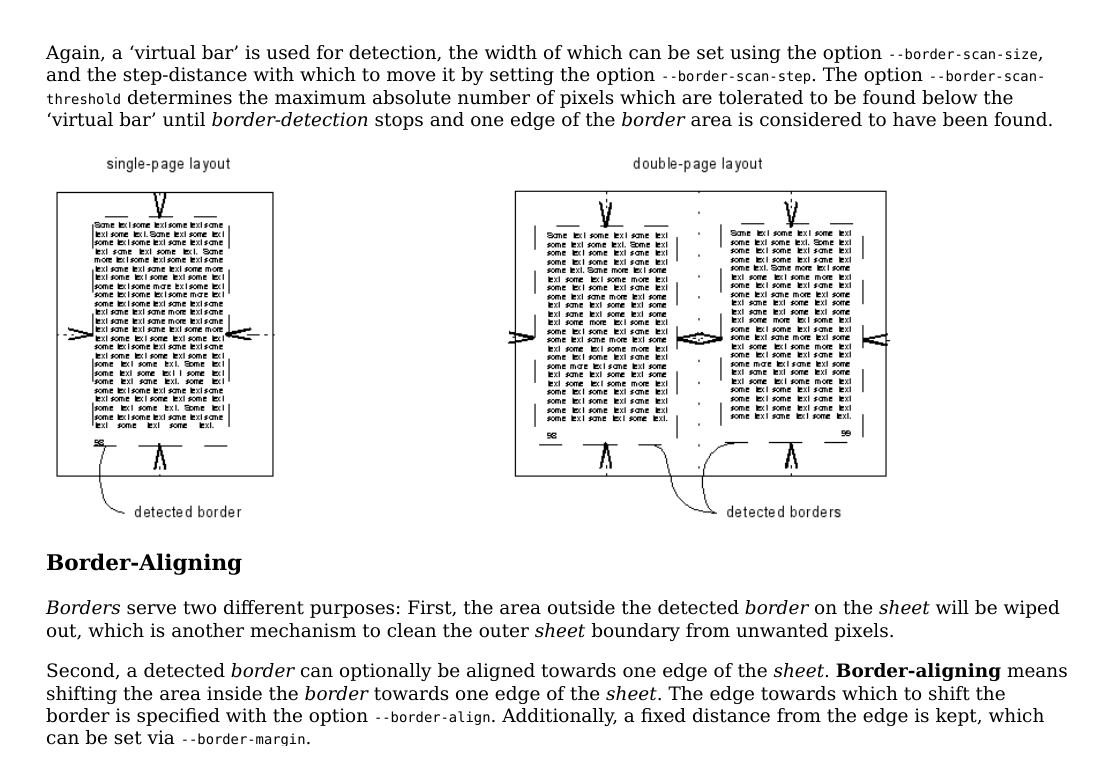
Источник иллюстрации: unpaper / Xeon Live
unpaper в особенности силён там, где сотни страниц похожи друг на друга и ценится воспроизводимость. Он не пытается быть универсальным редактором: его модель основана на листах, масках, порогах, фильтрах и небольших геометрических поправках. По этой причине выбор зависит в первую очередь от однородности исходников и готовности один раз тщательно настроить профиль.
Плюсы
- Подходит для повторяемой пакетной очистки однотипных сканов и легко встраивается в сценарии автоматизации.
- Разделяет одиночные страницы и книжные развороты через модель sheet/page, layout и input-pages/output-pages.
- Позволяет независимо отключать фильтры и этапы, по этой причине проблемную страницу можно сделать более щадящей без смены всей цепочки.
- Предлагает маски, deskew, работу с границами, полями и фиксированными зонами wipe в одном последовательном процессе.
- Хорошо сочетается с OCRmyPDF, Tesseract, FFmpeg, ImageMagick и инструментами сборки PDF как специализированный промежуточный этап.
- Команда и журнал легко сохраняются, по этой причине итог можно повторить на другой партии файлов при том же окружении.
Минусы
- Нет собственного графического интерфейса и интерактивного предпросмотра; параметры оцениваются через внешние изображения.
- Вывод ориентирован на PNM, по этой причине PNG, TIFF и PDF обычно создаются следующим инструментом.
- Агрессивные фильтры могут удалить значимые пиксели: точки, подписи, серые линии, фотографии и элементы у края страницы.
- Deskew исправляет небольшой общий наклон, но не заменяет коррекцию перспективы и dewarp для сильно изогнутых книжных строк.
- Первоначальная настройка требует контрольной выборки и понимания порядка обработки; универсальный профиль для неоднородного архива ненадёжен.
- Несжатые промежуточные PGM/PPM на больших проектах требуют заметного объёма диска.
Кому подойдёт
- Оцифровщикам книг и архивов с большим количеством похожих страниц.
- Администраторам и разработчикам, которые строят автоматизированную цепочку скан → очистка → OCR → PDF.
- Пользователям Linux, macOS и Windows-окружений, которым удобна командная строка и повторяемые профили.
- Проектам, где важнее стабильность параметров на серии, чем ручная правка каждой страницы.
Кому не подойдёт
- Тем, кому необходим визуальный редактор с перетаскиванием рамок и мгновенным предпросмотром.
- Коллекциям, где практически каждая страница имеет уникальную перспективу, освещение, формат и кривизну.
- Задачам, где требуется полноценное редактирование содержимого PDF, а не подготовка исходного растра.
- Сценариям, где нельзя визуально проверить итог хотя бы на репрезентативной выборке.
Из реальных альтернатив ScanTailor Advanced делает акцент на интерактивной постобработке: разделении страниц, deskew, выборе области содержимого, полях и dewarp с визуальным контролем. Он удобнее, когда оператор должен видеть и править каждую проблемную страницу. OCRmyPDF решает другую задачу — создание поискового PDF и может вызывать unpaper через --clean и --clean-final. gscan2pdf объединяет сканирование, сортировку страниц, OCR и экспорт в графическом окне, а ImageMagick удобен для универсальных преобразований растра, но не повторяет модель листов и парных страниц unpaper.
Для архива из нескольких тысяч однотипных серых страниц разумный процесс выглядит так: стабильное сканирование, нормализация в PGM, тестовый профиль unpaper, короткая контрольная серия, полный пакет, контактный лист, OCR и только затем сборка PDF. Для небольшой книги с кривым корешком и различными страницами чаще рациональнее интерактивный инструмент с dewarp. Для уже готового сканированного PDF, где главная цель — поиск по тексту, OCRmyPDF обычно становится центральным инструментом, а unpaper — добавочным этапом очистки.
Главный критерий успешной настройки — не максимально белый фон, а сохранённое содержание при ровной геометрии и понятной цепочке преобразований. Raw остаётся неизменным, параметры фиксируются, исключения известны, а итог проверяется визуально. При таком режиме unpaper полезен именно как управляемый производственный инструмент, а не как фильтр, который применяют ко всей папке без контроля.