
Tabula превращает таблицы из текстовых PDF в данные, которые удобнее проверять и переносить в электронные таблицы. На странице Xeon Live можно скачать Tabula бесплатно, а в этом руководстве разобраны интерфейс, точная разметка, Stream и Lattice, шаблоны, экспорт и контроль ошибок без обещаний универсального распознавания.
Для чего необходима Tabula и где проходит граница её возможностей
Tabula — специализированный экстрактор таблиц из PDF. Она не редактирует исходный документ, не создаёт сложную разметку страницы и не выполняет OCR. Её задача уже: взять существующий текстовый слой PDF, восстановить из координат символов строки и столбцы, показать получившуюся структуру и сохранить её в машинно-читаемом виде. По этой причине программа в особенности полезна для статистических бюллетеней, финансовых отчётов, реестров, ведомостей, приложений к исследованиям и любых документов, где таблица визуально есть, а обычное копирование ломает колонки.
Pythonic Excursions / автор страницы
Как понять, подходит ли документ до импорта
Самая важная предварительная проверка занимает меньше минуты. Откройте PDF в обычном просмотрщике и попробуйте выделить отдельное слово внутри таблицы. Когда символы выделяются как текст, у Tabula есть исходные текстовые объекты для анализа. Когда вся страница выделяется как единая картинка, сперва необходим OCR. Отдельный порядок подготовки сканов разобран в материале как распознать текст в PDF. После OCR имеет смысл проверить несколько чисел и похожих символов: ошибки распознавания Tabula не исправляет, а переносит в итоговые ячейки.
Второе ограничение связано со смыслом данных. Tabula восстанавливает геометрию, но не знает, что строка «Итого» должна быть итоговой, что звёздочка означает примечание, а тире — отсутствие значения. Программа тоже не превращает сложную таблицу в идеальную нормализованную базу. Структурную очистку, приведение типов, объединение переносов строк и проверку бизнес-правил выполняют после экспорта. Это важное разделение: сперва извлечение, затем преобразование и валидация.
Интерфейс Tabula: что находится на каждом экране
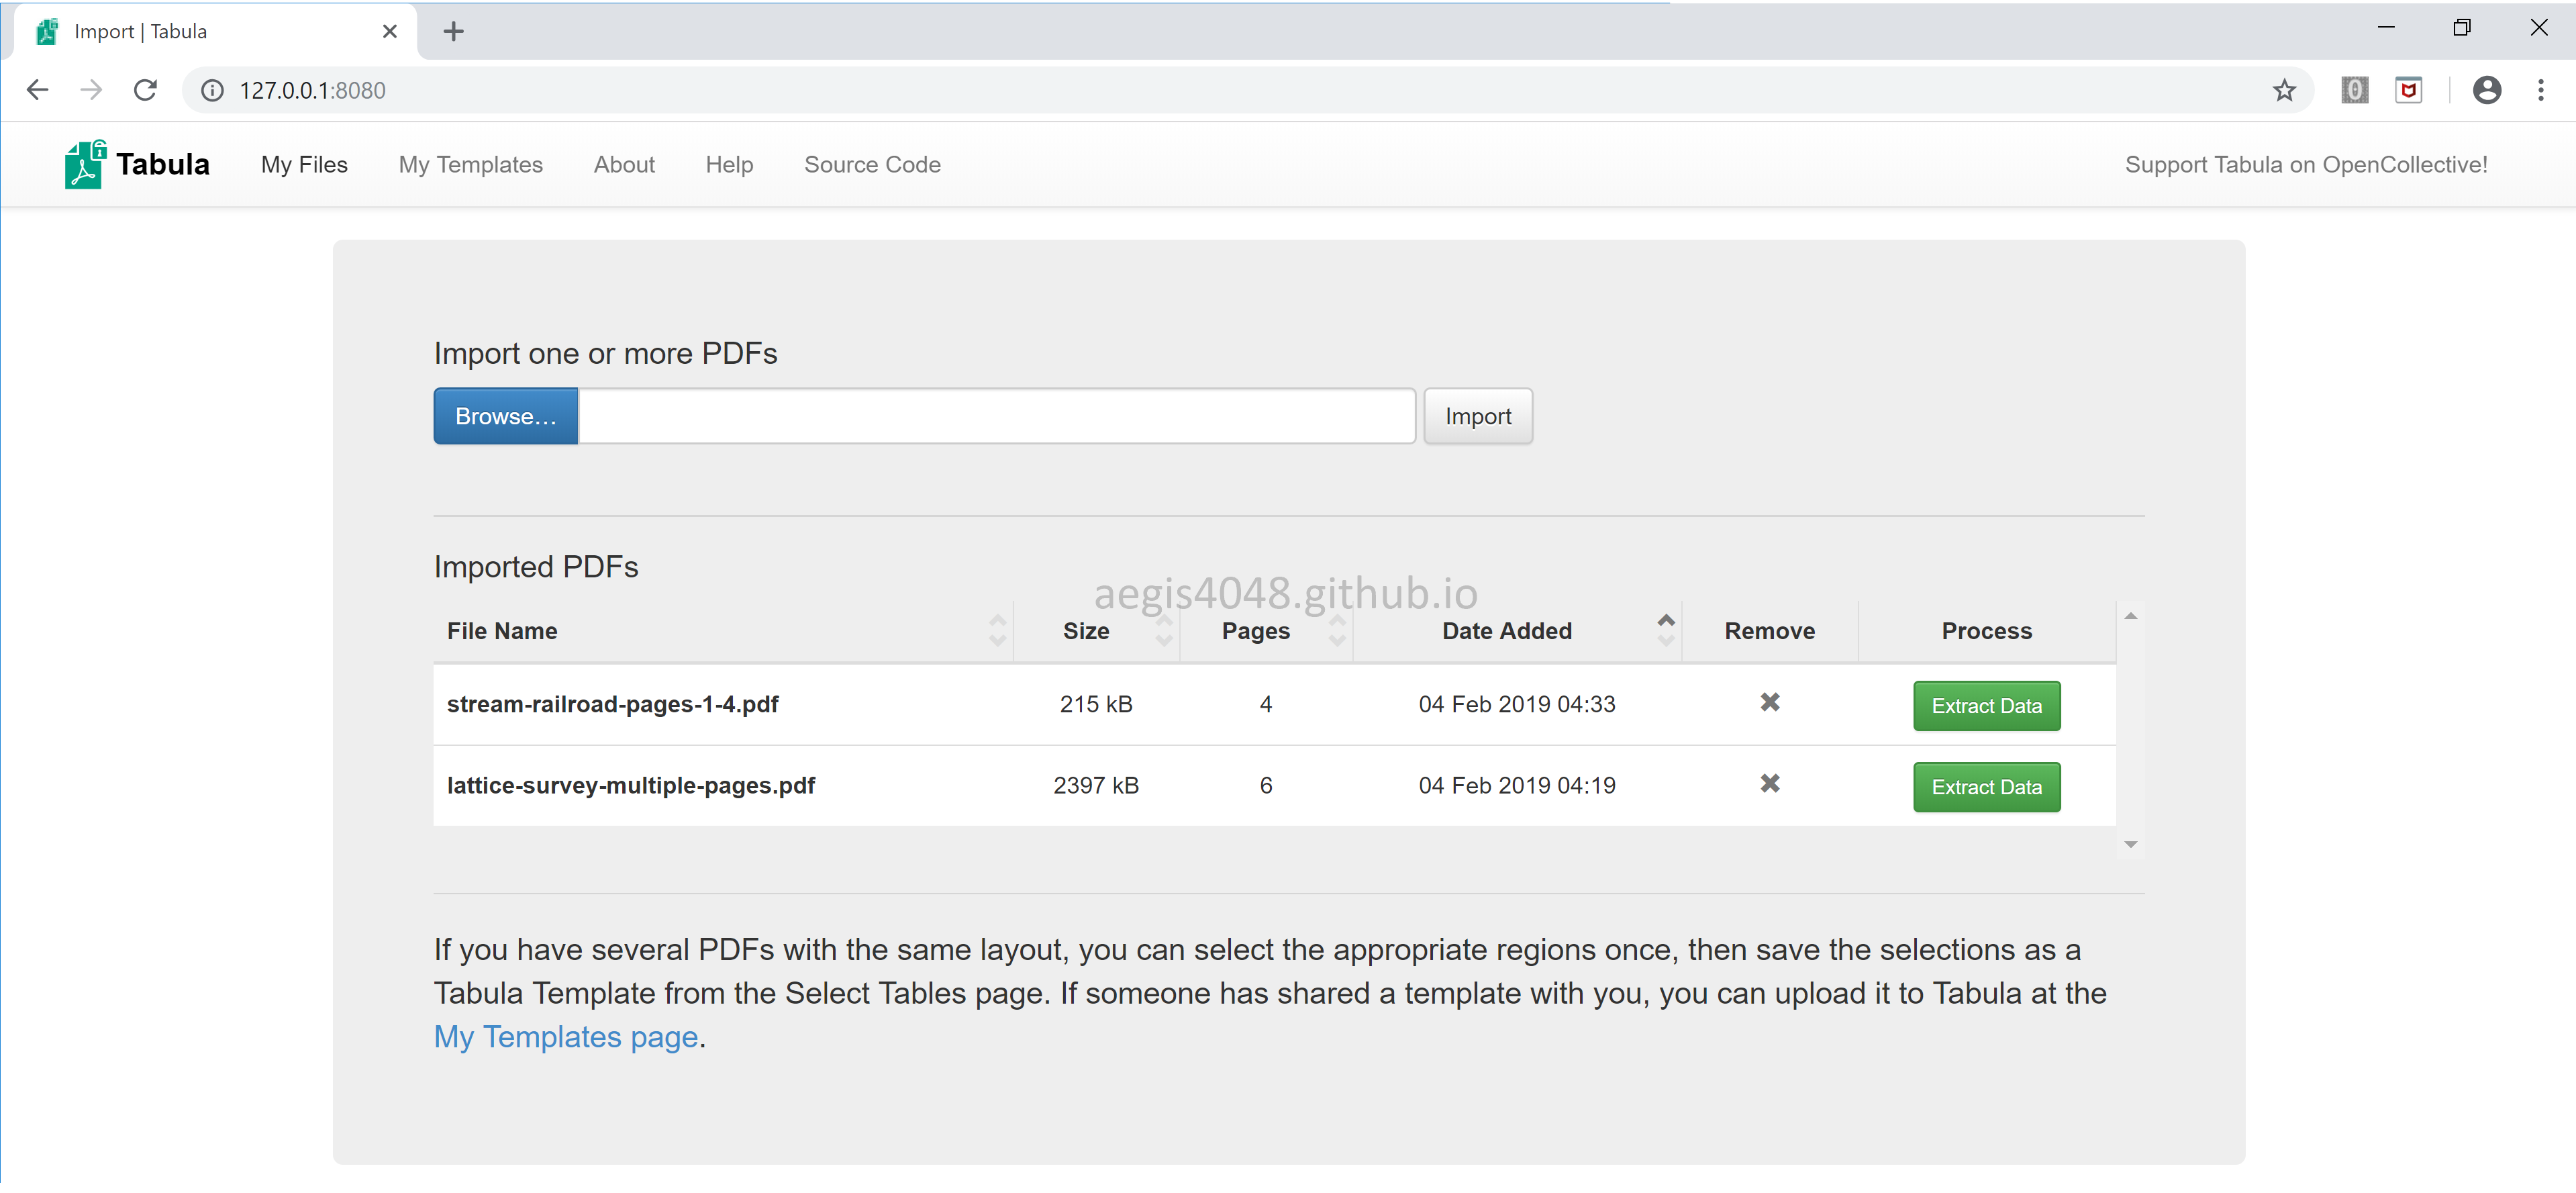
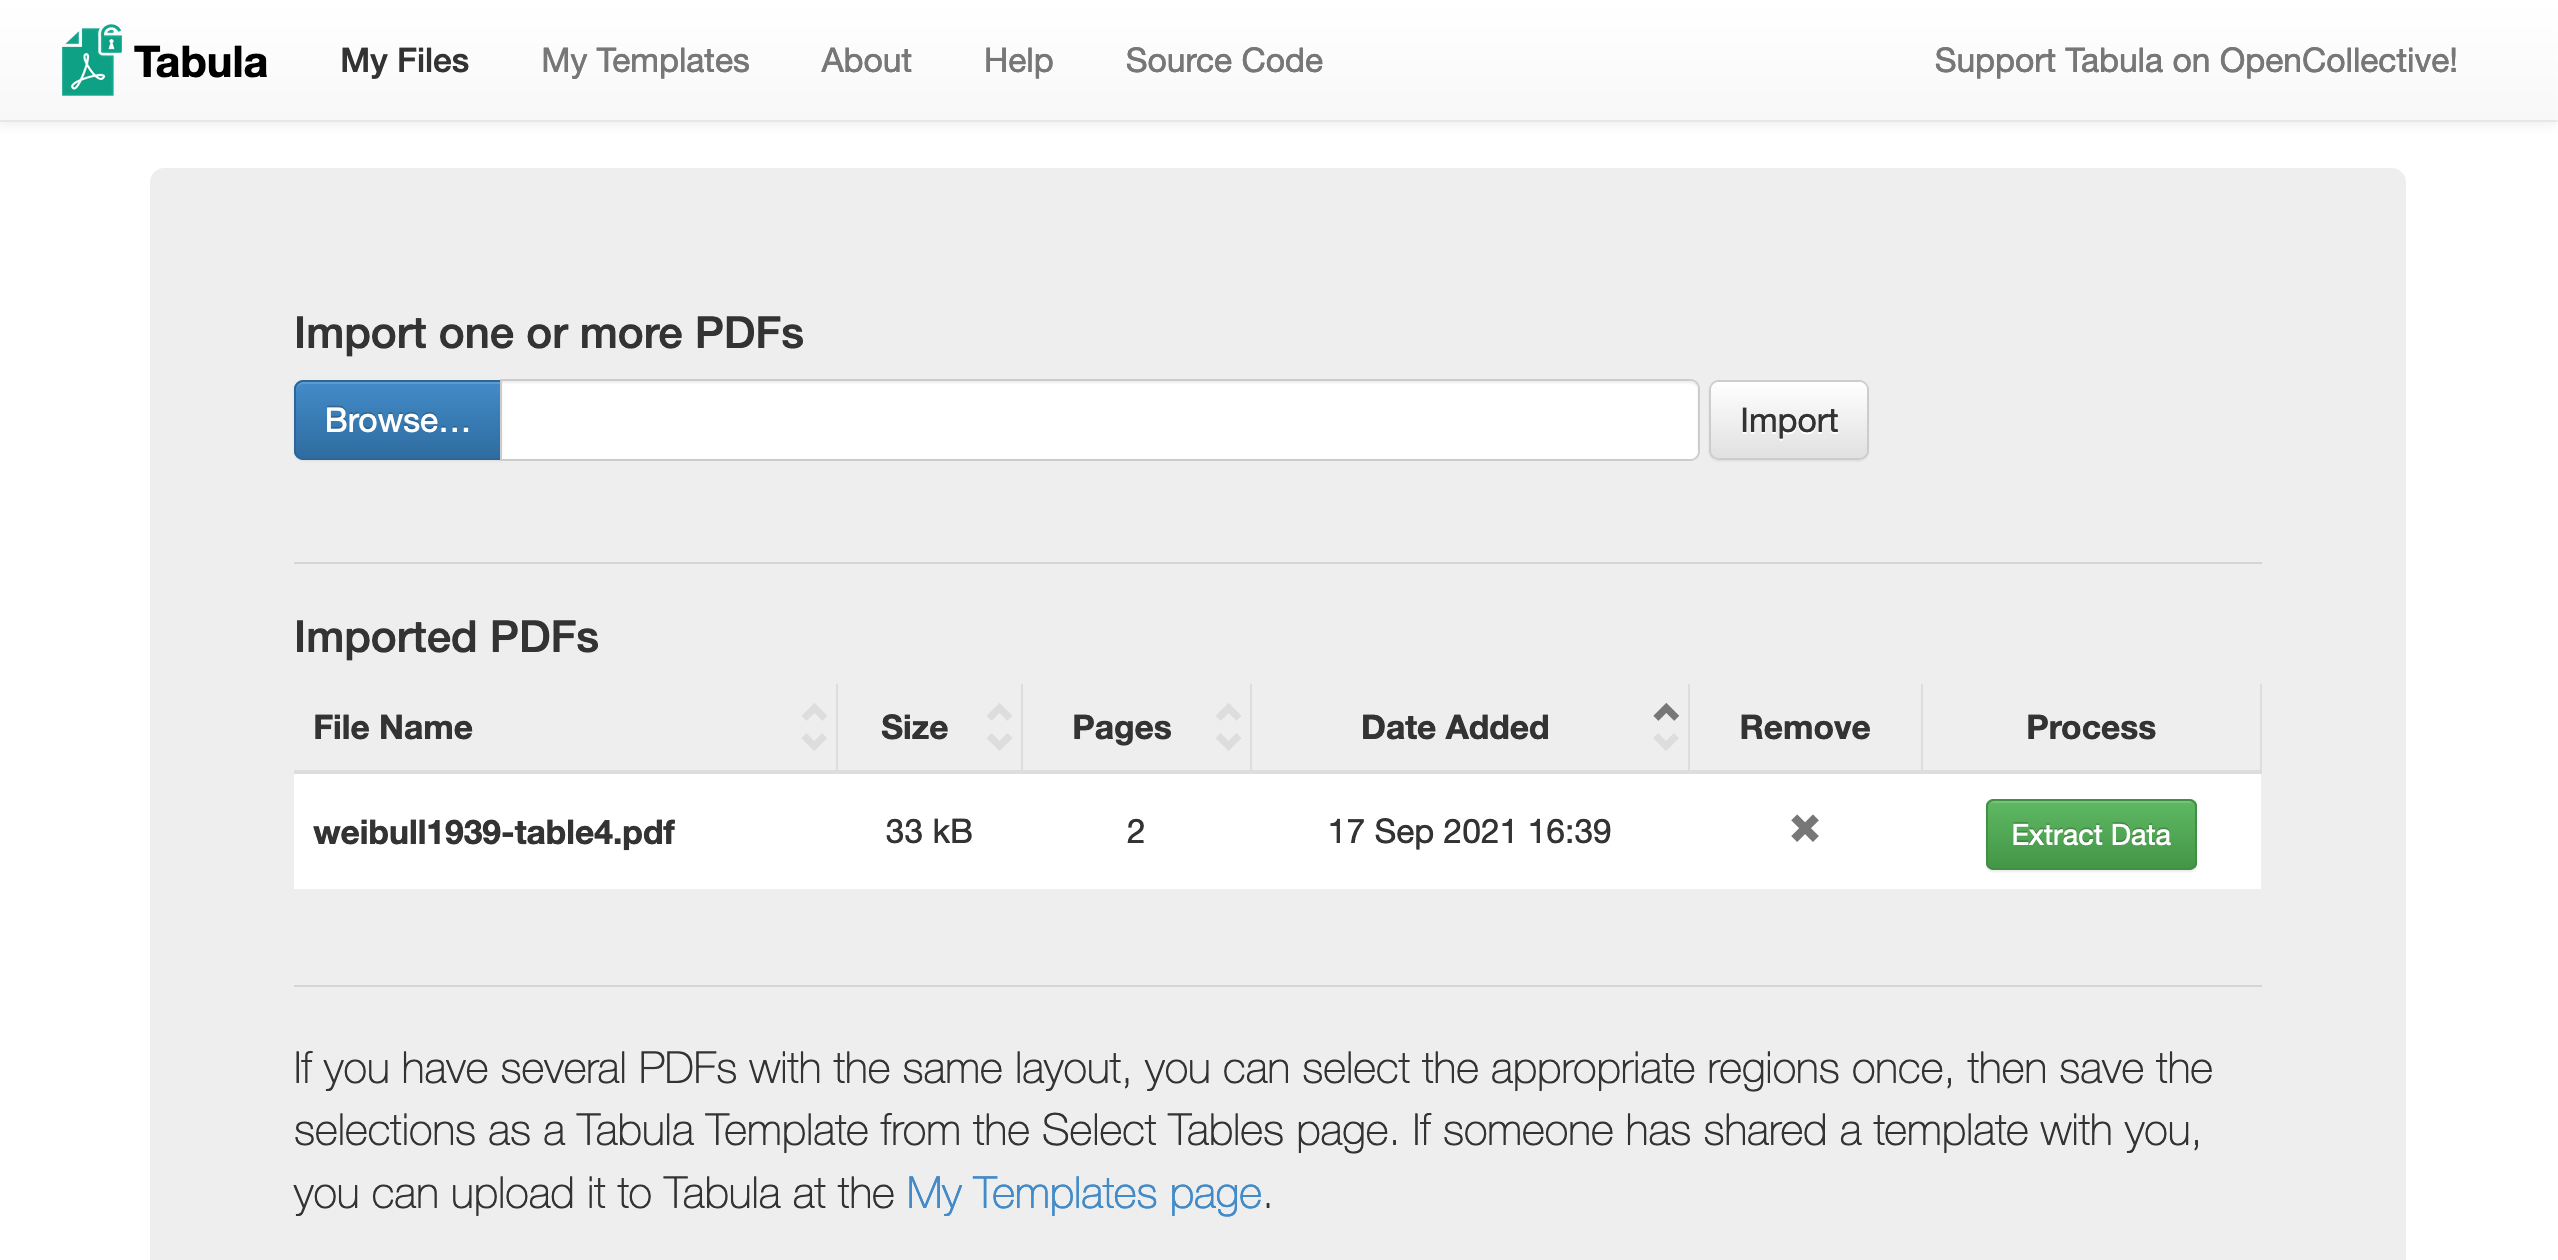
Tabula выглядит как веб-сайт, но при обычном запуске интерфейс открывается из локального Java-приложения. В адресной строке браузера применяется localhost или 127.0.0.1, а работа с PDF идёт на компьютере. На первом экране находятся форма Import one or more PDFs и локальная библиотека Imported PDFs. После импорта в строке документа показываются имя файла, размер, количество страниц, дата добавления, удаление и кнопка Extract Data.
Materials Informatics 101 / Zachary del Rosario
Три рабочие области, которые необходимо запомнить
- My Files. Импорт и перечень документов. Тут начинается новый сеанс и отсюда ещё раз открывается уже добавленный PDF.
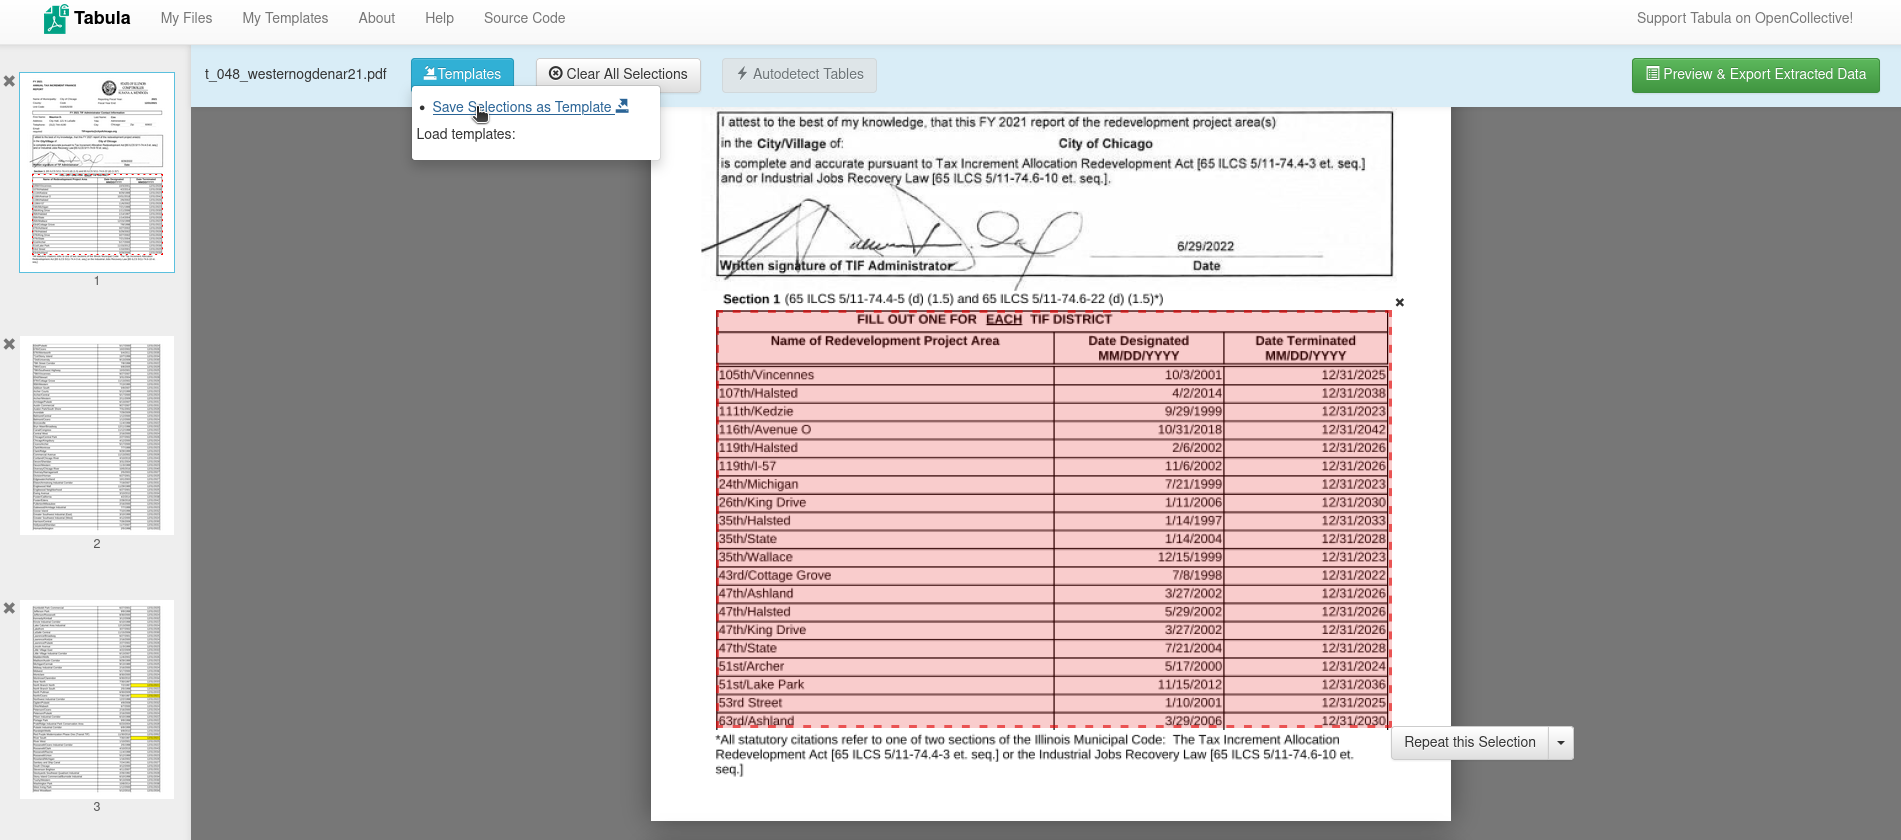
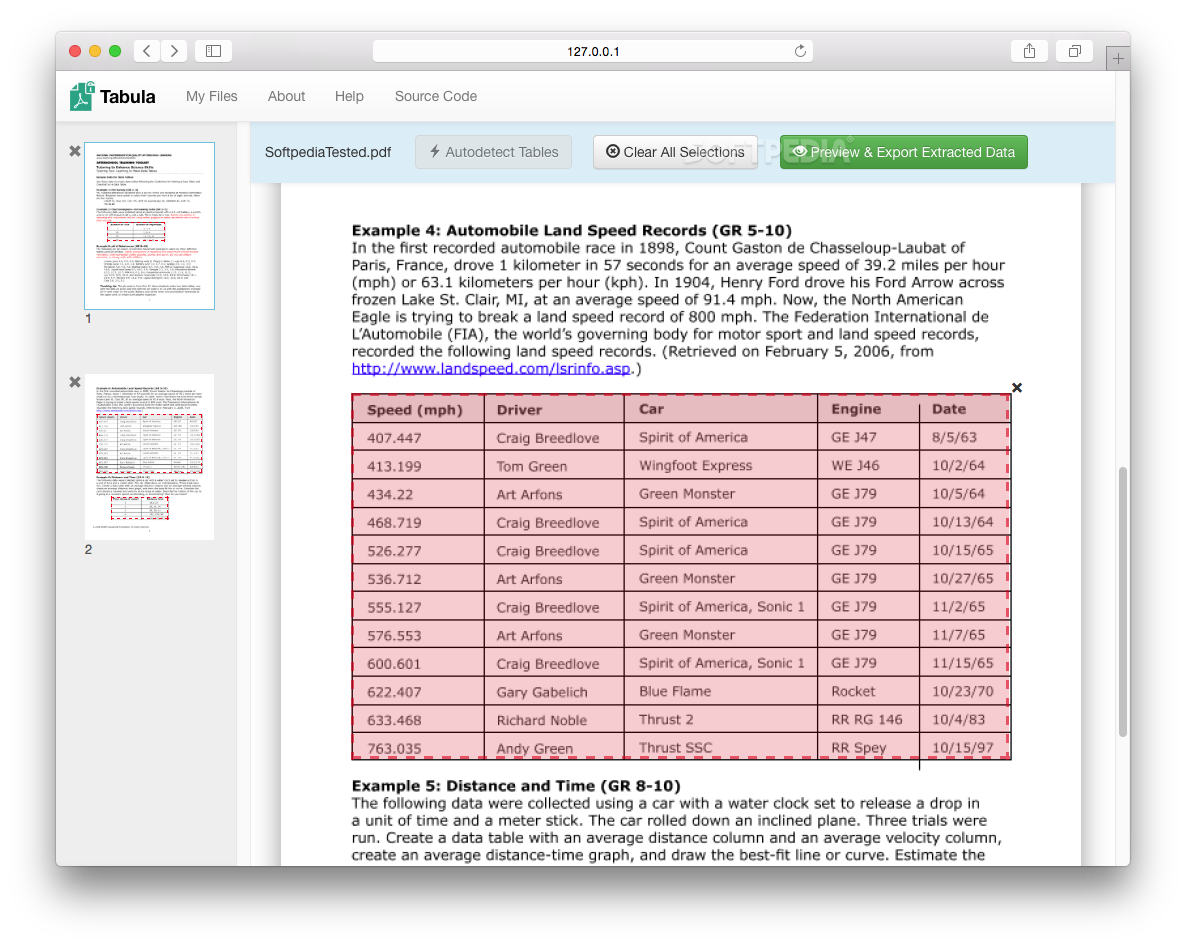
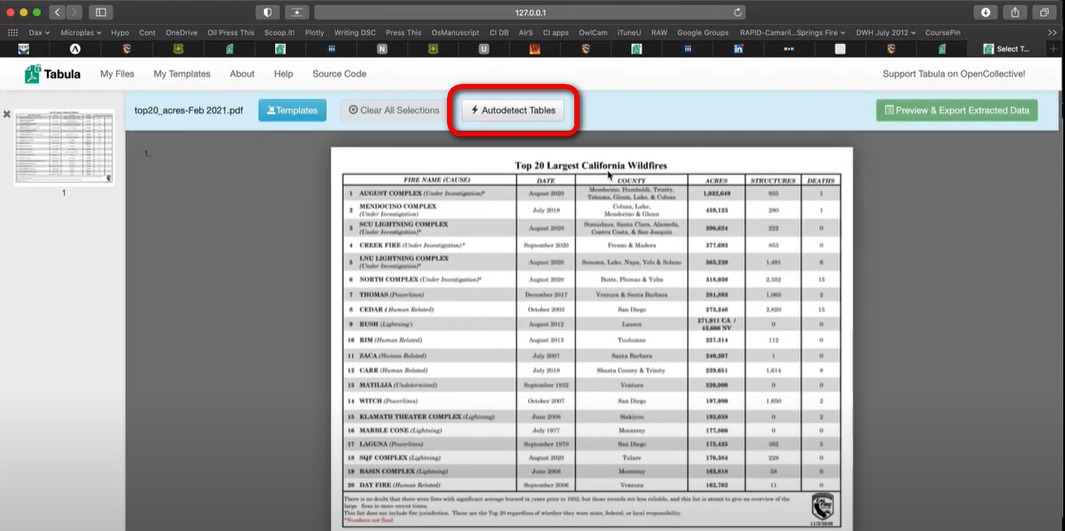
- Select Tables. Просмотр страниц с миниатюрами слева, основным листом в центре и панелью Templates, Clear All Selections, Autodetect Tables и Preview & Export Extracted Data сверху.
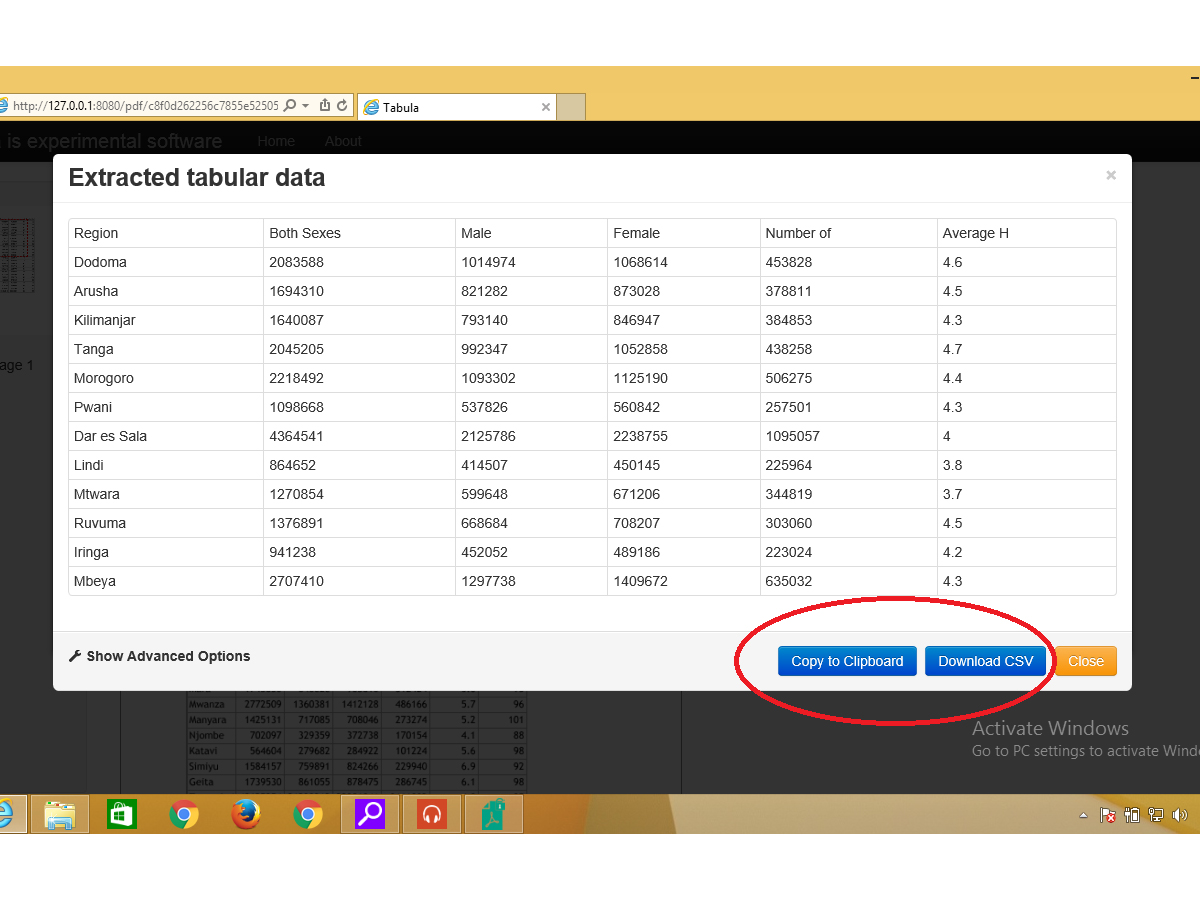
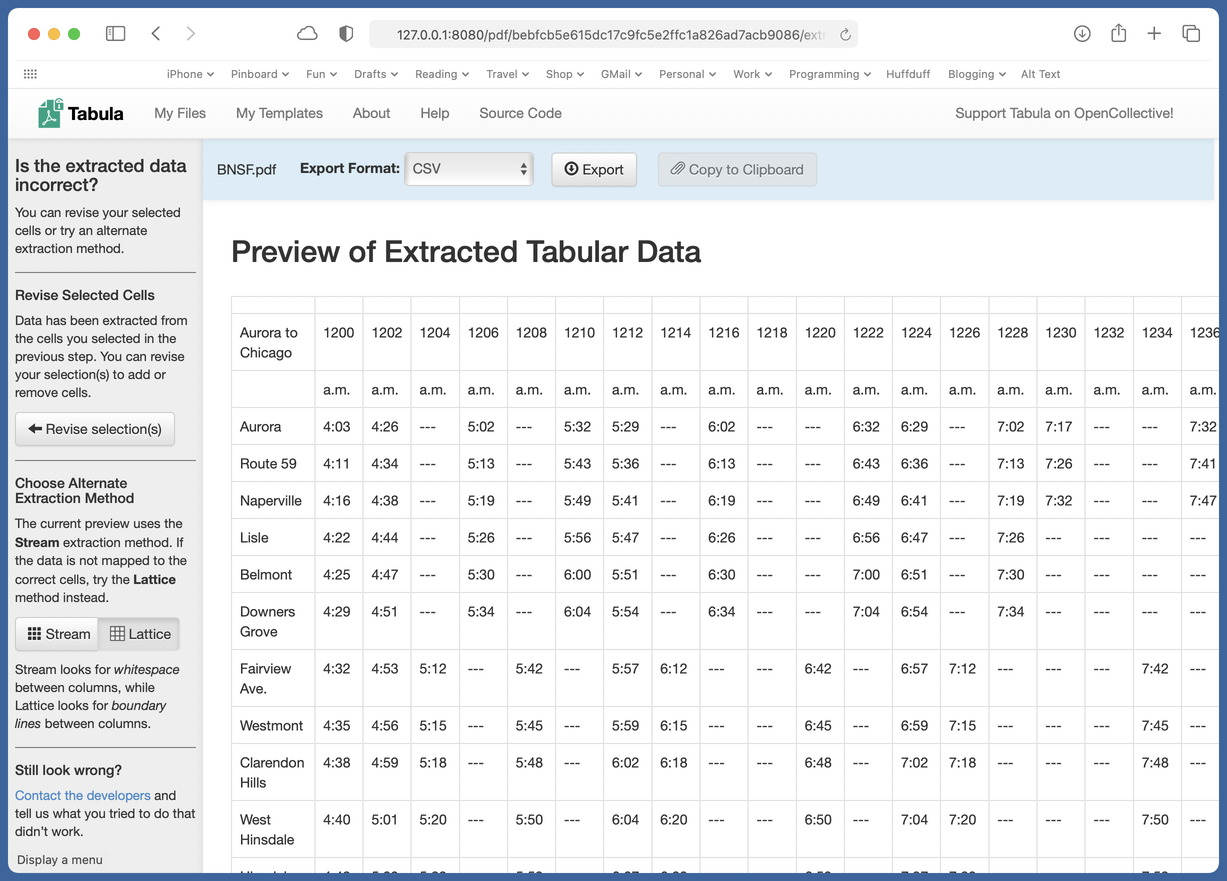
- Preview of Extracted Tabular Data. Предварительная таблица, кнопка Revise selection(s), переключатели Stream и Lattice, выбор Export Format, Export и Copy to Clipboard.
Переходы между этими областями важнее любых скрытых настроек. Tabula построена как короткий цикл: импортировать документ, очертить нужную область, просмотреть итог, вернуться к разметке при ошибке и лишь после этого экспортировать. Большинство проблем решается именно повторением этого цикла, а не поиском десятков параметров.
В стабильной оболочке 1.2.1 есть My Templates. Там хранятся сохранённые геометрические шаблоны, их можно переименовывать, удалять, выгружать и импортировать в JSON. Шаблон не содержит «обученной модели» и не запоминает правильные значения: он переносит координаты областей. По этой причине его надёжность зависит от того, насколько одинаково сверстаны документы.
Как извлечь одну таблицу из текстового PDF
Для первой таблицы лучше пройти полный ручной цикл без автоматизации. Такой порядок даёт контрольную точку: вы увидите, где Tabula начинает ошибаться, и лишь после этого решите, необходимы ли шаблоны или командная строка. В качестве исходника берите копию PDF, чтобы не путать исходные данные с последующими очищенными файлами.
MuckRock
Шаг 1. Импорт, переход к странице и точная рамка
- Запустите Tabula и дождитесь локальной страницы в браузере. На Windows и Linux для стабильной сборки требуется Java; macOS-пакет поставлялся со встроенной Java.
- Нажмите Browse…, выберите PDF и затем нажмите Import. Дождитесь появления документа в Imported PDFs. Для объёмного файла подождите окончания подготовки миниатюр.
- Нажмите Extract Data. В режиме выбора применяйте миниатюры слева, чтобы перейти к странице с нужной таблицей.
- Увеличьте страницу браузером или прокруткой, чтобы видеть крайние колонки, последнюю строку и сноски. Чем точнее рамка, тем меньше лишнего текста попадёт в алгоритм.
- Протяните рамку от левого верхнего к правому нижнему углу таблицы. Не включайте заголовок страницы, номер листа, соседний абзац и примечания, когда они не являются частью данных.
- Проверьте границы. Красная полупрозрачная область должна охватывать последнюю строку и крайний столбец, но не захватывать лишний текст рядом.
Для таблиц со сложной многоуровневой шапкой полезен пробный приём: сперва выделите только несколько обычных строк тела без заголовка и посмотрите, правильно ли определяются колонки. Когда структура стабильна, расширьте рамку. Это быстрее, чем экспортировать весь лист и потом разбирать, почему один объединённый заголовок сдвинул десятки строк.
Шаг 2. Предварительный просмотр и первая проверка
Нажмите Preview & Export Extracted Data. Tabula откроет представление, где каждая обнаруженная ячейка уже занимает своё место в строке и колонке. Не переходите сразу к Export. Сперва сопоставьте с PDF не только верхние строки, но и середину и конец таблицы. Хорошая проверка включает строку с длинным текстом, строку с пустой ячейкой, отрицательное или дробное число и крайние значения справа.
- Сосчитайте число столбцов в исходной таблице и в preview.
- Проверьте, не слиплись ли две соседние колонки в одну.
- Убедитесь, что длинный текст не создал лишнюю строку.
- Сопоставьте знак минус, десятичный разделитель и разделители тысяч.
- Посмотрите, не попали ли в данные сноска, заголовок страницы или номер листа.
При ошибке нажмите Revise selection(s). Это возвращает к исходной странице без повторного импорта PDF. Сузьте область, исключите проблемную шапку или разбейте одну большую таблицу на две независимые области. После изменения вновь откройте preview. Такой цикл «рамка — preview — корректировка» является основным рабочим методом в Tabula и обычно экономит больше времени, чем ручная очистка неудачного CSV.
Как обработать многостраничный отчёт без ручной разметки каждой страницы
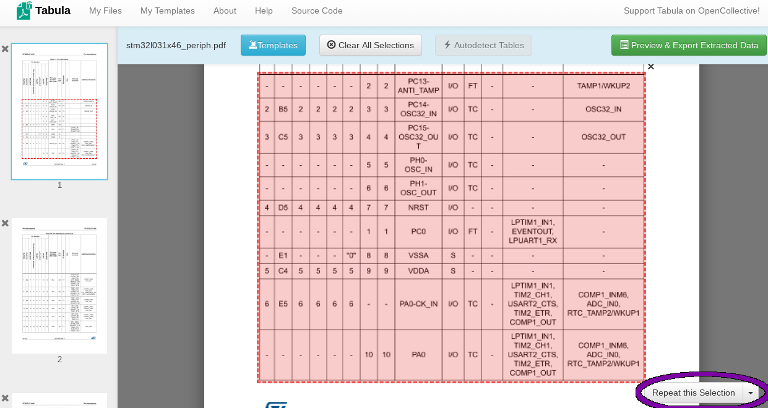
Многостраничные отчёты часто повторяют один и тот же макет: одинаковые поля, одинаковая ширина колонок и таблица в одном месте. В этом случае Tabula позволяет перенести выделение на следующие страницы. Важно различать повторение рамки и объединение данных: программа копирует координаты, но не понимает смысл перехода со страницы на страницу.
Vivonomicon
Повторение выделения и контроль смещений
- Сперва добейтесь правильной рамки на одной странице. Не размножайте неточную область.
- Применяйте Repeat this Selection. Команда переносит ту же геометрию на следующую страницу или выбранный диапазон, в зависимости от доступного элемента интерфейса.
- Просмотрите миниатюры после повторения. Убедитесь, что рамка появилась на нужных страницах, а не на титульных листах и приложениях другой структуры.
- Откройте несколько контрольных страниц. Проверяйте первую, одну из середины и последнюю, а также любую страницу с заметно отличающейся длиной заголовка.
- Исправьте локальные исключения ручным способом. Если на одной странице таблица ниже из-за добавочного заголовка, переместите рамку только там, не меняя остальные выделения.
- Запустите Preview & Export Extracted Data и проверьте, что блоки с различных страниц имеют одинаковое число колонок.
Повторяющаяся шапка таблицы заслуживает отдельного решения. Когда рамка включает заголовки колонок на каждой странице, в экспорт попадают дубли. Для аналитической таблицы чаще удобнее исключить повторные шапки из рамок и добавить один набор наименований после объединения. Когда заголовок необходим как контроль контекста, его можно оставить и удалить дубли при очистке. Главное — принять одно правило и применять его ко всему набору.
Что делать с разрывами строк между страницами
PDF не хранит логическое продолжение записи между листами. Длинное наименование, разорванное переносом страницы, обычно попадает в два фрагмента. Tabula не соединяет такие части автоматически. После экспорта отыщите строки, где основной идентификатор отсутствует или где последняя колонка внезапно пуста, и сопоставьте их с PDF. Для реестров удобно сохранять номер исходной страницы в отдельном служебном столбце во время последующей обработки.
Для большого отчёта полезен выборочный контроль после preview: по одной строке на каждый десяток страниц плюс все места со сменой шапки, ориентации или примечаний. Такой подход не гарантирует абсолютную безошибочность, но резко уменьшает риск незаметного сдвига столбцов на середине документа.
Как выбрать Stream и Lattice и исправить разбитые столбцы
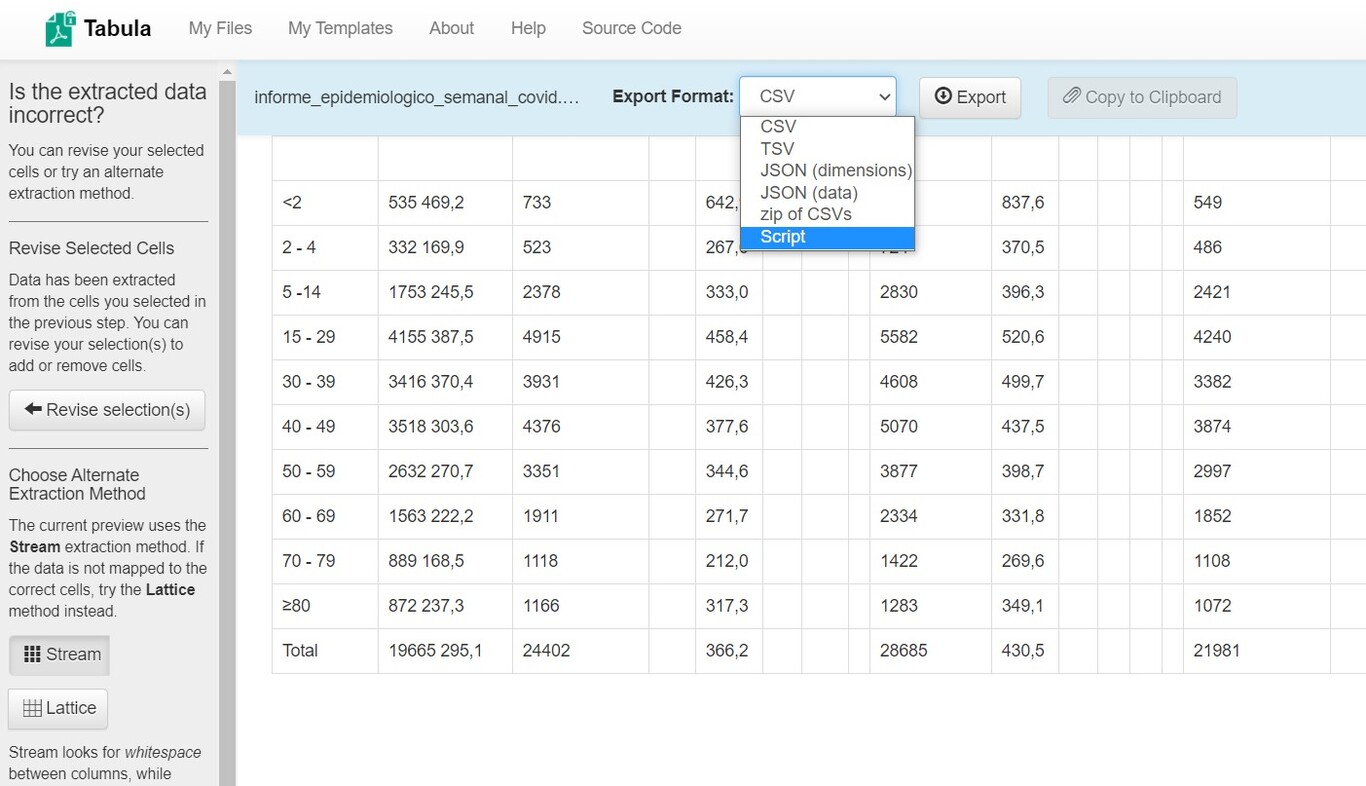
Tabula предлагает два основных метода реконструкции. Stream ищет пробелы между текстовыми фрагментами и по ним отделяет колонки. Lattice ориентируется на графические линии, образующие границы ячеек. Переключатели находятся слева на экране предварительного просмотра. Они применяются к уже выбранной области, по этой причине для сравнения методов не нужно заново импортировать PDF.
Genbeta
Практический выбор метода по виду таблицы
- Таблица без сетки, колонки разделены пустым пространством. Начните со Stream. В особенности хорошо он подходит ведомостям и отчётам, где строки выровнены, но границы ячеек не нарисованы.
- Ячейки окружены горизонтальными и вертикальными линиями. Сопоставьте Lattice. Он применяет линии как геометрические границы и часто лучше держит колонки в таблицах, экспортированных из электронных таблиц.
- Сетка есть только местами. Не полагайтесь на наименование режима. Сопоставьте оба итога на одинаковой области и выберите тот, где устойчивее сложные строки.
- Объединённые заголовки портят разметку. Сперва исключите их из рамки или выделите отдельно. Смена Stream на Lattice не всегда компенсирует сложную шапку.
Сопоставляйте методы не по первой строке. Выберите три контрольных примера: короткая числовая строка, строка с пропуском и строка с длинным текстом. В Stream важно проверить, не разбился ли один длинный текст на несколько столбцов. В Lattice — не создали ли декоративные линии лишние ячейки. Метод считается подходящим, когда одинаковая структура сохраняется на различных строках и страницах.
Как исправить слипшиеся и лишние колонки
- Вернитесь через Revise selection(s) и сузьте рамку до тела данных.
- Исключите многоуровневую шапку, если она перекрывает несколько колонок.
- Вновь откройте preview и переключите метод.
- Проверьте одну строку с пустой ячейкой: именно на ней часто видно ошибочное склеивание.
- Если одна часть таблицы строится правильно, а другая нет, выделите их отдельными прямоугольниками и экспортируйте раздельно.
- Не пытайтесь «долечить» геометрию форматом CSV или TSV: формат экспорта не меняет итог извлечения.
В сложной верстке маленькие отдельные рамки часто надёжнее одной огромной. Это в особенности верно для страницы, где слева основная таблица, справа блок примечаний, а сверху многоуровневый заголовок. Tabula не получает добавочных преимуществ от того, что всё помещено в один прямоугольник; наоборот, лишние элементы усложняют группировку текста.
Как экспортировать данные и проверить файл после сохранения
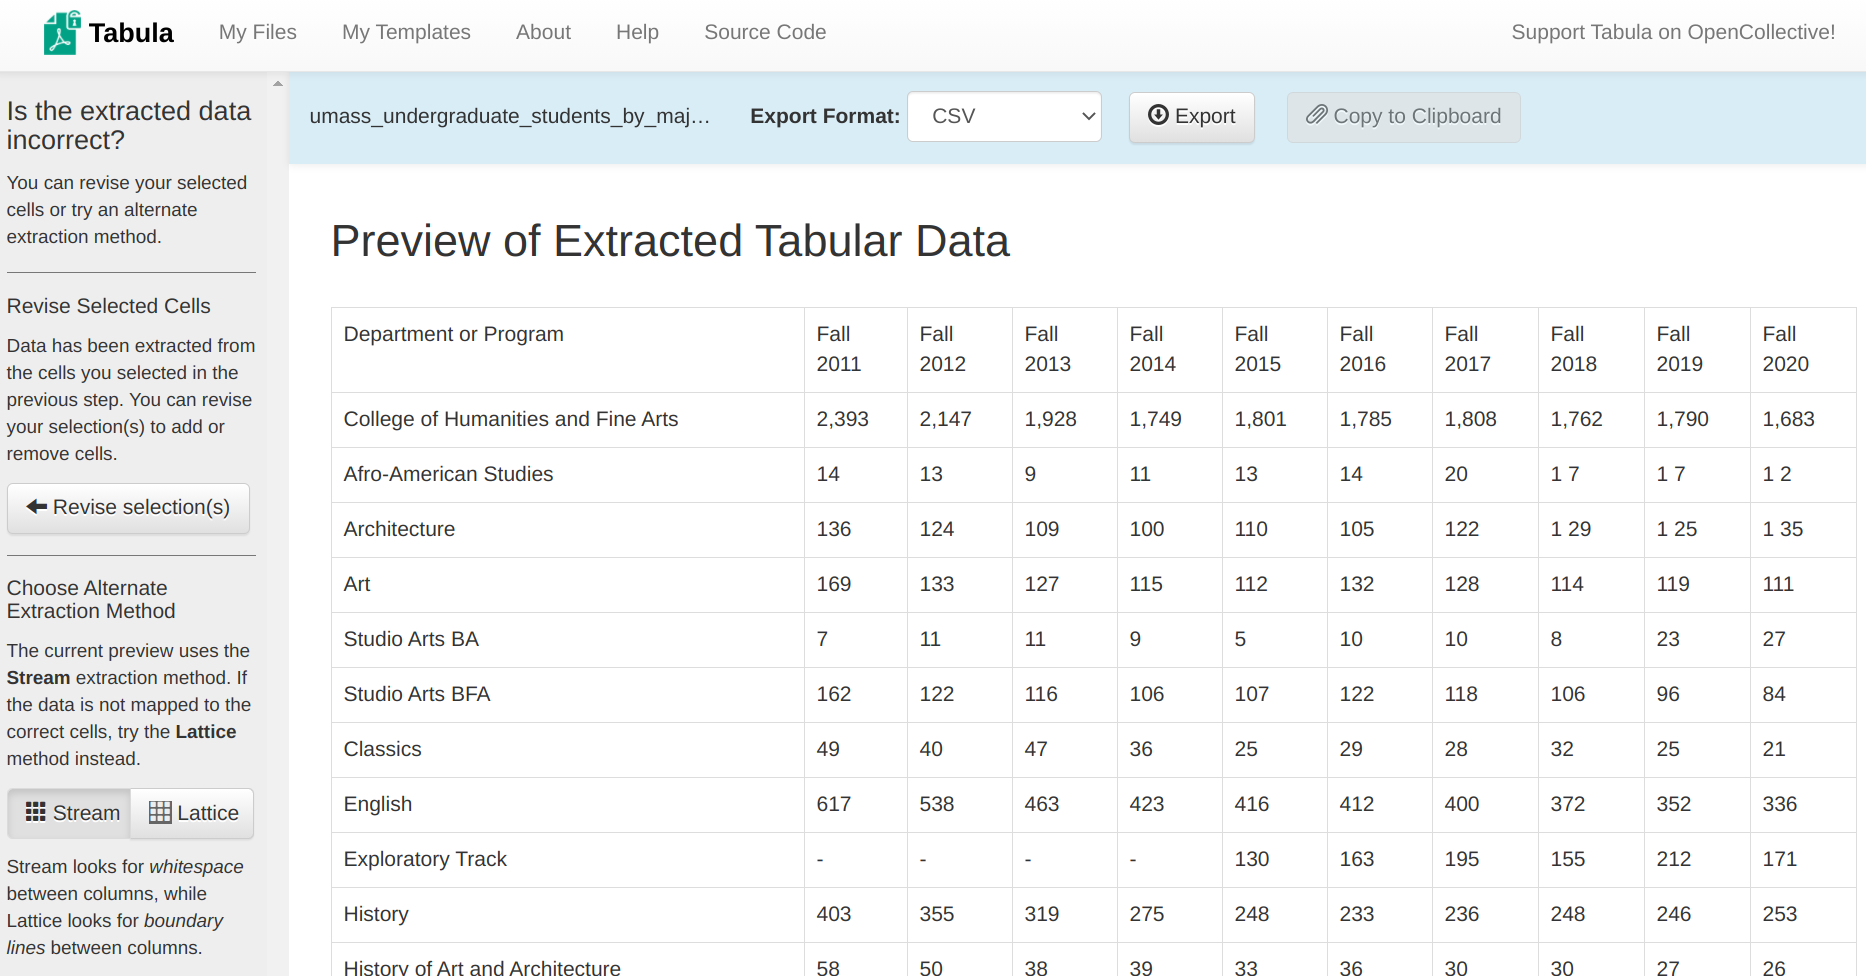
Экспорт выполняется лишь после того, как preview выглядит устойчиво. Стабильная оболочка предлагает CSV, TSV, JSON (data), JSON (dimensions), zip of CSVs и Script. Для большинства офисных задач необходим CSV или TSV; JSON полезен для программной обработки, а ZIP удобен, когда выделено несколько независимых таблиц.
Data-Driven Storytelling / Rodrigo Zamith
Как выбрать формат под дальнейшую работу
- CSV. Базовый вариант для Excel, LibreOffice Calc, аналитических систем и импорта в базы. После открытия проверьте разделитель и кодировку.
- TSV. Удобен, когда сами значения часто содержат запятые: колонки отделяются табуляцией, а не запятой.
- JSON (data). Подходит для скриптов, где необходим массив извлечённых значений.
- JSON (dimensions). Сохраняет геометрические сведения и полезен при отладке процессов, привязанных к координатам.
- zip of CSVs. Сохраняет независимые выделения как отдельные CSV, не смешивая таблицы.
- Script. Даёт основу для повторения визуально найденных координат через командный движок.
Для задачи «получить таблицу в Excel» сохраняйте CSV или TSV, затем открывайте файл в электронной таблице и отдельно сохраняйте как XLSX. Tabula не должна восприниматься как редактор Excel: она извлекает структуру из PDF. Общие методы переноса и проверки таблиц раскрыты в руководстве как преобразовать PDF в Excel.
Контроль итога после Export
- Откройте экспортированный файл в программе, где он будет реально применяться.
- Сопоставьте количество строк с исходным PDF или хотя бы с ожидаемым диапазоном.
- Проверьте крайние колонки: первая и последняя чаще всего выдают обрезанную рамку.
- Отыщите пустые значения в колонках, которые по смыслу должны быть заполнены.
- Проверьте числа с минусом, десятичной частью, процентом и разделителем тысяч.
- Сверьте несколько строк из начала, середины и конца с исходным документом.
- Сохраните необработанный экспорт отдельно от очищенной версии.
Последний пункт важен для воспроизводимости. Когда CSV сразу исправляют ручным способом и сохраняют поверх исходного, становится невозможно понять, какие значения дала Tabula, а какие изменил редактор. Практичнее держать три уровня: исходный PDF, сырой экспорт и очищенный набор. Для ответственной аналитики рядом стоит хранить краткое описание того, какие страницы и области извлекались.
Как ускорить повторяющуюся работу: шаблоны, Script и tabula-java
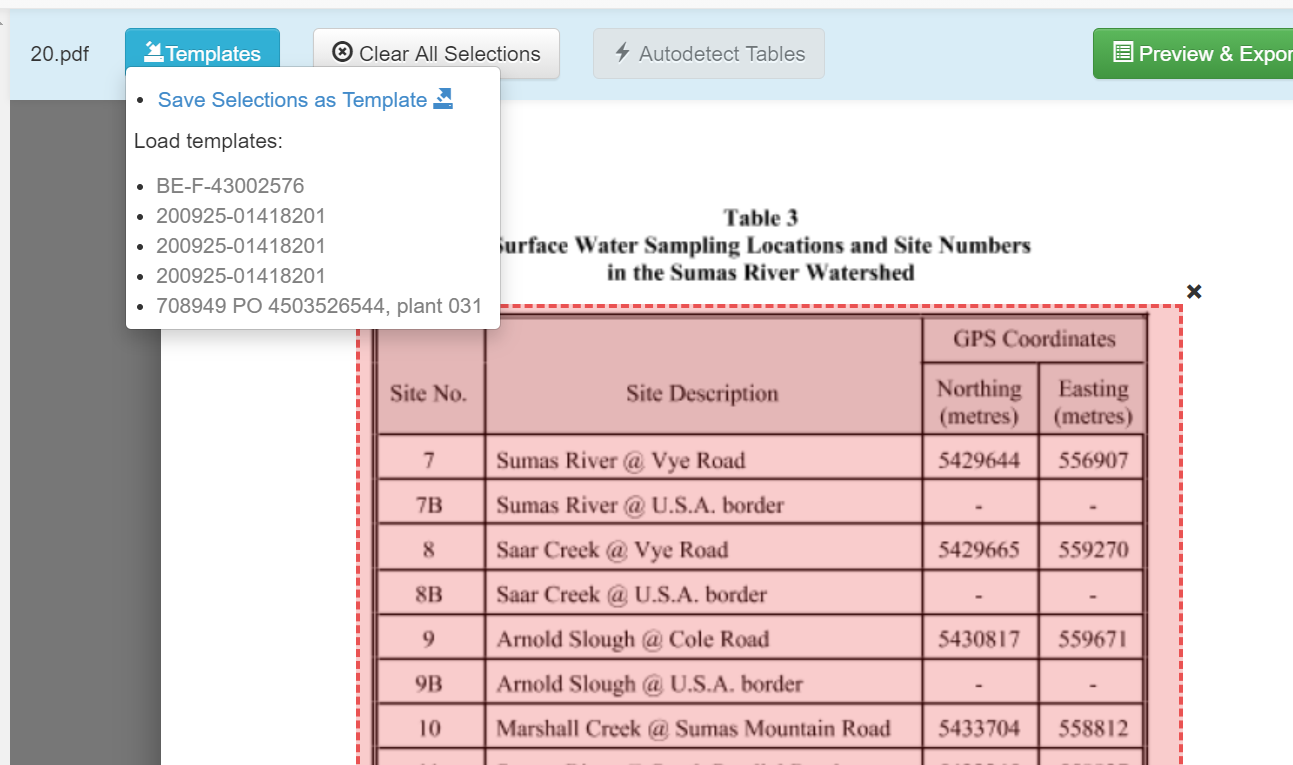
Когда один удачный экспорт уже получен, следующий шаг — убрать повторную ручную разметку. В Tabula для этого есть Templates, а для более крупного потока — Script и отдельный движок tabula-java. Эти инструменты решают различные уровни одной задачи: шаблон повторяет координаты в графическом интерфейсе, Script помогает перенести визуально найденные параметры в командный процесс, а tabula-java выполняет извлечение без ручного интерфейса.
Bedroom Computing
Как сохранить и применить Template
- Разметьте контрольный PDF и проверьте preview до сохранения шаблона.
- Откройте Templates и выберите Save Selections as Template.
- Дайте шаблону имя, которое отражает форму документа или период, а не случайное имя файла.
- Откройте другой PDF с тем же макетом.
- Загрузите сохранённый шаблон и проверьте, куда попали рамки.
- Сверьте хотя бы первую и последнюю таблицу нового документа до экспорта.
- При изменении верстки создайте отдельный шаблон, а не исправляйте старый вслепую.
Шаблоны можно выгружать в JSON и переносить между компьютерами. Это удобно в команде: один человек определяет стабильные области на контрольном документе, другой применяет те же координаты. Но шаблон привязан к геометрии. Добавленный титульный лист, другой размер страницы, смещённая таблица или изменившаяся высота заголовка требуют проверки и часто отдельной версии шаблона.
Когда переходить к tabula-java
Для десятков и сотен однотипных PDF графический интерфейс становится узким местом. tabula-java — тот же извлекающий движок, доступный как библиотека и командная утилита. В актуальном README описаны параметры области страницы, номеров страниц, формата, Stream/Lattice, вертикальных границ колонок, пароля и пакетной обработки каталога. Перед автоматизацией координаты разумно отыскать в графической Tabula, где проще визуально увидеть ошибку.
- Зафиксируйте рабочую область в графическом интерфейсе.
- Получите корректный preview на нескольких документах одного шаблона.
- Сохраните координаты через Template или Script.
- Перенесите их в tabula-java и запустите на небольшой тестовой папке.
- Сопоставьте автоматический итог с ручным контрольным экспортом.
- Лишь после этого запускайте пакет на полном наборе файлов.
Пакетный режим не отменяет выборочный контроль. Даже при одинаковом наименовании формы издатель может изменить поля, ориентацию, шрифт или добавить колонку. Хорошая автоматизация включает правило остановки: заметное изменение количества столбцов, пустой итог или аномальное число строк отправляет файл на ручную проверку.
Как исправлять типичные ошибки и проверять причину, а не симптом
Ошибки Tabula обычно связаны не с «поломкой программы», а с типом PDF, границами выделения или выбором метода. По этой причине диагностика должна идти в определённом порядке. Начинайте с текстового слоя, потом проверяйте рамку, потом Stream/Lattice и лишь после этого формат экспорта. Так легче отыскать источник проблемы.
Scolary
Пошаговая диагностика восьми частых ситуаций
Tabula сообщает, что PDF image-based
В документе нет встроенного текстового слоя. Выполните OCR в отдельной программе, сохраните PDF с распознанным текстом, проверьте несколько слов и чисел копированием и импортируйте новый файл в Tabula.
Две колонки слились в одну
Сперва сузьте рамку и исключите сложный заголовок. Потом сопоставьте Stream и Lattice. Для таблицы без линий обычно проверяют Stream, для таблицы с замкнутой сеткой — Lattice.
Появились лишние строки
Проверьте переносы длинного текста, верхние индексы и попавшие в рамку примечания. Разделите большую область на несколько более простых, когда различные части страницы имеют различную геометрию.
Крайний столбец обрезан
Вернитесь через Revise selection(s), расширьте рамку вправо и ещё раз откройте preview. После Export отдельно проверьте несколько строк именно из крайнего столбца.
На следующих страницах рамка съехала
Repeat this Selection копирует координаты буквально. Исправьте только отличающиеся страницы либо создайте отдельный шаблон для другого макета.
Русские буквы в CSV выглядят неправильно
Сохраните исходный экспорт, потом откройте его с явным выбором UTF-8 в электронной таблице. Не меняйте содержимое до проверки кодировки, иначе появятся необратимые замены символов.
Copy to Clipboard не сработал
Применяйте Export в CSV или TSV. Буфер обмена зависит от браузера, а файл даёт более воспроизводимый итог и сохраняет промежуточный артефакт для проверки.
Preview выглядит хорошо, но данные всё равно подозрительны
Сверьте строки с пустыми ячейками, отрицательными числами, длинным текстом и примечаниями. Визуально ровная сетка не гарантирует, что каждый символ интерпретирован верно.
Для отсканированных документов порядок особый: сперва OCR и проверка текстового слоя, затем Tabula. Нельзя пытаться исправить отсутствие текста переключением Stream/Lattice — оба метода работают с уже существующими текстовыми объектами. При числовых таблицах после OCR уделите внимание похожим символам: 0 и O, 1 и I, точке и запятой. Такие ошибки выглядят правдоподобно и легко проходят поверхностный контроль.
Как построить контроль качества для рабочего процесса
- До извлечения зафиксируйте ожидаемые колонки и обязательные поля.
- После preview проверьте минимум четыре типовых строки различной сложности.
- После Export сопоставьте количество строк и несколько сумм или контрольных итогов, когда они есть в документе.
- Храните PDF и сырой экспорт вместе, чтобы любую строку можно было восстановить до источника.
- Для серии документов ведите список исключений: смещённая рамка, новая шапка, лишняя колонка, ошибка OCR, нестандартная кодировка.
Этот подход превращает Tabula из разовой утилиты в управляемый процесс. Главный критерий качества — не скорость кликов, а возможность пояснить, откуда взялась каждая колонка и как проверялся итог.
Отдельно проверяйте несколько таблиц на одной странице. Нарисуйте независимую рамку вокруг каждого блока вместо общего прямоугольника, потом откройте preview и убедитесь, что Tabula показывает их как отдельные таблицы, а не склеивает строки в один набор. При экспорте в zip of CSVs это в особенности удобно: каждый выделенный блок сохраняется отдельным файлом. После распаковки сопоставьте имена файлов с порядком выделений и сразу переименуйте их по смыслу, чтобы при дальнейшей обработке не перепутать показатели из соседних таблиц.
Для числовых данных добавьте простую арифметическую проверку. Выберите в PDF строку или столбец, где напечатан итог, затем вычислите ту же сумму по экспортированным значениям. Расхождение указывает не только на арифметическую ошибку: оно зачастую помогает обнаружить пропущенную строку, неверно распознанный минус или ячейку, которая попала в соседний столбец. В отчётах без контрольных итогов сопоставляйте количество записей по страницам и диапазоны идентификаторов.
При повторной обработке одного и того же документа не удаляйте прежний сырой экспорт до окончания сравнения. Сперва сохраните новый файл рядом, потом проверьте размер, число строк, число колонок и несколько контрольных значений. Разница между двумя экспортами при неизменном PDF требует объяснения: изменились рамки, метод Stream/Lattice, версия движка или условия OCR. Такой журнал изменений в особенности важен для регулярной отчётности, где итоги месяца должны быть сопоставимы с предыдущими периодами.
Преимущества, недостатки и кому подходит Tabula
Сильная сторона Tabula — прозрачный контроль над геометрией. Пользователь сам выбирает область, видит предварительный итог и при необходимости меняет метод. Это в особенности ценно там, где универсальный конвертер пытается обработать весь документ и смешивает таблицу с соседним текстом.
Leancrew
Плюсы
- бесплатная программа с открытым исходным кодом и MIT-лицензией;
- локальная обработка PDF в обычном сценарии запуска;
- ручное точное выделение одной или нескольких областей;
- предварительный просмотр до сохранения;
- два понятных метода — Stream и Lattice;
- шаблоны и повторение выделений для однотипных документов;
- экспорт в CSV, TSV и JSON, а также переход к командной автоматизации через tabula-java.
Минусы
- нет встроенного OCR для сканов без текстового слоя;
- стабильная оболочка Tabula давно не получает обычных пользовательских релизов;
- интерфейс англоязычный и основан на локальном браузерном приложении;
- сложные многоуровневые таблицы требуют ручной разметки и проверки;
- данные после извлечения часто нуждаются в очистке и приведении типов;
- шаблоны зависят от неизменности геометрии страниц.
Кому подойдёт
- аналитикам, исследователям и журналистам данных, которые получают таблицы в PDF;
- сотрудникам, которым важно не отправлять рабочие документы в сторонний онлайн-сервис;
- разработчикам, которым необходимо визуально отыскать корректные области перед переходом к tabula-java;
- командам, обрабатывающим повторяющиеся формы с одинаковой версткой.
Кому не подойдёт
- пользователям, которым необходим OCR сканов в одном окне;
- тем, кому требуется редактирование текста, страниц, подписей и защиты PDF;
- проектам, где необходима полностью автоматическая семантическая интерпретация сложных таблиц без ручной проверки;
- задачам, где основной вход — фотографии или изображения без текстового слоя.
Сравнение с реальными альтернативами
Tabula стоит сопоставлять не по количеству функций, а по роли в процессе. Она специализирована на визуальной разметке и извлечении таблиц из текстового PDF. Другие инструменты закрывают соседние задачи: OCR, программную обработку, низкоуровневую работу с геометрией или полноценное редактирование документов.
Softpedia
Когда лучше выбрать иной инструмент
- ABBYY FineReader PDF или Adobe Acrobat. Подходят, когда исходник — скан и первым этапом необходим OCR либо требуется универсальная работа с PDF. После OCR итог всё равно стоит проверять перед аналитикой.
- Camelot. Ориентирован на Python и воспроизводимую обработку текстовых PDF кодом. Удобнее, когда задача уже формализована и должна запускаться в скриптах.
- pdfplumber. Даёт низкоуровневый доступ к символам, словам, линиям и координатам. Полезен для собственных правил извлечения, но требует программирования.
- tabula-java. Движок самого проекта без графической оболочки. Предпочтителен для командной строки, пакетного режима и интеграции в автоматизированный процесс.
Для человека, которому необходим не инструмент извлечения, а общая работа с форматом, полезнее сперва определить задачу по материалу что такое PDF и как с ним работать. Для конкретной проблемы «таблица есть, но копируется неправильно» есть отдельное руководство как вытащить таблицу из PDF. Tabula занимает узкую позицию между универсальными PDF-программами и кодовыми библиотеками: визуально настраивает область, но сохраняет данные в удобном для дальнейшей автоматизации виде.
При выборе инструмента применяйте тип исходника как первый фильтр. Текстовый PDF с одной сложной таблицей — естественная территория Tabula. Скан — сперва OCR. Сотни однотипных файлов — после визуального прототипа переход к CLI. Документ, который необходимо подписать, отредактировать и переставить страницы, — задача полноценного PDF-редактора, а не Tabula.
Практические рекомендации перед началом проекта
Для единичной таблицы не усложняйте процесс: импорт, точная рамка, preview, сравнение Stream/Lattice, экспорт, проверка. Для серии документов сперва получите один эталонный итог, потом сохраните шаблон и протестируйте его на нескольких файлах различного периода. Для большого массива после стабилизации геометрии переносите параметры в tabula-java и сохраняйте логи обработки.
PDFgear
Короткий рабочий чек-лист
- Убедитесь, что PDF содержит выделяемый текст.
- Сделайте контрольную рамку без лишних заголовков и сносок.
- Проверьте preview минимум на нескольких различных строках.
- Сопоставьте Stream и Lattice на сложной строке, а не только на первой.
- Выберите CSV/TSV для таблиц или JSON для программной обработки.
- Не перезаписывайте сырой экспорт очищенной версией.
- Для повторяющейся верстки применяйте Template и храните его вместе с описанием формы.
- Для сканов сперва выполните OCR и отдельно проверьте качество распознавания цифр.
- При автоматизации предусмотрите выборочную проверку и обработку исключений.
Tabula полезна не потому, что обещает «один клик», а потому, что делает процесс наблюдаемым. Пользователь видит исходную страницу, сам задаёт геометрию и получает preview до сохранения. В задачах, где точность важнее внешней эффектности, такой контроль часто ценнее универсального конвертера. Главное — не смешивать извлечение с очисткой и всегда оставлять возможность вернуться от итоговой строки к исходному PDF.
Pythonic Excursions / автор страницы
Vivonomicon
Genbeta
Bedroom Computing