
Super PDF Editor — настольный PDF-процессор для Windows, ориентированный не только на одиночные правки, но и на очереди файлов, повторяемые операции со страницами, OCR, конвертацию, защиту и полиграфическую подготовку. На XeonLive можно скачать Super PDF Editor бесплатно и сверить назначение программы перед установкой. Ниже — практическая схема работы с подтверждёнными командами и ограничениями.
Что делает Super PDF Editor и как читать его интерфейс
Super PDF Editor разработан Pulkitsoft LLP как локальный настольный процессор PDF. Его сильная сторона — не классическое редактирование одного документа в стиле текстового редактора, а потоковая обработка: файлы собираются в очередь, для них выбирается операция, задаются диапазон страниц, правила имени и папка итога, после чего задача запускается одной командой. Такой подход в особенности удобен для повторяющихся офисных, архивных и допечатных операций, когда одинаковое действие необходимо применить сразу к серии документов.
Текущая страница загрузки Pulkitsoft указывает версию 11.2.0, 64-разрядную Windows-сборку, .NET Framework 4.8 и поддержку Windows 10/11. Публичные снимки интерфейса, по которым можно точно назвать элементы управления, относятся в том числе к версии 10.3.0 и более ранним выпускам. По этой причине ниже наименования кнопок привязаны к реально показанным экранам, а список возможностей версии 11.2.0 сверяется отдельно по актуальному описанию функций.
Карта рабочего окна: очередь, операция, параметры и запуск
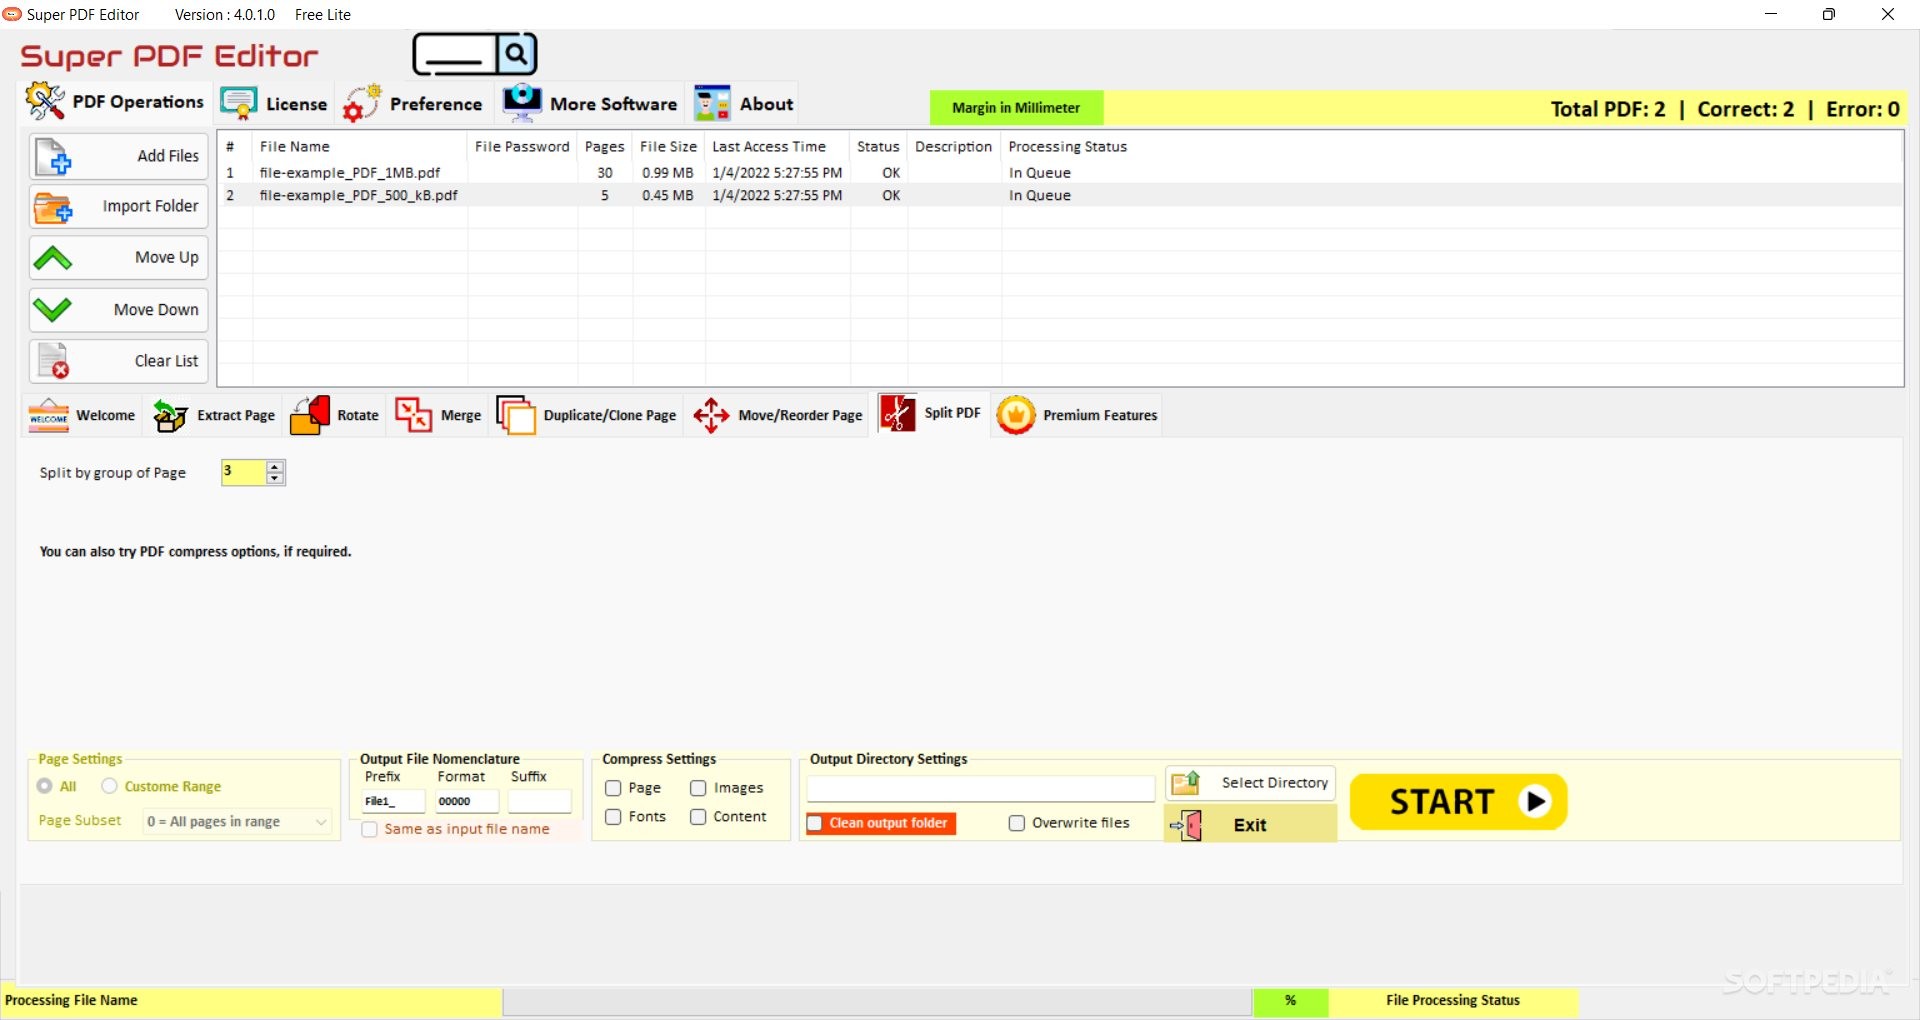
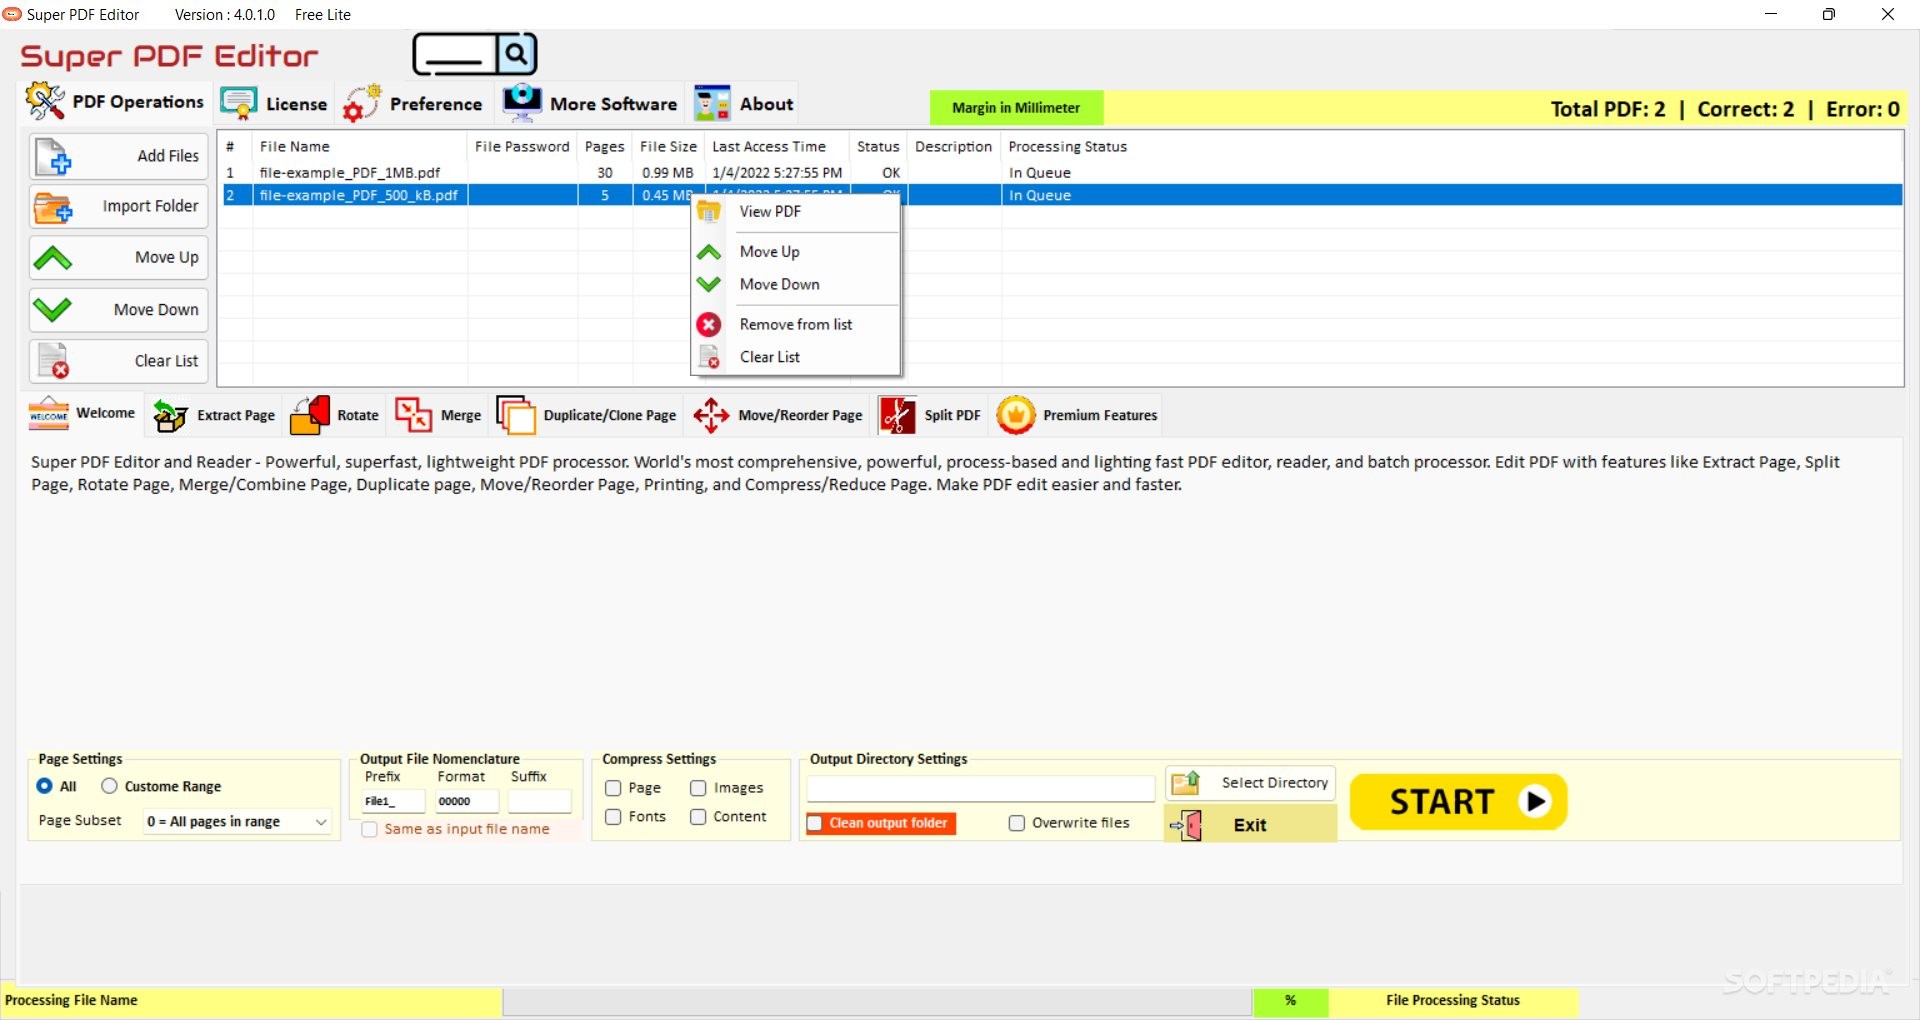
Рабочее окно построено вокруг очереди. Слева находятся команды добавления и управления входными файлами: Import Files, Import Folder, Move Up, Move Down и очистка списка. В центральной таблице видны имена документов и служебные колонки обработки. Внизу размещается панель выбранной операции, рядом — диапазон страниц, формирование имени итога и выходная папка. Кнопка START или START-HERE запускает обработку.
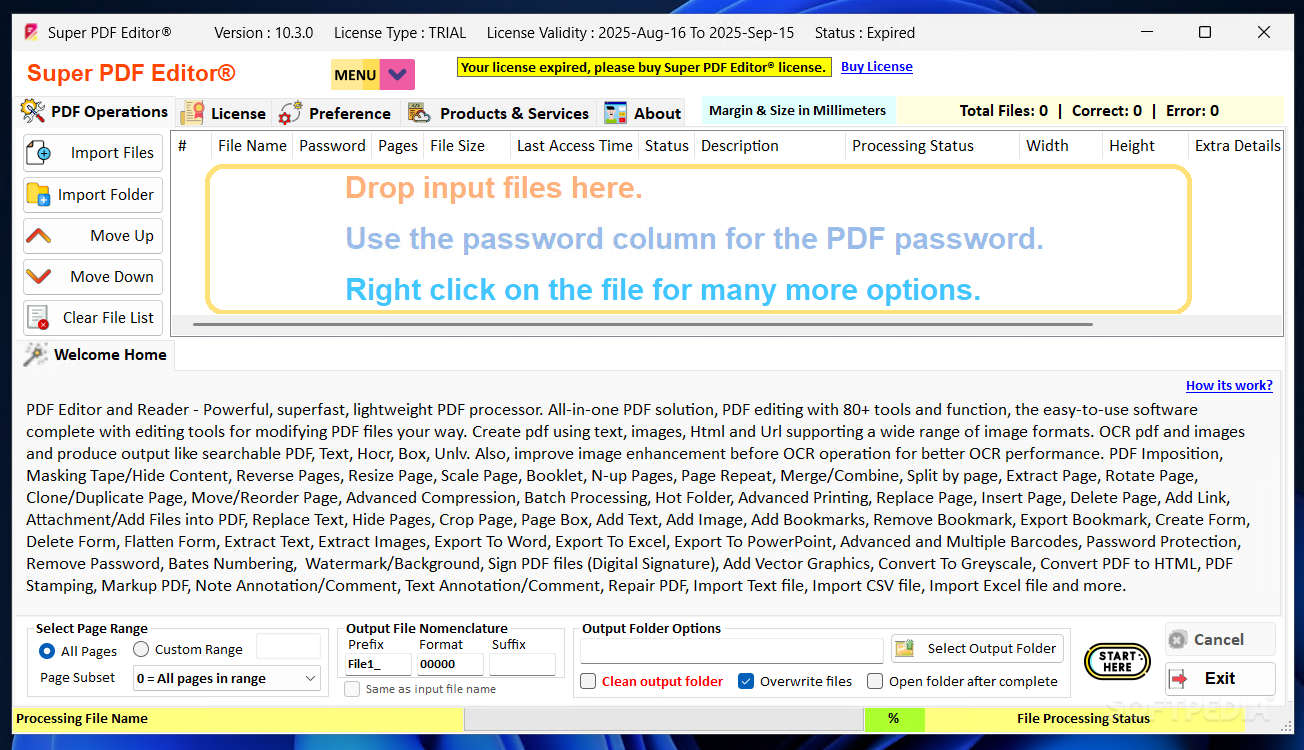
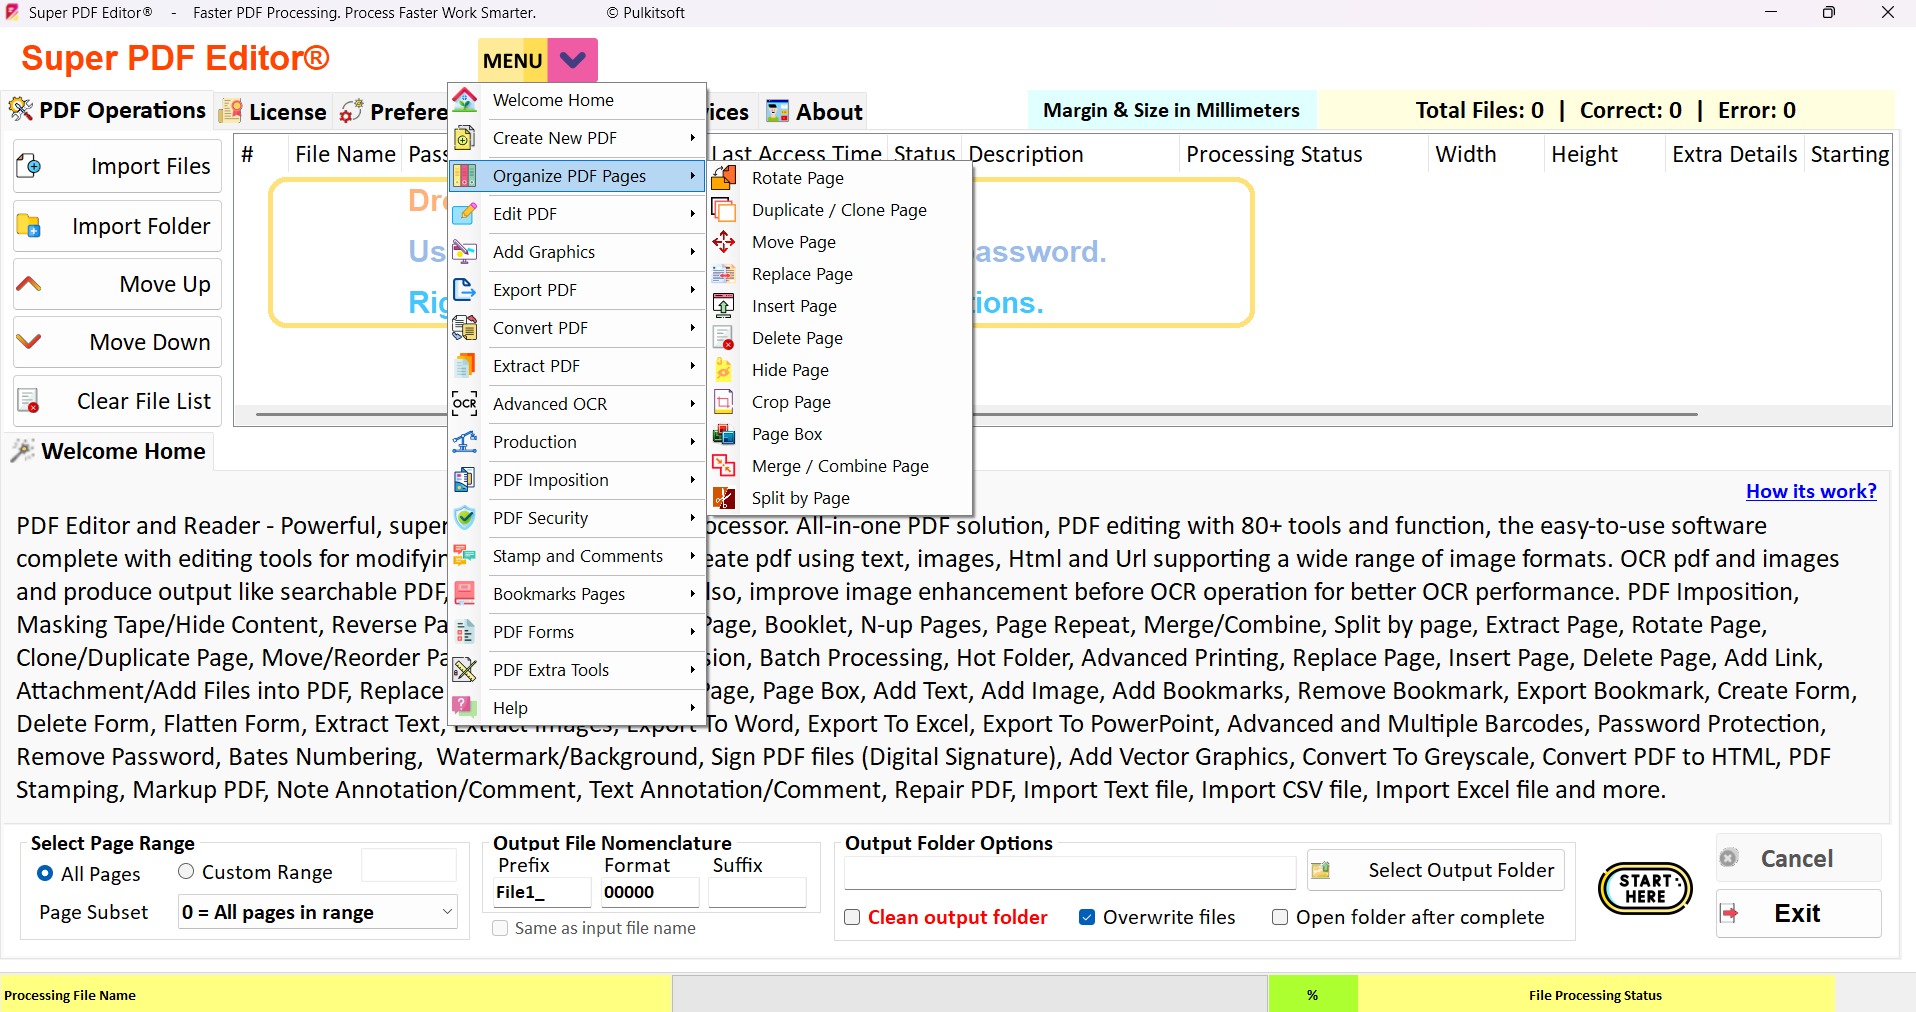
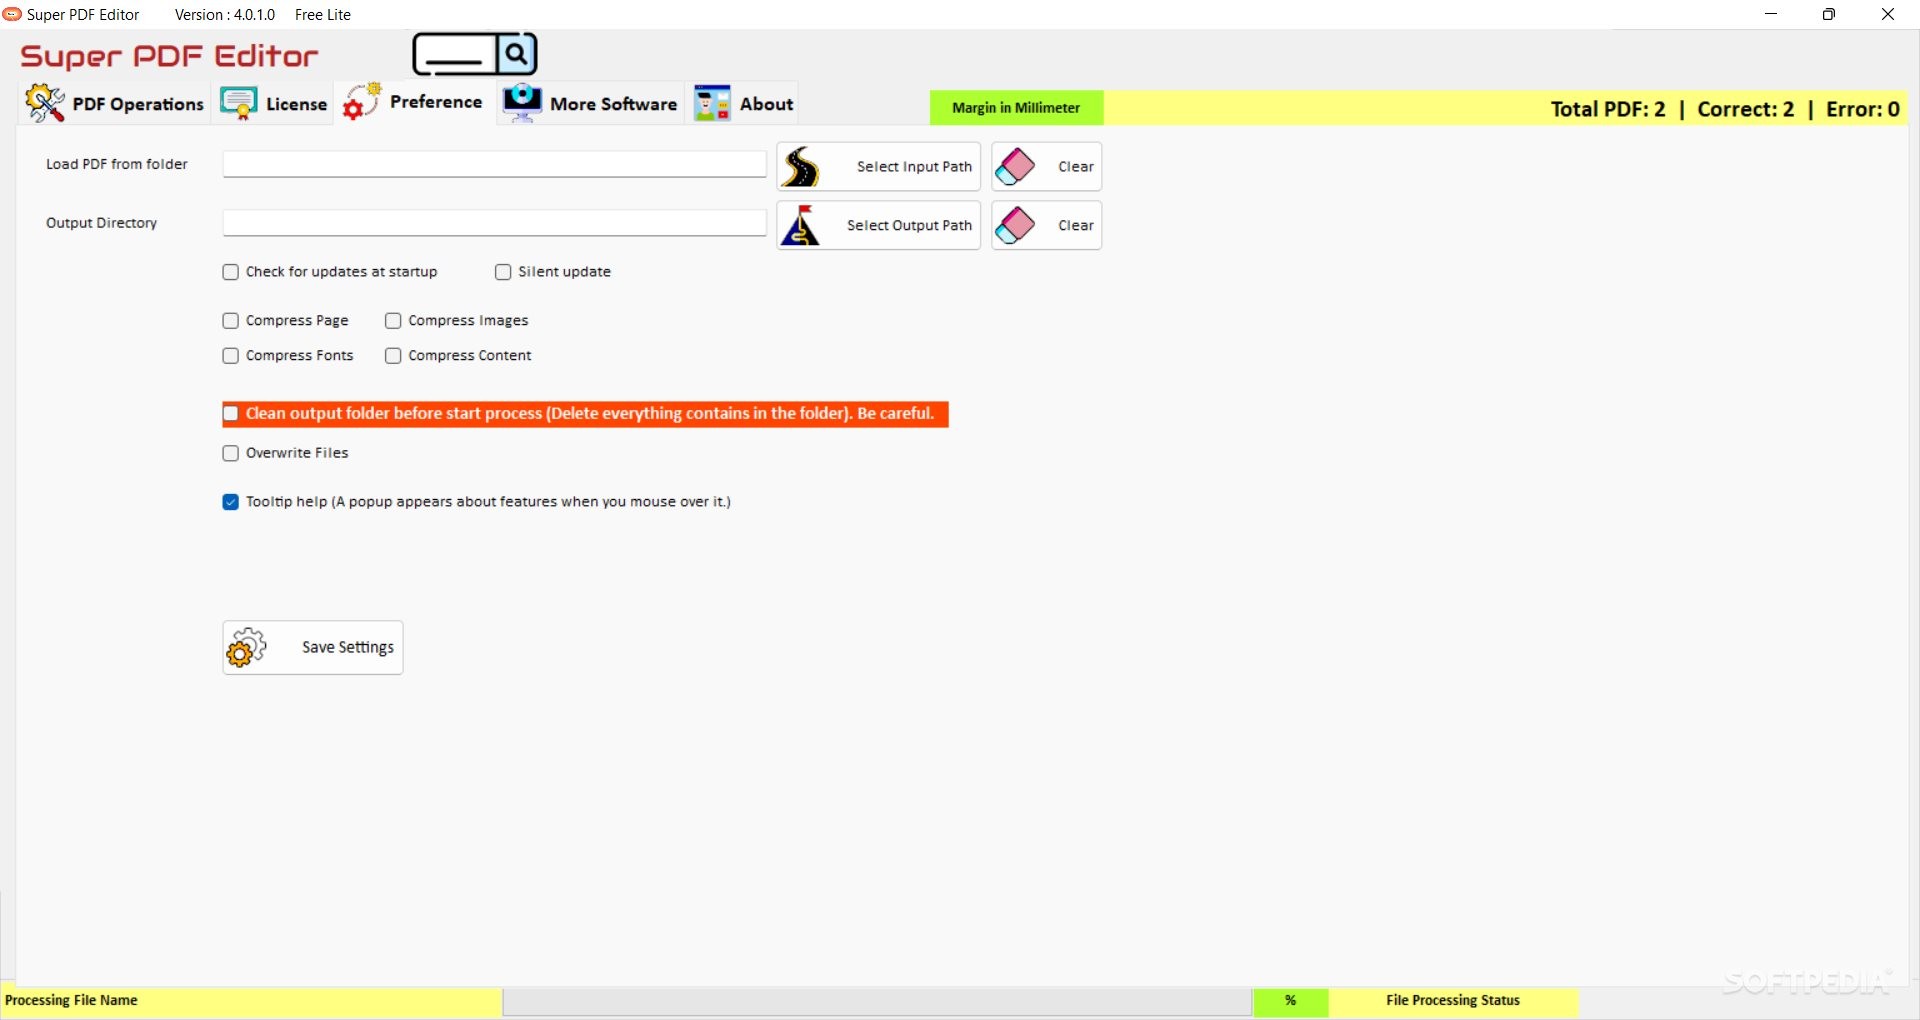
В верхней части публичного интерфейса тоже видны разделы PDF Operations, License, Preference, Products & Services и About. Отдельное меню группирует действия в Create New PDF, Organize PDF Pages, Extract PDF и справку. Это важная логика: сперва выбирается тип процесса, затем входные файлы и лишь после этого параметры конкретной операции.
Практически полезно воспринимать Super PDF Editor как конвейер из четырёх зон. Первая зона — вход: один файл, набор файлов или папка. Вторая — операция: поворот, объединение, извлечение, OCR, создание PDF, защита и другие действия. Третья — настройки: страницы, качество, имя, папка, перезапись и сжатие. Четвёртая — контроль: статус по каждому документу, итоговые счётчики и журнал. При таком чтении интерфейс перестаёт выглядеть перегруженным, даже когда на панели доступно много функций.
Для понимания базовых операций самого формата полезно держать рядом отдельный гид XeonLive по устройству и обработке PDF: он помогает отличать редактирование содержимого от перестановки страниц, конвертации и OCR.
Как пакетно объединять, делить, поворачивать и переставлять страницы
Самый показательный рабочий сценарий Super PDF Editor — серия однотипных операций с несколькими PDF. Порядок действий одинаков для объединения, разделения, поворота, извлечения и части других инструментов: собрать очередь, выбрать процесс, ограничить страницы, задать выход и запустить обработку. Важно сперва привести очередь к нужному порядку, потому что для объединения последовательность входных файлов напрямую влияет на итоговый документ.
Пошаговый процесс от загрузки файлов до проверки итога
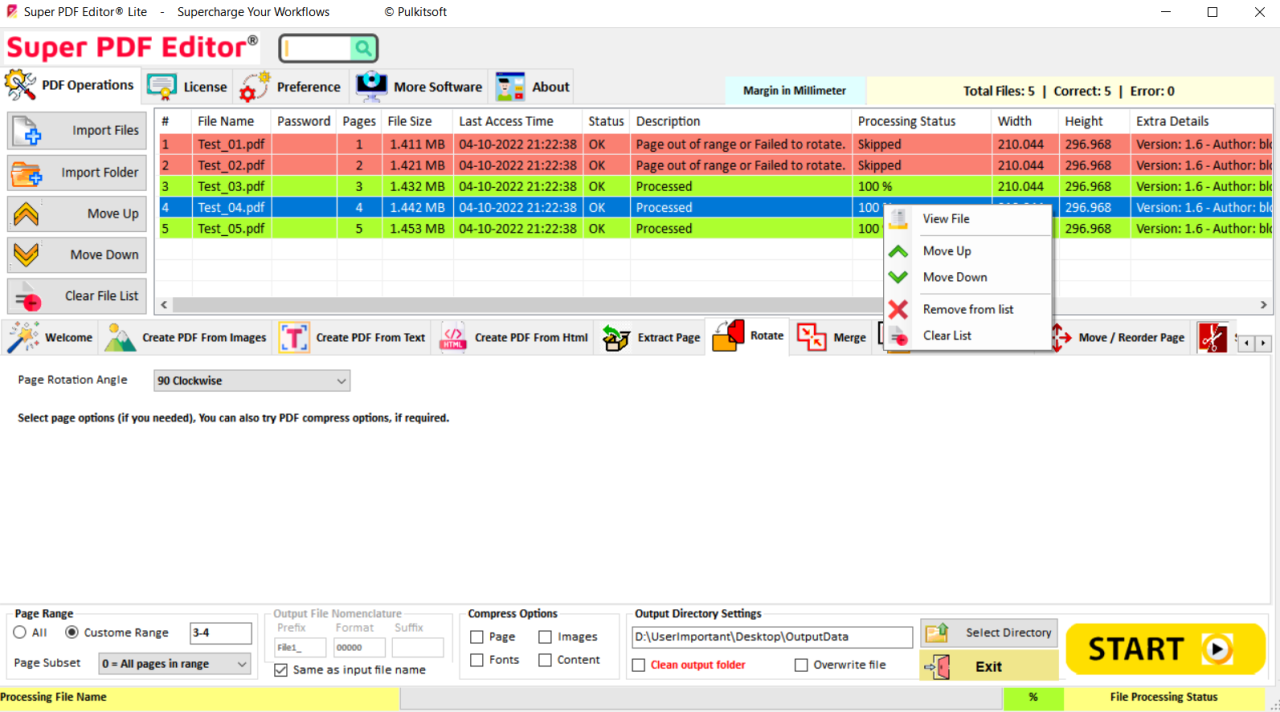
Шаг 1. Соберите входную очередь. Нажмите Import Files для выборочных документов или Import Folder, когда задача охватывает папку. После загрузки проверьте таблицу: в ней должны оказаться только те файлы, которые входят в текущую операцию. Лишний элемент удаляется через контекстное меню или очистку списка, а порядок меняется командами Move Up и Move Down.
Шаг 2. Сразу разберите защищённые документы. На публичных экранах предусмотрена колонка Password для PDF с паролем. Не запускайте длинную очередь, пока не убедитесь, что защищённые файлы открываются и программа получила нужные данные для обработки. Иначе часть списка уйдёт в пропуски, а итоговая папка окажется неполной.
Шаг 3. Выберите операцию. Для поворота применяется Rotate, для объединения — Merge или Merge/Combine, для получения отдельных частей — Split PDF либо Split by Page, для копирования страниц — Duplicate/Clone Page, для изменения позиции — Move/Reorder Page. Отдельные операции доступны из группы Organize PDF Pages.
Шаг 4. Ограничьте диапазон. В блоке Page Range сперва выберите все страницы или собственный диапазон. Для одиночного документа полезно начать с короткого теста: к примеру, обработать несколько страниц, открыть итог и только затем повторить задачу для полного диапазона. Такой приём в особенности полезен при повороте, масштабировании и обрезке, где ошибка параметра легко размножается на весь пакет.
Шаг 5. Настройте имена. В области Output File Nomenclature публичный интерфейс отображает Prefix, Format и Suffix. Эти поля позволяют не смешивать исходники с итогами и получать предсказуемые имена. Для производственной папки разумно задавать различимый префикс операции, а исходные файлы оставлять нетронутыми.
Шаг 6. Выберите выходную папку. Через Select Directory назначьте отдельный каталог итога. Опция Clean output folder очищает выходной каталог перед обработкой, по этой причине её применяют только к специально выделенной рабочей папке. Overwrite files разрешает замену существующих итогов; при первой настройке процесса безопаснее оставить перезапись неактивной.
Шаг 7. Запустите короткую проверочную очередь. Нажмите START. Следите за колонками Processing Status и счётчиками Correct/Error. В показанном интерфейсе успешные строки получают статус Processed, а проблемные могут быть помечены Skipped с текстом причины. После окончания не ограничивайтесь зелёным статусом: откройте несколько итогов, сверьте число страниц, ориентацию и порядок.
Шаг 8. Повторите процесс для полного набора. Когда тестовый файл или небольшая группа дали ожидаемый итог, добавьте весь пакет, сохраните те же параметры и запустите обработку. Для повторяемых процессов удобно сохранять структуру входной и выходной папок отдельно, чтобы очередь было проще воспроизвести без ручной сортировки.
Для объединения порядок файлов проверяют до запуска: документ, который должен идти первым, ставят выше остальных. Для разделения, наоборот, главным становится правило Split by Page и диапазон. Для поворота сперва задают угол и короткий диапазон, затем проверяют один итог. Для перемещения страниц задают исходную и целевую позицию. Программа рассчитана на повторение одного процесса над серией документов, по этой причине не стоит в одной очереди смешивать различные задачи.
Когда требуется не просто разделить файл, а продумать структуру документа, полезна отдельная инструкция XeonLive о том, как организовать PDF: сортировать, удалять и объединять страницы. Для точечного сценария объединения есть тоже инструкция по объединению нескольких PDF.
Сценарий: извлечь нужные страницы из большого документа. Выберите Extract Page, загрузите PDF и в Page Range задайте только нужный фрагмент. Для нескольких несмежных частей выполняйте отдельные проходы, чтобы имена итогов однозначно показывали, какой диапазон они содержат. После запуска сопоставьте количество полученных страниц с диапазоном и откройте первую и последнюю страницу каждого итога. Отдельная операция Extract удобнее ручного удаления десятков ненужных листов, потому что мастер-файл остаётся неизменным.
Сценарий: заменить ошибочную страницу. В группе операций со страницами выберите Replace Page. Подготовьте корректную страницу заблаговременно как отдельный PDF, потом укажите позицию замены и выполните задачу на копии исходника. Контроль состоит из трёх пунктов: общее количество страниц не должно измениться, новая страница должна оказаться на заданной позиции, а соседние страницы должны остаться прежними. Такой подход подходит для договоров, каталогов и инструкций, где заменяется один лист без пересборки всего документа.
Сценарий: вставить новый лист. Применяйте Insert Page, когда нужно добавить титульную страницу, приложение или разделитель. До запуска определите, перед какой или после какой существующей страницы должен появиться новый материал. После обработки проверьте не только позицию вставки, но и нумерацию, закладки и ссылки в документе: добавление листа меняет физические номера страниц, даже когда печатные номера внутри макета остаются прежними.
Сценарий: убрать страницу без пересборки. Для Delete Page сперва создайте копию исходника и задайте точный диапазон удаления. После START сопоставьте исходное и итоговое количество страниц. Для серии однотипных файлов удаление одного и того же листа удобно выполнять пакетно, но только когда структура документов в самом деле одинакова. Несовпадающие по длине документы лучше обрабатывать отдельными группами.
Сценарий: кадрирование и выравнивание размеров. Crop Page, Page Box, Resize и Scale решают различные задачи. Crop убирает лишние поля, Resize меняет размер листа, Scale изменяет масштаб содержимого. Сперва обработайте одну страницу с характерными полями, откройте итог и измерьте визуальные отступы. Для документов, которые пойдут в печать, проверка должна охватывать реальный размер страницы, а не только вид на экране.
Сценарий: быстро восстановить порядок. Когда страницы расположены не так, как необходимо, применяйте Move/Reorder Page вместо последовательного извлечения и повторного объединения. Сперва запишите требуемую позицию проблемного листа, потом выполните перемещение. Итог проверяйте по содержанию соседних страниц. Для десятков перестановок удобнее разбить задачу на несколько контролируемых проходов, чем задавать сложную схему без промежуточной проверки.
Как создавать PDF из изображений и распознавать сканы через OCR
Super PDF Editor умеет создавать PDF из изображений, текстовых и HTML-файлов, а OCR применяется к PDF и графическим сканам. Для изображений в особенности важен этап подготовки: в интерфейсе предусмотрены коррекция яркости и контраста, разрешения, поворота, цвета и других параметров. На странице функций Pulkitsoft тоже перечислены deskew, crop, scale, resize, binarize, grayscale, noise reduction и добавочные фильтры. Эти действия полезны до распознавания, потому что OCR работает лучше на ровном, контрастном и читаемом исходнике.
Пошагово: из сканов в нормальный PDF с текстовым слоем
Шаг 1. Подготовьте исходники. Для сканов и фотографий документов применяйте файлы JPG, PNG, GIF, TIFF или BMP — эти форматы перечислены для OCR на странице функций. До загрузки отсортируйте страницы по порядку. При пакетном импорте удобнее именовать файлы так, чтобы сортировка совпадала с порядком страниц.
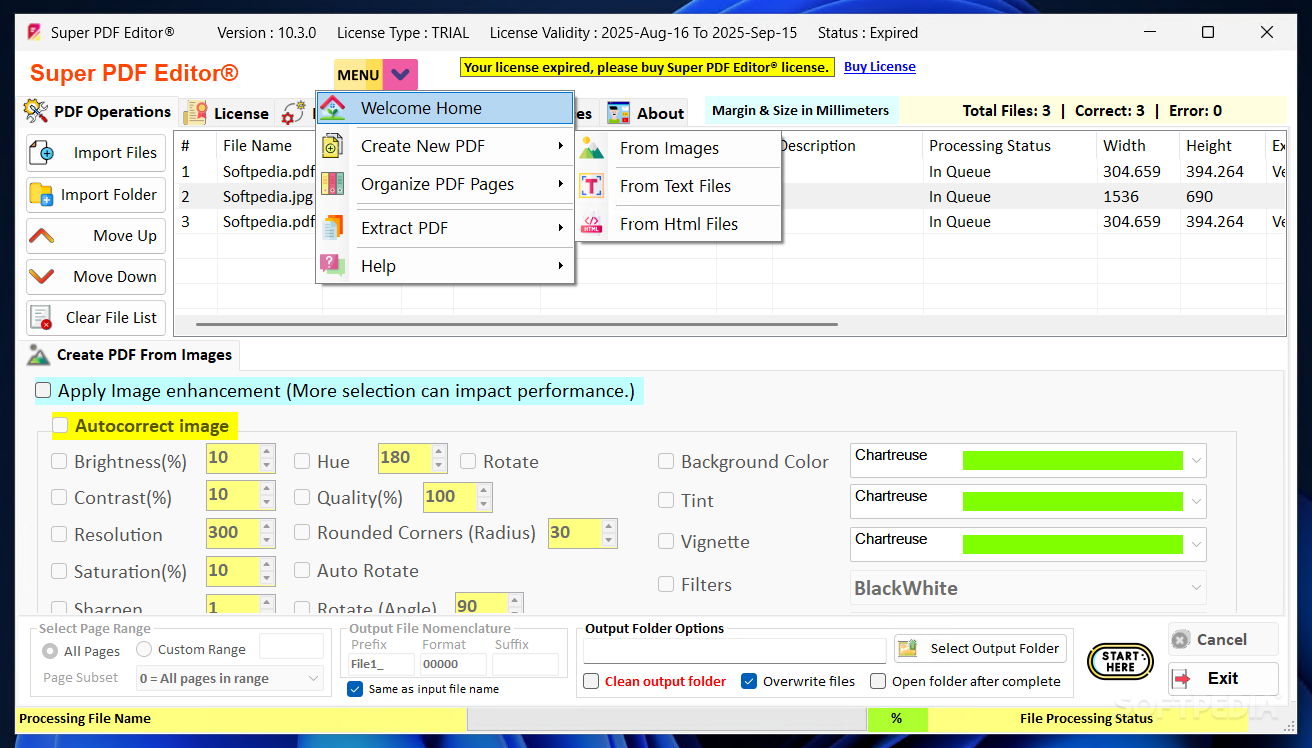
Шаг 2. Откройте создание PDF из изображений. В меню Create New PDF выберите From Images. Добавьте изображения через Import Files или целую папку. В таблице проверьте, что отсутствуют дубликаты и лишние файлы, затем при необходимости исправьте порядок.
Шаг 3. Активируйте коррекцию только там, где она необходима. В показанном окне есть Apply Image enhancement и Autocorrect image. Ручные параметры содержат Brightness, Contrast, Resolution, Saturation, Sharpen, Hue, Quality, Rotate и другие преобразования. Не активируйте весь набор одновременно. Для серых офисных сканов сперва проверьте ориентацию, контраст и удаление фонового шума, потом сопоставьте итог с исходником.
Шаг 4. Сохраните пробный PDF. Укажите выходную папку, диапазон и имя итога, потом запустите процесс. Откройте готовый документ во встроенном просмотрщике или отдельном PDF-reader и проверьте размер страницы, порядок изображений, наличие обрезанных полей и читаемость мелкого текста.
Шаг 5. Перейдите к OCR. Для распознавания выберите OCR PDF или OCR для изображений. Актуальная страница загрузки отдельно предупреждает, что для OCR и обработки изображений необходим Microsoft Visual C++ Runtime; тоже предлагаются языковые наборы Main, Fast и Best. Набор Main описан как баланс скорости и точности, Fast — как более быстрый и менее точный, Best — как наиболее точный и медленный.
Шаг 6. Выберите языки и качество распознавания. Официальное описание заявляет поддержку 165+ языков и возможность применять несколько языков одновременно. Для смешанного документа выбирайте только реально присутствующие языки: это сокращает число неоднозначных распознаваний. Для черновой индексации подходит быстрый режим, а для архивной копии с последующим поиском — более точный набор.
Шаг 7. Выберите тип итога. Для OCR подтверждены Searchable PDF, Text, hOCR, Box и UNLV. Для обычного документооборота основной вариант — Searchable PDF: визуальная страница остаётся PDF, а поверх неё появляется текстовый слой для поиска и копирования. Текстовый файл удобен, когда необходим чистый извлечённый текст без исходной верстки.
Шаг 8. Проверьте OCR по проблемным местам. После обработки ищите в документе редкие фамилии, номера, сокращения и слова из мелкого шрифта. Не оценивайте качество только по тому, что поиск в целом работает. Сверьте несколько строк с оригиналом, отдельно проверьте таблицы и наклонные сканы. Ошибочные страницы лучше ещё раз обработать после коррекции, а не переделывать весь пакет.
Детальный разбор текстового слоя и отличий OCR от обычного копирования есть в материале XeonLive о распознавании текста в PDF. Для исходных бумажных документов пригодится и инструкция по созданию PDF со сканера, телефона и фото.
Сценарий: сделать PDF из текстовых файлов. Откройте Create New PDF и выберите From Text Files. Добавьте исходники, установите формат бумаги и доступные параметры оформления, затем сформируйте один пробный документ. Проверяйте переносы строк, кодировку символов и разрывы страниц. Этот режим полезен для логов, отчётов и простых текстовых материалов, где важнее единый PDF, чем сложная верстка.
Сценарий: преобразовать HTML в PDF. На странице функций указано создание PDF из HTML с применением Google Chrome или Microsoft Edge. Подготовьте HTML-файл, откройте соответствующий пункт From HTML Files, выберите вход и папку итога, потом выполните пробный проход. После сохранения проверьте длинные страницы, фоновые элементы, изображения и переносы. Веб-страница и печатный PDF применяют различные модели разметки, по этой причине контроль внешнего вида обязателен.
Сценарий: OCR нескольких языков. Подберите только те языки, которые встречаются в документе, и применяйте одинаковый набор для всей однородной партии. Сперва распознайте две-три страницы с заголовками, цифрами, именами и таблицами. В Searchable PDF попробуйте отыскать слова на каждом языке и скопировать одну строку в текстовый редактор. После такой проверки можно запускать полный документ или папку.
Сценарий: слабый скан с серым фоном. До OCR активируйте коррекцию изображения и начните с контраста, яркости, выравнивания и удаления фонового шума. Сохраните тестовую страницу, сопоставьте детали букв с исходником и только затем запускайте распознавание. Чрезмерная резкость и сильная бинаризация могут превращать тонкие элементы букв в разрывы, по этой причине каждый параметр лучше менять отдельно и оценивать на одном и том же фрагменте.
Сценарий: многостраничный TIFF. TIFF прямо указан среди входов OCR, в том числе многостраничные файлы. Добавьте исходник как единый документ, проверьте порядок кадров и сформируйте Searchable PDF. После обработки сопоставьте количество страниц с исходным TIFF и отыщите текст на нескольких удалённых друг от друга страницах. Это быстрее, чем заранее разбирать многостраничный TIFF на отдельные изображения без необходимости.
Как экспортировать, защищать и готовить PDF к выпуску
После формирования страниц работа часто заканчивается не простым сохранением PDF. Super PDF Editor поддерживает экспорт в офисные и технические форматы, защиту паролем, удаление пароля, водяные знаки, фон, цифровую подпись, PDF/A, штампы, штрихкоды и расширенную печать. В производственных сценариях дополнительно применяются импозиция, Booklet, N-up Pages, Page Repeat, Scale Page и другие операции подготовки листов.
Пошагово: экспорт, защита, подпись, сжатие и печать
Шаг 1. Определите тип конечного файла. Для дальнейшего редактирования в офисной среде доступны экспорт в DOC/DOCX, XLS/XLSX и PPT/PPTX. Для технических задач на странице функций подтверждены TeX, EPUB, XPS, SVG, XML, HTML и PS/EPS. Не выбирайте формат только по расширению: сперва решите, необходим ли редактируемый текст, векторная структура, веб-страница или архивный PDF.
Шаг 2. Сделайте контрольную конвертацию. Возьмите один документ, содержащий типичные для всего пакета элементы: таблицу, изображение, колонтитул и несколько шрифтов. Экспортируйте его в выбранный формат и откройте в целевой программе. Проверьте переносы строк, таблицы, порядок страниц и изображения. Лишь после этого запускайте серию документов с теми же параметрами.
Шаг 3. Для долговременного хранения применяйте PDF/A лишь после проверки. В программе подтверждены преобразования PDF в PDF/A и обратно. После конвертации откройте итоговый файл и убедитесь, что все страницы читаются, встроенные изображения сохранились, а важные интерактивные элементы не потеряли смысл. Архивный формат ограничивает часть возможностей обычного PDF, по этой причине его логично делать финальным вариантом, а рабочий оригинал сохранять отдельно.
Шаг 4. Для защиты установите пароль и права до распространения. Super PDF Editor поддерживает Password Protection и Remove Password. Сперва сохраните незашифрованный мастер-файл в закрытой рабочей папке, потом создайте защищённую копию для передачи. После обработки обязательно закройте документ и откройте его заново, чтобы проверить пароль и фактическое поведение ограничений.
Шаг 5. Водяной знак настраивайте на копии. В программе есть Watermark/Background, а независимое описание Softpedia подтверждает настройку позиции, масштаба и прозрачности. На первой странице проверьте, что знак не перекрывает подписи, таблицы и мелкий текст, затем распространите настройку на нужный диапазон. Для различных ориентаций страниц применяйте отдельные тесты.
Шаг 6. Цифровую подпись отделяйте от простой картинки подписи. Super PDF Editor поддерживает цифровое подписание, а продуктовая страница Pulkitsoft перечисляет PFX, PKCS#12, USB, Smart Card и Certificate Store. Для сертификатной подписи загрузите требуемый контейнер, укажите его пароль, выберите видимость подписи и сформируйте подписанную копию. После этого откройте файл в PDF-просмотрщике, который умеет показывать статус подписи.
Шаг 7. Сжимайте после смысловой обработки. Среди функций есть Compress, Reduce File Size и Advanced Compression. Сжатие удобно оставлять на конец процесса: сперва OCR, страницы, водяные знаки и подпись, затем уменьшение размера. Проверьте мелкий текст, штрихкоды и линии чертежей на масштабе 100–200 %. Слишком агрессивное сжатие изображения способно ухудшить читаемость даже при небольшом итоговом файле.
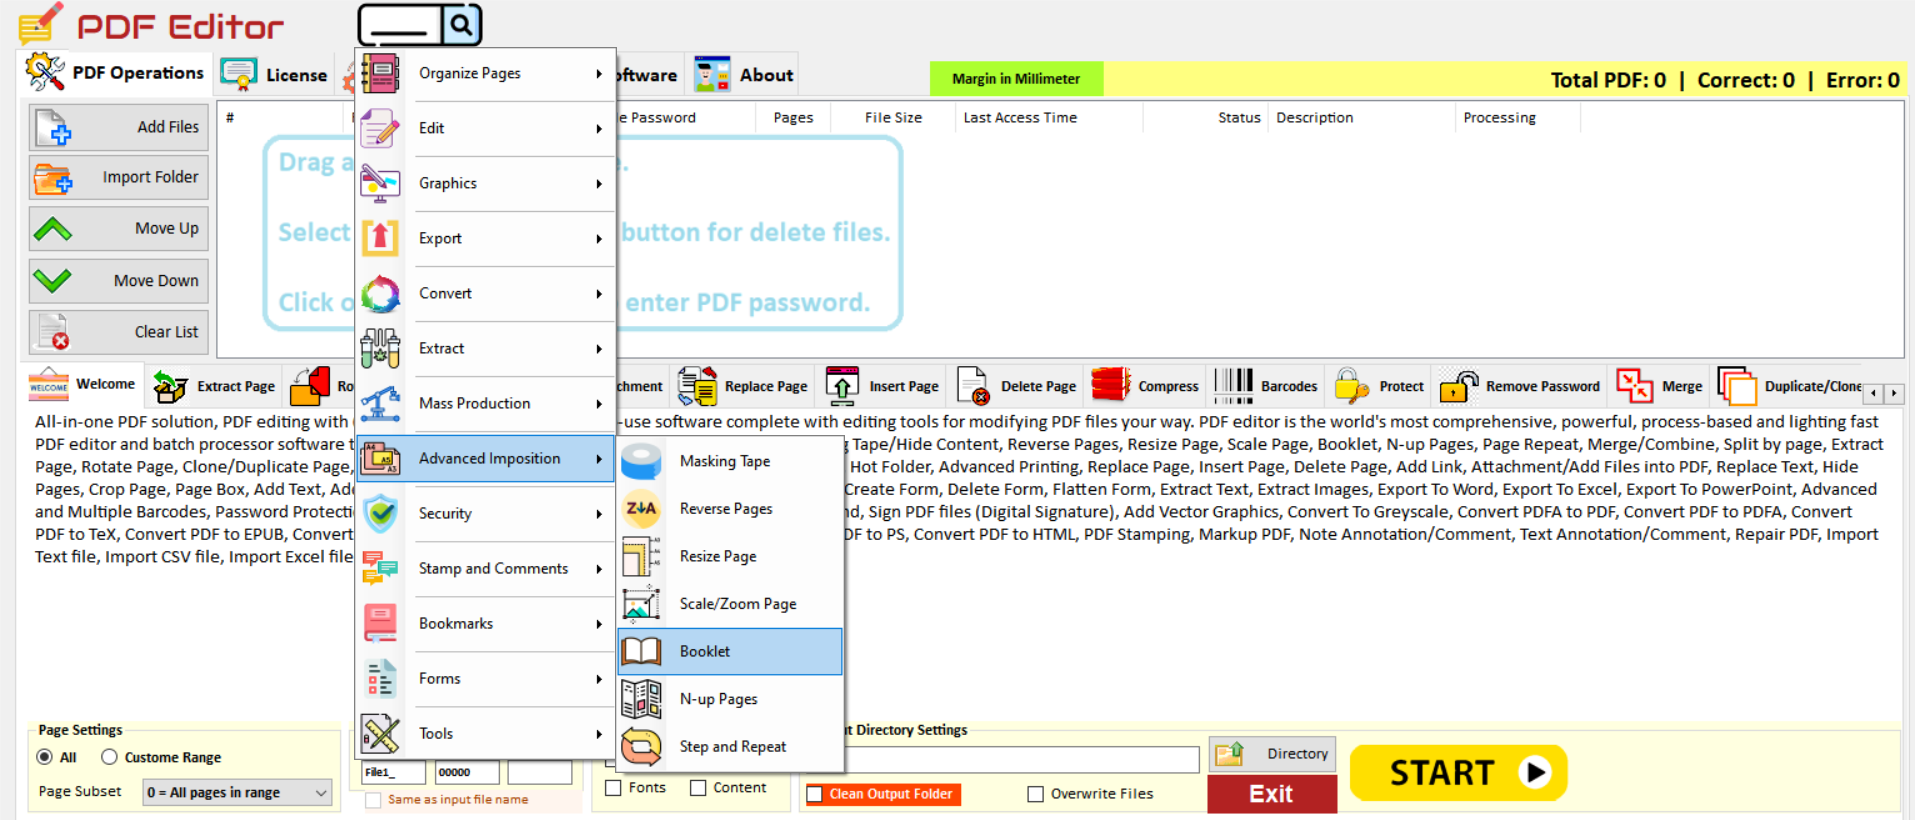
Шаг 8. Для печати сперва сделайте пробный лист. Расширенная печать предусматривает выбор лотка, носителя, качества и режима. Импозиция предлагает Booklet, N-up, Reverse Pages, Resize Page, Scale Page и Step and Repeat. Для тиража сперва сформируйте небольшой PDF или один физический лист, сверьте поля, ориентацию, порядок сторон и размер после печати, потом запускайте весь комплект.
Для отдельных задач можно сверяться с практическими материалами XeonLive: как уменьшить размер PDF, как защитить PDF паролем и как добавить подпись в PDF.
Сценарий: добавить ссылку или вложение. В наборе Edit PDF подтверждены Links и Attachment File. Для ссылки сперва определите страницу и область, к которой она относится, потом выполните операцию на копии и откройте итоговый PDF в просмотрщике, где можно проверить переход. Для вложения убедитесь, что файл в самом деле присутствует в перечне приложений PDF и открывается после сохранения документа.
Сценарий: массовая нумерация Bates. Инструмент Bates Numbering предназначен для последовательной маркировки документов. Перед большой партией выберите несколько файлов, задайте схему нумерации и сформируйте тест. Проверьте уникальность номера, его положение и читаемость на светлом и тёмном фоне. Лишь после этого применяйте схему к основной серии, сохраняя исходники отдельно.
Сценарий: добавить штрихкод или QR-код. В производственном наборе подтверждены Barcode и QR Code; среди типов штрихкодов перечислены Data Matrix, Code128, Intelligent Mail и PDF 417. Для теста возьмите один файл, добавьте код и распечатайте или откройте итог в масштабе 100 %. Затем считайте код отдельным сканером или камерой. Визуального присутствия недостаточно: контроль должен подтверждать, что закодированные данные реально читаются.
Сценарий: подготовить PDF для быстрого просмотра в сети. Среди служебных операций есть Fast Web View. Применяйте её к уже готовому документу, после редактирования и проверки. Потом откройте локальную копию и убедитесь, что содержимое не изменилось. Эта операция относится к структуре выдачи PDF и не заменяет уменьшение размера или оптимизацию изображений.
Сценарий: исправить повреждённый документ. В списке функций есть Repair PDF и Repair Page Structure. Работайте только с копией проблемного файла. После восстановления откройте итог, пролистайте страницы, проверьте поиск, ссылки и печать. Ремонт структуры считается успешным не по факту создания нового файла, а по тому, что целевые операции снова выполняются без ошибок.
Сценарий: производственный буклет. В Advanced PDF Imposition выберите Booklet и подготовьте небольшой фрагмент документа, достаточный для проверки порядка разворотов. Сформируйте итог, распечатайте пробный комплект с двусторонней печатью и сложите его так, как будет собираться тираж. На данном этапе выявляются ошибки ориентации, пустые страницы и неверный порядок намного дешевле, чем после запуска полной партии.
Типичные ошибки, ограничения, плюсы и выбор альтернативы
Super PDF Editor удобнее всего там, где один и тот же процесс повторяется над множеством файлов: объединение, перестановка страниц, OCR, экспорт, сжатие, водяной знак, штрихкоды, печать и допечатная подготовка. Вместе с этим интерфейс ориентирован на параметры процесса, а не на привычное визуальное редактирование страницы. Пользователю, который ожидает поведение как у Word или современного макетного редактора, придётся сперва привыкнуть к логике очереди и отдельных операций.
Диагностика проблем и выбор подходящего инструмента
Наиболее частая практическая ошибка — запуск большой очереди без короткого теста. Программа в самом деле рассчитана на пакетную обработку, по этой причине неверный диапазон, угол поворота, выходная папка или параметр сжатия быстро распространяется на весь набор. Правильный контрольный цикл состоит из одного характерного файла, проверки итога, затем небольшой группы и лишь после этого полного пакета.
Вторая проблема — смешивание различных типов задач. Очередь для Merge должна быть выстроена в нужном порядке; очередь для OCR должна состоять из файлов с близкими требованиями к качеству; для создания PDF из изображений важна сортировка исходных кадров. Когда документы сильно различаются по структуре, их лучше разнести на отдельные серии с различными настройками.
Третья проблема — OCR без подготовленных компонентов. Актуальная страница загрузки прямо указывает Microsoft Visual C++ Runtime как обязательный компонент для OCR и обработки изображений и предлагает отдельные языковые наборы. При проблемах распознавания сперва проверяют наличие этих компонентов, затем язык и качество входного изображения, а уже после этого меняют параметры самого OCR.
Четвёртая проблема — обработка в той же папке, где лежат исходники. Комбинация Clean output folder и Overwrite files требует дисциплины. Для рабочего процесса выделяют отдельный каталог итога и сохраняют исходные документы неизменными до окончания проверки. Это в особенности важно перед пакетным переименованием, сжатием и защитой.
Пятая проблема — оценка итога только по статусу Processed. Успешное окончание операции не подтверждает визуальное качество, порядок страниц или корректность распознанного текста. После пакетной задачи проверяют несколько файлов из начала, середины и конца списка, а для OCR ищут сложные слова и числа. Для печати проверяют реальный размер страницы и поля.
OCR запускается, но качество текста низкое
Сперва проверьте ориентацию, контраст, фон и разрешение исходного скана. Потом выберите подходящий языковой набор Main или Best и повторите обработку проблемной страницы. Оценку делайте по редким словам, цифрам и мелкому шрифту.
Некоторые файлы в очереди имеют статус Skipped
Откройте текст причины в строке статуса, проверьте диапазон страниц и доступ к защищённому PDF. На публичном экране показан пример пропуска из-за выхода номера страницы за допустимый диапазон.
Итог оказался не в том порядке
Перед Merge и созданием PDF из изображений переставьте входные элементы командами Move Up и Move Down. Порядок очереди необходимо проверять до START.
После сжатия мелкий текст выглядит хуже
Повторите задачу на исходном файле с более мягкими параметрами. Сжатие выполняйте после OCR и редактирования, потом сопоставьте мелкий текст и тонкие линии при увеличении.
Выходная папка содержит старые файлы
Применяйте отдельный каталог для каждой серии. Clean output folder применяйте лишь в рабочей папке, содержимое которой разрешено удалить перед запуском.
Необходимо изменить пару страниц, а не весь пакет
Задайте Custom Range или применяйте операции Extract, Replace, Insert, Delete, Rotate и Move/Reorder для конкретных страниц. После обработки проверьте количество страниц и позицию изменённого фрагмента.
Плюсы
- Сильная ориентация на пакетную обработку и повторяемые процессы над большим числом PDF.
- Широкий набор операций со страницами: объединение, разделение, извлечение, поворот, клонирование, перемещение, замена, вставка, удаление и кадрирование.
- OCR для PDF и изображений с предварительной коррекцией сканов и несколькими режимами языковых данных.
- Создание PDF из изображений, текста и HTML, а также экспорт в офисные и технические форматы.
- Полиграфические функции: Booklet, N-up, масштабирование, повтор страницы и расширенная печать.
- Локальная обработка документов на компьютере без обязательной отправки файлов в облачный сервис.
Минусы
- Интерфейс плотный и процессный: новичку требуется время, чтобы привыкнуть к очереди, множеству вкладок и параметров.
- Публичные снимки различных выпусков заметно отличаются по оформлению, по этой причине расположение отдельных элементов необходимо сверять с установленной сборкой.
- Для OCR и обработки изображений требуются добавочные компоненты и языковые данные.
- Lite-редакция ограничивает часть функций; полный набор относится к старшим редакциям и пробному периоду основной версии.
- Программа лучше подходит для операций над документом и страницами, чем для свободной визуальной верстки PDF как в настольной издательской системе.
В качестве альтернативы для обычного визуального редактирования текста и объектов можно рассмотреть PDF-XChange Editor или Foxit PDF Editor. Для простого объединения и разделения без десятков производственных инструментов подходит PDFsam. Для привычного универсального рабочего процесса с глубоким редактированием, формами и экосистемой можно сопоставить возможности с Adobe Acrobat Pro.
Super PDF Editor имеет смысл выбирать для отдела, где документы проходят одинаковые операции партиями: архивное сканирование, нормализация страниц, массовый экспорт, подготовка к печати, штрихкоды, защита или OCR. Для редких разовых правок проще инструмент с более визуальным интерфейсом. Для производственного потока, напротив, логика очереди, отдельной выходной папки и единого набора параметров становится преимуществом.
Практический порядок внедрения простой: установить актуальную сборку 11.2.0 и нужные компоненты, отработать одну типовую операцию на копиях, зафиксировать структуру входной и выходной папок, сохранить ясное правило имён, затем расширить процесс на пакет. Для OCR отдельно проверить языки и качество скана, для печати — физический пробный лист, для защиты — повторное открытие готового файла, для конвертации — просмотр итога в целевой программе.