
Utopia Documents — специализированный настольный ридер, который соединяет научный PDF с метаданными, библиографией и предметными базами. На Xeon Live можно скачать Utopia Documents бесплатно и сверить назначение программы перед запуском. Главная особенность ридера — контекстный слой рядом со страницей: он помогает переходить от термина, ссылки или рисунка к связанным научным данным, не изменяя исходный PDF.
Что такое Utopia Documents и для каких задач она создана
Utopia Documents вырос из исследовательского проекта Манчестерского университета и развивался как научный PDF-ридер, а не как универсальный офисный редактор. В академической публикации 2010 года система описана как средство, которое анализирует структуру статьи, подключает плагины и связывает элементы страницы с онлайновыми данными. В 2014 году проект перевели в открытый формат; в архивах Linux сохранились сборки 3.0.2, а справочные материалы относят позднюю публичную ветвь к поколению 3.x. Для современного рабочего места это важное ограничение: интерфейс и идеи остаются полезными, но сетевые интеграции относятся к старой экосистеме.
Семантический слой поверх обычного PDF
Utopia Documents; источник изображения: Xeon Live
Обычный просмотрщик показывает страницу, выполняет поиск и управляет масштабом. Utopia Documents дополняет этот набор смысловой обработкой. Программа выделяет элементы научной статьи, показывает сведения о документе, связывает распознанные ссылки с библиографическими записями и отдаёт выбранные термины подключённым модулям. В ранней редакторской версии Biochemical Journal рядом с определением отображался знак организации, подтвердившей связь: так читатель различал машинное совпадение, пользовательский комментарий и издательскую аннотацию.
Такой подход в особенности понятен на биомедицинских статьях. Упоминание белка, рецептора, соединения или мутации превращается в точку перехода к специализированной записи. В опубликованных демонстрациях применялись Wikipedia через DBpedia, PDB, UniProtKB, GPCRDB, NucleaRDB и другие сервисы. Для произвольного отчёта, договора или учебника ценность ниже: программа не предназначена для правки текста PDF, перестановки страниц, OCR сканов, заполнения форм и электронной подписи. Общую логику формата и типичные операции с документами лучше сопоставлять с руководством по PDF.
- Основная аудитория: исследователи, биоинформатики, фармакологи, редакторы научных публикаций и специалисты, изучающие семантические документы.
- Главная задача: читать статью и сразу видеть связанные определения, библиографию, данные и интерактивные объекты рядом с исходной страницей.
- Не главная задача: менять содержание PDF, выполнять OCR, объединять файлы, подписывать документы и вести большую синхронизируемую библиотеку.
- Состояние экосистемы: программная база относится к старому поколению настольных клиентов, по этой причине сетевой слой необходимо считать отдельным от локального просмотра PDF.
Практически полезно разделять две части продукта. Первая — локальный рендеринг PDF, поиск, выделение текста, масштаб и переход по страницам. Вторая — веб-обогащение: карточки Summary, сведения о терминах, ссылки на литературу, интерактивные молекулы и другие модули. Такое разделение позволяет сразу понять причину сбоя: когда страница читается, а боковая панель остаётся пустой, проблема находится не в самом PDF-рендеринге, а в распознавании статьи или во внешнем сервисе.
Карта интерфейса и базовая навигация
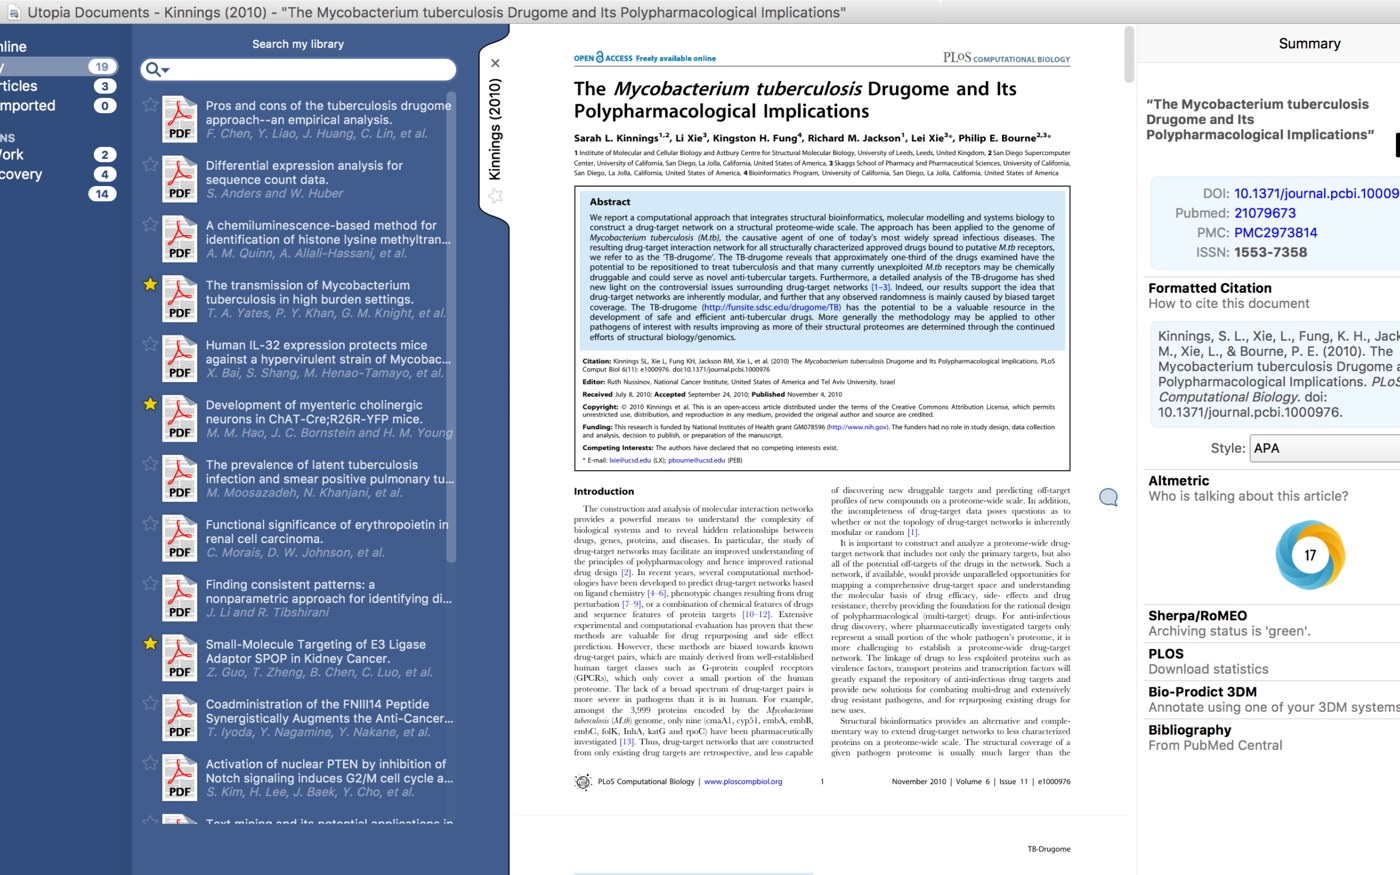
Рабочее окно поздних версий строится вокруг библиотеки, центральной страницы и правой контекстной панели; снизу подключается pager с миниатюрами. PCWorld тоже описывал переключатели pager, sidebar и Figure Browser в нижней части окна. Эта схема важна для всех следующих действий: пользователь сперва держит в центре сам документ, а боковые области открывает ровно на тот срок, который необходим для навигации или проверки связанных данных.
Как настроить окно перед чтением
Utopia Documents; источник изображения: Xeon Live
- 1. Откройте одну статью и убедитесь, что центральная область занимает большую часть экрана. На первом сеансе не открывайте сразу несколько документов: каждая статья в Windows-версии занимала отдельное окно, по этой причине рабочий стол быстро перегружается.
- 2. Разверните левую библиотеку лишь для выбора материала. В ней поздний интерфейс показывал группы, импортированные статьи, наименования и авторов. После перехода к нужному PDF сверните библиотеку, когда её ширина мешает читать двухколоночную страницу.
- 3. Включите pager и проверьте миниатюры. Щелчок по миниатюре переводит чтение на соответствующую страницу. Для длинной статьи это быстрее последовательной прокрутки и одновременно показывает, на каких страницах присутствуют добавочные метки.
- 4. Откройте правую панель и ничего не выделяйте в тексте. В таком состоянии она применяется как обзор документа: в исторических сборках там появлялись наименование, DOI, библиографическая запись, ссылки и дополнительные карточки.
- 5. Перед углублённым чтением установите масштаб так, чтобы строка и формулы оставались читаемыми. Для двух колонок практичнее увеличить фрагмент страницы, чем пытаться одновременно держать открытыми библиотеку, полный pager и широкую боковую панель.
У этой компоновки есть важное свойство: правая область контекстная. После выбора термина она перестаёт быть сводкой по документу и показывает сведения о выбранном фрагменте; после возврата к общему состоянию вновь появляются карточки статьи. По этой причине исчезновение Summary после выделения текста не означает потерю данных. Сперва снимите выделение или вернитесь к обзору документа, потом продолжайте проверку метаданных.
Для локального поиска по PDF применяйте штатный поиск ридера; для поиска по уже добавленной коллекции — строку библиотеки. Это две различные операции. Первый вариант ищет слова внутри открытого файла и подходит для проверки методики, имени вещества или номера рисунка. Второй помогает отыскать сам документ среди добавленных материалов. Детальный разбор приёмов поиска по PDF есть в инструкции по поиску слова или фразы в PDF.
- Ускорение работы: держите открытыми только те панели, которые необходимы на текущем этапе; это освобождает место и снижает визуальный шум.
- Сравнение двух статей: расположите два окна рядом, а остальные материалы оставьте закрытыми. У программы нет современного режима вкладок.
- Проверка страницы: переходите через pager на последнюю страницу и обратно, чтобы сразу убедиться, что навигация и отрисовка стабильны.
- Поиск ошибок рендера: сопоставляйте формулы, греческие символы и сложные схемы с современным ридером. Старый графический стек не следует считать эталоном для любой сложной публикации.
В настройках качества Utopia Documents не документированы современные пресеты рендеринга, аппаратного ускорения или экономии памяти. Реальное управление производительностью строится вокруг числа открытых окон, состава активных панелей и сетевых модулей. По этой причине оптимизация начинается не с несуществующего профиля качества, а с простого рабочего режима: один PDF, минимальный набор панелей и последовательная проверка добавочных функций.
Как открыть статью и проверить, что она распознана правильно
Документ открывается как локальный PDF; PCWorld тоже описывал вставку прямого адреса PDF. После загрузки Utopia Documents анализирует текст и библиографические признаки, а затем дополняет страницу информацией в боковой области. Главная проверка перед работой — убедиться, что программа связала файл именно с той публикацией, которая открыта в центре. Иначе связанные статьи, идентификаторы и сформированная цитата будут относиться к другому материалу.
Пошаговая проверка перед чтением
Utopia Documents; источник изображения: Xeon Live
- 1. Начните с текстового PDF научной статьи, у которой на первой странице видны наименование, авторы и DOI. Для первого контрольного сеанса лучше брать открытую публикацию с обычной журнальной вёрсткой, а не скан или авторскую рукопись с нестандартной титульной страницей.
- 2. Откройте файл и дождитесь отрисовки первой страницы. Прокрутите несколько страниц, измените масштаб и вернитесь к началу. Так локальный просмотр отделяется от сетевого обогащения: страница обязана оставаться доступной даже тогда, когда внешняя карточка не загрузилась.
- 3. Выделите строку в основном тексте и скопируйте её в обычный редактор. Нормальный порядок слов подтверждает наличие пригодного текстового слоя. Набор бессмысленных символов указывает на проблему со шрифтами или кодировкой; скан без выделяемого текста требует отдельного OCR перед семантической обработкой.
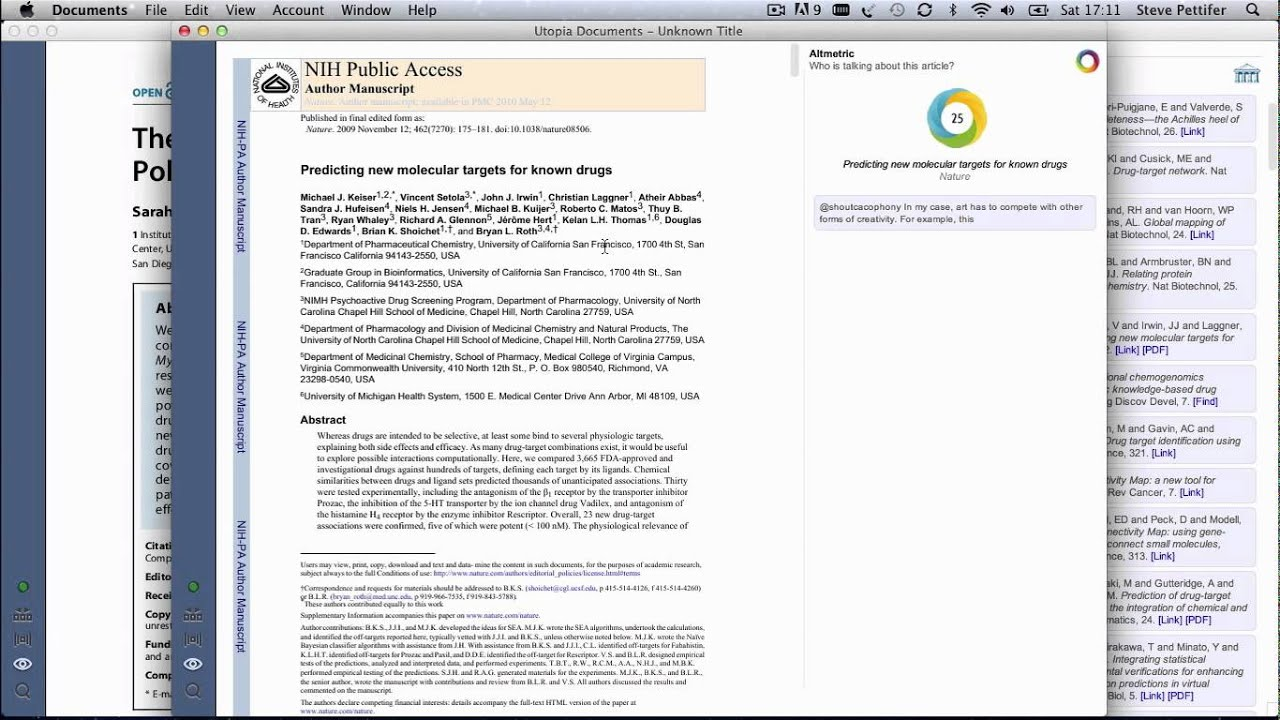
- 4. Снимите выделение и откройте Summary. Сопоставьте заголовок статьи, авторов и DOI с первой страницей PDF. В показанном интерфейсе рядом тоже встречались PubMed/PMC, ISSN, Formatted Citation, Altmetric, Sherpa/RoMEO и Bibliography; состав карточек зависел от статьи и доступных модулей.
- 5. Проверьте одну библиографическую запись. Сопоставьте автора, год, журнал и DOI с текстом списка литературы. Автоматическая связь экономит время, но неверное совпадение нельзя переносить в научную работу без сверки.
- 6. Перейдите через pager на страницу с рисунком и затем на последнюю страницу. Сопоставьте количество страниц и расположение крупных элементов с современным просмотрщиком. Такая короткая проверка обнаруживает проблемы рендера до того, как вы начнёте анализировать данные.
- 7. Зафиксируйте итог контрольного открытия: PDF читается, текст копируется, DOI совпадает, библиография распознана, рисунки доступны. После этого переходите к Explore и предметным модулям.
Распознавание публикации не равно проверке имени файла. Система разрабатывалась вокруг отпечатка содержимого, чтобы связывать различные версии одной статьи. Это удобно для авторских рукописей и копий из репозитория, но требует ручного контроля: рукопись и итоговая версия содержат одинаковую научную работу, хотя номера страниц, рисунков и отдельные формулировки различаются. В рабочей заметке сохраняйте DOI и указывайте, какую редакцию читали.
Сканированный PDF открывается как изображение страниц, но лишает программу основного материала для смыслового анализа. Высокое разрешение скана само по себе не заменяет текстовый слой. После OCR проверьте фамилии, DOI, химические обозначения и порядок чтения колонок: ошибки в этих местах в особенности сильно искажают распознавание сущностей. Для проблем с копированием текста полезна отдельная инструкция по извлечению текста из PDF, эта страница тоже присутствует в sitemap Xeon Live.
Сформированную библиографическую запись применяйте как ускоритель, а не как окончательный источник. В обзоре PCWorld один из вариантов библиографического вывода возвращал ошибку сервера. Даже без технической ошибки порядок авторов, сокращение журнала и диапазон страниц необходимо сверять с DOI. Для постоянной библиотеки лучше переносить проверенную запись в Zotero, а Utopia Documents оставлять средством чтения и исследования конкретной статьи.
- Неверно определена статья: закройте PDF, сверяйте первую страницу и возьмите издательскую копию или версию из репозитория с корректным текстовым слоем.
- Текст выделяется, но копируется мусором: проблема находится в кодировке шрифта; применяйте другую копию публикации вместо попытки исправлять содержимое внутри Utopia Documents.
- Summary пуст: сперва подтвердите локальную работу PDF, потом проверяйте распознавание документа и сетевые модули отдельно.
- Не доверяйте одному признаку: совпадение наименования без DOI недостаточно для похожих редакционных заметок и препринтов.
Как исследовать термины, библиографию и рисунки
Сильная сторона Utopia Documents раскрывается после корректного распознавания статьи. Выделенный фрагмент передаётся функции Explore, а правая область показывает найденные определения и предметные записи. В академическом описании отдельно указаны итоги из Wikipedia через DBpedia и PDB; библиотечные материалы добавляли PubMed, UniProt и другие источники. Для биомедицинской статьи такой режим сокращает переключения между PDF и браузером, но окончательный выбор значения остаётся за читателем.
Explore, ручной поиск и Figure Browser
Utopia Documents; источник изображения: Xeon Live
- 1. Выберите в тексте не одиночную букву или короткое сокращение, а полный термин с уточняющим словом. К примеру, наименование белка вместе с обозначением семейства даёт контекст, которого нет у одной аббревиатуры.
- 2. В контекстном действии выберите Explore. Исторический интерфейс заменяет общую сводку боковой панели карточками, относящимися к выделенному фрагменту. Сопоставьте несколько вариантов и их происхождение, а затем вернитесь к предложению в статье, чтобы проверить смысл.
- 3. Когда в тексте встречается неоднозначное обозначение, измените границы выделения и повторите Explore. Не выбирайте первое совпадение автоматически: одно сокращение в различных дисциплинах обозначает различные сущности.
- 4. Для понятия, которого нет в статье в полной форме, применяйте ручной поиск в панели. Академическое описание Utopia Documents указывает отдельный lookup для терминов, не написанных в документе напрямую. Итог проверяйте тем же методом — по источнику и контексту.
- 5. Для автоматических аннотаций удерживайте клавишу Space. В обзоре PCWorld и в публикации о GPCRDB этот приём показан как метод увидеть отмеченные области и специальные функции на странице. После отпускания клавиши вернитесь к спокойному чтению без постоянной подсветки.
- 6. Откройте библиографическую ссылку из текста или правой панели. Сперва сопоставьте полную запись с номером ссылки в PDF; затем переходите к связанной публикации. Для обзора литературы переносите только проверенные записи в менеджер источников.
- 7. Включите Figure Browser и пролистайте собранные иллюстрации. Сверьте номера рисунков с самим PDF. PCWorld отдельно отмечал, что браузер фигур пропускает часть иллюстраций в некоторых статьях, по этой причине галерея служит быстрым обзором, а не полной инвентаризацией.
- 8. Закончив исследование термина, снимите выделение и вернитесь к общей сводке документа. Так сохраняется разделение между данными о всей статье и итогами по одному объекту.
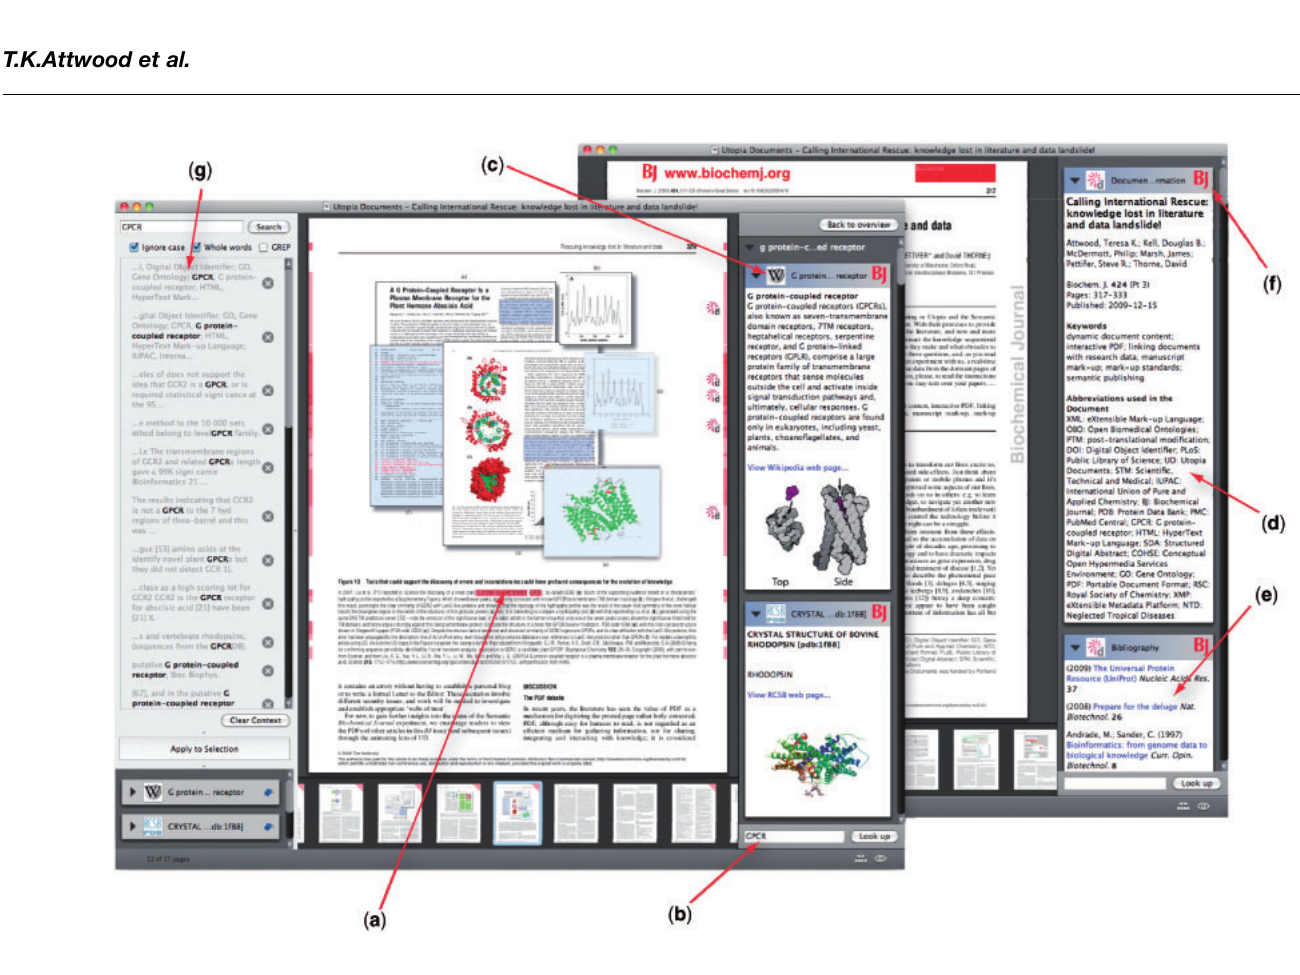
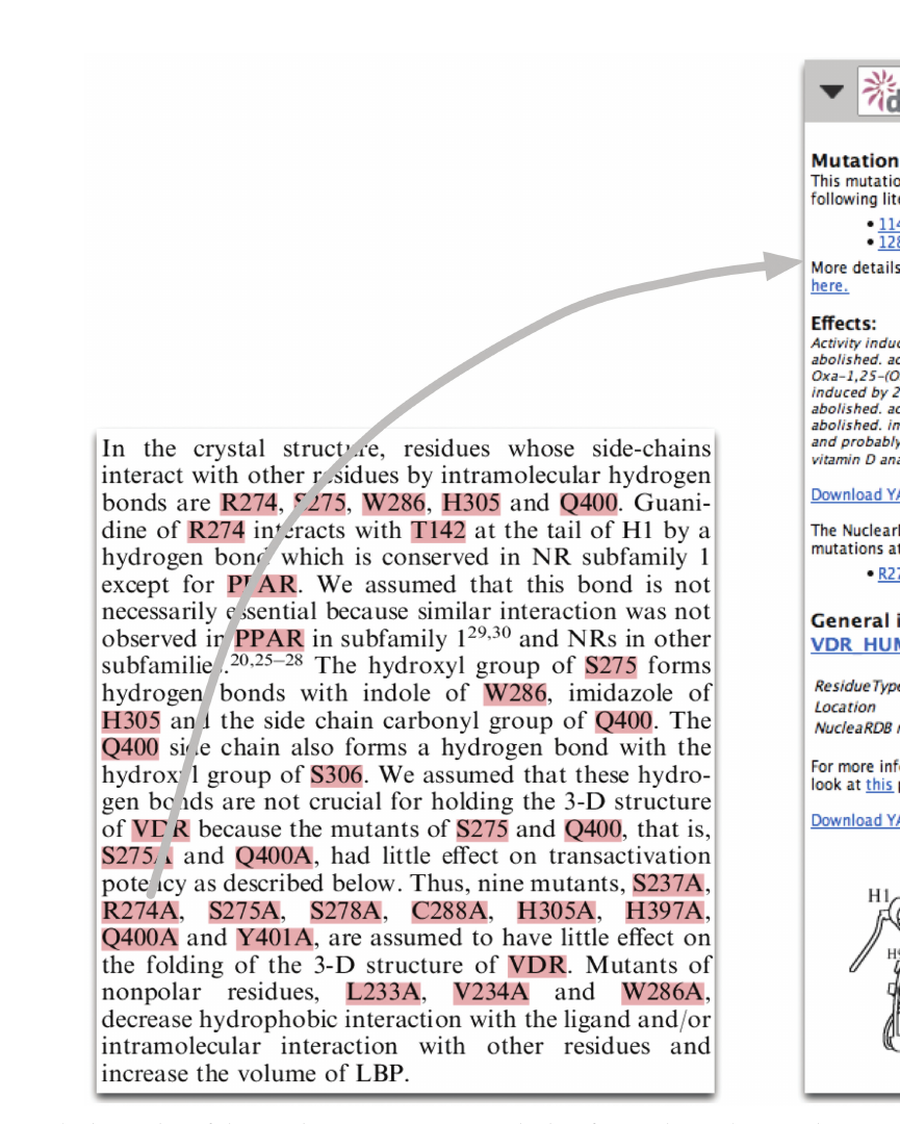
Для биологических сущностей происхождение карточки принципиально важно. На изображении NucleaRDB аннотация связывает мутацию в тексте с предметным описанием справа. Это не простой веб-поиск: система получает текст из PDF, предметный модуль определяет сущности и возвращает разметку клиенту. В статье о GPCRDB подобный поток показан как отдельная интеграция между Utopia Documents и внешней базой.
Библиография работает по похожей логике. Программа анализирует список литературы и пытается связать запись с цифровой версией работы. В ранней научной статье указано, что при недоступном PDF переход выполнялся к поиску публикации. Для современного процесса важнее сама идея: применяйте Utopia Documents, чтобы быстро разобрать перечень ссылок, а доступ к полному тексту и долговременное хранение организуйте в поддерживаемой библиотечной системе.
Figure Browser в особенности полезен на этапе первичного просмотра: графики и схемы быстро показывают дизайн исследования и основные итоги. Однако составная фигура в PDF часто собрана из нескольких объектов, подпись расположена отдельно, а изображение пересекает колонку. По этой причине после галереи выполните ручную проверку по словам Figure, Fig. или нумерации в документе. Отсутствие миниатюры в Utopia Documents не доказывает отсутствие иллюстрации.
- Горячая клавиша: удерживание Space показывает размеченные области и специальные элементы в поддерживаемых статьях.
- Ручной поиск: применяйте его для полного термина, который в тексте представлен сокращением или находится лишь на рисунке.
- Проверка сущности: смотрите на наименование базы и устойчивый идентификатор, а не только на краткое описание.
- Контроль библиографии: сверяйте автора, год, журнал и DOI до переноса записи в свою библиотеку.
- Контроль рисунков: сопоставляйте Figure Browser с нумерацией в самом PDF.
Как работать с аннотациями и интерактивными научными объектами
Utopia Documents проектировалась не только для показа определений. В научных демонстрациях статическая область страницы связывалась с интерактивным объектом: трёхмерной структурой, последовательностью или набором числовых данных. В статье Bioinformatics описан медиаплеероподобный блок управления: запуск заменял статическое представление интерактивным, а отдельное действие открывало объект в новом окне. Эти возможности требовали подготовленной разметки и соответствующего плагина; произвольный PDF не превращает любую картинку в 3D автоматически.
Комментарии, издательская разметка и живые данные
Utopia Documents; источник изображения: Xeon Live
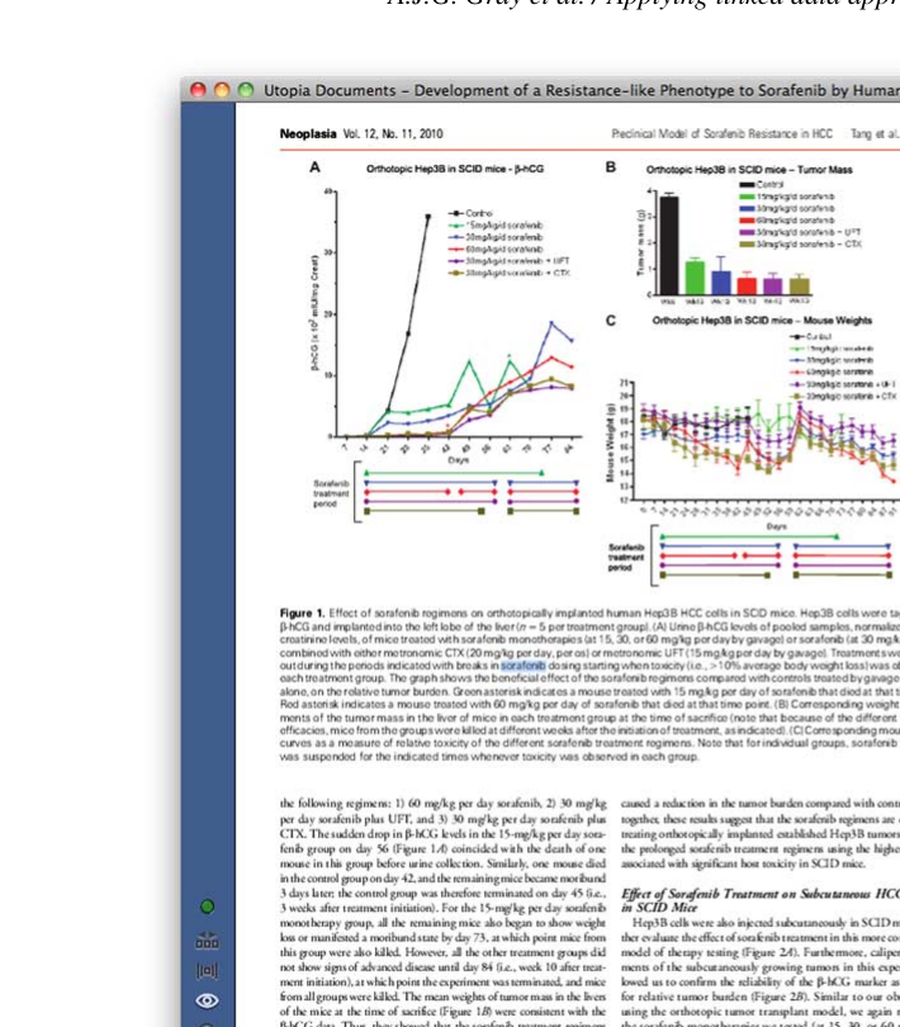
- 1. Отыщите на странице цветной маркер или другую отметку добавочного содержимого. В академическом интерфейсе такие глифы располагались в поле страницы и отражались на миниатюрах pager. Наведение подсвечивает связанную область, выбор открывает содержимое в правой панели или активирует интерактивный модуль.
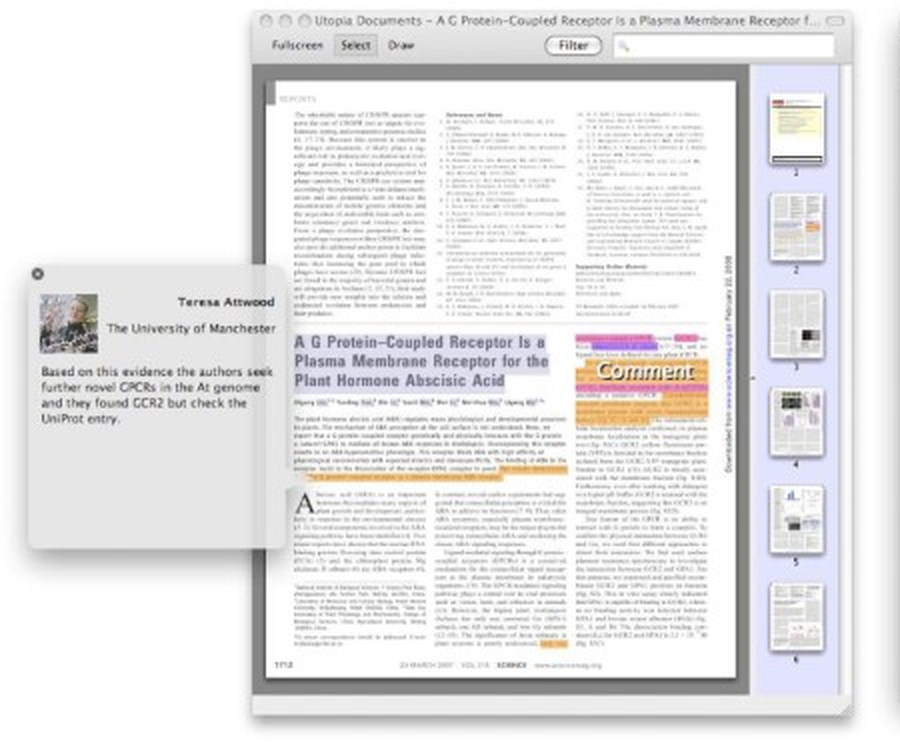
- 2. Перед запуском интерактивного объекта прочитайте происхождение аннотации. Значок издателя или конкретной базы показывает, откуда взята связь. Автоматическую сущность, редакторское подтверждение и пользовательский комментарий нельзя считать равнозначными.
- 3. Для молекулярной модели применяйте доступные средства вращения и масштабирования. В опубликованной версии поддерживались различные стили отображения молекул. Сопоставляйте модель с подписью и идентификатором PDB, чтобы не потерять связь с конкретным объектом статьи.
- 4. Для таблицы или набора чисел сперва проверьте, какие данные связаны с областью страницы. Историческая система умела передавать подготовленные данные в интерактивное представление и строить графические варианты. Не применяйте такой итог вместо сохранённого воспроизводимого анализа, когда важны точные столбцы, пропуски и единицы измерения.
- 5. Для комментария выделите относящийся к нему фрагмент и просмотрите карточку автора. В ранних версиях существовали частные заметки и публичные обсуждения, но это не стандартная PDF-аннотация: комментарий хранится в служебном слое и не обязан быть виден в другом просмотрщике.
- 6. После просмотра интерактивного содержимого вернитесь к статической странице и убедитесь, что исходный PDF не изменился. Именно сохранение неизменного файла было одним из принципов Utopia Documents.
- 7. Сохраните в независимом рабочем журнале DOI статьи, идентификатор сущности и вывод, который вы сделали по добавочным данным. Такой итог остаётся проверяемым даже после отключения старого сервиса.
Издательская разметка имела отдельный статус. В пилоте Biochemical Journal редакторы связывали термин с выбранным определением и подтверждали связь собственным знаком. Для читателя это полезнее безымянной подсветки: видно, кто отвечает за сопоставление. Автоматические карточки, напротив, требуют проверки, потому что одно слово связывается с несколькими сущностями.
Комментарии Utopia Documents не заменяют обычные выделения, закладки и заметки универсального ридера. PCWorld критиковал именно слабость стандартных средств чтения и отмечал, что сетевое комментирование требовало учётной записи. Когда заметки должны остаться внутри самого PDF и открываться в других программах, применяйте современный инструмент; практические методы собраны в руководстве по примечаниям в PDF.
Для демонстрации расширенных функций удобно применять несколько связанных экранов. Первый показывает автоматическую предметную разметку, второй — Open PHACTS рядом со статьёй, третий — раннюю издательскую систему. Они иллюстрируют общий принцип: добавочный слой живёт рядом с печатной страницей, а не заменяет её.
Utopia Documents; источник: Xeon Live
Utopia Documents; источник: Xeon Live
Utopia Documents; источник: Xeon Live
У программы нет документированного режима пакетной обработки, который массово превращает каталог PDF в набор экспортированных данных. Её рабочая модель интерактивная: открыть статью, выбрать объект, изучить контекст и сохранить проверенный итог отдельно. Это важно для ожиданий от производительности. Utopia Documents ускоряет отдельные исследовательские переходы, но не заменяет конвейер извлечения данных или современную систему обработки большого корпуса.
Как диагностировать сбои и организовать устойчивую работу
Старый настольный клиент лучше диагностировать послойно. Сперва подтверждается запуск приложения, затем локальный PDF, потом распознавание публикации и лишь после этого веб-модули. Такой порядок исключает ситуацию, когда пустую карточку принимают за повреждение файла, а ошибку старого сервиса пытаются исправить переустановкой ридера.
Пустая панель, неверное распознавание и расход памяти
Utopia Documents; источник изображения: Xeon Live
- 1. Клиент не запускается. Проверьте, для какой эпохи ОС собрана версия. Архивы Linux содержат 3.0.2 и старые зависимости; Windows и macOS-сборки относятся к прежним поколениям систем. Для эксперимента применяйте изолированную совместимую среду, а не заменяйте современные системные библиотеки устаревшими ручным способом.
- 2. Окно запускается, но PDF не открывается. Возьмите небольшой публичный текстовый PDF и проверьте его в современном ридере. Повреждённый файл, нестандартный шрифт или сложная защита создают отдельную проблему, не связанную с семантическими модулями.
- 3. PDF читается, а правая панель пуста. Скопируйте строку текста, сопоставьте DOI и заголовок, потом проверьте доступность сети. Локальная отрисовка при пустой панели подтверждает, что рендерер работает; причина находится в распознавании статьи или во внешнем сервисе.
- 4. Показана другая публикация. Не применяйте сформированную цитату. Закройте файл, сверьте титульную страницу и откройте другую копию статьи с корректным текстовым слоем. Для препринта и итоговой версии сохраняйте явную пометку о редакции.
- 5. Figure Browser пропускает иллюстрацию. Перейдите к странице ручным способом, отыщите подпись и сопоставьте нумерацию. Автоматическая галерея не считается доказательством полноты.
- 6. Explore даёт много нерелевантных сущностей. Выделяйте более длинное выражение, отключайте ненужный предметный модуль и применяйте ручной поиск для нескольких в самом деле важных терминов.
- 7. Приложение замедляется при нескольких статьях. Закройте лишние окна и перезапустите клиент. PCWorld фиксировал расход более 100 МБ на окно в Windows-версии своего времени; отсутствие вкладок усиливает неудобство при большой подборке.
- 8. Библиографический вывод возвращает ошибку. Переключите доступный стиль, скопируйте базовые поля и сверяйте DOI в современной библиотечной системе. Массовое цитирование лучше выполнять в менеджере литературы.
Для оценки сети применяйте один контрольный документ, который ранее правильно распознавался и содержит DOI, PubMed-запись, рисунки и обычный текст. Запишите четыре факта: открылась ли страница, совпал ли DOI, отработал ли Figure Browser, появились ли предметные карточки. Повторите сеанс после перезапуска. Стабильная локальная часть при плавающем сетевом итоге указывает на зависимость от внешней инфраструктуры, а не на случайное повреждение PDF.
Безопасность важнее восстановления старой интеграции любой ценой. Не отключайте системную проверку сертификатов и не устанавливайте случайные корневые сертификаты ради одной карточки. Старый клиент тоже не стоит применять для конфиденциальных рукописей, пока не понятен маршрут сетевых обращений. Для закрытого материала оставляйте внешние модули выключенными и работайте современным локальным ридером.
Организуйте небольшую рабочую коллекцию, а не весь многолетний архив. В библиотеке держите только статьи текущего проекта; постоянное хранение, теги, синхронизацию и цитирование передавайте менеджеру литературы. Имена файлов можно нормализовать по году, первому автору и короткому наименованию, но идентификацию публикации всё равно проверяйте по DOI и содержимому.
Почему правая панель остаётся пустой?
Сперва подтвердите наличие нормального текстового слоя и совпадение DOI. При исправном локальном просмотре пустая панель относится к распознаванию статьи или недоступной внешней интеграции.
Почему Explore показывает не то значение термина?
Расширьте выделение до полного выражения и сопоставьте происхождение карточек. Короткие сокращения часто неоднозначны, по этой причине вариант выбирают по контексту абзаца и идентификатору базы.
Почему Figure Browser не показывает все рисунки?
Составные панели, подписи на соседней странице и сложное устройство PDF распознаются неполно. Сверьте галерею с ручной нумерацией рисунков в документе.
Почему комментарий не виден в другом PDF-ридере?
Комментарии Utopia Documents относятся к добавочному служебному слою и не равны стандартным аннотациям PDF. Для переносимых заметок применяйте современный редактор, который записывает их в документ.
Почему несколько открытых статей замедляют программу?
Документы открываются в отдельных окнах, а семантические модули добавляют память и сетевые операции. Закройте лишние статьи и оставьте только те панели и модули, которые необходимы в настоящее время.
Можно ли считать найденную карточку научным доказательством?
Нет. Карточка ускоряет переход к источнику, но вывод подтверждают по профильной записи, устойчивому идентификатору и исходной публикации. Автоматическое сопоставление требует проверки.
После диагностики итог необходимо вынести из старого клиента. Сохраните проверенные DOI, библиографические записи, идентификаторы белков или соединений и собственные выводы в поддерживаемом инструменте. Потом откройте несколько записей без Utopia Documents и убедитесь, что маршрут воспроизводится: менеджер отыскивает статью, DOI разрешается, предметный идентификатор ведёт к актуальной базе, а заметка поясняет, зачем этот объект был необходим.
Преимущества, недостатки, альтернативы и практические рекомендации
Utopia Documents интересна не количеством стандартных команд PDF, а методом чтения: страница остаётся центром работы, а контекст появляется рядом с конкретным термином, ссылкой или рисунком. Именно по этой причине программа до сих пор полезна для изучения семантических публикаций и старых биоинформатических интеграций. Одновременно возраст клиента и зависимость от внешних служб не позволяют рассматривать её как универсальный ежедневный ридер без резервных инструментов.
Когда Utopia Documents имеет смысл применять
Utopia Documents; источник изображения: Xeon Live
Плюсы
- Связывает научный PDF с метаданными, библиографией и предметными данными без переписывания исходного файла.
- Позволяет исследовать выделенный термин через Explore и ручной поиск прямо во время чтения.
- Показывает происхождение части аннотаций и в издательских сценариях различает подтверждённую разметку и автоматические совпадения.
- Figure Browser и pager ускоряют обзор длинной статьи.
- Документированная архитектура плагинов связывала PDF с PDB, UniProtKB, GPCRDB, NucleaRDB, Open PHACTS и другими научными системами.
- Исходный PDF остаётся неизменным, а добавочные данные образуют отдельный слой.
Минусы
- Клиент относится к старому поколению настольного ПО, а значительная часть веб-обогащения зависит от исторических сервисов.
- Нет полноценной правки текста и страниц, OCR, работы с формами и современной электронной подписи.
- Стандартные локальные аннотации и закладки слабее, чем у актуальных универсальных ридеров.
- Нет современного режима вкладок; несколько статей открываются отдельными окнами.
- Автоматическое распознавание рисунков, ссылок и сущностей требует ручной проверки.
- На новых ОС появляются проблемы совместимости со старыми библиотеками, графическим стеком и сетевыми протоколами.
Кому подойдёт
- Исследователям истории научных интерфейсов, семантической разметки и цифрового издательского дела.
- Биоинформатикам и фармакологам, которым необходимо воспроизвести старый процесс работы с предметными плагинами и размеченными статьями.
- Преподавателям информационных систем, демонстрирующим связь между статичным PDF, онтологиями и внешними научными базами.
- Специалистам, которым важен контекстный переход от фразы в статье к метаданным и научной сущности, а постоянное хранение ведётся отдельно.
Кому не подойдёт
- Тем, кому необходим основной современный PDF-редактор для договоров, форм, подписей, OCR и перестановки страниц.
- Пользователям, которым требуется надёжная работа всех функций без сети и без старых зависимостей.
- Командам с конфиденциальными рукописями, пока сетевые обращения старого клиента не изолированы и не изучены.
- Владельцам больших библиотек, которым необходимы синхронизация, совместная работа, теги, цитирование и мобильный доступ в одной поддерживаемой системе.
По альтернативам полезно разделять задачи. Zotero подходит для постоянной библиотеки, метаданных, цитирования и современного чтения PDF. Okular удобен как универсальный локальный просмотрщик с обычными аннотациями. UPDF относится к классу современных редакторов с правкой, OCR и операциями со страницами. Ни один из этих инструментов не повторяет историческую предметную модель Utopia Documents один в один, но каждый лучше закрывает свою повседневную роль.
Рациональный рабочий процесс выглядит так: Utopia Documents применяется для изучения старого семантического слоя или демонстрационной статьи; DOI и библиографию после проверки переносят в современный менеджер; стандартные заметки сохраняют в обычных PDF-аннотациях; предметные идентификаторы фиксируют в рабочем журнале; интерактивные структуры открывают в актуальных профильных программах. Такой подход сохраняет сильную идею Utopia Documents, но не делает старый клиент единственной точкой доступа к итогам.
Для первого знакомства достаточно одного хорошо подготовленного открытого PDF. Проверьте отрисовку, текстовый слой, Summary, одну библиографическую ссылку, Explore, Space для подсветки и Figure Browser. Затем решите, даёт ли контекстная панель реальную экономию времени на ваших материалах. Когда сетевые карточки не воспроизводятся, применяйте программу как исторический интерфейс и переходите к современным базам через сохранённые DOI и идентификаторы. Для повседневного редактирования PDF выбирайте актуальный инструмент, а Utopia Documents оставляйте для той задачи, ради которой она создавалась: связать научный текст с данными вокруг него.