
SysTools PDF Extractor — настольная утилита для выборочного извлечения содержимого из PDF: вложений и файлов портфолио, встроенных изображений, текста, закладок, гиперссылок, комментариев, метаданных и rich media. На странице Xeon Live можно скачать SysTools PDF Extractor бесплатно, а ниже разберём интерфейс и рабочие сценарии так, чтобы итог можно было проверить, а не просто получить набор файлов в папке.
Для чего необходим SysTools PDF Extractor и как устроен интерфейс
Программа решает узкую задачу: не редактирует страницы как универсальный PDF-редактор, а разбирает документы на отдельные типы содержимого и сохраняет их во внешние файлы. Это полезно, когда в десятках PDF необходимо собрать вложения, выгрузить иллюстрации, получить текстовые копии, вынести комментарии для согласования или собрать метаданные для архива. Чтобы понимать границы формата до начала работы, полезно свериться с материалом Xeon Live о том, как устроен PDF и чем его содержимое отличается от обычного документа.
Скриншот: SysTools Software Pvt. Ltd.
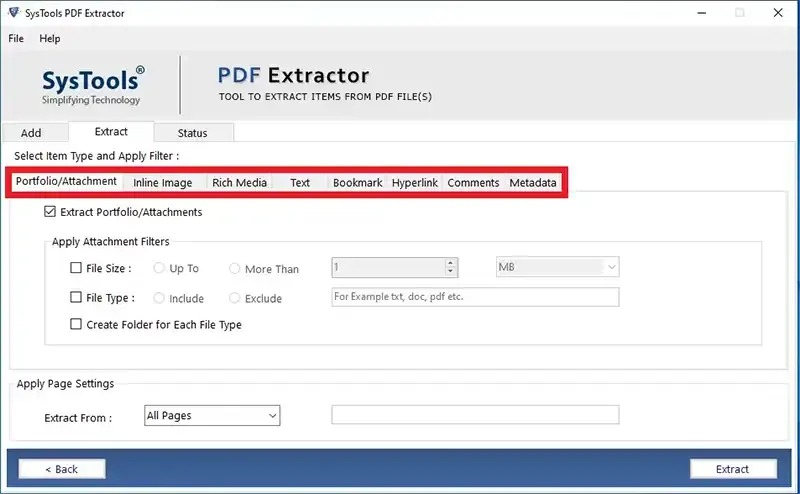
Логика окна последовательная. На вкладке Add формируется очередь PDF, задаётся папка назначения и при необходимости единая папка для всех итогов. На вкладке Extract расположены категории данных и связанные с ними параметры. Вкладка Status показывает ход обработки, количество успешно и неуспешно обработанных файлов и путь к итогу. Такой подход удобен тем, что выбор источников, настройка извлечения и проверка выполнения разделены на три понятных этапа.
Что именно программа извлекает, а что оставляет за пределами задачи
Для вложений и PDF Portfolio файлы сохраняются в исходных форматах; для встроенной графики предусмотрены графические форматы и режимы сборки в PDF; текст выводится в TXT с опциями сохранения форматирования и номера страницы. Закладки могут сохраняться отдельными PDF по каждой отмеченной странице или собираться в один PDF. Гиперссылки, комментарии и метаданные программа экспортирует в PDF, DOC или DOCX. Rich media рассматривается как отдельная категория. Вместе с этим SysTools PDF Extractor не является OCR-системой: скан, в котором текст существует только как изображение, сперва необходимо распознать в другом инструменте.
Важное практическое отличие от функции «Экспорт страниц»: извлечение встроенной картинки не равно превращению страницы целиком в JPEG или PNG. В первом случае программа забирает графические объекты из структуры PDF, во втором — растеризует страницу. По этой причине для фотографий и иллюстраций внутри документа необходим режим Inline Image, а для получения отдельных страниц как самостоятельных PDF подходит другой класс инструментов; о нём есть отдельная инструкция по извлечению страниц из PDF.
Пошаговая подготовка: как добавить PDF и организовать папку итога
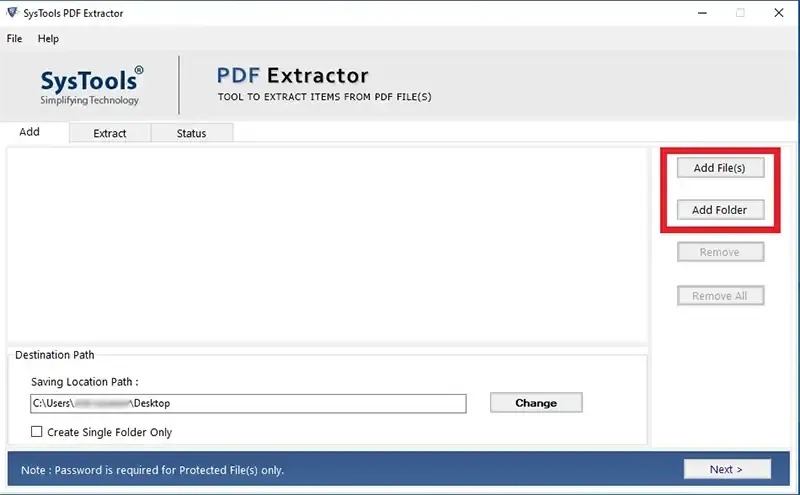
Начинать лучше не с выбора типа данных, а с организации входных файлов и папки назначения. Это уменьшает риск смешать итоги различных проектов и упрощает проверку. Интерфейс Add содержит кнопки Add File(s), Add Folder, Remove и Remove All, таблицу выбранных файлов, поле Saving Location Path, кнопку Change и флажок Create Single Folder Only. В таблице есть отдельная колонка для пароля, который требуется лишь для PDF с известным паролем открытия.
Скриншот: SysTools Software Pvt. Ltd.
Добавление одного набора документов и контроль очереди
Шаг 1. Откройте вкладку Add и нажмите Add File(s), если документы лежат в различных местах, либо Add Folder, если подготовлена отдельная папка. После выбора файлов посмотрите на таблицу: в ней должны появиться именно те PDF, которые относятся к одной задаче. Не смешивайте договоры, презентации и технические отчёты, когда для них необходимы различные правила извлечения — в дальнейшем параметры применяются к текущему набору.
Шаг 2. Удалите лишние позиции кнопкой Remove. Если ошибочно добавлена целая папка, быстрее применять Remove All и сформировать очередь заново. Для защищённого файла введите известный пароль в соответствующей колонке. Пароль тут необходим не для снятия неизвестной защиты, а для доступа к файлу, который вы имеете право открыть.
Шаг 3. До перехода на Extract проверьте исходные PDF обычным просмотрщиком. Откройте по одному типичному файлу из набора и убедитесь, что в нём в самом деле есть требуемые объекты: вложения через панель вложений, закладки в навигации, комментарии в панели рецензирования, либо выделяемый текст. Такой контроль в особенности важен для сканов: пустой итог по Text часто связан не с ошибкой программы, а с отсутствием текстового слоя.
Скриншот: SysTools Software Pvt. Ltd.
Папка назначения и режим Create Single Folder Only
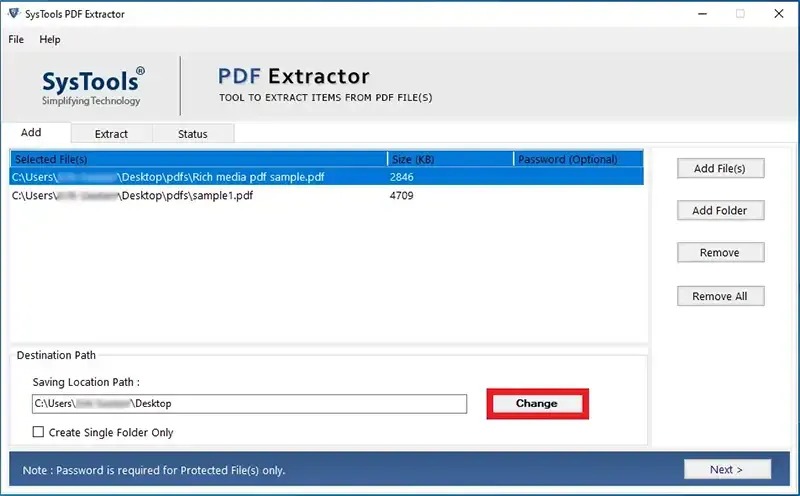
Шаг 4. Нажмите Change и укажите новую пустую папку. В рабочем процессе лучше создавать отдельный каталог под каждую операцию, к примеру для вложений или текста. Это позволяет сопоставлять итоги, не перезаписывая предыдущий запуск, и упрощает поиск пропущенных файлов.
Шаг 5. Решите, как группировать итог. При включённом Create Single Folder Only извлечённые элементы из всего набора складываются в один общий каталог. Без этого флажка программа создаёт структуру по исходным PDF. Единая папка удобна, когда необходимо собрать однотипные файлы в общий пул, а раздельные каталоги полезнее для аудита: сразу видно, из какого документа появился конкретный объект.
Шаг 6. Нажмите Next и убедитесь, что открылся экран Extract. Перед выбором категории зафиксируйте ожидаемый итог: к примеру, «из пяти PDF получить только вложения DOCX и XLSX» или «сохранить изображения с определённых страниц». Чёткое ожидание необходимо для финальной проверки на вкладке Status и в папке назначения.
Пошаговое извлечение вложений и файлов PDF Portfolio
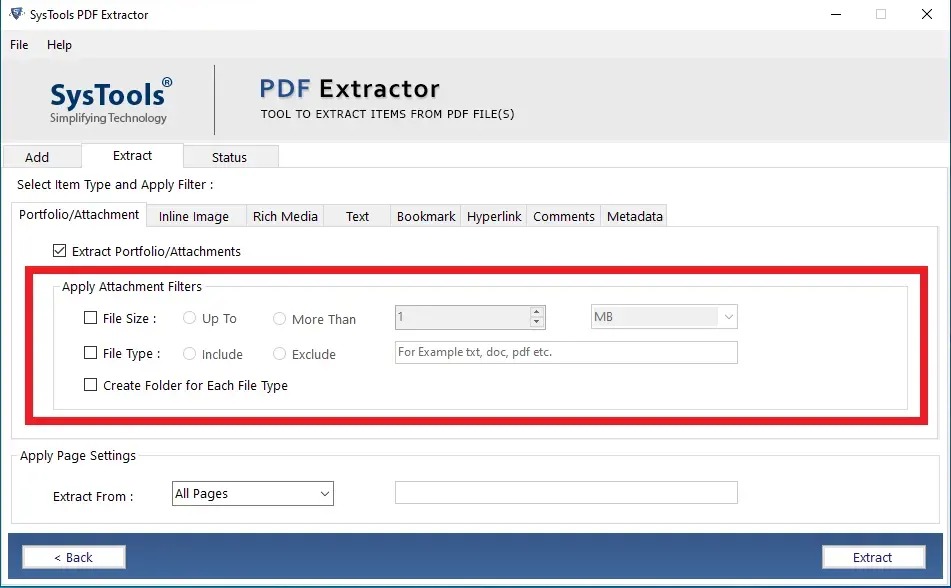
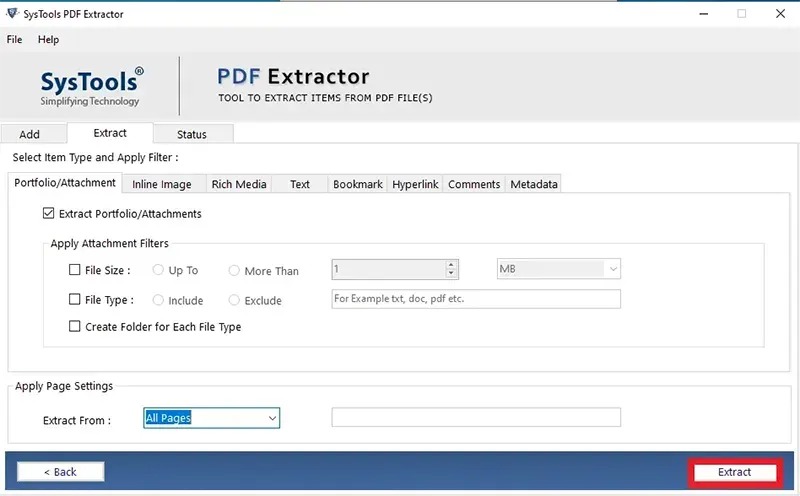
Режим Portfolio/Attachment предназначен для файлов, прикреплённых к PDF, и содержимого PDF Portfolio. Он полезен при разборе проектной документации, отчётов с приложенными таблицами и пакетах, где внутри контейнера лежат документы различных типов. В отличие от копирования текста или картинок, вложения сохраняются в исходных форматах.
Скриншот: SysTools Software Pvt. Ltd.
Как отфильтровать вложения по типу и размеру
Шаг 1. На вкладке Extract выберите Portfolio/Attachment и оставьте включённым Extract Portfolio/Attachments. Если необходимо извлечь все вложения, не включайте добавочные фильтры. Для выборочной выгрузки активируйте File Type или File Size лишь после того, как определили правило отбора.
Шаг 2. Для File Type выберите Include, когда необходим ограниченный набор форматов, либо Exclude, когда требуется извлечь всё, кроме нескольких типов. В поле рядом перечислите нужные расширения в том синтаксисе, который подсказывает интерфейс. После запуска обязательно сопоставьте полученный набор расширений с ожиданием: фильтр удобен, но ошибка в условии отбора может незаметно исключить часть вложений.
Шаг 3. Для File Size применяется условие Up To или More Than и размер. Этот фильтр полезен, когда в PDF есть много служебных мелких объектов либо, наоборот, требуется быстро отыскать крупные приложенные архивы и медиафайлы. Не воспринимайте его как оценку важности: размер не говорит о содержании, по этой причине после выгрузки всё равно проверьте имена и типы файлов.
Шаг 4. Включите Create Folder for Each File Type, если итог содержит много расширений и дальше их будут обрабатывать различные программы. При таком подходе документы, таблицы и изображения разводятся по отдельным каталогам. Для последующей автоматизации это удобнее, чем одна папка с сотнями смешанных файлов.
Скриншот: SysTools Software Pvt. Ltd.
Ограничение страниц и проверка состава итога
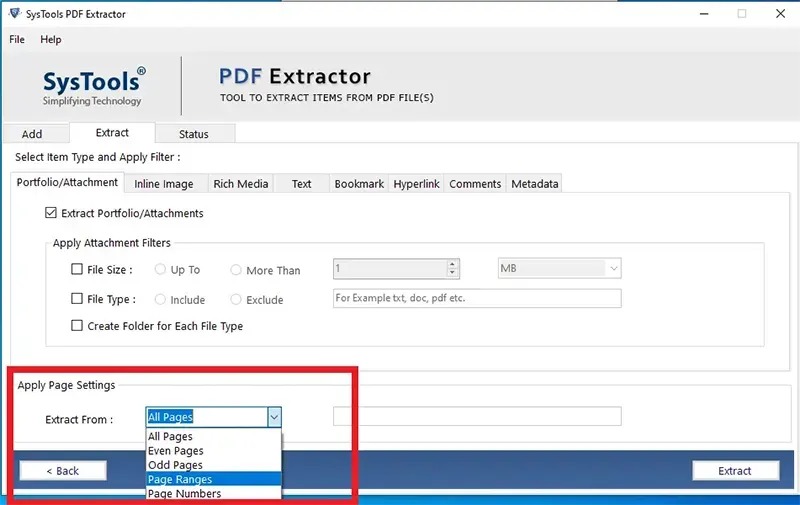
Шаг 5. В блоке Apply Page Settings выберите All Pages только тогда, когда содержимое необходимо со всего документа. Для выборочной обработки доступны Even Pages, Odd Pages, Page Ranges и Page Numbers. Если документ большой, сперва протестируйте правило на небольшом диапазоне: так быстрее увидеть, соответствует ли структура PDF предположению и находятся ли нужные вложения в выбранной части.
Шаг 6. Нажмите Extract. После окончания перейдите в Status и потом откройте папку назначения. Сверьте количество исходных PDF с количеством строк Completed и Failed, а потом проверьте не только число полученных файлов, но и несколько типичных вложений: они должны открываться в соответствующих приложениях и иметь ожидаемые расширения.
Шаг 7. Для PDF Portfolio вдобавок проверьте иерархию папок. Программа заявляет сохранение дерева портфолио, по этой причине при сложной структуре имеет смысл открыть исходный Portfolio в Acrobat или другом совместимом просмотрщике и сопоставить уровни каталогов с выгруженными. Этот шаг обнаруживает ситуацию, когда содержимое извлечено, но организация проекта потеряна.
Пошаговая работа с изображениями и текстом
Inline Image и Text — два наиболее частых режима, но они решают различные задачи. Первый извлекает графические объекты, встроенные в структуру PDF; второй выгружает существующий текстовый слой в TXT. Для сканированных страниц без OCR режим Text не создаёт распознанный текст. Перед запуском полезно выделить несколько слов курсором в обычном просмотрщике: если выделение невозможно, сперва потребуется OCR.
Скриншот: SysTools Software Pvt. Ltd.
Как выгрузить встроенные изображения без превращения страниц в картинки
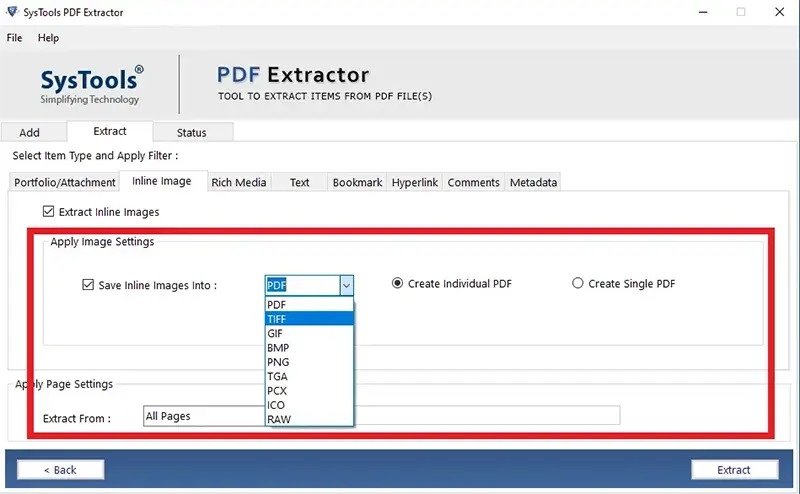
Шаг 1. Выберите Inline Image и включите Extract Inline Images. В Apply Image Settings отметьте Save Inline Images Into и укажите формат итога. В интерфейсе перечислены PDF, TIFF, GIF, BMP, PNG, TGA, PCX, ICO и RAW. Для последующей веб-публикации практичнее PNG или GIF в зависимости от исходника, для архивирования важнее сохранить подходящий формат без лишнего перекодирования.
Шаг 2. Если выбран PDF, определите режим сборки. Create Individual PDF создаёт отдельный PDF для каждого извлечённого изображения, а Create Single PDF собирает изображения в один документ. Первый вариант проще для точечной передачи и именования, второй удобен для просмотра всей подборки как единого файла.
Шаг 3. Ограничьте страницы через Apply Page Settings, когда интересует конкретная глава или диапазон. После Extract откройте несколько файлов и сопоставьте их с исходным PDF при увеличении. Проверяйте не только видимый размер, но и отсутствие ненужной рамки страницы: если вместо объекта получилась целая страница, использован не тот режим или исходный PDF устроен иначе, чем ожидалось.
Отдельный разбор подходов к этой задаче есть в материале Xeon Live о том, как извлечь картинки из PDF без потери качества. Он помогает отличить извлечение исходных графических объектов от конвертации страниц и выбрать метод под конкретный документ.
Скриншот: SysTools Software Pvt. Ltd.
Как получить TXT с форматированием и номерами страниц
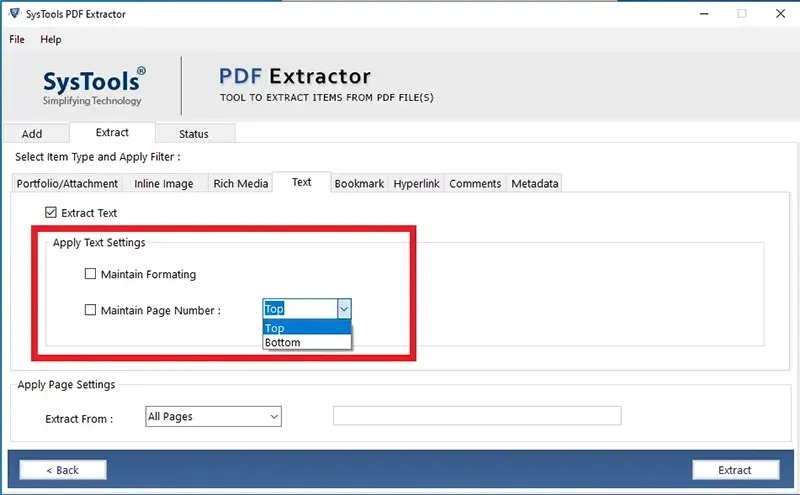
Шаг 4. Перейдите на Text и включите Extract Text. Если важна структура абзацев, отметьте Maintain Formatting. Для задач, где необходимо сопоставлять фрагменты с источником, включите Maintain Page Number и выберите Top либо Bottom. Номер страницы в текстовом файле помогает при проверке цитат и при последующей ручной сверке.
Шаг 5. Выберите страницы. All Pages подходит для полного архива, Page Ranges — для главы, Page Numbers — для разрозненных страниц. На больших наборах документов сперва обработайте один или два типичных PDF. Если итог читабелен, форматирование приемлемо и номера совпадают, применяйте те же настройки к остальной очереди.
Шаг 6. Нажмите Extract и откройте TXT в редакторе, который показывает кодировку и переносы строк без добавочного форматирования. Сверьте начало, середину и конец текста с PDF. Отдельно посмотрите таблицы, колонки, сноски и декоративные блоки: PDF хранит текст не так, как DOCX, по этой причине даже при Maintain Formatting сложная верстка может требовать ручной доработки.
Если необходима не просто текстовая копия, а перенос в редактируемый документ, полезно сопоставить итог с инструкцией Xeon Live о преобразовании PDF в TXT и материалом о том, как копировать текст из PDF. Это в особенности важно для файлов с ограничениями или необычной версткой.
Пошаговое извлечение закладок, ссылок, комментариев, метаданных и rich media
Остальные категории Extract необходимы для более специализированных задач: сохранения страниц, отмеченных закладками, инвентаризации ссылок, переноса комментариев из рецензирования, выгрузки свойств документа и извлечения мультимедийных объектов. Их удобно обрабатывать отдельными запусками, чтобы выходные файлы не смешивались и проверка оставалась прозрачной.
Скриншот: SysTools Software Pvt. Ltd.
Закладки: отдельные PDF или один документ
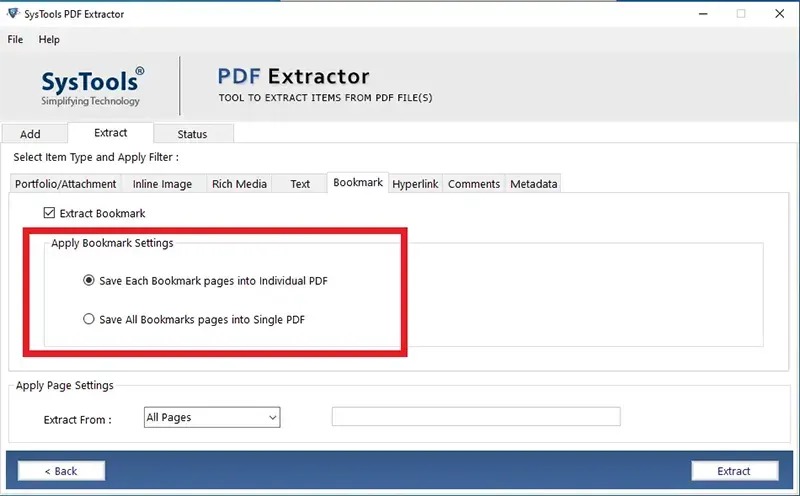
Шаг 1. Выберите Bookmark и включите Extract Bookmark. Режим Save Each Bookmark pages into Individual PDF создаёт отдельный файл для каждой отмеченной закладкой страницы. Save All Bookmarks pages into Single PDF собирает такие страницы в один документ. Первый режим подходит для рассылки отдельных разделов, второй — для компактной подборки по навигационной структуре исходника.
Шаг 2. Задайте Apply Page Settings, если необходимо ограничить извлечение частью документа. После запуска откройте созданный PDF и сопоставьте его страницы с переходами по закладкам в исходном документе. Не все PDF применяют закладки одинаково: порой они ведут на позицию внутри страницы, по этой причине фактический итог следует оценивать по страницам, а не по тексту наименований закладок.
Скриншот: SysTools Software Pvt. Ltd.
Гиперссылки, комментарии и выделенный текст
Шаг 3. Для ссылок откройте Hyperlink и выберите выходной формат PDF, DOC или DOCX. После извлечения не ограничивайтесь просмотром списка: возьмите несколько ссылок из различных страниц и сопоставьте их с исходным документом. Смысл такой выгрузки — инвентаризация, по этой причине важна полнота, а не визуальная похожесть на исходную страницу.
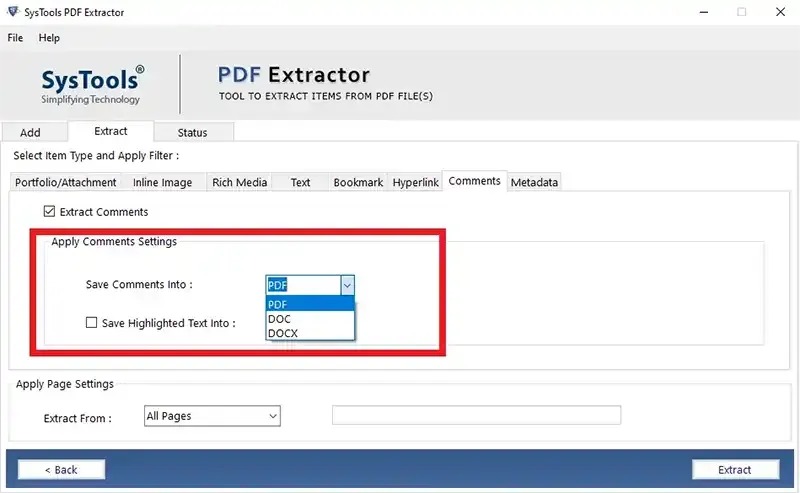
Шаг 4. Для рецензирования откройте Comments. Выберите формат PDF, DOC или DOCX; при необходимости включите сохранение highlighted text. После Extract сопоставьте итог с панелью комментариев в исходном PDF: проверьте наличие заметок из начала и конца документа и отдельно убедитесь, что выделенные фрагменты не потерялись. Для согласований это надёжнее, чем считать успешно законченный статус достаточным доказательством полноты.
Скриншот: SysTools Software Pvt. Ltd.
Метаданные и rich media
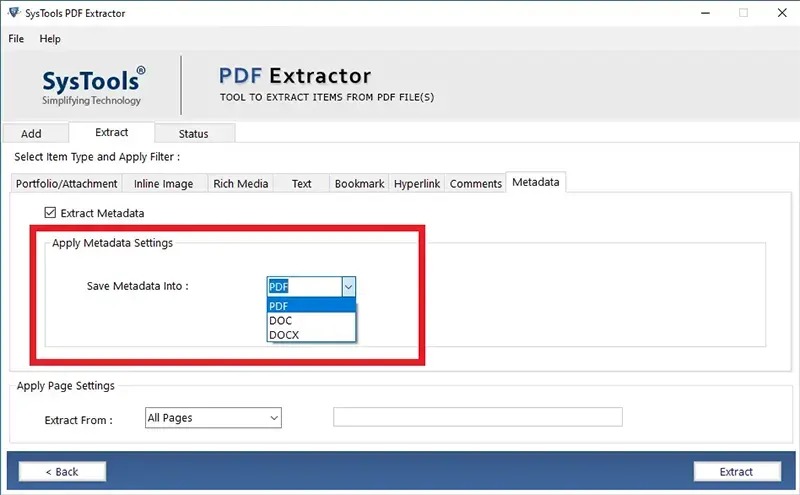
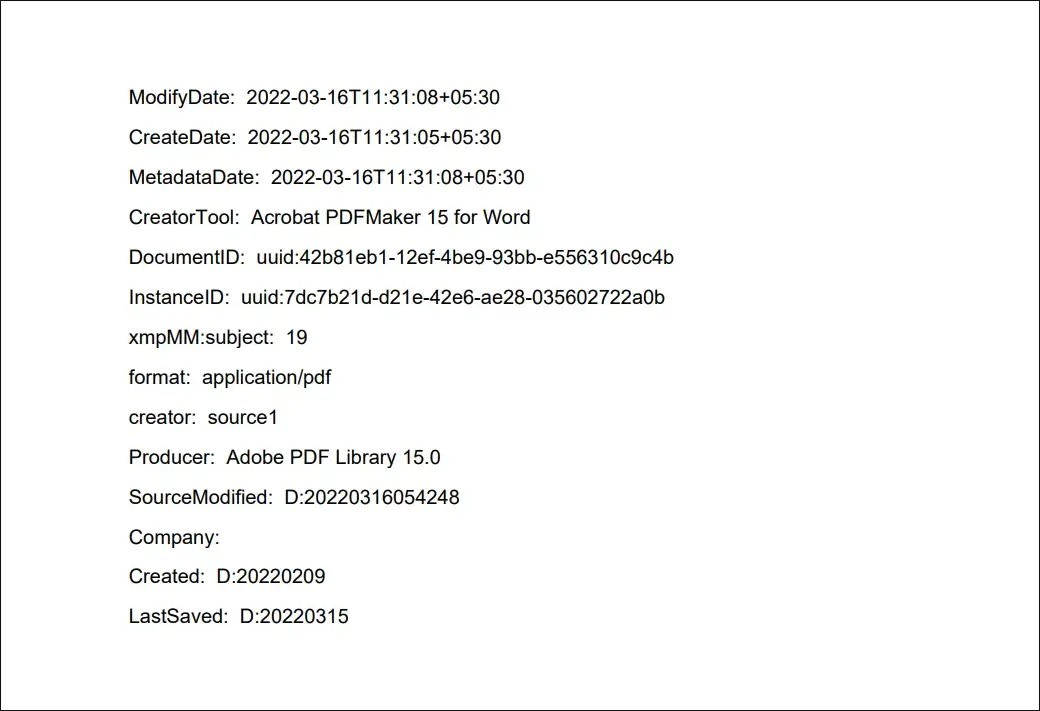
Шаг 5. На Metadata включите Extract Metadata и выберите PDF, DOC или DOCX. Итог может включать поля вроде автора, заголовка, даты создания, производителя PDF и других свойств, которые реально присутствуют в файле. После выгрузки сопоставьте несколько полей с Document Properties в просмотрщике PDF. Пустое поле в результате может означать, что исходный документ его не содержит.
Шаг 6. Rich Media применяйте лишь для PDF, где в самом деле есть встроенные аудио-, видео-, SWF- или иные мультимедийные объекты. Программа относит эту категорию к отдельной вкладке и заявляет фильтры по типу и размеру. Сперва протестируйте один документ и проверьте, открываются ли полученные файлы в соответствующем проигрывателе. Старые SWF-объекты могут быть проблемой уже на уровне современных систем, даже если извлечение прошло правильно.
Шаг 7. Для каждой специализированной категории применяйте отдельную папку назначения или отдельный запуск. Так проще доказать полноту: в папке Metadata лежат только свойства, в Comments — материалы рецензирования, в Hyperlink — ссылки. Смешивание уменьшает управляемость и делает ручную проверку сложнее.
Пакетная обработка, защищённые PDF и проверка итога
Сильная сторона SysTools PDF Extractor — обработка нескольких PDF одной очередью. Пакетный режим экономит время лишь при одинаковой задаче для всех файлов: одна категория, одинаковые фильтры и единый принцип проверки. Когда документы различаются по структуре, разумнее делить их на небольшие группы и сперва прогонять репрезентативный образец.
Скриншот: SysTools Software Pvt. Ltd.
Как строить безопасный пакетный процесс
Шаг 1. Подготовьте отдельную входную папку и оставьте в ней только PDF одной задачи. Добавьте папку через Add Folder и проверьте список. Если файлы защищены паролем открытия, внесите известные пароли в очередь до перехода на Extract. Документы с неизвестным паролем не стоит включать в рабочий пакет: программа не предназначена для угадывания учётных данных.
Шаг 2. Настройте категорию и фильтры на одном или двух типичных документах. Запустите извлечение в тестовую папку и посмотрите выход. Лишь после этого сформируйте полную очередь. Этот приём в особенности полезен для Include/Exclude и Page Ranges: ошибка в одном поле, умноженная на сотни PDF, создаёт больше ручной работы, чем небольшой пилотный запуск.
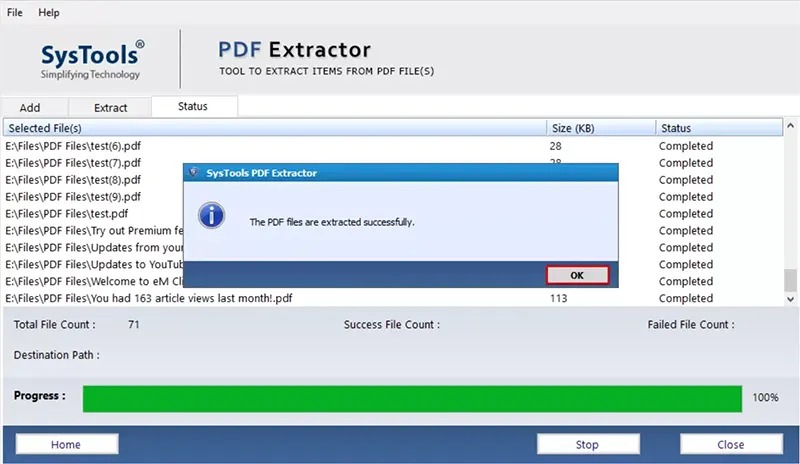
Шаг 3. Во время выполнения следите за Status. В нормальном сценарии строки переходят в Completed, прогресс доходит до конца, а счётчик Failed остаётся нулевым. Если есть сбой, не запускайте весь пакет ещё раз поверх той же папки. Сперва вынесите проблемные файлы в отдельную очередь и разберите причину.
Шаг 4. После окончания проверьте три уровня: статус в приложении, структуру папок и содержимое файлов. Статус подтверждает только выполнение операции; наличие папки подтверждает сохранение; открытие файлов и сравнение с исходником подтверждает полезность итога. Для критичных архивов сохраните список исходных PDF и число выходных объектов по каждому документу.
Шаг 5. Если применяется Create Single Folder Only, уделите больше внимания происхождению файлов. В единой папке легче получить совпадающие имена и сложнее определить источник. Для аудита и юридически значимых наборов раздельные папки по исходным PDF обычно дают более прозрачный след обработки.
Шаг 6. Для повторяемого процесса зафиксируйте настройки вне программы: какая категория выбрана, включены ли фильтры, какие страницы обрабатываются, включён ли единый каталог и чем проверяется итог. Такой короткий регламент в особенности полезен, когда задачу выполняют несколько сотрудников. Он защищает от ситуации, когда один и тот же архив в различные дни обрабатывается различными правилами, а расхождение замечают уже после передачи файлов дальше.
Шаг 7. При большом наборе разбивайте очередь на партии, размер которых удобно проверить ручным способом. После каждой партии откройте несколько итогов из начала, середины и конца списка. Для вложений сверяйте расширения и открываемость, для текста — читаемость и номера страниц, для изображений — качество и соответствие объектам, для ссылок и метаданных — полноту полей. Такая выборка не заменяет формальный контроль, но быстро обнаруживает систематическую ошибку настройки.
Шаг 8. Не применяйте папку назначения как единственное место хранения. Сперва закончите проверку, затем перенесите подтверждённый итог в рабочий архив или систему документооборота. Исходные PDF сохраняйте отдельно и не удаляйте до окончания сверки: Extractor создаёт внешние файлы, а обратная сборка полного исходного состояния из них не является его задачей.
Скриншот: SysTools Software Pvt. Ltd.
Скриншот: SysTools Software Pvt. Ltd.
Скриншот: SysTools Software Pvt. Ltd.
Слайдер выше сводит пакетный цикл к трём контрольным точкам: категория, страничный фильтр, запуск. На практике к ним необходимо добавить четвёртую — проверку итога. В особенности это важно для текста и ссылок: программа может правильно закончить операцию, но исходная структура PDF сама по себе не гарантирует удобный для дальнейшей работы выход.
Типичные ошибки и методы их диагностировать
Большинство проблем при работе с Extractor связано не с «поломкой PDF», а с неверным ожиданием от структуры документа, фильтром, выбранной категорией или правами доступа. Диагностику удобнее вести от простого к сложному: один файл, одна категория, All Pages, без фильтров, отдельная пустая папка. После успешного базового запуска ограничения добавляются по одному.
Скриншот: SysTools Software Pvt. Ltd.
Пустой итог, неправильные страницы и проблемы с защитой
- Text создаёт пустой или практически пустой TXT. Проверьте, выделяется ли текст в исходном PDF. Если страница является сканом, необходим OCR до извлечения. Если текст выделяется, повторите запуск на одном файле с All Pages и без добавочных ограничений.
- Inline Image не даёт ожидаемых картинок. Убедитесь, что изображения в самом деле встроены как отдельные объекты, а не являются частью одной растровой страницы. Для сканированного PDF страница может быть единственным большим изображением.
- Фильтр Include/Exclude пропускает нужные вложения. Уберите фильтр, извлеките всё из одного PDF и посмотрите реальные расширения. Потом настройте правило заново и сопоставьте два итога.
- Page Ranges возвращает не тот набор. Сперва проверьте нумерацию визуально в самом PDF. Печатный номер на странице и фактический индекс страницы в файле могут различаться.
- Защищённый PDF не обрабатывается. Для пароля открытия требуется известный пароль. Введите его для соответствующего файла и повторите обработку отдельно, не смешивая проблему с остальной очередью.
- Status показывает Failed. Перенесите проблемный PDF в отдельную очередь, смените папку назначения на новую, уберите фильтры и попробуйте одну категорию. Если базовый сценарий работает, возвращайте параметры по одному.
Отдельная проверка необходима для старых или необычных PDF с повреждённой структурой. Если один документ ведёт себя иначе, чем остальные, откройте его в нескольких просмотрщиках и попробуйте сохранить копию через надёжный PDF-редактор. Не стоит маскировать проблему повторными запусками всего пакета: так сложнее понять, на каком файле и на каком этапе появляется отклонение.
Почему программа не распознаёт текст со скана?
SysTools PDF Extractor извлекает существующий текстовый слой, но не выполняет OCR. Для скана сперва требуется распознавание текста, после чего можно повторить режим Text.
Можно ли извлекать данные из PDF с паролем открытия?
Да, когда пароль известен: его вводят для соответствующего файла. Утилита тоже заявляет работу с документами, где стоят ограничения владельца.
Чем Inline Image отличается от экспорта страницы в PNG?
Inline Image извлекает графические объекты, встроенные в PDF. Экспорт страницы растеризует всю страницу целиком, включая текст и фон.
Как сохранить только несколько типов вложений?
В Portfolio/Attachment включите File Type и применяйте Include для нужных расширений либо Exclude для исключаемых. Сперва проверьте правило на одном PDF.
Как понять, что пакет отработал полностью?
Сверьте Status, число Completed и Failed, структуру папок и содержимое нескольких выходных файлов. Для важных архивов дополнительно сопоставьте число объектов с исходными PDF.
Можно ли выгрузить комментарии и выделенный текст?
В категории Comments доступны экспорт комментариев в PDF, DOC или DOCX и отдельная опция сохранения highlighted text.
Преимущества, недостатки, альтернативы и рекомендации по выбору
SysTools PDF Extractor удобен, когда задача состоит именно в разборе содержимого PDF на составляющие и таких документов много. Интерфейс не перегружен редактированием страниц: пользователь последовательно формирует очередь, выбирает категорию, задаёт фильтры и получает отдельные файлы. Но эта специализация одновременно задаёт ограничения: программа не заменяет полноценный редактор, OCR и инструменты для сложной конвертации макета.
Скриншот: SysTools Software Pvt. Ltd.
Плюсы
- Единый интерфейс для вложений, портфолио, встроенных изображений, текста, закладок, гиперссылок, комментариев, метаданных и rich media.
- Пакетное добавление отдельных файлов или целой папки.
- Фильтры вложений по типу и размеру, раздельные папки по расширениям.
- Выбор страниц: все, чётные, нечётные, диапазоны или отдельные номера.
- Отдельные настройки для текста, изображений, закладок, комментариев и метаданных.
- Вкладка Status с прогрессом и счётчиками успешных и неуспешных файлов.
Минусы
- Нет OCR: сканированные PDF без текстового слоя требуют предварительного распознавания.
- Узкая специализация: редактирование страниц, полноценная конвертация документов и исправление PDF выполняются другими инструментами.
- Сложная верстка текста при выгрузке в TXT может требовать ручной проверки и доработки.
- Пакетная обработка не отменяет контроль итога; фильтры способны массово исключить нужные объекты при неверной настройке.
- Демо-режим имеет ограничения на число обрабатываемых файлов и извлекаемых элементов, по этой причине для оценки необходимо учитывать характер конкретной задачи.
Чем отличаются Adobe Acrobat, PDF24, Sejda и PDF-XChange
Adobe Acrobat подходит шире: он редактирует PDF и умеет экспортировать изображения и текстовые данные, по этой причине логичен в организациях, где Acrobat уже является основным рабочим инструментом. PDF-XChange Editor и PDF-Tools сильны в управлении страницами и экспорте, а отдельное действие Extract Images from PDF позволяет строить более автоматизированные цепочки. PDF24 и Sejda удобны для разовых операций в браузере, но при конфиденциальных документах необходимо учитывать, что обработка выполняется на внешнем сервере и подчиняется правилам конкретного сервиса.
SysTools PDF Extractor отличается тем, что в одном окне объединяет именно «объектное» извлечение: вложения, изображения, текст, закладки, ссылки, комментарии, метаданные и мультимедиа. Это делает его удобным для архивов и пакетных задач, но не даёт преимуществ там, где требуется редактировать текст прямо на странице, распознавать скан или пересобирать документ. Выбор зависит не от числа функций вообще, а от того, какая операция повторяется чаще всего.
Кому подойдёт
- Архивистам и техническим специалистам, которым необходимо массово разбирать PDF на вложения и отдельные типы содержимого.
- Командам, которые получают пакетные PDF с приложенными файлами, комментариями или метаданными и хотят хранить эти данные отдельно.
- Редакторам и контент-менеджерам, которым требуется извлечь встроенную графику или текст из серии документов с одинаковыми правилами.
- Пользователям, которым важен локальный процесс на компьютере вместо загрузки документов в веб-сервис.
Кому лучше выбрать иной инструмент
- Тем, кому необходим OCR для сканов и фотографий документов.
- Тем, кто редактирует исходный PDF: меняет текст, изображения, страницы, формы и подписи.
- Тем, кому необходимо один раз извлечь пару картинок из несекретного PDF: веб-сервис может быть быстрее.
- Тем, кому требуется программный конвейер без графического интерфейса: в таком сценарии удобнее SDK, библиотека или командная утилита.
Практическая рекомендация проста: для повторяющейся пакетной выгрузки объектов из PDF начните с теста на нескольких репрезентативных файлах, зафиксируйте настройки и метод проверки, затем масштабируйте процесс. Для сканов сперва выполняйте OCR; для редактирования и преобразования макета применяйте PDF-редактор или конвертер. Так SysTools PDF Extractor остаётся в своей сильной зоне — аккуратном извлечении уже существующих элементов документа.