
Text Fairy необходим, когда текст уже существует на бумаге, фотографии или скриншоте и перепечатывать его ручным способом не хочется. На странице Xeon Live можно скачать Text Fairy бесплатно и сверить назначение приложения. Ниже — практическая инструкция: от первого снимка и выбора языка до проверки OCR, копирования, озвучивания и экспорта итога в PDF.
Что умеет Text Fairy и где проходит граница его возможностей
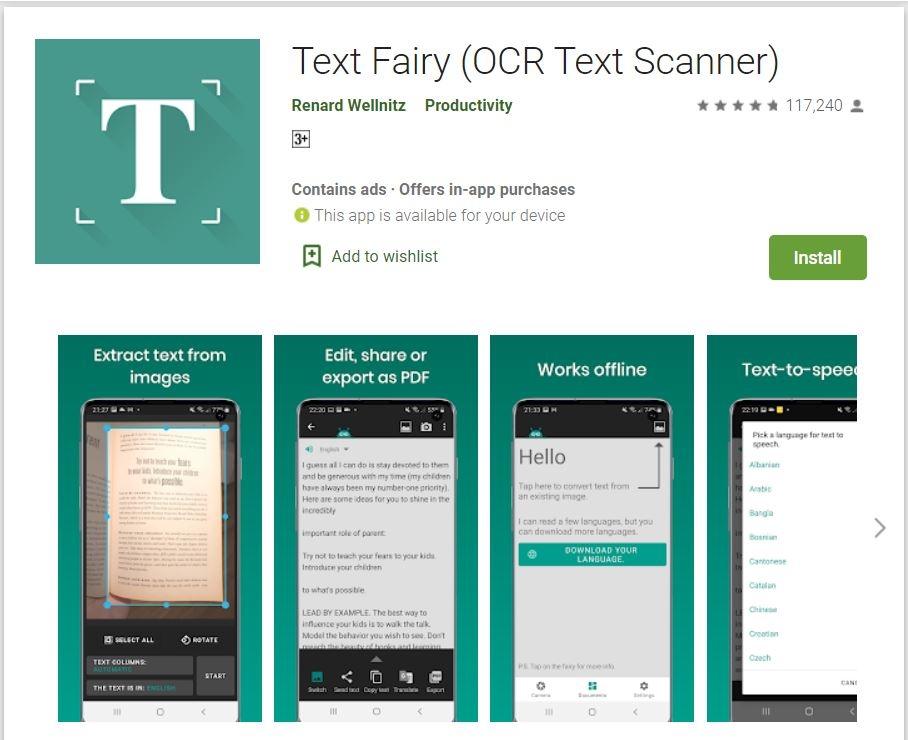
Text Fairy — Android-приложение для оптического распознавания печатного текста. В актуальной карточке Google Play перечислены извлечение текста из изображений, редактирование итога, передача в иные приложения, экспорт в PDF, синтез речи, распознавание более чем 110 языков, работа с многоязычными документами, управление отсканированными файлами и автоматическая коррекция изображения. Основное ограничение указано там же: рукописный текст программа не распознаёт.
По этой причине основная аудитория — пользователи Android, которым необходимо быстро оцифровать страницу книги, распечатку, инструкцию, учебный материал, чек, объявление или иной документ с печатными символами. Для одной-двух страниц такой мобильный сценарий заметно короче настольного: достаточно камеры и нескольких действий в приложении. Для многостраничных архивов, сложных таблиц, юридически значимой вычитки и массовой обработки удобнее полноценный OCR-комплекс на компьютере.
Если задача шире одного приложения, полезно сопоставить Text Fairy с другими инструментами в обзоре программ для распознавания текста. В нём хорошо видна разница между мобильным OCR, настольными редакторами PDF и сервисами, которые делают поисковый текстовый слой внутри документа.
- Подходит: печатные книги, листовки, инструкции, учебные материалы, объявления, визитки, простые счета и фотографии страниц.
- Работает с изображениями, полученными камерой или выбранными из памяти устройства; итог можно править ручным способом.
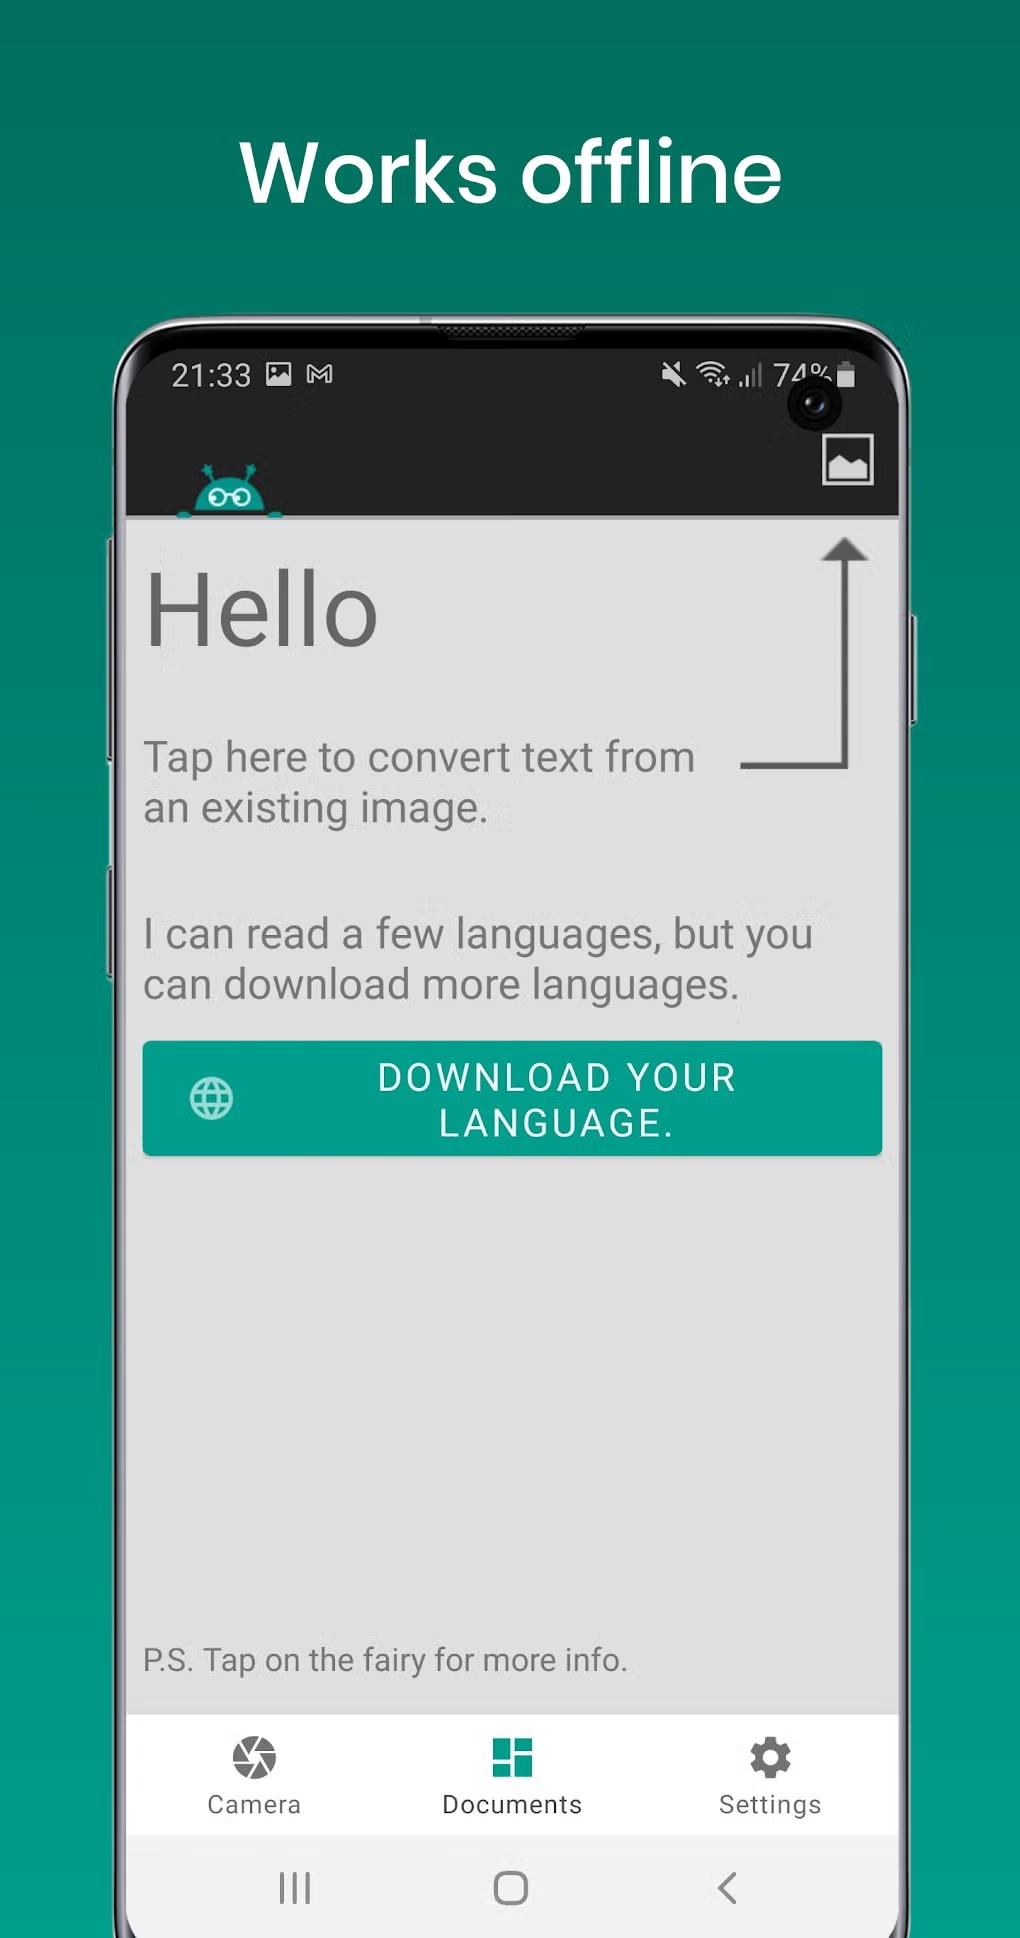
- Поддерживает локальное распознавание и добавочные языковые данные, по этой причине базовую OCR-задачу можно выполнять без постоянного подключения к сети.
- Не рассчитан на рукопись; декоративные шрифты, сильные тени, блики, низкая резкость и сложная верстка повышают количество ошибок.
- PDF в Text Fairy логичнее рассматривать как формат вывода итога, а не как замену полноценному редактору многостраничных PDF.
Отдельно стоит различать локальный OCR и сетевые действия вокруг него. Само распознавание в описании приложения заявлено как офлайн, что удобно для страниц, которые не хочется отправлять на сервер только ради извлечения текста. Но кнопки перевода и системного обмена уже могут передавать содержимое выбранному сервису или приложению. Для рабочих документов полезно выстроить простой порядок: сперва выполнить OCR и ручную проверку локально, затем отдельно решить, можно ли отправлять полученный текст в переводчик, облачное хранилище или мессенджер. Такая граница между распознаванием и последующей передачей в особенности важна для договоров, внутренних инструкций и материалов с персональными данными.
Карта интерфейса: камера, галерея, документы и настройки
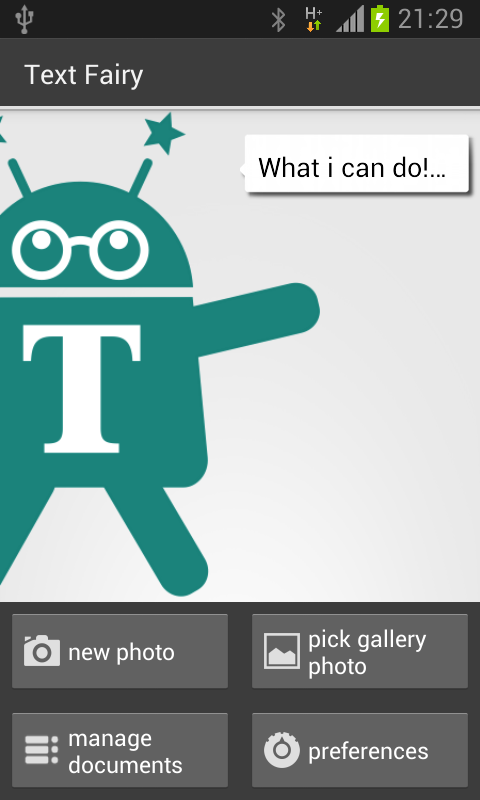
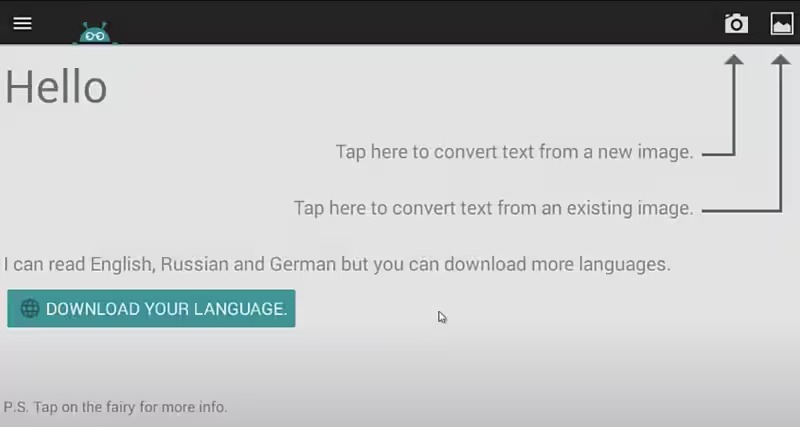
Логика Text Fairy строится вокруг короткого маршрута: получить изображение, выделить нужную область, указать язык и структуру страницы, запустить OCR, потом проверить текст и выбрать дальнейшее действие. В различных версиях оформление менялось, но основные команды хорошо узнаваемы по иконкам камеры, изображения, документов и меню.
Камера и выбор готового изображения
Для нового бумажного источника применяется камера: приложение передаёт управление системной камере или собственному экрану съёмки, после чего открывает полученный кадр для подготовки. Для уже существующего скриншота или фотографии выбирается иконка изображения/галереи. Это важное различие: ещё раз фотографировать скриншот с экрана не нужно — исходный файл практически всегда даст OCR более чёткие контуры символов.
Документы, итог и служебные настройки
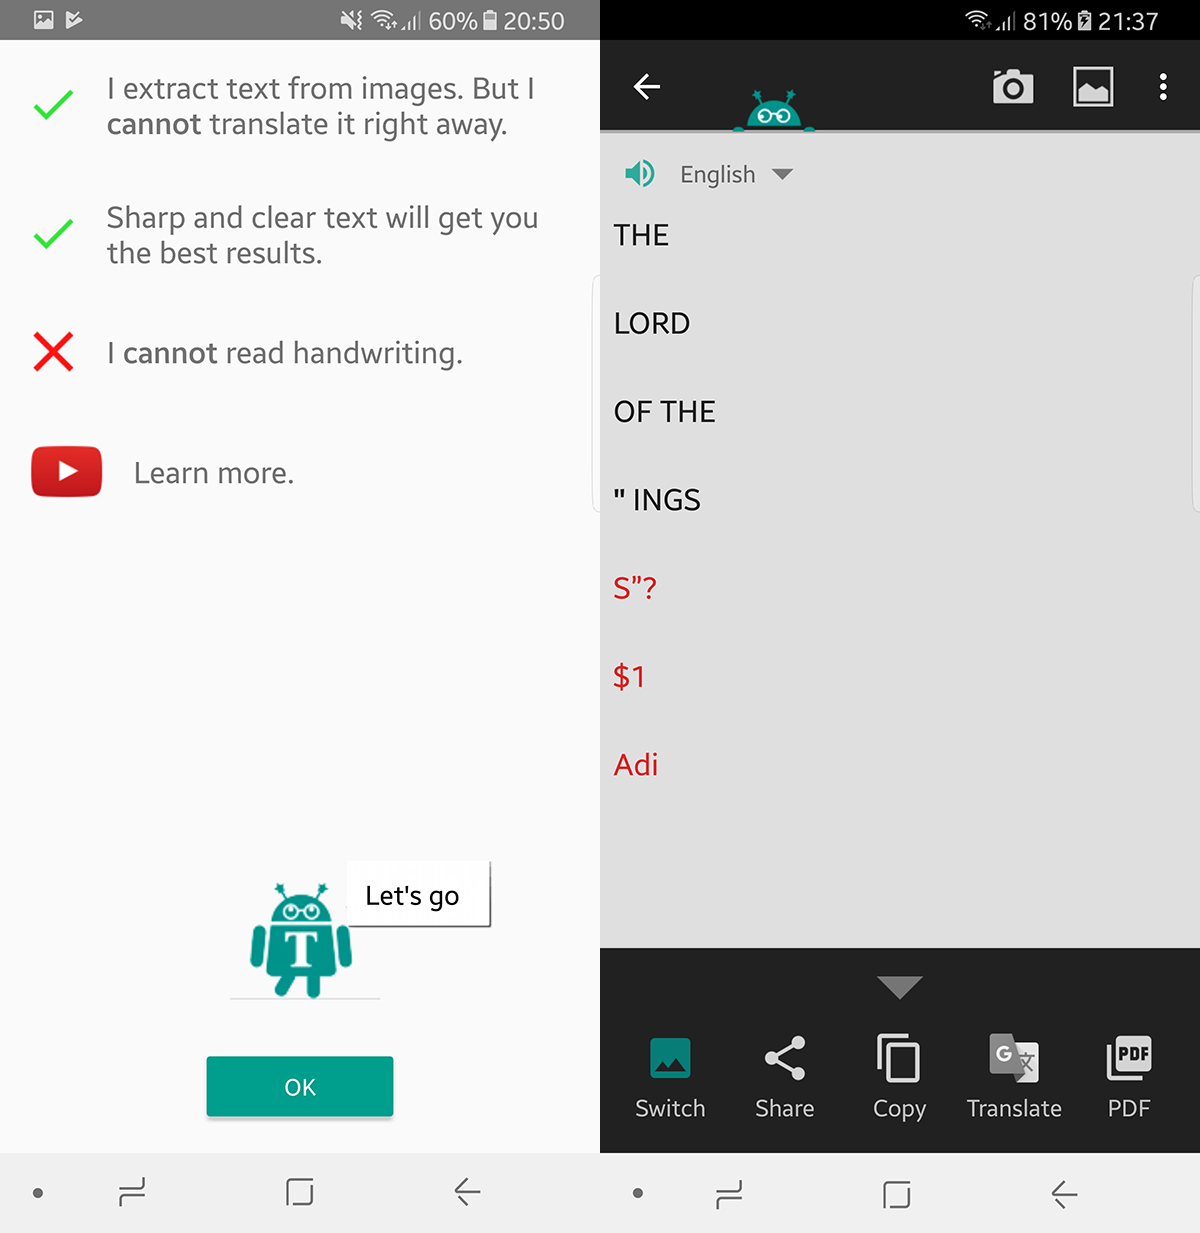
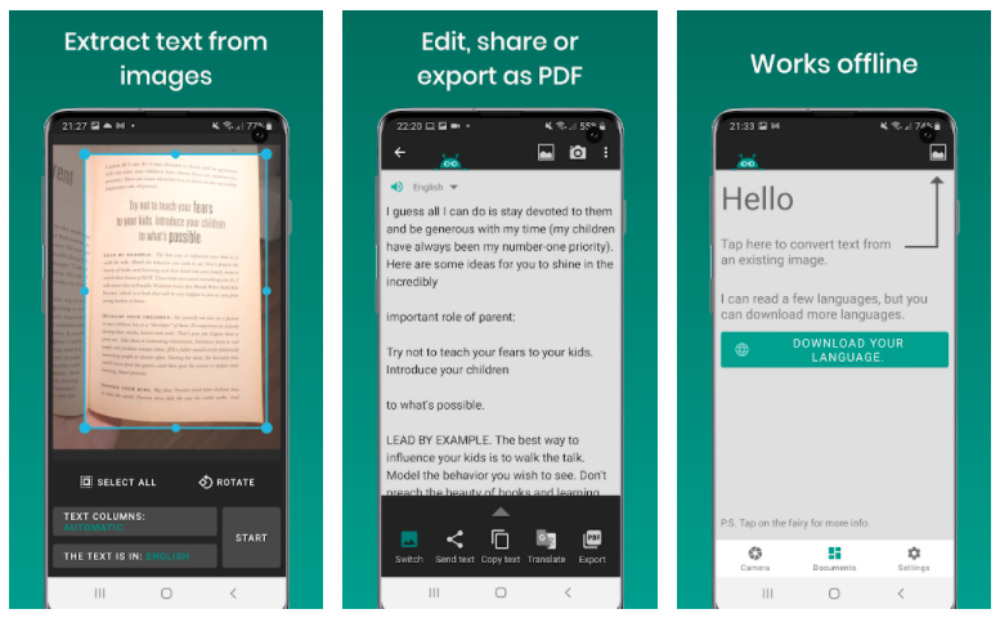
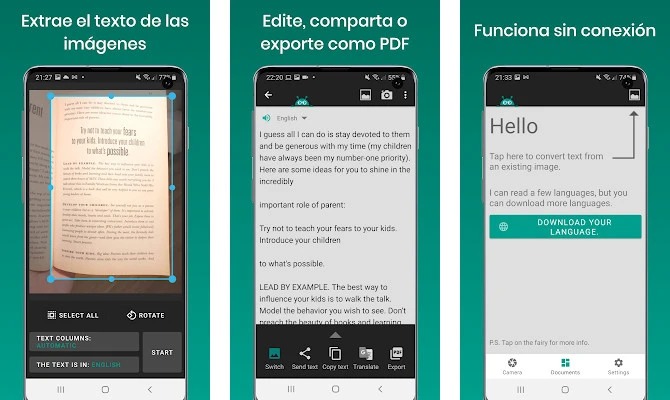
После распознавания Text Fairy хранит материал как документ, который можно открыть ещё раз, поправить, объединить с другими сохранёнными материалами или удалить. Google Play прямо указывает операции edit, join и delete. Отдельно находятся языки и настройки, влияющие на рабочий процесс. На экране итога применяются команды Switch, Share, Copy, Translate и Export/PDF: первая помогает вернуться к исходному изображению для сверки, остальные отвечают за передачу распознанного содержимого.
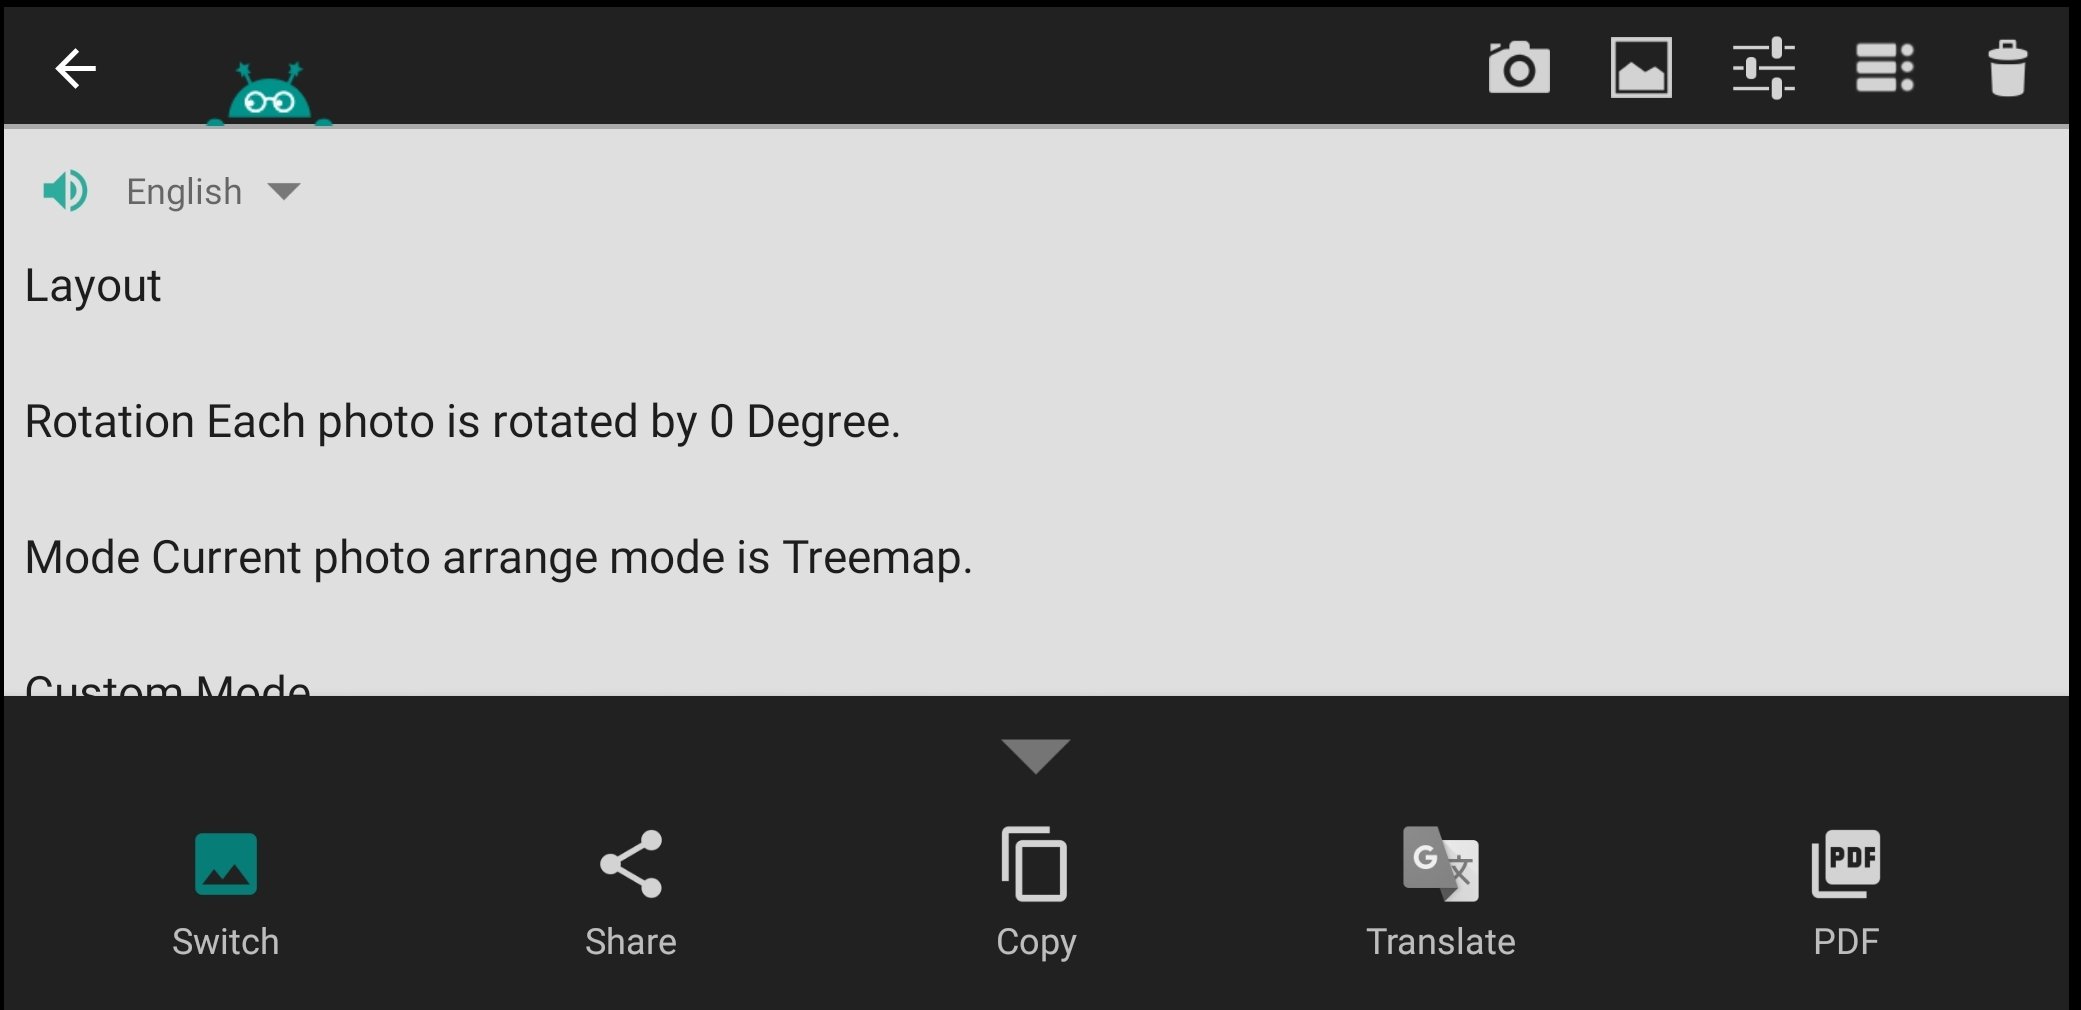
С точки зрения пользователя интерфейс лучше осваивать не по всем пунктам меню сразу, а по контрольным точкам. До запуска OCR необходимо видеть оригинальное изображение, рамку выбранной области, язык и режим колонок. После OCR — сам текст, возможность переключиться на картинку и действия копирования или экспорта. Остальные настройки подключаются только тогда, когда базовый сценарий уже работает.
- Перед OCR: изображение в правильной ориентации, рамка без лишних объектов, выбран язык, понятна структура колонок.
- После OCR: текст читается в правильном порядке, есть доступ к исходному кадру для сверки, критичные цифры проверены.
- Перед экспортом: выбран подходящий метод — Copy для вставки, Share для передачи или PDF для отдельного файла.
- Перед удалением исходника: готовый текст уже сохранён и проверен в конечном приложении.
Как распознать текст с фотографии: полный рабочий цикл
Это главный сценарий Text Fairy. Его лучше выполнять в одном и том же порядке: сперва получить максимально чистый исходник, затем ограничить область, после этого выбрать язык и структуру страницы. Попытка исправлять плохой кадр уже после OCR обычно занимает больше времени, чем переснять страницу или аккуратно изменить рамку.
Снять страницу камерой без лишних ошибок
1. Откройте Text Fairy и нажмите значок камеры. Разрешите доступ к камере, когда Android показывает системное окно разрешения. Не выдавайте другие разрешения заблаговременно: приложению для этой операции необходима именно камера и доступ к выбранным файлам.
2. Положите документ на ровную поверхность и направьте телефон практически перпендикулярно странице. Проверьте четыре угла: они должны попадать в кадр, а строки — оставаться приблизительно параллельными краям экрана. Автоматическая коррекция перспективы помогает, но сильный угол съёмки всё равно снижает качество букв.
3. Уберите тень от телефона и руки. Для глянцевой бумаги переместите источник света в сторону, чтобы на строках не было белых бликов. Для книжного разворота слегка прижмите страницу ближе к корешку, но не перекрывайте текст пальцами.
4. Сфокусируйтесь по центральной части текста и сделайте снимок. Сразу увеличьте его пальцами и посмотрите на мелкие знаки: точки, запятые, цифры, буквы с тонкими штрихами. Если они расплываются, не продолжайте — переснимите страницу. OCR не восстановит контуры, которых нет в исходном кадре.
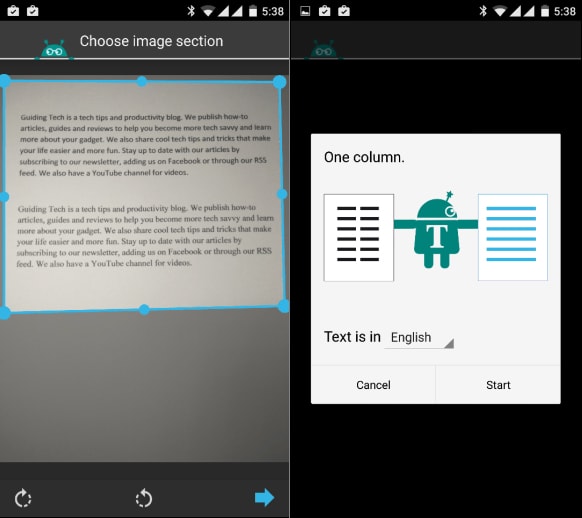
5. Подтвердите удачный снимок. На следующем экране появится область выделения. Потяните маркеры рамки так, чтобы внутрь входил только нужный текст. Чем меньше декоративных элементов, полей, соседних страниц и фоновых объектов останется внутри, тем проще движку определить структуру.
Для общей техники съёмки бумажных документов пригодится инструкция по сканированию документов: принципы света, геометрии кадра и проверки резкости одинаковы для большинства мобильных OCR-приложений.
Распознать текст из скриншота или готовой фотографии
1. На главном экране выберите иконку изображения или галереи. Откройте исходный файл в полном разрешении. Не отправляйте его заранее через мессенджер с сильным сжатием: мелкие шрифты после такого пересохранения получают ореолы и рваные края.
2. На экране Choose image section оставьте в рамке только участок, который необходимо превратить в текст. Для длинной страницы лучше сделать два последовательных OCR-фрагмента, чем пытаться распознать крошечный шрифт со всей страницы сразу. Такой подход в особенности полезен для газетных колонок, таблиц с мелкими примечаниями и экранных снимков интерфейса.
3. Применяйте поворот, когда строки расположены боком. Цель — дать алгоритму обычные горизонтальные строки до распознавания. После поворота повторно проверьте рамку: часть изображения может выйти за границы выделения.
4. Перейдите дальше стрелкой или кнопкой продолжения. На следующем шаге Text Fairy спрашивает о структуре текста и языке. Не запускайте OCR, пока эти параметры не соответствуют изображению.
Для других методов извлечения текста из скриншотов и фотографий можно свериться с практическим руководством по распознаванию текста с картинки. Оно полезно, когда Text Fairy не справляется с конкретным исходником и необходим запасной инструмент.
Выбрать язык, колонки и запустить OCR
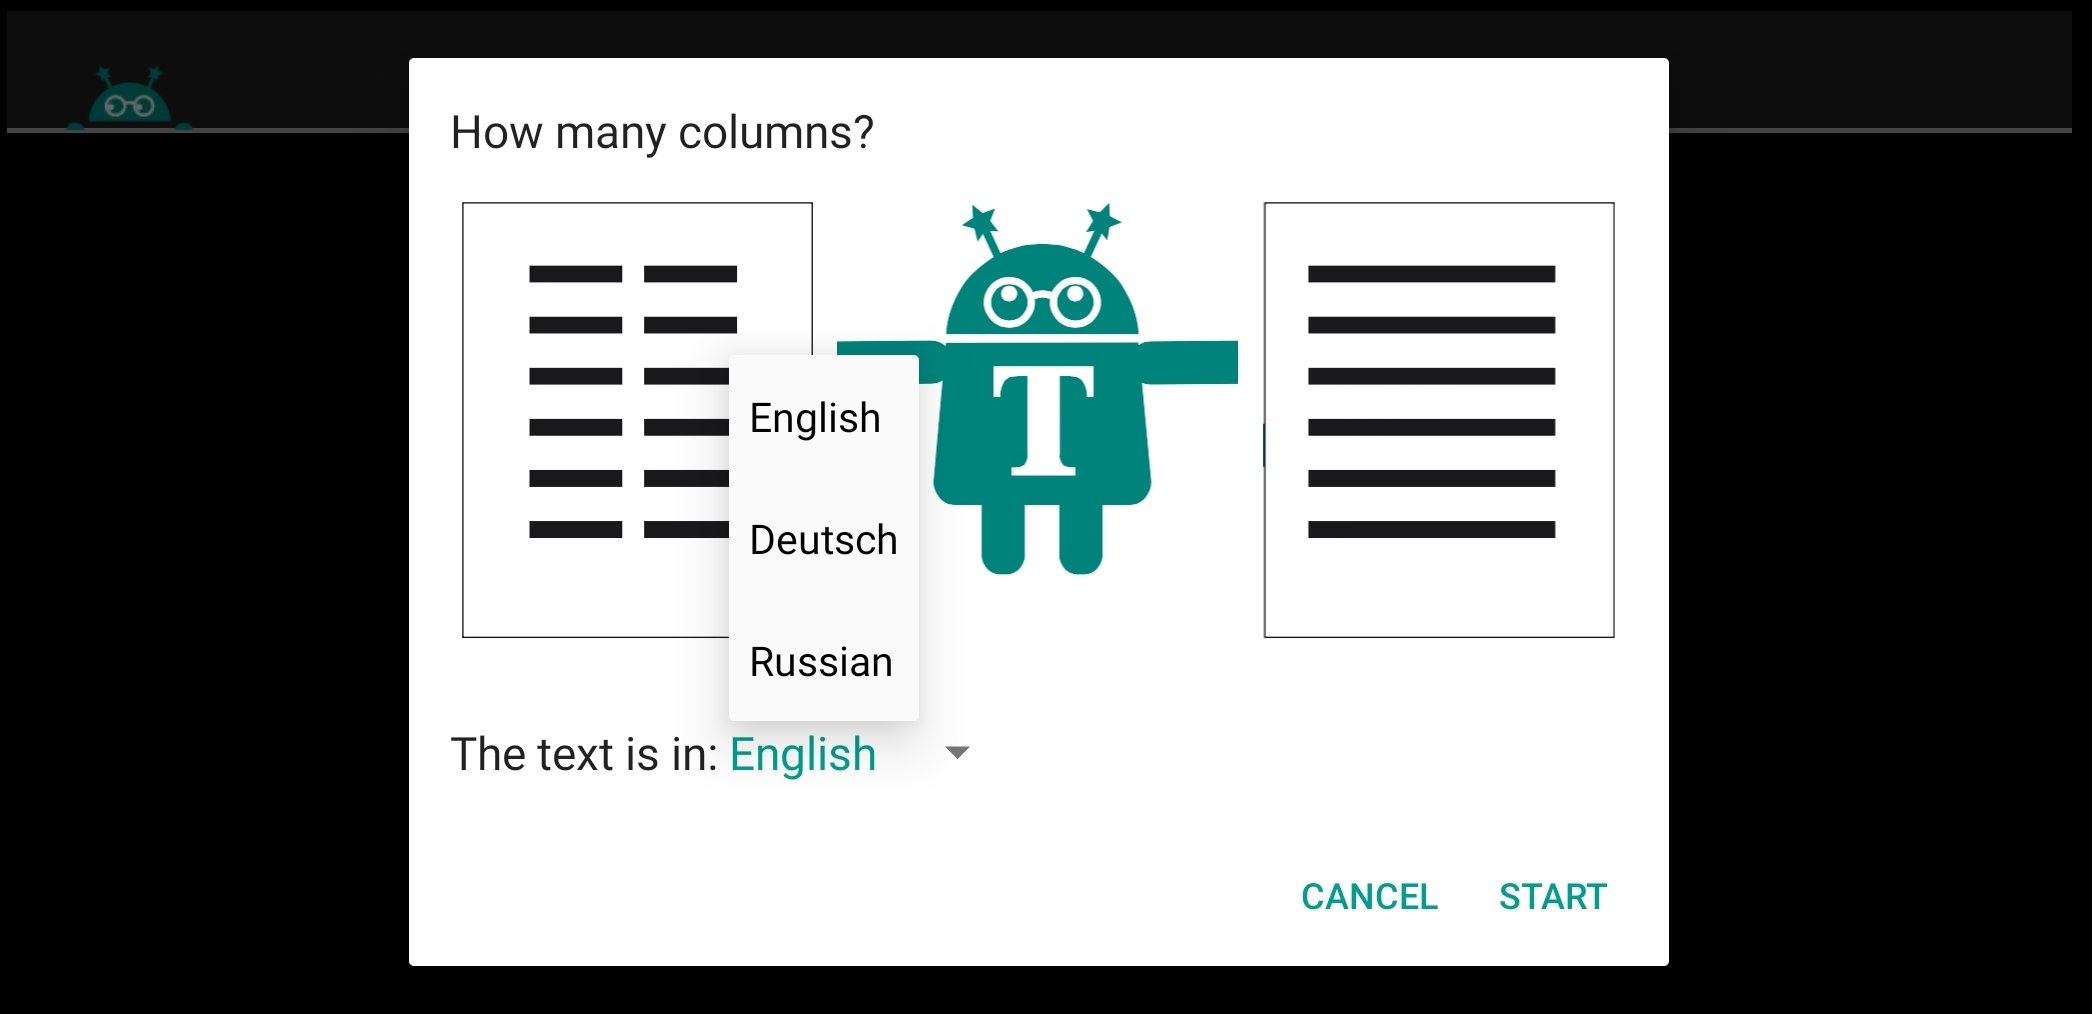
1. В поле языка выберите язык печатного текста. Для русской страницы необходим русский языковой пакет; для английской — английский. Когда в одном документе встречаются два языка, применяйте многоязычный выбор, если он доступен в текущем экране.
2. Укажите структуру страницы. Один столбец подходит для обычного письма, книги или инструкции, где строки идут по всей ширине. Несколько колонок необходимы для газеты, журнала, двухколоночной статьи или макета, где независимые текстовые блоки расположены рядом. Неверный выбор часто даёт текст в неправильном порядке: конец строки из левой колонки соединяется с началом правой.
3. Нажмите Start. Во время распознавания не закрывайте приложение принудительно и не удаляйте оригинальное изображение. На коротком фрагменте итог появляется быстро; сложная страница с большим количеством текста требует больше времени.
4. После окончания не копируйте итог вслепую. Сперва переключитесь между изображением и текстом, отыщите 3–5 контрольных мест: заголовок, строку с цифрами, слово с похожими буквами, знаки препинания и конец абзаца. Если в этих местах много ошибок, вернитесь к исходнику и измените кадр или параметры OCR.
5. Если распознавание успешно, сохраните документ внутри Text Fairy либо сразу переходите к копированию, передаче или PDF. Исходную фотографию стоит оставить до конца проверки — она необходима как эталон при исправлении фамилий, номеров, дат и специальных символов.
Практический пример: необходимо перенести две страницы инструкции с русским текстом и английскими наименованиями кнопок. Снимите каждую страницу отдельно, обрежьте до области текста, выберите русский и английский языки, оставьте один столбец и запустите OCR. На итоге сперва проверьте наименования кнопок на латинице и все числовые значения, затем уберите случайные переводы строк внутри абзацев. После этого скопируйте обе страницы в заметки или документ и только там объедините их в общий текст. Такой сценарий обычно быстрее и надёжнее, чем распознавать сразу разворот или пытаться ручным способом исправить перепутанный порядок строк.
Как проверить, исправить и применять распознанный текст
Итог OCR нельзя считать готовым документом непосредственно после появления на экране. Даже хороший снимок может дать единичные ошибки в похожих символах, переносах и пунктуации. Text Fairy удобен тем, что после распознавания оставляет текст редактируемым и показывает набор действий для дальнейшей работы.
Редактирование и копирование в иное приложение
1. Откройте распознанный документ и включите текстовое представление. Если доступна команда Switch, применяйте её для быстрой сверки с исходным кадром. Сопоставляйте не каждую букву подряд, а критичные данные: фамилии, артикулы, номера договоров, суммы, даты, адреса сайтов, единицы измерения.
2. Коснитесь текста и исправьте явные OCR-ошибки обычной экранной клавиатурой. Особое внимание уделите парам 0/O, 1/l/I, 5/S, 8/B, а также русским и латинским буквам, которые внешне похожи. В смешанном тексте OCR порой подставляет символ из другого алфавита, и визуально ошибка заметна лишь при поиске или проверке орфографии.
3. Проверьте переносы строк. Если исходник был узким столбцом, Text Fairy может сохранить частые переводы строки. Для вставки в письмо или заметки их удобнее убрать, сохранив только реальные абзацы. Для цитаты из книги, наоборот, полезно оставить абзацное деление и лишь соединить строки внутри каждого абзаца.
4. Нажмите Copy, чтобы поместить итог в буфер обмена. Перейдите в заметки, почту, мессенджер, офисный документ или форму и вставьте текст. Непосредственно после вставки проверьте, не потерялись ли абзацы и специальные символы: некоторые приложения по-разному обрабатывают переводы строк и длинные тире.
5. Если текст необходим позднее, сохраните его как документ внутри Text Fairy. Это надёжнее, чем рассчитывать лишь на буфер обмена, который Android может заменить новым содержимым после следующего копирования.
Озвучивание и перевод распознанного текста
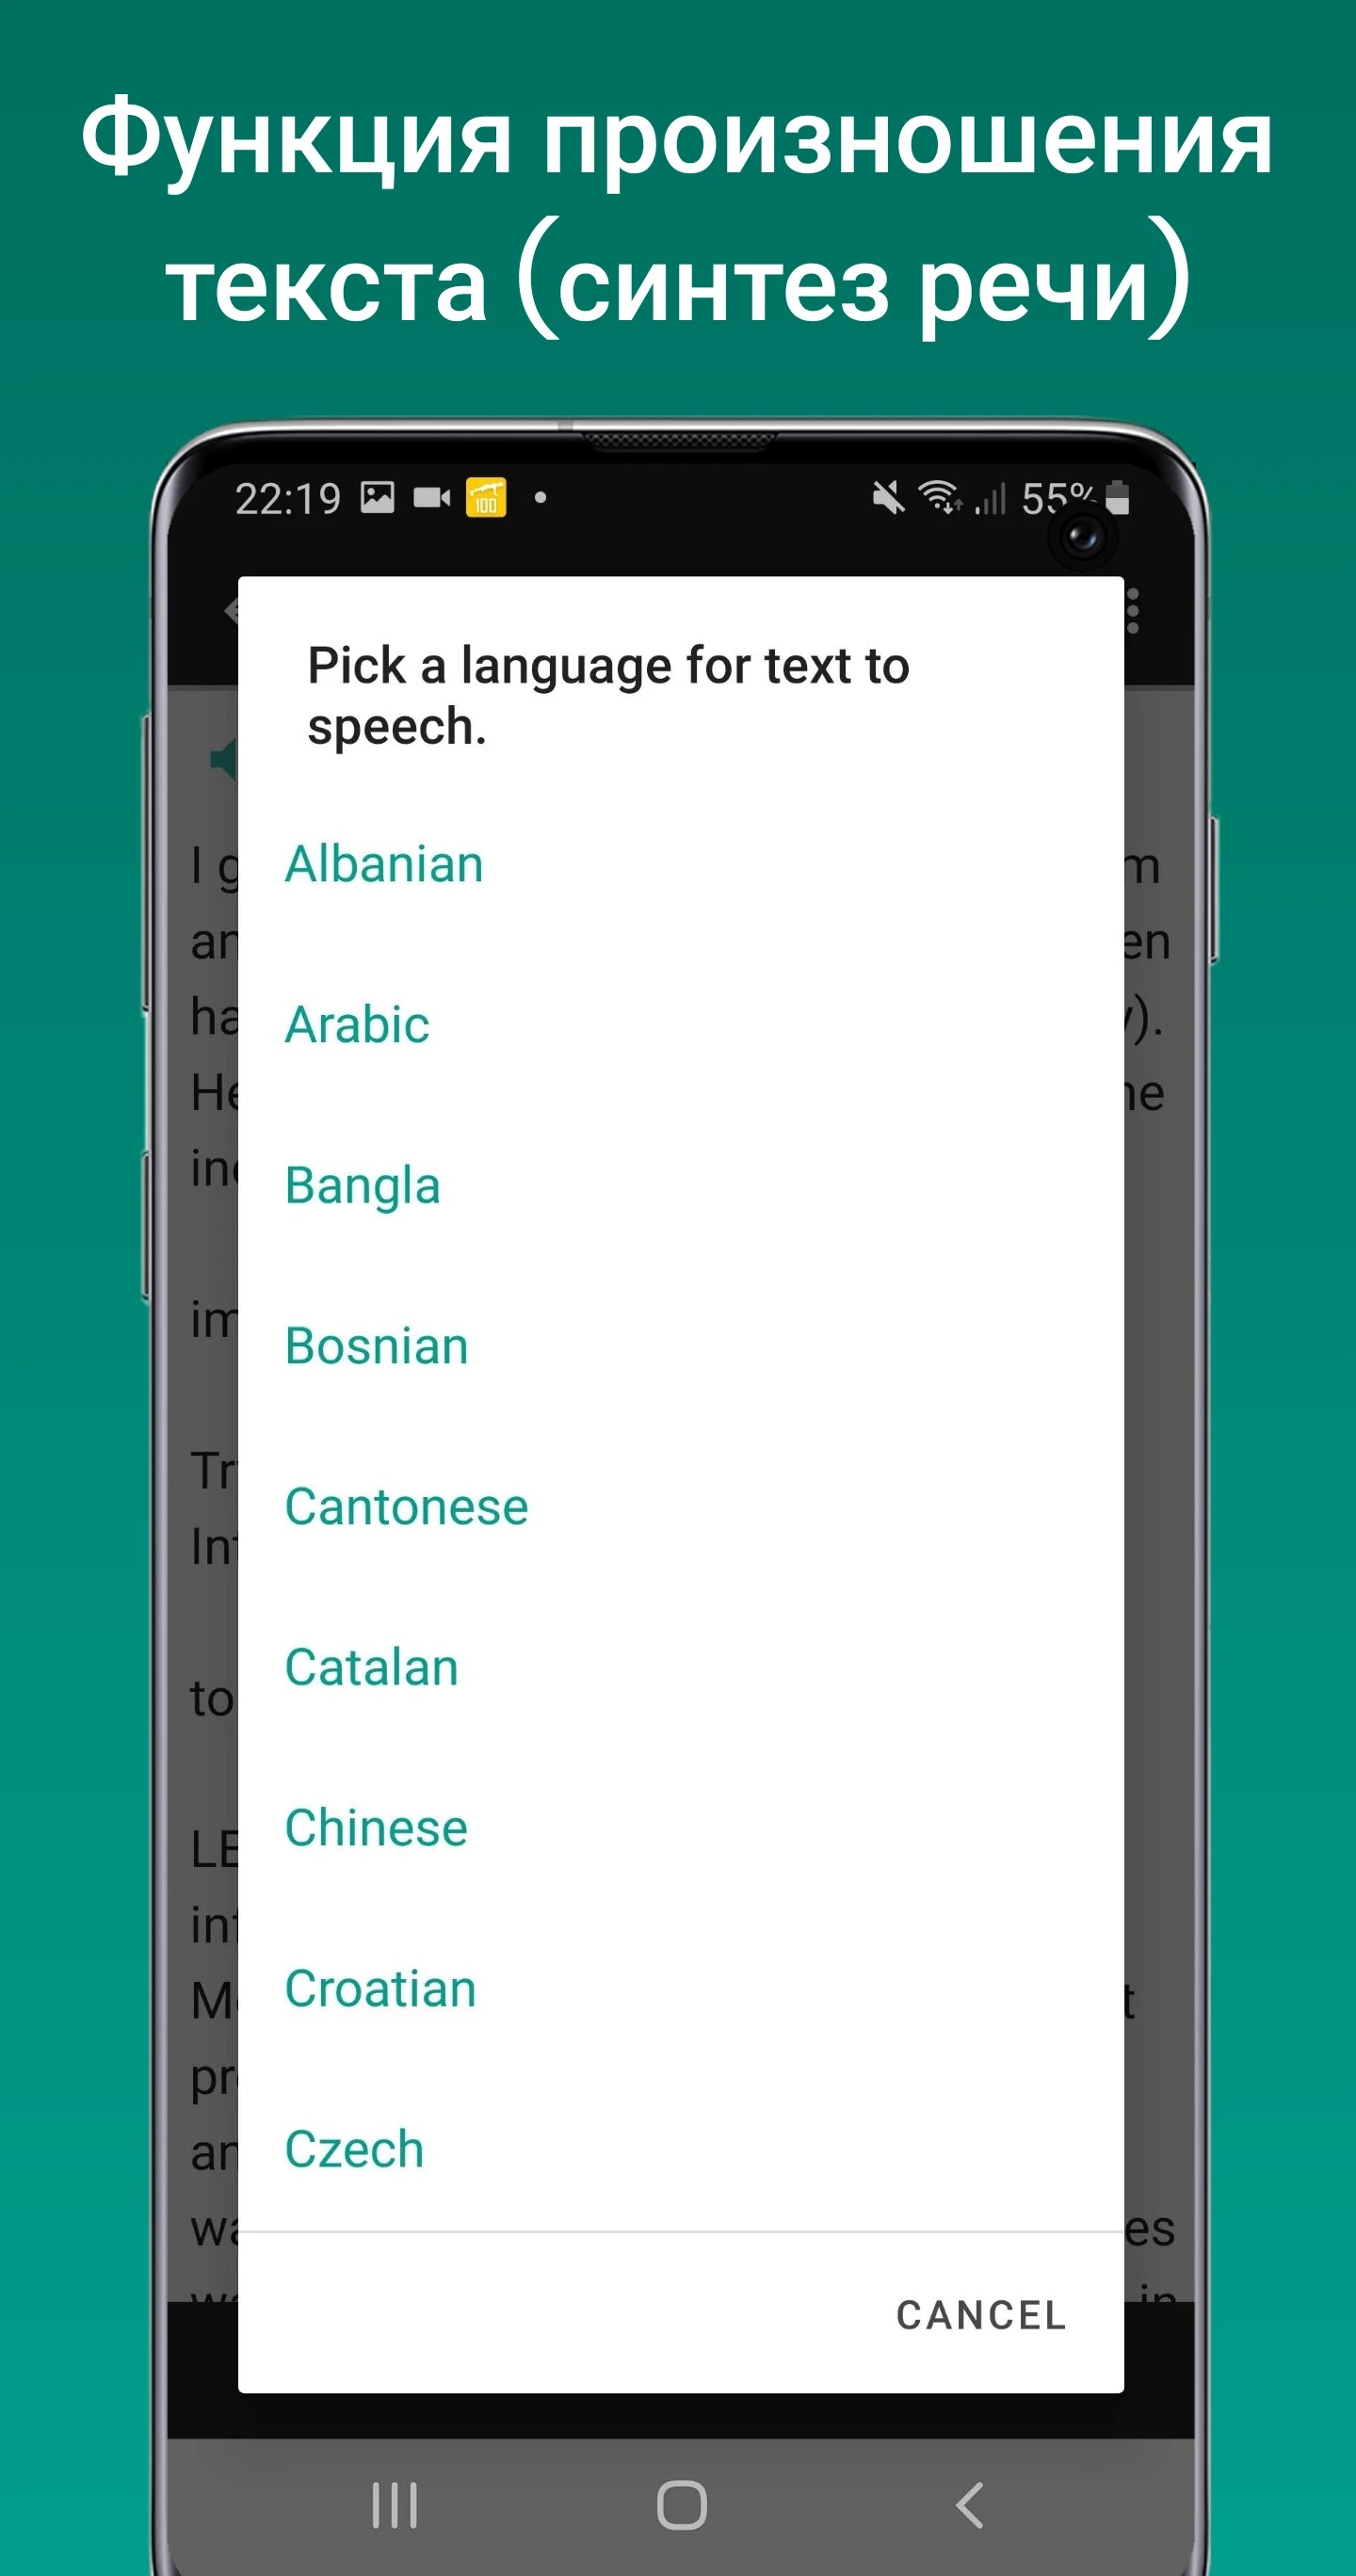
1. Для синтеза речи откройте распознанный текст и выберите функцию чтения вслух. Text Fairy применяет системный механизм text-to-speech, по этой причине доступные голоса и качество произношения зависят от установленных в Android речевых данных.
2. Выберите язык TTS, соответствующий содержимому. Русский текст, озвученный английским голосом, будет читаться неправильно даже при безошибочном OCR. Если нужного голоса нет, установите системные голосовые данные Android и повторите выбор.
3. Прослушайте начало абзаца. Озвучивание полезно не только для чтения: на слух быстро обнаруживаются пропуски слов, лишние символы и странные разрывы предложений. Для длинной страницы это удобный второй метод контроля после визуальной сверки.
4. Команда Translate передаёт распознанный текст в доступный переводчик. Сперва исправьте OCR-ошибки, затем переводите: неправильное исходное слово практически всегда ухудшает и перевод. Для конфиденциальных материалов учитывайте, что перевод уже может требовать сетевого сервиса, даже если само распознавание выполнялось локально.
Экспорт в PDF и отправка итога
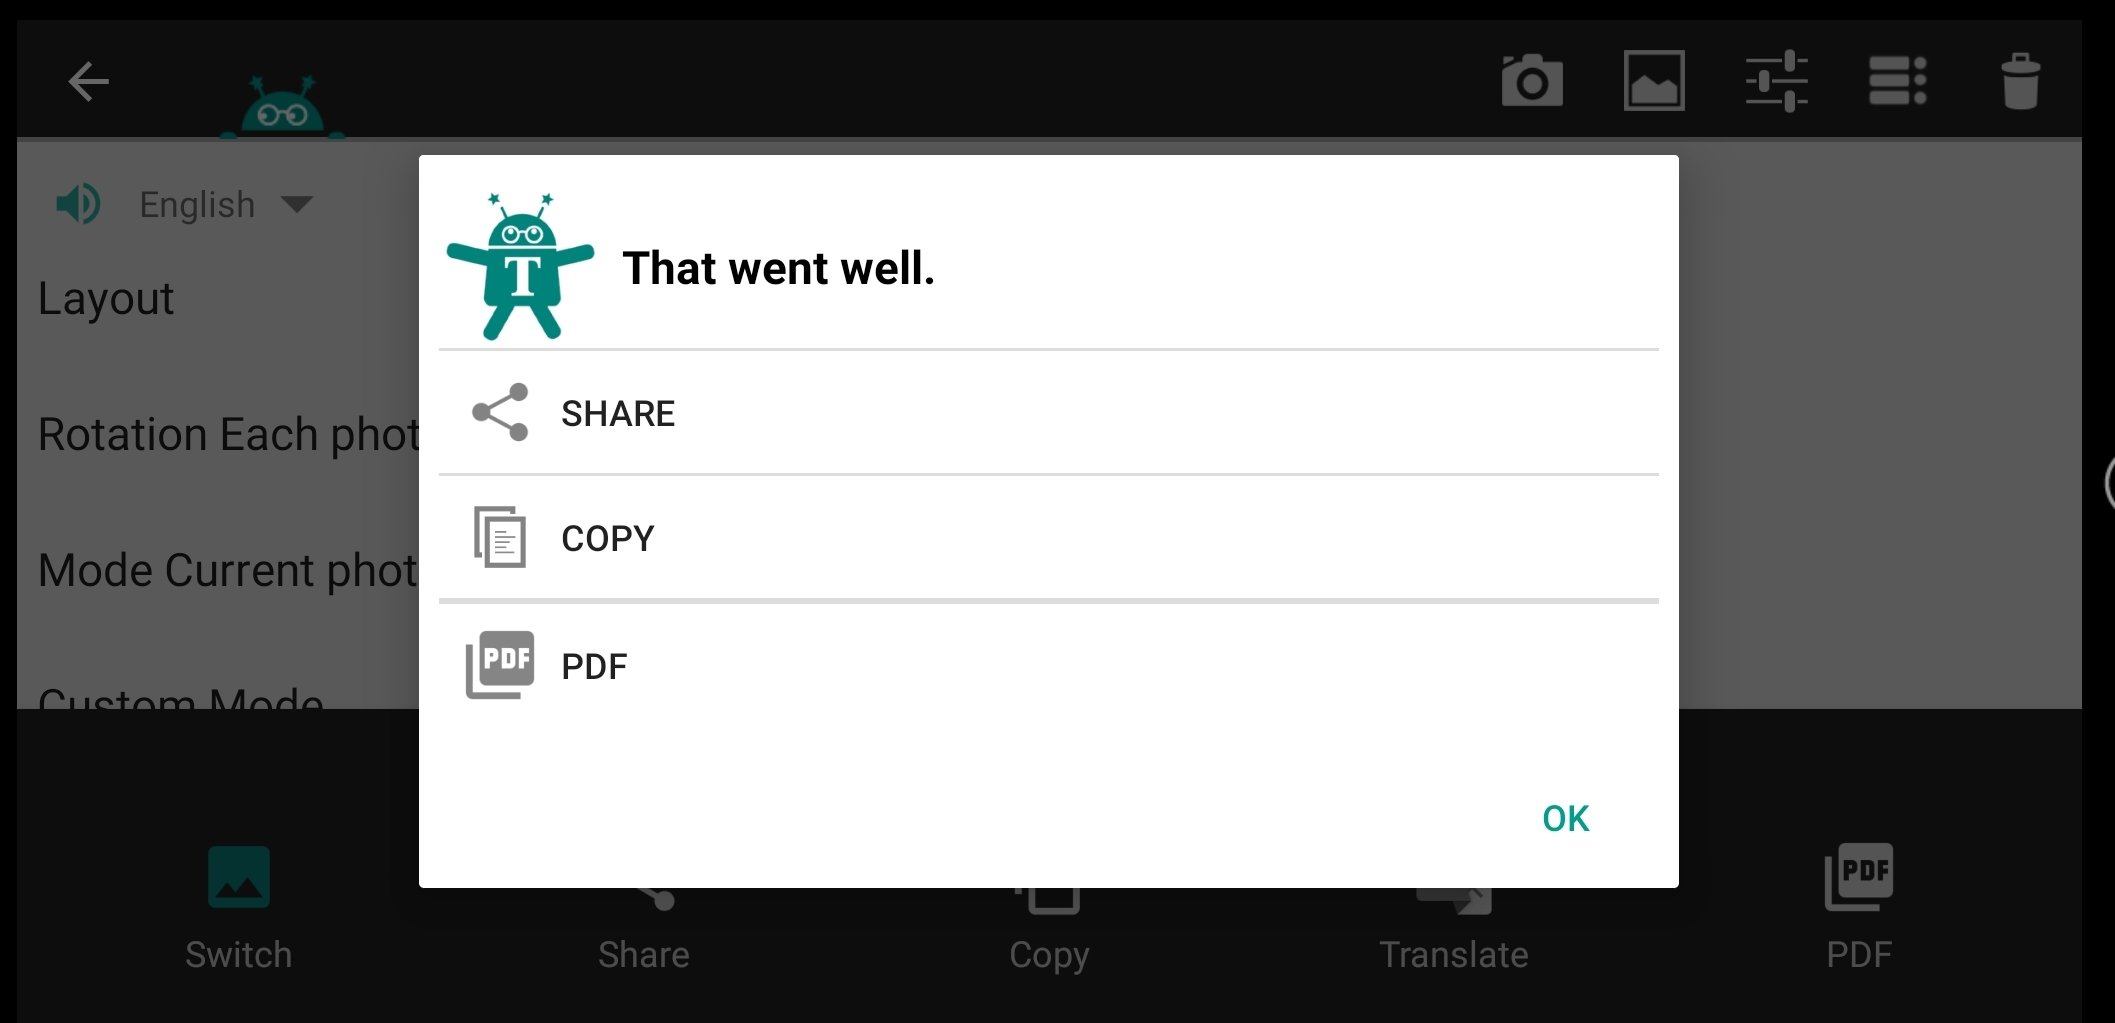
1. После сообщения об успешном распознавании выберите PDF/Export, когда необходим файл, который удобно хранить, отправлять или печатать. Перед этим повторно проверьте порядок страниц и текст, потому что PDF фиксирует итог в форме документа, а исправлять его потом неудобнее, чем в текстовом поле.
2. Если задача — передать только содержание, применяйте Share или Copy. Share вызывает системное меню Android и позволяет выбрать приложение-получатель. Copy лучше, когда необходимо вставить фрагмент в существующий документ и сохранить его оформление средствами иного редактора.
3. Для многостраничного материала сперва убедитесь, что страницы относятся к одному документу и идут в правильной последовательности. Внутреннее управление сканами позволяет редактировать, объединять и удалять сохранённые элементы. После объединения откройте начало, середину и конец, чтобы не пропустить дубликат или перевёрнутую страницу.
Если итог должен быть именно поисковым PDF с полноценной работой по страницам, сопоставьте возможности с инструкцией по распознаванию текста в PDF. Text Fairy удобен как мобильный OCR, но не заменяет редактор, рассчитанный на большие многостраничные документы.
Перед отправкой PDF откройте его в обычном просмотрщике и проверьте три вещи: все ли страницы присутствуют, читается ли текст при обычном масштабе и соответствует ли порядок страниц исходному документу. Для делового материала дополнительно попробуйте выделить или отыскать знакомое слово, когда ожидаете поисковый текстовый слой. Если PDF фактически оказался набором изображений без поиска, это не делает файл бесполезным, но меняет дальнейший сценарий: для поиска и редактирования потребуется отдельный OCR-инструмент.
Как работать с несколькими языками, колонками и серией страниц
Сложные исходники обычно дают ошибки не потому, что OCR «плохой», а потому что ему неверно описали структуру страницы. В Text Fairy есть три полезных механизма: выбор нескольких языков, определение колонок и управление уже распознанными документами. Ими стоит пользоваться до ручной вычитки — они уменьшают объём исправлений.
Многоязычный документ и языковые пакеты
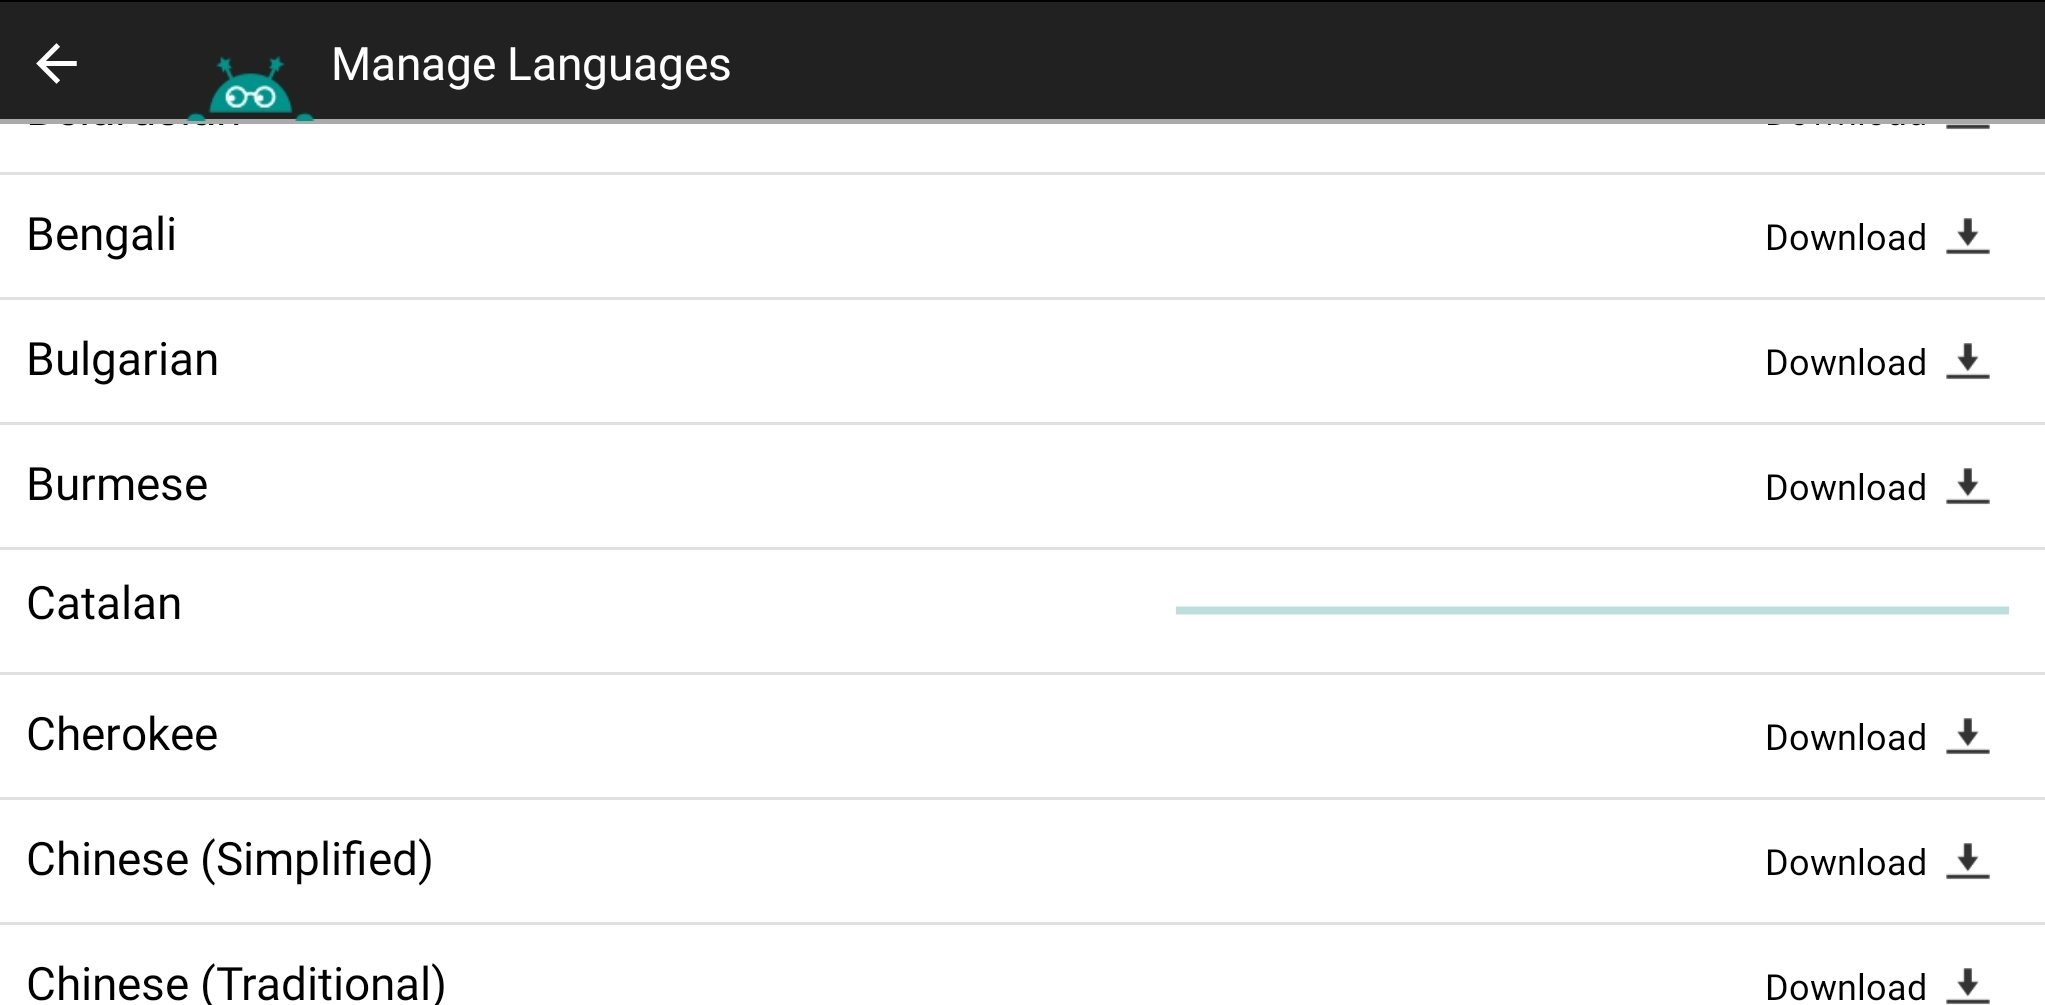
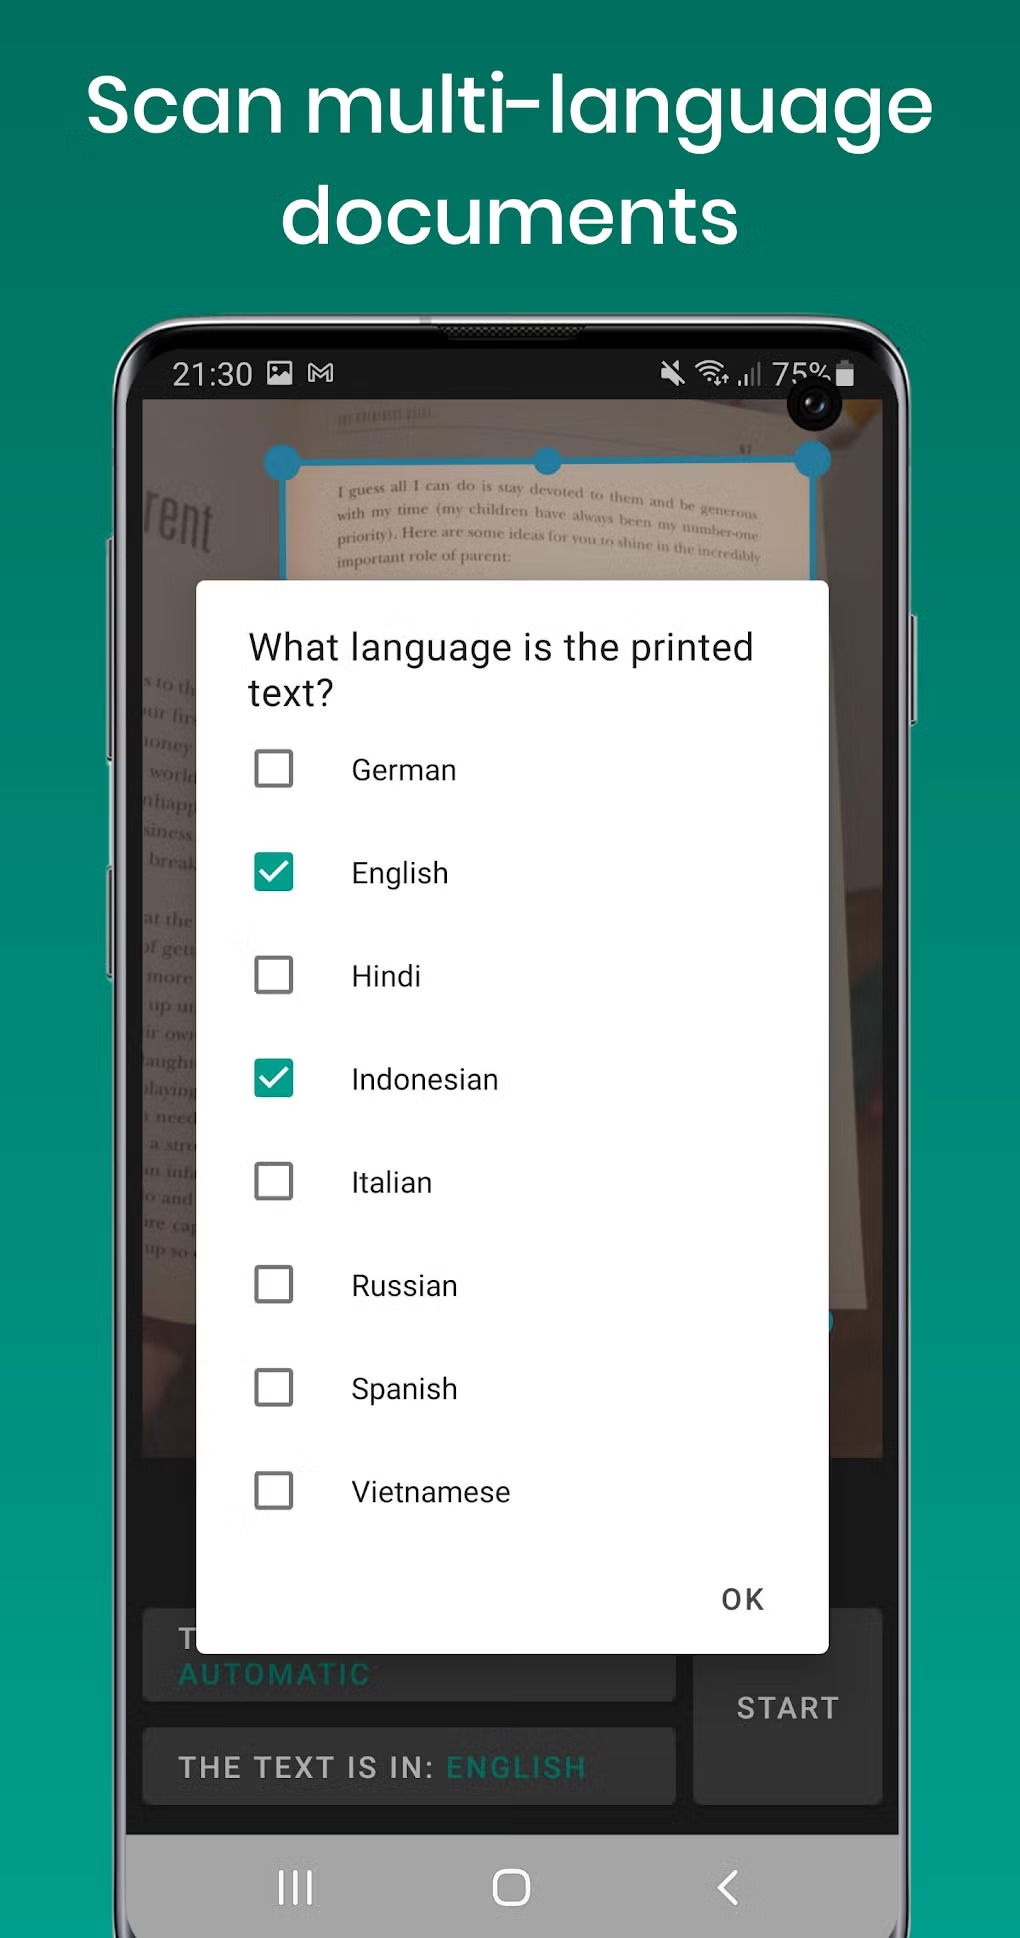
1. Откройте управление языками и заблаговременно загрузите те языки, которые реально встречаются в документе. Это в особенности полезно перед поездкой или работой без связи: языковые данные должны находиться на устройстве до запуска OCR.
2. На шаге распознавания отметьте языки, присутствующие на странице. Не добавляйте десятки языков «на всякий случай»: чем точнее набор, тем легче движку выбирать между похожими символами. Для русско-английской инструкции достаточно русского и английского; для страницы лишь на русском оставьте один язык.
3. После OCR отыщите места переключения алфавита: марки моделей, URL, англоязычные кнопки, латинские аббревиатуры. Именно на границе языков чаще появляются подмены символов. Исправьте их до копирования или перевода.
4. Если отдельный абзац на другом языке распознаётся плохо, сделайте второй проход только по этому фрагменту, выбрав один нужный язык. Потом скопируйте исправленный фрагмент в основной документ. Это быстрее, чем многократно перезапускать OCR всей страницы.
Колонки, журнальные полосы и книжные развороты
1. Для двухколоночной страницы сперва обрежьте поля и посторонние элементы, потом укажите режим нескольких колонок. Если приложение просит порядок чтения, задайте его так же, как человек читает страницу: верх левой колонки, её низ, затем верх правой.
2. Для книжного разворота не захватывайте обе страницы одним кадром, когда корешок создаёт сильную перспективу. Сделайте два снимка — по одному на страницу. Так линии останутся ровнее, а тень у переплёта не будет разрывать буквы.
3. Для журнальной полосы с фотографиями выделяйте только текстовые зоны. Подписи к изображениям, выноски и основной текст лучше распознавать отдельными фрагментами, если они имеют различный размер шрифта и направление. Потом объедините итог ручным способом в нужном порядке.
4. Для длинной серии страниц применяйте понятные имена документов непосредственно после распознавания. К примеру, номер главы и номер страницы. Встроенное управление сканами умеет объединять документы, но правильная нумерация уменьшает риск собрать их в неверной последовательности.
5. После объединения выполните выборочную проверку: первая страница, место соединения каждых двух фрагментов и последняя страница. Ошибка порядка заметнее именно на границах, где конец одного абзаца не соответствует началу следующего.
Для книги или методички удобно работать небольшими сериями. К примеру, распознавать по пять страниц, сразу исправлять повторяющиеся ошибки в терминах и сохранять серию, а потом переходить к следующей. Так вы быстрее замечаете систематическую проблему: неправильный язык, тень у корешка или чрезмерно мелкий масштаб. Обработка всей главы одним длинным циклом скрывает такие ошибки до самого конца и делает повторную съёмку существенно дороже по времени.
Как повысить точность OCR и исправить типичные ошибки
Качество Text Fairy прежде всего зависит от входного изображения. Google Play прямо перечисляет автоматическую очистку, коррекцию точки съёмки и выравнивание строк, но эти инструменты не превращают смазанный кадр в чёткий. По этой причине эффективная стратегия — предотвращать дефект до OCR, а не пытаться исправлять десятки ошибок после него.
Подготовить изображение так, чтобы OCR было проще
1. Применяйте максимальное доступное разрешение камеры и не применяйте цифровой зум. Лучше приблизить телефон физически, сохраняя всю нужную область в кадре. Цифровой зум увеличивает пиксели, но не добавляет деталей в тонких штрихах букв.
2. Снимайте при равномерном освещении. Свет сбоку под острым углом подчёркивает фактуру бумаги и создаёт тени; прямой источник над глянцевой страницей даёт блики. Переместите документ или лампу так, чтобы фон был светлым, а буквы контрастными.
3. Старайтесь держать плоскость камеры параллельно листу. Небольшой наклон программа исправляет, но при сильной перспективе символы на дальнем краю становятся физически меньше и теряют детали. Для плотной книги лучше отдельно снимать каждую страницу.
4. Перед распознаванием обрежьте пустые поля, изображения, номера страниц и декоративные рамки, если они не нужны. OCR получает меньше визуального шума и быстрее определяет, где находятся строки.
5. Выберите точный язык и режим колонок. Эти два параметра так же важны, как резкость. Неправильный язык заставляет движок подбирать символы из чужого алфавита, а неверная структура страницы ломает порядок чтения.
Разобрать сбой по симптомам, а не перезапускать наугад
Текст получается обрывочным. Увеличьте исходник и проверьте резкость. Если контуры букв размыты, переснимите страницу. Если картинка резкая, сократите область до одного абзаца и запустите OCR снова. Улучшение после уменьшения области означает, что оригинальная страница была слишком мелкой для выбранного кадра.
Строки идут в неправильном порядке. Проверьте режим колонок. Для двухколоночной верстки один столбец практически неизбежно смешивает соседние строки. Обрежьте страницу так, чтобы границы колонок были очевидны, и повторите распознавание.
Русские буквы заменяются похожими латинскими. Проверьте выбранные языки. Для чисто русского текста оставьте русский; для смешанного русско-английского — оба. Затем ручным способом проверьте короткие коды, номера моделей и слова с C/С, P/Р, B/В, H/Н, X/Х.
Много ошибок в пунктуации и цифрах. Переснимите страницу при лучшем свете и без JPEG-сжатия. Мелкие точки и запятые теряются ранее крупных букв. Для финансовых и юридических данных всегда сверяйте итог с оригиналом вне зависимости от общей точности OCR.
Приложение не распознаёт рукопись. Это не ошибка настройки: актуальное описание Text Fairy прямо указывает, что рукописный текст не поддерживается. Для рукописных заметок необходим другой класс распознавания, обученный на handwriting recognition.
Нужный язык отсутствует в списке текущего документа. Откройте управление языками, загрузите языковой пакет и вернитесь к распознаванию. После загрузки можно повторить OCR той же области без нового снимка, если оригинальное изображение сохранено.
Полезная диагностика строится от простого к сложному. Сперва убедитесь, что изображение резкое; потом проверьте ориентацию и обрезку; после этого — язык и колонки; только потом оценивайте сам OCR. Такой порядок исключает ситуации, когда пользователь многократно запускает распознавание с тем же плохим исходником и получает практически одинаковые ошибки. Если после корректного кадра, языка и структуры конкретный шрифт всё равно читается плохо, рациональнее перейти к альтернативному OCR, чем бесконечно редактировать один и тот же итог ручным способом.
Почему хороший снимок всё равно распознаётся с ошибками?
Проверьте язык и структуру страницы. Резкость решает только качество символов; неверный язык или режим колонок меняет метод интерпретации текста.
Почему после OCR появляются лишние переводы строк?
Программа старается сохранить структуру исходника. Для вставки в обычный документ соедините строки внутри абзацев ручным способом, оставив только реальные абзацные разрывы.
Можно ли доверять цифрам, датам и реквизитам без проверки?
Нет. Даже единичная ошибка OCR критична для сумм, дат, номеров документов, артикулов и фамилий. Эти поля необходимо сверять с изображением.
Почему страница с двумя колонками читается вперемешку?
Перед запуском выбран неверный режим структуры. Повторите OCR с несколькими колонками либо распознавайте колонки отдельными областями.
Можно ли распознать рукописную записку?
Text Fairy заявлен для печатного текста и не поддерживает рукопись. Для рукописных заметок применяйте специализированный инструмент.
Что делать с конфиденциальным документом?
Само OCR в Text Fairy работает офлайн. Но перевод и отправка итога могут применять сетевые приложения, по этой причине перед передачей проверьте выбранный сервис и его правила обработки данных.
Преимущества, недостатки, альтернативы и практические рекомендации
Text Fairy силён именно как компактный Android-OCR: получить фото или готовую картинку, подготовить область, распознать печатный текст, исправить его и передать дальше. Он не пытается заменить полноценную систему электронного документооборота, редактор сложных PDF или специализированный табличный OCR. Такое позиционирование и определяет его сильные и слабые стороны.
Плюсы
- Работа на Android без обязательной загрузки изображения в облако для самого распознавания.
- Более 110 языков печатного текста в актуальном описании Google Play и возможность многоязычного OCR.
- Коррекция перспективы, очистка изображения, выравнивание строк и определение колонок перед распознаванием.
- Редактируемый итог с быстрыми действиями Copy, Share, Translate и экспортом в PDF.
- Синтез речи удобен для чтения и добавочной проверки длинных фрагментов.
- Управление сохранёнными сканами: редактирование, объединение и удаление документов.
Минусы
- Рукописный текст не поддерживается.
- Качество заметно падает на смазанных снимках, бликах, тенях, очень мелком шрифте и сложной декоративной верстке.
- Многостраничный корпоративный документооборот и пакетная обработка удобнее в настольных OCR-системах.
- Итоги с цифрами, именами и реквизитами требуют ручной сверки — типичное ограничение любого OCR.
- Актуальная карточка Google Play указывает наличие рекламы и покупок внутри приложения.
- Перевод и передача текста в сторонние приложения выходят за рамки локального OCR и могут потребовать интернет-соединение.
Кому подойдёт
- Студентам и преподавателям для цитат из печатных книг, методичек и раздаточных материалов.
- Специалистам, которые получают отдельные бумажные страницы, объявления, инструкции, счета и хотят быстро перенести текст в рабочий документ.
- Пользователям Android, которым важна локальная обработка изображения и не нужен тяжёлый PDF-редактор.
- Тем, кому необходим простой цикл фото → OCR → правка → копирование/озвучивание/PDF.
Альтернативы выбираются по задаче, а не по одной шкале. Google Lens удобен для мгновенного копирования и перевода текста с камеры, но это не архив документов. Adobe Scan и CamScanner больше ориентированы на мобильное сканирование и многостраничные PDF. ABBYY FineReader PDF и другие настольные OCR-программы подходят, когда важны сложная верстка, таблицы, пакетная обработка и офисный экспорт. Для локального десктопного распознавания можно тоже посмотреть Text-R для PDF и изображений.
Практический выбор простой. Для одного печатного фрагмента на Android начинайте с Text Fairy и тратьте время в первую очередь на хороший исходный кадр. Для длинного документа снимайте страницы отдельно, сразу задавайте ясный порядок и проверяйте места склейки. Для PDF на десятки страниц переходите к инструменту, где OCR встроен в работу со страницами. А если вы только разбираетесь в формате, поможет руководство по PDF.
Итоговая проверка любого OCR должна быть содержательной: прочитайте заголовок и первый абзац, отыщите все числа и собственные имена, сопоставьте переносы и порядок колонок, потом вставьте текст в конечное приложение и повторно проверьте итог уже в том виде, в котором он будет применяться. Такой контроль занимает минуты, но защищает от ошибок, которые автоматическое распознавание визуально маскирует очень убедительно.