
Transym TOCR — настольный OCR-инструмент и движок для Windows, рассчитанный на распознавание печатного текста в сканах, BMP, TIFF и PDF. На Xeon Live можно скачать Transym TOCR бесплатно, а ниже разобран полный рабочий цикл: от загрузки страницы и подготовки изображения до настройки точности, пакетной обработки и проверки итога.
Первый рабочий цикл: загрузка документа, интерфейс и распознавание
Viewer построен как двухпанельное рабочее окно. Слева находится оригинальная страница, справа — редактируемый итог OCR. Между панелями расположен разделитель, а сверху доступны меню File, Image, View, Options и Help, панель быстрых команд и отдельные регуляторы масштаба для изображения и итога. Такая компоновка ориентирована не на сложную верстку, а на последовательную сверку: оператор видит строку на скане и сразу правит распознанный текст рядом.
Карта интерфейса и пошаговое распознавание одной страницы
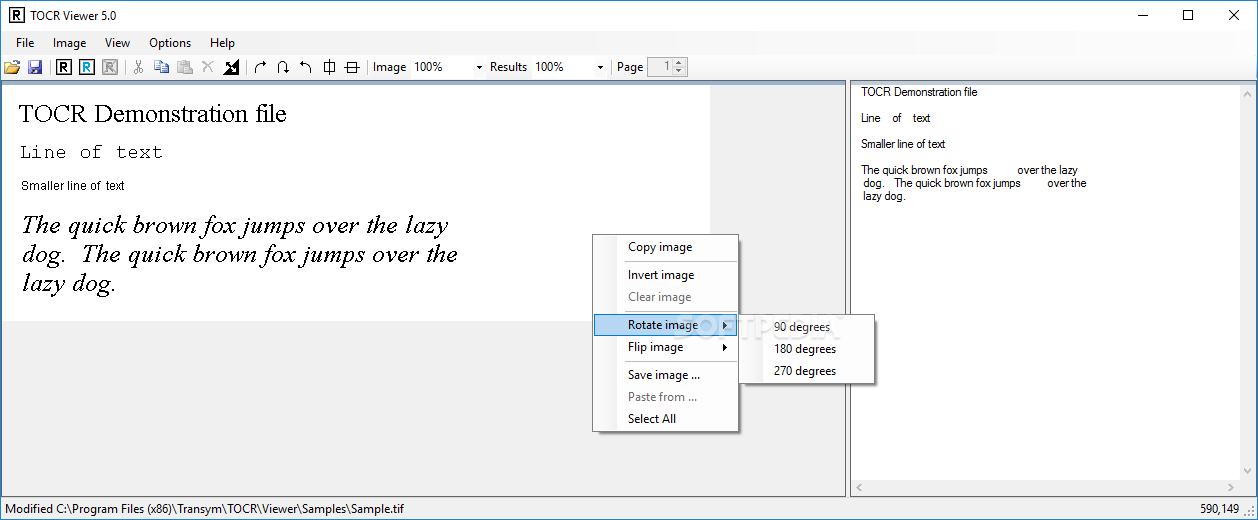
Для первого запуска берите короткий и типичный документ: одну страницу с тем же шрифтом, контрастом и качеством, что и основная партия. Такой контрольный лист показывает реальные ошибки до пакетной обработки. В открытом Viewer сперва проверьте пустое поле итога справа, текущий масштаб и номер страницы. После этого выполняйте операции в одном порядке и не меняйте несколько параметров одновременно: так видно, какое именно действие улучшило или ухудшило распознавание.
- Откройте файл. В меню File выберите Open...; для этой команды в исходном проекте Viewer назначено Ctrl+O. Поддерживаемый набор для движка 5.1 включает PDF, BMP и TIFF. После загрузки страница появляется в левой панели, а строка состояния и счётчик страниц помогают контролировать многостраничный контейнер.
- Для прямого сканирования применяйте Acquire images... Команда File → Acquire images... обращается к TWAIN. В среде с проблемным драйвером надёжнее сперва получить изображение штатным ПО сканера и потом открыть готовый файл в Viewer: OCR в обоих случаях работает уже с растровой страницей.
- Выберите нужную страницу. В многостраничном файле счётчик Page переключает кадры. Перед OCR сопоставьте номер в Viewer с фактическим содержимым листа, в особенности у документов с обложкой, титульным листом или ненумерованными вставками.
- Исправьте ориентацию и геометрию. Контекстное меню изображения содержит Rotate image с вариантами 90, 180 и 270 градусов, Flip image, Invert image, Clear image, Copy image и Select All. Поворот выполняйте до OCR: перевёрнутый или боковой текст создаёт систематические ошибки во всей странице.
- Запустите OCR Image. Этот режим обрабатывает текущий кадр целиком. Во время задачи команда Stop OCR останавливает обработку. После окончания итог появляется справа; при нулевом числе найденных символов Viewer сообщает, что символы не идентифицированы.
- Проверьте текст рядом с оригиналом. Увеличьте изображение и поле итога независимо. Сперва сверяйте коды, даты, фамилии, суммы, артикулы и другие поля, где одна ошибка меняет смысл. Затем просматривайте обычные абзацы и разрывы строк.
- Исправьте найденные ошибки прямо в правой панели. Поле итога допускает обычное редактирование, вырезание, копирование и удаление выбранного текста. После ручной правки сохраните итог до перехода на другую страницу: Viewer отслеживает изменения текста и предупреждает о несохранённых правках.
- Сохраните итог. File → Save results... записывает распознанный материал. Форматирование настраивается отдельно, по этой причине сперва добейтесь корректного текста, а уже затем выбирайте текстовый или форматированный вариант вывода.
При обработке только части страницы применяется OCR Selection. В Viewer это рабочий сценарий с выделенным фрагментом изображения, однако сам OCR API Transym не предоставляет встроенный зональный режим. Для интеграций разработчик распознаёт всю страницу и фильтрует символы по координатам либо копирует нужные зоны на отдельное чистое изображение. В Viewer выделение удобно для разовой проверки колонки, подписи или поля формы; для большого числа одинаковых зон рациональнее автоматизировать подготовку изображений в вызывающем приложении.
PDF в TOCR 5.1 проходит через растеризацию страниц: из страницы извлекается bitmap/DIB, и движок распознаёт картинку. По этой причине увеличение масштаба в окне не добавляет информации к плохо отсканированному оригиналу. Сжатый скан с размытыми буквами остаётся сжатым сканом. Для документов, где текстовый слой уже существует и правильно копируется, повторный OCR не даёт практической пользы; сперва проверьте выделение и поиск текста в обычном PDF-просмотрщике.
Для понимания формата PDF и различия между изображением страницы и текстовым слоем полезен разбор формата PDF. В Transym TOCR итог распознавания и само изображение остаются различными сущностями: Viewer показывает их рядом, а версия 5.1 умеет сохранять OCR-результат как приложение к PDF, чтобы текст внутри изображений участвовал в поиске.
Форматы исходных изображений ограничены набором, который документирован для движка: PDF, BMP и TIFF. JPEG, PNG и другие графические форматы перед OCR требуется преобразовать во входной формат. Это важное отличие Viewer от универсальных конвертеров: его сильная сторона — сам OCR и контроль параметров, а не широкая медиаподдержка. Для единичного скриншота преобразование выполняется заблаговременно; для потока документов конвертацию лучше встроить перед вызовом TOCR.
После первой страницы зафиксируйте контрольный итог: сохраните исходный файл, выходной текст и короткую запись о выбранных настройках. Затем возьмите вторую страницу другого качества и повторите тот же порядок. Стабильный профиль определяется не по одной удачной странице, а по нескольким типичным примерам. Такой подход в особенности полезен перед Batch: пакетный режим берёт Processing options из основной интерактивной формы, по этой причине ошибочная настройка быстро размножается на всю партию.
Как повысить точность: DPI, цвет, допустимые символы и скорость
У TOCR итог сильнее всего зависит от качества входного растра и настроек обработки. Плохой фон, слабые или разорванные штрихи, слишком жирные буквы, слипшиеся символы и текст поверх изображения относятся к типичным причинам ошибок. Настройку удобнее вести от изображения к движку: сперва ориентация и DPI, затем преобразование цвета, после этого набор допустимых символов и лишь в конце баланс скорости.
Пошаговая настройка качества на контрольной странице

Начинайте с разрешения, потому что неверный DPI влияет не только на вид масштаба, но и на интерпретацию размеров символов. В меню Image откройте Adjust DPI. Диалог содержит отдельные поля X DPI и Y DPI. В исходном коде форма предназначена именно для изменения dots per inch изображения; после подтверждения Viewer меняет разрешение текущего bitmap и помечает страницу как изменённую.
- Проверьте X DPI и Y DPI. Для обычного скана значения по двум осям должны описывать реальное разрешение источника. Не повышайте число только ради «качества»: команда меняет метаданные DPI, а не дорисовывает утраченные детали. Размытая буква не становится резкой от записи большего значения.
- Сопоставьте размеры букв с реальным документом. При явно ошибочных метаданных скорректируйте обе оси согласованно и повторите OCR на той же странице. Сохраняйте исходник отдельно, чтобы всегда можно было вернуться к нему.
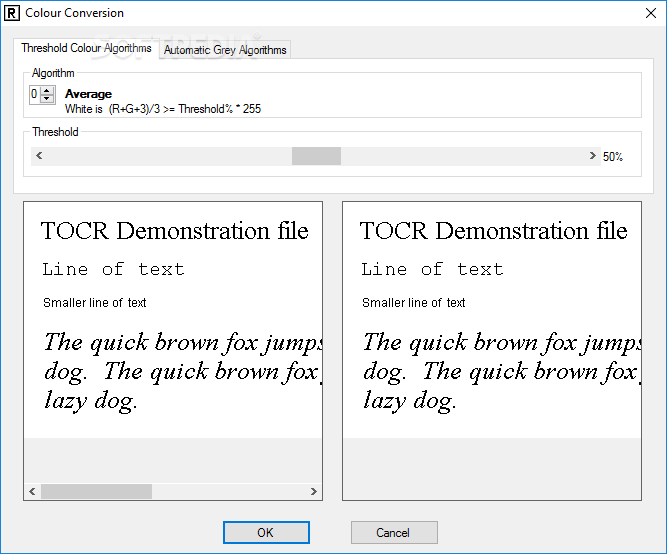
- Откройте Colour Conversion. Движок принимает цветные и серые изображения, но перед OCR преобразует их в чёрно-белое представление. В интерфейсе есть Threshold Colour Algorithms и автоматические алгоритмы для серого; в документации заявлено девять алгоритмов преобразования цвета.
- Настройте порог на проблемном фрагменте. Цель — получить тёмные цельные штрихи букв на чистом фоне без слияния соседних символов. Слишком низкий порог рвёт тонкие элементы; слишком высокий затягивает в текст фон, печати и тени. Меняйте один параметр, всякий раз сравнивая одну и ту же строку.
- Проверьте обработанное изображение. Кнопка Show Processed image показывает bitmap, который фактически прошёл подготовку к OCR. Это более надёжная диагностика, чем оценка исходного цветного скана: именно обработанный чёрно-белый кадр получает движок.
- Откройте Options → Processing options... Тут задаются параметры распознавания, включая наборы допустимых символов и режим скорости. Для полей, состоящих только из цифр, разумно отключить лишние группы символов; для обычного текста сохраните все реально встречающиеся буквы и знаки.
- Выберите скорость. В интерфейсе Viewer четыре уровня: Slow, Medium, Fast и Express. В структуре API им соответствуют значения 0, 1, 2 и 3. Чем выше режим, тем быстрее обработка и тем заметнее риск небольшой потери точности; выбор фиксируйте по контрольной выборке, а не по субъективному ощущению.
- Повторите OCR и сопоставьте критичные поля. Считайте не только визуально заметные ошибки. Отдельно сверяйте 0/O, 1/I/l, 2/Z, знаки пунктуации, десятичные разделители, дефисы и символы валют. Для договоров и бухгалтерских форм ошибка в одном знаке важнее нескольких лишних пробелов.
- Зафиксируйте лучший профиль. После выбора порога, DPI, глифов и скорости обработайте ещё несколько страниц. Профиль принимается лишь после стабильного итога на различных экземплярах одного типа документа.
Lex в TOCR 5.1 работает автоматически. В актуальных константах API оставлен режим TOCRJOBLEXMODE_AUTO; прежние принудительные варианты On и Off помечены как удалённые для версии 5. Это означает, что в современных 5.x не стоит строить инструкцию вокруг ручного переключателя словаря. Для задач с кодами и короткими полями больший эффект даёт точный набор допустимых глифов и качественный входной растр.
Поддержка языков устроена необычно: перед распознаванием не требуется выбирать язык. В списке Transym присутствуют европейские языки, а также русский, украинский и ряд других алфавитов; движок позиционируется как языково-независимый и автоматически применяет лексическую коррекцию там, где она применима. Практический вывод прост: для смешанного документа не ищите в Viewer список Language. Контролируйте именно доступные символы и качество изображения.
Исторические измерения Transym для старых сборок показывают направление компромисса, а не текущую гарантию производительности: более быстрые режимы уменьшали время обработки с небольшой потерей оценки точности, а 64-битная сборка 4.0 была заметно быстрее 32-битной в тестовом наборе. Эти цифры нельзя переносить на современный ПК как прогноз. Правильный метод — измерить собственную партию: одинаковые страницы, одинаковый профиль и четыре режима Speed, потом сопоставить время и количество исправлений.
На слабом фоне порядок коррекции должен оставаться консервативным. Сперва новый скан или более качественный исходник, затем преобразование цвета. Агрессивные фильтры не восстанавливают штрихи, которых нет в растре. Страница с бликом, пересветом или сильным JPEG-размытием требует пересканирования до OCR. Для фотографий документов полезен отдельный этап выравнивания перспективы и преобразования в BMP/TIFF до загрузки в Viewer.
Полосы от стекла сканера и линии форм создают систематические ошибки. Вертикальную полосу лучше убрать на этапе сканирования или препроцессинга, поскольку она пересекает десятки строк. Подчёркивания и рамки, слипшиеся с нижними штрихами букв, проверяются на обработанном изображении. В Processing options доступны параметры, связанные с удалением линий и шумом; изменяйте их на копии контрольной страницы и сверяйте текст после каждого шага.
Для отдельной картинки или скриншота полезно вдобавок свериться с инструкцией по извлечению текста из изображения: там важны те же базовые принципы — достаточное разрешение, ровная ориентация, контраст и проверка итога. Transym TOCR отличается тем, что даёт низкоуровневый контроль OCR и рассчитан на Windows-интеграцию, а не на универсальный захват с любого устройства.
Установка и совместимость тоже влияют на рабочий процесс. В текущем FAQ Transym для TOCR 4.0/5.1 перечислены Windows 10, 8.1, 8, 7, Vista и серверные Windows до Server 2019; Windows 11 в опубликованный список не входит. Для версии 5.1 доступны 32- и 64-битные варианты. При встраивании выбирайте разрядность, соответствующую вызывающему процессу и библиотекам, а прямое сканирование отдельно проверяйте с конкретным TWAIN/WIA-драйвером.
Пакетная обработка, формат итога и автоматизация
После того как одна страница стабильно распознаётся, переходите к Batch. В исходном проекте Viewer пакетная форма работает в двух состояниях: сперва задаются параметры задания, затем показывается ход обработки. Параметры OCR берутся из основной интерактивной формы, по этой причине Batch не заменяет настройку контрольной страницы — он повторяет уже выбранный профиль на серии файлов или сканов.
Пошаговый Batch: вход, страницы, выходные файлы и журнал
Пакетное задание открывается через File → Batch. Форма содержит группы Input Files, Multi Page Input, Output, Output File, Output Folder, Separator и Log File. Такой состав полезен для производственного OCR: вход, диапазон страниц, правила именования и журнал задаются до старта, а затем отдельная панель показывает текущий файл и счётчики успешных и неудачных итогов.
- Выберите источник. В Input Files доступны Files и Acquire. Files обрабатывает файлы с диска; Acquire получает изображения через TWAIN. Для TWAIN есть Select и флажок Show Device, который показывает интерфейс устройства во время получения.
- Укажите входные файлы. Кнопка с многоточием рядом с Files формирует список источников. Перед большим запуском создайте небольшой набор из двух-трёх файлов различного объёма: один одностраничный, один многостраничный и один типичный проблемный.
- Настройте страницы. В Multi Page Input выберите All Pages либо Some Pages. Поле Page принимает список страниц и диапазонов через запятую; подсказка интерфейса указывает специальный символ L для последней страницы. Сперва проверьте нумерацию на реальном контейнере.
- Задайте схему вывода. Форма поддерживает Output Per Input Page, Output Per Input File и All Output In One. Первый вариант удобен для независимых страниц, второй сохраняет связь с исходным контейнером, третий собирает итоги партии в один выходной файл.
- Настройте расширение. Batch умеет добавлять расширение к имени или заменять исходное. Не смешивайте режимы в одной рабочей папке: единое правило имён облегчает контроль повторных запусков и последующую загрузку итогов.
- Выберите папку вывода. Итоги записывайте отдельно от исходников. Флажок Overwrite Existing включайте лишь в воспроизводимом конвейере, где исходный итог уже сохранён в другом месте; в обычной вычитке безопаснее не перезаписывать принятые файлы.
- Решите, необходимы ли обработанные изображения. Save Images сохраняет растровый материал вместе с OCR-выходом. Такой архив полезен при разборе ошибок: всегда видно, какой кадр поступил на движок, даже когда исходный PDF позднее был заменён.
- Включите журнал. Create Log File фиксирует ход пакетной обработки; для существующего файла предусмотрены Append и Overwrite. Для повторяющейся задачи Append сохраняет историю, а для отдельного контрольного прогона удобнее новый журнал.
- Запустите пакет и следите за панелью Results. Там выводятся Input Folder, Output Folder, Log File, Input Files, Output Files, Failed Files и Current File. Кнопка Start после запуска используется для управления текущей задачей.
- После окончания сверяйте три величины. Число входных файлов, число выходных файлов и Failed Files должны объясняться выбранным режимом вывода. Любое расхождение разбирайте по журналу до переноса партии в рабочее хранилище.
Разделитель между итогами необходим при объединении нескольких OCR-выходов в один файл. Значение Separator должно быть легко отличимо от реального текста документа и стабильно для всех запусков. Не применяйте естественную фразу, которая встречается внутри документов; технический разделитель удобнее разбирать последующим скриптом и легче проверять на дубли.
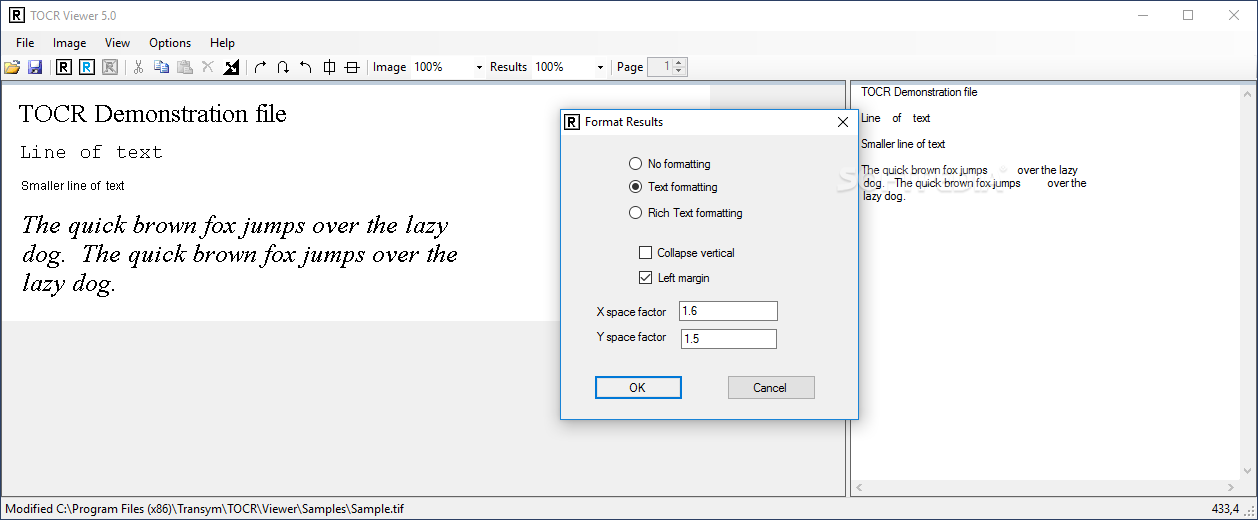
Форматирование итога задаётся отдельным окном Format Results. Доступны No formatting, Text formatting и Rich Text Formatting, а также параметры Collapse vertical, Left margin, X space factor и Y space factor. Эти настройки влияют на визуальное расположение текста, но не исправляют ошибочно распознанные символы. Сперва принимайте сам OCR-текст, затем настраивайте расстояния и форматирование под систему назначения.
Для интеграции движок предоставляет C API и примеры для других языков. Нативного .NET-интерфейса в FAQ нет, но комплект содержит демонстрационный код .NET; публичный Viewer 5.1 написан на VB.NET и показывает практический вызов DLL, получение расширенных итогов и форматирование. В документации тоже указаны примеры Visual Basic и C, а для Delphi и Python доступны примеры без официальной поддержки со стороны Transym.
Масштабирование обработки строится по лицензируемым экземплярам движка. Один стандартный лицензируемый экземпляр запускает один OCR engine на одной машине; добавочные лицензии позволяют поднимать несколько движков, заявленный предел — 255. Для корпоративного конвейера это означает явное управление параллельностью: распределяйте очередь по доступным экземплярам и не создавайте больше рабочих процессов, чем покрывает лицензирование и память.
Один engine требует памяти, и системные требования Transym указывают 512 МБ RAM на движок как базовое значение. Для больших PDF необходим запас сверх минимума, потому что страница растеризуется перед распознаванием. Параллельные процессы умножают потребление памяти. Перед масштабированием сперва измерьте пик RAM на самых тяжёлых страницах, а затем назначайте безопасное число одновременных OCR-задач.
Для программной обработки полезно разделить конвейер на четыре этапа: приём файла, нормализация в поддерживаемый формат, OCR и валидация итога. Ошибка на каждом этапе должна иметь отдельный код в журнале. Такой дизайн отделяет повреждённый PDF от ошибки распознавания и проблему TWAIN от неверного набора глифов. Повторяйте только технически временные сбои; плохой скан переводите на ручную проверку или повторное получение оригинала.
При необходимости поискового PDF рассмотрите и специализированные инструменты. OCRmyPDF строит конвейер вокруг добавления OCR-слоя в существующий PDF, тогда как Transym TOCR даёт собственный движок, координаты символов и Windows API. Выбор определяется тем, необходим готовый поисковый PDF или встраиваемый OCR-компонент с низкоуровневым контролем.
Перед переносом пакетного задания в расписание выполните контрольный прогон и сохраните его как эталон. Запишите список входных файлов, диапазон страниц, схему Output, расширение, состояние Save Images и журнал. После обработки откройте минимум один итог из начала, середины и конца партии, сопоставьте критичные поля с оригиналом и отдельно разберите каждый Failed File. Для регулярного процесса храните вход и выход в различных каталогах, а законченную партию переводите в архив лишь после проверки счётчиков. Такой порядок защищает от тихой ошибки, когда неверный диапазон или правило перезаписи формально завершается без сбоя, но создаёт не тот набор итогов. При изменении Processing options контрольный прогон повторяется: Batch наследует эти параметры из основной формы, по этой причине новая настройка должна быть проверена до запуска всей очереди.
Ошибки, ограничения, преимущества, недостатки и реальные альтернативы
Transym TOCR решает узкую задачу хорошо определённым методом: получает растровую страницу, подготавливает её, распознаёт печатные символы и возвращает текст с координатной информацией. Это не полнофункциональный PDF-редактор и не система документного менеджмента. Ограничение полезно понимать заблаговременно: Viewer необходим для контроля OCR, Batch — для повторяемой серии, API — для интеграции. Верстку, формы, подписи, перестановку страниц и сложное редактирование PDF выполняют другие инструменты.
Диагностика, оценка итога и выбор подходящего инструмента
Характерная ошибка — пытаться исправить низкую точность параметрами форматирования. Окно Format Results меняет раскладку вывода, а не качество распознавания. При неправильных символах возвращайтесь к исходной странице, DPI, Colour Conversion и Processing options. При правильных символах, но неудобных отступах и переносах, настраивайте уже формат итога. Такое разделение резко ускоряет диагностику.
OCR не отыскивает символы
Проверьте ориентацию страницы, фактическую видимость текста и обработанное чёрно-белое изображение. Потом повторите распознавание на коротком чистом фрагменте. Пустой итог на читаемом оригинале указывает на проблему входного растра или настроек, а не на форматирование вывода.
В тексте много 0/O, 1/I/l и похожих подмен
Увеличьте исходник, проверьте DPI и контраст, затем ограничьте допустимые глифы в Processing options там, где структура поля известна. Для числового идентификатора не оставляйте ненужные буквенные группы.
Фон, печать или линии сливаются с буквами
Откройте Colour Conversion и сравните алгоритмы на одной контрольной строке. Выбирайте вариант, где штрихи букв цельные, а фон не превращается в чёрный шум. При отсутствии деталей в исходнике получите новый скан.
PDF открывается, но качество OCR низкое
TOCR 5.1 растеризует страницы PDF. Проверьте реальное качество встроенного изображения: масштаб просмотра не повышает его детализацию. Для сильно сжатой страницы применяйте более качественный исходник или повторное сканирование.
Batch даёт меньше файлов, чем ожидалось
Сопоставьте режим Output Per Input Page, Output Per Input File или All Output In One с количеством источников и страниц. Потом проверьте Failed Files, журнал, диапазон Some Pages и правила перезаписи существующих итогов.
Сканер не работает через Acquire
Прямое получение зависит от TWAIN/WIA-драйвера. Выберите устройство через Select и проверьте его интерфейс через Show Device. При нестабильном драйвере получайте сканы штатной программой устройства и передавайте готовые BMP/TIFF/PDF в Viewer или Batch.
Плюсы
- Двухпанельный Viewer упрощает ручную сверку исходной страницы и распознанного текста.
- Есть отдельное распознавание всей страницы и выбранного фрагмента в Viewer, а API возвращает координаты символов для программной фильтрации.
- Пакетный режим умеет обрабатывать файлы и TWAIN-ввод, диапазоны страниц, различные схемы выходных файлов и журнал.
- Девять алгоритмов преобразования цвета, настройка допустимых символов и четыре режима скорости дают низкоуровневый контроль OCR.
- Доступны 32- и 64-битные варианты 5.1, примеры интеграции и публичный демонстрационный Viewer с исходным кодом.
- Русский входит в документированный набор распознаваемых языков; предварительный выбор языка не требуется.
Минусы
- Интерфейс Viewer англоязычный и выглядит как классическое Windows-приложение, без современного мастера обработки документов.
- Документированный вход движка ограничен PDF, BMP и TIFF; JPEG и PNG требуют предварительного преобразования.
- Нативного .NET API в опубликованном FAQ нет: интеграция .NET опирается на пример-обёртку над DLL.
- Встроенного зонального OCR в API нет; зоны распознаются через отдельные изображения либо фильтрацию итога по координатам.
- Windows 11 отсутствует в опубликованном списке поддерживаемых систем Transym; в официальном списке 5.1 указаны Windows до Windows 10 и серверные версии до Server 2019.
- Пробная версия 4.0/5.1 ограничена обработкой 50 листов A4, после чего необходим лицензированный движок.
Для полноценной работы с PDF рациональнее применять редактор, а TOCR оставить OCR-компонентом. ABBYY FineReader PDF объединяет распознавание с просмотром, редактированием текста и изображений, организацией страниц, формами, комментариями и экспортом. Такой продукт удобнее оператору, которому требуется законченный документный интерфейс. Transym TOCR интереснее там, где важны собственный конвейер, API и контроль низкоуровневых параметров распознавания.
Tesseract решает похожую базовую задачу с другой моделью применения. Это открытый OCR-движок с командной строкой и библиотекой, поддержкой большого числа языков и нескольких форматов вывода; встроенного GUI в проекте нет. Для кроссплатформенного проекта и открытого стека Tesseract даёт больше свободы. Для Windows-приложения, где уже построена интеграция с TOCR DLL и необходим готовый Viewer/Batch-пример, Transym сохраняет практическую ценность.
OCRmyPDF специализируется на поисковом слое PDF и применяет Tesseract внутри. Он в особенности логичен для архива сканированных PDF, где требуется оставить исходный вид страниц и добавить поиск. Capture2Text решает другую задачу — быстро забирает текст с области экрана; его обзор на Xeon Live доступен в разделе OCR-программ. Transym TOCR лучше рассматривать как компонент распознавания сканов и файлов, а не как универсальный экранный захват.
Для повторяющейся офисной работы сформируйте простой регламент: сканирование с одинаковым разрешением, проверка ориентации, контроль Colour Conversion на одной странице, OCR, сверка критичных полей, сохранение итога и журнал партии. Для разработческой интеграции добавьте автоматическую нормализацию форматов, отдельные коды ошибок, лимит параллельных движков и контрольный корпус документов. Для разового извлечения текста из изображения без Windows-интеграции проще применять более специализированный инструмент.
Отдельная инструкция по OCR текста в PDF помогает сопоставить этот подход с редакторами, мобильными приложениями и браузерными сервисами. Внутри Transym TOCR главный критерий качества остаётся неизменным: распознанный текст принимается лишь после сопоставления с изображением, а не по факту успешного окончания задачи.
Практическая граница продукта понятна. TOCR подходит разработчикам Windows-решений, небольшим операционным группам со стабильным набором сканов и процессам, где необходимы координаты символов, Batch и управляемая обработка. Он не заменяет PDF-редактор, систему электронного документооборота или инструмент для рукописного текста. Для смешанного архива с формами, цифровыми подписями, сложной версткой и готовым офисным экспортом удобнее комплексная платформа.
Перед внедрением зафиксируйте контрольный набор из 20–30 характерных страниц и измеряйте качество на нём после изменения сканера, драйвера, разрядности, Processing options или вызывающего приложения. Сопоставляйте не только общую долю ошибок, но и критичные поля. Такая контрольная выборка превращает настройку OCR из субъективного просмотра в воспроизводимую процедуру и показывает, когда дальнейшая фильтрация уже не помогает, а необходим новый оригинал.
Итоговый порядок работы сводится к шести действиям: получить качественный BMP/TIFF/PDF, исправить ориентацию и DPI, подобрать Colour Conversion, ограничить глифы только там, где структура поля известна, выполнить OCR и вычитать критичные данные, потом переносить проверенный профиль в Batch или API. Transym TOCR ценен именно этой управляемостью: итог зависит не от одной кнопки, а от понятной цепочки подготовки, распознавания и контроля.