
TrOCR — не обычная программа с кнопкой «Открыть» и отдельным редактором, а модель распознавания текста и Python-инструментарий вокруг неё. На Xeon Live можно скачать TrOCR бесплатно и сразу сверить назначение решения. Для практической работы важнее всего правильно выбрать модель, подготовить изображение строки, запустить инференс через Transformers и отдельно организовать обработку страниц, PDF и контроль качества.
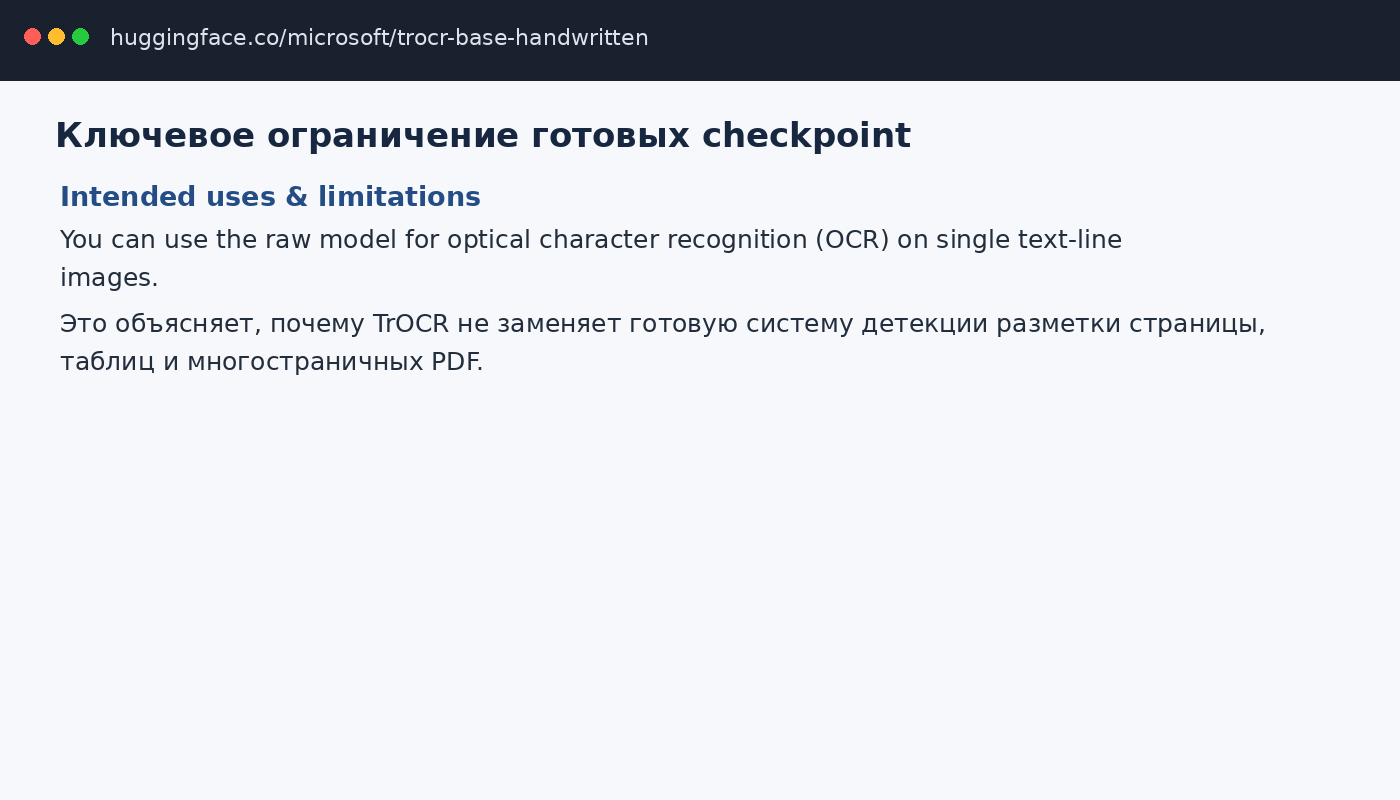
Главная особенность TrOCR — единая encoder-decoder архитектура: визуальный Transformer кодирует изображение, а текстовый Transformer последовательно генерирует распознанный текст. Это делает TrOCR удобным строительным блоком для собственного OCR-конвейера, но одновременно поясняет важное ограничение: готовые модели Microsoft работают на уровне изображения текстовой строки и не заменяют систему анализа макета страницы, детектор таблиц или полноценный PDF-редактор.
Что такое TrOCR и для каких задач он подходит
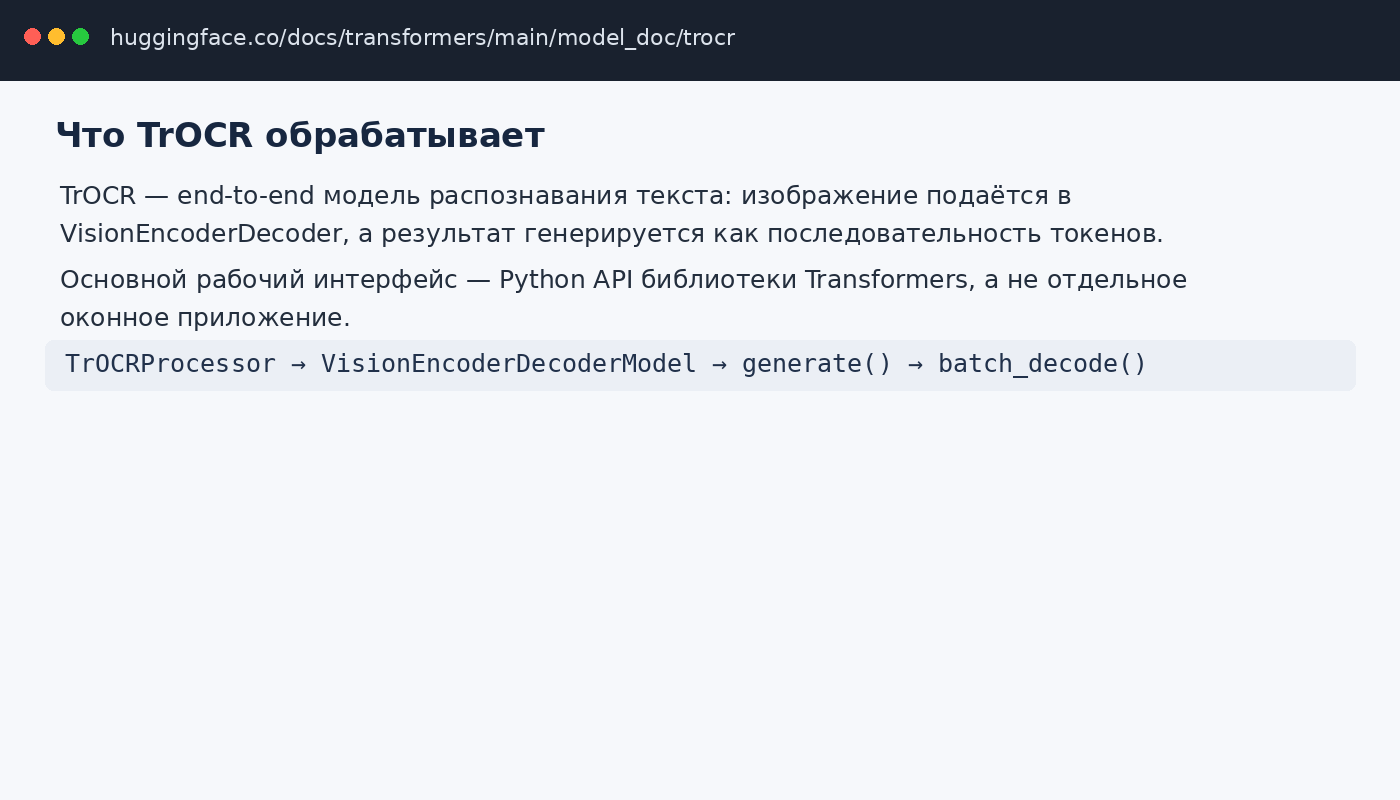
TrOCR расшифровывается как Transformer-based Optical Character Recognition. Проект опубликован исследователями Microsoft, а исходный код находится в репозитории UniLM. Современный практический путь работы проходит через Hugging Face Transformers: готовые checkpoints Microsoft загружаются классами TrOCRProcessor и VisionEncoderDecoderModel, изображение преобразуется в тензор, модель выполняет generate(), после чего токены превращаются в строку через batch_decode().
Где заканчивается модель и начинается приложение
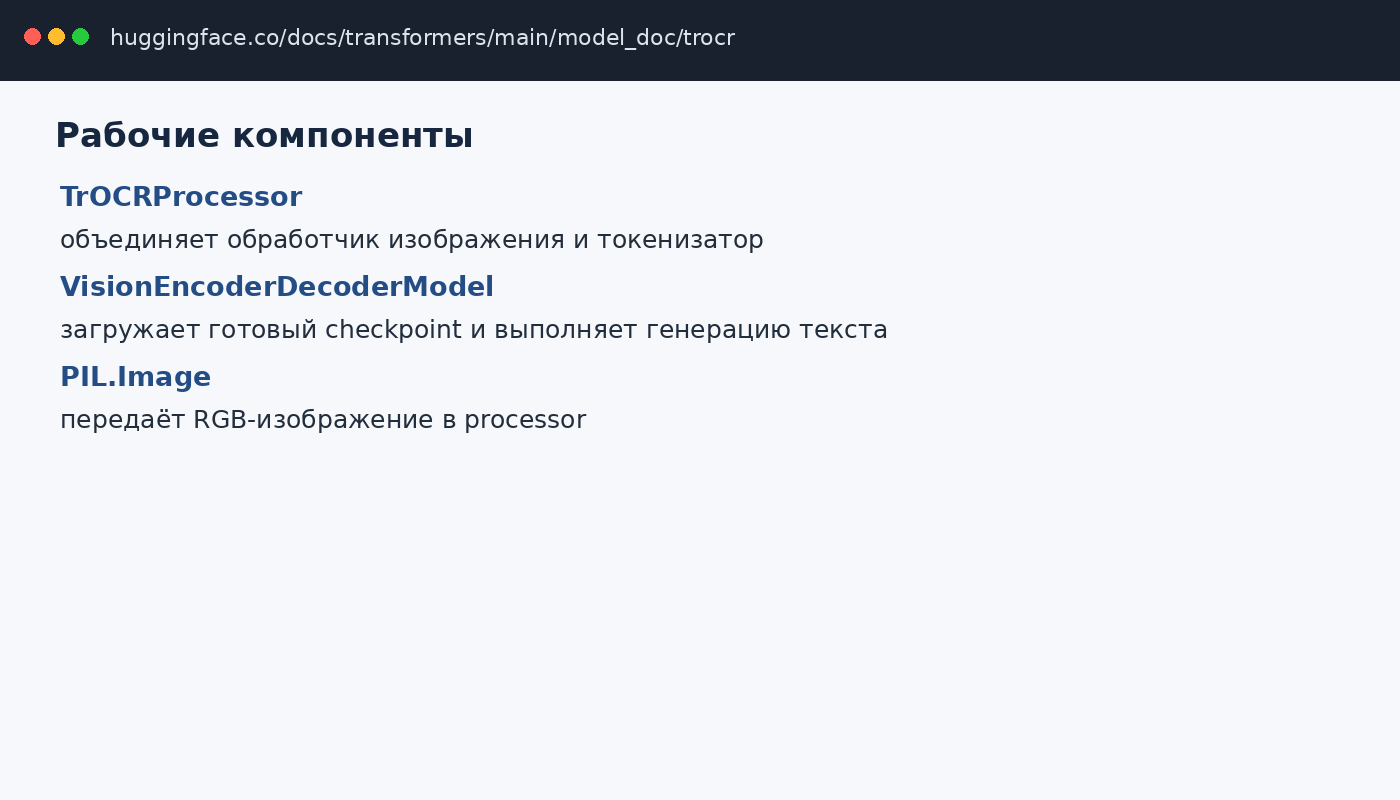
У TrOCR нет собственного настольного окна, панели миниатюр, меню импорта PDF или встроенного редактора итогов. Его «интерфейс» — вызовы Python API, карточки моделей и параметры генерации. По этой причине обзор TrOCR полезно читать как руководство по сборке рабочего процесса: где взять checkpoint, как передать картинку, как вернуть текст, как распознавать пачку строк и как проверить качество. Готовое приложение поверх TrOCR создаётся отдельно — к примеру, как скрипт, веб-сервис, notebook или внутренний сервис компании.
Какие готовые модели доступны
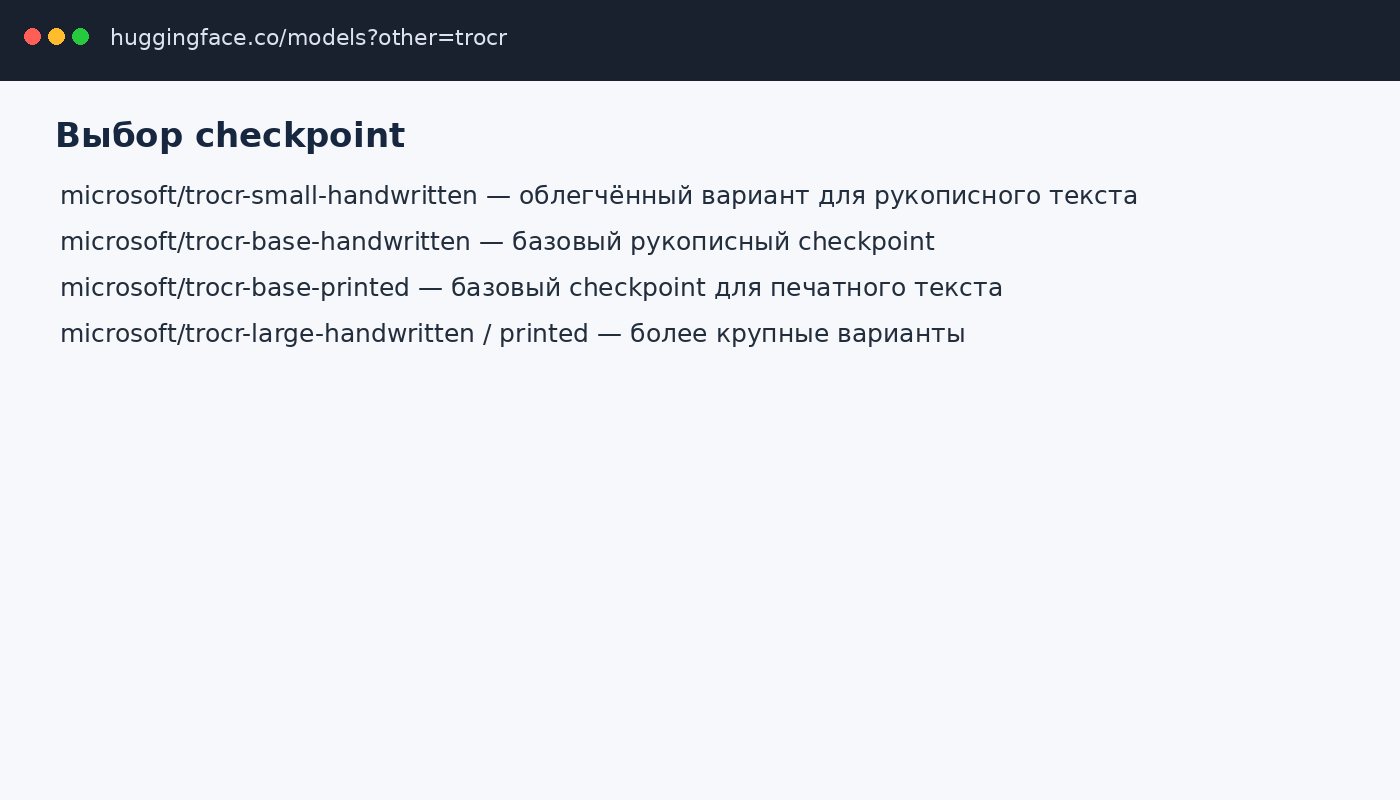
В публичной коллекции Microsoft доступны small, base и large варианты, а также checkpoints для рукописного и печатного текста. В исходном проекте для семейств Small, Base и Large приведены 62, 334 и 558 млн параметров. Карточки microsoft/trocr-base-handwritten и microsoft/trocr-base-printed описывают модели как OCR для изображений одной строки. Handwritten-вариант дообучен на IAM, printed-вариант — на SROIE; по этой причине тип исходника учитывается ещё до загрузки весов.
Готовые Microsoft-модели не следует воспринимать как универсальный распознаватель всех языков. IAM — англоязычный набор рукописных строк, а точность на кириллице зависит от отдельного дообучения и конкретного checkpoint. В экосистеме Hugging Face существуют сторонние модели, адаптированные к кириллице, но их качество проверяется на собственных документах так же строго, как качество любой другой модели.
Карта рабочего процесса: данные, модель, итог
Практический конвейер состоит из четырёх зон. Первая — источник изображения: скан, фотография, кадр страницы PDF или готовый crop строки. Вторая — предварительная обработка через TrOCRProcessor. Третья — VisionEncoderDecoderModel, который выполняет генерацию. Четвёртая — постобработка: сбор строк, проверка ошибок, сохранение текста и передача данных дальше. Чем сложнее документ, тем больше работы происходит вокруг TrOCR, а не внутри самой модели.
Вход: изображение строки, а не готовый PDF
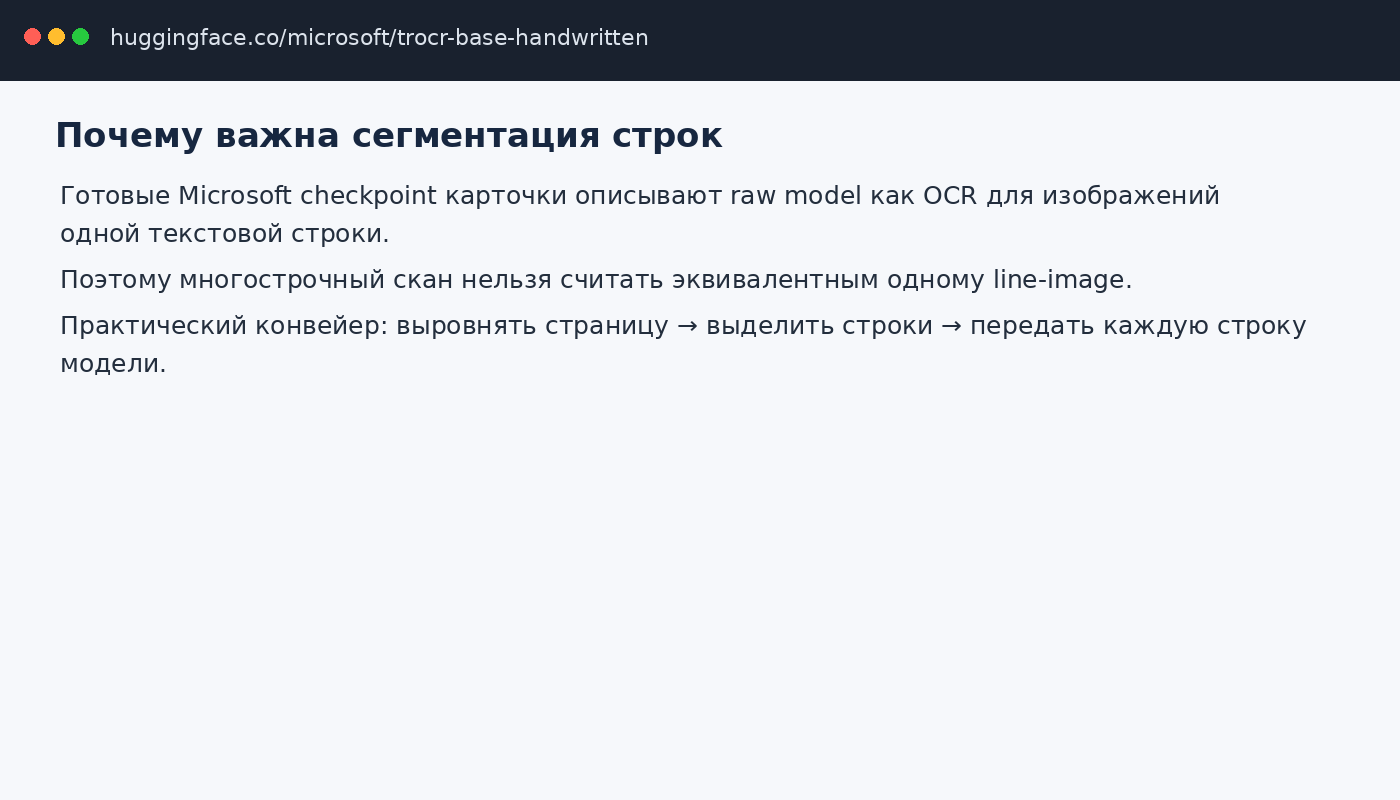
Модельные карточки прямо ограничивают типовой raw-сценарий одной текстовой строкой. Страница с несколькими абзацами сперва превращается в изображение и делится на строки либо небольшие логические фрагменты. PDF тоже заранее рендерится в растровые страницы. TrOCR не читает структуру PDF, не извлекает встроенный текстовый слой и не определяет порядок колонок самостоятельно. Для этих этапов применяют библиотеку рендеринга PDF и отдельную сегментацию макета.
Выход: строка текста без готовой верстки документа
batch_decode() возвращает строку либо список строк. Дальше приложение само решает, куда сохранить итог: TXT, JSON, базу данных, поле формы или новый текстовый слой PDF. Форматирование исходного документа, координаты слов, границы таблиц и стили не восстанавливаются одной моделью TrOCR. Для документооборота это принципиально: итог OCR считается промежуточными данными, а не готовой копией страницы.
Как запустить TrOCR на одном изображении

Самый прозрачный сценарий — распознать один заблаговременно подготовленный crop строки. Он показывает весь путь данных без лишней инфраструктуры и подходит для первого запуска, проверки окружения и сравнения checkpoints. Ниже команды описаны для актуального интерфейса Transformers, где TrOCR применяется внутри VisionEncoderDecoderModel.
Подготовить окружение и зависимости
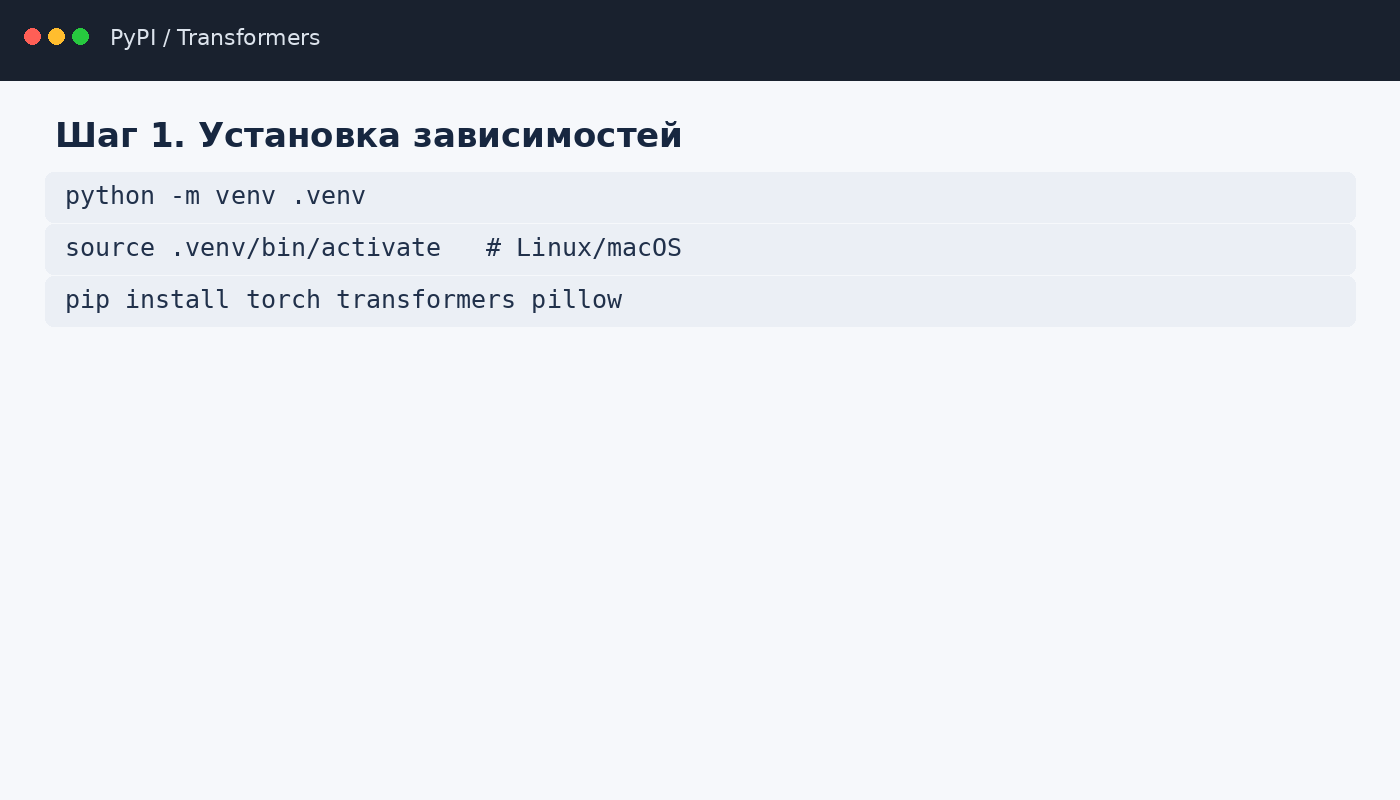
- Создайте отдельное виртуальное окружение Python, чтобы версии библиотек проекта не смешивались с системными пакетами.
- Установите PyTorch, Transformers и Pillow. Для GPU сборка PyTorch подбирается под установленный стек CUDA; для CPU достаточно обычной сборки PyTorch.
- Запустите Python и проверьте импорт TrOCRProcessor и VisionEncoderDecoderModel. Ошибка импорта означает, что работа до загрузки весов ещё не началась.
- Оставьте кэш Hugging Face на диске с достаточным свободным местом: веса Base занимают заметно больше сотен мегабайт, Large — ещё больше.
Для быстрого старта удобнее Transformers, а не историческая fairseq-инструкция из исходного репозитория. Microsoft UniLM сохраняет исходный исследовательский код и команды обучения, но современная документация Transformers даёт короткий путь инференса. Это снижает количество зависимостей и делает пример переносимым между notebook, локальным скриптом и серверным приложением.
Загрузить изображение и привести его к RGB
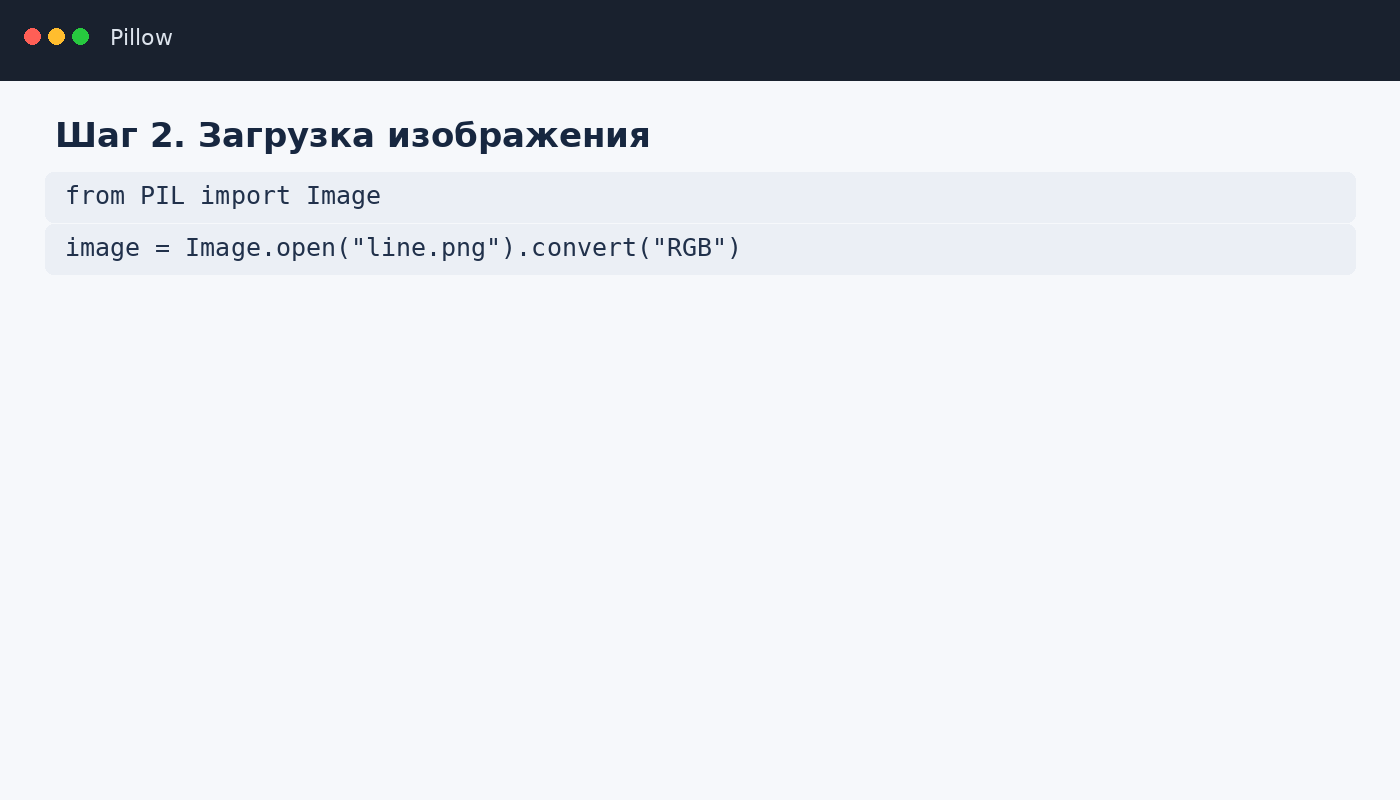
- Возьмите изображение с одной строкой текста. Для первого запуска лучше выбрать горизонтальную строку без сильного наклона и лишнего фона.
- Откройте файл через Pillow: Image.open(...).
- Выполните convert("RGB"). Это устраняет различия между палитровыми PNG, градациями серого и четырёхканальными изображениями.
- Визуально проверьте crop до инференса: начало и конец строки не обрезаны, соседние строки не попали в кадр, текст не повернут на 90 градусов.
Готовый TrOCRProcessor сам выполняет предобработку, описанную конфигурацией checkpoint. Для microsoft/trocr-base-handwritten в preprocessor_config задано масштабирование к размеру 384 и нормализация с параметрами 0.5/0.5/0.5. По этой причине ручным способом дублировать ту же нормализацию без причины не требуется: это создаёт риск получить вход не того распределения, на котором модель ожидает работать.
Загрузить processor и модель
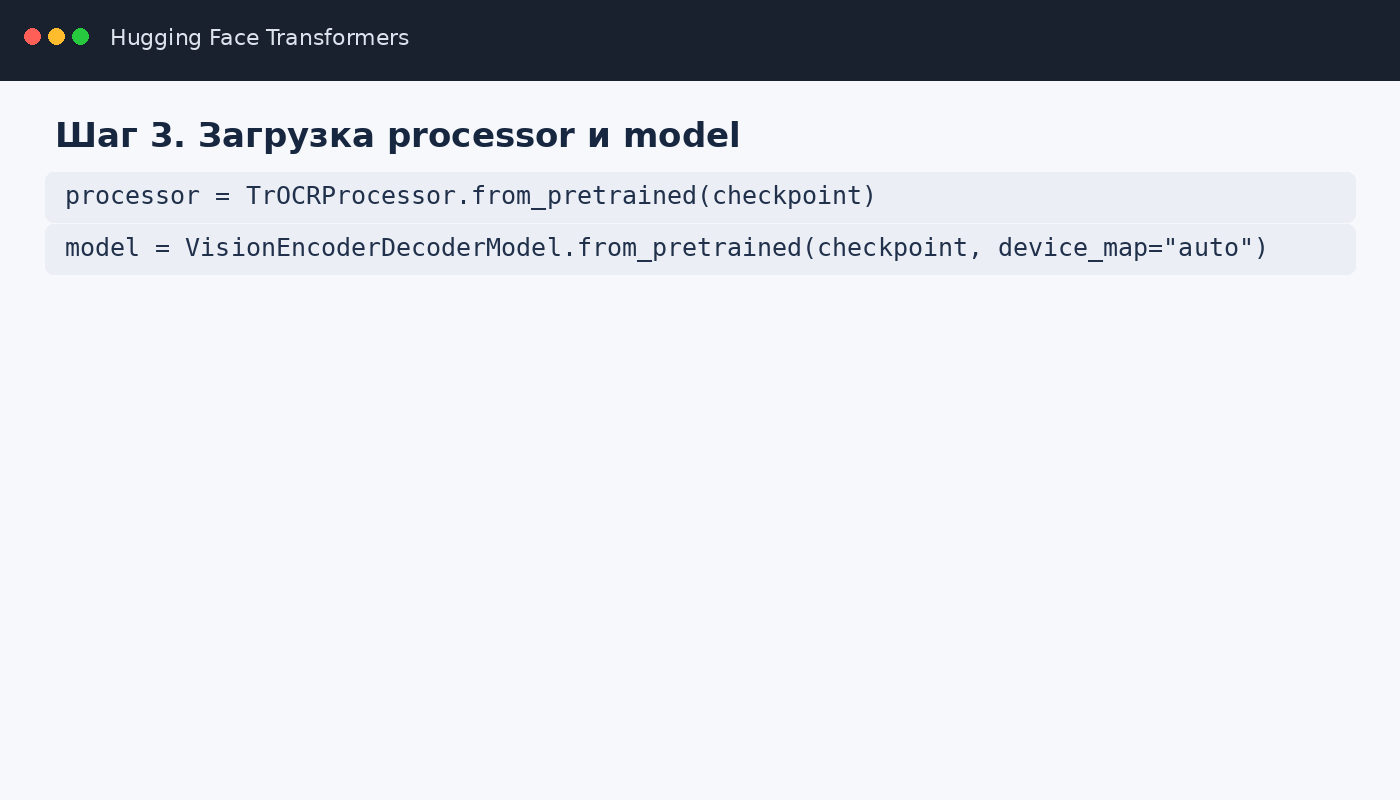
- Определите checkpoint одной строкой, к примеру microsoft/trocr-base-handwritten для рукописного английского текста или microsoft/trocr-base-printed для печатного.
- Вызовите TrOCRProcessor.from_pretrained(checkpoint). Processor связывает обработку изображения с токенизатором декодера.
- Вызовите VisionEncoderDecoderModel.from_pretrained(checkpoint, device_map="auto"). В актуальной документации device_map="auto" показан как удобный вариант размещения модели.
- После загрузки убедитесь, что processor и модель относятся к одному checkpoint. Смешивание processor от одной модели с другой моделью усложняет диагностику и не даёт преимущества.
Получить pixel_values, запустить generate и декодировать текст
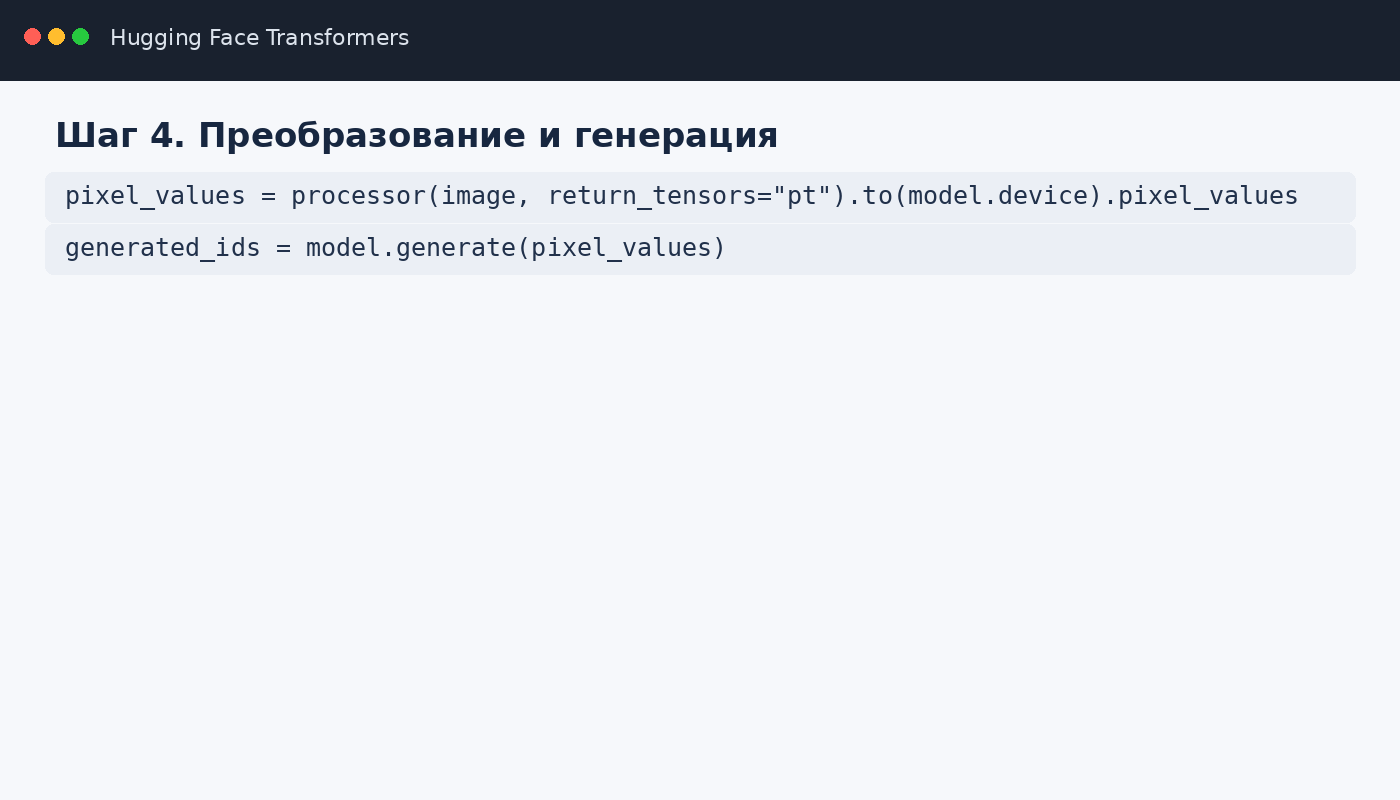
- Передайте image в processor с return_tensors="pt" и извлеките pixel_values.
- Переместите пакет на устройство модели через .to(model.device), как показано в современной документации.
- Передайте pixel_values в model.generate(). Итогом станет последовательность идентификаторов токенов.
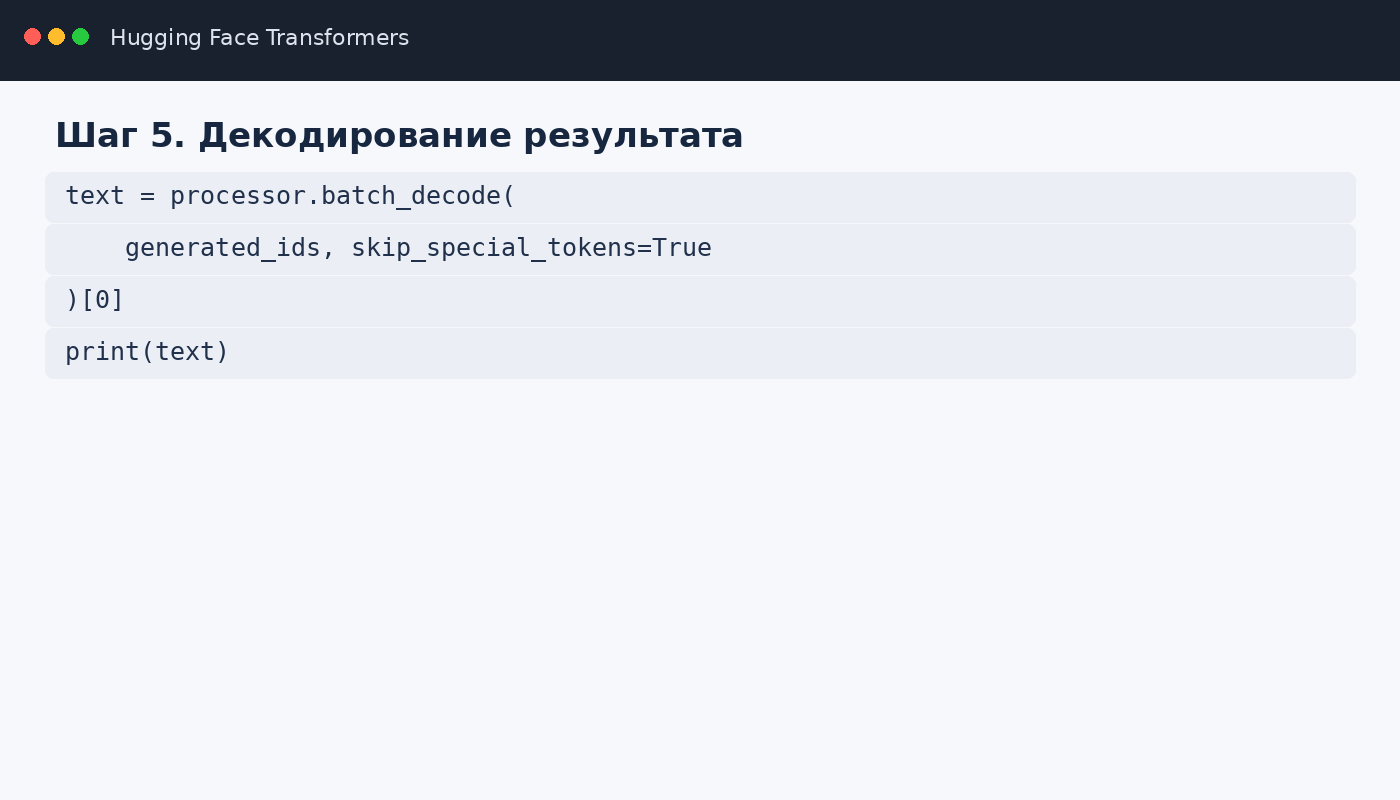
- Передайте generated_ids в processor.batch_decode(..., skip_special_tokens=True). Для одного изображения возьмите первый элемент списка.
- Напечатайте итог и сопоставьте его с исходной строкой. Сразу отметьте пропуски, подмены символов, неверные пробелы и знаки препинания.
На этом минимальный цикл закончен. Он не записывает файл автоматически и не меняет оригинальное изображение. Сохранение итога добавляется обычным кодом Python: строка записывается в текстовый файл, структуру JSON или базу. Такой контроль полезен в бизнес-процессе: вместе с текстом сохраняют имя исходного файла, номер страницы, индекс строки и показатель ручной проверки.
Как выбрать модель для печатного и рукописного текста
Выбор checkpoint влияет на итог сильнее, чем косметическая настройка кода. Microsoft публикует отдельные семейства printed и handwritten. Нельзя считать их взаимозаменяемыми только потому, что интерфейс классов одинаков. Практический подбор начинается с типа текста и языка, затем подтверждается тестом на своих документах.
Распознать печатную строку
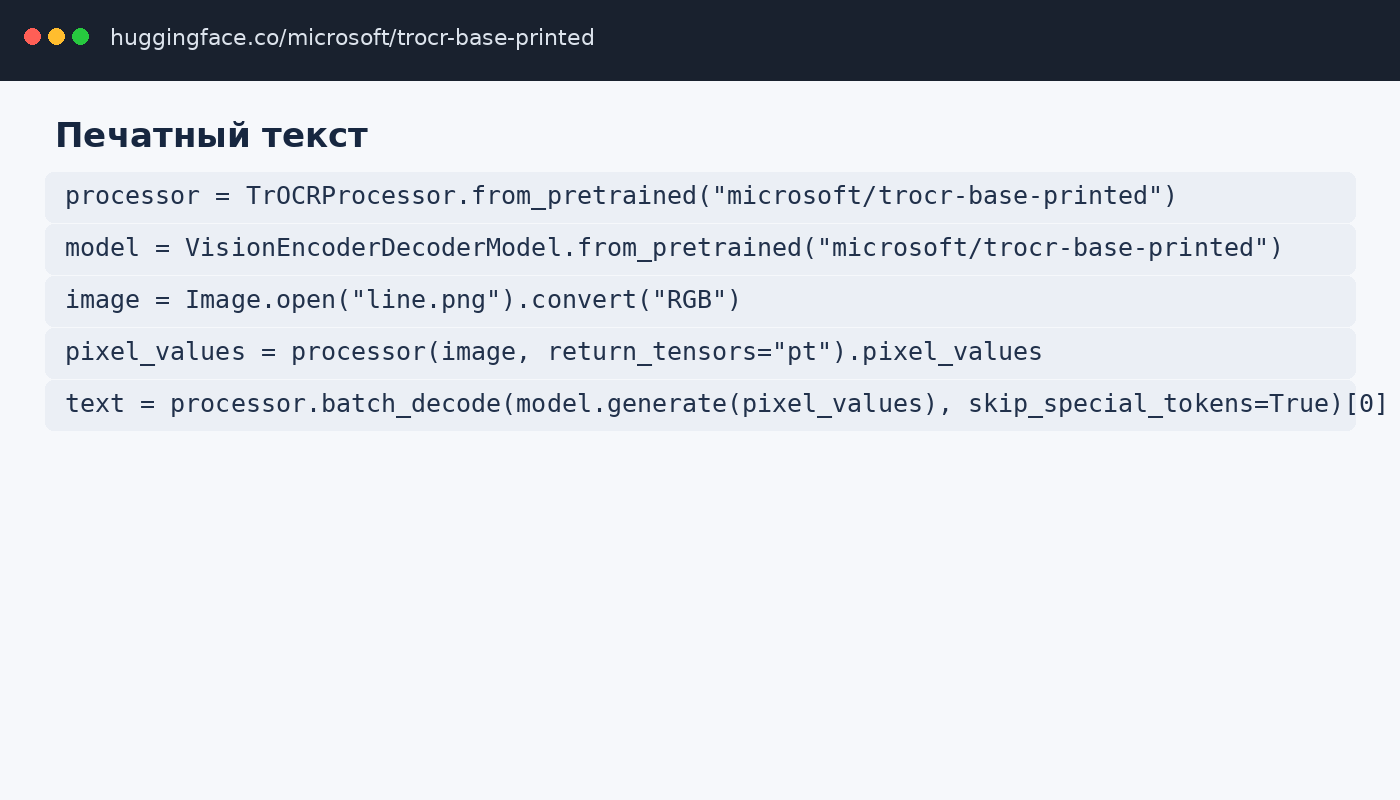
- Подготовьте crop с одной печатной строкой. Для документов полезно убрать широкие поля и соседние элементы, чтобы модель видела именно текст.
- Укажите checkpoint microsoft/trocr-base-printed и загрузите processor вместе с VisionEncoderDecoderModel.
- Передайте RGB-изображение в processor и выполните generate().
- Декодируйте итог с skip_special_tokens=True.
- Сопоставьте распознавание с оригиналом по цифрам, сокращениям, знакам валюты и пунктуации. Печатный текст в чеках и документах зачастую содержит именно такие критичные символы.
Printed-модель Microsoft связана с SROIE и текстом документов, но raw-карточка всё равно описывает работу с одной строкой. Табличный лист или чек целиком требует предварительного выделения строк и сохранения их порядка. TrOCR не формирует координаты ячеек и не восстанавливает структуру таблицы из одного вызова generate().
Распознать рукописную строку
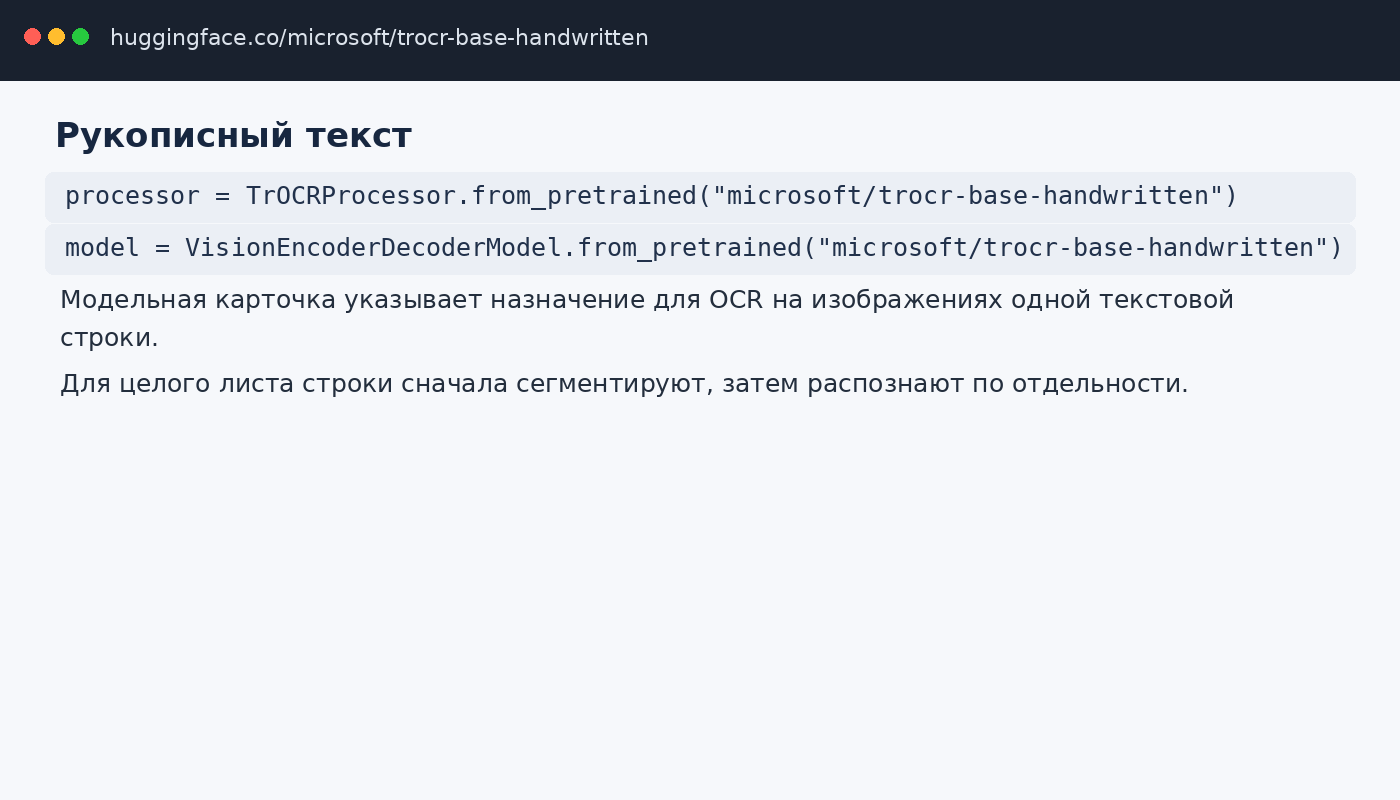
- Подготовьте изображение одной рукописной строки без обрезанных верхних и нижних выносных элементов букв.
- Загрузите microsoft/trocr-base-handwritten. Карточка модели указывает дообучение на IAM.
- Обработайте изображение через TrOCRProcessor и передайте pixel_values модели.
- Декодируйте строку и сохраните исходный crop рядом с итогом для последующей проверки.
- Для кириллицы применяйте checkpoint, реально дообученный на кириллических данных, и измерьте качество на своей выборке. Microsoft base-handwritten не позиционируется как готовый русский рукописный OCR.
На рукописном вводе в особенности полезно хранить изображение каждой строки вместе с распознанным текстом. Ручная верификация тогда не требует ещё раз искать место на странице. Внутренний идентификатор вида page_003_line_012 связывает исходник, строку OCR и исправленную версию. Такой формат упрощает повторное обучение и анализ типовых ошибок.
Как распознавать PDF и многострочные документы
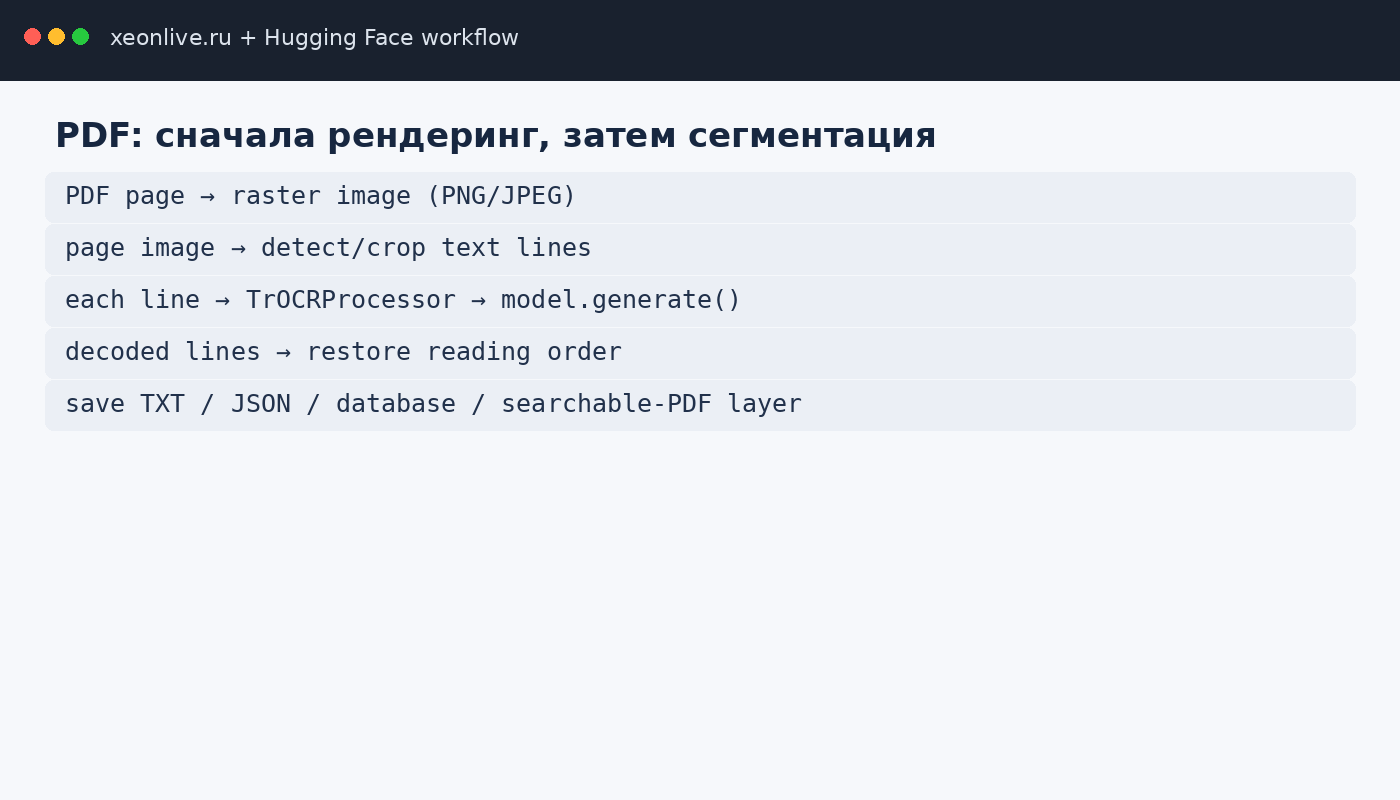
TrOCR не принимает PDF как документный контейнер, по этой причине рабочий сценарий строится вокруг страницы. Сперва PDF рендерится в изображение подходящего разрешения. Затем страница выравнивается, при необходимости очищается от шума, после чего отдельный алгоритм выделяет строки. Только line-crops передаются TrOCR. На финальном этапе строки возвращаются в порядок чтения.
Преобразовать PDF в изображения страниц
- Откройте PDF библиотекой рендеринга и преобразуйте каждую страницу в PNG либо другой растровый формат без сильного JPEG-сжатия.
- Назначьте странице стабильный индекс. Он потребуется при обратной сборке текста.
- Проверьте ориентацию страницы. Перевёрнутый или боковой текст сперва разворачивается, затем передаётся детектору строк.
- Сохраните исходный рендер отдельно от последующих crop-файлов. Это помогает повторить обработку без повторного чтения PDF.
Для общего понимания работы с OCR в PDF полезна отдельная инструкция по распознаванию текста в PDF на Xeon Live. Она охватывает готовые приложения и сервисы, а TrOCR занимает в таком процессе место распознающей модели, а не PDF-редактора.
Разделить страницу на строки и сохранить порядок
- Отыщите области текста детектором строк или процедурой сегментации. TrOCR сам не выполняет этот этап.
- Отсортируйте строки по координате сверху вниз, а для многоколоночного документа дополнительно учитывайте порядок колонок.
- Добавьте небольшой безопасный отступ вокруг строки, чтобы крайние символы не обрезались.
- Сохраните crop с именем, содержащим номер страницы и индекс строки.
- После OCR соберите строки в том же порядке и только затем формируйте абзацы. Ошибка сортировки не исправляется самой моделью.
Собрать текст и сохранить итог
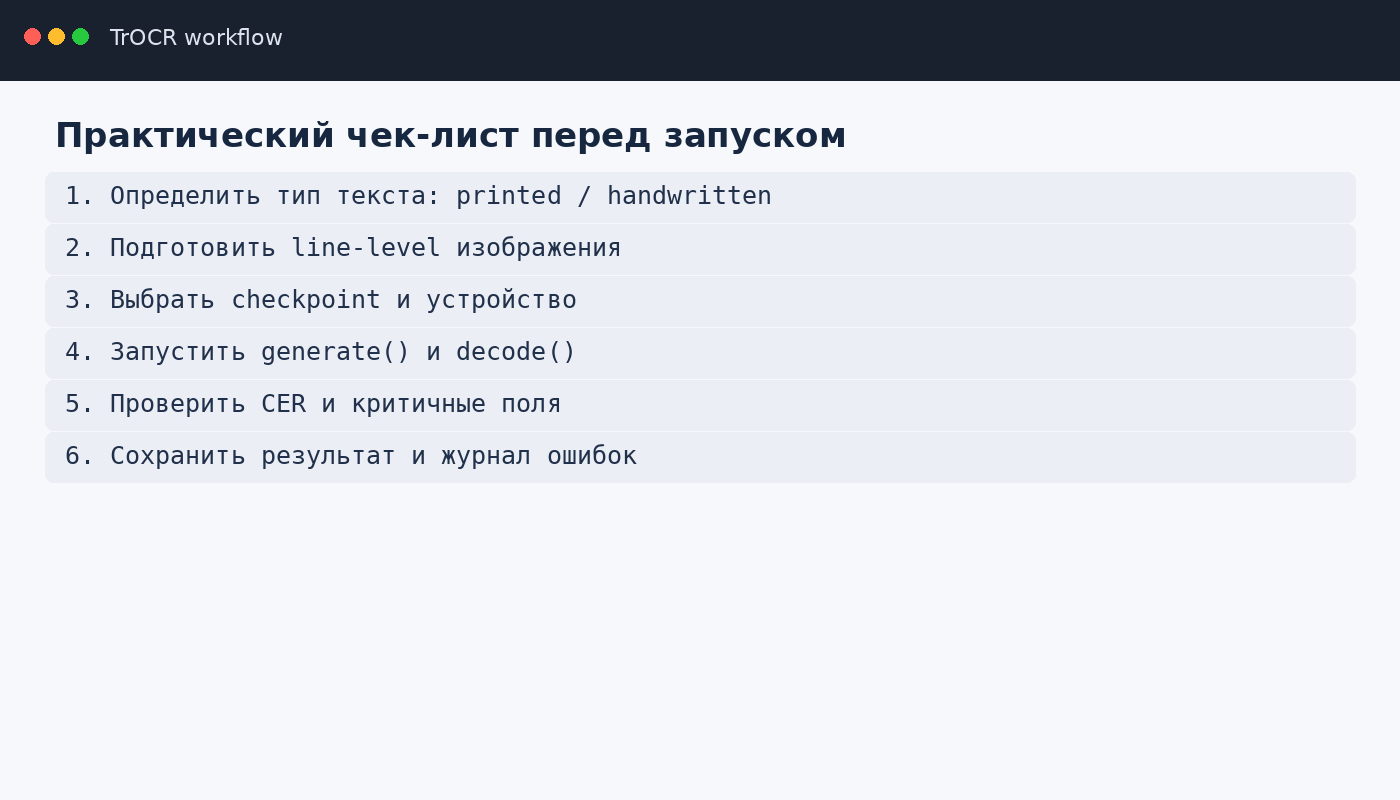
- Сохраните для каждой строки исходный путь, координаты crop, checkpoint и распознанный текст.
- Объедините строки страницы с переносами. Не удаляйте переносы автоматически до проверки, иначе слитые абзацы осложнят поиск ошибок.
- Для JSON храните поля page, line, bbox и text. Координаты приходят от внешнего детектора, а не от TrOCR.
- Для searchable PDF добавьте распознанный текстовый слой отдельной PDF-библиотекой. TrOCR сам такой файл не создаёт.
- Откройте готовый итог и проверьте выборочное копирование текста, порядок страниц и соответствие исходнику.
При разовой задаче извлечения текста из картинки проще применять готовый OCR-инструмент. Xeon Live отдельно разбирает извлечение текста из изображения и скриншота. TrOCR оправдан там, где необходим программный конвейер, выбор модели, собственная сегментация и возможность дообучения.
Как ускорить пакетную обработку и снизить расход памяти
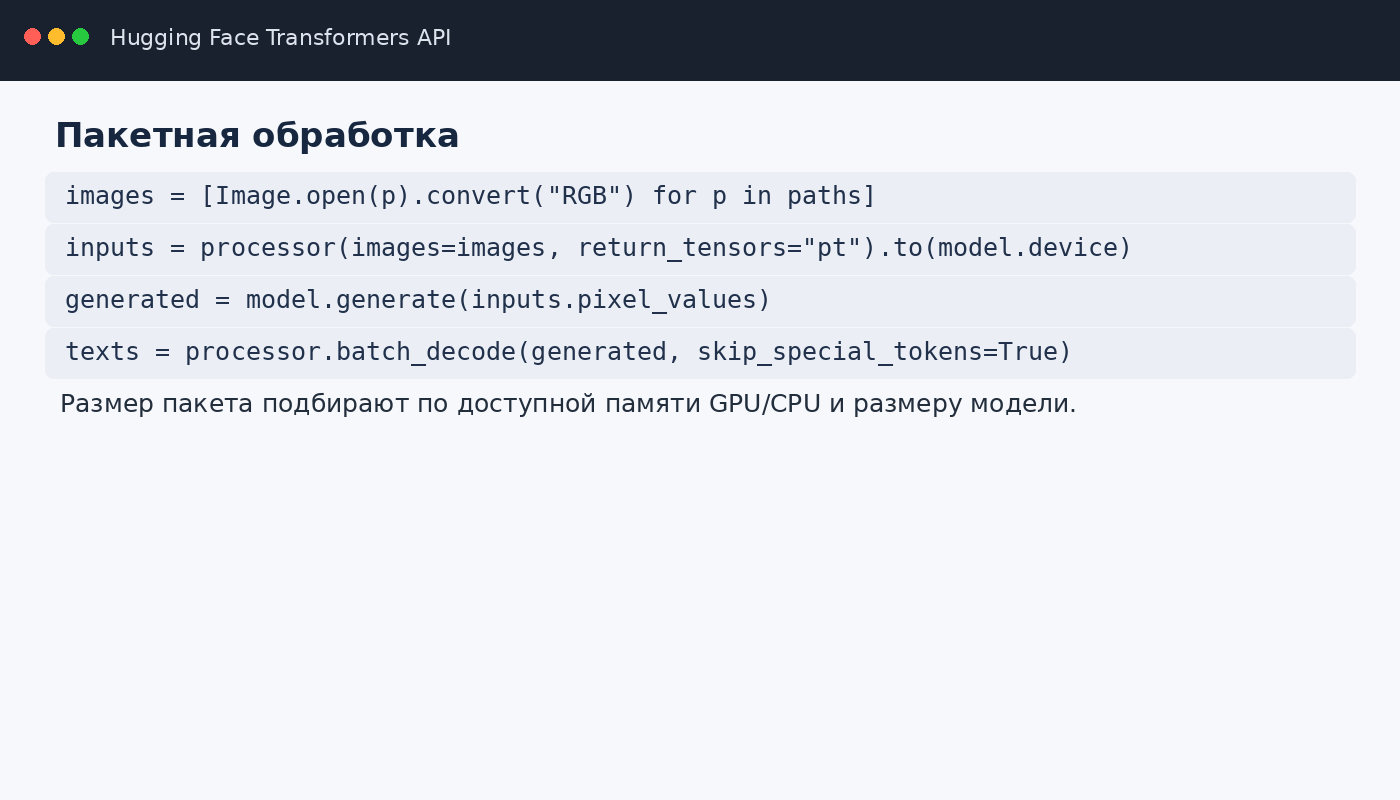
В производственном сценарии по одному вызову на строку быстро становится узким местом. Transformers позволяет передать список изображений processor и получить пакет pixel_values. Дальше один вызов generate() обрабатывает пакет, а batch_decode() возвращает набор строк. Реальный размер batch подбирается по памяти устройства и длине выходных последовательностей.
Собрать batch без потери связи с исходными файлами
- Сформируйте список paths в стабильном порядке и не меняйте его между загрузкой изображений и сохранением итога.
- Откройте каждый файл через Pillow и приведите к RGB.
- Передайте список images в processor(images=images, return_tensors="pt").
- Переместите полученные тензоры на устройство модели и вызовите generate().
- Декодируйте весь batch через batch_decode(). Сопоставьте texts[i] с paths[i] и сохраните пару в журнал.
- При нехватке памяти уменьшите batch, а не размер исходного текста до нечитаемого состояния.
Применять GPU правильно
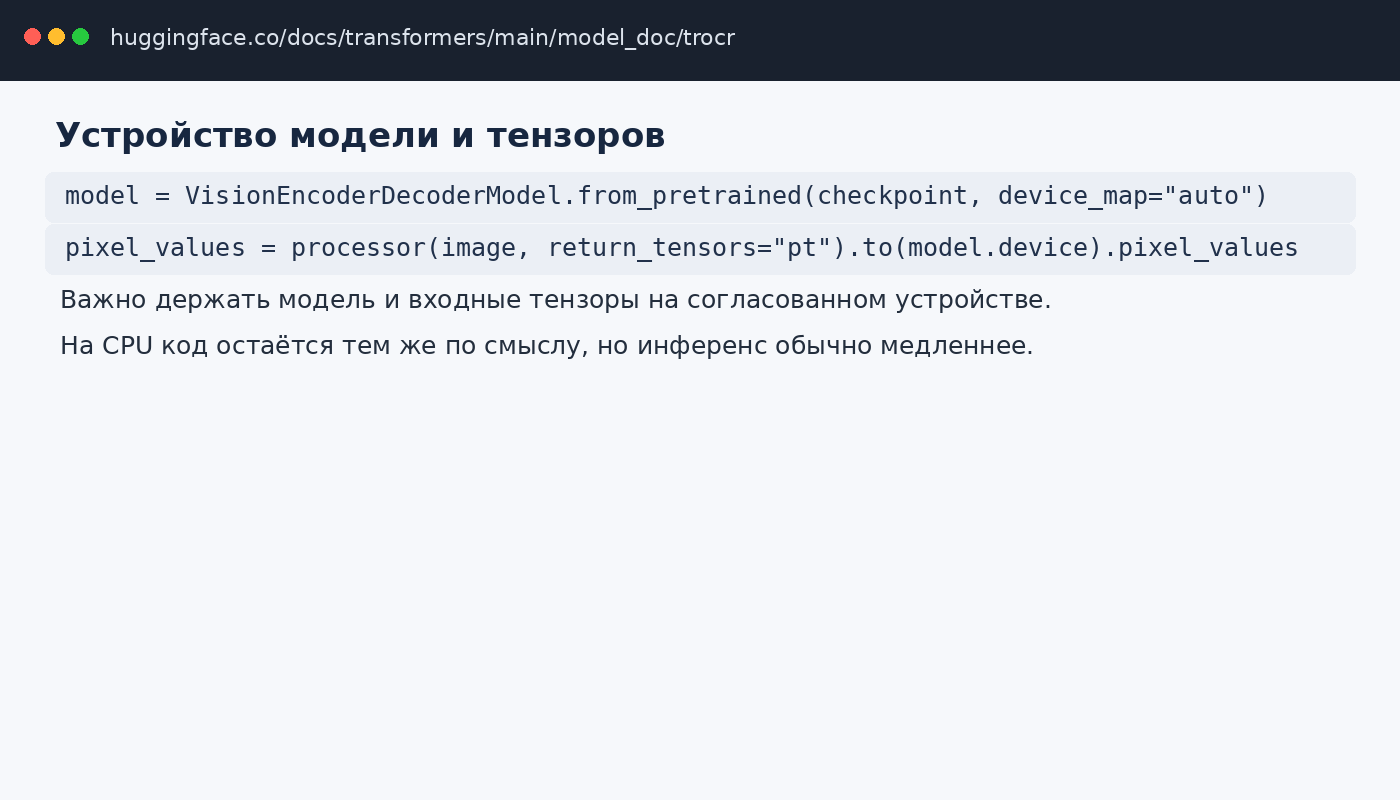
- Загрузите модель с device_map="auto" либо разместите её на выбранном устройстве явным методом, согласованным с используемой версией PyTorch и Transformers.
- После processor перенесите BatchFeature на model.device. В актуальном примере документации именно этот порядок предотвращает несовпадение устройств.
- Проверьте, что инференс выполняется без градиентов в прикладном сценарии. Обучение и инференс имеют различные требования к памяти.
- Измеряйте не только скорость одной строки, но и throughput всего набора: загрузка изображений, сегментация, модель и запись итога образуют один процесс.
Включить 8-битную квантизацию для крупной модели
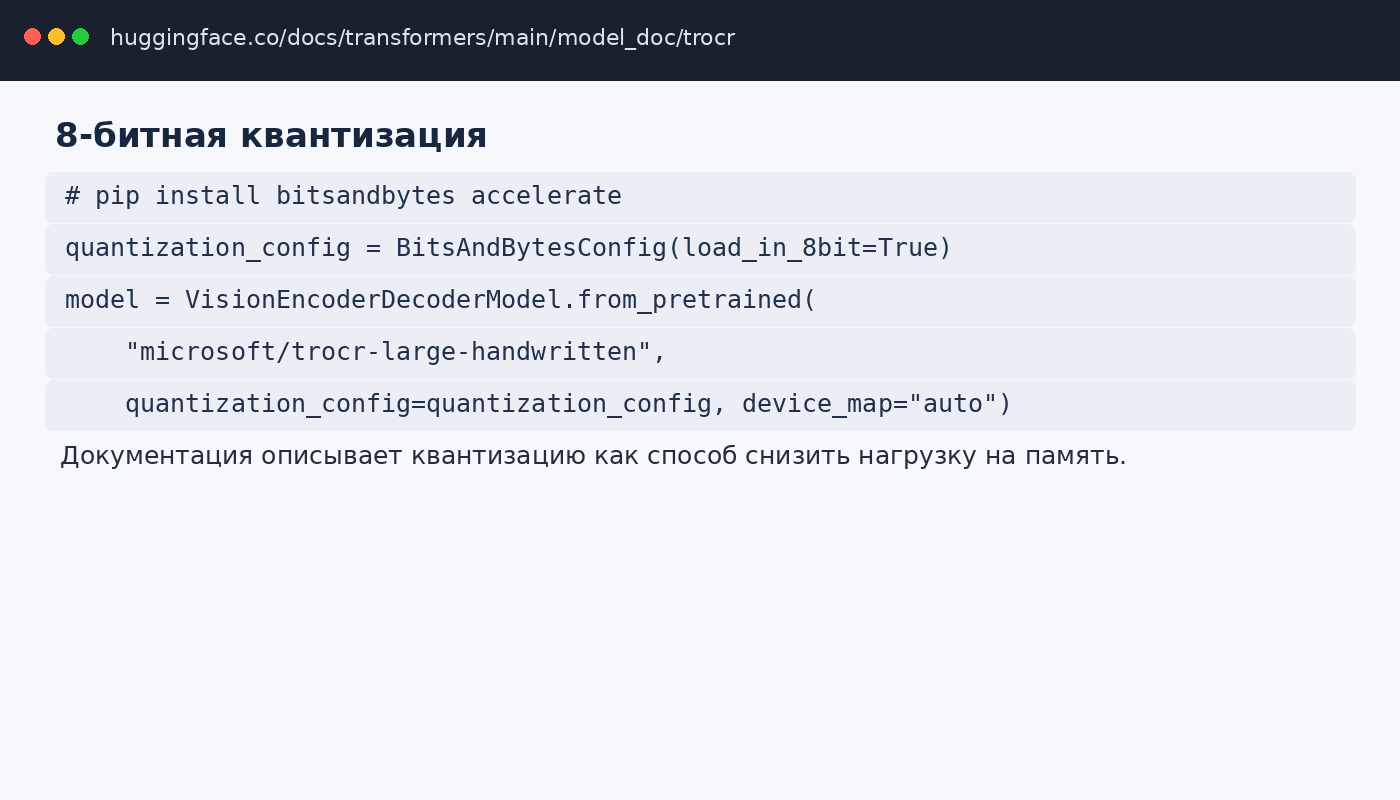
- Установите bitsandbytes и accelerate, как указано в разделе Quantization документации Transformers.
- Создайте BitsAndBytesConfig(load_in_8bit=True).
- Передайте quantization_config в VisionEncoderDecoderModel.from_pretrained вместе с device_map="auto".
- Сперва измерьте качество на своей контрольной выборке, потом сопоставьте экономию памяти и скорость с обычной загрузкой.
- Не переносите вывод о качестве с одной коллекции документов на другую: шрифты, язык и качество сканов меняют картину сильнее, чем удобная настройка памяти.
Квантизация полезна в первую очередь для снижения памяти больших checkpoints. Она не заменяет правильный выбор модели и не решает ошибки сегментации. Для base-модели часто важнее хороший batch и быстрый ввод данных, а для large-варианта ограничением чаще становится память ускорителя. Решение принимают по измерениям на реальном рабочем наборе.
Как проверять качество и исправлять ошибки распознавания
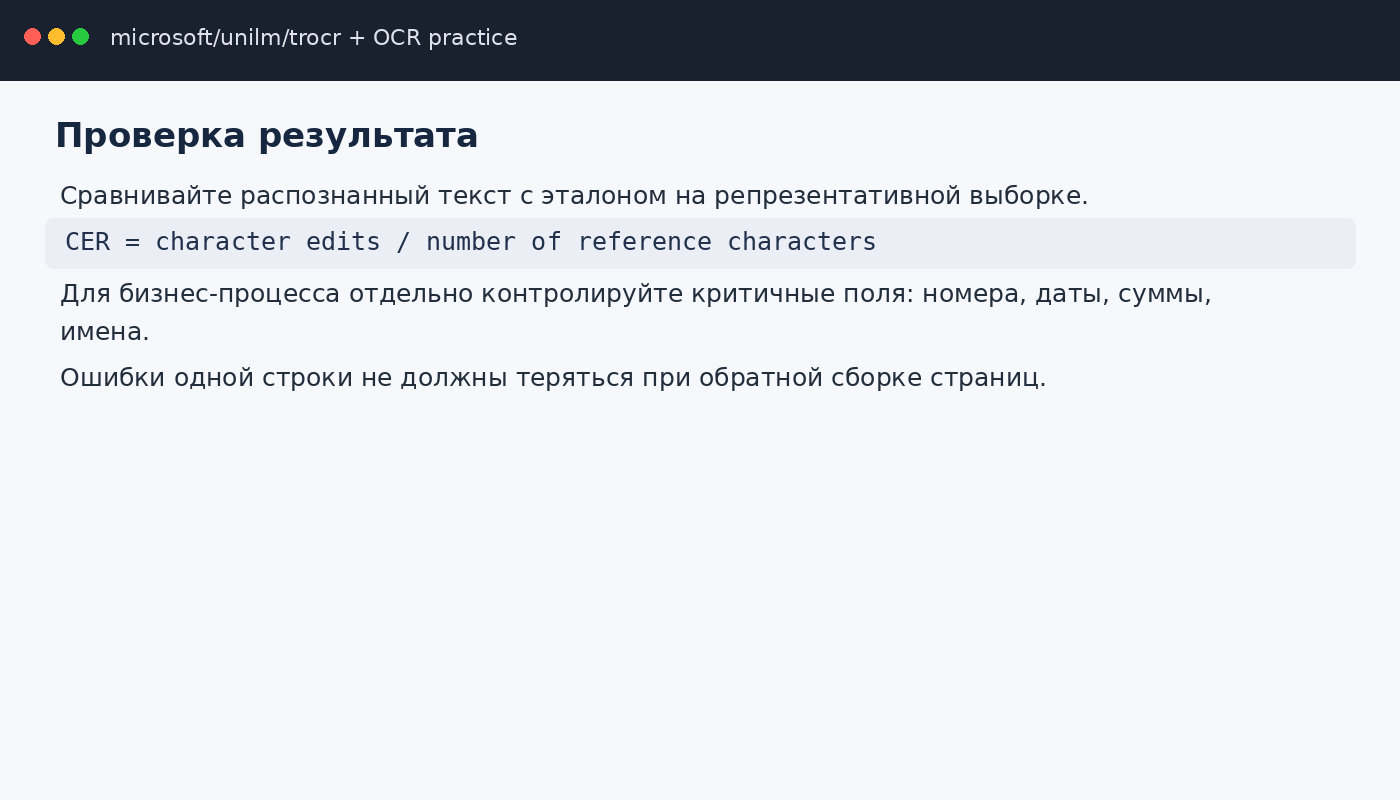
OCR нельзя оценивать только по одной удачной картинке. Необходима контрольная выборка, отражающая реальные сканы: различные почерки, размеры строк, качество бумаги, поворот, шум, цифры и редкие символы. В исходном проекте TrOCR для IAM применяется CER — Character Error Rate. Для прикладного процесса к CER добавляют проверку полей, ошибка в которых несёт бизнес-риск.
Посчитать CER на эталонной выборке
- Подготовьте набор line-images и эталонных строк, проверенных человеком.
- Запустите один и тот же checkpoint на всём наборе без ручного выбора удачных примеров.
- Для каждой пары reference и prediction посчитайте расстояние редактирования на уровне символов.
- Разделите суммарное число вставок, удалений и замен на суммарное число символов эталона.
- Сохраните не только итоговый CER, но и список худших строк. Он показывает тип ошибок и помогает понять, что исправлять: данные, сегментацию или checkpoint.
Низкий CER не гарантирует корректность каждого критичного поля. В счёте ошибка одной цифры в сумме важнее нескольких опечаток в описательном тексте. По этой причине для форм, договоров и чеков полезно вести отдельную точность по выбранным полям и отправлять сомнительные строки на ручную проверку.
Диагностировать типовые проблемы
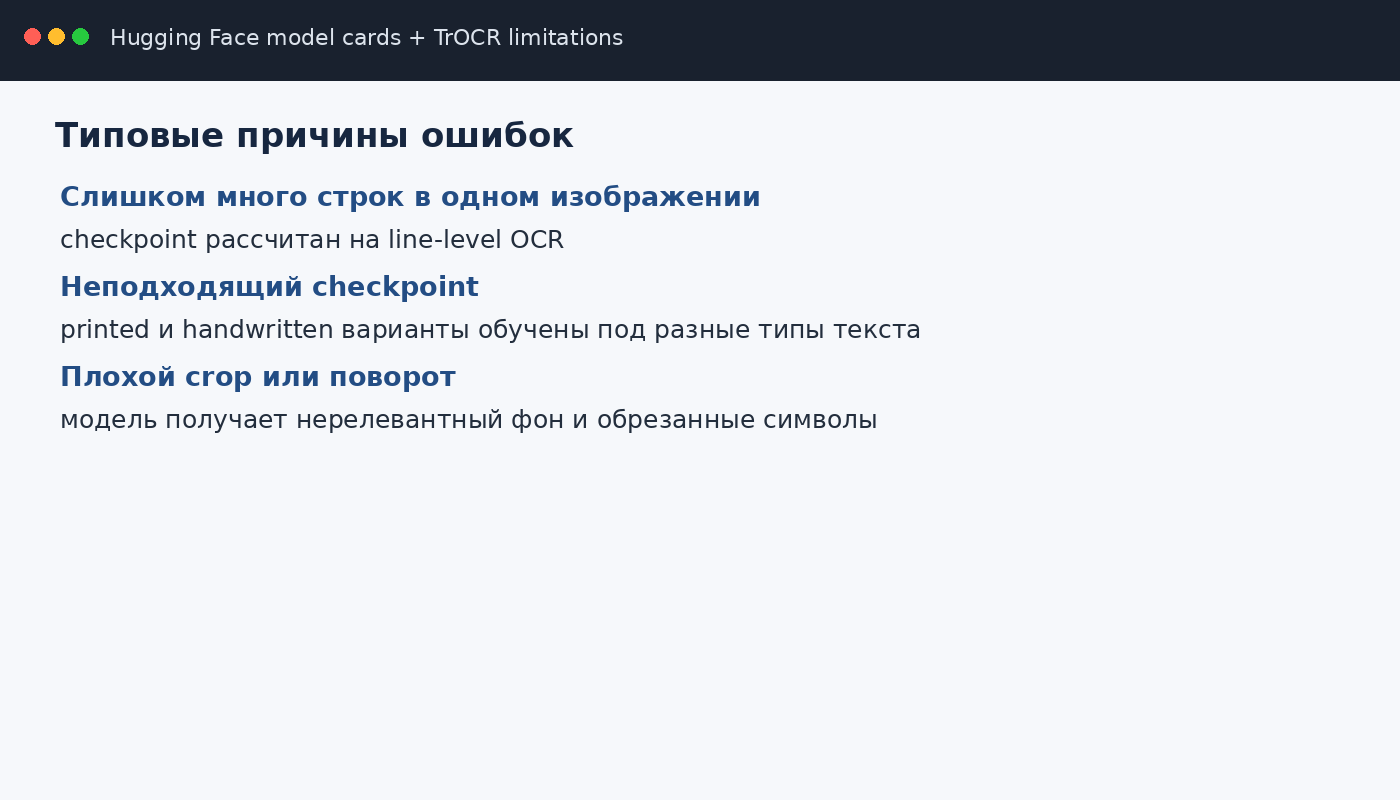
- Несколько строк в одном crop: вернитесь к сегментации и сократите область до одной строки.
- Обрезанные символы: увеличьте отступ вокруг строки и повторите рендеринг.
- Сильный наклон: выровняйте строку до processor, сохранив высоту символов.
- Печатный текст распознаётся handwritten-моделью или наоборот: переключите checkpoint и сопоставьте на контрольной выборке.
- Кириллица даёт систематические замены: применяйте модель, реально дообученную на нужной письменности, и измерьте итог на собственных данных.
- GPU выдаёт ошибку несовпадения устройств: перенесите pixel_values на model.device перед generate().
Проверить итог перед автоматическим применением
- Откройте случайную выборку исходных строк рядом с prediction и оцените визуально.
- Отдельно проверьте строки с цифрами, датами, артикулами и именами.
- Сопоставьте количество найденных строк с ожидаемым числом строк на страницах. Пропущенная сегментация не отражается в тексте как явная ошибка.
- Для PDF проверьте порядок строк и страниц после обратной сборки.
- Запишите версию checkpoint и библиотеки вместе с итогом, чтобы обработку можно было воспроизвести после обновления окружения.
Модель возвращает бессвязный текст
Проверьте тип checkpoint, crop строки, ориентацию изображения и соответствие processor той же модели. Для многострочной страницы сперва выполните сегментацию.
Распознаётся только часть строки
Увеличьте поля crop и убедитесь, что крайние символы полностью попали в изображение. Обрезанные графемы нельзя восстановить настройкой декодера.
Русская рукопись распознаётся плохо
Готовый microsoft/trocr-base-handwritten дообучен на IAM и не является специализированной русской рукописной моделью. Применяйте checkpoint для кириллицы и измерьте качество на своей выборке.
Не хватает памяти GPU
Уменьшите batch либо примените документированный 8-битный режим для подходящего оборудования. Large-модель требует больше памяти, чем Base и Small.
PDF не открывается моделью
TrOCR получает изображения, а не PDF-контейнер. Сперва рендерьте страницы в изображения, затем выделяйте строки.
Текст распознан, но потеряна верстка
Это ожидаемо для line-level OCR. Координаты, порядок колонок, таблицы и текстовый слой PDF собираются внешними компонентами конвейера.
Перед серийным запуском полезно сделать небольшой контрольный прогон на нескольких десятках строк. Сперва сохраните исходные crops, затем predictions, затем ручным способом исправленные строки. После этого сгруппируйте ошибки по типу: обрезка символов, наклон, неверный язык, похожие графемы, пробелы, пунктуация. Такая карта ошибок показывает, что менять в процессе. Ошибка crop исправляется сегментацией, языковая ошибка — другим checkpoint или дообучением, а порядок строк — логикой сборки страницы.
Для устойчивой автоматизации каждый этап оформляйте как отдельную функцию: render_page(), detect_lines(), recognize_batch(), validate_output(), save_result(). Граница между функциями хранит простые данные: изображения, координаты, строки и метаданные. Это облегчает повторный запуск только проблемного этапа. При замене модели не приходится заново рендерить PDF, а при улучшении сегментации не меняется код сохранения итога.
При сравнении checkpoints применяйте один и тот же набор изображений и одинаковую схему предобработки. Запишите время, пик памяти, CER и количество строк, отправленных на ручную проверку. Потом сопоставьте Base и Large по совокупности показателей. Более крупная модель оправдана только тогда, когда снижение ошибок компенсирует добавочные ресурсы. Для потока документов полезнее стабильный throughput и прогнозируемая проверка, чем рекорд на единичном примере.
В производственном журнале храните минимум имя исходного файла, номер страницы, координаты строки, имя checkpoint, дату обработки, prediction и статус ручной проверки. При смене версии модели старые и новые итоги тогда можно сопоставить без путаницы. Для чувствительных документов журнал не должен дублировать весь исходный текст без необходимости; структура хранения определяется политикой доступа организации.
Преимущества, недостатки и ограничения TrOCR
TrOCR силён как модельный компонент: архитектура единым encoder-decoder трактом связывает визуальный вход и генерацию текста, а экосистема Transformers упрощает загрузку checkpoints и интеграцию с Python. Но это не готовый офисный OCR-пакет. Пользователь сам отвечает за страницы, сегментацию, интерфейс, хранение итогов и проверку качества.
Плюсы
- Готовые Microsoft checkpoints для печатного и рукописного текста доступны в Hugging Face.
- Один программный интерфейс для processor, модели, generate() и decode() упрощает интеграцию.
- Есть Small, Base и Large варианты, что даёт выбор между ресурсами и размером модели.
- Поддерживается пакетная обработка изображений через processor.
- В актуальной документации описана 8-битная квантизация через bitsandbytes.
- Исходный код TrOCR и код Transformers открыты, по этой причине модель удобно встраивать в собственные процессы.
Минусы
- Нет отдельного настольного интерфейса и готового документационного рабочего места.
- Готовые raw checkpoints ориентированы на изображения одной строки; полноценная страница требует внешней сегментации.
- Нет прямого импорта PDF, анализа колонок, таблиц и готового экспорта searchable PDF.
- Microsoft handwritten checkpoint не является готовым универсальным OCR для русской рукописи.
- Крупные модели требуют заметных вычислительных ресурсов и времени на загрузку весов.
- Качество сильно зависит от crop, языка, типа письма и домена исходных документов.
Кому подойдёт
- ML- и backend-разработчикам, которые строят собственный OCR-сервис.
- Исследовательским командам, которым необходим дообучаемый Transformer OCR.
- Проектам с уже готовой сегментацией строк и собственным хранением итога.
- Командам, которым важно контролировать checkpoint, инфраструктуру и метрики качества.
Для пользователя, которому необходим готовый OCR в графическом окне, TrOCR создаёт лишнюю техническую работу. В этом случае логичнее сопоставить его с полноценными приложениями. На Xeon Live есть обзор ABBYY FineReader, где OCR встроен в документный интерфейс.
Сравнение с реальными альтернативами
TrOCR стоит сопоставлять не по количеству кнопок, а по роли в системе. Он подходит как модель распознавания внутри собственного приложения. ABBYY FineReader закрывает настольный документный сценарий; OCR.space даёт веб-интерфейс и API; Capture2Text решает быстрый захват текста с экрана Windows. Эти продукты не являются взаимозаменяемыми по архитектуре, но пересекаются по конечной задаче — превратить изображённый текст в редактируемые данные.
- TrOCR: разработка собственного OCR-конвейера, line-level распознавание, выбор и дообучение моделей.
- ABBYY FineReader: готовая работа с документами, PDF и визуальным интерфейсом без написания Python-кода.
- OCR.space: браузерная обработка и API для изображений и PDF; удобно для быстрого внешнего сервиса.
- Capture2Text: локальный захват небольшой области экрана с последующим копированием распознанного текста.
Для облачного сценария полезен обзор OCR.space. Для моментального OCR фрагмента экрана — Capture2Text. TrOCR выигрывает не готовностью интерфейса, а гибкостью интеграции: разработчик сам определяет сегментацию, checkpoint, вычислительное окружение, хранение и проверку.
Практические рекомендации по выбору сценария
Для одного изображения начните с Base-checkpoint, подготовьте line-crop и запустите короткий пример Transformers. Для печати применяйте printed-вариант, для англоязычной рукописи — handwritten. Для кириллицы переходите на специально дообученную модель лишь после проверки на собственном наборе. Для PDF заблаговременно проектируйте рендеринг страниц и сегментацию строк: TrOCR не заменяет эти компоненты.
Для большого потока документов применяйте batch, храните соответствие между файлами и prediction, фиксируйте модель и версию окружения, а качество измеряйте на стабильной контрольной выборке. Large имеет смысл лишь после сравнения с Base по реальным метрикам и затратам. 8-битная загрузка уменьшает расход памяти, но не лечит ошибки данных и неверный checkpoint.
Для готового пользовательского OCR без разработки берите приложение или сервис с PDF-интерфейсом, просмотром страниц и экспортом. Для исследовательской или корпоративной интеграции TrOCR остаётся удобным конструктором: модель хорошо отделена от внешней логики, по этой причине детектор строк, очередь задач, ручная верификация и экспорт выбираются под конкретный процесс.