Xtracta — облачная система интеллектуальной обработки документов: она принимает PDF, сканы, фотографии и офисные файлы, извлекает реквизиты и повторяющиеся строки, применяет преобразования и проверки, а затем передаёт структурированные данные дальше. На странице Xeon Live можно скачать Xtracta бесплатно и быстро перейти к сервису; ниже разберём рабочий процесс без рекламных обещаний — от первой загрузки до контроля итога и интеграции.
Xtracta в двух словах: назначение и границы
Xtracta не редактирует страницы PDF как обычный PDF-редактор. Её задача — превратить неоднородные документы в данные для учётных, финансовых, логистических и отраслевых систем. Основой служит workflow: набор полей, правил, очередей проверки и методов вывода.
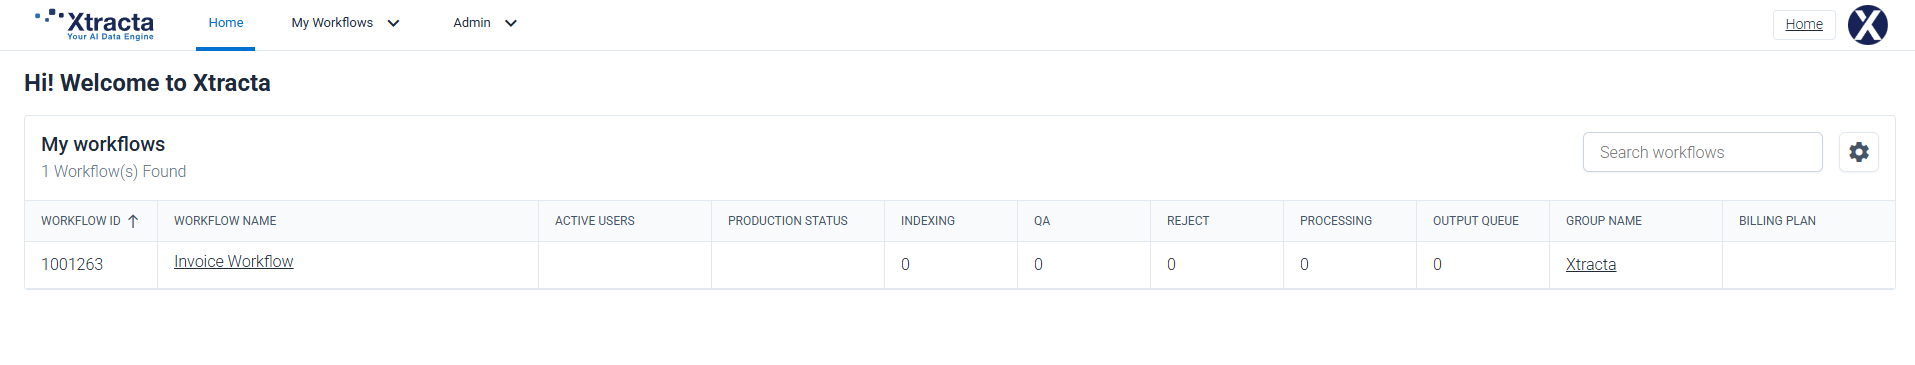
Сервис работает через браузер. На домашнем экране видны доступные workflow и счётчики Indexing, QA, Reject, Processing и Output Queue. Они показывают, где именно накапливаются документы и на каком этапе требуется вмешательство.
Xtracta требует заблаговременно описанного процесса: полей, повторяющихся наборов, очистки, проверок, справочников и вывода. Она автоматизирует повторяемую часть работы, но не заменяет профессиональное решение по содержанию документа.
Интерфейс Xtracta: карта рабочих областей
Интерфейс разделён на Dashboard для потока документов и New ELS для работы с конкретным файлом. Dashboard хранит очереди и статусы, а New ELS показывает страницу, извлечённые поля, повторяющиеся строки, сведения о Class и Design и действия над документом.
Dashboard: очереди, фильтры и состояние документов
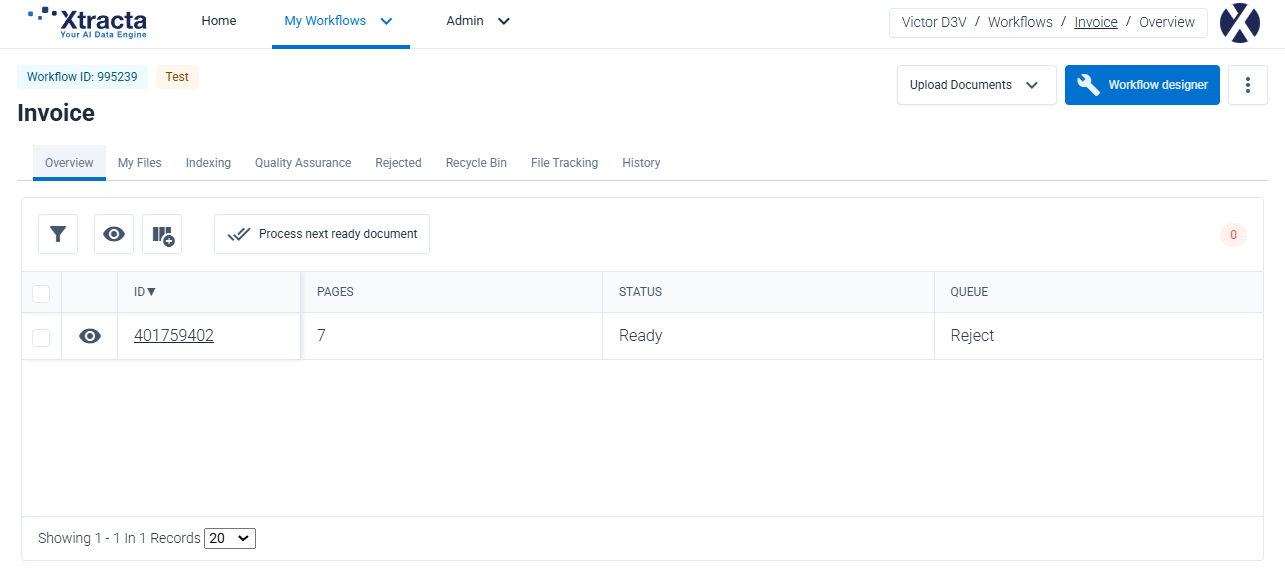
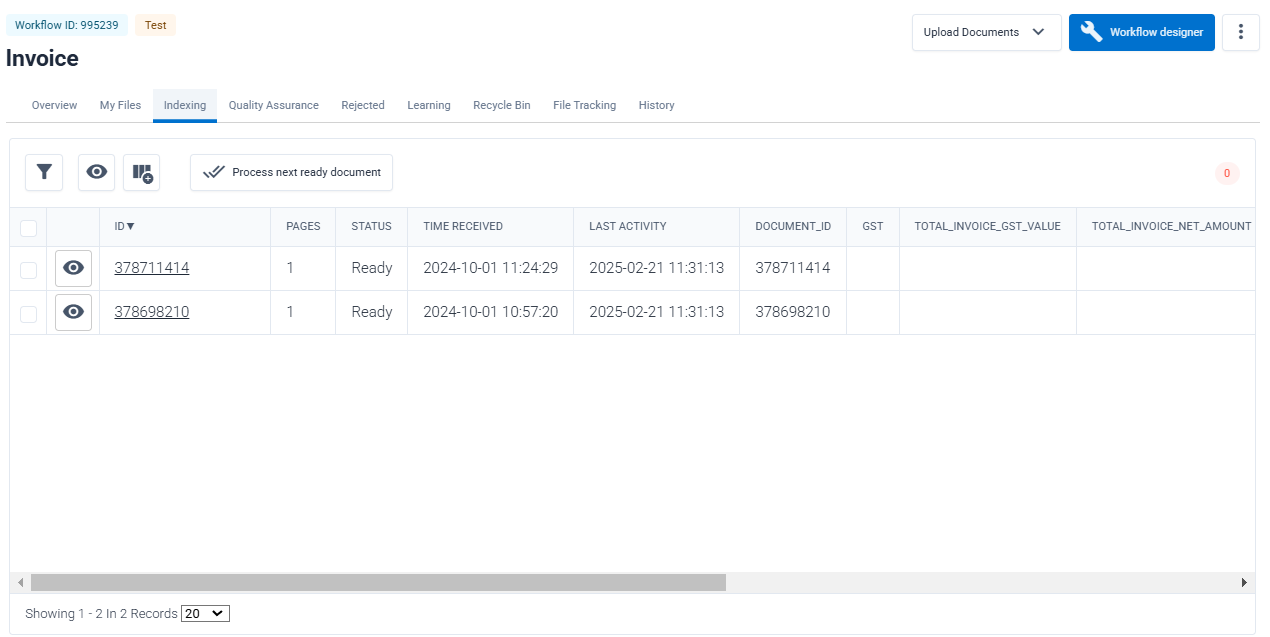
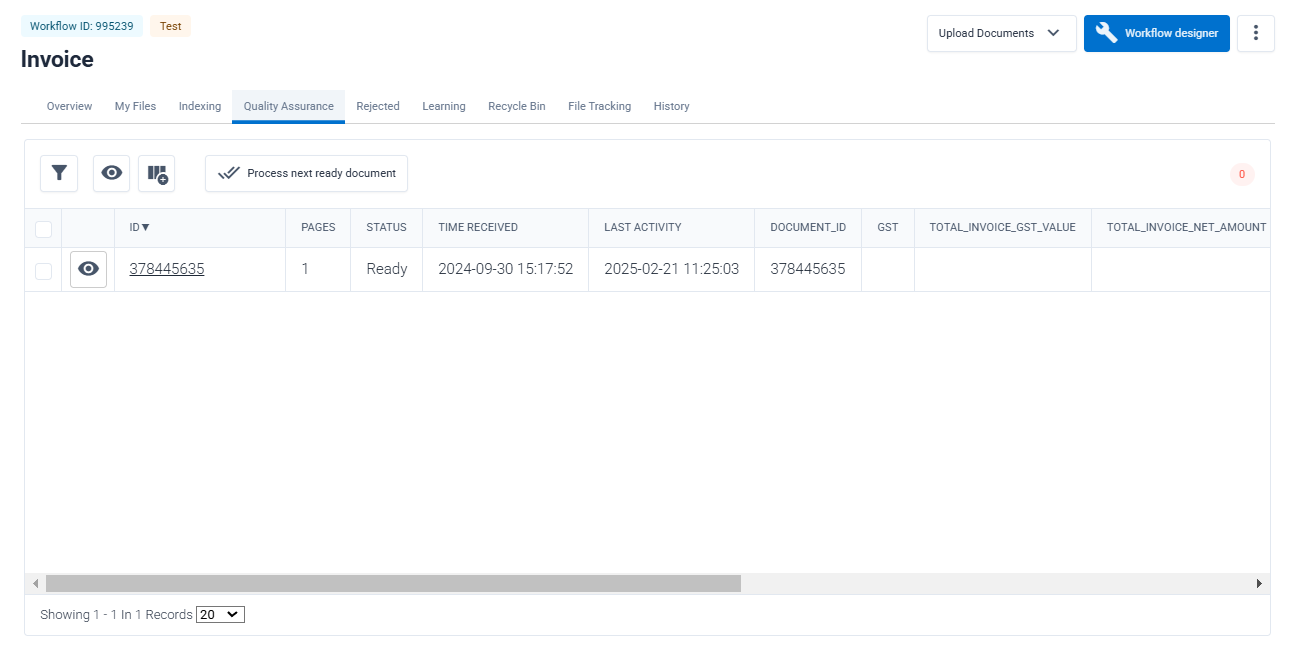
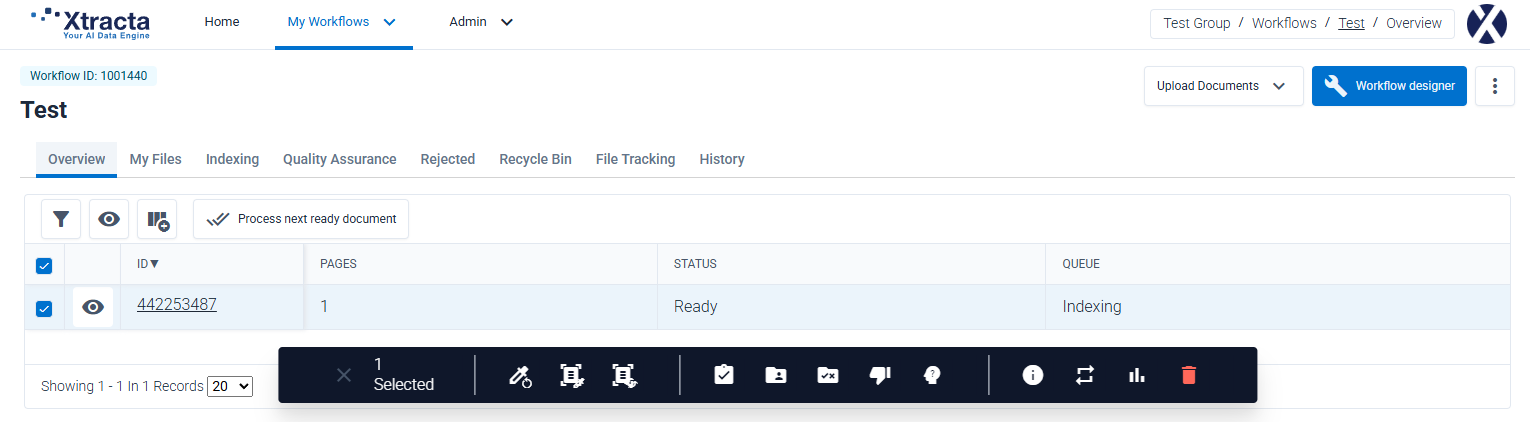
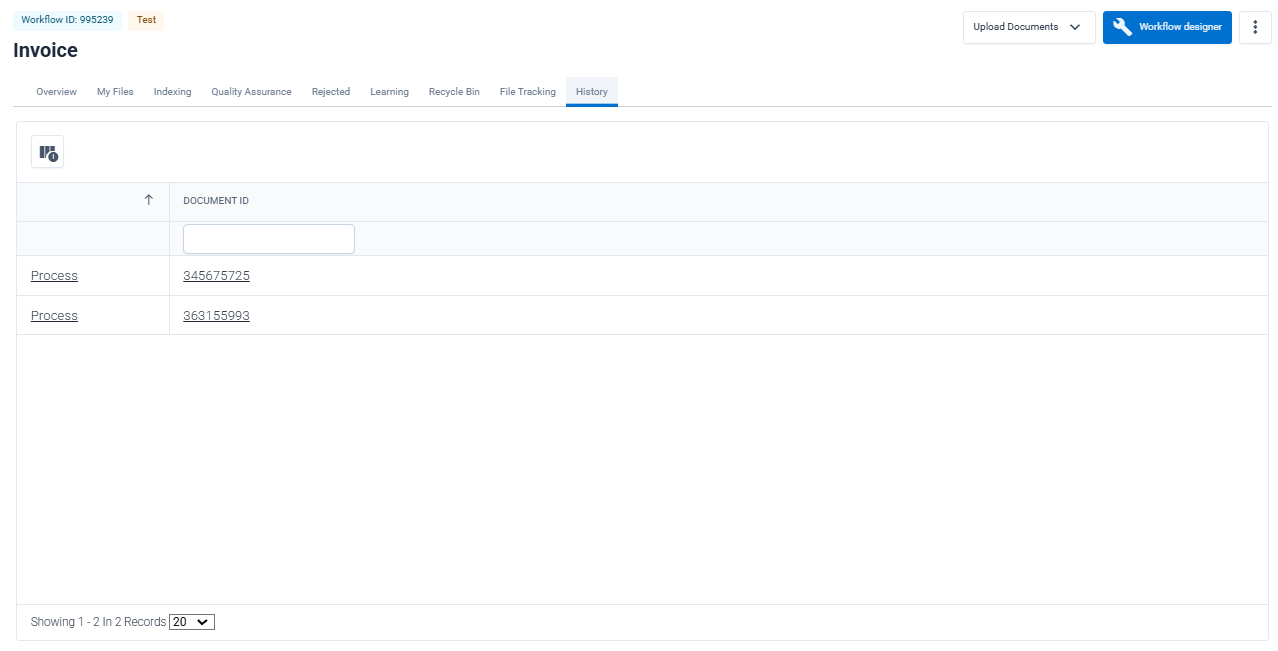
После выбора workflow открывается Dashboard. В верхней части размещены Overview, My Files, Indexing, Quality Assurance, Rejected, Recycle Bin, File Tracking и History. Таблица ниже содержит ID, количество страниц, статус, очередь, время получения, последнюю активность и добавочные бизнес-поля, которые выведены администратором. Кнопка Process next ready document берёт следующую готовую запись без ручного поиска, а фильтр помогает сузить набор по нужному состоянию или значению.
Overview даёт общий контроль, Indexing — ручную проверку и обучение, QA — второй уровень контроля. My Files закрепляет документ за оператором, Rejected показывает причину отказа, File Tracking — хронологию, History — уже обработанные записи.
New ELS: документ, поля и таблица в одном экране
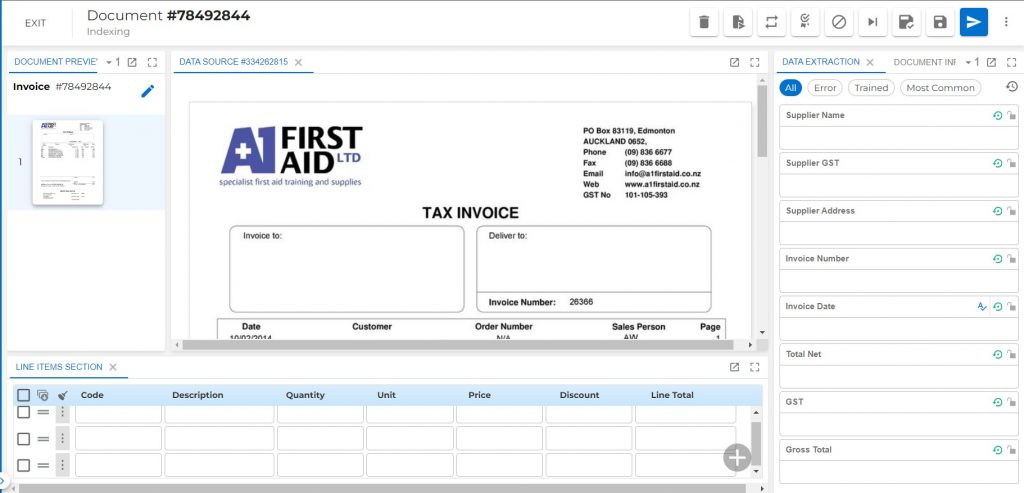
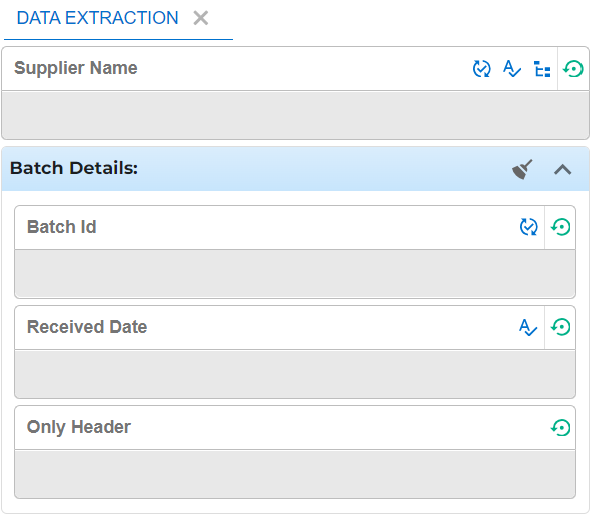
New ELS объединяет несколько панелей. Document Preview показывает страницы и позволяет управлять многостраничным файлом. Центральная область Data Source показывает сам документ. Справа Data Extraction выводит поля шапки и текущие значения. Внизу Repeating Field Set ведёт себя как электронная таблица для строк товаров, транзакций или других повторяющихся записей. Document Information показывает Class, Design, Page Count и Revision — эти сведения в особенности важны при диагностике неверного обучения.
В верхней панели находятся действия над текущим документом. Exit & Unlock возвращает запись в прежнее состояние без окончания. Save сохраняет исправления без обучения. Save and Learn закрывает документ и передаёт подтверждённые значения в обучение согласно конфигурации. Output заканчивает обработку и запускает настроенные выходы. Send to QA переводит запись на добавочную проверку, Reject Document отправляет её в отклонённые с причиной, My Files закрепляет за текущим пользователем, Reassign переносит в другой доступный workflow.
Как загрузить документ и довести его до Indexing
Первый практический сценарий — ручная загрузка и контроль того, что документ дошёл до очереди проверки. Он подходит для первоначальной настройки workflow, тестовой партии и единичных файлов. Перед началом определите, в какой workflow должен попасть документ: одинаковый PDF, отправленный в поток счетов и в поток договоров, будет обрабатываться по различным полям и правилам.
Загрузка через Web Uploader
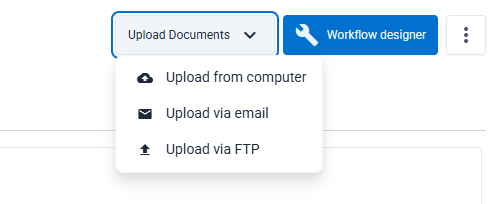
- Откройте My Workflows и выберите нужный workflow. Проверьте его наименование и назначение, чтобы не смешать различные типы документов.
- Нажмите Upload Documents и выберите Upload from computer. В появившемся окне перетащите файл или выберите его через системный диалог.
- До отправки убедитесь, что документ открывается без пароля. Xtracta принимает PDF, DOC, DOCX, ODS, ODT, XLS, XLSX, а среди изображений — GIF, HEIC, JPG/JPE/JPEG, PNG, TIF и TIFF.
- Для Web Uploader учитывайте предел размера отдельного файла 100 МБ и максимальный размер POST 110 МБ. Файл крупнее следует подготовить заблаговременно или направить по поддерживаемому каналу, рассчитанному на больший объём.
- После загрузки вернитесь в Dashboard. Новый документ получает Document ID и сперва проходит pre-processing: подготовку страниц, OCR, классификацию, извлечение, преобразования и проверки.
- Не нажимайте повторную загрузку только потому, что запись несколько минут остаётся в Processing. Сперва проверьте Page Count, размер исходника и Last Activity; повторная отправка создаст ещё один документ и усложнит контроль дублей.
Для сканов качество исходника напрямую влияет на распознавание. Страница должна быть целиком в кадре, без блика, перспективного искажения и обрезанных полей. Для цифрового PDF сохраняйте исходный файл, а не фотографию экрана. В отдельной инструкции Xeon Live разобраны базовые принципы распознавания текста в PDF, которые полезны при подготовке проблемных сканов до загрузки в Xtracta.
Как убедиться, что файл попал в нужную очередь
- Откройте Overview и найдите запись по Document ID. Для теста удобнее фиксировать ID непосредственно после появления документа — он связывает Dashboard, File Tracking и дальнейшие операции.
- Проверьте STATUS. Ready означает, что первичная обработка завершилась и запись доступна для ручной работы. Processing означает, что один из этапов ещё не закончен.
- Посмотрите QUEUE. Для нового workflow ожидаемым местом обычно становится Indexing, потому что первые документы требуют проверки и обучения. Конкретное направление задаётся конфигурацией workflow.
- Откройте вкладку Indexing и убедитесь, что строка появилась там. Значок глаза открывает документ, а Process next ready document берёт следующую готовую запись.
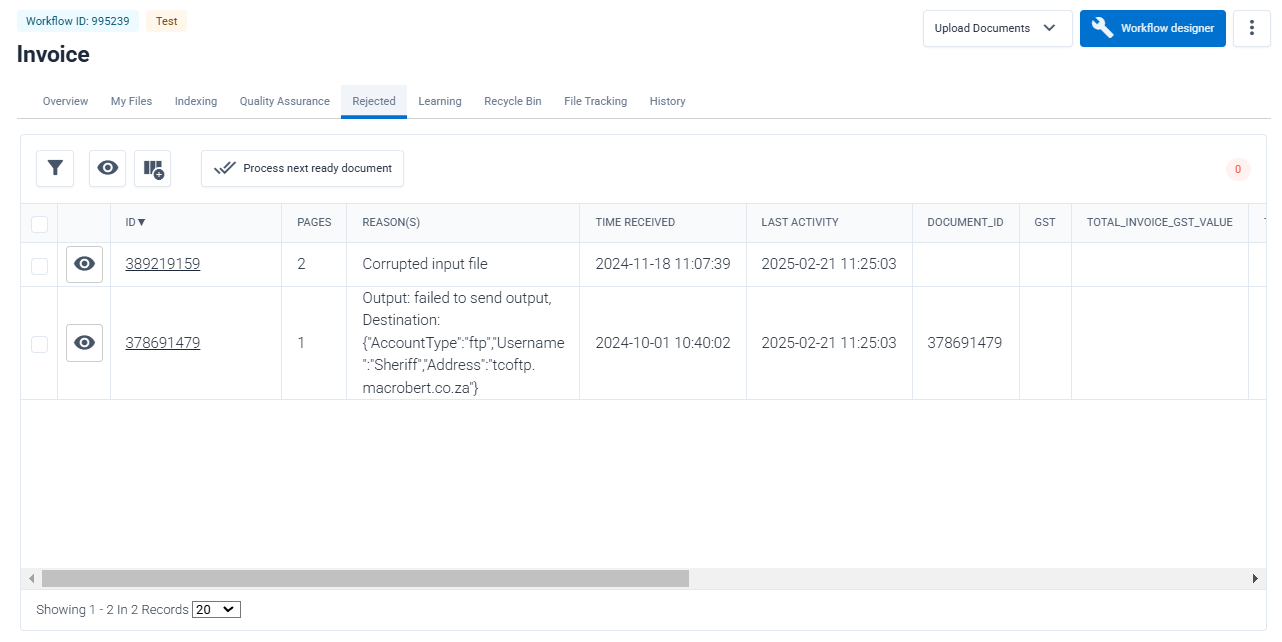
- При отсутствии документа проверьте Rejected и Error Documents. Rejected относится к нарушениям валидации после извлечения, Error Documents — к файлам, которые система не способна нормально обработать из-за пароля, физических размеров, числа страниц или других входных проблем.
- Для задержки откройте File Tracking и сравните Received Time и Last Activity. Так видно, в самом деле ли обработка продолжается, запись закреплена пользователем или остановилась на следующем этапе.
После этого исходная задача считается выполненной только тогда, когда документ имеет понятный статус и находится в ожидаемой очереди. Для рабочего процесса важен не факт успешной загрузки, а предсказуемое прохождение до Indexing, QA, Rejected или Output. Такой контроль предотвращает ситуацию, когда файл физически принят, но неделями остаётся в личной очереди или в pre-processing.
Как проверить и исправить извлечённые поля в New ELS
Основная операторская работа выполняется в New ELS. Цель — не перепечатать документ ручным способом, а подтвердить правильные значения, исправить ошибки и понять их источник. Важно разделять три уровня: OCR прочитал текст, модель выбрала нужный фрагмент, затем правила преобразовали итог. Ошибка на каждом уровне исправляется по-разному.
Проверка полей шапки и ручное выделение значения
- Откройте документ из Indexing. Сперва посмотрите Document Information и убедитесь, что Class и Design соответствуют типу документа. Неверная классификация делает последующее обучение полей рискованным.
- Перейдите в Data Extraction. Начните с обязательных полей: поставщик, номер документа, дата, валюта, сумма, номер заказа или другие поля, предусмотренные конкретным workflow.
- Выберите поле и отыщите соответствующий фрагмент на странице. Автоматически извлечённые значения подсвечиваются зелёным, ручное выделение — синим.
- При неверном значении выделите правильный фрагмент на документе. Старайтесь выбирать само значение без подписи и лишних соседних символов: модель должна учиться на содержимом поля, а не на случайном заголовке.
- Сверьте итог после преобразований. У суммы проверьте десятичный разделитель и знак, у даты — порядок дня, месяца и года, у идентификатора — ведущие нули и похожие символы.
- При непонятной подмене временно отключите для поля Strip and Replace, Data Matching или Auto Format через доступные переключатели New ELS. Сопоставьте исходное распознанное значение с итогом после каждого этапа.
- Если проблема находится в OCR, не обучайте поле на ошибочно прочитанной строке. Исправьте качество исходника или примените повторное OCR, затем вновь проверьте выделение.
Фильтры Error, Trained и Most Common сокращают панель до нужного набора. Error удобен для документа с несколькими десятками полей: оператор сперва разбирает только нарушения. Trained показывает значения, пришедшие из обученной модели. Most Common выводит часто вводимые пользователями варианты. Clear All Fields удаляет текущие значения, а Reload Prefilled Data возвращает заранее заполненные данные, по этой причине обе команды следует применять осознанно.
Проверка строк таблицы в Repeating Field Set
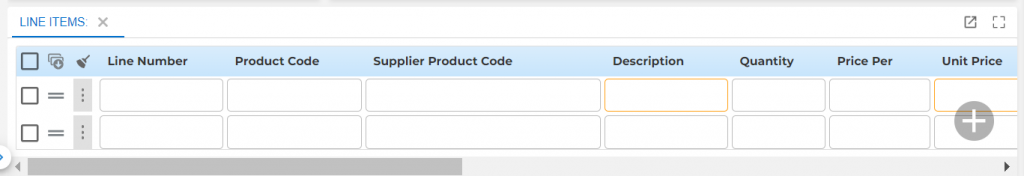
- Перейдите в Repeating Field Set и сопоставьте колонки с фактической таблицей документа. Для счёта это обычно код, описание, количество, единица, цена, скидка, налог и итог строки; конкретный набор задаёт workflow.
- Сперва сопоставьте число строк в ELS с числом строк в исходном документе. Лишняя строка зачастую появляется из-за переноса описания, а пропущенная — из-за нестабильной структуры или слабого распознавания.
- Проверяйте строки последовательно слева направо. Один неверный столбец способен вызвать арифметическое отклонение всего документа, по этой причине удобнее сперва восстановить структуру таблицы, затем суммы.
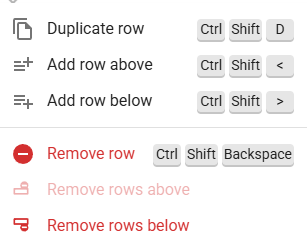
- При пропущенной записи применяйте Add Row. Для повторяющегося значения применяйте Duplicate Row или Copy Value to Fields Below, когда это соответствует документу.
- При лишней записи удалите строку через Row Options. Не очищайте всю колонку, если ошибка локальная: Clear Column Data удаляет значения по всем строкам текущего столбца.
- Если данные попали не в тот столбец, примените Swap Column Data или Move Column Data. После переноса проверьте минимум первую, среднюю и последнюю строки, чтобы убедиться, что операция затронула ожидаемый диапазон.
- В конце сверьте количество строк и арифметику. Для банковской выписки вдобавок сопоставьте начальный и конечный баланс; для счёта — суммы строк, налог и итог документа.
При точечном извлечении таблиц из текстовых PDF полезно понимать разницу между специализированным табличным инструментом и системой документного потока. В материале Xeon Live о том, как извлечь таблицу из PDF, рассмотрены отдельные методы. Xtracta идёт дальше: повторяющиеся строки становятся частью общего workflow вместе с проверкой, обучением и выводом.
Как ускорить работу с колонками, строками и навигацией
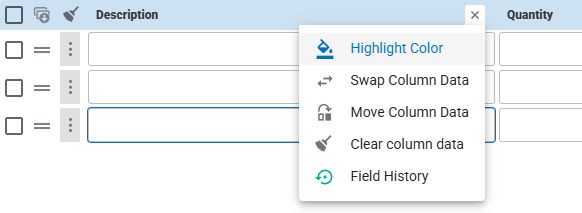
- Наведите указатель на заголовок колонки и откройте Column Options. Highlight Color задаёт цвет подсветки для выбранного столбца; Random быстро разносит цвета по колонкам.
- Применяйте различные цвета для визуально похожих полей, к примеру количества, цены и итоговой суммы. Настройка сохраняется для пользователя и уменьшает риск выделить число не в ту колонку.
- Для строк применяйте сочетания, показанные в Row Options: Duplicate Row — Ctrl+Shift+D, Add row above — Ctrl+Shift+<, Add row below — Ctrl+Shift+>, Remove row — Ctrl+Shift+Backspace.
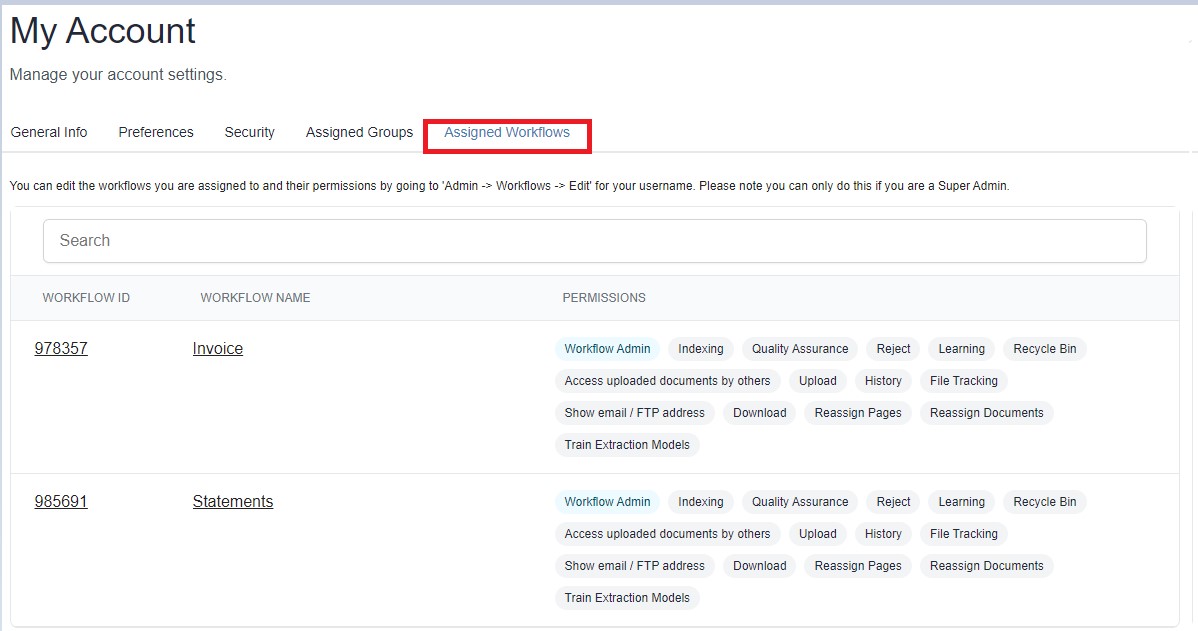
- В Preferences включите Scroll on Tab Press. После этого клавиша Tab переводит фокус между полями и прокручивает ELS к следующему значению, что ускоряет последовательную проверку длинной формы.
- После настройки пройдите один документ полностью только клавиатурой там, где это удобно, и отметьте места, где всё равно требуется выделение мышью. Так рабочее место настраивается под реальный поток, а не под абстрактный набор команд.
Как обучать Xtracta и сокращать ручные исправления
Обучение в Xtracta строится вокруг подтверждённых примеров. Программа различает простое сохранение и передачу данных в обучение, по этой причине оператору важно не нажимать Save and Learn автоматически. Случайный плохой скан, единичная рукописная пометка или документ с неверным классом не должен становиться образцом для последующих файлов.
Learn & Extract для однотипных строк
- Откройте документ в New ELS и перейдите к повторяющемуся набору. Для чистого обучения удобно удалить явно ошибочные автоматически созданные строки и добавить одну корректную строку.
- В первой строке по очереди выделите значения на документе для каждой нужной колонки. Сохраняйте одинаковую логику выбора: код только из колонки кода, цена только из цены, описание без соседних ячеек.
- После разметки хотя бы одной строки нажмите Learn & Extract. Xtracta применит распознанный рисунок к остальным строкам текущей таблицы.
- Для сложной структуры обучите две или больше строк до запуска Learn & Extract. Это в особенности важно при переносах описания, пустых ячейках, различных форматах количества и нескольких ставках налога.
- Проверьте верх таблицы, середину и последнюю строку. Сопоставьте число созданных записей с документом и убедитесь, что итоги не были приняты за обычные товарные строки.
- Исправьте локальные ошибки. Learn & Extract ускоряет первичное заполнение, но не отменяет контроль итога.
- Закончите документ через Save and Learn или Output лишь после полной проверки. Само применение Learn & Extract не запускает долговременное обучение модели.
Для нестабильных таблиц полезнее несколько аккуратно размеченных документов, чем большой набор с противоречивыми примерами. В обучающую выборку стоит включить различные длины таблиц, валюты, кредит-ноты, цифровые PDF и сканы. Цель — показать повторяющиеся закономерности, а не запомнить один конкретный лист.
Field History, Class и Design: как понять причину ошибки
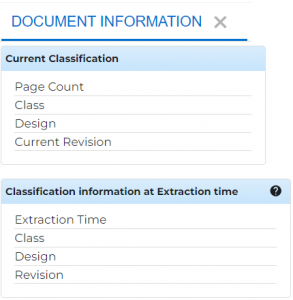
- При повторяющейся ошибке откройте Document Information и сравните Current Classification с ожидаемыми Class и Design. Несоответствие класса исправляется до обучения полей.
- В меню поля откройте Field History. Learning History показывает прежние примеры обучения, которые влияют на выбранное поле, когда эта функция включена в workflow.
- Перейдите в Data History, чтобы увидеть изменения текущего поля: исходное и обновлённые значения, пользователя или System, ревизию и время изменения.
- Сопоставьте историю с текущей подсветкой на документе. Старый пример от прежнего макета поясняет систематический выбор соседней подписи или неправильной области.
- Исправьте текущий документ и выполните Save and Learn лишь после подтверждения, что он относится к правильному Class и Design.
- На следующих документах того же типа контролируйте зелёную автоматическую подсветку и число ручных исправлений. Улучшение определяется повторяемым итогом, а не успешным сохранением одного примера.
Design описывает визуальный вариант внутри одного класса. Один поставщик в самом деле присылает несколько вариантов счёта — старую и новую форму, различные языки, документы из различных систем. Их объединяют по бизнес-смыслу полей, но обучение должно учитывать устойчивый макет. Создание отдельного дизайна для каждого единичного документа, наоборот, дробит модель и усложняет сопровождение.
Как разделять, переставлять и переназначать страницы
Многостраничные пакеты требуют отдельного контроля. Один PDF содержит либо один логический документ на нескольких страницах, либо несколько документов, склеенных вместе. Неверная граница ломает классификацию, количество строк и итоговые суммы, по этой причине разделение выполняется до обучения извлечения.
Ручное разделение и перестановка в New ELS
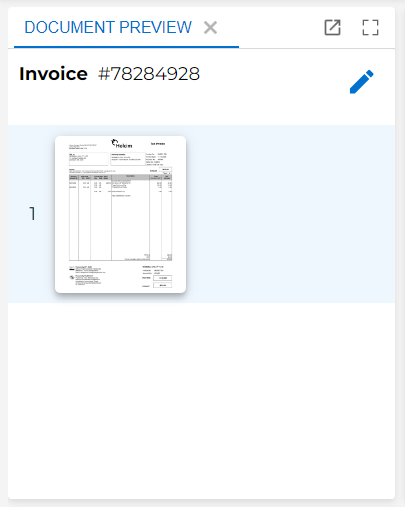
- Загрузите многостраничный файл и откройте его в New ELS. В Document Preview убедитесь, что все страницы присутствуют и идут в ожидаемом порядке.
- Откройте Edit Document в верхней части панели страниц. Между страницами появятся точки разделения.
- Отыщите границу, после которой начинается новый логический документ, и нажмите Split Document. Страницы после выбранной границы образуют новую запись.
- Повторите операцию лишь на реальных границах документов. Не делите выписку по каждой странице, когда таблица и баланс продолжаются на следующем листе.
- При неправильном порядке перетащите страницы в нужную последовательность. При ошибочном действии применяйте Undo.
- Сохраните изменения. Изменённые документы проходят повторное извлечение, по этой причине после разделения повторно проверьте Class, Design, количество страниц и строки.
- Зафиксируйте новые Document ID. Каждая созданная часть становится самостоятельным документом, и интеграция должна учитывать связь с исходным пакетом.
Автоматическое разделение и Reassign Pages
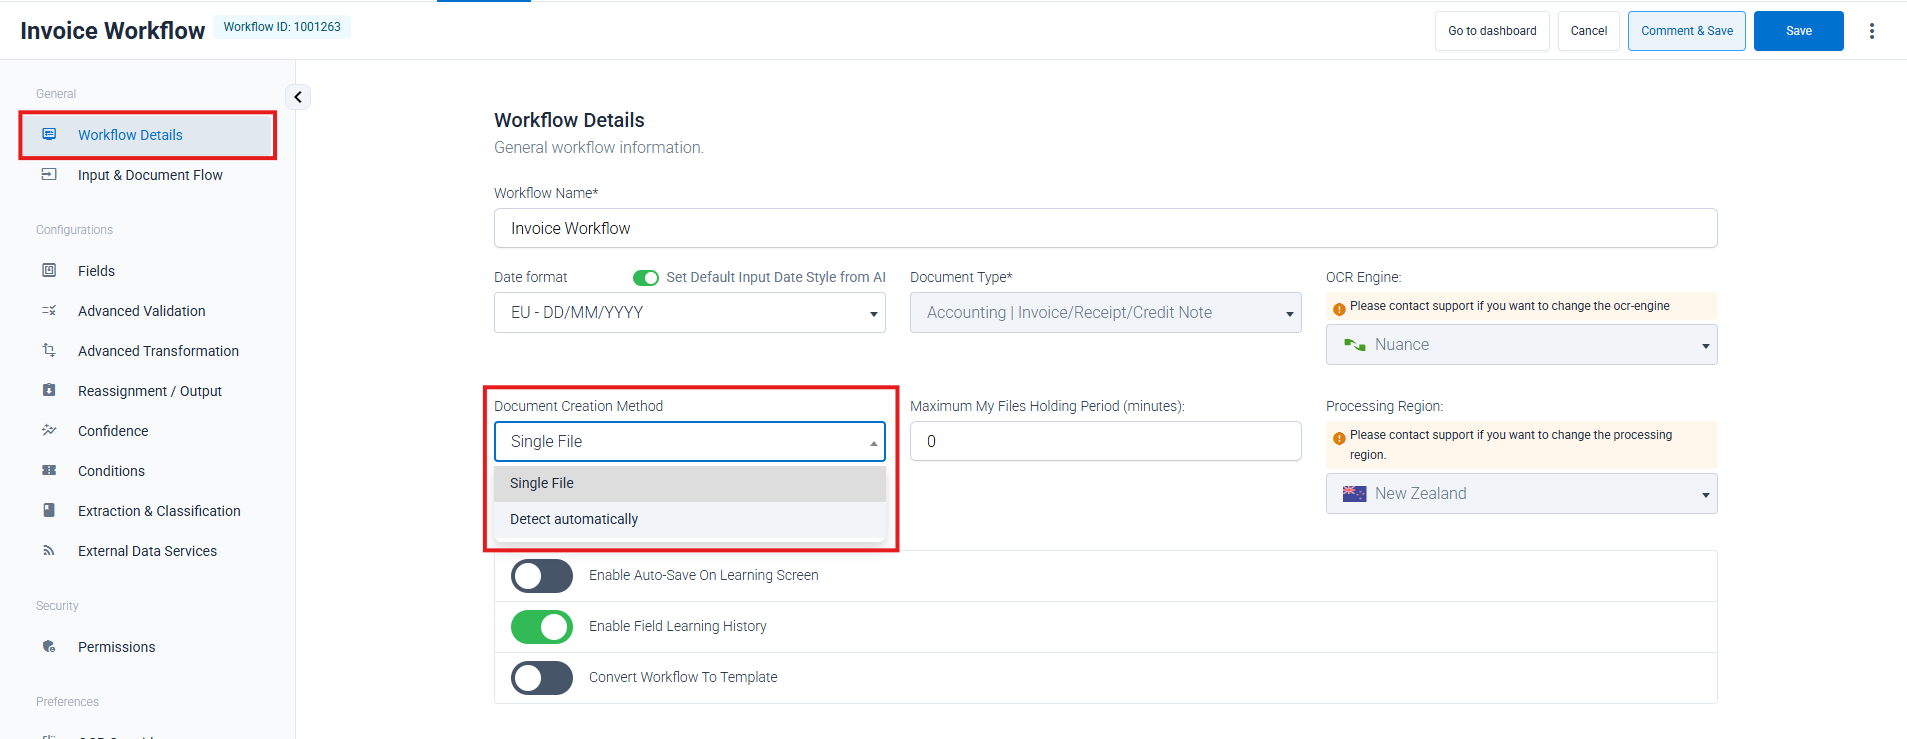
- Откройте Workflow Designer и перейдите в настройки Input & Document Flow. В параметре Document Creation Method выберите Detect automatically только для потока, где регулярные пакеты в самом деле содержат несколько документов.
- Подготовьте тестовую серию: чистые границы, пустые страницы, приложения и варианты без явного заголовка. Пропустите её через workflow и сопоставьте созданные Document ID с ожидаемым количеством документов.
- При ошибочном разделении вернитесь в Dashboard и применяйте Reassign Pages. Укажите Source Document ID и номера Source Pages, которые необходимо перенести.
- Для создания самостоятельной записи выберите Target Type New. Для возврата страниц к существующему документу применяйте существующую целевую запись и укажите позицию вставки.
- После Reassign дождитесь повторной обработки и откройте получившиеся документы. Проверьте порядок страниц, классификацию и извлечённые суммы.
- Если один и тот же тип постоянно делится неправильно, корректируйте настройку процесса и обучающие примеры. Ручное переназначение подходит для исключений, а не для постоянной компенсации плохой конфигурации.
Авторазделение влияет и на учёт применения сервиса: после разделения появляются отдельные идентификаторы документов. По этой причине тестирование на репрезентативной серии важно не только для точности, но и для предсказуемого объёма обработки.
Как настроить OCR, преобразования и валидации
После базового обучения наступает этап, который сильнее всего влияет на стабильность автоматизации: выбор OCR и правил после распознавания. В Xtracta обработка идёт последовательно: OCR, Class и Design, извлечение, Strip and Replace, Auto Format, расчёты дат, объединение полей, Data Matching, математические расчёты, индивидуальные и расширенные валидации, затем направление в нужную очередь или Output. Ошибку необходимо искать на том этапе, где значение впервые стало неправильным.
Выбор OCR Engine и повторное распознавание
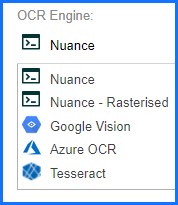
- Откройте Workflow Designer и найдите OCR Engine. Доступны Nuance, Nuance Rasterized, Tesseract, Google Vision и Azure OCR.
- Для цифровых PDF начните с Nuance, который документация Xtracta рекомендует как основной вариант. Для сканов применяйте Nuance Rasterized, когда растровая обработка даёт более стабильный итог.
- Для проблемного шрифта и специальных символов сопоставьте Tesseract. Для сложных изображений сопоставьте Azure OCR и Google Vision на одинаковом наборе обезличенных документов.
- Учтите маршрут данных: при Azure OCR и Google Vision документ передаётся соответствующему внешнему поставщику OCR; Nuance и Tesseract обрабатываются внутри инфраструктуры Xtracta. Это решение должно соответствовать политике обработки конфиденциальных материалов.
- После смены OCR ещё раз проверьте не только текст, но и извлечение полей. Различные движки создают отличающиеся координаты и идентификаторы слов, по этой причине старые обучающие примеры ведут себя иначе.
- Для единичного документа применяйте Re-OCR then Re-Extract из массовых действий. Для системной проблемы изменяйте workflow после контролируемого сравнения на тестовой серии.
Русский текст поддерживается несколькими доступными методами, включая Nuance, Google Vision и Azure. Для смешанных документов отдельно проверяйте коды, номера и даты: визуально похожие кириллические и латинские символы портят идентификатор даже при читаемом слове. Форматная проверка и сопоставление со справочником выявляют такие ошибки надёжнее визуальной оценки.
Strip and Replace, Auto Format, Data Matching и проверки
- Выберите одно проблемное поле и проследите его цепочку. Сперва сопоставьте выделенный текст с тем, что OCR реально прочитал на странице.
- Проверьте Strip and Replace. Правила выполняются в порядке полей и в порядке самих правил. Удаляйте только устойчивые лишние символы: валютные знаки, префиксы, пробелы или служебные части.
- Проверьте Auto Format. Для дат убедитесь, что ожидаемый формат соответствует региону входных документов. Для сумм сопоставьте десятичный и тысячный разделители.
- Проверьте Data Matching. Сопоставление работает со справочниками и запускается циклически до прекращения изменений, по этой причине правила не должны возвращать значения в предыдущее состояние.
- Добавьте индивидуальные валидации обязательности и формата. Критические требования оформляйте как hard validation; допустимые исключения — как soft validation, которую оператор способен осознанно подтвердить.
- Для сумм применяйте расширенную математическую проверку. Учитывайте округление, отрицательные значения, кредит-ноты, несколько ставок налога и варианты налога, включённого в цену.
- Пропустите через workflow положительные и отрицательные примеры. Корректный документ должен доходить до Indexing, QA или Output, а документ с нарушением — попадать в Rejected с понятной причиной.
- При массовом одинаковом Reject исправляйте правило в workflow. Ручное исправление сотен документов скрывает конфигурационную ошибку и не улучшает процесс.
Для сопоставления Xtracta применяет встроенные базы. В них хранят поставщиков, клиентов, налоговые ставки, товары и другие справочники; CSV импортирует новую базу или обновляет существующую. Перед подключением Data Matching удалите дубли и нормализуйте значения, иначе неоднозначные совпадения превращаются в скрытую бизнес-ошибку.
Как вывести итог и подключить API
После проверки документ должен покинуть операторскую очередь и передать данные потребителю. Xtracta поддерживает ручное и автоматическое окончание. Для интеграции доступны REST API и webhook, а в настройках вывода встречаются CSV, XLS, SQL, email, download, SFTP, OAuth и S3. Конкретный набор зависит от конфигурации workflow и прав пользователя.
Output, QA и безопасное окончание документа
- Перед Output проверьте обязательные поля, строки, итоговые суммы и причины мягких предупреждений. Выход должен запускаться лишь на подтверждённом документе.
- Для критичного процесса отправьте запись в Quality Assurance. QA сохраняет данные и передаёт документ другому уровню проверки, но не запускает конечный вывод.
- После независимой проверки откройте документ из QA и выполните Output. Xtracta запустит настроенные выходы и переведёт документ в финальное состояние согласно конфигурации.
- Не применяйте Save вместо Output для завершённого документа. Save сохраняет текущие правки и возвращает запись в прежнюю очередь, по этой причине она продолжает ждать обработки.
- Не применяйте Skip для документа с важными исправлениями. Skip не заканчивает работу и несохранённые изменения теряются, когда автоматическое сохранение в workflow отключено.
- После Output проверьте принимающую систему. Успешное извлечение не доказывает успешную доставку: интеграция должна фиксировать Document ID, время, итог передачи и идентификатор созданной записи у получателя.
Базовая схема интеграции через REST API
- Храните API-токен на доверенном сервере. Не вставляйте его в браузерный JavaScript, общедоступный репозиторий, письмо или чат.
- Для отправки применяйте endpoint загрузки документа и передайте workflow_id вместе с файлом. При успешном приёме сохраните возвращённый Document ID в собственной системе.
- Не пытайтесь сразу получить конечные поля после загрузки. Обработка асинхронная: документ проходит pre-processing, OCR, извлечение, преобразования и проверки.
- Проверяйте состояние через Document API или принимайте webhook. Для собственного опроса задайте разумный интервал и прекращайте проверку после финального статуса.
- После готовности получите детальные данные документа. Для одного документа применяйте его ID, для серии — workflow_id и пагинацию.
- Обрабатывайте вложенные поля и repeating sets как структурированные данные, не как плоскую строку. Сохраняйте типы: суммы — числа, идентификаторы с ведущими нулями — строки, пустое значение — отдельно от нуля.
- После успешной загрузки в целевую систему пометьте документ обработанным в собственной базе и применяйте идемпотентную логику. Повторная доставка того же Document ID не должна создавать второй бухгалтерский документ.
- Для открытия операторского интерфейса из своей системы применяйте Open Document UI. Возвращаемая ссылка ограничена по времени; формируйте её при необходимости, а не храните как постоянный адрес.
- Для долгого хранения оригинала не полагайтесь на старый URL документа. Xtracta перемещает файлы между хранилищами, по этой причине при каждом просмотре через API получайте актуальную ссылку.
API в особенности полезен для программ, где Xtracta работает как встроенный слой document intelligence. Пользователь остаётся в своей ERP, бухгалтерской или отраслевой системе, а сервис получает файл, возвращает статус и структурированные данные. В таком варианте интерфейс Xtracta необходим администраторам и операторам исключений, а массовый поток идёт автоматически.
Как разбирать ошибки, задержки и повторную обработку
Диагностика в Xtracta эффективна только по этапам. Повторное обучение не исправляет повреждённый PDF, смена OCR не устраняет недоступный SFTP, а Force Reprocess не снимает пароль. Сперва определите, где впервые возникло отклонение: вход, OCR, классификация, извлечение, преобразование, валидация или вывод.
Rejected и Error Documents: различные причины и различные действия
- Для Rejected сперва прочитайте Reason(s). Отсутствующее обязательное поле, неверный формат и арифметическое расхождение исправляются в данных или правилах. Ошибка доставки требует проверки конечного канала.
- Откройте документ в ELS и сопоставьте подсветку, исходное OCR-значение и итог после преобразований. Исправляйте только тот уровень, где появляется ошибка.
- После коррекции ещё раз проверьте валидации и направьте документ в Output или QA. Не игнорируйте hard validation — такой документ не должен завершаться до исправления.
- Для Error Documents проверьте тип входной проблемы. Парольная защита, физический размер страницы и некоторые непропорциональные JPEG требуют исправления исходного файла.
- Документы свыше 300 страниц относятся к Error Documents. Для определённых случаев доступен Force Reprocess, а Limit Processed Pages сокращает обработку до первых и последних N страниц.
- Acknowledge только убирает ошибку из активного счётчика. Команда не исправляет файл и не запускает обработку заново.
- При массовом сбое возьмите один репрезентативный документ, сохраните его ID, текст ошибки и параметры, исправьте причину и повторите обработку лишь на нём. После подтверждения итога применяйте решение к партии.
Что делать, когда документ долго остаётся в Processing
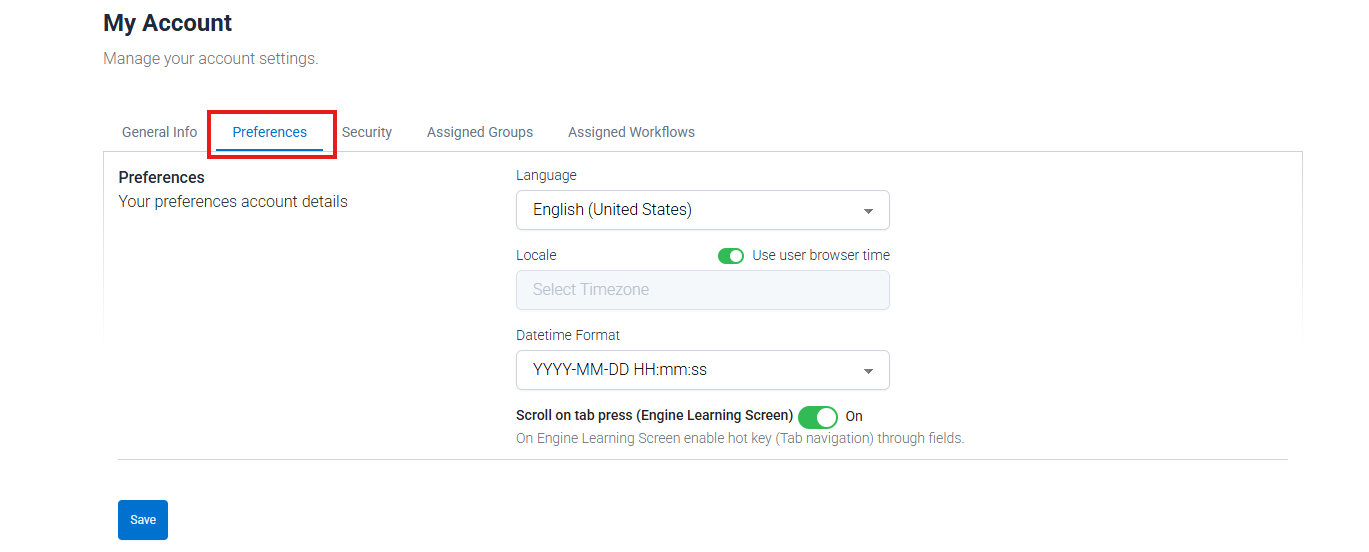
- Сперва откройте File Tracking и зафиксируйте Received Time и Last Activity. Большой интервал между ними показывает, что документ долго остаётся на одном этапе.
- Сопоставьте проблемный файл с нормальным: количество страниц, количество строк, размеры изображения и число активных правил. В Xtracta нагрузка растёт не только с размером PDF, но и с количеством значений в repeating sets.
- Для очень больших таблиц применяйте New ELS. Документация Xtracta прямо рекомендует новый экран как более эффективный для крупных и сложных документов.
- Уберите ненужные поля и преобразования из workflow. Сильное сжатие исходника не является оптимизацией: оно ухудшает OCR и увеличивает ручные исправления.
- Проверьте лимит плана. После исчерпания доступного количества новые документы остаются в pre-processing до обновления или изменения плана.
- Проверьте My Files. Запись, закреплённая отсутствующим сотрудником, выглядит как задержка процесса, хотя вычислительная обработка уже закончена.
- Проверьте Output Queue и принимающий канал. Документ с готовыми полями способен задержаться на передаче, по этой причине повторное OCR в такой ситуации ничего не меняет.
- После исправления причины сопоставьте Last Activity, финальный статус и данные в целевой системе. Только эта тройная проверка подтверждает восстановление потока.
Преимущества, недостатки и кому подходит Xtracta
Xtracta сильнее обычного OCR-сервиса там, где необходима связка распознавания, обучения, ручной проверки, справочников, правил и интеграции. Но именно эта глубина делает продукт избыточным для единичной задачи вроде копирования текста из одного PDF. Перед внедрением стоит оценивать не красивый пример распознавания, а весь путь документа: вход, исключения, подтверждение, аудит и вывод.
Плюсы
- Единый workflow от поступления документа до проверенного вывода данных.
- New ELS объединяет оригинал, поля, повторяющиеся строки и действия над документом.
- Обучение на подтверждённых примерах и отдельный Learn & Extract для повторяющихся строк.
- Очереди Indexing, QA, Rejected, My Files, History и File Tracking подходят для распределённой операторской работы.
- Поддерживаются преобразования, Data Matching, мягкие и жёсткие проверки, арифметика и справочники.
- Несколько методов поступления документов: Web Uploader, email, FTP(S) и API.
- REST API позволяет встроить обработку в существующую бизнес-систему и открывать ELS лишь для исключений.
Минусы
- Требуется проектирование workflow: набор полей, правила, проверки и вывод нельзя заменить одной универсальной кнопкой.
- Интерфейс ориентирован на английский язык, по этой причине русскоязычной команде необходим короткий внутренний регламент с наименованиями элементов.
- Качество зависит от исходных файлов и дисциплины обучения; ошибочный пример способен ухудшить последующее извлечение.
- Большие документы с множеством повторяющихся строк и правил дольше обрабатываются и открываются.
- Некоторые OCR-движки передают документ внешнему поставщику, что требует отдельного согласования для чувствительных данных.
- Старые сохранённые URL оригиналов нельзя считать постоянными; интеграция должна получать актуальные адреса через API.
Кому подойдёт
- Бухгалтерии и финансовым службам с постоянным потоком счетов, заказов и выписок.
- Логистическим и отраслевым системам, где необходимо извлекать данные из документов различных контрагентов.
- Командам, которым требуется операторская проверка исключений, второй уровень QA и аудит изменений.
- Разработчикам SaaS и корпоративных систем, которым необходим API-слой интеллектуального извлечения документов.
Кому не подойдёт
- Пользователю, которому необходимо один раз скопировать текст или таблицу из PDF без настройки процесса.
- Задачам полноценного визуального редактирования PDF, верстки страниц, аннотаций и подготовки документа к печати.
- Процессам без готовности описать поля, правила валидации, роли операторов и конечный формат данных.
Xtracta и альтернативы: что сопоставлять перед выбором

Сопоставлять Xtracta стоит с системами intelligent document processing. ABBYY Vantage, Rossum, Nanonets и Azure AI Document Intelligence решают сходную задачу, но различаются моделью обучения, операционным интерфейсом, интеграциями и тем, насколько готовый продукт закрывает весь путь документа.
Для разработческой архитектуры полезно отдельно изучить Azure AI Document Intelligence. Для автоматизации документов внутри более широких бизнес-процессов сопоставьте подход с Automation Anywhere Document Automation. А для узкой задачи извлечения таблиц из текстового PDF без корпоративного workflow достаточно более простого Tabula.
Выбор стоит проверять по пяти точкам: источники документов, разнообразие макетов, работа с исключениями, правила качества и конечная система. Xtracta в особенности уместна, когда эти этапы необходимо связать в один контролируемый процесс.
Итоговые рекомендации по запуску Xtracta
Начните с одного типа документа. Оставьте нужные поля, настройте repeating set, вход и OCR, загрузите тестовую серию. Первые документы ведите через Indexing и обучайте после проверки.
После стабилизации подключите Strip and Replace, Auto Format, Data Matching и валидации. Настройте понятный Reject, затем QA и разделение страниц. Автоматический Output и интеграцию включайте после того, как тестовая серия проходит предсказуемо.
Для эксплуатации разделите роли: оператор ведёт Indexing и исключения, контролёр принимает QA, администратор отвечает за workflow и права, интегратор — за API и конечный канал. File Tracking и Data History применяйте для аудита, Field History — для диагностики обучения.
Какие форматы принимает Xtracta?
Документация перечисляет PDF, DOC, DOCX, ODS, ODT, XLS, XLSX, а также GIF, HEIC, JPG/JPE/JPEG, PNG, TIF и TIFF.
Почему документ попал в Rejected?
Rejected означает, что извлечение состоялось, но одна или несколько настроенных проверок не прошли. В строке документа отображается причина.
Почему документ попал в Error Documents?
Типичные подтверждённые причины: парольная защита, более 300 страниц, физический размер страницы свыше 1700 мм и некоторые непропорциональные JPEG.
Чем Save отличается от Save and Learn?
Save сохраняет изменения без запуска обучения. Save and Learn закрывает документ и передаёт подтверждённые значения в обучение согласно настройке workflow.
Что делает Learn & Extract?
После ручной разметки одной или нескольких строк инструмент извлекает остальные строки по тому же устойчивому рисунку. Долговременное обучение запускается лишь после Output или Save and Learn.
Можно ли работать только через API?
API поддерживает загрузку документов, получение статусов и данных, изменение документа и открытие интерфейса обработки. Для исключений New ELS открывается по временной ссылке.