
Xpdf Tools — набор консольных утилит для анализа и преобразования PDF. Он необходим там, где действие должно повторяться без ручного открытия окна: извлечь текст, проверить шрифты, получить изображения, выгрузить вложения, построить PNG-превью или подготовить отчёт о свойствах документа. Базовую страницу Xeon Live, где можно скачать Xpdf Tools бесплатно, удобно применять как точку входа, а ниже разобрана рабочая схема для версии 4.06 с проверкой итога после каждого шага.
Главное отличие Xpdf Tools от обычного PDF-редактора — отсутствие единого графического окна. Интерфейсом служат команды pdftotext, pdfinfo, pdfimages, pdffonts, pdfdetach, pdftopng, pdftoppm, pdftops и pdftohtml. Такой подход требует аккуратной работы с путями и параметрами, зато хорошо подходит для пакетной обработки, серверных задач и воспроизводимых сценариев. Для понимания ограничений самого формата полезен отдельный материал о том, как устроен PDF и чем просмотр отличается от извлечения данных.
Для чего необходим Xpdf Tools и что входит в комплект
Xpdf Tools решает задачи чтения и преобразования содержимого, но не заменяет редактор. Утилиты не переставляют страницы, не рисуют аннотации, не меняют существующий текст и не выполняют OCR. На практике пакет удобен администраторам, разработчикам, архивистам, издательским командам и аналитикам, которым важно получить машинно обрабатываемый итог из большого числа PDF без ручных действий. Один процесс может сперва узнать количество страниц, затем извлечь текст, отдельно проверить шрифты и лишь после этого запустить рендер нужного диапазона.
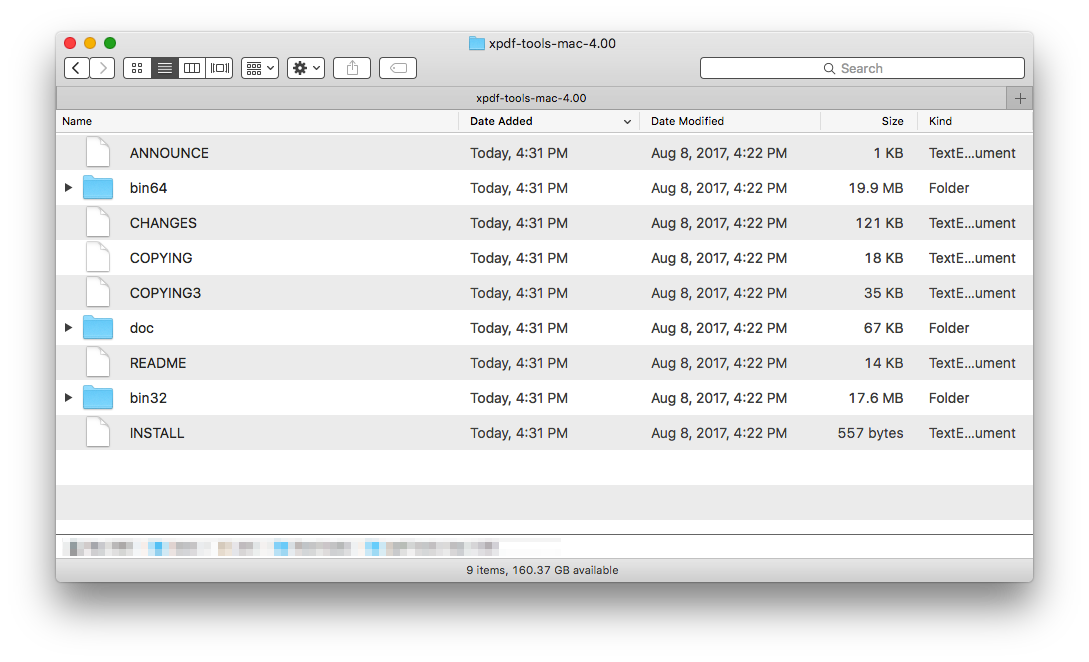
Комплект разделён по функциям. pdfinfo выдаёт свойства документа и сведения из информационного словаря; pdffonts перечисляет применённые шрифты; pdfimages извлекает встроенные растровые объекты; pdfdetach работает с файловыми вложениями. Остальные программы создают новое представление: pdftotext — текст, pdftohtml — HTML и ресурсы, pdftopng — PNG, pdftoppm — PBM/PGM/PPM, pdftops — PostScript или EPS в поддерживаемом режиме. Такое разделение уменьшает риск случайно выполнить не ту операцию: каждая команда имеет узкий итог и не изменяет исходный PDF.
- pdftotext — извлечение уже существующего текстового слоя в TXT или стандартный вывод.
- pdfinfo — число страниц, размер листа, версия PDF, шифрование, метаданные и другие технические свойства.
- pdffonts — диагностика шрифтов, встраивания, подмножеств и сопоставления символов.
- pdfimages — выгрузка растровых объектов без превращения всей страницы в картинку.
- pdfdetach — список и сохранение встроенных файлов.
- pdftopng / pdftoppm — растеризация страниц целиком.
- pdftohtml — HTML-представление с отдельными ресурсами.
- pdftops — PostScript для печатных и совместимых технических процессов.
Выбор утилиты начинается с формулировки итога. Для поиска слов необходим pdftotext, для изображения страницы — pdftopng, для исходной фотографии внутри PDF — pdfimages. Эти итоги нельзя считать взаимозаменяемыми: извлечённый JPEG не включает текст и векторную графику страницы, а отрендеренный PNG уже является новым растром. При работе со сканом отсутствие текста означает необходимость внешнего распознавания, а не неисправность Xpdf Tools.
Как подготовить Xpdf Tools к работе и проверить окружение
Рабочий процесс начинается не с массовой конвертации, а с проверки конкретного исполняемого файла. На Windows у Xpdf и Poppler встречаются одинаковые имена команд, по этой причине одного сообщения о том, что pdfinfo найден, недостаточно. Версия 4.06 идентифицируется выводом параметра -v, а полный путь фиксируется в сценарии. Это в особенности важно для планировщиков, служб и автоматизаторов, где переменная PATH отличается от интерактивного терминала.
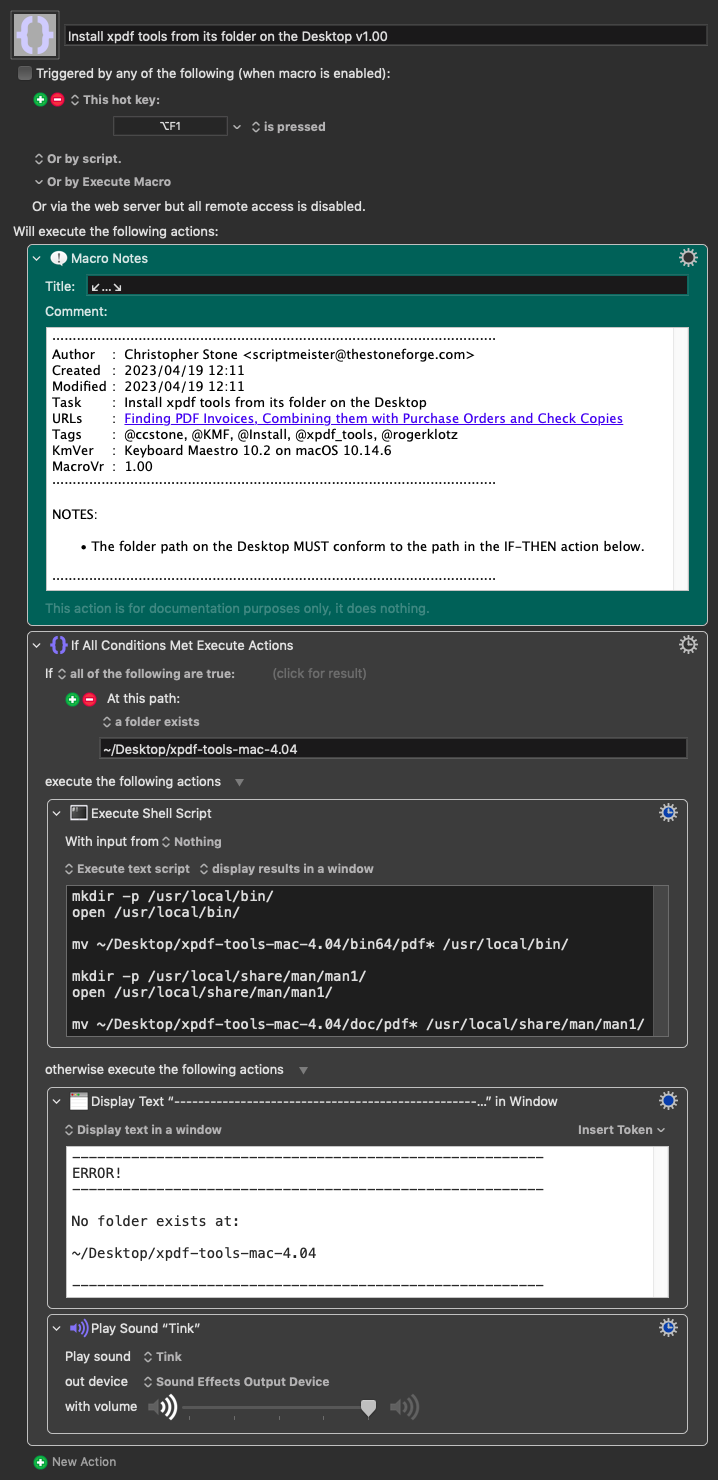
- Распакуйте текущий пакет Xpdf Tools 4.06 в постоянный каталог, а не запускайте исполняемые файлы из окна архива. На Windows рабочие бинарники выбирают из каталога нужной разрядности.
- Откройте Command Prompt, PowerShell или Terminal и перейдите в каталог с программами. Путь с пробелами всегда берите в двойные кавычки.
- Выполните pdfinfo -v. В выводе должно быть имя Xpdf и версия 4.06. На Windows для однозначности применяйте полный путь, к примеру C:\Tools\xpdf-tools-win-4.06\bin64\pdfinfo.exe -v.
- Выполните pdftotext -h и pdfimages -h. Справка подтверждает, что запускаются нужные программы, а не одноимённые утилиты из другого пакета.
- На Windows выполните where pdfinfo и where pdftotext; в PowerShell тоже работает Get-Command pdfinfo. На macOS и Linux применяйте command -v pdfinfo. Сверьте найденный путь с каталогом Xpdf.
- Создайте отдельную тестовую папку, положите туда небольшой PDF с понятным текстом и одной картинкой. Все первые команды выполняйте лишь на этой копии.
- Запустите pdfinfo для тестового файла и проверьте число страниц, размер страницы и состояние шифрования. Ненулевой код окончания фиксируйте до перехода к следующей операции.
- После успешной проверки сохраните полный путь к бинарникам в переменной сценария. Массовую обработку запускайте лишь после этого.
Установка в привычном смысле пакету не требуется: это набор исполняемых файлов и документации. На Unix-подобной системе важны права исполнения и реальный путь до бинарника. На Windows после изменения PATH уже открытое окно терминала не получает новое значение автоматически, по этой причине его закрывают и открывают заново. Для автоматизации полный путь надёжнее глобального PATH: он делает среду воспроизводимой и устраняет конфликт с Poppler utilities.
Проверка тестового документа должна содержать не только успешный код. Сопоставьте количество страниц из pdfinfo с просмотрщиком, затем извлеките текст одной страницы и убедитесь, что кириллица читается правильно. После этого запустите рендер одной страницы в PNG и откройте файл. Такая короткая цепочка подтверждает три независимые части: чтение структуры PDF, текстовый вывод и графический рендер.
Xpdf Tools применяет общий файл конфигурации xpdfrc. В Linux, Unix и macOS пользовательский файл называется ~/.xpdfrc; при его отсутствии проверяется системное расположение, обычно /etc/xpdfrc. На Windows файл называется xpdfrc без точки и расширения и располагается рядом с исполняемым файлом. Опция -cfg задаёт другой конфигурационный файл для конкретного запуска.
- Для переносимого проекта: храните свой xpdfrc рядом со сценарием и всегда передавайте его через -cfg. Тогда глобальная настройка пользователя не меняет итог.
- После изменения конфигурации: прогоните набор контрольных PDF с кириллицей, латиницей, таблицами и встроенными шрифтами. Сопоставляйте не только код окончания, но и содержимое TXT и PNG.
- При Config Error: сперва временно запустите команду с чистым конфигурационным файлом. Ошибка, исчезнувшая в чистой конфигурации, указывает на устаревший путь к карте символов, шрифту или другому ресурсу.
В рабочем каталоге заблаговременно разделите вход и итог. К примеру, input хранит исходные PDF, text — TXT, render — PNG, assets — извлечённые картинки, attachments — вложения, logs — журналы. Xpdf не обязан создавать все промежуточные папки. Каталоги формируют до запуска, а готовый файл перемещают из временного имени лишь после успешной проверки. Такой порядок предотвращает смешивание итогов различных документов и уменьшает риск принять отчасти записанный файл за законченный.
Как извлекать текст из PDF и проверять итог
pdftotext читает текстовые объекты PDF и превращает их в обычный текст. Он не распознаёт буквы на изображении. По этой причине правильная инструкция всегда содержит две проверки: наличие текстового слоя и пригодность восстановленного порядка чтения. Цифровой документ из офисной программы обычно даёт текст сразу; скан без OCR создаёт пустой или практически пустой итог.
Базовое извлечение, layout и диапазоны страниц
Для первого запуска лучше указать входной и выходной файлы явно. Базовая команда выглядит как pdftotext "report.pdf" "report.txt". Режим -layout старается сохранить физическое расположение текста пробелами и переводами строк; параметры -f и -l ограничивают диапазон страниц. Специальное имя - в позиции итога направляет текст в стандартный вывод, что удобно для конвейера без промежуточного TXT.
- Выполните pdfinfo "report.pdf" и запишите число страниц. Так диапазон не выходит за реальный документ.
- Запустите pdftotext "report.pdf" "report.txt". Непосредственно после окончания сохраните код процесса.
- Откройте report.txt как UTF-8 и проверьте начало, середину и конец. Наличие файла само по себе не подтверждает корректность текста.
- Для документа с таблицами или колонками создайте второй вариант: pdftotext -layout "report.pdf" "report-layout.txt". Сопоставьте порядок строк и расстояния между полями.
- Для точечной проверки применяйте диапазон, к примеру pdftotext -f 3 -l 7 "manual.pdf" "chapter.txt". Нумерация страниц в командах начинается с единицы.
- Для обработки следующей программой направьте текст в stdout: pdftotext -layout "invoice.pdf" -. В вызывающем процессе отделяйте stdout от stderr.
- При необходимости явно задайте кодировку: pdftotext -enc UTF-8 "input.pdf" "output.txt". Наличие UTF-8 затем проверяется редактором или собственным валидатором.
- Зафиксируйте метод извлечения рядом с итогом: версия Xpdf, режим, диапазон страниц и исходный файл. Это позволяет воспроизвести обработку после обновления.
В PDF текст часто хранится отдельными фрагментами с координатами, а не как готовые абзацы. Обычный режим pdftotext старается восстановить порядок чтения, а -layout сохраняет геометрию более буквально. Для отчёта с фиксированными колонками layout обычно полезнее, для полнотекстового поиска — естественный поток. Сложная газетная верстка, повернутые подписи и формы требуют контрольного сравнения нескольких режимов и проверки конкретных полей.
Для отдельной задачи преобразования удобно свериться с инструкцией как преобразовать PDF в TXT. Проблемы с копированием часто имеют ту же природу, по этой причине материал почему текст не копируется из PDF помогает отличить защиту, отсутствие текстового слоя и повреждённое сопоставление символов.
Как отличить текстовый PDF от скана
Сканированный документ хранит страницу как изображение. При отсутствии скрытого OCR-слоя pdftotext не получает символы. Диагностика строится не вокруг повторного запуска одной и той же команды, а вокруг сопоставления трёх признаков: размер TXT, возможность выделить слова в просмотрщике и наличие полноформатных растров по данным pdfimages -list.
- Извлеките одну характерную страницу через pdftotext -f N -l N "scan.pdf" -. Пустой вывод фиксируется как итог проверки, а не сразу как ошибка программы.
- Откройте ту же страницу в просмотрщике и попробуйте выделить отдельное слово. Отсутствие выделяемого текста подтверждает растровую природу страницы.
- Выполните pdfimages -list "scan.pdf". Полноформатный растр размером со страницу подтверждает, что основное содержимое представлено изображением.
- Для OCR подготовьте источник: pdfimages подходит для исходного растра без сложных преобразований, pdftopng — для точного вида страницы с поворотом и наложенными элементами.
- Передайте полученные изображения внешней системе распознавания. Xpdf Tools на данном этапе не выполняет распознавание.
- После OCR повторите pdftotext на PDF с добавленным текстовым слоем и сопоставьте несколько фрагментов с изображением. Ошибки OCR исправляются на стороне распознавания, а не параметрами pdftotext.
Для сканов важна граница ответственности: Xpdf отвечает за извлечение или рендеринг, распознавание выполняется иным инструментом. Полная последовательность для такого документа разобрана в материале как распознать текст в PDF. Повторное OCR уже распознанного документа способно создать дублирующий слой, по этой причине сперва проверяют существующий текст и направляют на распознавание только нужные страницы.
Как автоматизировать обработку папки
Пакетная обработка не должна останавливаться на первом повреждённом PDF и не должна оставлять частичный TXT под окончательным именем. Безопасная схема создаёт временный итог, проверяет код окончания и размер, после успеха переименовывает файл. Для каждого входа журнал хранит путь, версию Xpdf, код и ограниченный stderr без содержимого документа и паролей.
- Задайте полный путь к pdftotext 4.06 в переменной сценария и отдельно определите входной и выходной каталоги.
- Перечисляйте PDF средствами оболочки, которые сохраняют имя файла целиком. В PowerShell применяйте Get-ChildItem -File; в Bash — нулевой разделитель find ... -print0.
- Для каждого PDF сформируйте уникальное имя итога и временное имя с суффиксом .tmp. Не применяйте один общий output.txt.
- Запустите pdftotext с нужным режимом, к примеру -layout -enc UTF-8, передавая путь отдельным аргументом.
- Сразу прочитайте код окончания. Код 0 переводит процесс к проверке итога; любой другой код сохраняется в журнале, временный файл удаляется, очередь продолжает работу.
- Проверьте, что TXT существует и соответствует ожидаемому сценарию. Для цифрового документа полезен минимальный ненулевой объём; для скана пустой TXT является допустимым диагностическим исходом и отправляет файл в OCR-ветку.
- После проверки переименуйте временный файл в окончательное имя. Готовый итог предыдущего запуска не повреждается при аварийном окончании нового процесса.
- На контрольном наборе сопоставьте итоговые TXT после обновления Xpdf. Изменение порядка текста или обработки редкого шрифта должно обнаруживаться до массового запуска.
Пароли не записывают в командные журналы и BAT-файлы общего доступа. В приложении аргументы передают списком без запуска оболочки, а не собирают строку из пользовательского ввода. Для недоверенных документов задают тайм-аут, ограничение памяти и объёма итога. Параллельность настраивают отдельно для лёгкого pdfinfo и тяжёлого рендера: десятки одновременных pdftopng на больших листах быстро расходуют память.
ALYB / Keyboard Maestro Forum
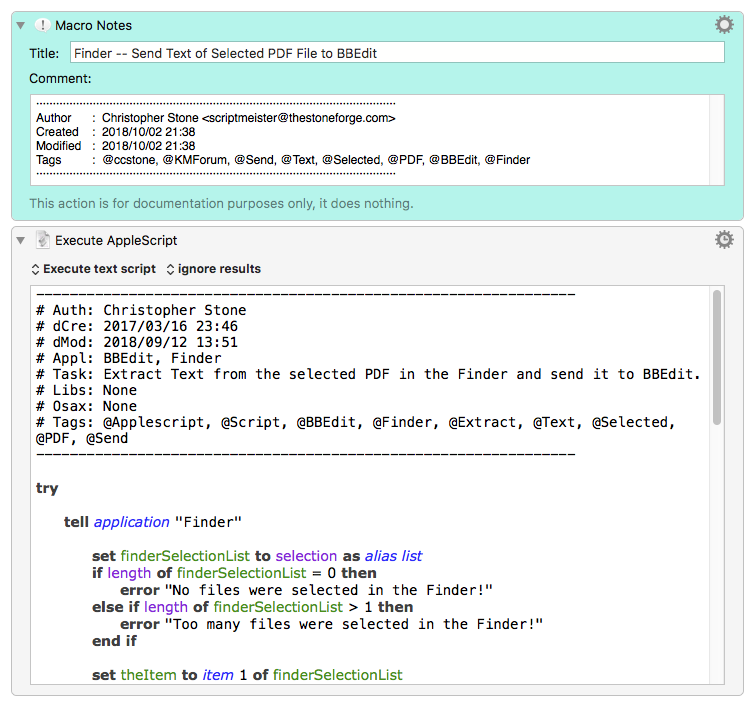
Christopher Stone / Keyboard Maestro Forum
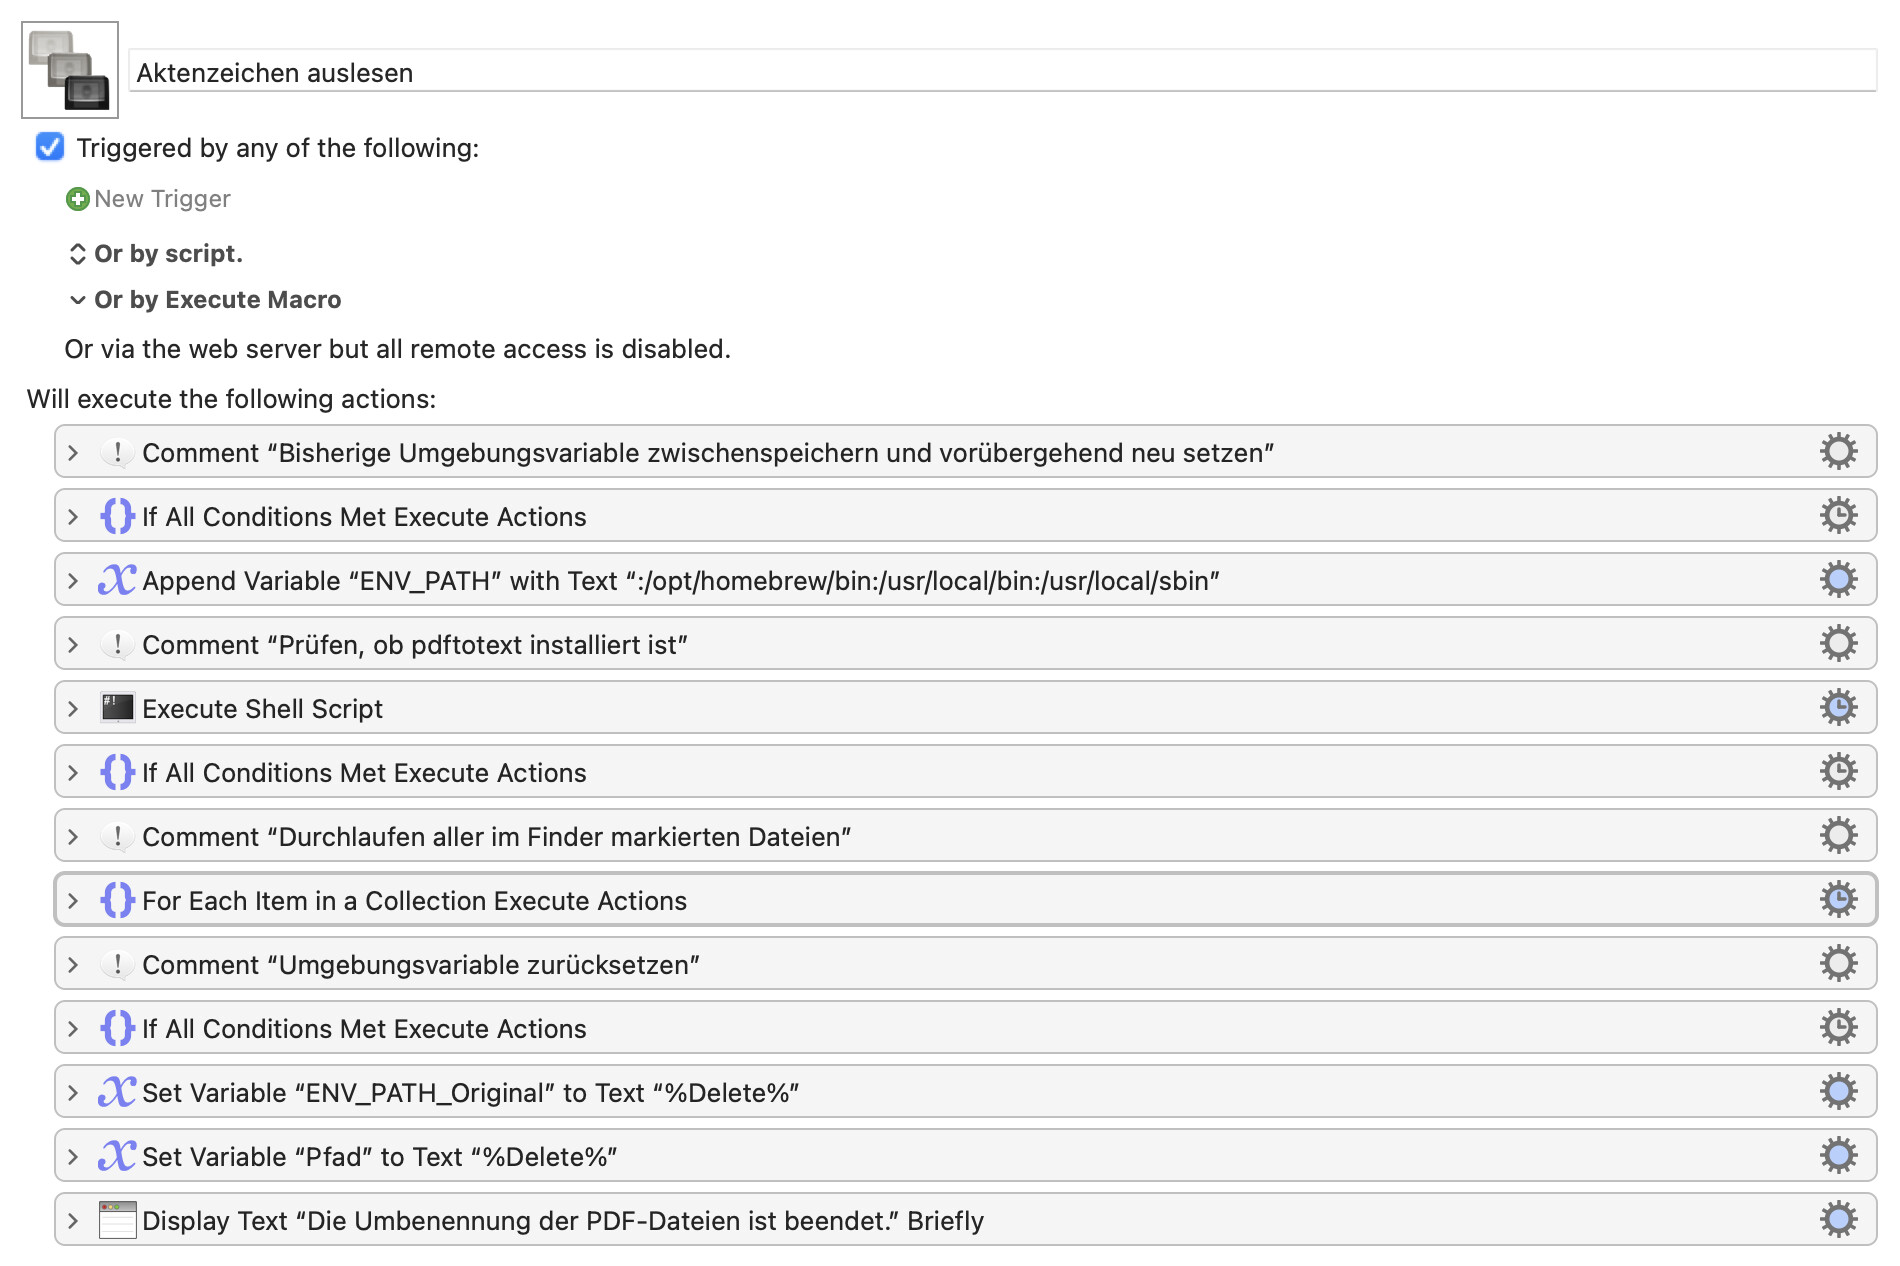
Caroline / Keyboard Maestro Forum
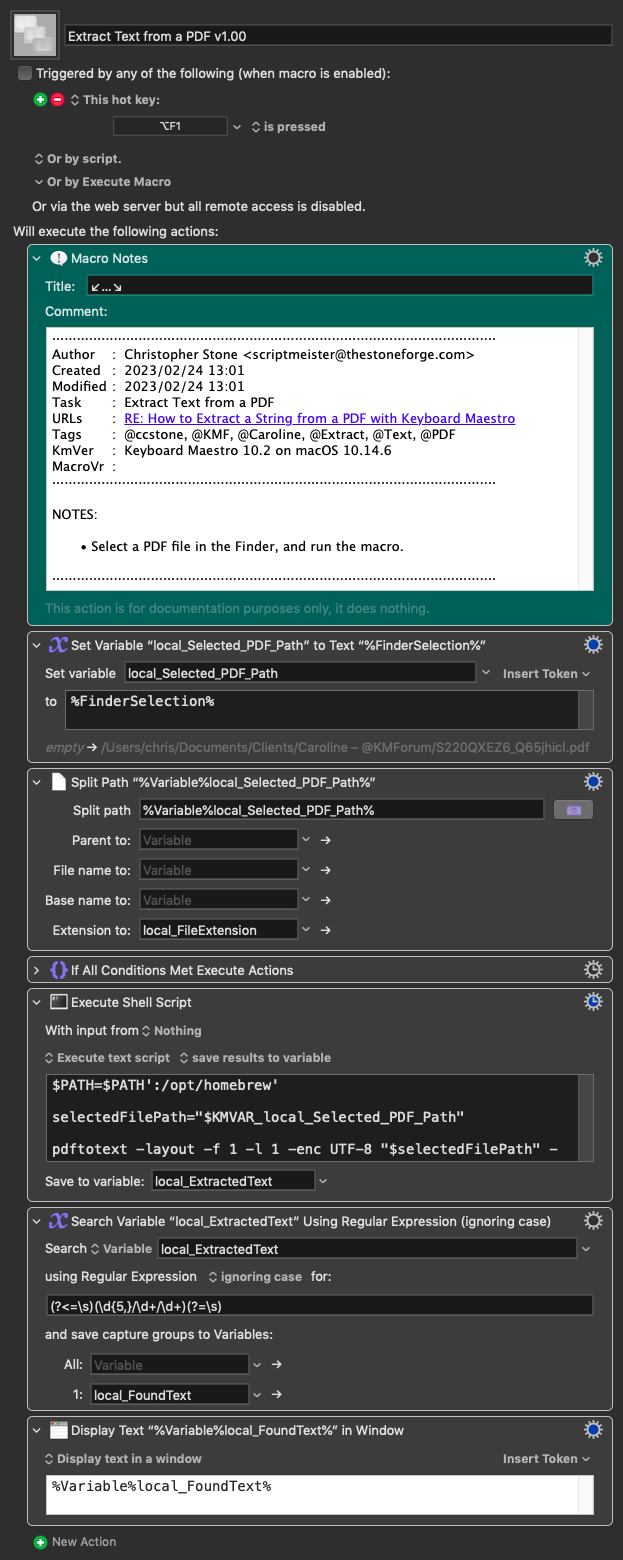
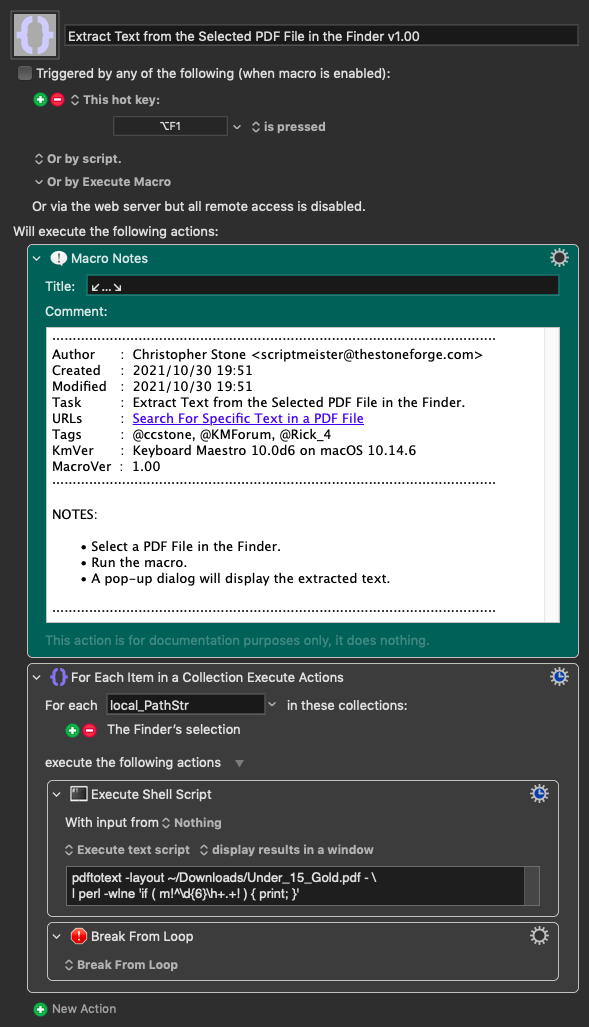
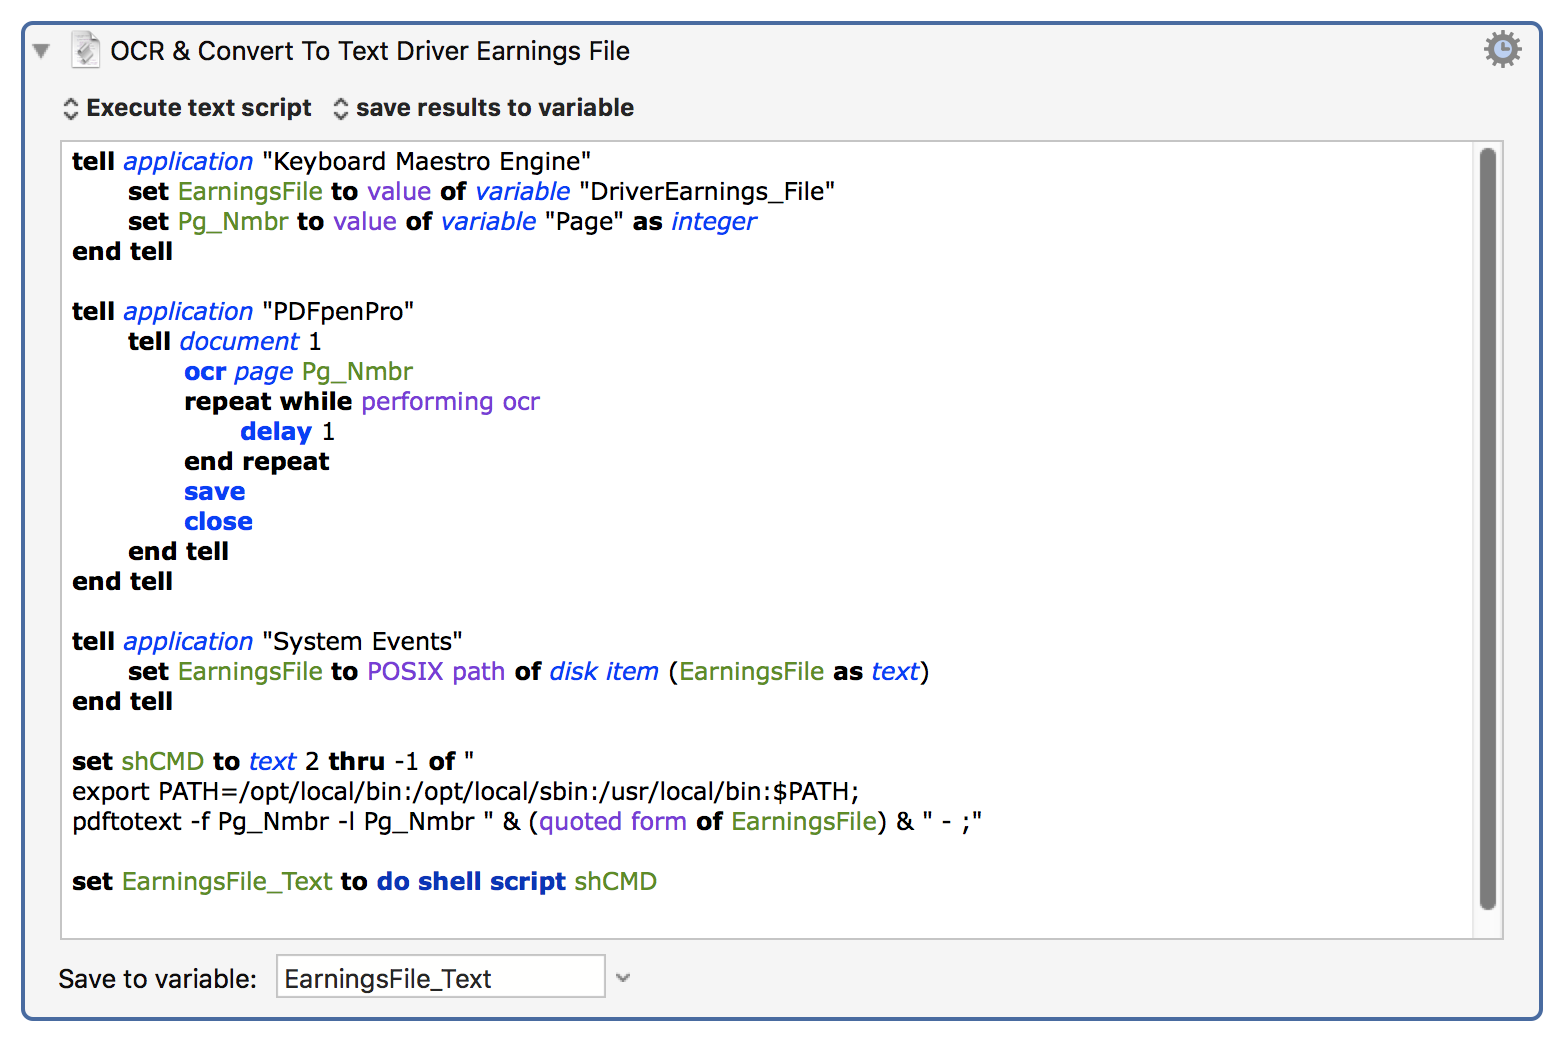
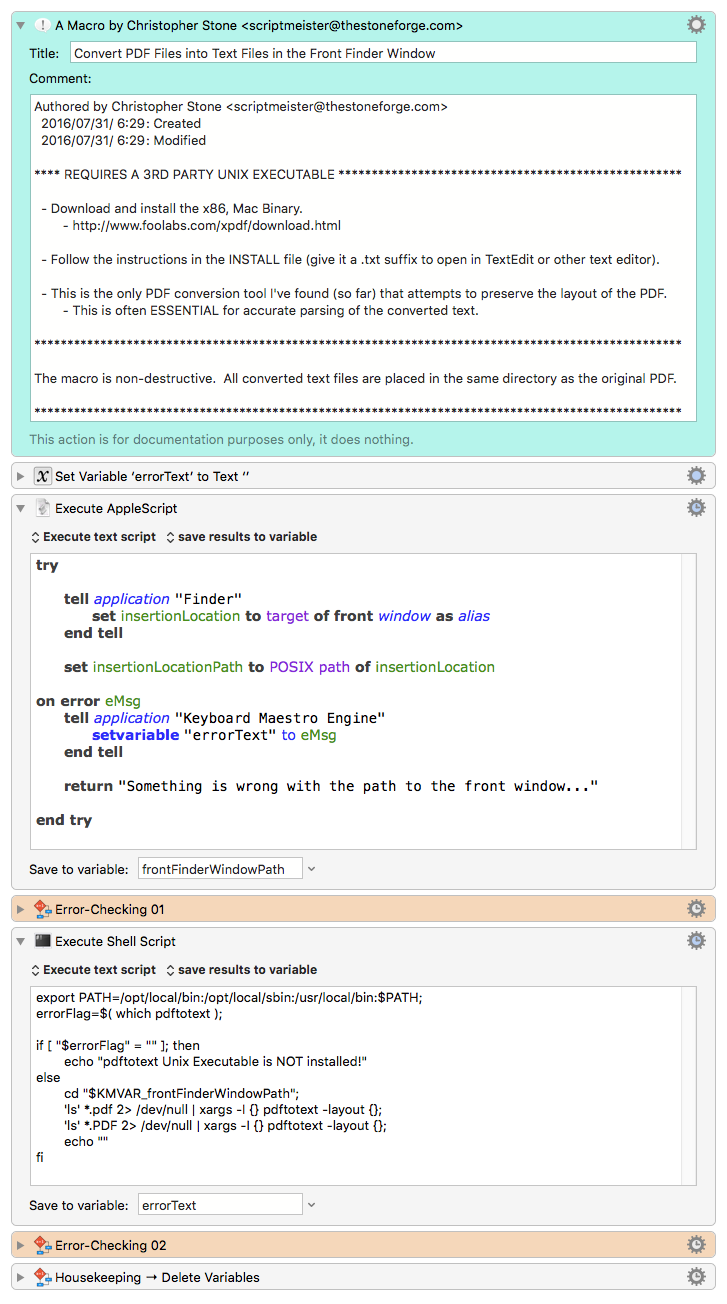
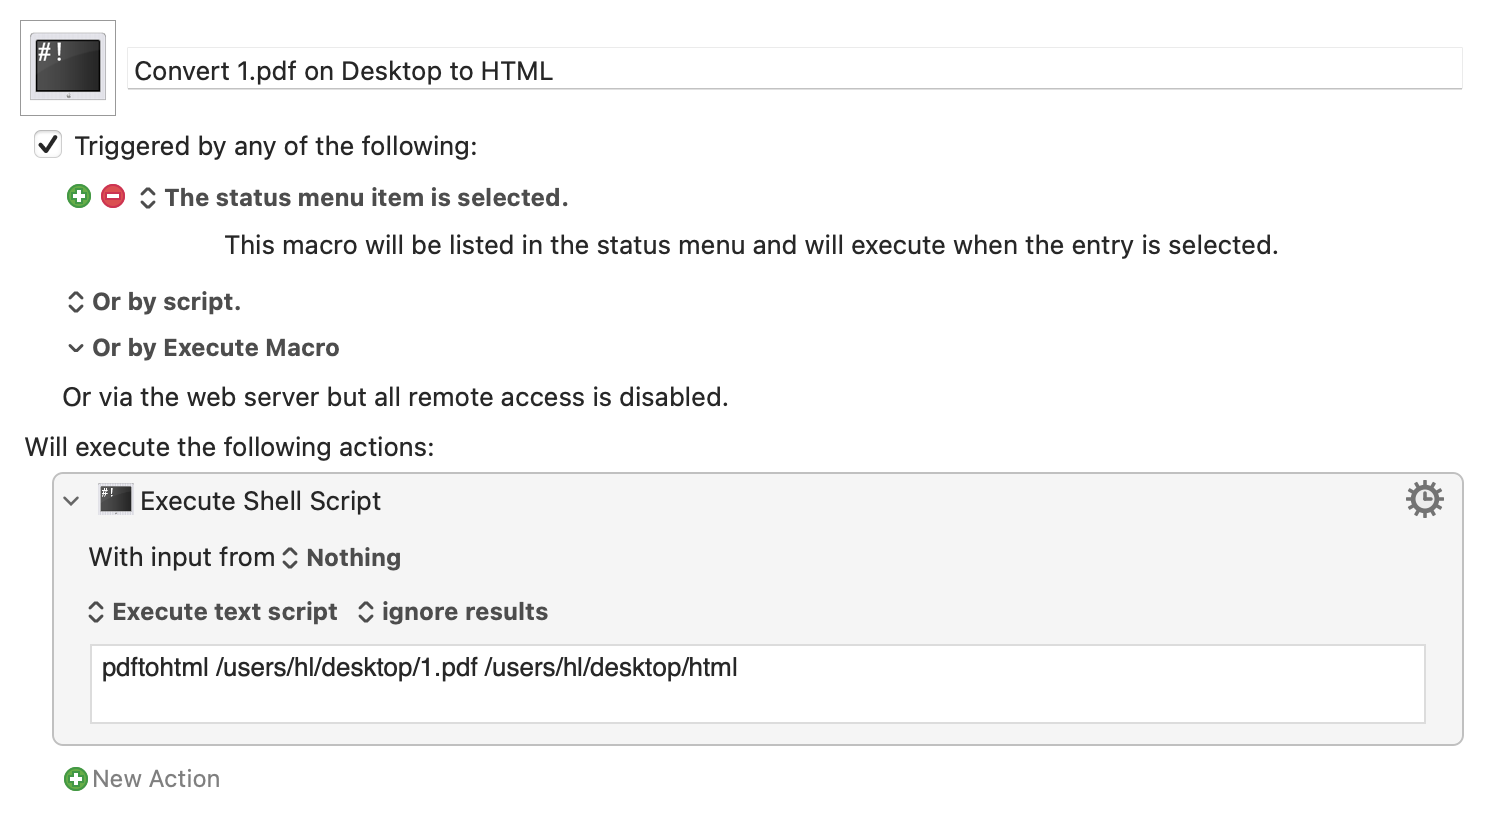
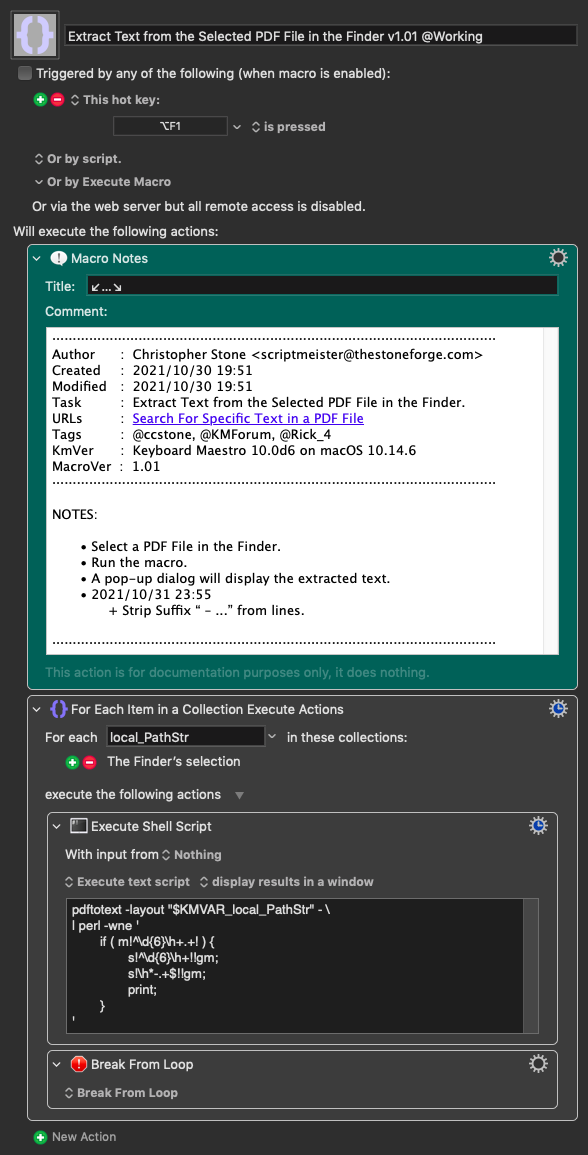
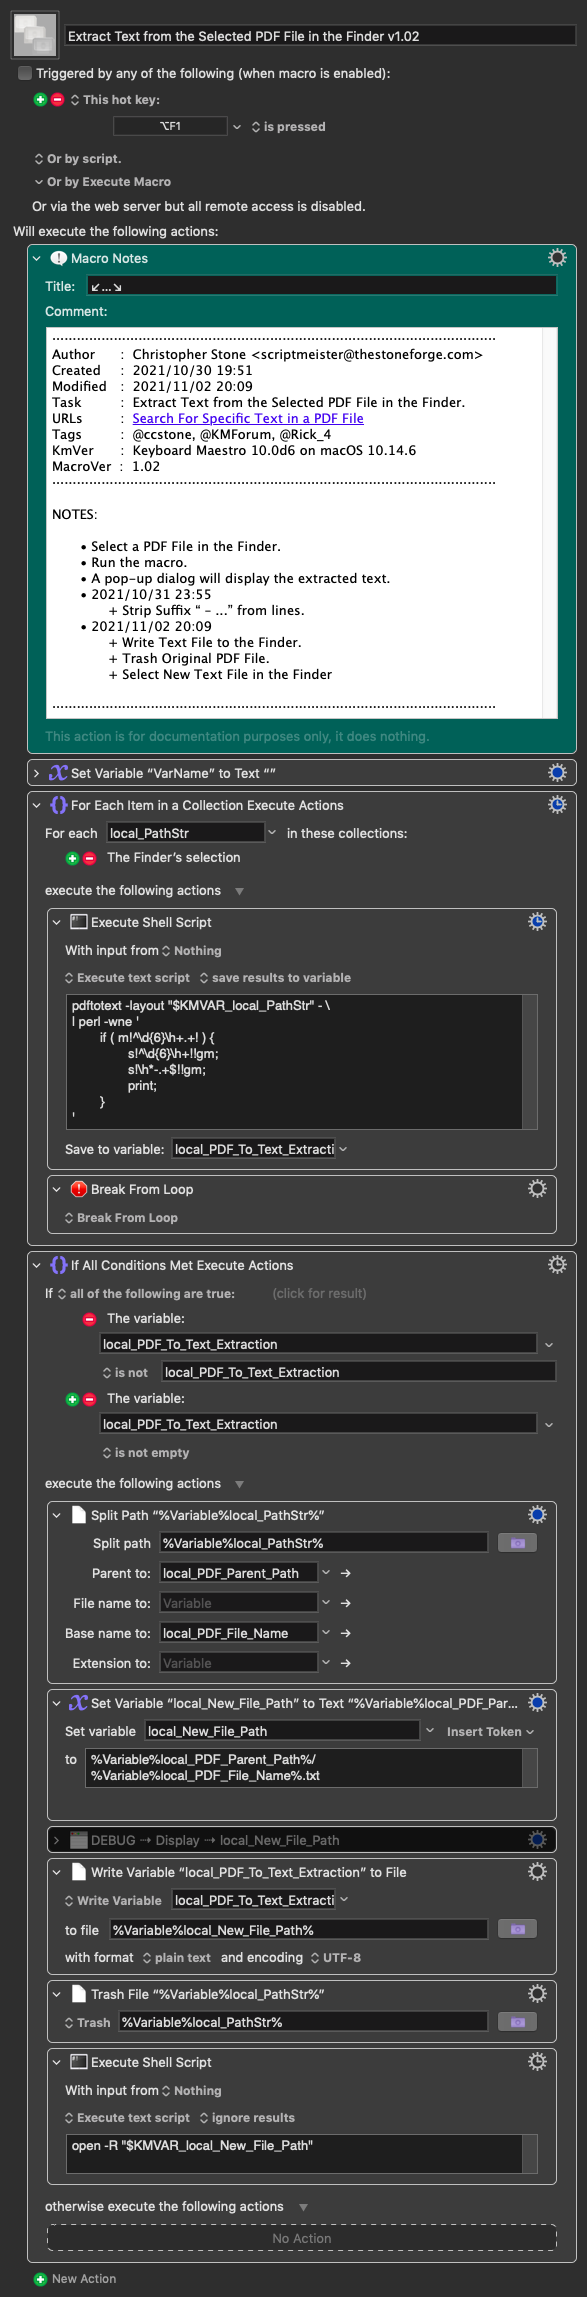
Три экрана в галерее показывают добавочные интеграционные сценарии вокруг Xpdf: HTML-конвертацию, передачу текста во внешний редактор и предварительную проверку окружения. Это важное архитектурное свойство пакета: Xpdf остаётся небольшим консольным процессом, а выбор файлов, правила именования, фильтрация и бизнес-проверка выполняются вызывающей системой.
Как извлекать изображения, вложения, шрифты и метаданные
Для диагностики PDF полезно разделять четыре слоя: технические свойства документа, шрифты, растровые изображения и файловые вложения. Xpdf Tools даёт отдельную программу для каждого слоя. Последовательность ниже помогает понять структуру файла до конвертации и не смешивать исходный растр со снимком всей страницы.
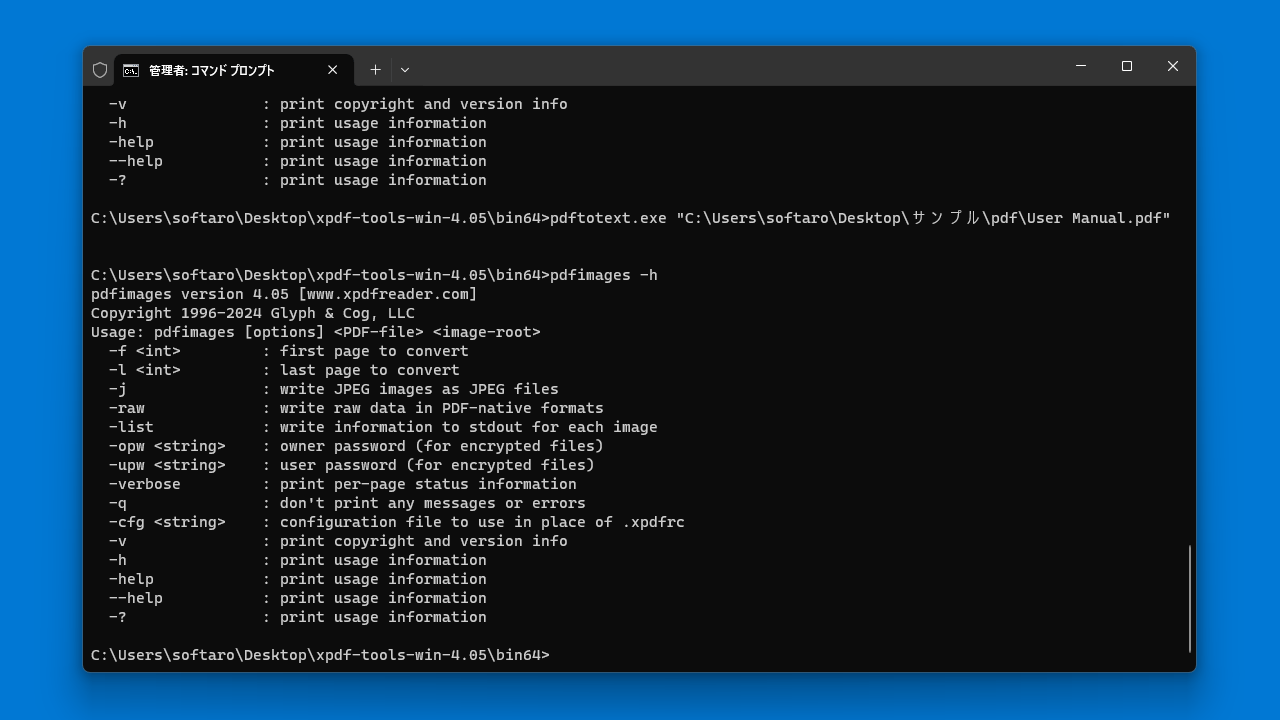
- Начните с pdfinfo "document.pdf". Сохраните отчёт и проверьте Page count, Page size, Encrypted, PDF version и доступные метаданные. Это базовая карточка входа.
- Выполните pdffonts "document.pdf". Обратите внимание на имя шрифта, тип, встраивание, подмножество и сведения о кодировке. При проблемах с текстом этот отчёт сопоставляют с pdftotext.
- Выполните pdfimages -list "document.pdf". Список показывает страницу, номер изображения, размер в пикселях, цветовое пространство, глубину и тип кодирования. На этом шаге файлы ещё не создаются.
- Для JPEG-потоков, которые необходимо сохранить без повторного рендеринга, применяйте pdfimages -j "document.pdf" "assets/image". Для других сценариев применяйте формат, который поддерживает текущая 4.06 и который необходим следующему этапу.
- После извлечения сопоставьте число файлов со списком pdfimages. Маска или альфа-компонент может быть отдельным объектом, по этой причине число файлов не обязано совпадать с числом видимых иллюстраций.
- Выполните pdfdetach -list "document.pdf". Встроенные файлы рассматривайте как недоверенные данные: сперва список, затем выбор конкретного вложения.
- Сохраните выбранное вложение командой pdfdetach -save N -o "attachment.bin" "document.pdf" или весь набор через -saveall с каталогом назначения. После сохранения проверьте тип файла по сигнатуре и стандартными средствами безопасности.
- Сведите отчёты pdfinfo, pdffonts, pdfimages -list и pdfdetach -list в единый журнал. Так последующая ошибка текста, графики или вложения связывается с конкретным слоем PDF.
pdfimages принципиально отличается от pdftopng. Он извлекает растровый объект без применения всех преобразований потока страницы: поворота, обрезки, масок и некоторых цветовых операций. По этой причине извлечённый файл способен выглядеть иначе, чем картинка на готовой странице. Для задачи сохранения исходных фотографий это ожидаемое поведение; для точного снимка композиции необходим рендер страницы.
Практическая проверка изображений состоит из трёх сравнений. Сперва изучите pdfimages -list и отыщите ожидаемый объект по странице и размеру. Затем извлеките его и откройте отдельно. После этого отрендерьте ту же страницу pdftopng и визуально сопоставьте. При различии исходный объект применяют для архива или дальнейшей обработки, а PNG страницы — для визуального контроля. Детальный разбор этой задачи есть в инструкции как извлечь изображения из PDF.
pdffonts ничего не исправляет; он только показывает состояние шрифтов. Невстроенный шрифт устраняется повторным экспортом из исходной программы или специализированным PDF-процессором. При повреждённом сопоставлении символов смена выходной кодировки pdftotext не восстанавливает смысл. Это видно по сочетанию двух признаков: визуально буквы отображаются правильно, а копирование и pdftotext дают одинаковые неверные символы. Тогда необходима другая стратегия — OCR, другой парсер или восстановление исходного документа.
pdfinfo тоже не является средством верификации происхождения документа. Поля Author, Creator, Producer и даты — обычные метаданные, которые могут отсутствовать или не соответствовать реальной истории файла. Для аудита сохраняют хэш входного PDF и журнал обработки отдельно. Значения pdfinfo полезны для маршрутизации: большой лист направляют в ограниченный рендер, зашифрованный файл — в ветку с разрешёнными данными доступа, документ с JavaScript — в более жёсткую песочницу.
Как рендерить страницы, получать HTML и PostScript
Конвертеры Xpdf Tools создают новое представление документа. Тут в особенности важно заблаговременно определить цель: PNG необходим для визуальной копии страницы, PPM/PGM/PBM — для технической растровой цепочки, HTML — как промежуточная веб-структура, PostScript — для совместимых печатных процессов. Один формат не заменяет остальные.
- Перед рендерингом выполните pdfinfo и запишите количество страниц и размер листа. Большой плакат при высоком DPI создаёт очень крупный растр, по этой причине диапазон и разрешение задают до массового запуска.
- Для обычного PNG выполните pdftopng -r 150 "manual.pdf" "render/page". Программа создаст отдельный файл на страницу и добавит номер к корню имени.
- Для одной страницы применяйте -f и -l с одинаковым номером, к примеру pdftopng -f 12 -l 12 -r 300 "drawing.pdf" "render/drawing". Это быстрее и безопаснее, чем рендерить весь документ ради одного листа.
- После окончания посчитайте PNG и сопоставьте число с выбранным диапазоном. Откройте первый, средний и последний кадр; проверьте мелкий текст, линии, поворот и фон.
- Для Netpbm-процесса применяйте pdftoppm. В версии 4.06 базовый цветной вывод — PPM, параметры -gray и -mono переводят вывод в PGM и PBM, а -r задаёт DPI.
- Для HTML подготовьте отдельный пустой каталог и выполните pdftohtml "manual.pdf" "html-out". Версия 4.06 создаёт HTML по страницам и сопутствующие изображения; каталог назначения создаётся утилитой и не должен заблаговременно содержать другой итог.
- Откройте итоговый index.html и несколько страниц. Проверьте порядок текста и наличие картинок. HTML из PDF рассматривайте как промежуточное представление: сложные таблицы и колонки не становятся автоматически семантической веб-разметкой.
- Для PostScript выполните pdftops "document.pdf" "document.ps". Уровень PostScript выбирайте только по требованиям принимающего устройства или процесса; EPS применяйте для одной страницы с явно заданным диапазоном.
- После любого преобразования сохраняйте код окончания и проверяйте итог программой, которая реально будет его потреблять: браузером для HTML, просмотрщиком изображения для PNG, печатным интерпретатором для PS.
По документации 4.06 pdftopng и pdftoppm применяют 150 DPI по умолчанию. Повышение разрешения увеличивает количество пикселей по обеим осям, по этой причине расход памяти и объём несжатых данных растут заметно быстрее самого значения DPI. Для превью разумнее начинать с 150 DPI, а для мелкой типографики или подготовки к OCR увеличивать разрешение лишь после сравнения тестовой страницы.
В pdftopng доступны режимы монохромного, серого и цветного вывода, а также альфа-канал для PDF с прозрачным фоном. В pdftoppm доступны управление поворотом, сглаживанием шрифтов и векторной графики. Эти параметры влияют на визуальный итог, по этой причине менять их следует на контрольной странице, а затем фиксировать в сценарии. Для делового процесса важна не максимальная детализация, а стабильный итог при ограниченном времени и памяти.
Для создания PNG на практике полезно сопоставить команды с отдельной инструкцией как конвертировать PDF в PNG. При проблемном документе сперва проверьте, открывается ли исходный PDF и читается ли его структура; порядок диагностики для повреждённых файлов разобран в материале как открыть повреждённый PDF.
pdftohtml в 4.06 получил современный индекс с боковой панелью и областью просмотра; опция -noframe возвращает простой индекс ссылок на страницы. Это всё равно не редакционный HTML: PDF ориентирован на фиксированную геометрию, по этой причине порядок чтения и таблицы требуют ручной проверки. Для миграции контента практичный процесс выглядит так: создать HTML, извлечь текст и изображения, затем заново собрать логическую структуру в CMS, сохраняя исходный PDF как контрольный источник.
pdftops необходим там, где следующий этап в самом деле принимает PostScript. Версия 4.06 поддерживает уровни PostScript 1, 2 и 3, а также EPS для одного листа. При современном PDF-процессе без требования PS лишнее преобразование только добавляет точку несовместимости. По этой причине перед конвертацией фиксируют требования принимающей системы и проверяют тестовый документ с прозрачностями, встроенными шрифтами и цветной графикой.
Ошибки, безопасность, преимущества, недостатки и реальные альтернативы
Типичные сбои Xpdf Tools хорошо диагностируются по коду окончания и stderr. В актуальной документации семейства применяются коды 0 — успех, 1 — ошибка открытия PDF, 2 — ошибка выходного файла, 3 — ограничение разрешений PDF, 98 — нехватка памяти и 99 — прочая ошибка. Код 0 означает, что процесс завершился штатно, но не гарантирует полезность итога: скан без текстового слоя правильно даёт пустой TXT.
При коде 1 проверяют путь, кавычки, доступ к файлу и реальный формат. Расширение .pdf не доказывает, что внутри PDF: загрузчик мог сохранить HTML-страницу ошибки. При коде 2 проверяют существование каталога, права записи, свободное место и блокировку файла. Код 3 требует законных данных доступа к защищённому документу. Код 98 обрабатывают уменьшением диапазона, DPI или параллельности. Код 99 разбирают по stderr и повторяют на контрольной версии с явным xpdfrc.
Отдельная группа проблем связана с текстом. Перемешанные колонки исправляют выбором подходящего режима pdftotext и последующей проверкой конкретных полей. Неверные буквы указывают на кодировку просмотра или плохое сопоставление глифов внутри PDF. Пропавшие слова часто оказываются картинкой или контурами; рендер показывает их визуально, но текстом они становятся лишь после OCR. Лишние пробелы в -layout часто передают геометрию колонок, по этой причине автоматическое удаление пробелов до анализа структуры ухудшает итог.
Для внешних PDF безопасность важнее удобства. Парсер обрабатывает сложный контейнер, по этой причине входящие файлы запускают с минимальными правами, ограничением времени, памяти и числа создаваемых файлов. Извлечённые вложения не открывают автоматически. На 11 сентября 2026 запись CVE-2026-4407 помечает Xpdf 4.06 как затронутый ошибкой проверки ICCBased color spaces; оценка CNA по CVSS 4.0 — 2.1 Low. Это усиливает требование к изоляции недоверенных документов даже при применении текущей ветки.
Плюсы
- Чёткое разделение задач: текст, шрифты, изображения, вложения, свойства и рендер обрабатываются отдельными программами.
- Удобная автоматизация: команды принимают аргументы, возвращают код окончания и не зависят от состояния графического окна.
- Работа локально без загрузки документов в веб-сервис, что полезно для закрытых корпоративных данных.
- Одинаковая базовая модель работы на Windows, macOS и Linux при явном выборе реализации Glyph & Cog.
- Хорошая диагностическая ценность: pdfinfo, pdffonts, pdfimages -list и pdfdetach -list быстро показывают структуру PDF.
Минусы
- Нет графического редактора: пользователь не выбирает объект мышью и не видит страницу до запуска рендера или отдельного просмотрщика.
- Нет встроенного OCR; скан без текстового слоя требует внешнего распознавания.
- Нет операций ручного редактирования, объединения, перестановки страниц, подписания и аннотаций.
- Одноимённые команды встречаются в Poppler, по этой причине PATH и версия требуют обязательной проверки.
- Качество извлечённого текста зависит от внутренней структуры PDF, порядка текстовых объектов и карт сопоставления символов.
- Для недоверенных документов необходим изолированный запуск и контроль ресурсов, как и для других сложных PDF-парсеров.
Кому подойдёт
- Разработчикам и администраторам, которые строят повторяемые локальные или серверные конвейеры.
- Архивам и контентным командам, которым необходимо извлекать текст, картинки и метаданные из большого фонда PDF.
- Специалистам по допечатной подготовке и диагностике, которым полезны сведения о шрифтах и PostScript-вывод.
- Аналитикам, которые превращают цифровые PDF в TXT для поиска, классификации и дальнейшего разбора.
Кому не подойдёт
- Пользователю, которому необходим визуальный редактор PDF с мышью, страницами и аннотациями.
- Процессу, где главная задача — OCR сканов без внешней системы распознавания.
- Работе, где нужно менять текст и изображения внутри существующего PDF и сохранять исходную верстку ручным способом.
- Команде без готовности поддерживать командные сценарии, пути, журналы и контроль версий.
Среди консольных альтернатив важно различать задачи. Poppler utilities предлагает родственные команды и в особенности распространён в Linux, но совпадение имён не означает полного совпадения параметров и вывода. qpdf сильнее ориентирован на структурные преобразования, шифрование, разделение и объединение. MuPDF полезен для быстрого рендера и собственного набора консольных операций, а Ghostscript логичен в PostScript/PDF-печатных цепочках.
Для ручной работы выбор другой: PDF-XChange Editor предоставляет графическое редактирование и визуальные инструменты, которых у Xpdf Tools нет. Сравнение не сводится к лучшей программе вообще: Xpdf выигрывает в воспроизводимых командах и пакетных заданиях, графический редактор — в интерактивной правке, qpdf — в структурных операциях, Ghostscript — в печатной обработке.
Практическая рекомендация для бизнеса проста: Xpdf Tools стоит применять как узкий слой обработки PDF, а не как универсальный комбайн. Для цифровых документов связка pdfinfo → pdftotext → проверка текста закрывает индексацию и извлечение данных. Для графики применяют pdfimages или pdftopng в зависимости от цели. Для сканов добавляют отдельный OCR. Для массового процесса фиксируют версию 4.06, полный путь, xpdfrc, код окончания, ограничения ресурсов и контрольный набор документов. Такой конвейер остаётся прозрачным: на каждом шаге понятно, какой слой PDF обработан и чем проверен итог.
Почему pdftotext создаёт пустой файл?
В PDF нет пригодного текстового слоя. Проверьте одну страницу, выполните pdfimages -list и оцените возможность выделять текст в просмотрщике. Скан направляют во внешний OCR, затем pdftotext запускают ещё раз.
Почему команда запускается, но параметры отличаются от инструкции?
В PATH найден одноимённый бинарник Poppler или другой версии Xpdf. Проверьте полный путь и вывод -v, затем закрепите абсолютный путь в сценарии.
Почему pdfimages выдаёт картинку не так, как она выглядит на странице?
pdfimages извлекает растровый объект, а не готовую композицию страницы. Поворот, обрезка, маски и часть цветовых преобразований применяются при рендере. Для точного вида страницы применяйте pdftopng.
Почему HTML нельзя сразу публиковать?
PDF хранит фиксированную геометрию, а веб-страница требует логической структуры. pdftohtml создаёт рабочее промежуточное представление, но сложные колонки, таблицы и порядок чтения требуют редакторской доработки.
Что означает Config Error?
Xpdf не смог прочитать ресурс из xpdfrc: карту символов, шрифт или иной файл. Запустите процесс с чистой конфигурацией через -cfg, исправьте путь и повторите контрольные документы.
Можно ли считать код 0 полной проверкой качества?
Нет. Код 0 подтверждает штатное окончание процесса. После него отдельно проверяют содержимое TXT, число PNG, открываемость HTML, список вложений или другой ожидаемый итог.