
Когда из PDF (Portable Document Format — переносимый формат документов) в Word вместо кириллицы вставляются квадраты, иероглифы, набор латинских знаков или бессмысленные сочетания, проблема практически всегда находится не в самом Word, а в том, как PDF хранит связь между кодами символов и видимыми глифами. Для рабочего документа важен не только внешний вид страницы: текст должен правильно выделяться, копироваться, находиться поиском и переноситься в DOCX — формат документов Microsoft Word — без подмены букв. Ниже — последовательная диагностика и пять методов восстановить читаемый текст без ручной перепечатки сотен страниц.
Краткий ответ: что делать прежде всего
Сперва проверьте, выделяется ли текст в исходном файле и правильно ли он копируется в простой текстовый редактор. Для базовой диагностики полезна отдельная инструкция о том, как копировать текст из PDF. Самый надёжный путь для проблемного файла — не пытаться угадывать кодировку, а создать новый текстовый слой через оптическое распознавание символов, потом экспортировать итог в DOCX и проверить его по контрольной выборке страниц.
- Текст не выделяется вообще. Перед вами скан или страница, сохранённая как изображение. Необходим OCR (optical character recognition — оптическое распознавание символов).
- Текст выделяется, но после вставки появляются кракозябры. Нарушено сопоставление кодов символов с Unicode, либо документ собран с нестандартной таблицей кодирования шрифта. Лучшее решение — повторное OCR с формированием нормального текстового слоя.
- Буквы читаются, но ломается оформление. Проблема относится к структуре PDF: колонки, табуляция, раздельные текстовые блоки, переносы строк и таблицы. Тут эффективнее конвертация всей страницы в Word, а не обычное копирование.
- Ошибки появляются лишь в отдельных фрагментах. Часто это формулы, редкие символы, подписи на схемах или текст, набранный другим шрифтом. Такие места проверяют отдельно после основного переноса.
- В одном PDF всё работает, а в другом — нет. Это нормальная ситуация: два визуально похожих файла могут быть собраны совершенно по-разному. В одном присутствует полноценный Unicode-слой, в другом — только глифы без корректной карты соответствий.
Почему PDF выглядит нормально, но копируется неправильно
Чтобы не тратить время на случайную смену шрифтов, полезно понимать устройство формата. В расширенном материале о том, что такое PDF, разобрана логика формата как финального представления страниц. Для проблемы с копированием главное следующее: PDF умеет отрисовать правильный знак на экране даже тогда, когда программе недостаточно данных, чтобы однозначно восстановить его Unicode-значение.
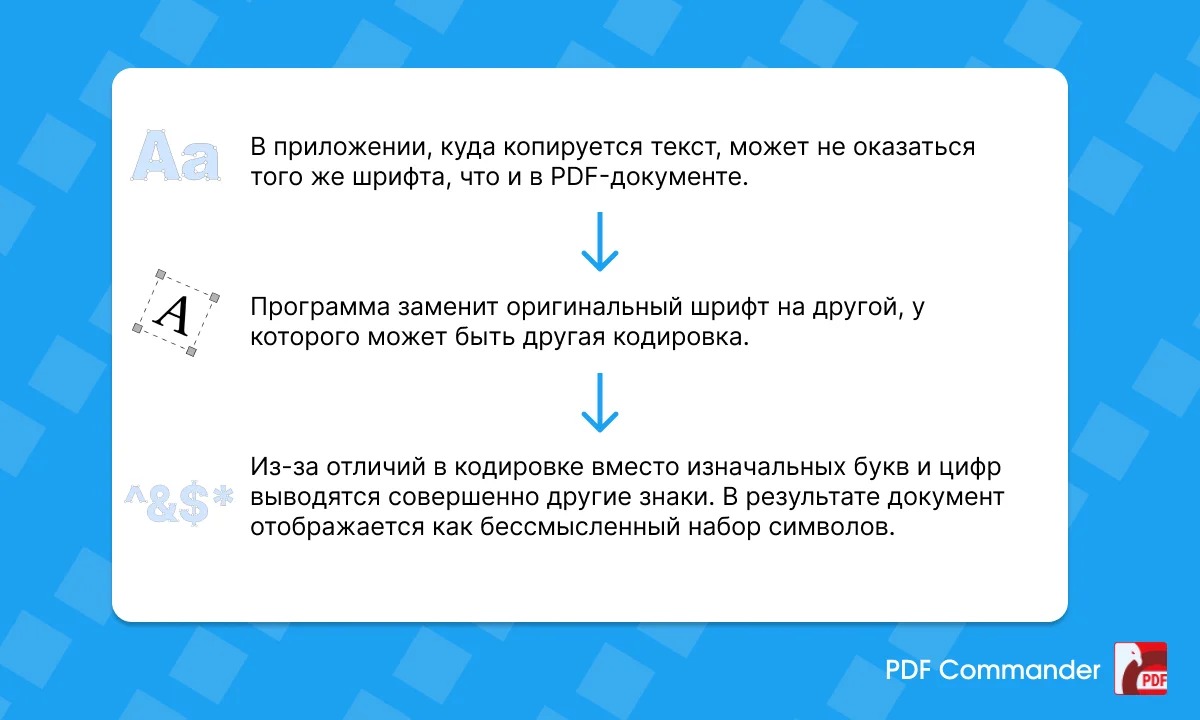
В PDF шрифт содержит глифы — графические формы символов. Для извлечения текста программе требуется ещё и корректное соответствие между внутренним кодом и символом Unicode. Для этого PDF применяет карту ToUnicode CMap (карта сопоставления кодов с Unicode). Когда она отсутствует, повреждена или составлена нестандартно, просмотрщик по-прежнему способен показать страницу правильно, потому что знает, какой глиф нарисовать. При копировании начинается другая операция: приложение пытается превратить внутренний код в обычный текст. Именно на данном этапе буква «А» визуально остаётся буквой «А», но в буфер обмена попадает другой символ.
Нестандартные встроенные подмножества шрифтов тоже часто осложняют перенос. Создатель PDF сохраняет только те глифы, которые реально применяются в документе, а внутренние коды подмножества не обязаны совпадать с привычной логикой текстового редактора. Такое сжатие нормальное для PDF и само по себе не означает повреждение файла. Проблема появляется тогда, когда вместе с подмножеством не сохранена полноценная карта символов. По этой причине установка похожего шрифта в Windows не восстанавливает утраченную связь автоматически.
Отдельный класс документов — сканы. В них текстовой структуры нет вообще: страница представляет собой изображение. Поиск и выделение появляются лишь после OCR. По этой причине фраза «поменять кодировку PDF на UTF-8» вводит в заблуждение: у PDF нет одной общей настройки кодировки, аналогичной TXT-файлу. Кодирование определяется объектами шрифтов и текстовыми потоками внутри документа. Практическое исправление строится вокруг OCR, конвертации или повторного выпуска PDF из исходного файла.
Для деловой работы эта разница принципиальна. Маркетолог получает медиакит, специалист по PR (public relations — связям с общественностью) — пресс-релиз, редактор — отчёт подрядчика, юрист — договор, аналитик — исследование в PDF. Визуально документ открыт и читается, но текст из него нельзя безопасно перенести в презентацию, лендинг, карточку продукта или внутреннюю базу знаний. По этой причине проверка копируемости — такой же этап входного контроля документа, как проверка изображений, таблиц и приложений.
Диагностика за пять минут перед исправлением
Перед обработкой сделайте небольшой контрольный тест. Он позволяет сразу выбрать подходящий путь и не прогонять весь файл через OCR без необходимости. Возьмите одну обычную страницу, страницу с таблицей и страницу с необычным шрифтом или схемой. Работайте с копией PDF, чтобы исходник оставался неизменным.
- Попробуйте выделить одно предложение. Курсор должен идти по строке, а не выделять прямоугольник как картинку.
- Скопируйте фразу в Word и в простой редактор без форматирования. Совпадение ошибки в обоих местах указывает на проблему самого текстового слоя PDF, а не оформления Word.
- Нажмите поиск по документу и введите слово, которое видно на странице. Отсутствие итога у скана подтверждает необходимость OCR.
- Проверьте дефисы, кавычки, знак №, букву Ё, длинное тире, цифры, адреса электронной почты и латиницу. Эти элементы быстро показывают качество распознавания и Unicode-сопоставления.
- Откройте несколько страниц из различных частей файла. Один документ способен содержать страницы, собранные различными методами: текстовый экспорт, сканы, вставленные изображения и приложения из сторонней системы.
После этого определите приоритет. Для договора, отчёта, коммерческого предложения или пресс-релиза важнее точность текста. Для брендбука и презентационного PDF дополнительно важна геометрия страницы. Для таблицы приоритетом становится сохранение строк и столбцов. Один и тот же метод редко одинаково хорошо решает все три задачи, по этой причине ниже варианты разделены по характеру исходника.
Пять рабочих методов получить нормальный текст
1. PDF Commander: заново распознать текст и экспортировать в DOCX
Первым методом применяем PDF Commander: у программы есть отдельный инструмент OCR и конвертация PDF в Word. Детальная карточка PDF Commander описывает распознавание, редактирование и экспорт. Для документа с кракозябрами повторное распознавание создаёт новый текстовый слой и тем самым обходит ошибочную внутреннюю карту символов исходного PDF.
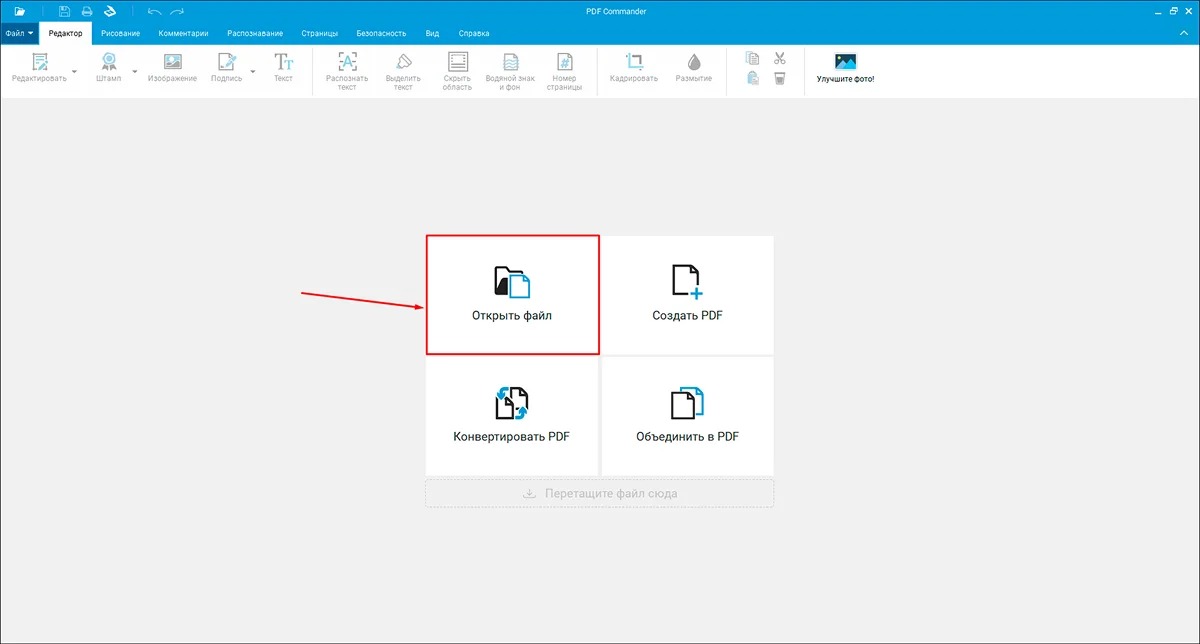
Рабочая последовательность начинается не с копирования проблемного фрагмента, а с подготовки всего документа. Откройте PDF, перейдите в режим редактора и запустите «Распознать текст». Выберите все страницы либо конкретный диапазон, задайте язык документа и интеллектуальный режим распознавания. Для сохранения внешнего вида страницы применяйте вариант с невидимым текстовым слоем: изображение исходной страницы остаётся сверху, а распознанный текст становится доступным для поиска и копирования.
- Откройте проблемный PDF в PDF Commander.
- Перейдите к инструменту «Распознать текст».
- Укажите нужные страницы и языки. Для смешанного русско-английского документа отметьте оба языка.
- Выберите интеллектуальный режим распознавания. Для сохранения визуального вида применяйте невидимый текстовый слой и объединение слов и строк.
- Запустите OCR и сохраните обработанную копию PDF.
- Для дальнейшего редактирования переведите документ в DOCX. Отдельная инструкция о том, как преобразовать PDF в Word, помогает выбрать путь для последующей доработки.
После экспорта не ограничивайтесь визуальным просмотром первых строк. Отыщите в Word несколько слов из начала, середины и конца документа; проверьте таблицы, числа, фамилии, кавычки и специальные знаки. При подготовке материалов для рекламы и PR отдельно смотрите на URL (Uniform Resource Locator — адрес ресурса), наименования брендов, артикулы и проценты: одна ошибочная цифра или заменённая буква способна перейти в макет, презентацию или публикацию и уже там стать фактической ошибкой.
Плюсы
- OCR выполняется локально на компьютере, по этой причине документ не требуется отправлять в браузерный сервис.
- Можно обработать весь PDF, а не копировать фрагменты по одному.
- Невидимый текстовый слой сохраняет внешний вид страницы и одновременно возвращает поиск и копирование.
- После OCR доступна конвертация в Word, по этой причине один и тот же рабочий поток подходит и для восстановления текста, и для дальнейшего редактирования.
Минусы
- OCR требует проверки итога: сложные таблицы, формулы, редкие символы и плохие сканы дают больше ошибок.
- Для многостраничных документов распознавание занимает заметное время в сравнении с обычным копированием.
- Когда исходный PDF уже содержит корректный текстовый слой, повторное OCR избыточно и способно ухудшить точность отдельных символов.
Кому подойдёт
Метод рассчитан на Windows-сценарий с проблемным текстовым слоем, сканами, архивными документами и PDF, где копирование стабильно даёт неправильные символы. Он в особенности удобен для договоров, медиакитов, отчётов, коммерческих предложений и инструкций, которые потом необходимо переработать в Word.
2. Microsoft Word: открыть PDF как документ, а не копировать ручным способом
В Word есть встроенное открытие PDF с преобразованием в редактируемую копию. Отдельная страница Microsoft Word посвящена работе редактора с документами и PDF. Этот путь подходит для обычных текстовых PDF, где структура относительно простая и главная задача — получить DOCX для дальнейшей правки.
Откройте Word, выберите «Файл» → «Открыть» и укажите PDF. Word создаёт копию, анализирует структуру страниц и преобразует её в редактируемый документ. Оригинальный PDF вместе с этим остаётся отдельным файлом. Метод в особенности полезен тогда, когда проблема проявляется лишь при копировании через буфер обмена, а сам текст в PDF определяется правильно.
- Запустите Word и откройте проблемный PDF через меню «Файл».
- Подтвердите преобразование PDF в редактируемый документ.
- Дождитесь окончания обработки и проверьте первые абзацы, таблицы и списки.
- Сохраните итог в DOCX под новым именем.
- Сопоставьте с оригиналом не только вид, но и содержание: поиск по фамилии, числу, дате и редкому слову быстро выявляет ошибки.
Преобразование лучше работает на документах, состоящих преимущественно из текста. Сложная графика, диаграммы и нестандартная верстка способны превратиться в изображения или изменить расположение. По этой причине этот метод не заменяет OCR для сканов и не подходит как универсальный инструмент восстановления повреждённой карты символов. Он хорош именно как альтернативный механизм разбора обычного PDF.
Отдельно существует режим «Сохранить только текст» при вставке. Он удаляет исходное форматирование и полезен, когда кириллица уже копируется правильно, а проблема ограничена стилями, размерами, фоном или странными переносами. При реальной подмене кодов символов этот режим не восстанавливает исходные буквы: в Word попадает тот же неправильный Unicode, только без оформления.
Плюсы
- Не требуется отдельный конвертер для текстовых PDF: преобразование выполняется в Word.
- Исходный PDF сохраняется отдельно, по этой причине легко сопоставлять итог с оригиналом.
- Удобно для документов, которые всё равно будут дорабатываться в DOCX.
Минусы
- Сложная верстка, графика и таблицы не всегда сохраняются точно.
- PDF, состоящий преимущественно из изображений, не превращается автоматически в качественно распознанный текст.
- Повреждённое сопоставление символов внутри PDF способно сохраниться и после конвертации, по этой причине итог обязательно проверяется.
Кому подойдёт
Метод удобен офисным сотрудникам, редакторам и специалистам по коммуникациям, когда PDF в основном текстовый, а итог всё равно необходим в Word для рецензирования, согласования и выпуска новой версии.
3. Adobe Acrobat Pro: Scan & OCR, затем экспорт в Word
Adobe Acrobat Pro объединяет OCR и экспорт в DOCX. Детальный обзор Adobe Acrobat Pro дополняет описание инструментов программы; в актуальном интерфейсе распознавание запускается через All tools → Scan & OCR.
Для скана откройте документ, перейдите в All tools → Scan & OCR → In this file, установите диапазон страниц и язык, после этого нажмите Recognize Text. Acrobat создаёт поисковый текстовый слой, по которому работают поиск и выделение. После распознавания откройте инструмент Convert и выберите Microsoft Word, DOCX либо DOC. Такой порядок разделяет две задачи: сперва восстановить текст, затем преобразовать структуру в офисный формат.
- Откройте исходный PDF и сохраните рабочую копию.
- Запустите Scan & OCR и укажите страницы и язык документа.
- После Recognize Text проверьте поиск по нескольким словам и выделение строк.
- Перейдите к Convert, выберите Microsoft Word и формат DOCX.
- Откройте полученный документ в Word и проведите содержательную проверку по контрольным фрагментам.
Преимущество подхода — явное разделение этапов. Когда исходный файл представляет собой скан, обычный экспорт без OCR недостаточен. Когда PDF уже текстовый, распознавание пропускают и сразу пробуют конвертацию. Для больших пакетов документов это позволяет не тратить время на заведомо лишнюю обработку.
Плюсы
- OCR создаёт поисковый текстовый слой непосредственно в PDF.
- Экспорт в Word встроен в тот же рабочий процесс.
- Поддерживается обработка многостраничных документов и выбор диапазона страниц.
Минусы
- Интерфейс насыщен профессиональными инструментами и требует больше времени на освоение.
- Сложный исходный макет всё равно нуждается в ручной проверке после экспорта.
- Для разового исправления одного небольшого файла функциональность продукта избыточна.
Кому подойдёт
Acrobat Pro уместен в организациях, где уже построен документооборот вокруг Acrobat и систематически встречаются сканы, формы, согласование версий, OCR и экспорт в офисные форматы.
4. Google Drive и Google Docs: OCR в браузере для небольшого файла
Google Drive умеет преобразовывать PDF и изображения в текст через открытие в Google Docs. Отдельная инструкция о том, как открыть PDF в Google Документах, разбирает тот же путь детальнее. Этот вариант удобен для небольших неконфиденциальных материалов, когда локального OCR-инструмента нет под рукой.
Valentyna Sagan, CC BY-SA 3.0, Wikimedia Commons
Загрузите PDF в Google Drive, щёлкните по нему правой кнопкой мыши и выберите «Открыть с помощью» → «Google Документы». Сервис создаёт новый документ и извлекает текст. Для такого преобразования лучше подходят файлы до 2 МБ, текст высотой не менее 10 пикселей, правильная ориентация страниц и чёткое изображение с хорошим контрастом. Списки, таблицы, колонки, сноски и концевые сноски переносятся хуже обычного текста.
- Загрузите копию PDF в Google Drive.
- Откройте файл через Google Docs, а не через обычный режим просмотра Drive.
- Дождитесь появления распознанного документа.
- Сопоставьте несколько абзацев с исходной страницей.
- При необходимости перенесите проверенный текст в Word и заново оформите сложные таблицы или колонки.
Для коммерчески чувствительных файлов этот метод требует отдельного решения по политике хранения данных. Договоры с персональными данными, внутренние финансовые документы и закрытые медиапланы не стоит отправлять во внешний облачный сервис только ради OCR, когда корпоративные правила требуют локальной обработки. В таких сценариях безопаснее применять настольный инструмент внутри разрешённой инфраструктуры.
Плюсы
- Работает в браузере и не требует установки отдельного OCR-пакета.
- Подходит для фотографий документов и небольших PDF.
- Полученный текст сразу доступен для редактирования и совместной работы.
Минусы
- Для OCR через Google Docs рекомендуется файл размером не более 2 МБ.
- Сложные таблицы, колонки, сноски и элементы верстки распознаются хуже обычных абзацев.
- Облачная обработка не подходит документам, которые по внутренней политике нельзя загружать во внешние сервисы.
Кому подойдёт
Метод полезен для небольших публичных материалов: брошюр, пресс-релизов, сканов публикаций, учебных фрагментов и документов без чувствительной информации, когда необходимо быстро получить редактируемый текст на любом компьютере.
5. Microsoft OneNote: извлечь текст из страниц PDF как из изображений
OneNote применяет OCR для картинок и файловых распечаток. Отдельная страница OneNote описывает работу с заметками и вложениями. Метод работает как обходной путь: PDF вставляется в заметку в виде распечатки страниц, после чего текст копируется из одной страницы или из всех страниц сразу.
Вставьте PDF как файловую распечатку в OneNote. На нужной странице щёлкните правой кнопкой мыши и применяйте Copy Text from this Page of the Printout либо Copy Text from All the Pages of the Printout. Извлечённый текст затем вставляется в Word. Качество OCR зависит от читаемости изображения, а сама команда порой появляется не сразу: обработка сложного содержимого способна занять заметное время.
- Создайте отдельную страницу OneNote и вставьте PDF как файловую распечатку.
- Дождитесь обработки изображения текста.
- Откройте контекстное меню на странице распечатки.
- Скопируйте текст текущей страницы или всех страниц.
- Вставьте итог в Word и проверьте ошибки распознавания.
OneNote полезен как аварийный метод, когда рабочая среда уже включает Microsoft 365, а устанавливать отдельный OCR-пакет нельзя. Но для большого документа с таблицами и строгой версткой он менее удобен, чем специализированный PDF-редактор: итог ориентирован на извлечение содержания, а не на точное восстановление макета.
Плюсы
- OCR встроен в привычную среду заметок Microsoft.
- Текст можно извлекать как с одной страницы, так и со всей файловой распечатки.
- Подходит для фрагментов сканов, снимков экрана и страниц PDF.
Минусы
- Распознавание не предназначено для точного восстановления исходной верстки PDF.
- Команда OCR иногда становится доступна не сразу после вставки изображения.
- Большие многостраничные документы удобнее обрабатывать специализированным OCR-инструментом.
Кому подойдёт
OneNote удобен для точечного извлечения текста из нескольких страниц, иллюстраций, сканов и вложений, в особенности в командах, которые уже применяют Microsoft 365 для заметок и внутренней базы знаний.
Как выбрать метод по типу исходного PDF
Выбор лучше строить не по привычке к программе, а по природе документа. Сперва определите, есть ли в файле настоящий текстовый слой, потом оцените важность верстки и конфиденциальность. Для отдела маркетинга или PR это в особенности полезно: пресс-релиз, исследование, брендбук и скан договора требуют различных приоритетов.
- Скан, фото страниц, старый архив. Применяйте OCR. Для локальной работы — PDF Commander или Acrobat Pro; для небольшого открытого файла — Google Docs; для пары страниц — OneNote.
- Обычный текстовый PDF, который плохо копируется. Сперва попробуйте открыть его непосредственно в Word. При повторении кракозябр переходите к OCR и создавайте новый текстовый слой.
- Документ с плотной версткой. Сохраняйте оригинал отдельно и рассматривайте DOCX как рабочую копию. Вёрстку проверяйте постранично по образцу.
- Конфиденциальный документ. Предпочтение отдаётся локальной обработке в разрешённом настольном ПО, без загрузки в публичный браузерный сервис.
- Файл из исходного Word или иной программы доступен. Самое чистое решение — исправить исходник и заново экспортировать PDF. Это лучше, чем восстанавливать итоговый файл методом обратной конвертации.
Почему смена шрифта в Word часто не помогает
Проблемы со шрифтами в PDF в самом деле существуют, и для них полезен отдельный разбор о том, как изменить шрифт в PDF. Но кракозябры после копирования нельзя сводить только к отсутствующей гарнитуре. Шрифт отвечает за форму глифа, а перенос в Word требует ещё и правильного соответствия этому глифу в Unicode.
Представьте, что внутри PDF код 37 отрисовывается как русская «Д». На экране всё выглядит правильно. При копировании приложение должно понять, что код 37 означает именно U+0414. Когда карты нет, программа выбирает другое значение или вообще не отыскивает соответствия. Замена гарнитуры уже после вставки не меняет сам код символа — она лишь рисует другой глиф для того кода, который попал в Word.
По этой причине установка шрифта полезна лишь в конкретном случае: Word получил правильные символы, но не умеет их отобразить выбранной гарнитурой. Тогда после смены шрифта появляется нормальный текст. При настоящем нарушении Unicode-сопоставления в документе вместо «Договор» вставляется другой набор кодов, и визуальная смена оформления ничего не исправляет.
Почему совет «поменяйте кодировку PDF на UTF-8» обычно неверен
У TXT-файла в самом деле есть понятие текстовой кодировки всего содержимого. PDF устроен иначе: в нём одновременно живут шрифты, подмножества шрифтов, CMap, текстовые операторы, графические объекты и изображения. По этой причине внутри обычного редактора PDF нет одной универсальной кнопки, которая переводит весь документ из «неправильной кодировки» в UTF-8 и гарантированно исправляет копирование.
Некоторые старые инструкции предлагают сохранить PDF «как текст» и выбрать UTF-8. Такая операция создаёт новый текстовый файл из того, что сумел извлечь конвертер. Она полезна как эксперимент, но не чинит исходную PDF-структуру. Когда извлечение уже выдаёт неправильные символы, выбор UTF-8 на этапе сохранения лишь записывает эти неправильные символы в корректной кодировке UTF-8. По этой причине итог остаётся ошибочным.
Рабочая логика другая: получить надёжный Unicode-текст из изображения страницы или из правильно распознанной структуры, затем уже сохранить его в DOCX, TXT или другом формате. Именно по этой причине повторное OCR часто эффективнее бесконечной смены кодировок.
Что делать с защищённым PDF
Защита и неправильные символы — различные проблемы. PDF способен запрещать копирование, редактирование или печать. В этом случае сперва необходимо получить легитимный доступ к содержимому: попросить владельца прислать незашифрованную копию, исходный DOCX или разрешённую для редактирования версию. Не следует обходить ограничения чужого документа только ради удобства переноса текста.
Когда копирование разрешено, но в Word появляются иероглифы, защита не является главной причиной. Возвращайтесь к диагностике текстового слоя: выделение, поиск, копирование в простой редактор и, при необходимости, OCR. Это экономит время и не смешивает две независимые задачи.
Контроль качества после OCR и конвертации
Главная ошибка после удачной конвертации — считать итог готовым только потому, что кириллица стала читаемой. OCR и обратное преобразование способны давать точечные ошибки, которые визуально практически незаметны. Для делового документа необходим короткий протокол проверки, в особенности когда текст дальше попадёт в рекламу, презентацию, договор, пресс-релиз или публичную статью.
- Проверка по контрольным словам. Отыщите 5–10 редких слов из различных частей исходника. Поиск должен приводить к тем же фрагментам в Word.
- Проверка чисел. Сверьте даты, проценты, суммы, номера документов, коды, артикулы и показатели исследований.
- Проверка кириллицы и латиницы. Особое внимание — похожим символам: А/A, В/B, С/C, Е/E, Н/H, К/K, М/M, О/O, Р/P, Т/T, Х/X.
- Проверка пунктуации. OCR часто путает дефис, длинное тире, кавычки, апострофы, двоеточия и знак №.
- Проверка структуры. Сопоставьте порядок абзацев в колонках, подписи к рисункам, списки, сноски и последовательность таблиц.
- Проверка ссылок и наименований. URL, адреса электронной почты и торговые марки нельзя оставлять без ручной сверки.
- Проверка выборки страниц. Для длинного документа проверьте начало, середину, конец и все страницы с нестандартной версткой.
Удобная метрика для команды — доля ошибок на 1000 символов. Возьмите контрольный фрагмент длиной приблизительно в тысячу знаков, сопоставьте с оригиналом и посчитайте замены, пропуски и лишние символы. Для повторяющихся типов документов это позволяет сопоставить различные OCR-сценарии на практике и выбрать тот, который стабильно даёт меньше ручной правки.
Вторая метрика — время от получения PDF до готового проверенного DOCX. Быстрый, но неточный инструмент часто оказывается медленнее в реальной работе, поскольку редактор тратит время на исправление фамилий, чисел и переносов. По этой причине оценивайте полный цикл: подготовка, распознавание, экспорт, ручная проверка и финальное сохранение.
Практический сценарий для маркетинга, PR и контент-команды
Представим типовую задачу: подрядчик прислал исследование в PDF, из которого необходимо взять цитаты и несколько цифр для презентации, пресс-релиза и лендинга. Копирование одной страницы даёт кракозябры. Ручная перепечатка создаёт риск ошибок и не масштабируется на десятки страниц.
Рабочий процесс начинается с сохранения исходного PDF как эталона. Затем на трёх тестовых страницах запускается OCR, проверяются наименования брендов, проценты и цифры. После успешного теста обрабатывается весь документ и создаётся DOCX. В отдельном списке фиксируются страницы с таблицами, диаграммами и сносками — их редактор проверяет ручным способом по оригиналу.
После этого контент-команда работает уже с очищенным текстом, но каждую цифру перед публикацией возвращает к исходной странице PDF. Такой подход разделяет две задачи: OCR восстанавливает удобство работы, а фактчекинг сохраняет точность. Для материалов, где одна неверная цифра влияет на бизнес-вывод, это важнее внешней похожести Word-документа на PDF.
Итоговая проверка проста: открыть исходный PDF и DOCX рядом, выбрать случайные страницы, отыскать одинаковые фразы и убедиться, что порядок текста, числа и имена совпадают. Лишь после этого рабочая копия становится источником для редактирования внутри команды.
Типовые ошибки и как их распознать
- Вместо кириллицы появляются латинские буквы с диакритикой. Это признак неправильного сопоставления кодов, а не плохого шрифта Word. Переходите к OCR.
- Вставляются только знаки препинания и пробелы. Текстовый слой неполный или построен нестандартно. Проверяйте поиск в PDF и распознавайте страницу заново.
- Копируется одна буква на строку или нарушается порядок слов. PDF собран из отдельных позиционированных текстовых объектов. Конвертация всей страницы обычно эффективнее обычного копирования.
- В Word появляются квадраты. Сперва смените гарнитуру на шрифт с полной поддержкой нужного алфавита. Когда квадраты превращаются в другие неправильные символы, причина находится глубже и требует OCR.
- На одной странице всё нормально, на другой кракозябры. Документ собран из различных источников. Обрабатывайте проблемный диапазон отдельно, а не распознавайте без нужды весь файл.
- После OCR текст читается, но таблица развалилась. Распознавание решило символы, но не восстановило табличную структуру. Для критичной таблицы лучше перенести данные отдельно и сверить каждую строку.
- После конвертации пропали изображения или подписи. Word восстанавливает редактируемую структуру, а не точную модель PDF. Применяйте исходный PDF как визуальный эталон.
Как предотвратить проблему при создании собственного PDF
Самый надёжный метод избежать кракозябр в будущем — выпускать PDF из исходного документа корректным экспортом, а не экзотическим виртуальным принтером или устаревшей библиотекой. В Word, LibreOffice, издательской системе или ином редакторе применяйте штатный экспорт в PDF и проверяйте, что полученный файл допускает поиск и копирование кириллицы.
Перед отправкой клиенту или публикацией выполните мини-тест: откройте готовый PDF на ином компьютере, отыщите по поиску слово с буквой «ё» или длинным тире, скопируйте абзац в простой редактор и проверьте специальные символы. Такой тест занимает меньше минуты, но сразу показывает, сохранилась ли текстовая семантика документа.
При работе с фирменными шрифтами полезно заблаговременно проверять условия их встраивания. Некоторые гарнитуры имеют ограничения на встраивание, а отдельные системы создают подмножества шрифтов. Для публичных документов выбирайте настройки экспорта, которые сохраняют доступный текстовый слой и не превращают весь документ в набор контуров.
Чек-лист перед передачей исправленного Word-файла
- Оригинальный PDF сохранён отдельно и не перезаписан.
- В DOCX нет кракозябр, квадратов и случайной латиницы вместо кириллицы.
- Поиск отыскивает контрольные слова из начала, середины и конца документа.
- Проверены числа, даты, проценты, наименования организаций, имена и фамилии.
- Проверены таблицы, колонки, сноски, подписи к рисункам и порядок абзацев.
- Ссылки и адреса электронной почты сверены с PDF посимвольно.
- Документ сохранён под новым именем, чтобы его нельзя было перепутать с исходником.
- Для важного материала выполнена выборочная постраничная сверка вторым человеком.
Как понять источник проблемы по типу PDF
Полезно определить, откуда появился файл. PDF, экспортированный из Word, InDesign, бухгалтерской системы, браузера, сканера или старой базы документов, несёт различные риски. У офисного экспорта чаще ломается структура абзацев и таблиц; у сканов отсутствует текстовый слой; у старых специализированных систем встречаются нестандартные встроенные шрифты и собственные таблицы сопоставления символов. Такая классификация сокращает число проб и помогает сразу выбрать нормальный путь восстановления.
Файл из Word или другого современного текстового процессора обычно содержит полноценный текст и шрифты. Когда именно такой документ копируется кракозябрами, стоит проверить, не был ли он ещё раз пропущен через старый виртуальный принтер, систему электронного архива или программу, которая пересобрала шрифты. Прямое открытие в Word порой восстанавливает структуру, но повторный OCR остаётся более предсказуемым методом при систематической подмене символов.
Файл из издательской или дизайнерской системы требует осторожности: визуальный макет для него важнее редактируемости. Текст может быть разбит на множество отдельных блоков, размещённых с точностью до координат, а часть надписей превращена в кривые. В Word такой PDF часто теряет сетку и порядок элементов даже при корректной кириллице. Тут полезно отделить две задачи: текст извлекать OCR или конвертацией, а внешний вид сверять по оригинальному PDF, не пытаясь сделать DOCX точной копией макета.
Сканированный документ распознаётся проще с точки зрения логики: исходного Unicode-слоя нет, по этой причине исправлять в нём нечего. Необходимо получить новый слой через OCR. Качество зависит от резкости, контраста, перекоса, языка, размера символов и загрязнений страницы. Светло-серые печати, фоновые узоры, старые машинописные шрифты и рукописные пометки требуют отдельной проверки. Для большого архива разумно сперва распознать несколько типичных страниц и только затем запускать весь массив.
Документы из ведомственных, инженерных и старых корпоративных систем часто выглядят идеально, но текст внутри хранится нестандартно. Именно тут встречается эффект, когда одна и та же буква визуально правильная, поиск порой работает, а после копирования появляется другой символ. Попытки «починить Word» бесполезны: Word получает уже искажённую последовательность. Новый OCR-слой создаёт независимое распознавание по изображению страницы и по этой причине обходит дефект исходной кодовой карты.
Что делать с таблицами, колонками и сложной версткой
Самая нелёгкая часть конвертации — не буквы, а порядок чтения. PDF хранит элементы по координатам страницы, по этой причине текст из двух колонок способен перемешаться: сперва первая строка левой колонки, затем первая строка правой, потом вторая строка левой и так далее. Для человека страница очевидна, для алгоритма порядок приходится восстанавливать. После OCR или конвертации такие места проверяют не только визуально, но и логически.
- Две и более колонки. Прочитайте первые два абзаца подряд и убедитесь, что текст не перескакивает между колонками.
- Таблицы. Сверьте количество строк и столбцов, объединённые ячейки, шапку, единицы измерения и итоговые значения.
- Сноски. Проверьте номера и связь с основным текстом. После конвертации сноска порой становится обычным абзацем внизу страницы.
- Подписи к графикам. Убедитесь, что наименование диаграммы не вклинилось внутрь основного абзаца и не потеряло число или процент.
- Формулы. Математические символы, верхние и нижние индексы требуют ручной сверки; OCR не заменяет редактор формул.
- Вертикальный текст. Подписи осей, боковые колонтитулы и повернутые элементы часто распознаются отдельно от основного потока.
Для таблицы с важными числами эффективнее не добиваться идеального внешнего совпадения с PDF, а проверить данные как структуру. Сперва сопоставьте заголовки колонок, потом выберите несколько строк в начале, середине и конце. После этого проверьте итоговые суммы, проценты и единицы измерения. Такой подход быстрее, чем посимвольная сверка всей таблицы, и лучше выявляет ошибки, которые реально влияют на смысл отчёта.
Колонтитулы и номера страниц тоже создают шум. При конвертации они способны повторяться внутри основного текста, в особенности когда каждая страница PDF обрабатывается как самостоятельный блок. Перед применением итога в статье или презентации удалите повторяющиеся служебные строки, но сперва убедитесь, что это в самом деле колонтитул, а не содержательная подпись раздела.
Для брендированных PDF важно сохранить оригинал рядом. Цветные плашки, декоративные сетки и изображения не обязаны переноситься в Word точно. Цель исправления кракозябр — получить достоверное редактируемое содержание. Точное воспроизведение дизайна остаётся задачей исходной программы верстки, а не Word.
Рабочий стандарт для команды, которая часто получает проблемные PDF
Когда такие файлы приходят систематически, разовые действия лучше превратить в короткий стандарт. Это снижает зависимость от личного опыта одного сотрудника и делает качество предсказуемым. Стандарт не требует сложной автоматизации: достаточно фиксированного порядка диагностики, именования файлов, выбора инструмента и проверки итога.
- Шаг 1. Сохранить оригинал. Исходный PDF получает пометку original и не перезаписывается.
- Шаг 2. Проверить три страницы. Обычная страница, таблица и страница с нестандартным оформлением дают достаточную картину качества.
- Шаг 3. Выбрать один основной путь. Для скана — OCR, для простого текстового PDF — открытие в Word, для сложного повреждённого слоя — OCR с последующим экспортом.
- Шаг 4. Создать рабочую копию. DOCX и обработанный PDF получают отдельные имена и дату обработки.
- Шаг 5. Выполнить контроль. Проверяются слова, числа, имена, URL, таблицы и сложные страницы.
- Шаг 6. Зафиксировать источник цифр. При дальнейшем применении в публичном материале каждая значимая цифра сверяется с исходной страницей PDF.
Для маркетинговой команды этот стандарт полезен при обработке исследований, медиакитов, партнёрских презентаций и технических описаний. Для PR — при работе с пресс-релизами, отчётами и официальными публикациями. Для редакции — при подготовке материалов из архивных PDF. Для юридической и административной функции — при извлечении текста из договоров, актов и сканов. Во всех случаях цель одна: отделить восстановление редактируемости от подтверждения фактов.
Необходимо тоже договориться о допустимом уровне риска. Публичный буклет без чувствительных данных можно обработать через браузерный OCR. Внутренний договор, коммерческая аналитика или документ с персональными данными должны проходить только через разрешённую инфраструктуру. Это решение относится не к качеству OCR, а к правилам обращения с информацией.
Для регулярной работы полезно хранить один небольшой эталонный PDF с типичными сложностями: кириллица, латиница, цифры, таблица, длинное тире, кавычки, знак №, проценты и одна двухколоночная страница. После обновления программы или изменения рабочего процесса этот файл позволяет за короткое время проверить, не ухудшилось ли качество распознавания и конвертации.
Как проверить итог без полного перечитывания документа
Полное сравнение сотен страниц слишком дорого по времени. Вместо него применяется выборочный контроль с повышенным вниманием к рискованным участкам. Возьмите по одной странице из каждого типа верстки, потом добавьте страницы с максимальным количеством цифр, таблиц, сносок и нестандартных шрифтов. Такая выборка ловит большую часть системных ошибок.
- Сверьте по одному абзацу на первой, средней и последней странице.
- Отыщите три редких слова и убедитесь, что поиск в DOCX приводит к правильным местам.
- Проверьте пять числовых значений, включая одно с десятичной частью и одно с процентом.
- Сверьте две фамилии или наименования брендов, в особенности содержащие похожие кириллические и латинские буквы.
- Откройте самую сложную таблицу и проверьте её шапку, две строки и итог.
- Проверьте одну страницу с изображением и подписью, чтобы убедиться в правильном порядке текста.
- Сопоставьте один фрагмент со специальными символами: №, кавычки, тире, скобки, двоеточие, адрес электронной почты.
Когда в проверочной выборке появляется системная ошибка, не исправляйте её ручным способом по всему DOCX до выяснения причины. К примеру, массовая подмена русской «С» на латинскую C указывает на дефект распознавания или исходной карты символов. Проще повторить OCR с другим языковым набором или иным методом, чем искать сотни замен после окончания работы.
При единичных ошибках ручная коррекция оправданна. Типичные примеры — редкий символ, дробь, номер с верхним индексом, декоративная кавычка или подпись на графике. Важно отличать единичный дефект от системного: системный требует смены метода, единичный — обычной редакторской правки.
Когда итог необходимо передавать дальше в публикацию или макет
После технического восстановления текста полезно сделать ещё один переход — от документа к рабочему контенту. Не переносите весь полученный DOCX в макет автоматически. Сперва выделите фактические элементы, которые в самом деле пойдут в публикацию: наименования организаций и продуктов, цитаты, числа, даты, проценты, подписи к иллюстрациям и ссылки. Каждый такой элемент сверяется с исходным PDF в момент применения. Это в особенности важно для рекламных материалов, пресс-релизов, лендингов, презентаций и коммерческих предложений, где редакторская правка часто меняет порядок абзацев и сокращает исходный текст. Такой двухэтапный контроль отделяет техническую точность OCR от содержательной точности будущей публикации и уменьшает риск, что одна незаметная ошибка распознавания превратится в публичную фактическую ошибку.
Почему смена шрифта в Word не исправляет кракозябры?
Потому что шрифт меняет внешний вид уже полученных кодов символов. Когда PDF передал в буфер обмена неправильный Unicode, другая гарнитура не восстанавливает исходные буквы. В такой ситуации необходим новый текстовый слой через OCR или другое полноценное преобразование.
Поможет ли вставка «только текст»?
Она помогает при проблемах оформления: убирает стили, размеры, цвет, таблицы и часть служебного форматирования. При неправильном сопоставлении кодов символов кракозябры останутся, потому что в Word попадают те же ошибочные символы.
Необходимо ли искать кодировку UTF-8 внутри PDF?
Нет. PDF не устроен как обычный TXT-файл с одной кодировкой всего содержимого. За извлечение отвечают структуры шрифтов, карты соответствий и текстовые объекты. Практическое исправление выполняют через OCR, конвертацию или повторный экспорт из исходного документа.
Почему поиск в PDF работает, а копирование всё равно ломается?
Поиск и копирование применяют близкие, но не идентичные механизмы конкретного приложения. Частичная карта символов порой достаточна для поиска по части текста, но не гарантирует корректный перенос всех глифов в буфер обмена. Проверка итога в Word остаётся обязательной.
Можно ли распознать только проблемные страницы?
Да. Это рациональный подход для смешанного PDF, где часть страниц уже содержит нормальный текст, а часть пришла как сканы или имеет повреждённую карту символов. Обрабатывайте проблемный диапазон и сохраняйте оригинал для сравнения.
Как понять, что OCR выполнен качественно?
Проверьте поиск, выборочную сверку абзацев, цифры, имена, специальные символы, таблицы и порядок текста. Для регулярной работы полезно считать количество ошибок на контрольный фрагмент и сопоставлять полное время обработки вместе с ручной коррекцией.
Итог
Непонятные символы при переносе из PDF в Word появляются из-за того, что видимая страница и извлекаемый текст — не одно и то же. PDF способен правильно рисовать глифы, но вместе с этим хранить неполное или нестандартное соответствие символам Unicode. По этой причине бесконечная смена шрифта и попытки отыскать «правильную кодировку» часто не решают задачу.
Практический порядок такой: сперва определить, есть ли текстовый слой; затем попробовать полноценное открытие в Word; при кракозябрах или скане создать новый текстовый слой через OCR. Для локальной обработки удобен PDF Commander, в существующей экосистеме Acrobat — Scan & OCR, для небольшого открытого файла подойдёт Google Docs, а OneNote полезен для точечного извлечения текста из распечаток страниц. После любого метода итоговый DOCX необходимо проверять по оригиналу — в особенности числа, имена, ссылки и табличные данные.