
ABBYY FineReader долго задавал привычный сценарий работы со сканами: получить изображение страницы, распознать символы, проверить ошибки, сохранить редактируемый документ и при необходимости продолжить работу с PDF. В 2026 году эту цепочку закрывают различные классы инструментов — от локальных PDF-редакторов до открытых OCR-движков и мобильных сканеров. По этой причине полезнее выбирать не продукт с похожим наименованием, а решение, которое закрывает конкретный рабочий процесс. Для ориентира у Xeon Live есть отдельный рейтинг замен FineReader, а тут мы подробно разбираем шестнадцать вариантов и критерии выбора для бизнеса, контента и документооборота.
Что должно уметь решение вместо ABBYY FineReader
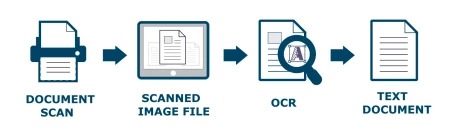
Оптическое распознавание символов, или OCR, — только один этап. В реальной работе после распознавания требуется сохранить структуру страницы, отыскать сомнительные фрагменты, перенести таблицу, собрать многостраничный файл, экспортировать материал в текстовый формат или оставить исходный вид PDF с невидимым поисковым слоем. Для договоров и архивов важна локальная обработка, для отдела контента — скорость правок и перенос в редактор, для исследовательских массивов — пакетность и автоматизация. Базовую механику OCR и типичные причины ошибок подробно раскрывает инструкция по распознаванию текста в PDF.
- Тип итога. Поисковый слой в исходном PDF сохраняет внешний вид страниц; полностью редактируемый текст удобнее для переработки содержания, но сильнее зависит от качества верстки.
- Сложность макета. Обычная деловая страница, журнал с несколькими колонками, таблица и рекламный макет требуют различного уровня анализа структуры.
- Пакетная обработка. Для десятков и сотен файлов важны очередь, обработка папок, профили сканирования, командная строка или API, а не только одиночная кнопка OCR.
- Контроль ошибок. Полезны выделение сомнительных символов, выбор зон распознавания и возможность быстро сопоставить скан с полученным текстом.
- Конфиденциальность. Локальные документы можно обрабатывать без передачи содержимого в браузерный сервис; для облачных методов необходимо заблаговременно учитывать правила хранения корпоративных материалов.
- Дальнейший маршрут. Маркетинговый отчет часто уходит в Word, таблица — в Excel, архив — в searchable PDF, а фрагмент изображения — в обычный текст для CMS или презентации.
Отдельно стоит различать качество распознавания и качество восстановления верстки. OCR способен правильно прочитать большинство символов, но перепутать порядок колонок, разорвать таблицу или поставить подпись к изображению не туда. Именно по этой причине сравнение по одному короткому скану дает мало информации. Необходим набор материалов, похожий на документы вашей команды: брифы, медиапланы, договоры, исследования, презентации, старые PDF-каталоги и фотографии печатных страниц.
Критерии рейтинга и практическая матрица выбора
В рейтинг включены настольные редакторы, открытые инструменты, браузерные сервисы и мобильные приложения, потому что они решают различные части одной задачи. Порядок внутри групп не означает универсальную победу: первая позиция отдана PDF Commander по условию материала и потому, что программа сочетает OCR с повседневной работой с PDF на Windows и Linux. Остальные продукты оцениваются по тем же признакам — без отдельной поблажки для продвигаемого решения.
- OCR для сканов и изображений: можно ли получить выделяемый и копируемый текст из страницы-картинки.
- Работа с PDF после OCR: редактирование, поиск, комментарии, порядок страниц, объединение и экспорт.
- Сохранение структуры: насколько инструмент рассчитан на колонки, таблицы, графику и смешанные страницы.
- Платформы: настольная система, браузер или мобильное устройство; один продукт учитывается в рейтинге только один раз.
- Масштабирование процесса: пакетная обработка, профили, автоматизация, командная строка или серверный сценарий.
- Проверка итога: визуальное сравнение, корректировка сомнительных мест, экспорт тестового фрагмента и повторный поиск по распознанному PDF.
Для маркетинга и PR в особенности важен не только точный текст, но и скорость повторного применения материала. Старый медиакит, исследование в скане, каталог партнера или PDF с таблицей легче оценивать, когда инструмент позволяет быстро отыскать нужную фразу и перенести фрагмент в новый документ. Вместе с этим распознанный текст нельзя автоматически считать готовым к публикации: наименования брендов, фамилии, суммы, даты и юридические формулировки требуют ручной сверки со сканом.
Windows и Linux
1. PDF Commander
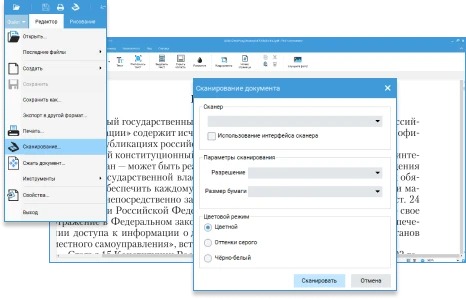
PDF Commander — настольный PDF-редактор для Windows и Linux с распознаванием сканов, редактированием текста, работой со страницами и сканированием. обзор PDF Commander помогает понять его место среди обычных PDF-инструментов: это не отдельный OCR-движок, а рабочая среда, в которой распознавание встроено в дальнейшую правку документа. Такой подход удобен, когда после получения текста необходимо сразу исправить страницу, объединить файл, добавить изображение или подготовить PDF к передаче коллегам.
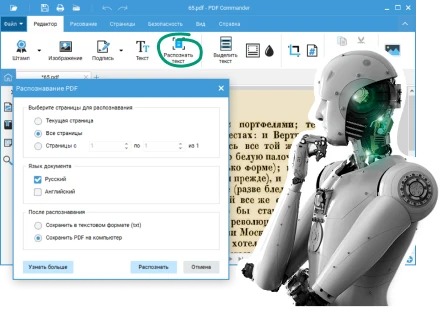
Для OCR в программе предусмотрены различные сценарии. Быстрое распознавание рассчитано на обычные печатные страницы, а отдельный режим распознавания с интеллектуальной обработкой подходит для более сложных сканов. Можно ограничить обработку текущей страницей, диапазоном или всем документом, выбрать язык и указать, необходим ли извлеченный текст либо новый файл. Для неоднородной страницы полезна разметка сегментов: пользователь задает области, которые должны трактоваться как строки, текстовые блоки и другие элементы.
В деловом процессе сильная сторона такого формата — короткая цепочка действий. К примеру, отдел коммуникаций получает от партнера отсканированный PDF-каталог, распознает нужные страницы, копирует спецификации, исправляет опечатки и сохраняет рабочую копию, не переключаясь между несколькими приложениями. Для архивного сценария удобнее оставить визуальный слой страницы и добавить распознанный текст, чтобы PDF стал доступен для поиска. Для контентного сценария важнее извлечь текст и затем ручным способом проверить заголовки, цифры и имена собственные.
Ограничение PDF Commander связано с классом продукта: это в первую очередь универсальный PDF-редактор, а не специализированная платформа промышленного ввода документов. Для потоков с тысячами анкет, сложной маршрутизацией, обучаемыми схемами извлечения полей и централизованным контролем качества лучше смотреть на серверные или корпоративные системы. В обычной работе малого и среднего офиса, редакции или маркетинговой команды его набор функций покрывает наиболее частую связку «скан → OCR → проверка → правка PDF».
Плюсы
- Распознавание встроено в полноценный PDF-редактор, по этой причине итог можно сразу править и собирать в итоговый документ.
- Есть отдельные режимы OCR и настройка областей на странице.
- Поддерживаются Windows и Linux, что удобно для смешанного парка рабочих станций.
- Сканирование и последующая обработка находятся в одном приложении.
Минусы
- Не ориентирован на промышленный поток документов с серверной маршрутизацией и сложными схемами извлечения полей.
- Для многоуровневых макетов и критичных данных итог OCR все равно необходимо сверять с оригиналом.
Кому подойдёт
Редакциям, маркетинговым отделам, небольшим компаниям и пользователям Windows или Linux, которым необходим локальный инструмент для распознавания и дальнейшей ручной работы с PDF без построения отдельной OCR-инфраструктуры.
2. ContentReader PDF 16
ContentReader PDF 16 продолжает классический подход FineReader: распознает сканы и фотографии документов, превращает содержимое в редактируемый текст и одновременно работает как PDF-редактор. В разбор ContentReader PDF продукт рассматривается как самостоятельная среда для чтения и обработки документов. В актуальной линейке заявлена поддержка 203 языков распознавания; для русскоязычного документооборота важнее не само число, а наличие русского языка, работа со смешанными страницами и экспорт таблиц.
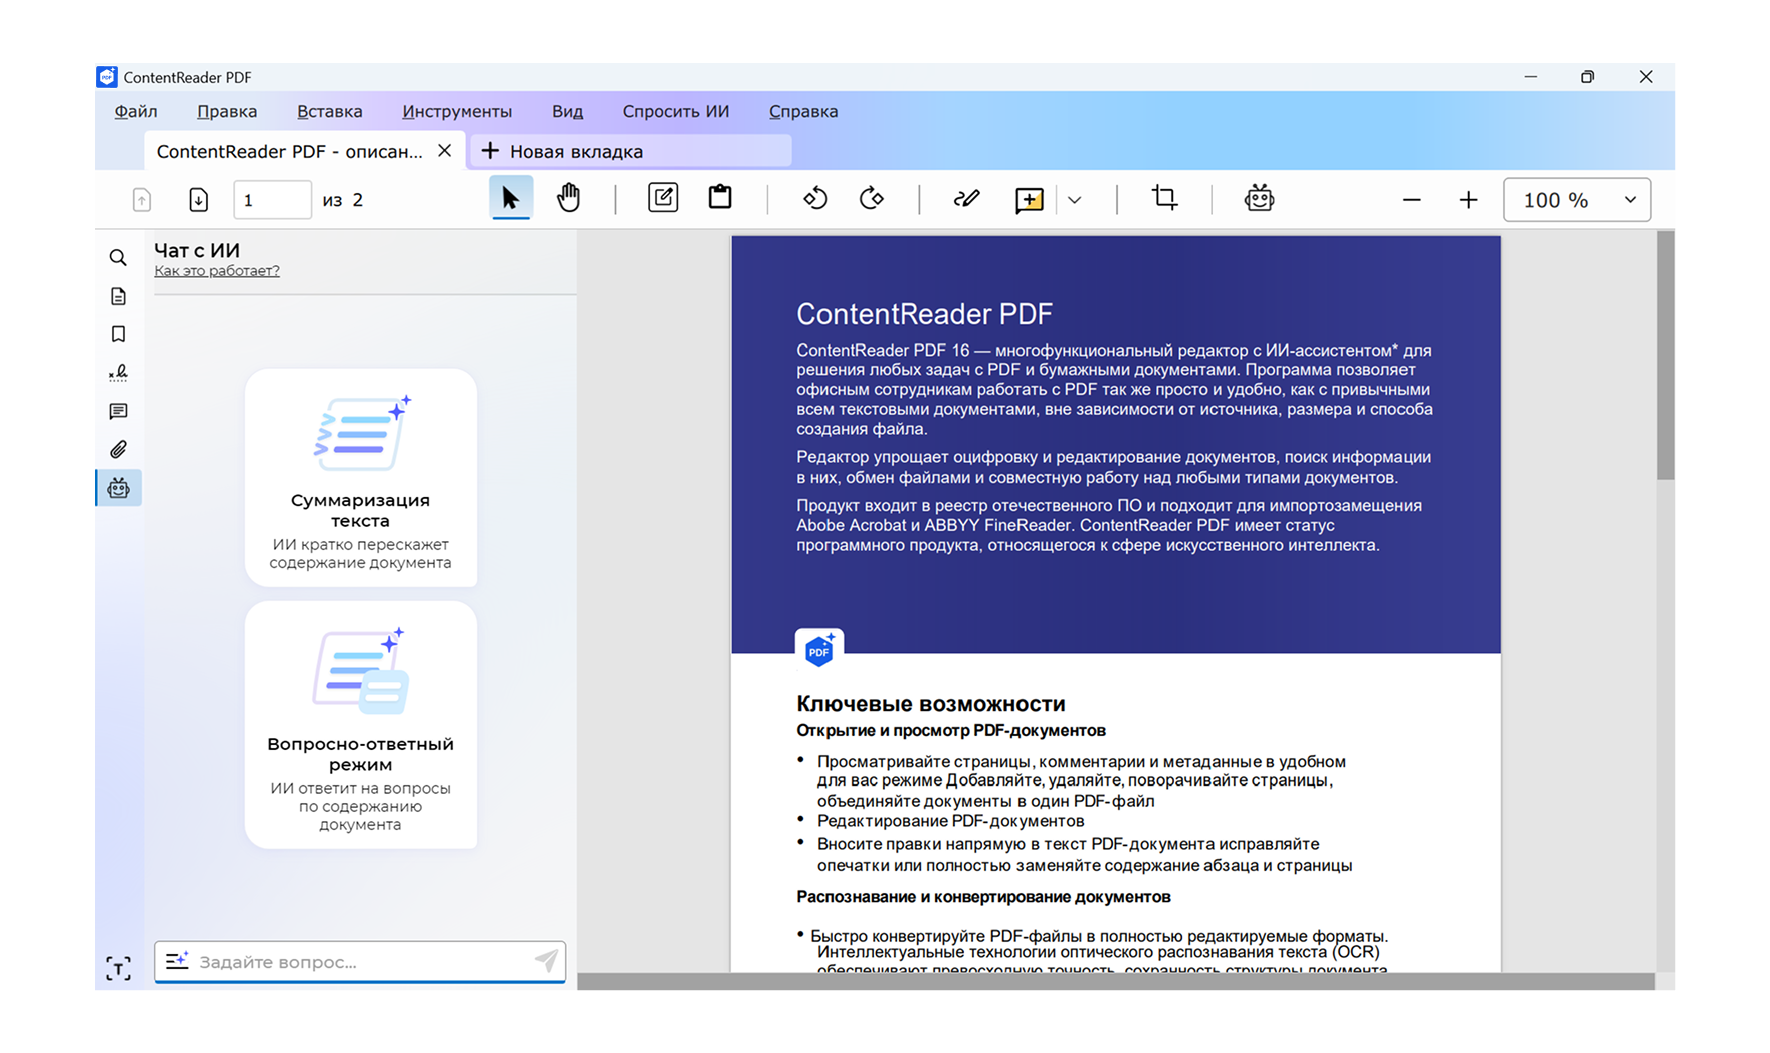
Программа умеет распознавать страницы, редактировать уже отсканированный PDF и переносить данные в распространенные офисные форматы. Для сложных документов полезно сперва определить, что именно требуется сохранить: внешний вид страницы, последовательность текста или таблицу. При подготовке исследования для презентации можно распознать только нужный раздел, перенести таблицу отдельно, а затем сверить заголовки и сноски по исходной странице. Такой маршрут уменьшает риск незаметно потерять структуру при массовом копировании.
ContentReader PDF 16 доступен для Windows и российских Linux-дистрибутивов, что делает его заметным вариантом для организаций с ограничениями по платформе и локальному ПО. Совместимость с ROSA Хром 13 была отдельно подтверждена летом 2026 года. Для компаний, которые мигрируют часть рабочих мест на Linux, это практичнее, чем строить процесс вокруг программы, существующей лишь в Windows или macOS.
При выборе необходимо учитывать границы OCR. В справочных материалах Content AI рукописный текст не относится к поддерживаемому сценарию: продукт ориентирован на печатные документы. На плохо снятых страницах с бликами, перспективным искажением и мелким шрифтом сперва требуется улучшить оригинальное изображение или повторить сканирование. Для юридически значимых документов автоматический экспорт должен завершаться проверкой сумм, дат, наименований и нумерации.
Плюсы
- Ориентация на полный цикл: распознавание, редактирование PDF и экспорт содержимого.
- Широкий набор языков распознавания, включая русский.
- Есть варианты для Windows и Linux-среды российского корпоративного сегмента.
- Подходит для извлечения текста и таблиц из отсканированных документов.
Минусы
- Рукописный текст не относится к штатному сценарию распознавания.
- Для сложной верстки и поврежденных сканов требуется обязательная ручная проверка структуры.
Кому подойдёт
Организациям, которые ищут локальную замену привычному рабочему процессу FineReader и должны обрабатывать русскоязычные печатные документы на Windows или Linux.
Windows и macOS
3. Adobe Acrobat Pro
Adobe Acrobat Pro подходит тем, кому OCR необходим как часть большого PDF-процесса: создание, редактирование, комментарии, формы, сравнение и подготовка документов. обзор Adobe Acrobat Pro помогает отделить функции редактора от возможностей обычного просмотрщика. Инструмент Scan & OCR распознает изображение текста в открытом документе, позволяет задавать страницы и язык, а также запускать обработку нескольких файлов.
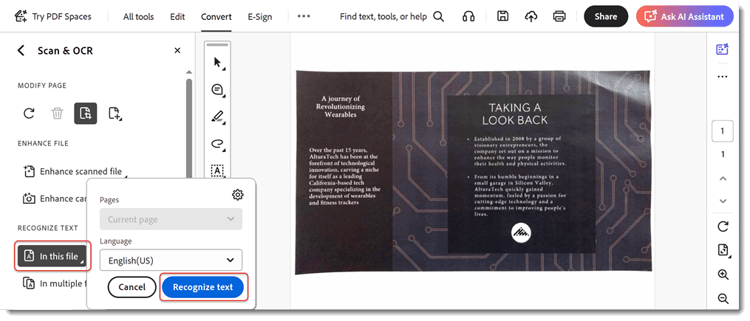
Практический сценарий для агентства — восстановление старого PDF-презентационного архива. Сперва сканы делают доступными для поиска, затем по наименованию клиента или кампании отыскивают нужные страницы, после чего текст и иллюстрации переносят в новый материал. Если требуется редактировать сам скан, Acrobat предлагает режим работы с распознанной страницей: текст становится объектом, который можно корректировать, а оригинальное изображение остается визуальным ориентиром.
Сильная сторона Acrobat — развитая работа после OCR. Там, где FineReader применялся не только ради распознавания, но и ради финального PDF, замена выглядит логично: можно организовать страницы, добавить комментарии, проверить доступность, подготовить форму и собрать окончательную версию в одной среде. Для команд, уже использующих Acrobat в документообороте, отдельный OCR-продукт порой просто дублирует часть имеющихся возможностей.
Для чистого массового распознавания есть более специализированные варианты. Acrobat рассчитан на ручную работу с документом и не заменяет специализированный конвейер извлечения структурированных полей. На сложных журнальных разворотах полезно после OCR проверить порядок чтения, переносы и подписи к изображениям, а при экспорте в Word — открыть несколько страниц из различных типов макета, а не оценивать итог по первой странице.
Плюсы
- OCR встроен в зрелую среду редактирования и проверки PDF.
- Можно обрабатывать текущий документ и несколько файлов.
- После распознавания доступны поиск, правка, комментарии и другие PDF-инструменты.
- Поддерживаются Windows и macOS.
Минусы
- Для специализированного массового извлечения полей и сложных схем документооборота требуется другое решение.
- Экспорт сложной верстки необходимо проверять ручным способом даже при хорошем распознавании символов.
Кому подойдёт
Командам, которые уже строят рабочий процесс вокруг PDF и хотят объединить OCR с редактированием, согласованием и выпуском финальных документов на Windows или macOS.
4. Foxit PDF Editor
Foxit PDF Editor сочетает OCR с привычным редактированием PDF. В обзор Foxit PDF Editor собраны основные сценарии программы, а для распознавания важны три режима итога: поисковый текст поверх изображения, вариант с сохранением исходного вида страницы и редактируемый текст. Пользователь задает диапазон страниц и язык, а в профессиональной редакции может ограничить распознавание выбранной областью.
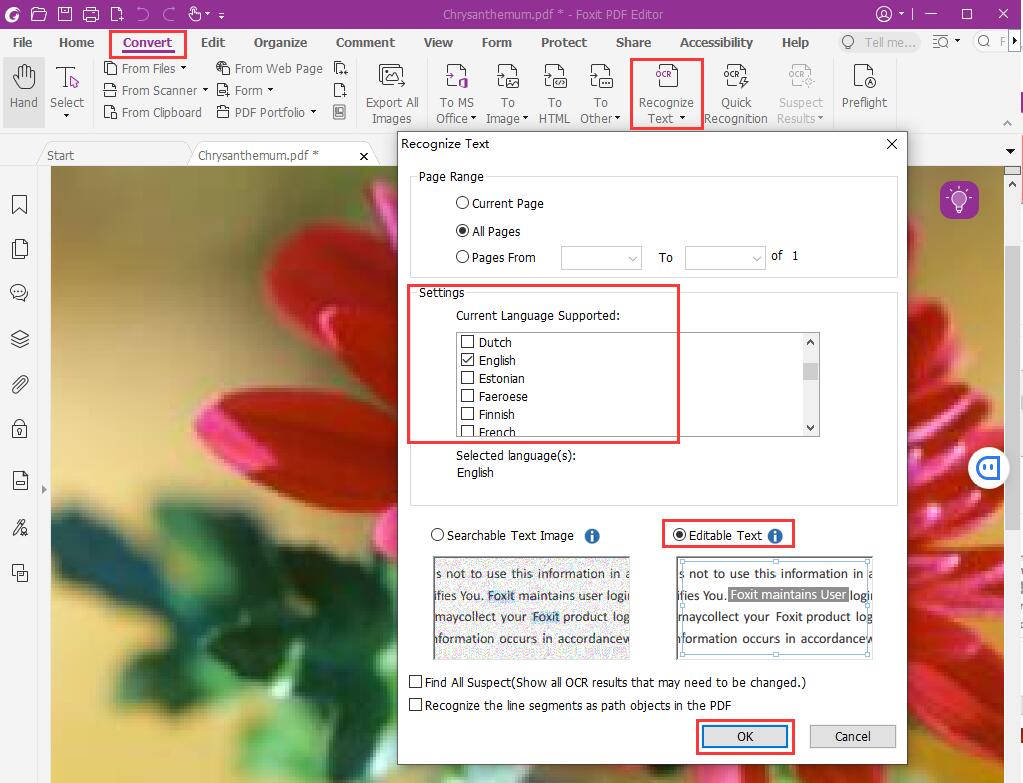
Отдельное достоинство Foxit — работа с сомнительными итогами. После OCR программа умеет помечать фрагменты, в которых распознавание не уверено, и открывать диалог OCR Suspects. В нем рядом показываются оригинальный символ или слово и распознанный вариант, после чего пользователь подтверждает корректный текст либо помечает объект как не-текст. Для договоров, отчетов и публикаций такая проверка полезнее, чем слепое доверие общей оценке качества.
В маркетинговом отделе Foxit удобен для повторного применения PDF-каталогов и материалов партнеров. Сперва документ превращают в поисковый, затем отыскивают нужную спецификацию, проверяют проблемные места и лишь после этого переносят фрагмент в презентацию или текстовый редактор. Если цель — исправить пару строк в отсканированном PDF, режим Editable Text сокращает число промежуточных шагов.
Ограничение связано с комплексностью продукта: функциональность шире, чем необходимо пользователю, который один раз в месяц распознает одну страницу. Помимо этого, режим редактируемого текста сильнее вмешивается в структуру документа, по этой причине для архивов разумнее сохранять оригинальное изображение страницы и добавлять поисковый слой. Таблицы, колонки и нестандартные шрифты после преобразования следует проверять на нескольких типовых страницах.
Плюсы
- Есть различные типы OCR-результата для поиска и редактирования.
- Механизм OCR Suspects помогает точечно проверять сомнительные распознавания.
- Распознавание связано с полноценными средствами редактирования PDF.
- Можно выбирать страницы, языки и, в соответствующей редакции, отдельную область страницы.
Минусы
- Для редких одноразовых задач набор функций может быть избыточным.
- Редактируемый OCR-слой сложных макетов требует визуальной сверки с оригиналом.
Кому подойдёт
Специалистам, которым необходима не только выдача текста, но и контролируемая проверка OCR, редактирование и дальнейшая сборка PDF в Windows или macOS.
5. Wondershare PDFelement
Wondershare PDFelement — еще один PDF-редактор, в котором OCR встроен в общую панель инструментов. обзор PDFelement показывает его как универсальную программу для правки документов. Для скана доступны сценарии превращения страницы в редактируемый текст или создания поискового слоя; тоже предусмотрено распознавание выделенной области и пакетная обработка, что заметно ускоряет работу с серией однотипных файлов.
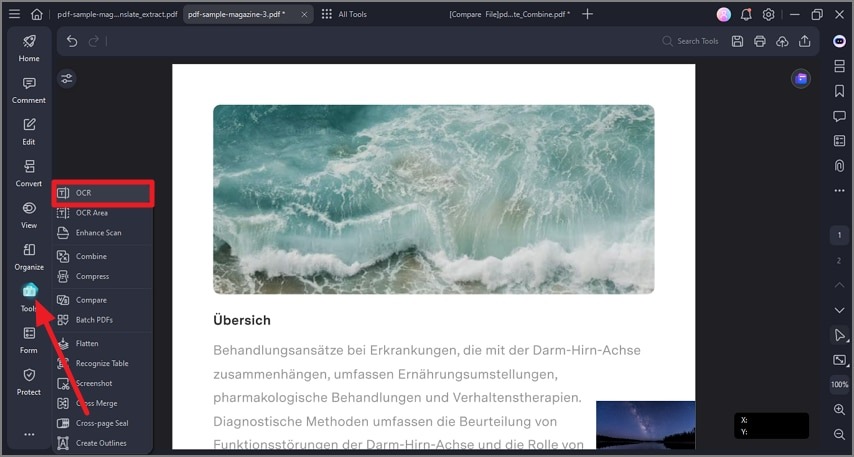
Подход с областью распознавания полезен в коммуникационных задачах. Если из старого отчета необходим только абзац с выводами или одна таблица, нет смысла перестраивать всю страницу. Пользователь выделяет фрагмент, распознает его и переносит в рабочий документ. При полной конвертации, наоборот, стоит заблаговременно решить, важнее ли визуальная близость к исходнику или удобство последующего редактирования — эти цели требуют различных настроек.
Пакетный режим делает PDFelement уместным для небольших архивов: к примеру, когда требуется превратить папку отсканированных актов или исследований в доступные для поиска PDF. Проверку лучше организовать выборочно по типам страниц: обычный текст, таблица, страница с несколькими колонками, мелкий шрифт. Если ошибки концентрируются на одном типе, корректируют сканирование или настройки именно для него, а не повторяют весь массив.
PDFelement не следует воспринимать как замену промышленной системе интеллектуального ввода. Он остается настольным PDF-редактором и эффективнее всего работает там, где человек контролирует итог. Для документов с критичными цифрами требуется финальная сверка, а для конфиденциальных материалов — заблаговременно определить, какие функции выполняются локально и какие сервисные возможности применяются отдельно.
Плюсы
- Есть OCR в редактируемый текст и в поисковый PDF.
- Поддерживается распознавание выбранной области страницы.
- Пакетная обработка подходит для серии документов.
- После OCR доступны инструменты полноценного PDF-редактора.
Минусы
- Не заменяет серверную систему массового захвата и классификации документов.
- Для сложной верстки и ответственных данных нужна выборочная или полная ручная сверка.
Кому подойдёт
Пользователям Windows и macOS, которым необходим единый PDF-редактор с OCR для регулярной, но контролируемой обработки документов и небольших архивов.
6. Readiris PDF 25
Readiris PDF 25 ближе к классическому OCR-продукту: распознавание и конвертация тут занимают центральное место, а не являются побочной возможностью просмотрщика. материал о Readiris помогает оценить этот подход в сравнении с обычными PDF-редакторами. Актуальная ветка Readiris PDF 25 выпущена в 2026 году и доступна для Windows и macOS; программа работает с цифровыми и отсканированными PDF, изображениями и офисными форматами.
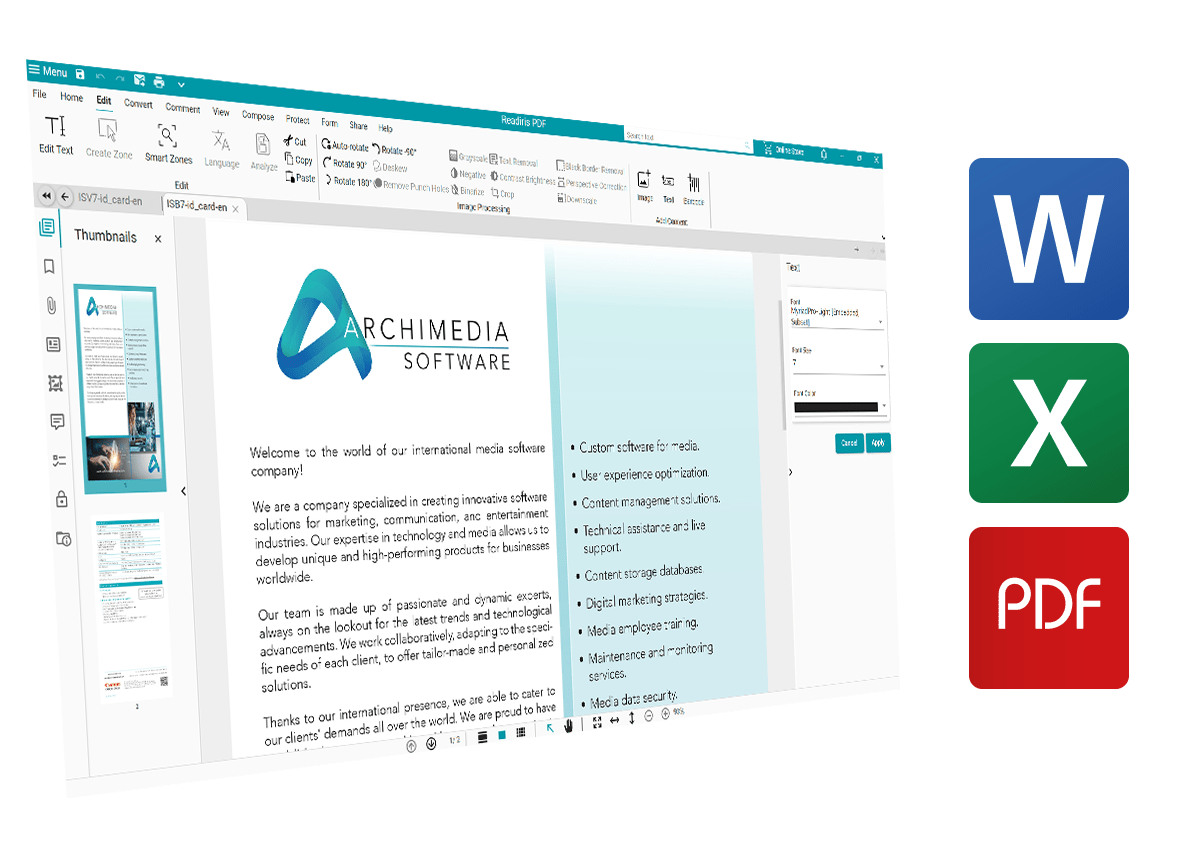
Для маркетинговой команды Readiris полезен там, где систематически приходится разбирать входящие материалы различных типов: презентационный буклет в PDF, снимок страницы, скан таблицы, старый отчет. После распознавания текст можно направить в редактируемый документ, а таблицы — в формат, удобный для дальнейшей работы. Вместе с этим сохранение внешнего вида и получение чистого текста — различные задачи, по этой причине перед пакетной обработкой необходимо выбрать один приоритетный итог.
Рабочий процесс лучше строить через тестовую выборку. Возьмите по две-три страницы каждого типа, распознайте их, проверьте переносы, колонки, таблицы и иллюстрации, потом сохраните целевой формат. Если именно таблицы дают заметно больше ошибок, отделите их в отдельную очередь. Такой прием дает более предсказуемый итог, чем единый профиль для всего архива.
Readiris в особенности логичен для пользователей, которым необходим OCR как самостоятельная дисциплина, а не только возможность искать текст в скане. Но если главная задача — комментирование, совместное согласование и сложное редактирование PDF, универсальные редакторы выше могут оказаться удобнее. При плохом исходнике итог по-прежнему зависит от разрешения, перекоса, контраста и сложности страницы.
Плюсы
- OCR и конвертация находятся в центре продукта.
- Есть версии для Windows и macOS.
- Подходит для преобразования сканов в редактируемые офисные документы и поисковые PDF.
- Удобен для регулярной работы с разнородными входящими материалами.
Минусы
- Для чисто PDF-редакторских задач интерфейс и логика могут быть менее привычны, чем у универсальных редакторов.
- Сложные таблицы и многоколоночные страницы все равно требуют отдельной проверки.
Кому подойдёт
Специалистам, которые часто конвертируют сканы и изображения в редактируемые документы и хотят настольный OCR-инструмент для Windows или macOS.
7. Nitro PDF Pro
Nitro PDF Pro рассматривает OCR как часть ежедневной PDF-работы. В обзор Nitro PDF Pro собраны базовые возможности редактора, а распознавание применяется к уже существующему сканированному PDF. В настройках можно выбрать языки, автоматический поворот и выравнивание страниц, а также поведение программы при открытии сканов — это удобно, когда документы поступают из различных источников и отличаются ориентацией.
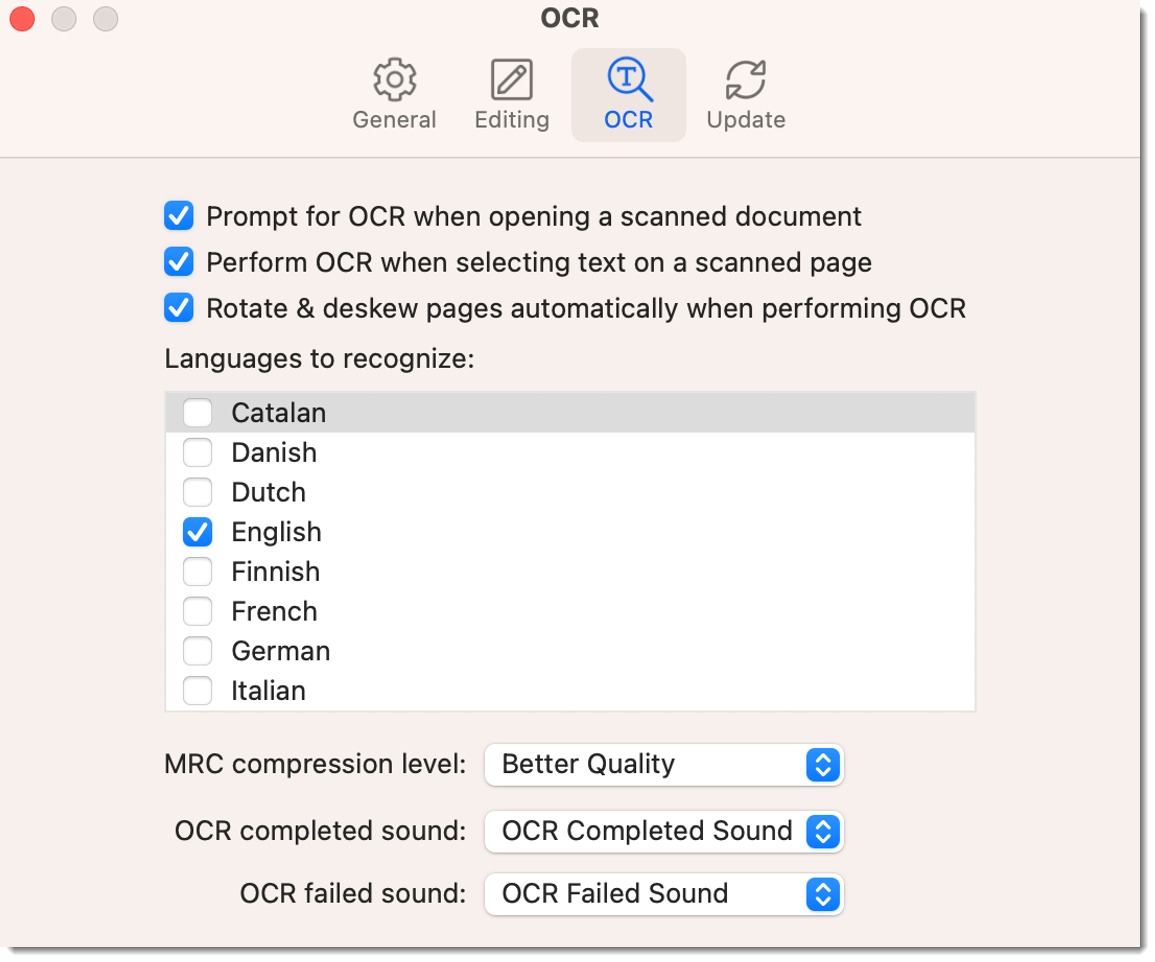
Для отдела продаж или PR такой сценарий работает с архивом коммерческих предложений и партнерских материалов: PDF остается привычным контейнером, но после OCR становится доступен полнотекстовый поиск. Вместо ручного просмотра десятков страниц специалист отыскивает наименование продукта или формулировку, затем сверяет найденный фрагмент по изображению страницы. Такой путь в особенности полезен для материалов, где внешний вид важнее полной перестройки в Word.
Автоматическое выравнивание снижает количество ошибок на слегка перекошенных сканах, но не исправляет все дефекты съемки. Блики, сильная перспектива, тени от переплета и очень низкое разрешение лучше устранять до OCR. Иначе система распознавания будет исправлять следствие, а не причину. Для серии документов полезно сперва отбраковать самые слабые изображения и пересканировать их.
Nitro PDF Pro имеет смысл, когда итоговый формат остается PDF. Если задача — массово извлекать структурированные таблицы, анкеты и поля в базы данных, потребуется другой класс инструментов. При миграции с FineReader тоже стоит проверить языки именно на ваших документах и не переносить старые ожидания автоматически: поведение OCR, управление зонами и экспорт у различных продуктов заметно различаются.
Плюсы
- OCR встроен в полноценную работу с PDF.
- Есть настройки языков, поворота и выравнивания сканированных страниц.
- Удобен для превращения архива сканов в набор доступных для поиска PDF.
- Поддерживает настольный сценарий на Windows и macOS.
Минусы
- Не ориентирован на сложное извлечение структурированных данных в корпоративные системы.
- Качество сильно поврежденных или снятых под углом страниц зависит от предварительной подготовки изображения.
Кому подойдёт
Командам, которые работают главным образом с PDF и хотят добавить полнотекстовый поиск и локальное распознавание в существующий процесс без перехода к отдельной системе захвата данных.
Linux и открытые OCR-инструменты
В Linux замена FineReader чаще строится не вокруг одного монолитного приложения, а вокруг связки сканирования, OCR-движка и утилит для PDF. Это дает больше контроля и автоматизации, но требует точнее понимать, какой этап выполняет каждый компонент. Для графической работы удобны NAPS2 и gImageReader; для пакетного PDF — OCRmyPDF; базовый движок Tesseract полезен как фундамент собственных сценариев.
8. NAPS2
NAPS2 — бесплатная открытая программа для сканирования и PDF, доступная на Windows, macOS и Linux. обзор NAPS2 полезен тем, кто ищет не столько редактор, сколько надежный конвейер «сканер → страницы → PDF». OCR можно включить для создания поискового текстового слоя, выбрать язык и сохранить обработку как часть профиля сканирования.
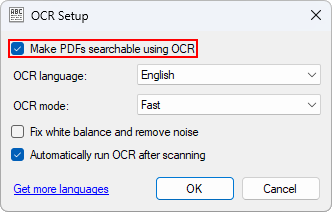
Сильная сторона NAPS2 — повторяемость. В отделе документооборота можно завести различные профили для договоров, входящих писем и архивных материалов: свой источник сканирования, цветовой режим, разрешение и обработка. После сканирования страницы переставляются, поворачиваются и объединяются, а OCR делает итоговый PDF доступным для поиска. Это ближе к производственной рутине, чем к разовой конвертации одной картинки.
Для автоматизации у проекта есть интерфейс командной строки. Он полезен там, где файлы появляются по расписанию или проходят одинаковую последовательность действий. Вместе с этим NAPS2 не стремится быть сложным текстовым редактором: он лучше всего работает как средство захвата и подготовки PDF, после чего содержимое при необходимости открывают в ином приложении.
Если исходная задача FineReader заключалась именно в распознавании сложной верстки с последующей правкой текста, NAPS2 не повторит весь этот опыт. Зато для архивов, регистрационных папок и обычных одноколоночных документов его простая схема часто оказывается рациональнее. Проверять необходимо в первую очередь читаемость поискового слоя, ориентацию страниц и корректность выбранного языка.
Плюсы
- Бесплатный открытый проект для Windows, macOS и Linux.
- OCR встраивается непосредственно в процесс сканирования и создания PDF.
- Профили помогают повторять одинаковые параметры для различных типов документов.
- Есть командная строка для автоматизации рутинных операций.
Минусы
- Не является полноценным редактором распознанного текста уровня специализированного OCR-пакета.
- Сложные журнальные макеты и таблицы требуют добавочного инструмента или ручной проверки.
Кому подойдёт
Организациям и частным пользователям, которым важнее стабильное сканирование, сборка многостраничных PDF и поисковый OCR-слой, чем глубокая переработка макета.
9. gImageReader
gImageReader — графическая оболочка для Tesseract OCR с интерфейсами на GTK и Qt. обзор gImageReader поясняет его роль: программа принимает изображения и PDF, позволяет выбирать области страницы, запускать распознавание и работать с итогом в виде обычного текста или hOCR. Для пользователя Linux это один из методов получить удобный настольный интерфейс поверх мощного открытого движка.
Работа по зонам в особенности полезна для страниц, где автоматическое определение структуры дает неверный порядок чтения. На буклете с двумя колонками можно отдельно выделить заголовок, левую и правую колонку, затем распознать их в нужной последовательности. Это требует больше ручных действий, зато пользователь контролирует структуру вместо того, чтобы исправлять смешанный текст после полной автоматической конвертации.
gImageReader подходит для небольших и средних задач: извлечь текст из скриншота, страницы отчета, книги или отсканированного письма, собрать несколько изображений в сессию и проверить итог. Для команды контента это удобно как локальный инструмент быстрой расшифровки, в особенности если материалы нельзя отправлять во внешний браузерный сервис.
Ограничения наследуются от архитектуры: качество зависит от Tesseract и выбранных языковых данных, а восстановление сложного офисного документа не является главной целью. hOCR дает информацию о расположении текста, но полноценная реконструкция таблиц и дизайна потребует дальнейшей обработки. На Windows программа тоже доступна, но в рейтинге мы относим ее к открытым Linux-инструментам, где она в особенности востребована.
Плюсы
- Удобная графическая оболочка поверх Tesseract.
- Ручной выбор областей помогает контролировать порядок распознавания сложной страницы.
- Работает с изображениями и PDF.
- Подходит для локального извлечения текста без передачи документа браузерному сервису.
Минусы
- Не восстанавливает сложную офисную верстку так же, как специализированные коммерческие OCR-пакеты.
- Качество и набор языков зависят от установленного Tesseract и языковых данных.
Кому подойдёт
Пользователям Linux и техническим специалистам, которым необходим визуальный интерфейс для Tesseract и ручной контроль зон распознавания без сложной корпоративной системы.
10. OCRmyPDF
OCRmyPDF решает узкую, но очень важную задачу: добавляет текстовый OCR-слой в существующий PDF, стараясь сохранить оригинальное изображение страницы. обзор OCRmyPDF в особенности уместен для архивов, где внешний вид документа нельзя заменять полностью перестроенной версией. Инструмент применяет Tesseract, умеет исправлять поворот и перекос, поддерживает выпуск PDF/A и работает из командной строки.
Для архивной коллекции это сильный сценарий. Сотни исторических PDF уже выглядят правильно, но по ним нельзя искать. Вместо экспорта в Word и обратной сборки OCRmyPDF проходит по файлам, добавляет невидимый текст и оставляет визуальный слой. После обработки сотрудник проверяет поиск по нескольким контрольным словам и открывает страницу, чтобы убедиться, что найденный фрагмент соответствует изображению.
Командная строка делает инструмент удобным для автоматизированного процесса: обработку можно запускать по папкам, включать в серверные задания и сочетать с другими утилитами. Для разработчика или администратора это дает гораздо больше контроля, чем графическая кнопка. Одновременно возрастает ответственность за параметры: язык, поворот, обработка уже распознанных файлов и политика ошибок должны быть заблаговременно определены.
OCRmyPDF не редактирует текст как офисный документ и не предназначен для визуальной перестройки сложной страницы. Его сильная сторона — searchable PDF. Если цель — извлечь таблицу в Excel или массово править абзацы, после OCR потребуется иной инструмент. Для конфиденциальных архивов локальная архитектура в особенности привлекательна, поскольку процесс можно держать внутри собственной инфраструктуры.
Плюсы
- Сохраняет визуальный вид PDF и добавляет поисковый текстовый слой.
- Поддерживает автоматизацию через командную строку.
- Есть функции поворота, выравнивания и подготовки архивного PDF/A.
- Работает локально и подходит для больших коллекций документов.
Минусы
- Нет привычного графического редактора распознанного текста.
- Не является инструментом восстановления сложной верстки в офисный формат.
Кому подойдёт
Архивам, библиотекам, ИТ-отделам и техническим командам, которым необходимо массово сделать существующие PDF доступными для поиска без изменения визуального слоя.
11. Tesseract OCR
Tesseract OCR — открытый движок распознавания, а не готовый настольный редактор. В главном репозитории проекта он описан как OCR-engine с поддержкой более ста языков и выводом в текст, hOCR, PDF, TSV, ALTO и PAGE. Отсутствие собственного универсального интерфейса — одновременно ограничение и преимущество: Tesseract легко встраивается в приложения и сценарии, но обычному офисному пользователю удобнее работать через оболочку вроде gImageReader или через OCRmyPDF.
Для технической команды Tesseract полезен там, где распознавание необходимо встроить в собственный процесс. К примеру, система получает изображения из внутреннего хранилища, подготавливает контраст и ориентацию, запускает OCR для русского и английского, а затем передает текст в индекс поиска. Такой процесс можно измерять и менять вне зависимости от интерфейса конечного пользователя.
Форматы hOCR, TSV, ALTO и PAGE важны, когда кроме текста необходимы координаты и структура распознанных элементов. Это уже не типичный офисный сценарий, а основа для дальнейшей аналитики документов, архивных систем и собственных конвейеров. Вместе с этим движок не обязан сам решать, как восстановить красивую страницу в Word — эту задачу берет на себя программа вокруг него.
При миграции с FineReader на Tesseract следует заблаговременно заложить инженерную работу: установка языковых моделей, предварительная обработка изображений, правила для поворота, выбор режима сегментации, постобработка и контроль качества. Без этого сравнение будет некорректным: готовый коммерческий пакет включает многие из этих шагов в интерфейс, а тут они становятся явной частью процесса.
Плюсы
- Открытый OCR-движок с большим набором языков и выходных форматов.
- Хорошо встраивается в автоматизированные и серверные процессы.
- Поддерживает структурированные форматы с координатами распознанного текста.
- Работает локально и служит основой для множества других OCR-инструментов.
Минусы
- Нет встроенного универсального настольного интерфейса для офисного пользователя.
- Для стабильного итога требуется самостоятельно организовать подготовку изображений, параметры распознавания и контроль качества.
Кому подойдёт
Разработчикам, администраторам и исследовательским командам, которым необходим не готовый PDF-редактор, а настраиваемый OCR-движок для собственной инфраструктуры.
Онлайн
Браузерные методы удобны для разовых материалов и работы с любого компьютера, но меняют модель конфиденциальности: файл передается внешнему сервису. Для публичного буклета это часто приемлемо, для договора с персональными данными или внутреннего исследования — уже отдельное решение службы безопасности. Перед загрузкой стоит проверить политику обработки документов и внутренние правила организации.
12. Google Drive + Google Docs
Связка Google Drive и Google Docs подходит для быстрого превращения PDF или изображения в редактируемый документ без отдельной настольной программы. обзор Google Docs полезен для понимания совместной работы в Docs. В Drive файл открывается через Google Docs, после чего сервис извлекает текст; в актуальном Google Workspace тоже развита работа с редактируемыми PDF внутри Docs.
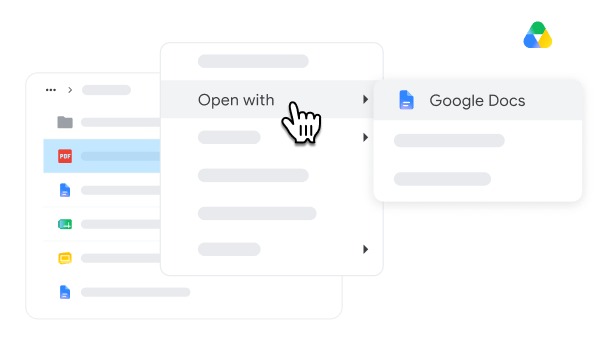
Главное ограничение этого метода — восстановление сложной структуры. Справка Google отдельно предупреждает, что базовое форматирование вроде начертания и переносов воспроизводится лучше, чем списки, таблицы, колонки, сноски и концевые примечания. По этой причине метод хорошо работает для обычной страницы с последовательным текстом, но не должен быть первым выбором для каталога с сеткой, финансовой таблицы или журнального разворота.
Для команды контента сценарий простой: загрузить публичный PDF-отчет, открыть в Docs, получить редактируемый текст, сверить абзацы с исходной страницей и перенести нужные данные в рабочий документ. В особенности важно проверять цифры, наименования компаний и подписи к диаграммам. Если таблица критична, ее лучше обработать отдельным инструментом, чем исправлять ручным способом после распада структуры.
Такой метод выигрывает доступностью и совместной правкой, но проигрывает локальным инструментам по контролю над документом. Конфиденциальные материалы нельзя отправлять в облачную среду только из-за удобства OCR — сперва действует политика компании. Для регулярного потока однотипных сканов настольная или автоматизированная система будет предсказуемее.
Плюсы
- Работает в браузере и сразу переводит итог в совместно редактируемый документ.
- Удобен для обычных текстовых PDF и изображений.
- Не требует отдельного локального OCR-интерфейса.
- Итог легко включить в дальнейшую работу с документами Google Workspace.
Минусы
- Таблицы, колонки и сложные элементы верстки могут переноситься неудовлетворительно.
- Передача файла в облако не подходит для материалов, которые по внутренним правилам должны обрабатываться локально.
Кому подойдёт
Редакторам, маркетологам и небольшим командам, которым необходимо быстро получить текст из неконфиденциального PDF и продолжить совместную работу в браузере.
13. OnlineOCR.net
OnlineOCR.net — специализированный браузерный OCR-сервис для PDF и изображений. В обзор OnlineOCR.net он разобран как самостоятельный метод извлечения текста. Сервис поддерживает 46 языков распознавания и выдает итог в PDF, Word, Excel, RTF или обычный текст, а перед OCR выполняет автоматический поворот и выравнивание страниц.
Это удобный инструмент для точечной задачи: получить текст из одной-двух страниц или быстро проверить, как документ переносится в офисный формат. К примеру, специалист получает скан коммерческого предложения, выбирает русский язык, преобразует файл в редактируемый документ и сопоставляет несколько абзацев с изображением. Если итог удовлетворителен, дальше работает уже с текстом; если таблица распалась, меняет метод, а не тратит время на ручную перестройку всей страницы.
Сервис принимает многостраничные PDF и распространенные растровые форматы. В реальной работе следует отделять техническую возможность от политики данных. Условия хранения и удаления файлов необходимо проверять перед применением, в особенности если документ содержит персональные сведения, коммерческую тайну или внутреннюю финансовую информацию. Для такого контента локальный OCR обычно легче согласовать.
Еще одно ограничение онлайн-метода — зависимость от качества исходника и сетевого процесса. Если скан перекошен на 20 градусов, снят с бликом или содержит очень мелкий текст, автоматическое выравнивание не восстановит отсутствующие детали. Повысить качество OCR часто проще не заменой программы, а повторным получением более четкого исходного изображения.
Плюсы
- Специализированный OCR в браузере без настольного интерфейса.
- Поддерживает PDF и распространенные изображения.
- Есть несколько форматов итога, включая Word, Excel, RTF и текст.
- Выполняет автоматический поворот и выравнивание перед распознаванием.
Минусы
- Облачная обработка требует отдельной оценки допустимости для конфиденциальных документов.
- Сложная верстка и плохие исходные изображения могут потребовать иного инструмента или пересканирования.
Кому подойдёт
Пользователям, которым необходим разовый OCR неконфиденциальных документов с выбором офисного формата и без установки настольной программы.
14. OCR.Space
OCR.Space — браузерный сервис распознавания PDF и изображений с отдельными OCR-движками и режимами для многостраничных и многоколоночных материалов. обзор OCR.Space показывает его как легкий веб-инструмент для получения текста и searchable PDF. Русский язык входит в поддерживаемые варианты, по этой причине сервис можно применять для быстрых проверок русскоязычных сканов.
В отличие от универсального PDF-редактора, OCR.Space лучше рассматривать как отдельный этап. Пользователь передает файл, выбирает параметры распознавания и получает текстовый итог или PDF с поисковым слоем. Дальнейшая правка выполняется уже в ином приложении. Это удобно для автоматизированной цепочки, когда распознавание не должно тащить за собой большой редактор.
Для сложной страницы важно проверять порядок чтения. Многоколоночный режим помогает, но не гарантирует идеальную реконструкцию любого дизайнерского макета. На рекламном буклете с плашками, подписями и несколькими смысловыми зонами лучше сопоставить итог построчно или распознавать отдельные области. Для обычного отчета с одной колонкой процесс заметно проще.
Как и у любого внешнего веб-сервиса, область применения определяется не только функциями. Конфиденциальный документ должен проходить через согласованную среду; публичные пресс-релизы, открытые исследования и некритичные материалы подходят для такого метода лучше. Для регулярной обработки большого внутреннего архива логичнее локальный или собственный автоматизированный OCR.
Плюсы
- Работает в браузере и поддерживает русский язык.
- Есть сценарии для многостраничных и многоколоночных документов.
- Можно получить текст или searchable PDF.
- Подходит как отдельный OCR-этап в простом рабочем процессе.
Минусы
- Не заменяет полноценный PDF-редактор после распознавания.
- Облачная обработка ограничивает применение документов с внутренними или чувствительными данными.
Кому подойдёт
Тем, кому необходим быстрый браузерный OCR для публичных или некритичных документов и кто готов выполнять дальнейшую правку в ином приложении.
Android и iPhone
На смартфоне полноценная замена FineReader обычно необходима не как настольный редактор, а как точка захвата: сфотографировать документ, выровнять перспективу, собрать страницы в PDF и сделать текст доступным для поиска или копирования. Мобильный этап в особенности полезен в полевых интервью, на мероприятиях и при работе с бумажными материалами вне офиса.
15. Adobe Scan
Adobe Scan превращает камеру Android или iPhone в документ-сканер: определяет границы страницы, исправляет перспективу, очищает изображение и применяет OCR, чтобы PDF стал доступен для поиска и повторного применения текста. обзор Adobe Scan полезен тем, кто строит мобильный сценарий захвата. Это не копия настольного FineReader, а компактный вход в документный процесс.
Для маркетолога мобильный OCR востребован на конференциях и выставках: сфотографировать раздаточный материал, программу события или печатный отчет, собрать несколько страниц и позднее отыскать нужную фразу. Основное качество закладывается в момент съемки. Страница должна быть полностью в кадре, камера — параллельна листу, свет — равномерным, а мелкий текст — достаточно крупным на исходном изображении.
После автоматической коррекции полезно просмотреть границы каждой страницы. Если приложение обрезало номер страницы, подпись к диаграмме или часть таблицы, OCR уже не сможет восстановить потерянное. Для длинного документа лучше делать короткие серии и сразу проверять качество, чем обнаружить проблему после десятков страниц.
Adobe Scan удобен как мобильная точка захвата, но глубокая работа с распознанным содержимым продолжается в PDF-редакторе или офисном приложении. Для документов, которые по правилам организации нельзя помещать в облачные сервисы, следует применять согласованный локальный сценарий сканирования. Мобильная скорость не отменяет требования к защите данных.
Плюсы
- Автоматически определяет границы и корректирует перспективу снимка документа.
- OCR делает отсканированный PDF доступным для поиска и копирования текста.
- Работает на Android и iPhone.
- Удобен для захвата материалов вне офиса.
Минусы
- Не заменяет настольный редактор для глубокой правки сложного PDF.
- Качество сильно зависит от съемки: света, резкости, перспективы и полноты кадра.
Кому подойдёт
Специалистам, которым необходимо быстро оцифровывать бумажные материалы смартфоном и затем работать с поисковым PDF или извлеченным текстом.
16. Microsoft OneDrive
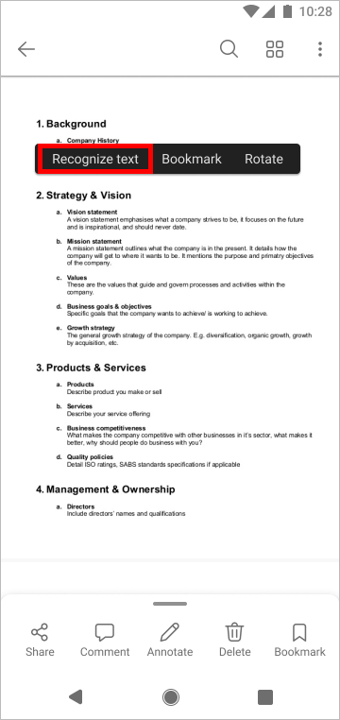
Microsoft OneDrive в мобильных приложениях Android и iOS получил OCR для уже отсканированных PDF: после долгого нажатия на страницу в контекстном меню появляется команда Recognize text, а после обработки текст можно выделять и копировать. обзор возможностей OneDrive для PDF помогает рассматривать OneDrive не только как хранилище, но и как мобильный PDF-инструмент. Функция распространяется поэтапно, по этой причине ее наличие зависит от текущего развертывания приложения.
В 2026 году этот вариант в особенности важен из-за окончания Microsoft Lens. Поддержка Lens прекратилась в феврале, а создание новых сканов — в марте; Microsoft указывает OneDrive как рекомендуемую замену для мобильного сканирования. По этой причине старые подборки, где Lens стоит отдельным актуальным приложением, уже вводят в заблуждение. Для нового процесса лучше сразу строить маршрут через OneDrive или другой действующий сканер.
Практический сценарий OneDrive — быстро отыскать и скопировать текст из сохраненного скана на телефоне. К примеру, перед встречей сотрудник открывает PDF-приложение к договору, распознает страницу и копирует пункт в рабочую заметку. Для длинного многостраничного архива это не альтернатива настольному пакетному OCR: мобильный интерфейс ориентирован на точечную работу.
Есть и организационное ограничение: сканы хранятся в OneDrive, а мобильное сканирование не предназначено для локального сохранения итога как автономного файла на устройстве в сценарии замены Lens. По этой причине перед переходом важно проверить требования компании к хранилищу, учетным записям и доступу. Для локального закрытого процесса лучше выбрать настольный инструмент.
Плюсы
- OCR встроен в мобильный просмотр сканированных PDF.
- После распознавания текст можно выделять и копировать.
- OneDrive заменяет часть сценариев завершившего работу Microsoft Lens.
- Подходит для быстрого доступа к сканам на Android и iPhone.
Минусы
- OCR-функция распространяется поэтапно и может появляться у пользователей не одновременно.
- Не рассчитан на настольную пакетную обработку и сложное восстановление верстки.
Кому подойдёт
Пользователям Microsoft 365 и OneDrive, которым необходим мобильный поиск и копирование текста из сканированных PDF и простой переход со старого Microsoft Lens.
Как выбрать замену под конкретную задачу
Универсальной замены FineReader для всех сценариев нет, потому что под одним наименованием ранее часто объединялись различные ожидания. Один сотрудник распознавал договоры, другой превращал книги в Word, третий делал searchable PDF, четвертый извлекал таблицы. Правильная матрица начинается с итога, а уже затем выбирается интерфейс.
Для обычных сканов и редактирования PDF
Если после OCR документ необходимо ручным способом править, переставлять страницы, добавлять комментарии и выпускать в PDF, логичнее начинать с PDF Commander, ContentReader PDF, Adobe Acrobat, Foxit, PDFelement или Nitro. В этой группе решающим становится не сам факт наличия OCR, а удобство проверки и последующей правки. Возьмите один типовой документ и измерьте время от открытия скана до готового проверенного PDF.
Для архива и полнотекстового поиска
Когда внешний вид страниц уже устраивает, а задача состоит в поиске по тысячам сканов, предпочтительнее не перестраивать документ в офисный формат. NAPS2 подходит для захвата новых страниц, OCRmyPDF — для существующего PDF-архива, а Tesseract — для собственной автоматизации. Проверка простая: после обработки отыскать десять заблаговременно выбранных слов на различных страницах и убедиться, что поиск ведет к правильным местам.
Для таблиц и повторного применения контента
Если материалы систематически превращаются в статьи, презентации или аналитические таблицы, оценивайте не только число распознанных символов, но и сохранение структуры. ContentReader PDF, Readiris и полноценные PDF-редакторы удобнее тестировать на реальных таблицах и многоколоночных страницах. Для единичного публичного файла подойдут Google Docs или OnlineOCR.net, но итог таблиц нельзя принимать без сверки строк и столбцов.
Для Linux и локальной автоматизации
В Linux наиболее гибкая архитектура строится из открытых компонентов: NAPS2 для сканирования, gImageReader для визуальной работы по зонам, OCRmyPDF для searchable PDF, Tesseract как базовый движок. Такой стек требует настройки, зато позволяет держать документы внутри собственной инфраструктуры и повторять обработку скриптами. Для пользователя, которому необходим готовый PDF-редактор, проще начать с PDF Commander или ContentReader PDF.
Для мобильного захвата
На смартфоне критерии меняются: важны автоматические границы, коррекция перспективы, контроль резкости и удобное сохранение многостраничного PDF. Adobe Scan хорошо закрывает сам захват и OCR, OneDrive — быстрый поиск и копирование текста в уже сохраненных сканах. Качество необходимо проверять прямо во время съемки, потому что обрезанная или смазанная часть страницы не восстановится на этапе распознавания.
Как измерить качество OCR на своих документах
Самая надежная проверка — собственный контрольный набор. OCR-D рекомендует оценивать распознавание на репрезентативных данных с эталонной ручной расшифровкой и отдельно учитывать качество текста, структуры, время и ресурсы. Для бизнеса не нужен лабораторный стенд на тысячи страниц: достаточно небольшой, но разнообразной выборки, которая повторяет реальные документы отдела.
- Шаг 1. Соберите 20 страниц. Пять чистых офисных документов, пять сканов среднего качества, пять страниц с таблицами или колонками и пять сложных страниц с графикой, подписями и мелким текстом.
- Шаг 2. Сделайте эталон. Ручным способом сохраните правильный текст хотя бы для нескольких абзацев на каждой странице. Для таблиц отдельно зафиксируйте правильные строки и столбцы.
- Шаг 3. Запустите одинаковый сценарий. Один язык, одинаковый диапазон страниц, сопоставимый тип итога и одинаковая предварительная подготовка изображения.
- Шаг 4. Посчитайте CER. Character Error Rate — доля вставок, удалений и замен символов относительно эталонного текста. Чем ниже значение, тем меньше исправлений требуется на уровне символов.
- Шаг 5. Проверьте структуру. Отдельно отметьте ошибки порядка чтения, сломанные колонки, потерянные таблицы, неверные подписи и пропавшие изображения. Низкий CER не гарантирует правильную верстку.
- Шаг 6. Измерьте время. Запишите продолжительность OCR и минуты ручной корректуры на 10 страниц. Для рабочего процесса важнее общее время до проверенного итога, чем скорость самого движка.
- Шаг 7. Повторите на двух сотрудниках. Если один интерфейс требует постоянного обучения и ручной настройки, это проявится в разбросе времени и количестве исправлений.
Character Error Rate строится на редакционном расстоянии: считаются вставленные, удаленные и замененные символы. К примеру, если движок правильно прочитал длинный абзац, но трижды спутал похожие буквы и один знак пропустил, CER покажет небольшую текстовую ошибку. Однако для страницы с двумя колонками текст может быть распознан посимвольно практически безошибочно и вместе с этим идти в неправильном порядке. По этой причине OCR-D отдельно подчеркивает значение оценки структуры и порядка чтения.
Для коммерческого решения стоит добавить еще три операционных показателя: долю страниц, которые сотрудник принял без ручной правки; среднее время корректуры одной страницы; долю документов, где пришлось повторить сканирование. Эти цифры напрямую отражают нагрузку на команду. Если новый инструмент распознает чуть медленнее, но сокращает ручную проверку вдвое, он может быть эффективнее в реальной работе.
Минимальный приемочный тест перед внедрением
- Открыть PDF, где каждая страница является изображением, и убедиться, что после OCR работает поиск по русскому слову в середине документа.
- Скопировать два абзаца с числами, дефисами и латиницей; сопоставить с оригиналом посимвольно в критичных местах.
- Проверить таблицу: число строк и столбцов, заголовки, десятичные разделители, даты и знаки процента.
- Проверить страницу с двумя колонками и убедиться, что порядок чтения не перескакивает между ними.
- Экспортировать три различные страницы в целевой формат и открыть итог в том приложении, где команда будет продолжать работу.
- Повторить процедуру на плохом скане, чтобы увидеть не только лучший, но и типичный слабый сценарий.
- Зафиксировать время OCR и ручной корректуры; решение принимать по времени до проверенного итога, а не по впечатлению от одной кнопки.
Типовые ошибки при переходе с FineReader
Сопоставлять только по списку функций
Две программы могут обе иметь OCR, экспорт в Word и работу с PDF, но давать различный итог на конкретном макете. Список возможностей отвечает на вопрос «операция существует», а не «насколько она подходит вашим документам». По этой причине функциональное сравнение — фильтр первого уровня, а решение принимается после тестового набора.
Считать любой PDF текстовым
PDF — контейнер. Внутри может быть обычный текст, скан-изображение или комбинация слоев. Если выделение мышью не работает, сперва необходимо понять структуру файла. У Xeon Live есть отдельный материал о том, почему текст из PDF не копируется и как отличить защиту от отсутствующего OCR-слоя.
Экспортировать весь архив без пилотной выборки
Массовая обработка усиливает любую ошибку. Неправильный язык, неверный порядок колонок или лишний режим очистки может испортить сотни страниц одинаковым образом. Сперва обрабатывают несколько представителей каждого типа, сохраняют параметры, затем масштабируют процесс и проверяют выборку после каждой крупной партии.
Игнорировать оригинальное изображение
OCR не восстанавливает детали, которых нет на снимке. Сильный JPEG-шум, блик, тень от переплета, смаз и чрезмерно мелкий текст напрямую ухудшают итог. Порой повторное сканирование дает больший эффект, чем смена движка. Для новых архивов полезно стандартизировать разрешение, ориентацию и цветовой режим еще до распознавания.
Не проверять цифры и имена собственные
Даже единичная ошибка может быть критичной, если это сумма в договоре, дата исследования, фамилия спикера, артикул или наименование бренда. Такие элементы следует включать в обязательную ручную выборку. Для контентной публикации этот контроль в особенности важен: OCR-ошибка легко превращается в фактическую ошибку материала.
Отправлять чувствительные документы в случайный веб-сервис
Удобство браузерного OCR не отменяет корпоративных требований к данным. Перед обработкой договоров, персональных данных, внутренних исследований и финансовых материалов необходимо определить разрешенную среду. Если внешняя обработка не согласована, применяют локальный настольный инструмент или собственный OCR-контур.
Заменять Microsoft Lens по старым рекомендациям
Списки мобильных OCR-приложений быстро устаревают. Microsoft Lens завершил жизненный цикл в 2026 году: приложение удалено из магазинов, новые сканы больше не создаются, а Microsoft направляет пользователей к OneDrive. При выборе мобильного инструмента важно проверять не только функцию OCR, но и текущий статус продукта.
Рабочий алгоритм внедрения в команду
Для отдела из нескольких человек переход лучше оформлять как небольшой управляемый проект. Цель — не заставить всех освоить новый интерфейс, а сократить время от получения скана до проверенного материала. Практический процесс укладывается в семь этапов.
- 1. Инвентаризация. Перечислите типы документов и конечные форматы: searchable PDF, Word, Excel, обычный текст, архивный PDF/A.
- 2. Разделение по риску. Отделите публичные материалы от конфиденциальных. Это сразу определит, где допустим браузерный сервис, а где необходим локальный вариант.
- 3. Контрольный набор. Соберите 20–30 страниц, включая хорошие и плохие примеры, таблицы, колонки и смешанный русский/латинский текст.
- 4. Два финалиста на сценарий. Не сопоставляйте все шестнадцать одновременно. Для каждого рабочего маршрута оставьте два наиболее подходящих продукта.
- 5. Измерение. Запишите CER для эталонных фрагментов, число структурных ошибок и время ручной корректуры.
- 6. Пилот. Дайте решения двум сотрудникам на реальной неделе работы и соберите не впечатления, а число обработанных страниц, исправлений и повторных сканов.
- 7. Регламент. Зафиксируйте, какие документы обрабатываются каким методом, как проверяются критичные поля и где хранится итоговый файл.
Для PDF-процесса полезно сразу согласовать и последующую редактуру. Редактирование PDF после распознавания отличается от простого копирования текста: порой лучше оставить визуальный слой, порой — полностью перестроить документ, а порой — извлечь только нужный фрагмент. Чем точнее этот выбор зафиксирован в регламенте, тем меньше лишних преобразований.
Что выбрать в итоге
Для настольной работы на Windows и Linux первым в рейтинге стоит PDF Commander: он объединяет OCR, сканирование и обычное редактирование PDF. ContentReader PDF 16 ближе к классическому специализированному распознаванию и в особенности уместен в российской Windows/Linux-среде. На Windows и macOS наиболее цельные PDF-процессы предлагают Adobe Acrobat, Foxit, PDFelement, Readiris и Nitro, но их удобство необходимо проверять на собственных макетах.
В открытом стеке роли разделяются: NAPS2 отвечает за захват и сборку, gImageReader дает графический доступ к Tesseract, OCRmyPDF добавляет searchable-слой в архивные PDF, а Tesseract служит движком для автоматизации. Для разовых публичных файлов подходят Google Docs, OnlineOCR.net и OCR.Space. На смартфоне Adobe Scan удобен для захвата новых страниц, а OneDrive — для распознавания и копирования текста из уже сохраненных сканов.
Главный критерий выбора — не похожесть интерфейса на FineReader, а измеримый итог на ваших документах. Сопоставьте время до проверенного файла, CER на эталонных фрагментах, число сломанных таблиц и минут ручной корректуры. После такого теста становится понятно, где необходим универсальный PDF-редактор, где специализированный OCR, а где достаточно узкого открытого инструмента.
Какой вариант ближе всего к привычному настольному FineReader?
По логике «распознать скан и затем работать с PDF» ближе всего ContentReader PDF 16 и универсальные PDF-редакторы с OCR: PDF Commander, Adobe Acrobat, Foxit PDF Editor и PDFelement. Выбор между ними следует делать по тесту собственных документов, а не по совпадению списка функций.
Что выбрать для Linux без облака?
Для готового PDF-редактора подходят PDF Commander и ContentReader PDF в поддерживаемых Linux-средах. Для открытого стека удобна связка NAPS2, gImageReader, OCRmyPDF и Tesseract: каждый компонент закрывает свой этап и работает локально.
Какой метод лучше для searchable PDF без изменения внешнего вида?
Для существующего архива в особенности уместен OCRmyPDF: его задача — добавить текстовый слой к PDF и сохранить визуальную страницу. Для новых сканов тот же итог удобно получать через NAPS2 или PDF-редактор с режимом поискового слоя.
Можно ли оценивать OCR по одной странице?
Нет. Одна чистая страница не показывает поведение на таблицах, колонках, слабых сканах и смешанном языке. Минимальный практический тест должен включать несколько типов документов и учитывать не только текстовые ошибки, но и структуру.
Почему после OCR таблица распадается, хотя текст прочитан правильно?
Распознавание символов и анализ макета — различные задачи. Движок способен правильно прочитать буквы и цифры, но ошибиться в границах колонок, порядке чтения или структуре ячеек. Для таблиц необходим отдельный контроль строк, столбцов и заголовков.
Стоит ли применять браузерный OCR для договоров и внутренних отчетов?
Лишь в среде, которая разрешена правилами организации. Для документов с персональными, финансовыми или иными чувствительными данными проще применять согласованный локальный инструмент либо собственную инфраструктуру.
Что применять вместо Microsoft Lens после его закрытия?
Microsoft рекомендует OneDrive для мобильного сканирования. Для сценария «камера → многостраничный PDF → OCR» тоже подходит Adobe Scan. Старые инструкции с Microsoft Lens как действующим приложением в 2026 году уже неактуальны.