
Преобразование PDF в TXT необходимо не только для разовой правки текста. В работе маркетолога, редактора, PR-специалиста и аналитика обычный текст удобен для контент-аудита, подготовки цитат, сверки документов, загрузки материалов в внутренние базы знаний и обработки больших массивов отчётов. На Xeon Live уже есть отдельный разбор преобразования PDF в TXT; тут задача рассматривается шире: от выбора инструмента до проверки кодировки, структуры и качества итога после экспорта.
Главное различие между исходным PDF и итоговым TXT связано с назначением форматов. PDF фиксирует страницу как готовый документ: в нём важны расположение блоков, шрифты, изображения, колонтитулы и визуальная композиция. TXT хранит последовательность символов и переносов строк. По этой причине конвертация не переносит дизайн один к одному: она извлекает смысловой текстовый слой или создаёт его через оптическое распознавание символов (OCR), когда страницы являются изображениями. Перед началом работы полезно определить, что важнее: быстро получить читаемый текст, сохранить абзацы, распознать скан или максимально аккуратно разобрать сложную структуру.
Что происходит при конвертации PDF в TXT
Обычный PDF бывает двух принципиально различных типов. В первом текст уже присутствует как символы: его можно выделить курсором, отыскать через поиск и копировать. Во втором страницы получены со сканера или камеры и фактически являются изображениями. Такой файл визуально выглядит как документ, но внутри нет полноценного текстового слоя. Для первого типа достаточно экспортировать содержимое. Для второго сперва выполняется OCR, затем распознанный итог сохраняется в TXT. Детальный разбор этой операции есть в материале Xeon Live о том, как распознать текст в PDF.
Проверить тип исходника можно за минуту. Откройте PDF и попробуйте выделить одно слово в середине обычного абзаца. Потом выполните поиск по заметной фразе. Когда оба действия работают, документ содержит текстовый слой. Когда выделяется только вся страница как картинка, а поиск ничего не отыскивает, необходим OCR. Эта проверка экономит время: попытка прямого экспорта скана часто даёт пустой TXT, фрагменты служебных данных или текст только с тех страниц, где слой распознавания был создан ранее.
TXT тоже не предназначен для хранения графики, координат объектов и сложного оформления. Таблица после экспорта превращается в строки с пробелами, табуляцией или последовательностью ячеек; двухколоночная полоса порой читается в порядке, который отличается от визуального; переносы слов на границе строк переходят в обычный текст и требуют очистки. Это не ошибка формата, а следствие перехода от фиксированной страницы к линейной последовательности символов. Когда необходимо продолжить редактирование с сохранением структуры, практичнее применять DOCX или RTF; для извлечения числовых таблиц — XLSX. На Xeon Live есть отдельное руководство по преобразованию PDF в Word.
Как выбрать метод до начала работы
Выбор удобно строить не вокруг популярности программы, а вокруг свойств конкретного документа. Для внутреннего отчёта с коммерчески чувствительным содержимым приоритетом становится локальная обработка без отправки файла стороннему веб-сервису. Для одноразового публичного PDF без сканов важнее скорость. Для архива со страницами-изображениями решающим фактором становится качество OCR и возможность задать язык распознавания. Для большого отчёта с колонками и таблицами необходим инструмент, который позволяет просмотреть итог до финального сохранения и гибко управлять переносами строк.
- Текстовый PDF без сложной верстки. Подходит прямой экспорт в TXT через PDF Commander, Adobe Acrobat, PDFMate или браузерный конвертер.
- Скан или фотография страниц. Сперва необходим OCR; в этой задаче в особенности уместны PDF Commander, ABBYY FineReader PDF, Google Docs или Xodo с распознаванием.
- Документ с таблицами, колонками и большим количеством врезок. TXT всё равно упростит структуру, по этой причине после конвертации необходим обязательный контроль порядка чтения и разделителей.
- Конфиденциальный материал. Локальная программа сохраняет рабочий процесс на компьютере и не требует передачи исходника веб-конвертеру.
- Разовая работа с открытым документом. Онлайн-сервис сокращает количество действий: загрузка, выбор TXT, преобразование, сохранение итога.
- Необходимость последующей правки. Word или OCR-редактор удобны тем, что текст можно привести в порядок перед сохранением в обычный текстовый файл.
Для редакционных и маркетинговых задач полезно заблаговременно определить единицу итога. Порой необходим весь документ, порой только несколько страниц с описанием продукта, методологией исследования или пресс-релизом. Извлечение лишних разделов увеличивает объём ручной очистки и увеличивает риск пропустить повторяющиеся колонтитулы. В проектах с серией документов лучше сразу задать единое правило имён файлов, одну кодировку и одинаковый метод обработки. Тогда материалы легче сопоставлять, объединять и передавать между редактором, аналитиком и разработчиком.
Локальные методы на компьютере
Локальные инструменты подходят для регулярной работы, объёмных документов и материалов, которые нежелательно отправлять в стороннее облако. PDF Commander идёт первым, потому что в нём подтверждены прямой экспорт PDF в TXT, отдельная команда конвертации и встроенное распознавание текста. Остальные программы оцениваются по тем же практическим критериям: понятность последовательности, работа со сканами, контроль кодировки и качество итогового текста.
1. PDF Commander: прямой экспорт PDF в TXT
В PDF Commander преобразование запускается как отдельная операция, по этой причине не требуется сперва переводить документ в Word или копировать текст ручным способом. На стартовом экране есть команда «Конвертировать PDF», а в рабочем окне тот же сценарий доступен через «Файл» → «Инструменты» → «Конвертировать PDF…». Для обычного текстового PDF это самый короткий локальный путь из рассматриваемых в статье.

Как конвертировать в PDF Commander
- Откройте PDF Commander и запустите «Конвертировать PDF» со стартового экрана. В уже открытом документе применяйте «Файл» → «Инструменты» → «Конвертировать PDF…».
- Нажмите «Выбрать файл» и укажите исходный PDF.
- В списке выходных форматов выберите text, то есть TXT.
- Задайте имя файла и папку назначения, после этого нажмите «Сохранить».
- Откройте полученный TXT в текстовом редакторе и проверьте начало, середину и конец документа: кириллицу, переносы строк, заголовки, списки и порядок абзацев.
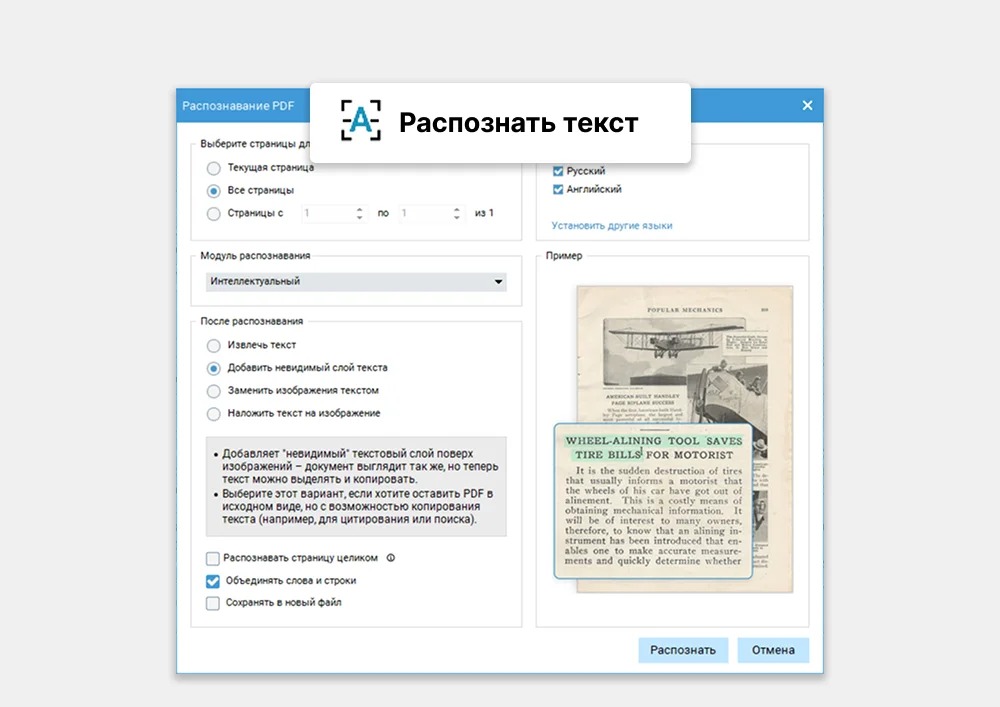
Со сканированным PDF порядок меняется: сперва выполните «Распознать текст». Инструмент даёт возможность выбрать текущую страницу, все страницы или диапазон, указать язык и затем получить распознанный текстовый слой. После OCR документ уже включает данные, которые можно экспортировать. Для длинного архива разумно проверить одну характерную страницу до обработки всего файла: страницу с обычным абзацем, страницу с таблицей и страницу с мелким шрифтом. Такая выборочная проверка сразу показывает, требуется ли улучшить исходный скан или скорректировать язык распознавания.
В деловом процессе PDF Commander в особенности удобен там, где конвертация — лишь один этап. К примеру, отдел коммуникаций получает сканированное исследование, распознаёт страницы, извлекает текст для внутреннего анализа, а исходный PDF остаётся рядом для визуальной сверки графиков и сносок. Важно не удалять исходник после получения TXT: обычный текст становится рабочей копией, а PDF остаётся контрольной версией с исходной нумерацией страниц и оформлением.
Плюсы
- Прямой локальный экспорт PDF в TXT без промежуточного DOCX.
- Отдельная команда распознавания текста для сканов и изображений страниц.
- Работа с документом остаётся в настольном приложении и не требует загрузки исходника в веб-конвертер.
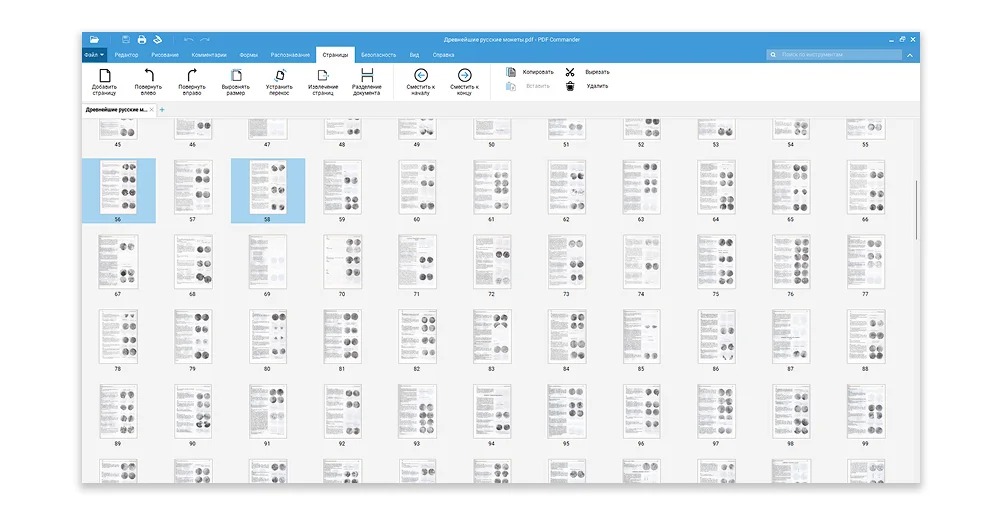
- Миниатюры страниц и другие инструменты PDF помогают проверить документ до экспорта.
Минусы
- Для единичной задачи требуется устанавливать настольное приложение.
- TXT не переносит изображения и исходную геометрию страницы; сложные таблицы после экспорта всё равно необходимо проверять ручным способом.
- Качество итога со сканов зависит от читаемости исходных страниц и корректного OCR.
Кому подойдёт
PDF Commander рационален для регулярного локального документооборота: редакционных материалов, договоров, инструкций, отчётов, сканов и архивов, где PDF необходимо не только читать, но и распознавать, преобразовывать и проверять в одном рабочем процессе.
2. Adobe Acrobat Pro: экспорт TXT с настройкой кодировки
Adobe Acrobat Pro предоставляет отдельный экспорт в обычный текст. В актуальном интерфейсе последовательность начинается с общей панели «Преобразовать»: далее выбираются «Другой формат» и TXT. Перед запуском экспорта доступна команда «Настройки», где меняются параметры кодировки. Это полезно для русскоязычных материалов и для документов, которые затем открываются в старых корпоративных системах или обрабатываются скриптами.
Как экспортировать TXT в Adobe Acrobat Pro
- Откройте PDF в Adobe Acrobat Pro.
- На общей панели выберите «Преобразовать».
- В левой панели откройте «Другой формат» и в списке выберите TXT.
- При надобности откройте «Настройки» и проверьте кодировку выходного текста.
- Нажмите «Преобразовать в TXT», укажите папку и имя файла, потом сохраните итог.
- После экспорта откройте TXT в том приложении, где он будет реально применяться, и проверьте кириллицу, длинные тире, кавычки, знаки валют и специальные символы.
Контроль кодировки важен не ради формальности. Один и тот же текстовый файл способен выглядеть правильно в современном редакторе и некорректно в старой системе импорта, если она ожидает другой набор символов. Для нового документооборота практичной базой служит Unicode; при обмене с унаследованными системами лучше заблаговременно согласовать формат и потом открыть тестовый файл на стороне получателя. Проблема обычно обнаруживается сразу: вместо кириллицы появляются нечитаемые последовательности, квадраты или вопросительные знаки.
Acrobat уместен и как контрольный инструмент. После преобразования можно держать рядом PDF и TXT, быстро переходить к спорной странице в оригинале и проверять абзацы, где в линейном тексте потерялся визуальный контекст. Для отчётов с диаграммами это в особенности важно: числовые подписи и примечания порой остаются в тексте, а сама диаграмма в TXT отсутствует. Значение таких фрагментов определяется только по исходной странице.
Плюсы
- Отдельный режим PDF → TXT в основном интерфейсе Acrobat.
- Параметры кодировки доступны до сохранения итога.
- Оригинал и экспорт удобно сверять внутри одного PDF-процесса.
- Подходит для документов, где вместе с конвертацией выполняются другие операции с PDF.
Минусы
- Для простой разовой выгрузки текста функциональность приложения заметно шире самой задачи.
- Обычный TXT не сохраняет изображения, стили и точное расположение элементов исходной страницы.
- Сложные макеты требуют ручной проверки порядка чтения после экспорта.
Кому подойдёт
Acrobat Pro удобен командам, где PDF уже является стандартным рабочим форматом и текстовый экспорт встроен в более широкий цикл согласования, правок, подготовки отчётов и архивирования.
3. ABBYY FineReader PDF: распознавание сканов и сохранение в TXT
ABBYY FineReader PDF логичнее выбирать для документов, где главная сложность не в самом формате PDF, а в качестве исходного изображения. После распознавания итог сохраняется через «Save As» → «TXT Document» или «File» → «Save As» → «TXT Document». В параметрах TXT доступны режимы форматированного и обычного текста, сохранение переносов строк, разделение страниц, колонтитулы и кодировка.
Как сохранить распознанный текст в ABBYY FineReader PDF
- Откройте PDF в OCR-редакторе ABBYY FineReader PDF.
- Проверьте язык распознавания и области на нескольких характерных страницах.
- Запустите распознавание и визуально просмотрите фрагменты, где есть мелкий шрифт, таблицы, колонки или плохой контраст.
- Откройте меню сохранения и выберите «TXT Document». Для части страниц можно заранее выделить нужные страницы на панели Pages.
- В параметрах TXT выберите Plain text для минимальной разметки либо Formatted text, когда нужно сохранить абзацы и часть визуального разделения пробелами.
- Проверьте переносы строк, колонтитулы и кодировку, потом сохраните файл и сделайте контрольную сверку с оригиналом.
Настройки TXT в FineReader полезны для автоматизированной обработки. Когда каждый абзац должен идти одной строкой, уберите сохранение исходных переносов строк. Когда важно видеть границы страниц, добавляется символ разрыва страницы. Колонтитулы можно сохранить для архивной привязки или убрать на этапе очистки, чтобы они не повторялись десятки раз. Такая управляемость в особенности важна при подготовке корпуса документов для внутреннего поиска, редакционного анализа или последующей загрузки в систему, чувствительную к структуре строк.
OCR не отменяет редакторскую проверку. Хорошо распознанный обычный текст всё равно способен содержать редкие замены похожих символов, потерянные дефисы и неверно собранные колонки. В финансовом или юридическом документе проверяйте фамилии, даты, номера документов, проценты и отрицательные значения по оригиналу. Для маркетингового исследования отдельно контролируйте наименования брендов, подписи диаграмм и методологические оговорки: именно они чаще всего определяют смысл цитируемой цифры.
Плюсы
- Сильный сценарий OCR для сканов и PDF без текстового слоя.
- Отдельные настройки TXT: обычный или форматированный текст, переносы строк, разрывы страниц, колонтитулы и кодировка.
- Можно сохранять только выбранные страницы, не экспортируя весь документ.
- Итог распознавания можно проверить до финального сохранения.
Минусы
- Для простого текстового PDF процесс длиннее, чем прямой экспорт в специализированном конвертере.
- Сложные таблицы и многоуровневая верстка в любом случае упрощаются при сохранении в TXT.
- Плохой скан требует добавочной проверки распознавания и порой подготовки изображения до OCR.
Кому подойдёт
FineReader PDF подходит для архивов, сканов, многостраничных документов и проектов, где качество распознавания важнее минимального количества действий. Это типичный выбор для оцифровки бумажных исследований, договоров, методичек и старых отчётов.
4. Microsoft Word: открыть PDF и сохранить как обычный текст
Microsoft Word применяет промежуточное преобразование: при открытии PDF программа создаёт копию и переводит содержимое в редактируемый документ. После этого файл сохраняется как Plain Text. Такой путь удобен, когда перед получением TXT необходимо быстро исправить лишние переносы, удалить повторяющиеся колонтитулы или собрать разорванные абзацы ручным способом.
Как сохранить PDF как обычный текст через Microsoft Word
- В Word выберите «Файл» → «Открыть» и укажите PDF.
- Подтвердите преобразование PDF в редактируемую копию Word.
- Просмотрите документ: объедините разорванные абзацы, удалите ненужные колонтитулы и проверьте порядок блоков.
- Выберите «Файл» → «Сохранить как». В поле типа файла укажите Plain Text.
- После нажатия «Сохранить» проверьте кодировку в окне преобразования файла. Для универсального обмена применяйте Unicode-кодировку, которую поддерживает принимающая система.
- Откройте полученный TXT отдельно и убедитесь, что все нужные символы сохранились.
Word лучше работает с PDF, где основную часть составляет обычный текст. Microsoft прямо предупреждает, что преобразованная копия не всегда совпадает с исходной страницей, а страницы, заполненные графикой, порой превращаются в изображение без редактируемого текста. По этой причине этот метод не стоит выбирать как основной OCR-механизм для сканов. Его сильная сторона — промежуточная ручная правка перед сохранением в TXT.
Для редакционной команды этот промежуточный этап бывает полезнее прямого экспорта. К примеру, в PDF-отчёте на каждой странице повторяются наименование компании, дата и наименование раздела. Прямой TXT сохранит десятки одинаковых строк. В Word их можно быстро удалить, восстановить абзацы и только затем получить чистый текст. Так уменьшается объём последующей ручной очистки в текстовом редакторе или внутренней системе анализа.
Отдельная настройка кодировки в Word помогает при передаче текста между различными системами. В окне сохранения Plain Text можно выбрать системную кодировку, MS-DOS или иной вариант и посмотреть предварительный итог. Если символы не представлены выбранной таблицей, Word предупреждает о потенциальной замене. Это полезный предохранитель перед импортом в старые базы, где ожидается конкретная кодировка.
Плюсы
- Можно отредактировать и очистить текст до сохранения в TXT.
- Есть явный выбор Plain Text и отдельное окно настройки кодировки.
- Подходит для текстовых деловых документов с относительно простой структурой.
- Исходный PDF не перезаписывается: Word создаёт отдельную редактируемую копию.
Минусы
- Промежуточное преобразование добавляет этап в сравнении с прямым экспортом.
- Сложная верстка может отличаться от исходного PDF.
- Страницы с преобладанием графики способны остаться изображениями без редактируемого текста.
Кому подойдёт
Word подходит пользователям, которым важнее всего получить текст, заранее ручным способом привести его в порядок и только потом сохранить в TXT. Это практичный сценарий для пресс-релизов, аналитических записок, договоров и текстовых отчётов.
5. PDFMate PDF Converter: отдельная утилита для PDF → TXT
PDFMate PDF Converter построен вокруг короткой последовательности: добавить PDF, выбрать TXT как выходной формат, указать папку и запустить преобразование. Это отдельный конвертер без промежуточного редактирования документа, по этой причине он удобен для предсказуемых текстовых PDF, где не требуется ручным способом перестраивать абзацы до экспорта.
Как конвертировать PDF в TXT через PDFMate
- Запустите PDFMate PDF Converter и добавьте исходный PDF через команду Add PDF.
- В области выходных форматов выберите TXT.
- Проверьте папку, куда будет сохранён итог.
- Запустите Convert и дождитесь окончания обработки.
- Откройте TXT и проверьте порядок абзацев, заголовков и переносов строк.
PDFMate стоит рассматривать как узкий инструмент конвертации, а не как редактор. Это определяет и рабочую схему: все исправления лучше делать до запуска или уже после получения TXT. Когда исходный документ чистый и текстовый, такой подход сокращает количество решений, которые необходимо принять в интерфейсе. Когда PDF содержит сканы, сложные таблицы или нестандартный порядок блоков, сперва потребуется распознавание или более внимательная подготовка.
При пакетной рабочей дисциплине полезно заблаговременно отделить исходники от итогов. Создайте две папки — PDF и TXT — и не сохраняйте файлы поверх исходных имён без расширения-идентификатора проекта. В редакции это помогает избежать ситуации, когда рядом лежат несколько версий одного отчёта и непонятно, из какой именно получен текст. Дата и короткий суффикс в имени позволяют быстро связать TXT с оригиналом без открытия обоих файлов.
Плюсы
- Короткая последовательность действий без промежуточного редактирования.
- TXT вынесен в отдельный выходной профиль.
- Локальная обработка обычных PDF не требует загрузки документа в браузер.
Минусы
- Меньше возможностей для ручной очистки текста до экспорта, чем в Word или OCR-редакторе.
- Для сложных сканов и проблемной структуры требуется добавочная проверка или отдельный этап OCR.
- TXT по определению не сохраняет исходную графическую компоновку страницы.
Кому подойдёт
PDFMate удобен для пользователей, которым необходим отдельный настольный конвертер и повторяемый простой маршрут от PDF к обычному тексту без расширенного редактирования.
Онлайн-способы в браузере
Браузерные сервисы удобны для открытых, неконфиденциальных документов и разовых задач. Их общий принцип одинаков: исходный файл отправляется на сервер сервиса, обрабатывается там, после чего пользователь получает TXT. Именно из-за передачи исходника в облако внутренние договоры, неанонсированные медиапланы, клиентские базы, персональные данные и другие чувствительные материалы разумнее обрабатывать локально. Для публичных отчётов, инструкций и открытых презентационных материалов онлайн-конвертер экономит время.
6. Google Docs: извлечение текста через Google Drive
Google Docs полезен тем, что работает не только с текстовыми PDF, но и с изображениями страниц: Google Drive умеет открывать PDF через Google Docs и создавать текстовую версию. Отдельная инструкция Xeon Live показывает, как открыть PDF в Google Документах. Сервис предупреждает, что часть оформления не переносится: списки, таблицы, колонки и сноски распознаются хуже обычных абзацев.
Как извлечь текст через Google Docs
- Загрузите PDF в Google Drive с компьютера.
- Щёлкните по файлу правой кнопкой и выберите «Открыть с помощью» → Google Docs.
- Дождитесь создания документа с извлечённым или распознанным текстом.
- Просмотрите порядок абзацев, списков и колонок; удалите явные повторы колонтитулов и лишние переносы.
- Откройте «Файл» → «Скачать» и выберите доступный текстовый формат. Когда необходим именно TXT, сохраните обычный текстовый вариант и после загрузки проверьте расширение и кодировку.
- Сверьте несколько фрагментов с исходным PDF, в особенности там, где были таблицы, две колонки или сноски.
Google Drive отдельно указывает, что OCR для PDF выполняется на компьютере через открытие файла в Google Docs. Этот путь полезен для небольших сканов, когда настольного OCR-редактора под рукой нет. Для стабильного итога оригинальная страница должна быть разборчивой и правильно ориентированной. При плохой фотографии документа ошибки появляются ещё до этапа сохранения TXT, по этой причине сперва стоит исправить поворот страницы и выбрать более чёткую копию.
Для совместной редакционной работы Google Docs даёт ещё одно преимущество: распознанный текст можно привести в порядок прямо в браузере, а затем отдать коллегам на проверку. Однако исходный PDF всё равно должен оставаться рядом. Форматирование в распознанной копии неполное, и без оригинала легко принять неверно собранную таблицу или подпись под иллюстрацией за обычный абзац.
Плюсы
- Открытие PDF через Google Docs даёт извлечение и распознавание текста.
- Полученный материал можно сразу исправить и совместно проверить в браузере.
- Подходит для простых сканов и публичных документов без установки отдельного OCR-приложения.
Минусы
- Таблицы, колонки, сноски и сложное оформление переносятся неполно.
- Исходный документ загружается в облако, по этой причине метод не подходит для материалов, которые по внутренним правилам должны оставаться локально.
- Перед финальным TXT приходится вдобавок проверить скачанный формат и структуру текста.
Кому подойдёт
Google Docs удобен для небольших публичных PDF, совместной редакторской работы и ситуаций, когда вместе с конвертацией необходим OCR и ручная правка в браузере.
7. Convertio: быстрый PDF → TXT в браузере
Convertio предоставляет отдельную страницу PDF → TXT. Последовательность предельно короткая: выбрать исходный файл, указать TXT как итог, запустить преобразование и сохранить готовый файл. Этот вариант хорошо подходит для единичных открытых документов, когда никакая правка перед экспортом не требуется.
Как применять Convertio
- Откройте режим PDF → TXT в Convertio.
- Добавьте PDF с компьютера или из доступного источника.
- Проверьте, что выбран выходной формат TXT.
- Запустите преобразование и сохраните полученный файл.
- Откройте TXT отдельно и проверьте кириллицу, абзацы, переносы строк и порядок текста.
Онлайн-конвертер не стоит оценивать только по тому, открылся ли итоговый файл. Для текстового PDF главным показателем является полнота: сохранены ли заголовки, не пропали ли абзацы, не перепутались ли колонки. Для сканов дополнительно оценивается распознавание. По этой причине после Convertio, как и после любого иного сервиса, необходим контроль минимум по трём участкам документа. Быстрая проверка занимает меньше времени, чем исправление ошибок после публикации или импорта текста в иную систему.
В агентской работе Convertio удобно применять для открытых медиакитов, публичных отчётов и материалов, которые уже размещены в интернете. Для документов клиента с ограничениями на передачу третьим сторонам выбирайте локальный инструмент. Такой критерий важнее удобства интерфейса: безопасность рабочего процесса определяется не количеством кликов, а тем, где физически обрабатывается исходный файл.
Плюсы
- Минимальная последовательность действий для разовой конвертации.
- Отдельный профиль PDF → TXT не требует настройки сложного редактора.
- Работает из браузера и подходит для публичных документов на различных настольных системах.
Минусы
- Файл отправляется на сервер сервиса, что ограничивает применение для конфиденциальных материалов.
- Нет промежуточной ручной очистки текста до получения TXT.
- Сложную структуру и качество OCR нужно проверять уже по итогу.
Кому подойдёт
Convertio подходит для быстрых разовых преобразований открытых PDF, когда важна скорость и не требуется локальный документооборот.
8. CloudConvert: облачная конвертация PDF в TXT
CloudConvert тоже имеет отдельный конвертер PDF → TXT. Рабочая логика стандартна для браузерных сервисов: загрузка исходника, выбор выходного формата, обработка и сохранение итога. Его удобно держать как резервный вариант, когда основной онлайн-инструмент недоступен или необходимо сопоставить итог двух движков на сложном документе.
Как применять CloudConvert
- Откройте конвертер PDF → TXT CloudConvert.
- Добавьте исходный PDF.
- Убедитесь, что выходным форматом выбран TXT.
- Запустите конвертацию и сохраните итог.
- Сверьте текст с оригиналом на страницах различного типа: обычный абзац, страница с колонками и страница с таблицей или подписями.
Сравнение двух онлайн-движков полезно не ради поиска формального победителя. Один и тот же PDF может содержать нестандартно собранный текстовый слой: слова нарезаны на отдельные фрагменты, колонки описаны в необычном порядке, часть страницы встроена как изображение. В такой ситуации Convertio и CloudConvert способны дать отличающуюся последовательность строк. Практичный подход — выбрать тот итог, который требует меньше ручной очистки, а не тот сервис, у которого ярче интерфейс.
Для массовой обработки публичных материалов важно не превращать браузерную конвертацию в бесконтрольную ручную операцию. Ведите список обработанных файлов, фиксируйте исходное имя и дату, а после загрузки TXT сразу перемещайте его в рабочую папку проекта. Это уменьшает риск ещё раз обработать тот же отчёт или перепутать версии. Для регулярной автоматизации лучше перейти к локальному или программируемому процессу, где имена и контроль качества задаются заблаговременно.
Плюсы
- Отдельный онлайн-режим PDF → TXT.
- Не требует установки настольной программы.
- Подходит как второй движок для сравнения итога на проблемном открытом PDF.
Минусы
- Исходный документ обрабатывается в облаке.
- Редактирование до экспорта не является частью основного сценария.
- После конвертации всё равно необходим контроль структуры, в особенности для колонок и таблиц.
Кому подойдёт
CloudConvert удобен для открытых документов, разовых задач и контрольного сравнения, когда необходимо быстро проверить, даст ли другой веб-конвертер более чистую последовательность текста.
9. Xodo: PDF → Text и OCR для сканов
Xodo предлагает онлайн-инструмент PDF to Text, а в сценарии конвертации поддерживается распознавание сканированных страниц. Это делает сервис полезным для смешанных документов, где часть страниц содержит нормальный текстовый слой, а часть пришла со сканера. Рабочая последовательность остаётся браузерной: выбрать PDF, запустить преобразование и сохранить TXT.
Как применять Xodo PDF to Text
- Откройте инструмент Xodo PDF to Text.
- Выберите исходный PDF.
- Для документа со сканированными страницами применяйте распознавание текста в процессе преобразования.
- Запустите конвертацию и сохраните TXT.
- Проверьте страницы со сканами отдельно: наименования, числа, знаки препинания и переносы строк должны совпадать с оригиналом.
Смешанный PDF — один из самых неприятных типов исходника. В нём первые страницы могут быть созданы из Word и выделяться как текст, а приложения — отсканированы и существовать только как изображения. Обычный экспорт в таких случаях создаёт иллюзию успеха: TXT содержит начало документа, но приложения пропадают. По этой причине перед выбором инструмента прокрутите файл до конца и проверьте несколько различных разделов. Когда встречаются страницы-изображения, применяйте OCR для всего нужного диапазона.
Для маркетинговых и исследовательских отчётов Xodo полезен как быстрый браузерный вариант, но итоговый TXT всё равно нельзя считать самостоятельным источником визуальных данных. Графики, диаграммы и композиция таблиц в обычный текст не переходят. При цитировании цифры всегда возвращайтесь к PDF и проверяйте подпись графика, единицы измерения, период и примечание. Текстовая выгрузка ускоряет поиск, но не заменяет визуальную верификацию.
Плюсы
- Отдельный браузерный режим PDF to Text.
- OCR помогает обрабатывать страницы, которые являются сканами.
- Подходит для смешанных PDF, где текстовые и растровые страницы находятся в одном файле.
Минусы
- Онлайн-обработка не подходит для документов, которые нельзя передавать стороннему сервису.
- Изображения и визуальная структура отчёта не переходят в TXT.
- Распознанные числа, имена и специальные символы требуют сверки с оригиналом.
Кому подойдёт
Xodo удобен для открытых смешанных PDF и сканов, когда необходим браузерный метод с распознаванием и быстрым получением обычного текста.
Какой метод выбрать для конкретного рабочего сценария
После девяти вариантов выбор сводится к четырём вопросам: где должен обрабатываться документ, есть ли в нём настоящий текстовый слой, требуется ли правка до экспорта и насколько сложна структура страницы. Для внутреннего договора с ограниченным доступом локальный PDF Commander, Acrobat, FineReader, Word или PDFMate безопаснее облачного маршрута с точки зрения передачи исходника третьей стороне. Для публичной методички на двадцать страниц браузерный Convertio или CloudConvert быстрее. Для скана отчёта приоритет получают OCR-инструменты. Для текста, который необходимо сперва привести в порядок, удобнее Word или Google Docs.
Сценарий 1. Публичный аналитический отчёт
В публичном исследовании чаще всего необходим не красивый повтор PDF, а быстрый доступ к тексту: формулировкам выводов, описанию выборки, комментариям экспертов и сноскам. Начните с проверки текстового слоя. Когда он корректный, прямой экспорт в PDF Commander, Acrobat или онлайн-конвертер даст рабочую основу. После получения TXT отыщите несколько контрольных слов из начала, середины и конца отчёта, а потом проверьте, не смешались ли две колонки. Графики и таблицы оставляйте для сверки в PDF: обычный текст не хранит их визуальную геометрию.
Для маркетолога полезно сразу удалить повторяющиеся верхние и нижние колонтитулы, номера страниц и технические подписи, которые мешают поиску по тексту. Вместе с этим методологию исследования, единицы измерения и сноски удалять нельзя: именно они ограничивают интерпретацию цифр. Хороший TXT для анализа — не самый короткий, а тот, где сохранён смысловой контекст и вычищен только визуальный шум.
Сценарий 2. Пресс-релиз или медиакит в PDF
Пресс-релизы и медиакиты часто содержат готовые цитаты, описания продукта и справочные блоки, но вместе с ними — логотипы, декоративные врезки и контактные элементы. После конвертации в TXT отделите основной текст от служебных блоков и сверяйте прямые цитаты по PDF. Для одного документа достаточно онлайн-сервиса; для серии материалов удобнее локальный процесс с одинаковыми правилами имён. Не переносите в рабочую базу телефонные номера или другие персональные данные автоматически: сперва определите, в самом деле ли они необходимы для задачи.
Сценарий 3. Скан старого исследования
Скан требует двухэтапной схемы: OCR, затем экспорт. PDF Commander и ABBYY FineReader PDF дают контроль над распознаванием до сохранения TXT; Xodo и Google Docs закрывают ту же базовую задачу в браузере. До запуска OCR проверьте поворот страниц, контраст и наличие обрезанных полей. После распознавания сопоставьте фамилии, наименования брендов, проценты и даты по оригиналу. Ошибка в одном символе способна полностью изменить числовой вывод, по этой причине для важных данных ручная сверка обязательна.
Сценарий 4. Внутренний документ с ограниченным доступом
Для материалов, которые нельзя передавать внешним сервисам по внутренним правилам, выбирайте настольную программу. Сам факт того, что веб-конвертер удобен и быстро удаляет файлы по собственной политике, не заменяет корпоративные требования к обработке данных. Локальный сценарий легче контролировать: исходник, промежуточная копия и итоговый TXT находятся в рабочем окружении организации. Вдобавок храните неизменённый PDF и фиксируйте, кто подготовил текстовую версию.
Сценарий 5. Подготовка текста для поиска по архиву
Для архивного поиска важнее единообразие, чем сохранение визуального вида. Определите общую кодировку, одинаковый метод разделения страниц и правило имён. В FineReader можно управлять переносами и разрывами страниц; в Word — проверить кодировку при сохранении Plain Text. После обработки создайте небольшой контрольный набор: несколько документов различного типа, по которым заблаговременно известны фразы. Поиск этих фраз в TXT показывает, насколько надёжно построен процесс до того, как в него попадут сотни файлов.
Как проверить качество готового TXT
Успешное окончание конвертера не означает, что текст готов к работе. Итоговая проверка должна быть частью процесса, а не добавочной опцией. Для делового документа достаточно короткого, но системного контроля. Он ловит три класса проблем: потерю содержимого, нарушение порядка чтения и ошибочную кодировку. Для сканов добавляется четвёртый класс — ошибки OCR.
1. Проверка полноты
Сопоставьте количество смысловых разделов в PDF и TXT. Не обязательно считать каждый символ: откройте начало документа, один фрагмент из середины и последние страницы. Отыщите уникальные фразы из каждого участка. Когда все три зоны присутствуют, риск пропуска целого диапазона заметно ниже. Затем отдельно проверьте приложения: именно там зачастую встречаются сканы, которые прямой экспорт пропускает.
2. Проверка порядка чтения
В одноколоночном документе абзацы обычно следуют естественно. В двух колонках, буклетах и сложной журнальной верстке порядок может нарушиться: сперва выгружаются все фрагменты верхней части страницы, потом нижней, либо правая колонка вклинивается в левую. Быстрый тест — прочитать подряд двадцать-тридцать строк в месте смены колонки. Когда мысль внезапно обрывается и продолжается чужим абзацем, такой участок требуется перестроить ручным способом или обработать иным инструментом.
3. Проверка кодировки
Откройте TXT в двух средах: в обычном текстовом редакторе и в приложении, куда файл будет импортирован. Просмотрите кириллицу, кавычки, длинное тире, знак процента, математические символы и буквы с диакритикой, если они встречаются. На Xeon Live разобрана отдельная проблема, почему при переносе текста появляются нечитаемые символы. Практический смысл один: кодировку проверяют в конечной среде, а не только там, где файл был создан.
4. Проверка переносов и абзацев
PDF часто хранит строки как отдельные визуальные элементы. После экспорта это проявляется лишними разрывами: каждый исходный ряд превращается в новую строку, хотя по смыслу это один абзац. Для чтения человеком проблема умеренная, а для дальнейшего анализа или импорта — существенная. Приводите переносы к одному правилу: один абзац — одна логическая группа, пустая строка — осознанный разделитель. Не объединяйте строки автоматически без проверки дефисов и списков.
5. Проверка таблиц, списков и сносок
Таблица в TXT перестаёт быть сеткой. Перед применением определите, какой символ разделяет колонки: табуляция, несколько пробелов, точка с запятой или другой разделитель. Для важных числовых данных разумнее переносить таблицу в XLSX, а TXT применять лишь для окружающего текста. Списки проверяйте на потерю маркеров и нумерации. Сноски — на связь с тем местом, к которому они относятся: после линейного экспорта примечание может оказаться далеко от исходной ссылки.
6. Проверка OCR
Для распознанного скана выберите фрагменты трёх типов: обычный абзац, строку с числами и строку со смешанными символами. Сверьте их посимвольно с PDF. В русском тексте особого внимания требуют похожие по форме буквы и цифры, дефисы, кавычки, сокращения и инициалы. В англоязычных приложениях проверяйте сочетания O/0, I/l/1 и знаки препинания. Такой контроль точнее, чем субъективное впечатление от одной удачно распознанной страницы.
- В TXT присутствуют начало, середина, конец и приложения исходного документа.
- Абзацы идут в правильном порядке, в особенности на страницах с двумя колонками.
- Кириллица и специальные символы правильно отображаются в целевой программе.
- Лишние переносы строк очищены, но списки и абзацы не слиты друг с другом.
- Табличные данные сверены по исходному PDF или перенесены в более подходящий формат.
- Распознанные числа, даты, имена и наименования проверены по изображению страницы.
- Исходный PDF сохранён как контрольная версия и не заменён TXT.
Что делать, когда TXT получается пустым или неполным
Пустой или практически пустой итог обычно означает, что в PDF нет полноценного текстового слоя. Откройте исходник и попробуйте выделить слово. Когда выделяется только вся страница, переходите к OCR. Подходящие варианты в этой статье — PDF Commander, ABBYY FineReader PDF, Google Docs и Xodo. После распознавания вновь выполните экспорт. Для смешанного документа проверьте не только первую страницу: текстовый слой способен присутствовать в основной части и отсутствовать в приложениях.
Второй источник неполноты — ограничения чтения структуры. Некоторые PDF собираются из множества мелких текстовых объектов, расположенных в точных координатах. Конвертер видит символы, но интерпретирует их порядок не так, как человек. В этом случае сопоставьте два движка: к примеру, локальный экспорт и один браузерный сервис. Выбирайте итог с более естественной последовательностью абзацев, после чего исправьте оставшиеся проблемные места ручным способом.
Третий случай — защищённый документ. Ограничения на копирование и извлечение могут мешать стандартному экспорту. Не пытайтесь обходить защиту без полномочий. Работайте с версией, на которую у вас есть разрешение, либо получите исходный файл у владельца. Xeon Live отдельно разбирает ситуацию, когда текст из PDF не копируется.
Как исправить нечитаемые символы и проблемы с кодировкой
Когда вместо текста появляются наборы символов, не начинайте с повторной ручной правки всего файла. Сперва определите, где возникло несоответствие: при экспорте или при открытии. Откройте тот же TXT в другом современном редакторе. Если там всё читается, проблема находится в ожиданиях целевой программы. Если текст повреждён везде, вернитесь к экспорту и выберите другую кодировку. Adobe Acrobat позволяет менять параметры кодировки перед преобразованием, Word — в диалоге сохранения Plain Text, ABBYY FineReader — в настройках TXT.
Для нового обмена между современными системами разумно унифицировать текст вокруг Unicode и зафиксировать это в рабочем регламенте. Отдельный случай — старые приложения, которые принимают только конкретную кодовую страницу. В таком проекте сделайте эталонный файл с русскими и латинскими буквами, кавычками, тире, процентами и специальными символами, потом проверьте его импорт. Это быстрее, чем выяснять причину повреждения после обработки большого архива.
Отдельно проверьте шрифтовые особенности исходного PDF. Некоторые документы визуально показывают нормальные буквы, но внутри применяют нестандартное сопоставление символов. Копирование даёт бессмысленный набор, хотя на экране всё выглядит правильно. Тут помогает OCR: программа распознаёт видимые формы на странице заново и строит новый текстовый слой, не полагаясь на повреждённое внутреннее сопоставление.
Почему таблицы и колонки ломаются при экспорте
PDF хранит страницу как набор объектов с координатами. TXT хранит линейный поток символов. Между этими моделями нет однозначного соответствия для таблиц, колонок, боковых врезок и подписей к изображениям. Конвертер вынужден определить порядок чтения сам. Хорошо размеченный PDF даёт предсказуемый итог, но файл, собранный из отдельных блоков, способен смешать левую и правую колонки или вывести подписи ранее основного абзаца.
Для таблиц заблаговременно определите конечную задачу. Когда необходимы значения для анализа, цель — не TXT, а структурированный табличный формат. Когда необходима поисковая копия отчёта, таблицу можно оставить в линейном виде, но пометить её границы и сохранить исходный PDF рядом. Когда необходимы цитаты, достаточно вынести окружающий текст и ручным способом сверять цифры по странице. Такой выбор уменьшает бессмысленную попытку восстановить в TXT то, чего формат не хранит.
С колонками помогает контроль порядка чтения на одной типовой странице. Отыщите место, где абзац продолжается со строки на строку, и посмотрите, не вставлен ли между ними текст соседней колонки. Когда ошибка системная, применяйте инструмент с предварительным распознаванием структуры — к примеру, FineReader — либо сперва переведите PDF в Word и перестройте абзацы там. Когда ошибка встречается на двух-трёх страницах из большого документа, быстрее исправить их ручным способом.
Как работать с большими сериями PDF
При десятках и сотнях документов основная проблема уже не в кнопке «Конвертировать», а в повторяемости процесса. Один специалист способен ручным способом исправить неудачный TXT, но серия из сотни файлов требует правила. Сперва сформируйте набор из пяти-десяти различных PDF: текстовый отчёт, скан, документ с таблицей, файл с двумя колонками и смешанный вариант. На нём выберите основной инструмент и зафиксируйте настройки. Лишь после этого запускайте массовую обработку.
Правило имён должно однозначно связывать итог с исходником. Подходит схема, где базовое имя PDF сохраняется, а к TXT добавляется короткий суффикс проекта или стадии. Не применяйте абстрактные наименования вроде final, final2 и new: через месяц они ничего не объяснят. Для редакционных архивов полезно хранить рядом журнал обработки с датой, выбранным инструментом и отметкой о ручной проверке. Такой журнал помогает быстро отыскать причину расхождения между двумя версиями текста.
Контроль качества тоже можно стандартизировать. Для каждого файла проверяются три контрольные фразы, наличие последней страницы и корректность кодировки. Для OCR добавляется одна строка с числами. Документы, которые не проходят тест, откладываются в отдельную папку на ручную обработку. Так команда не останавливает весь поток из-за нескольких сложных PDF и вместе с этим не пропускает ошибки в готовый архив.
Автоматическая обработка должна учитывать назначение итога. Поисковому индексу важна полнота текста и стабильная кодировка. Редактору — читаемые абзацы и отсутствие повторов. Аналитику — точные числа и сохранённый контекст. Одного универсального TXT для всех задач не существует: исходный PDF один, но правила очистки различаются. По этой причине до массовой конвертации определите, кто будет применять текст и какие ошибки для него критичны.
Безопасность и конфиденциальность
Онлайн-конвертер всегда добавляет внешнюю сторону в цепочку обработки: исходный PDF покидает рабочий компьютер и отправляется сервису. Для публичного отчёта это обычно не создаёт практической проблемы. Для договора, внутренней стратегии, неопубликованной кампании, персональных данных или документов клиента решение должно соответствовать внутренним правилам организации. Когда политика запрещает внешнюю обработку, применяйте локальное приложение вне зависимости от удобства веб-сервиса.
Даже для локального процесса стоит разделять исходники и производные файлы. PDF хранится как неизменяемая контрольная копия, TXT — как рабочий материал. Не отправляйте текстовую выгрузку дальше автоматически только потому, что она выглядит «проще» исходника: в ней остаётся содержание документа. Права доступа к TXT должны соответствовать смыслу данных, а не расширению файла.
При работе с внешними исследованиями и пресс-материалами полезно убрать из TXT технические контактные строки, которые не нужны аналитической задаче. Это уменьшает шум и уменьшает вероятность случайного распространения лишней информации. Вместе с этим не удаляйте сведения, влияющие на интерпретацию исследования: авторство, дату публикации, период исследования и методологию. Задача очистки — убрать служебный мусор, а не лишить текст контекста.
Как применять TXT в маркетинге, PR и контенте
После качественной конвертации TXT становится удобной рабочей прослойкой между PDF и системами, где важен именно текст. Редактор может быстро сопоставить формулировки в нескольких пресс-релизах, аналитик — искать повторяющиеся темы в серии отчётов, PR-команда — собирать цитаты из медиакитов, контент-менеджер — переносить справочные блоки в внутреннюю базу знаний. Главное достоинство не в «лёгкости» расширения, а в том, что обычный текст лишён визуальной оболочки и хорошо поддаётся поиску, сравнению и программной обработке.
Контент-аудит
Для контент-аудита экспортируйте PDF в TXT, удалите повторяющиеся колонтитулы и разрывы страниц, потом сопоставьте лексику, длину разделов и повторяемость тезисов между документами. Важно сохранять разметку абзацев: слитый поток текста хуже показывает структуру материала. Исходный PDF необходим для обратной проверки мест, где смысл зависит от таблицы, диаграммы или визуальной врезки.
Работа с цитатами
TXT ускоряет поиск фразы, но финальную цитату проверяют по PDF. Визуальный оригинал показывает кавычки, сноску, подпись автора и контекст соседнего абзаца. В особенности внимательно сверяйте OCR-текст: одна неправильно распознанная буква в фамилии или одно пропущенное отрицание делает цитирование ненадёжным. Текстовая копия служит навигацией, а PDF — контрольным источником.
Подготовка базы знаний
Для внутренней базы знаний обычный текст удобен как промежуточный формат. Перед загрузкой удалите служебные элементы, восстановите абзацы и добавьте понятный заголовок документа в метаданные самой базы. Не пытайтесь кодировать визуальную таблицу пробелами, когда её содержание важно: вынесите таблицу в отдельную структурированную форму или сохраните ссылку на PDF-страницу. Это делает базу надёжнее и облегчает последующую проверку.
Сравнение версий документов
Две версии PDF часто отличаются не только текстом, но и версткой. Экспорт обеих версий в TXT помогает отделить смысловые правки от изменения дизайна. Перед сравнением применяйте одинаковый конвертер и одинаковые параметры, иначе различия в переносах строк будут выглядеть как правки документа. После нормализации абзацев автоматическое сравнение показывает добавленные и удалённые фразы гораздо чище.
Подготовка материалов для сайта
При переносе текста из PDF на сайт не публикуйте TXT без редакторской обработки. Он не содержит семантической структуры заголовков, списков и таблиц в том виде, который необходим веб-странице. Применяйте текст как сырьё: восстановите иерархию, проверьте ссылки по исходнику, перенесите таблицы отдельно, добавьте альтернативные описания изображениям и сверяйте цифры. Такой процесс быстрее ручного перепечатывания и вместе с этим сохраняет редакционный контроль.
Типичные ошибки при конвертации
- Сразу выбирать онлайн-сервис для внутреннего документа. Сперва проверьте правила обработки данных и только потом определяйте инструмент.
- Пытаться экспортировать скан без OCR. Страница-изображение не содержит текста для прямого извлечения.
- Считать открывшийся TXT готовым. Необходима сверка полноты, порядка чтения и кодировки.
- Удалять исходный PDF после получения текста. Без оригинала нельзя надёжно проверить графики, сноски, таблицы и спорные OCR-фрагменты.
- Применять TXT для сохранения сложной верстки. Обычный текст предназначен для символов и переносов, а не для восстановления макета.
- Игнорировать кодировку до импорта. Проверка лишь в одном редакторе не гарантирует корректное чтение целевой системой.
- Обрабатывать сотни файлов без пилотного набора. Сперва процесс проверяется на различных типах PDF, затем масштабируется.
- Слепо доверять OCR в числовых данных. Проценты, даты и имена сверяются с изображением страницы.
Короткая матрица выбора
- PDF Commander. Первый выбор этой инструкции для локальной конвертации, в особенности когда вместе с экспортом необходим OCR и другие операции с PDF.
- Adobe Acrobat Pro. Уместен в существующем Acrobat-процессе и там, где важна явная настройка кодировки перед TXT.
- ABBYY FineReader PDF. Приоритетен для сканов, архивов и документов, где распознавание важнее минимального числа действий.
- Microsoft Word. Удобен, когда текст необходимо ручным способом привести в порядок до сохранения Plain Text.
- PDFMate PDF Converter. Подходит для прямой локальной конвертации текстовых PDF в отдельной утилите.
- Google Docs. Полезен для небольших публичных PDF и браузерного OCR с совместной правкой.
- Convertio. Быстрый вариант для одного открытого PDF без требований к локальной обработке.
- CloudConvert. Резервный браузерный движок и метод сопоставить итог на проблемном открытом документе.
- Xodo. Браузерный вариант для PDF to Text, в том числе для смешанных документов со сканированными страницами.
Частые вопросы
Почему после конвертации TXT пустой?
Исходный PDF, скорее всего, состоит из сканов без текстового слоя. Сперва выполните OCR в PDF Commander, ABBYY FineReader PDF, Google Docs или Xodo, потом повторите экспорт.
Можно ли сохранить в TXT изображения и оформление?
Нет. TXT хранит обычный текст и переносы строк. Изображения, шрифтовое оформление и точная геометрия страницы остаются лишь в исходном PDF или в более богатом выходном формате.
Почему русские буквы превращаются в нечитаемые символы?
Причина обычно в несовпадении кодировки файла и ожиданий программы, которая его открывает. Повторите экспорт с подходящей Unicode-кодировкой или выберите правильную кодовую страницу в целевой системе.
Что делать с таблицами?
Для поиска по документу таблицу допустимо оставить в линейном виде. Для анализа чисел лучше перенести данные в табличный формат и сверить значения по PDF, потому что TXT не хранит сетку ячеек.
Какой вариант лучше для конфиденциального документа?
Применяйте локальное приложение, которое обрабатывает файл на рабочем компьютере, и соблюдайте внутренние правила доступа к документам. Браузерный конвертер добавляет внешнюю сторону в обработку исходника.
Необходимо ли хранить исходный PDF после получения TXT?
Да. PDF остаётся контрольной версией для проверки страниц, таблиц, диаграмм, сносок и спорных итогов OCR. TXT следует воспринимать как производную рабочую копию.
Итог
Для обычного текстового PDF задача решается прямым экспортом: в этой инструкции первым стоит PDF Commander, далее подходят Adobe Acrobat Pro, PDFMate и браузерные Convertio или CloudConvert. Для сканов важнее OCR, по этой причине приоритет получают PDF Commander, ABBYY FineReader PDF, Google Docs и Xodo. Word полезен как промежуточный редактор, когда текст необходимо очистить до сохранения в Plain Text. Вне зависимости от инструмента финальный этап один: проверить полноту, порядок чтения, кодировку, переносы и спорные числовые фрагменты по исходному PDF.
Главный практический критерий — не скорость нажатия кнопки, а качество рабочего итога. Хороший TXT содержит весь нужный текст, читается в целевой системе, не смешивает колонки, не ломает кириллицу и сохраняет достаточно контекста для дальнейшей работы. Исходный PDF вместе с этим остаётся рядом как визуальная и фактическая контрольная копия. Такой процесс подходит и для единичного пресс-релиза, и для оцифровки большого архива: меняется масштаб, но не логика проверки.