
Когда текст из PDF (Portable Document Format) не выделяется, не копируется или после вставки превращается в набор странных символов, проблема практически всегда находится в одном из четырёх мест: на странице нет нормального текстового слоя, автор ограничил копирование, шрифты и кодировка собраны нестандартно либо сам файл повреждён. По этой причине попытка снова нажать Ctrl+C редко меняет ситуацию. Гораздо быстрее определить тип PDF и применить подходящий маршрут. В разборе причин проблем с копированием PDF на Xeon Live показаны базовые сценарии; тут мы превращаем их в детальный рабочий алгоритм для документов, макетов, презентаций, отчётов и материалов, которые приходится переносить в редактор, систему управления взаимоотношениями с клиентами, презентацию или корпоративную базу знаний.
Почему PDF не даёт скопировать текст
PDF хранит не только буквы. Формат фиксирует внешний вид страницы: координаты элементов, шрифты, изображения, векторную графику и служебные данные. В одном документе абзац в самом деле существует как текст, в другом та же страница является фотографией скана, а в третьем символы отображаются правильно, но их внутреннее сопоставление с обычными буквами нарушено. Снаружи три страницы выглядят одинаково, однако методы извлечения различаются. Если сперва установить тип проблемы, не придётся последовательно пробовать десяток программ и портить исходник многократными конвертациями.
- На странице нет текстового слоя. Курсор не превращается в средство выделения, поиск по знакомому слову ничего не отыскивает, а вся страница ведёт себя как одна картинка. Необходима технология оптического распознавания символов (OCR, Optical Character Recognition).
- Копирование ограничено настройками документа. В Adobe Reader сводка ограничений документа показывает, разрешено ли копирование. Для рабочего файла с известным паролем сперва правильно меняют разрешения, а не пытаются обходить защиту сторонними трюками.
- Текст выделяется, но вставляется искажённо. Частый признак — нормальный вид в PDF и абракадабра в Word, почте или мессенджере. В этом случае помогает OCR или конвертация с пересборкой текстового слоя.
- Структура страницы слишком сложная. Много колонок, врезок, подписей, таблиц и декоративных элементов заставляют конвертер угадывать порядок чтения. Текст извлекается, но порядок абзацев приходится проверять ручным способом.
- Файл повреждён. Ошибки проявляются не только при копировании: страницы открываются неполностью, пропадают объекты, просмотрщик выдаёт предупреждения. Сперва сохраняют резервную копию и проверяют документ в другом просмотрщике.
Для бизнес-задач различие принципиально. Из брендбука чаще необходим один абзац с правилами применения логотипа, из отчёта — несколько страниц таблиц, из презентационного PDF — подписи к слайдам, из скана договора — весь текст без потери фамилий, сумм и дат. Один универсальный сценарий тут хуже нескольких коротких: маленький фрагмент быстрее распознать со снимка экрана, а многостраничный скан рациональнее пропустить через OCR целиком и потом выполнить контроль качества.
Диагностика за две минуты: какой у вас PDF
Перед обработкой сделайте шесть коротких проверок. Они не меняют файл, зато сразу отсеивают неподходящие методы. Работайте с копией документа, если это единственный экземпляр или в нём есть подписи, аннотации и другие важные служебные элементы.
- Попробуйте выделить одно слово. Выделение должно идти по буквам, а не прямоугольником по картинке. Если выделения нет, основной кандидат — скан или PDF из изображений.
- Запустите поиск по слову, которое точно видно на странице. Найденное совпадение подтверждает наличие хотя бы отчасти пригодного текстового слоя. Нулевой итог при визуально очевидном слове усиливает подозрение на скан.
- Скопируйте короткую строку в простой текстовый редактор. Так отделяется проблема самого PDF от форматирования Word. Если и в простом редакторе появляются неправильные символы, переходите к OCR.
- Проверьте ограничения документа. В Adobe Reader откройте свойства PDF и раздел безопасности. При запрете копирования работайте с разрешениями лишь при наличии права на изменение файла и пароля, если он требуется.
- Откройте файл вторым просмотрщиком. Это быстро показывает, связана ли проблема с конкретной программой. Если один и тот же фрагмент не выделяется в двух независимых приложениях, причина находится в структуре PDF, а не в буфере обмена.
- Определите объём работы. Один абзац, двадцать страниц текста и таблица на 300 строк требуют различных инструментов. Объём влияет на время проверки сильнее, чем сам процесс копирования.
Есть полезный практический признак: если увеличенная страница остаётся типичной фотографией — заметны шум бумаги, перекос, неодинаковая резкость букв, тени от сгиба — перед вами скан. Цифровой PDF тоже может содержать страницы-картинки, к примеру после экспорта макета из графического редактора. В обоих случаях итог один: обычное копирование не работает, потому что программе нечего помещать в буфер обмена как текст.
Отдельно проверьте документ, который пришёл из корпоративной системы, электронной подписи или защищённого документооборота. Сохранение промежуточной копии, печать в новый PDF и удаление ограничений способны изменить служебные свойства. Когда важна юридическая или архивная целостность, исходный файл оставляют неизменным, а распознанный текст создают как отдельный рабочий материал. Такой подход одновременно упрощает проверку и сохраняет оригинал для сверки.
Windows: рабочие методы
1. PDF Commander: распознать скан и вернуть нормальное копирование
Первым методом применяем PDF Commander, потому что в одной настольной цепочке он закрывает две различные причины: отсутствие текстового слоя и ограничения в собственном документе, для которого у пользователя есть нужные полномочия. На Xeon Live есть отдельная карточка PDF Commander с описанием интерфейса. Для нашей задачи важно не редактирование само по себе, а последовательность: открыть файл, понять, выделяется ли текст, при необходимости распознать страницу и только потом копировать данные в рабочее приложение.
Скан или страница-картинка
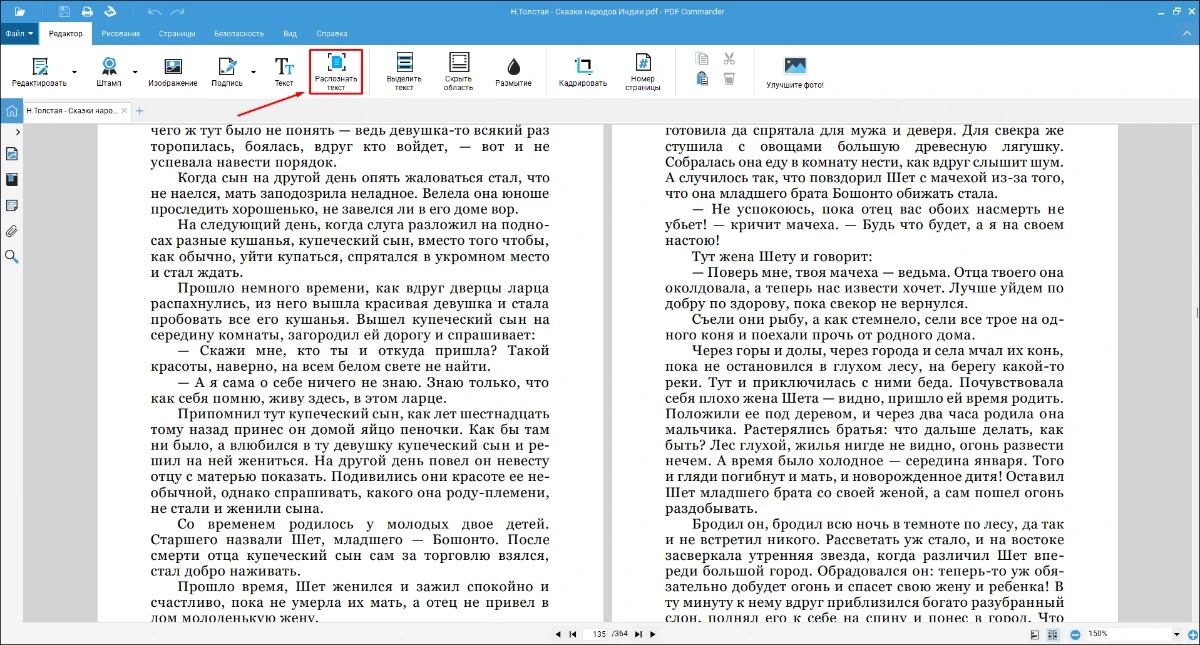
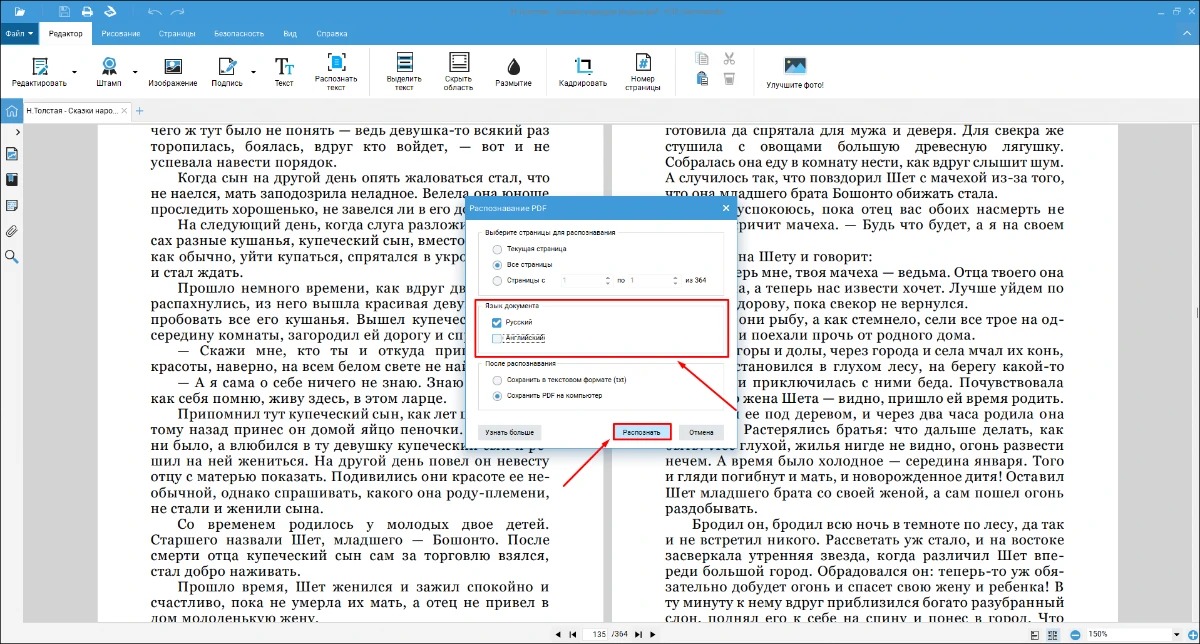
Откройте PDF и попробуйте выделить строку. Если вместо букв выбирается вся страница или выделения нет, переходите к распознаванию. В PDF Commander команда распознавания находится в редакторе; в окне распознавания задают язык документа и запускают обработку. После окончания вновь проверьте выделение, поиск по слову и копирование короткой строки. Эти три действия важнее визуального впечатления: PDF после OCR внешне практически не меняется, по этой причине итог необходимо подтвердить именно работой с текстом.
- Откройте исходный PDF и сразу сохраните рабочую копию под другим именем, чтобы любые изменения не затронули оригинал.
- Перейдите к распознаванию текста. Для многоязычного материала выбирайте язык, соответствующий реальному содержимому страницы; наименования брендов на латинице потом проверяйте отдельно.
- Запустите распознавание и дождитесь обработки нужных страниц.
- Выделите два-три контрольных фрагмента: обычный абзац, строку с цифрами и сложное имя или термин.
- Скопируйте их в простой текстовый редактор. Лишь после этого переносите весь нужный объём в Word, презентацию, систему управления контентом или внутреннюю систему.
В длинном скане не стоит оценивать качество только по первой странице. OCR сильнее ошибается там, где есть мелкий кегль, фон, печати, наклон, низкий контраст, двухколоночная верстка и смешение языков. Для маркетингового отчёта или коммерческого предложения выделите контрольные страницы различных типов: обычный текст, таблицу, слайд с инфографикой. Если ошибки повторяются системно, исправьте источник — к примеру, возьмите более качественный скан — вместо ручной правки сотен одинаковых искажений.
Документ с известным паролем и разрешённым редактированием
Когда текстовый слой есть, но копирование запрещено настройками безопасности, действуйте через штатные параметры доступа. В PDF Commander раздел безопасности позволяет работать с паролем и правами документа. Этот маршрут предназначен для собственного или разрешённого к обработке файла. Сперва проверьте, какой тип защиты включён, затем применяйте известный пароль и измените права так, чтобы копирование было разрешено. После сохранения заново откройте файл и протестируйте выделение. Не подменяйте этот этап печатью в новый PDF или сомнительными сервисами: они меняют документ и не дают гарантии сохранения структуры.
Если пароль неизвестен и права на изменение не подтверждены, рабочий процесс заканчивается обращением к владельцу документа. Для корпоративной среды это не формальность: владелец часто может прислать исходник Word, презентацию или экспорт без ограничений, и такой файл даст более точный итог, чем любой путь через распознавание. OCR в этой ситуации применяют к визуально доступному содержимому только тогда, когда правила организации и права на обработку это разрешают.
Небольшой фрагмент через снимок экрана
Для одного абзаца можно не распознавать двадцать страниц. Сделайте снимок нужной области средствами Windows, сохраните изображение и добавьте его в PDF Commander, потом запустите распознавание текста. Это в особенности удобно для подписи к диаграмме, цитаты из презентационного PDF или нескольких строк в медиаките. После распознавания сопоставьте текст с изображением символ в символ: краткость фрагмента позволяет сделать такую сверку быстрее, чем искать ошибку позднее в опубликованном материале.
Плюсы
- Один рабочий процесс для обычного PDF, скана и страниц, собранных из изображений.
- Распознавание выполняется локально на компьютере, по этой причине файл не нужно передавать в браузерный сервис.
- После OCR текст можно не только копировать, но и искать внутри обработанного документа.
- Подходит для поэтапной проверки: можно обработать небольшой фрагмент, оценить качество и только затем переходить к остальным страницам.
Минусы
- Распознавание не отменяет вычитку: фамилии, числа, тире, кавычки и символы на сложном фоне требуют контроля.
- Структурные элементы сложного макета — колонки, подписи, таблицы — после переноса в иной редактор всё равно приходится проверять.
- Маршрут с изменением параметров безопасности применим только к документам, на изменение которых у пользователя есть право и нужные данные доступа.
Кому подойдёт
PDF Commander удобен сотрудникам, которые систематически получают PDF от подрядчиков, сканы актов, презентационные материалы, брифы и отчёты и хотят обрабатывать их локально на Windows. В особенности логичен этот метод, когда в одном потоке встречаются и нормальные PDF, и сканы: не приходится всякий раз менять приложение и заново осваивать другой интерфейс.
2. Microsoft Word: открыть PDF как редактируемый документ
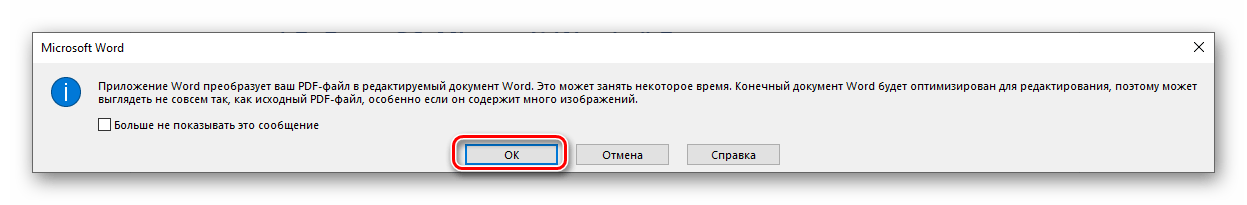
Word полезен, когда PDF в основном состоит из обычного текста, но копирование отдельных фрагментов неудобно или кодировка даёт проблемы. Microsoft прямо указывает, что Word создаёт копию PDF и преобразует её в редактируемый документ; исходный PDF вместе с этим не переписывается. На Xeon Live есть подробная инструкция по преобразованию PDF в Word. Главная оговорка: Word ориентируется на восстановление структуры документа, а не на пиксельное совпадение с исходной страницей.
Порядок действий
- Запустите Word и выберите открытие существующего файла.
- Укажите PDF. Word покажет предупреждение о преобразовании в редактируемый формат.
- Подтвердите преобразование и дождитесь создания копии.
- Отыщите нужный фрагмент, выделите его и скопируйте обычным методом.
- Сопоставьте абзац с исходным PDF, в особенности переносы строк, списки, сноски, колонки, числа и подписи.
Этот метод силён именно на текстовых документах: инструкциях, отчётах, статьях, регламентах, пресс-релизах. Microsoft предупреждает, что сложная графика способна превратиться в изображение, а макет после преобразования отличается от PDF. По этой причине Word не стоит воспринимать как универсальный экстрактор для дизайнерского каталога или буклета. Когда исходный файл похож на журнальный разворот, порядок чтения лучше проверить по странице, а не доверять последовательности абзацев в получившемся DOCX.
Word тоже полезен как диагностический инструмент. Если документ открывается и абзацы становятся редактируемыми, значит в PDF есть данные, которые конвертер сумел интерпретировать. Если целая страница вставлена в документ Word как одно изображение, проблема возвращается к OCR. В этом случае не нужно ручным способом перепечатывать текст: переходите к распознаванию в PDF Commander, Acrobat, Просмотре на Mac или к небольшому снимку экрана.
Для материалов с таблицами проведите отдельную проверку. Даже когда строки и цифры извлечены правильно, границы ячеек и связь заголовка со столбцом могут измениться. В медиаплане, отчёте по рекламе или прайс-листе это критично: цифра, попавшая на одну колонку вправо, формально распознана верно, но смысл уже ошибочен. По этой причине контроль должен учитывать не только символы, но и позицию данных относительно заголовков.
Плюсы
- Исходный PDF остаётся отдельным файлом, а Word работает с преобразованной копией.
- Удобно переносить большие объёмы обычного текста и сразу править их в знакомом текстовом редакторе.
- Подходит для дальнейшего редактирования, стилистической правки, комментирования и подготовки материала к публикации.
- Не требует предварительного ручного копирования страницы за страницей.
Минусы
- Сложная верстка, графика, таблицы и многоколоночные страницы преобразуются с изменениями.
- Скан без текстового слоя Word не превращает автоматически в идеальный редактируемый документ во всех сценариях; для такого файла рациональнее сперва применять OCR.
- После конвертации обязательна сверка логики абзацев, нумерации, подписей и числовых данных.
Кому подойдёт
Word удобен редакторам, специалистам по связям с общественностью, маркетологам и менеджерам, которым необходимо перенести в работу много обычного текста из отчёта, инструкции, исследования или коммерческого материала, а затем отредактировать его. Для дизайнерских PDF и сканов применяйте его как вспомогательный путь, а не как единственный этап.
3. Ножницы Windows: извлечь один фрагмент через Text actions
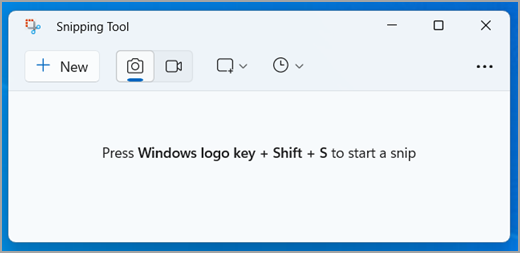
Когда необходим один абзац, подпись к графику или номер из страницы, полный OCR документа избыточен. В актуальных Ножницах Windows после снимка есть Text actions — распознавание текста на захваченном изображении. Комбинация Win+Shift+S открывает захват области. Для более широкого сценария работы со снимками и изображениями пригодится инструкция Xeon Live по извлечению текста из картинки или скриншота.
Порядок действий
- Откройте PDF на нужной странице и увеличьте масштаб так, чтобы буквы были чёткими.
- Нажмите Win+Shift+S и обведите только нужный текст. Не захватывайте лишние колонки и соседние подписи.
- Откройте созданный снимок в Ножницах.
- Выберите Text actions и дождитесь распознавания.
- Скопируйте конкретный фрагмент или весь распознанный текст, потом вставьте его в рабочий документ.
- Сверьте итог с изображением: наименования, числа, знаки процента, дефисы и похожие буквы различных алфавитов.
Microsoft указывает, что распознавание для Text actions выполняется локально. Для рабочего процесса это означает, что небольшой конфиденциальный фрагмент не нужно отправлять в сторонний онлайн-сервис только ради нескольких строк. Вместе с этим снимок экрана сам становится отдельным файлом с данными, по этой причине после окончания работы его следует хранить и удалять по тем же правилам, что и исходный документ.
Качество тут сильно зависит от того, что попало в кадр. Увеличьте PDF до комфортного масштаба, избегайте выделения сразу двух колонок и не включайте в область декоративные фоновые элементы. Для мелкого серого текста на цветном фоне порой лучше сделать более крупный снимок одной строки, чем пытаться распознать весь блок. Ножницы в особенности выигрывают там, где человеческая проверка занимает секунды: один номер договора, наименование кампании, цитата, подпись или короткий абзац.
Этот путь не исправляет исходный PDF. Поиск внутри файла, нормальное выделение и повторное копирование с других страниц не появятся. Если задача повторяется на десятках страниц, не делайте десятки снимков: это сигнал перейти к полноценному OCR всего документа.
Плюсы
- Очень быстрый маршрут для одного или нескольких небольших фрагментов.
- Не требуется преобразовывать весь PDF и рисковать его версткой.
- Распознавание текста выполняется средствами Windows после обычного снимка экрана.
- Удобно для визуально сложных страниц, когда необходим конкретный участок, а не весь порядок чтения.
Минусы
- Не создаёт текстовый слой в самом PDF и не решает задачу массового поиска по документу.
- При большом количестве страниц ручной захват становится медленным и увеличивает риск пропустить фрагмент.
- Снимки с мелким, наклонным или низкоконтрастным текстом требуют в особенности внимательной сверки.
Кому подойдёт
Ножницы подходят для разовых задач: быстро взять цитату из слайда, подпись к диаграмме, несколько строк из защищённого от выделения просмотрщика или текст из старого скана. Для регулярной обработки документов применяйте полноформатный OCR, чтобы не превращать работу в серию ручных снимков.
macOS: встроенный Просмотр и Adobe Acrobat
4. Просмотр: обычное выделение и встроенное распознавание
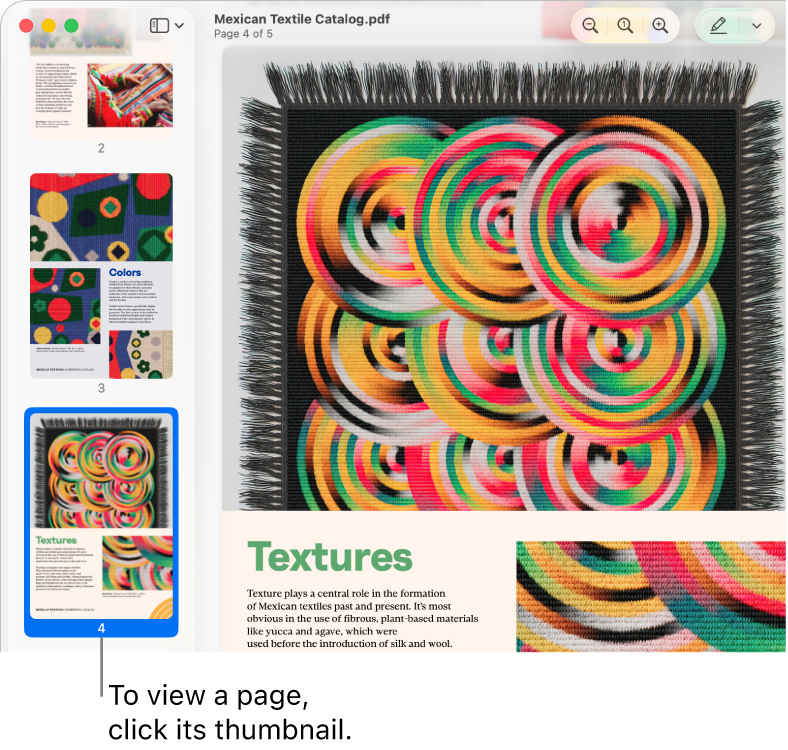
На Mac сперва проверьте системный Просмотр (Preview). Для текстового PDF Apple предлагает инструмент Text Selection: выделение копируется через Edit → Copy. Если PDF состоит из изображений, современные версии Просмотра умеют распознавать текст и при экспорте добавлять его в документ. Общие сведения о формате и его структуре собраны в гайде Xeon Live о PDF.
Сперва проверьте обычное копирование
- Откройте PDF в Просмотре.
- Выберите Tools → Text Selection, если активен иной инструмент выделения.
- Проведите курсором по фрагменту. Нормальный текст выделяется по строкам и словам.
- Скопируйте выделение через Edit → Copy и вставьте в простой редактор для проверки.
- Если выделить текст нельзя, переходите к встроенному распознаванию или проверке пароля.
Apple отдельно описывает ситуацию, когда текст нельзя выбрать или скопировать: сперва необходимо убедиться, что активирован инструмент текстового выделения; защищённый PDF тоже требует корректного пароля. Это полезно, потому что внешне неправильный режим выделения очень похож на отсутствие текстового слоя. Одно переключение инструмента экономит время, которое иначе ушло бы на ненужную конвертацию.
Добавление распознанного текста в PDF
Для PDF без распознанного текста Просмотр предлагает экспорт с опцией Embed Text. Откройте файл, выберите File → Export и активируйте добавление текста, когда этот параметр доступен. После экспорта откройте новую копию, повторите поиск и выделение. Храните исходный скан отдельно: распознанная версия удобна для работы, но любые ошибки OCR легче проверять, когда рядом остаётся неизменённая картинка страницы.
На macOS в особенности удобно держать рядом два окна: исходный скан и документ, куда переносится текст. При проверке длинного абзаца сверяйте не каждую букву подряд, а зоны повышенного риска — цифры, имена, сокращения, символы валют, номера пунктов и окончания строк с переносами. Затем выборочно сопоставьте несколько обычных предложений. Такой метод даёт разумный баланс между скоростью и качеством.
Плюсы
- Встроенный в macOS инструмент, по этой причине базовое копирование и проверка не требуют отдельной программы.
- Поддерживает как обычное текстовое выделение, так и добавление распознанного текста в подходящих PDF.
- Удобен для быстрых локальных задач и проверки нескольких страниц.
- Исходный документ легко оставить отдельным, экспортируя распознанную копию.
Минусы
- Сложные таблицы и дизайнерская верстка после распознавания всё равно требуют ручной проверки.
- Параметр добавления текста доступен только там, где Просмотр определяет, что распознавание нужно и поддерживается.
- Для массовой обработки документов с большим количеством исключений специализированный PDF-редактор даёт более управляемый процесс.
Кому подойдёт
Просмотр рационален владельцам Mac, которым необходимо без лишней инфраструктуры извлечь текст из обычного PDF или распознать несколько сканированных страниц. Для сложного корпоративного потока с проверкой ограничений, пакетной обработкой и экспортом в другие форматы удобнее Acrobat или другой специализированный редактор.
5. Adobe Acrobat: проверить ограничения, выполнить OCR и экспорт
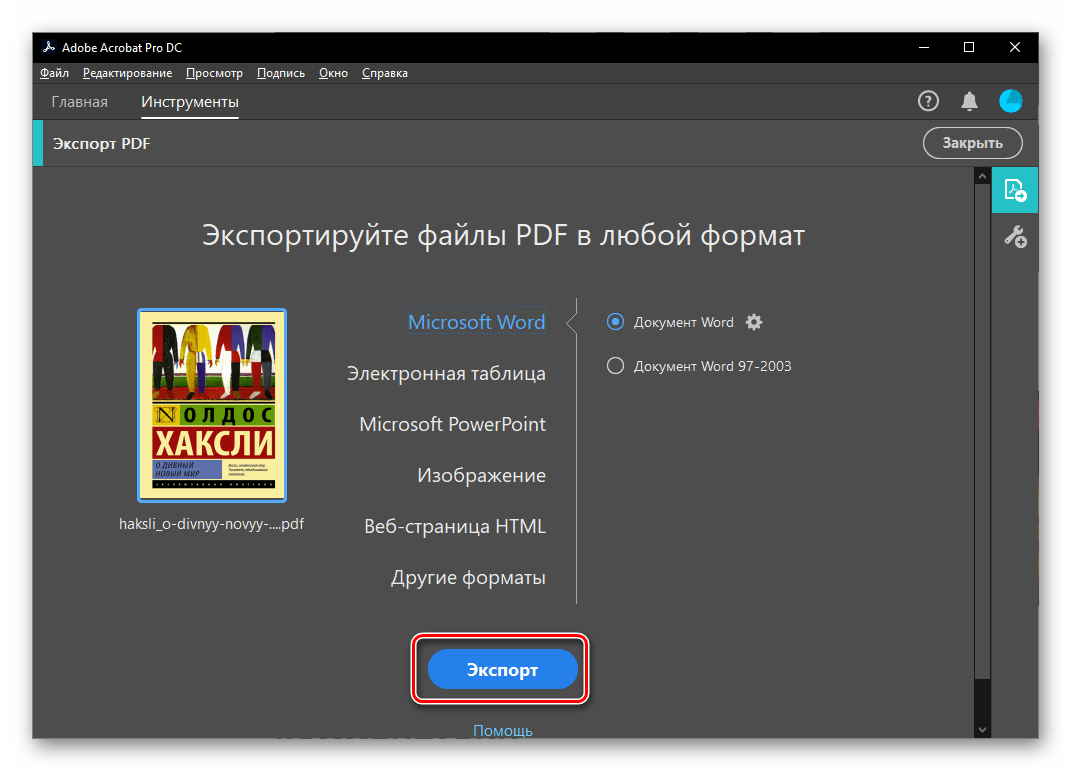
Acrobat полезен, когда необходимо сперва понять статус документа, а потом решить, достаточно ли обычного копирования или необходим OCR. В Adobe Reader и Acrobat свойства безопасности показывают ограничения, в том числе разрешено ли копирование. Для скана Acrobat применяет Scan & OCR и создаёт текстовый слой, который становится доступен для выделения и поиска. Пошаговый общий маршрут распознавания собран в инструкции Xeon Live по распознаванию текста в PDF.
Проверка ограничений
- Откройте PDF и перейдите к свойствам документа.
- На вкладке безопасности изучите Document Restrictions Summary — сводку ограничений.
- Если копирование разрешено, вернитесь к Select Tool и попробуйте выделить текст ещё раз.
- Если копирование запрещено, изменяйте разрешения лишь в своём документе с известными данными доступа или попросите у владельца версию без ограничения.
- Если ограничений нет, но текст не выделяется, переходите к OCR.
Распознавание скана
- Откройте All tools → Scan & OCR.
- Выберите In this file, задайте нужные страницы и язык.
- Запустите Recognize Text.
- После обработки отыщите несколько слов через поиск и скопируйте контрольный абзац.
- Применяйте проверку распознанного текста на страницах со сложным шрифтом, печатями и фоном; Adobe отдельно рекомендует просматривать итоги OCR на ошибки.
Для переноса большого объёма в Word можно применять экспорт в DOCX. Это не отменяет сверку: преобразование формата и OCR решают различные задачи. OCR отвечает за распознавание символов, а экспорт — за построение структуры нового документа. Ошибка способна появиться на любом из двух этапов. В отчёте с таблицами проверяйте значения и привязку к столбцам, в договоре — нумерацию и реквизиты, в презентации — соответствие подписи конкретному слайду.
Acrobat тоже хорошо подходит как эталонная диагностика ограничений. Когда команда копирования не работает, не нужно угадывать, поставил ли автор запрет: сводка безопасности показывает это явно. Такой контроль уменьшает риск бессмысленного OCR текстового PDF, который уже содержит корректные символы, но ограничен настройками доступа.
Плюсы
- В одном процессе совмещаются диагностика ограничений, OCR и экспорт в редактируемые форматы.
- Сводка безопасности позволяет отличить запрет копирования от отсутствия текстового слоя.
- OCR создаёт выделяемый и доступный для поиска текст поверх скана.
- Подходит для многостраничных документов, когда необходим системный процесс с контрольными этапами.
Минусы
- После OCR и экспорта сложной верстки всё равно нужна редакторская проверка.
- Для одного короткого фрагмента полный процесс избыточен в сравнении с системным снимком экрана.
- Изменение разрешений документа требует прав на файл и соответствующих данных доступа.
Кому подойдёт
Acrobat подходит командам, где PDF систематически проходит через согласование, архив, экспорт в Word и распознавание сканов. Это в особенности уместно для отчётов, исследований, договоров и длинных материалов, где важно не только получить текст, но и зафиксировать, почему обычное копирование не работало.
Онлайн: Google Drive и Google Документы
6. Google Drive: открыть PDF через Google Документы
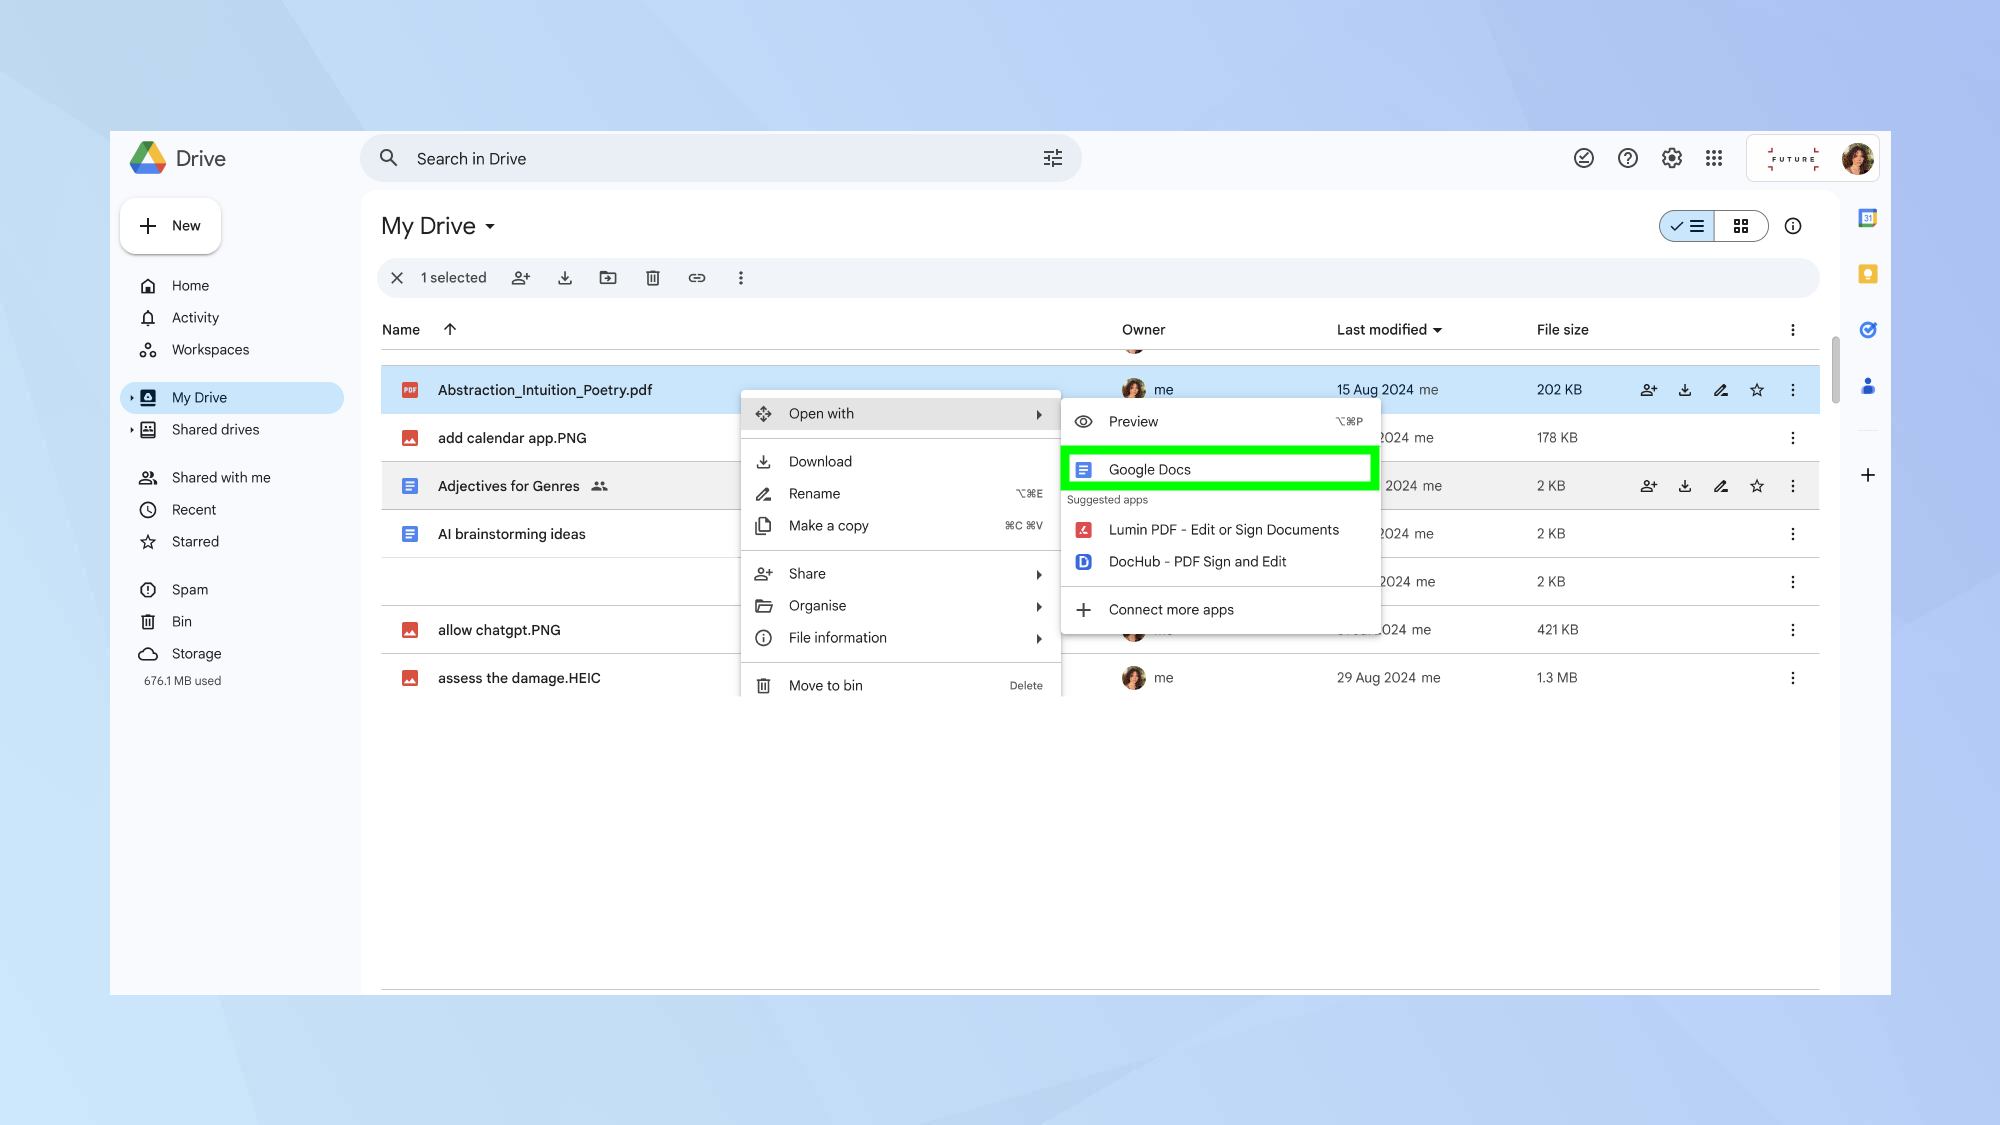
Для неконфиденциального файла, с которым удобно работать в браузере, Google Drive предлагает простой маршрут: загрузить PDF, нажать правой кнопкой и выбрать Open with → Google Docs. Google описывает этот метод именно как преобразование PDF или изображения в текст. На Xeon Live есть отдельная инструкция по открытию PDF в Google Документах.
Порядок действий
- Загрузите PDF в Google Drive с компьютера.
- Нажмите по файлу правой кнопкой мыши.
- Выберите Open with → Google Docs.
- Дождитесь создания документа с распознанным содержимым.
- Скопируйте нужный текст или продолжите редактирование в Google Документах.
- Сверьте итог с исходным PDF, в особенности таблицы, колонки, сноски, числа и смешанные алфавиты.
В справке Google для преобразования в текст указано ограничение размера файла до 2 МБ и рекомендации по качеству: изображение должно быть ориентировано правильно, текст — достаточно крупным, а исходник — резким. Google тоже предупреждает, что базовое форматирование вроде жирного и курсива сохраняется лучше, чем списки, таблицы, колонки, сноски и концевые примечания. Для статьи или заметки это приемлемо, для медиаплана и финансовой таблицы — сигнал к обязательной построчной проверке.
Онлайн-маршрут удобен совместной команде: распознанный текст сразу находится в документе, который можно комментировать и редактировать. Но удобство не отменяет политики обработки данных. Не загружайте в облачный сервис документы, для которых корпоративные правила требуют локального хранения. В этом случае применяйте PDF Commander, Ножницы, Просмотр или Acrobat локально.
Google Документы разумно воспринимать как средство получить редактируемую версию, а не как метод сохранить исходную верстку PDF. Дизайнерский буклет с несколькими колонками, карточками и подписями практически неизбежно потребует сборки текста в правильном порядке. Если важна именно визуальная структура, держите PDF открытым рядом и переносите содержимое блоками, сохраняя связь между заголовком, подписью и объектом.
Плюсы
- Не требуется отдельная настольная программа: обработка запускается из браузера на компьютере.
- Распознанный текст сразу доступен для совместного редактирования и комментариев.
- Подходит для простых сканов, заметок и небольших документов без сложной верстки.
- Удобно, когда итог всё равно должен оказаться в Google Документах.
Минусы
- Файл передаётся в облачную среду, по этой причине метод не подходит документам с запретом на внешнюю загрузку.
- Таблицы, колонки, списки и сноски преобразуются менее надёжно, чем обычные абзацы.
- Для встроенного преобразования Google рекомендует небольшой размер исходного файла; крупные многостраничные документы рациональнее обрабатывать локально.
Кому подойдёт
Google Drive удобен распределённым редакциям и маркетинговым командам, которые работают в Google Документах и извлекают текст из небольших неконфиденциальных PDF. Для чувствительных материалов и тяжёлых сканов выбирайте локальный процесс.
iPhone и Android: когда под рукой только телефон
На смартфоне наиболее предсказуемый путь — не пытаться заставить просмотрщик PDF выделить то, чего в файле нет, а превратить нужную область в изображение и применить системное распознавание. Такой маршрут в особенности удобен в дороге: необходимо перенести пару строк из скана, подпись к диаграмме или номер из презентации. Для самого захвата экрана пригодится инструкция Xeon Live по созданию снимка экрана. Для десятков страниц смартфон уже проигрывает настольному OCR по скорости проверки и организации файлов.
7. iPhone и iPad: снимок страницы и Live Text
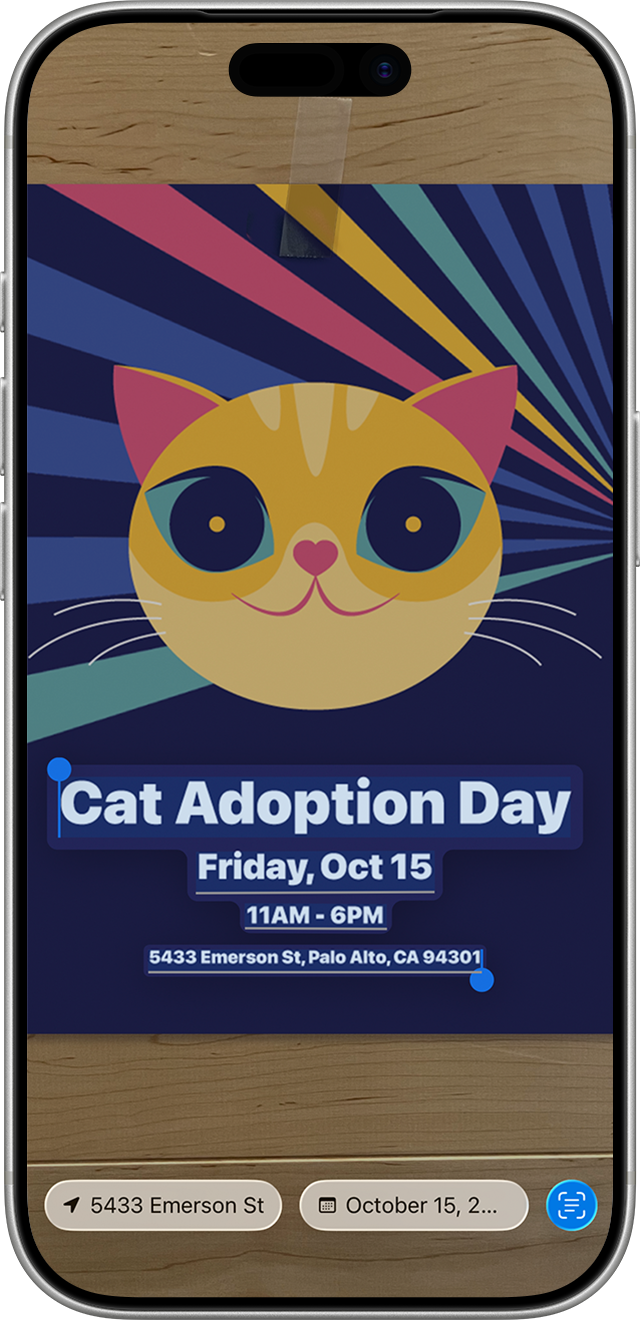
Apple Live Text распознаёт текст внутри фотографий и других изображений и позволяет выделить его обычными маркерами, затем нажать Copy. Для PDF без нормального текстового слоя практический порядок такой: откройте страницу, увеличьте нужный фрагмент, сделайте снимок экрана, откройте снимок в Фото и применяйте Live Text. В отличие от конвертации всего PDF, этот метод сохраняет задачу локальной и ограничивает распознавание ровно тем фрагментом, который необходим.
Порядок действий
- Откройте PDF и увеличьте страницу так, чтобы нужный текст занимал значительную часть экрана.
- Сделайте снимок экрана и откройте его в приложении Фото.
- Активируйте Live Text, затем удерживайте слово и растяните маркеры выделения на нужный фрагмент.
- Нажмите Copy и вставьте текст в Заметки, документ или другое рабочее приложение.
- Сверьте числа, имена и знаки с исходной страницей PDF до дальнейшего применения.
Apple в актуальной справке прямо описывает копирование текста из фото, видео или изображения. Для нашей задачи PDF выступает только источником картинки: после снимка Live Text работает с изображением страницы. Это полезно для скана и для PDF, где выделение отключено в конкретном просмотрщике, но не заменяет полноценную обработку многостраничного архива.
На телефоне в особенности важен масштаб. Если на снимке помещается вся страница A4 с мелким шрифтом, символы становятся слишком маленькими для надёжной проверки. Лучше сделать два-три крупных фрагмента, чем один общий кадр. Длинный материал удобнее передать на компьютер и распознать целиком, чтобы сохранить поиск и не собирать текст ручным способом по частям.
Плюсы
- Встроенный системный метод для совместимых iPhone и iPad, без отдельного OCR-сервиса.
- Очень быстро извлекает несколько строк из скана или изображения страницы.
- Удобно сразу вставить итог в Заметки, письмо, документ или мессенджер.
- Обрабатывается только нужный фрагмент, по этой причине визуальная сверка занимает мало времени.
Минусы
- Для многостраничного PDF серия снимков превращается в медленный ручной процесс.
- Сложные таблицы и колонки приходится собирать по визуальному оригиналу.
- Качество зависит от размера текста на снимке и читаемости исходной страницы.
Кому подойдёт
Live Text подходит тем, кому на iPhone или iPad необходимо быстро достать небольшой фрагмент из PDF без переноса файла на компьютер. Для целого отчёта, книги или архива применяйте настольный OCR: он лучше организует страницы и последующую проверку.
8. Android: снимок страницы и Google Lens
На Android аналогичную задачу закрывает Google Lens. В справке Google Photos указано, что Lens работает с фотографиями и позволяет выбрать слова для копирования; в карточке Google Lens в Google Play отдельно заявлено копирование длинных абзацев и кодов с изображения. Для PDF-сценария сперва сделайте снимок нужной области страницы, потом откройте изображение в Google Photos и передайте его в Lens.
Порядок действий
- Откройте PDF и увеличьте нужный текст до читаемого размера.
- Сделайте снимок экрана с минимальным количеством лишних элементов вокруг текста.
- Откройте снимок в Google Photos и выберите Google Lens через доступное меню приложения.
- Выделите нужные слова и скопируйте их в буфер обмена.
- Вставьте итог в рабочее приложение и сопоставьте его с изображением, в особенности в строках с цифрами и именами.
Google Lens удобно применять как точечный инструмент, а не как конвертер всего документа. Когда на странице есть две колонки, берите их отдельными кадрами. Если в PDF много повторяющихся страниц, передайте файл на компьютер: один полноценный OCR-проход даст цельный текстовый слой и сократит количество ручных операций.
Для рабочих документов учитывайте, что Google Lens относится к сервисам Google и отдельные функции применяют сетевую инфраструктуру. Документы с ограничениями на внешнюю обработку лучше не переносить в такой сценарий. В этом случае на Android рациональнее отложить обработку до локального настольного инструмента, а не искать случайное приложение с неизвестной политикой данных.
Плюсы
- Подходит для быстрого извлечения текста из снимка страницы на Android.
- Работает через привычный сценарий Google Photos и Google Lens.
- Позволяет выделить только нужные слова, а не переносить весь распознанный массив.
- Удобен для разовых задач в дороге и проверки коротких фрагментов.
Минусы
- Не создаёт полноценный текстовый слой внутри исходного PDF.
- Многостраничная обработка ручным способом занимает заметно больше времени, чем настольный OCR.
- Для документов с запретом на внешнюю обработку сервисный сценарий не подходит.
Кому подойдёт
Google Lens подходит пользователям Android, которым необходимо перенести несколько строк, подпись, код или небольшой абзац из PDF-скана. Для регулярной обработки отчётов и архивов применяйте компьютерный метод, где легче сохранить структуру и провести системную сверку.
Как выбрать метод без лишних экспериментов
Выбор инструмента проще свести не к брендам, а к характеристикам задачи. Перед началом ответьте на пять вопросов: есть ли текстовый слой, сколько страниц необходимо обработать, важна ли точная верстка, можно ли передавать файл в облако и сколько времени есть на проверку. Этого достаточно, чтобы исключить большую часть неподходящих маршрутов.
- Обычный текстовый PDF, много текста. Сперва Word или обычное копирование. Если символы искажаются, применяйте OCR как пересборку текстового слоя.
- Скан на десятки страниц. Полноценный OCR в PDF Commander, Acrobat или Просмотре на Mac. Ножницы тут создадут слишком много ручных операций.
- Один абзац или подпись. Ножницы Windows или системное распознавание изображения на Mac дают самый короткий путь.
- Документ с ограничением копирования. Проверьте свойства безопасности. Для собственного файла применяйте известный пароль и штатное изменение разрешений; для чужого — попросите у владельца разрешённую версию.
- PDF с таблицами и многоколоночной версткой. Извлечение текста всегда сопровождайте визуальной сверкой структуры. Важна не только точность символов, но и то, к какому столбцу или подписи они относятся.
- Конфиденциальный документ. Предпочитайте локальные средства и не создавайте лишние копии в облачных хранилищах, если внутренние правила этого не допускают.
Для повторяющейся корпоративной задачи полезно один раз закрепить маршрут в регламенте. К примеру: все сканы до десяти страниц обрабатываются локально через OCR, затем сотрудник сверяет первую, среднюю и последнюю страницу; отчёты с таблицами получают добавочную проверку цифр; документы с ограничениями не перерабатываются без подтверждённых прав. Такой процесс снижает разнобой и позволяет пояснить происхождение текста через месяц, когда материал уже ушёл в презентацию или публикацию.
Что делать, если текст вставляется иероглифами или странными символами
Ситуация, когда текст прекрасно виден и даже выделяется, но после вставки превращается в иероглифы, квадраты или бессмысленную последовательность, отличается от скана. Тут PDF содержит текстовые объекты, однако приложение-получатель получает неправильное соответствие показываемых знаков обычным символам. На Xeon Live есть отдельный разбор иероглифов при переносе PDF в Word. Практически полезно не исправлять каждую букву ручным способом, а получить новый текстовый слой через OCR либо преобразовать весь документ в Word и сопоставить итог.
Начните с короткого теста в простом текстовом редакторе. Если и там строка неправильная, проблема находится до Word: в самом PDF или в его текстовом слое. Затем попробуйте OCR одной страницы. Когда распознанная строка становится нормальной, обработайте нужный диапазон. Если OCR тоже путает символы, увеличьте качество исходного изображения или отыщите первоначальный цифровой файл — к примеру, DOCX или презентацию, из которой был сделан PDF.
Не пытайтесь восстанавливать длинный документ массовой заменой символов вроде «все квадраты заменить на букву А». Одинаковый визуальный знак способен соответствовать различным буквам в различных местах, а ошибка останется незаметной в именах и числах. Для публикационного текста допустима автоматизация лишь после выборочной проверки на нескольких страницах и обязательной финальной вычитки.
Отдельная зона риска — смешение кириллицы и латиницы. В наименовании бренда, домене или коде продукта буквы A, C, E, O, P, X визуально похожи на кириллические А, С, Е, О, Р, Х. Человеческий глаз не всегда заметит подмену, а поиск, сортировка и ссылки будут работать иначе. После OCR проверяйте такие строки в контексте, а не только на вид.
Сканированный документ: как подготовить его к распознаванию
Качество OCR начинается до программы. Если скан снят под углом, текст занимает маленькую часть кадра, на бумаге сильные тени, а страница пережата до низкого качества, любой распознаватель получает сложный материал. Для старых бумажных документов полезна инструкция Xeon Live по работе со сканированными документами. Главная цель подготовки — дать OCR ровные, контрастные и достаточно крупные символы.
- Выравнивайте страницу до распознавания. Наклон строк ухудшает распознавание и усложняет восстановление абзацев.
- Обрезайте пустые поля, соседнюю страницу, края стола и фон. Чем меньше лишних объектов, тем понятнее структура страницы.
- Не увеличивайте резкость агрессивно. Контурные ореолы вокруг букв могут восприниматься как добавочные штрихи.
- Для фотографии документа избегайте бликов. Белое пятно на строке уничтожает часть символов, которую программа не восстановит из контекста надёжно.
- Разворот книги лучше распознавать как две отдельные страницы. Сильный изгиб у корешка нарушает геометрию строк.
- После распознавания проверяйте не только визуально похожие буквы, но и дефисы, длинные тире, кавычки, знаки номера, проценты и десятичные разделители.
Если скан необходим для маркетингового исследования или пресс-материала, заблаговременно определите, что именно будет применяться. Не обязательно доводить весь архив до идеального состояния, если в работу идут две страницы. Но если материал станет источником десятков цитат, тезисов и цифр, выгоднее один раз получить качественный текстовый слой и провести системную сверку, чем всякий раз заново распознавать отдельные снимки.
Таблицы, колонки, буклеты и презентационные PDF
Самая неприятная ошибка после успешного копирования — не неправильная буква, а неправильная структура. В двухколоночной статье абзац из правой колонки способен вклиниться в левую; в таблице число попадает к соседнему показателю; в презентации подпись оказывается под другим слайдом. В результате текст выглядит грамотно, но смысл искажён. По этой причине сложный макет проверяют по связям между элементами.
Таблицы и медиапланы
Сперва определите заголовки столбцов и строки, затем переносите данные блоками. После конвертации сопоставьте минимум одну строку в начале, середине и конце таблицы, а также строки с пустыми ячейками и объединёнными заголовками. В рекламном отчёте отдельно проверяйте проценты, валюту, десятичные значения и даты. Ошибка «1,8» вместо «18» формально занимает всего один символ, но меняет вывод сильнее, чем десяток опечаток в тексте.
Многоколоночные статьи и каталоги
Не копируйте всю страницу одним движением, пока не проверили порядок чтения. Лучше обрабатывать каждую колонку отдельно или применять OCR с последующей сборкой по визуальному оригиналу. В особенности внимательно относитесь к врезкам и подписям: распознаватель часто воспринимает их как продолжение основного абзаца, хотя смысловой блок самостоятельный.
Презентации, брендбуки и пресс-киты
В презентационном PDF текст часто разбит на независимые блоки. При переносе в Word или Google Документы их порядок определяется не визуальной композицией слайда, а внутренней структурой объектов. По этой причине для цитаты или короткого описания безопаснее взять конкретный блок, а не конвертировать весь слайд и затем выбирать фрагмент из получившегося потока. Если необходимо переработать весь материал, фиксируйте номер страницы или слайда рядом с каждым извлечённым блоком до начала редакторской правки.
Для брендбука сохраняйте связь между текстом и визуальным примером. Правило «логотип на тёмном фоне» без соседней иллюстрации порой теряет важное исключение, которое показано графически, но не продублировано словами. Извлечение текста не заменяет чтение документа как макета.
Как проверить качество после OCR или конвертации
Вычитка необходима не потому, что OCR обязательно плох, а потому, что цена различных ошибок неодинакова. Пропущенная запятая редко ломает бизнес-решение; неверная цифра в бюджете, дата мероприятия или фамилия спикера — ломают. Проверка должна быть риск-ориентированной: сперва элементы с высокой ценой ошибки, затем обычный текст.
- Сверьте числа и даты. Проверьте суммы, проценты, номера договоров, периоды, версии, размеры, артикулы и показатели.
- Проверьте имена собственные. Фамилии, бренды, наименования компаний, продуктов и географические наименования плохо восстанавливаются по контексту, потому что словарь не всегда помогает.
- Сопоставьте заголовки и структуру. Убедитесь, что заголовок не оказался продолжением предыдущего абзаца, а подпись не переместилась к соседнему объекту.
- Проверьте переносы. Дефис в конце строки в исходном скане способен остаться внутри слова после переноса в непрерывный текст.
- Проверьте похожие символы. Ноль и буква O, единица и латинская l, кириллица и латиница, длинное тире и дефис.
- Сопоставьте начало, середину и конец длинного документа. Так выявляются страницы другого качества, которые не были заметны по первому развороту.
- Проверьте итог в том приложении, где текст будет применяться. Копирование в буфер — промежуточный этап; ошибки форматирования способны появиться уже при вставке в CMS, презентацию или таблицу.
Для ответственных материалов полезно разделить роли: один сотрудник извлекает и приводит текст к рабочему виду, другой сверяет цифры и спорные места по исходному PDF. Даже при небольшой команде независимый второй просмотр лучше обнаруживает подмену похожих символов и пропущенные строки, потому что проверяющий не опирается на собственную память о том, как он сам исправлял текст.
Простая метрика качества для большого документа
Когда страниц много, фраза «вроде распозналось нормально» недостаточна. Введите небольшую выборочную проверку. Возьмите три типовых фрагмента по 1000 видимых символов: обычный текст, сложную страницу и участок с цифрами или именами. Сопоставьте их с оригиналом и посчитайте количество смысловых и символьных ошибок. Такая метрика не заменяет финальную вычитку, но быстро показывает, какой метод даёт устойчивый итог именно на вашем документе.
- Символьная ошибка. Неправильная буква, цифра, знак препинания, пропуск или лишний символ.
- Структурная ошибка. Переставленный абзац, перепутанный столбец, потерянная подпись, объединение двух независимых блоков.
- Критическая ошибка. Искажение числа, даты, имени, ссылки, условия или другого фрагмента, который способен изменить решение или опубликованный факт.
Сопоставляйте методы по одной и той же выборке. К примеру, распознайте три страницы в PDF Commander и теми же страницами проверьте Acrobat или Google Документы. Оценивайте не только число опечаток, но и время доведения итога до готового текста. Метод с чуть более чистым OCR может оказаться хуже, если он постоянно ломает порядок колонок и требует долгой ручной сборки. Для редакционного процесса полезна итоговая метрика «минуты на одну готовую страницу после проверки».
Не применяйте процент точности, указанный разработчиком программы, как прогноз для своего архива. Качество зависит от шрифта, языка, разрешения, перекоса, фона и структуры конкретных страниц. Собственная контрольная выборка на реальных документах даёт более полезное решение, чем универсальная цифра из описания продукта.
Конфиденциальность и права доступа
Проблема с копированием зачастую появляется в документах, которые нельзя свободно пересылать: договорах, закрытых отчётах, внутренних презентациях, финансовых материалах. По этой причине инструмент выбирают не только по качеству распознавания. Локальный OCR предпочтительнее там, где файл должен оставаться на рабочем компьютере или в корпоративной среде. Облачный сервис применяют лишь в пределах разрешённой политики обработки данных.
- Оставляйте исходный PDF неизменным и создавайте отдельную рабочую копию.
- Не отключайте ограничения безопасности у чужого документа без разрешения владельца.
- Не загружайте конфиденциальный PDF в случайный онлайн-сервис ради одной страницы.
- Удаляйте временные снимки экрана и экспортированные промежуточные файлы по правилам вашей организации.
- Перед публикацией убедитесь, что вместе с текстом не перенесены скрытые персональные или служебные данные из соседних блоков страницы.
- Для юридически значимых документов применяйте извлечённый текст только как рабочую копию; оригинал остаётся источником для финальной сверки.
Если задача состоит в том, чтобы процитировать несколько строк из публичного отчёта, не нужно усложнять процесс. Но если документ содержит закрытые исследования, списки клиентов или условия договора, удобство браузерного OCR не является достаточным основанием для загрузки. Технологический выбор должен следовать режиму данных, а не наоборот.
Что не стоит делать
Некоторые обходные маршруты популярны потому, что выглядят быстрыми, но в рабочем процессе создают больше проблем, чем решают. Их лучше исключить заблаговременно.
- Не перепечатывайте большой скан ручным способом. OCR быстрее, а человеческая перепечатка тоже содержит ошибки и хуже масштабируется.
- Не сохраняйте документ много раз через различные конвертеры без причины. Каждый добавочный переход способен менять верстку, шрифты и структуру.
- Не воспринимайте «текст выделяется» как гарантию правильного копирования. Всегда сделайте тестовую вставку.
- Не считайте внешний вид доказательством качества. После OCR страница выглядит как исходный скан, даже если текстовый слой содержит ошибки.
- Не удаляйте защиту у файла, на изменение которого нет разрешения. Получить у владельца версию без ограничения — корректнее и часто быстрее.
- Не отправляйте чувствительный документ в первый попавшийся сервис. Для локальной задачи есть настольные и системные средства.
- Не публикуйте распознанный текст без проверки цифр и имён. Это самые дорогие ошибки для делового материала.
Рабочие сценарии для маркетинга, PR и контента
Из отчёта необходимо взять несколько цифр и выводов
Сперва проверьте, является ли отчёт текстовым. Если да, применяйте обычное копирование или Word. Если это скан, распознайте нужные страницы целиком, затем сверяйте цифры с таблицей и подписью. Не отделяйте показатель от периода: «рост 18%» без строки «год к году» или «за квартал» превращается в другой факт. В рабочей заметке сохраняйте номер страницы рядом с каждым важным значением, пока материал не прошёл редакционную проверку.
Из брендбука необходима формулировка правила
Чаще всего достаточно одного снимка области и распознавания через Ножницы, потому что объём мал. После копирования сверяйте не только буквы, но и условие применения: минимальный размер, фон, исключение, подпись например. Если правило зависит от картинки, сохраните визуальный контекст в рабочем материале, иначе текстовая цитата будет неполной.
Необходимо переработать PDF-презентацию в статью
Для текстовой презентации попробуйте Word или Acrobat, но не принимайте порядок полученных абзацев за готовую структуру статьи. Каждый слайд имеет собственную иерархию: заголовок, тезис, подпись, число, источник. Сперва восстановите смысл внутри слайда, затем уже перестраивайте материал под линейное чтение. На страницах-картинках выполните OCR по всему диапазону, чтобы поиск работал по презентации целиком.
Необходимо извлечь текст из старого скана договора
Применяйте локальный OCR и держите исходник рядом. Сперва распознайте одну сложную страницу, где есть печати, подписи, мелкий шрифт или таблица. Если качество устраивает, обработайте остальные. Затем отдельно сверяйте даты, номера, фамилии, суммы и отрицания вроде «не», потому что одна потерянная частица меняет смысл условия. Для юридического применения ориентируйтесь на оригинал, а распознанный текст оставляйте вспомогательной рабочей копией.
Необходимо быстро процитировать одну строку из PDF в браузере
Увеличьте страницу, сделайте снимок нужной области и примените локальное распознавание Ножниц. Это короче, чем загружать весь файл в сервис или конвертировать его в Word. После вставки сопоставьте строку с экраном. Для публичной цитаты сохраните номер страницы и контекст, чтобы редактор мог быстро проверить формулировку перед публикацией.
Чек-лист перед передачей текста в работу
- Определён тип PDF: текстовый, скан, смешанный или повреждённый.
- Исходный файл сохранён отдельно и не перезаписывается рабочими конвертациями.
- Выбран метод, соответствующий объёму: снимок для фрагмента, OCR для многостраничного скана, Word для обычного текста.
- Для защищённого документа проверены права и применяется разрешённый метод доступа.
- После OCR выполнен поиск по нескольким словам и тестовое копирование.
- Проверены числа, даты, имена, наименования брендов и смешение кириллицы с латиницей.
- Для таблиц проверена связь значений с колонками и строками.
- Для многоколоночных страниц проверен порядок чтения.
- Временные снимки и облачные копии соответствуют правилам работы с данными.
- Финальный текст сверён в том приложении, где он будет реально применяться.
Частые вопросы
Как понять, что PDF — это скан, а не текстовый документ?
Попробуйте выделить отдельное слово и отыскать знакомую фразу через поиск. У скана страница обычно ведёт себя как изображение: буквы не выделяются по строкам, а поиск по видимому слову ничего не отыскивает. Для такого файла необходим OCR.
Почему текст выделяется, но после вставки получается набор символов?
В PDF присутствует текстовый слой, но соответствие показываемых знаков обычным символам нарушено или нестандартно. Проверьте короткую строку в простом редакторе. Если проблема сохраняется, создайте новый текстовый слой через OCR либо преобразуйте документ и тщательно сверяйте итог.
Что делать, если копирование запрещено настройками безопасности?
Проверьте свойства документа и сводку ограничений. Для собственного файла применяйте известный пароль и штатное изменение разрешений. Для чужого документа попросите у владельца версию, в которой копирование разрешено. Не применяйте методы обхода защиты без подтверждённых прав.
Какой метод выбрать для конфиденциального PDF?
Применяйте локальные средства: PDF Commander, Acrobat, Просмотр на Mac или Ножницы Windows для небольшого фрагмента. Не отправляйте файл в облачный сервис, когда правила организации требуют локального хранения.
Что быстрее для одного абзаца?
На Windows — снимок области через Win+Shift+S и Text actions в Ножницах. Для одного фрагмента это короче полного распознавания документа. Если таких фрагментов становится много, переключайтесь на OCR всего PDF.
Почему таблица ломается после Word или Google Документов?
Преобразователь восстанавливает структуру нового редактируемого документа и не обязан сохранять точную геометрию PDF. Проверяйте не только цифры, но и их принадлежность к строке и столбцу. Для важных таблиц сверка по исходной странице обязательна.
Как сохранить визуальный оригинал и одновременно получить поиск по тексту?
Оставьте исходный скан отдельным файлом и создайте распознанную рабочую копию. В ней появится текстовый слой для поиска и копирования, а исходник останется доступен для проверки сложных мест.
Итог: сперва причина, потом инструмент
Когда PDF не копируется, правильный вопрос — не «какую кнопку нажать», а «что именно мешает получить текст». Скану необходим OCR, ограниченному документу — корректная работа с разрешениями, проблемной кодировке — новый текстовый слой или конвертация, а одному короткому фрагменту — быстрый снимок и локальное распознавание. На Windows первым практическим маршрутом остаётся PDF Commander: он позволяет работать с PDF и распознаванием в одном настольном процессе. Word удобен для больших объёмов обычного текста, Ножницы — для фрагментов, Просмотр — для встроенного сценария macOS, Acrobat — для комплексной диагностики и OCR, Google Документы — для небольших неконфиденциальных файлов в браузерном процессе.
Вне зависимости от программы итоговая проверка строится одинаково: сохраните оригинал, протестируйте одну страницу, убедитесь, что текст в самом деле копируется, затем сверяйте цифры, имена и структуру. Для публикаций, презентаций и отчётов качество определяется не тем, насколько быстро символы появились в буфере обмена, а тем, сохранился ли исходный смысл.