
Изображения внутри PDF зачастую необходимы отдельно: для презентации, карточки товара, отчета, пресс-материала, сайта или повторной верстки. Главная трудность в том, что видимая картинка на странице не всегда хранится как один готовый JPEG или PNG. В документе встречаются растровые объекты, сканы целых страниц, векторные элементы, маски прозрачности и композиции из нескольких фрагментов. По этой причине сперва полезно понимать как устроен формат PDF, а затем выбирать метод извлечения под конкретный тип содержимого.
Практическое правило простое: для сохранения качества прежде всего забирайте исходный встроенный объект, а не фотографируйте страницу экранным снимком. Когда внутри документа в самом деле находится отдельная растровая картинка, специализированный редактор, Acrobat, pdfimages или библиотека PyMuPDF получают данные намного ближе к исходному файлу. Снимок экрана оставляйте для ситуаций, где необходим именно видимый фрагмент страницы или где изображение собрано из нескольких элементов.
В этом руководстве разберем шесть рабочих подходов: PDF Commander, Adobe Acrobat и Acrobat Reader, PDF Candy в браузере, утилиту pdfimages из Poppler, PyMuPDF для автоматизации и системный снимок области. Каждый метод решает свою задачу. Для бизнеса в особенности важны три критерия: сохранность качества, конфиденциальность документа и возможность воспроизвести итог на десятках файлов без ручной рутины.
Сперва определите, что именно находится внутри PDF
Перед извлечением откройте документ на странице с нужной иллюстрацией и увеличьте масштаб. Посмотрите, ведет ли себя изображение как самостоятельный объект, является ли вся страница единым сканом и сохраняются ли подписи и линии резкими при сильном увеличении. Эти наблюдения сразу отсекают неподходящие приемы. Растровая фотография состоит из пикселей; векторная схема остается геометрией; скан представляет собой один большой растр страницы; сложная инфографика часто собрана из текста, линий и нескольких картинок.
- Отдельная фотография или иллюстрация. Приоритет — сохранение встроенного объекта через PDF Commander, Acrobat, pdfimages или PyMuPDF.
- Скан страницы. Внутри обычно находится один большой растр. В этом случае извлечение даст страницу целиком, после чего нужную область кадрируют.
- Векторная схема, логотип или диаграмма. Команды, которые выгружают только растры, не обязаны находить такой объект. Для публикации в пиксельном формате страницу рендерят с нужным разрешением; для редактируемого вектора лучше искать исходный макет.
- Композиция из нескольких частей. Видимый объект на странице состоит из фрагментов, масок и подписей. Отдельное извлечение возвращает компоненты, а не готовую композицию.
- Защищенный документ. Учитывайте разрешения владельца файла. Если копирование запрещено, корректный путь — получить версию с нужными правами или исходные материалы, а не обходить ограничения.
Для производственного процесса полезно заблаговременно решить, какой итог необходим. Если картинка идет в веб-публикацию, важны точные пиксельные размеры и предсказуемый цвет. Для печати дополнительно проверяют профиль и реальное разрешение. Для архива важнее сохранить исходные байты без повторного сжатия. Для согласования порой достаточно снимка фрагмента, но такой файл уже не считается исходным изображением из PDF.
Как выбрать метод за минуту
Не существует одного инструмента, который одинаково удобен для одиночного изображения, массовой выгрузки, серверной автоматизации и сложной векторной страницы. Ниже — короткая матрица выбора без таблицы.
- Необходимо забрать одну картинку на Windows. Начните с PDF Commander: контекстное сохранение подходит для единичного объекта, а массовая команда — для всего документа.
- Необходимо выгрузить все растровые изображения в Acrobat. Применяйте экспорт изображений с параметром Export all Images.
- Нельзя устанавливать программу. PDF Candy решает задачу в браузере; для конфиденциальных документов заблаговременно проверьте внутренние правила компании по передаче файлов внешнему сервису.
- Необходима максимальная воспроизводимость локально. pdfimages удобно включать в сценарии обработки папок и серверные процедуры.
- Необходима логика отбора, переименование и дальнейшая обработка. PyMuPDF дает доступ к объектам PDF из Python и позволяет строить собственный конвейер.
- Необходим видимый фрагмент страницы, а не исходный объект. Применяйте системный снимок области, заблаговременно выставив достаточный масштаб.
Для многостраничных документов сперва имеет смысл проверить диапазон страниц. Если нужные материалы собраны в небольшом разделе, обработка только этого диапазона снижает количество мусорных файлов, ускоряет контроль и упрощает именование. Когда полезный раздел уже известен, отдельная выгрузка нужных страниц PDF перед массовым извлечением делает дальнейшую работу аккуратнее.
Метод 1. PDF Commander: сохранить одно изображение или выгрузить все
Первым рассматриваем PDF Commander: в программе есть отдельная команда массового извлечения, сохранение единичного изображения через контекстное меню и конвертация страницы в графический формат для сканов. Это три различные операции, и их важно не смешивать. Массовая выгрузка ориентирована на встроенные изображения, контекстное сохранение — на выбранный объект, а конвертация превращает страницу целиком в растр.

Как извлечь все картинки из документа
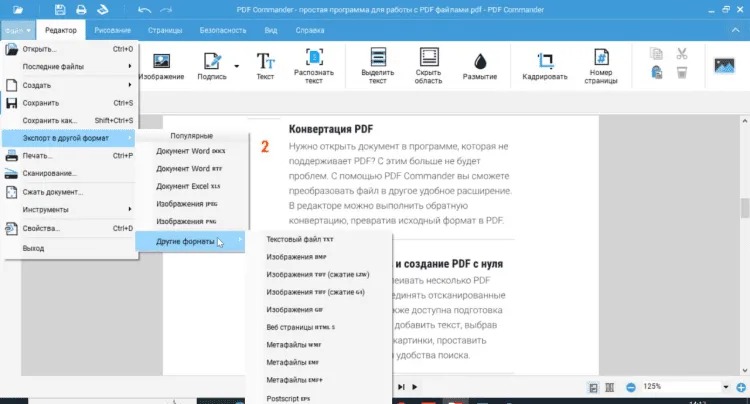
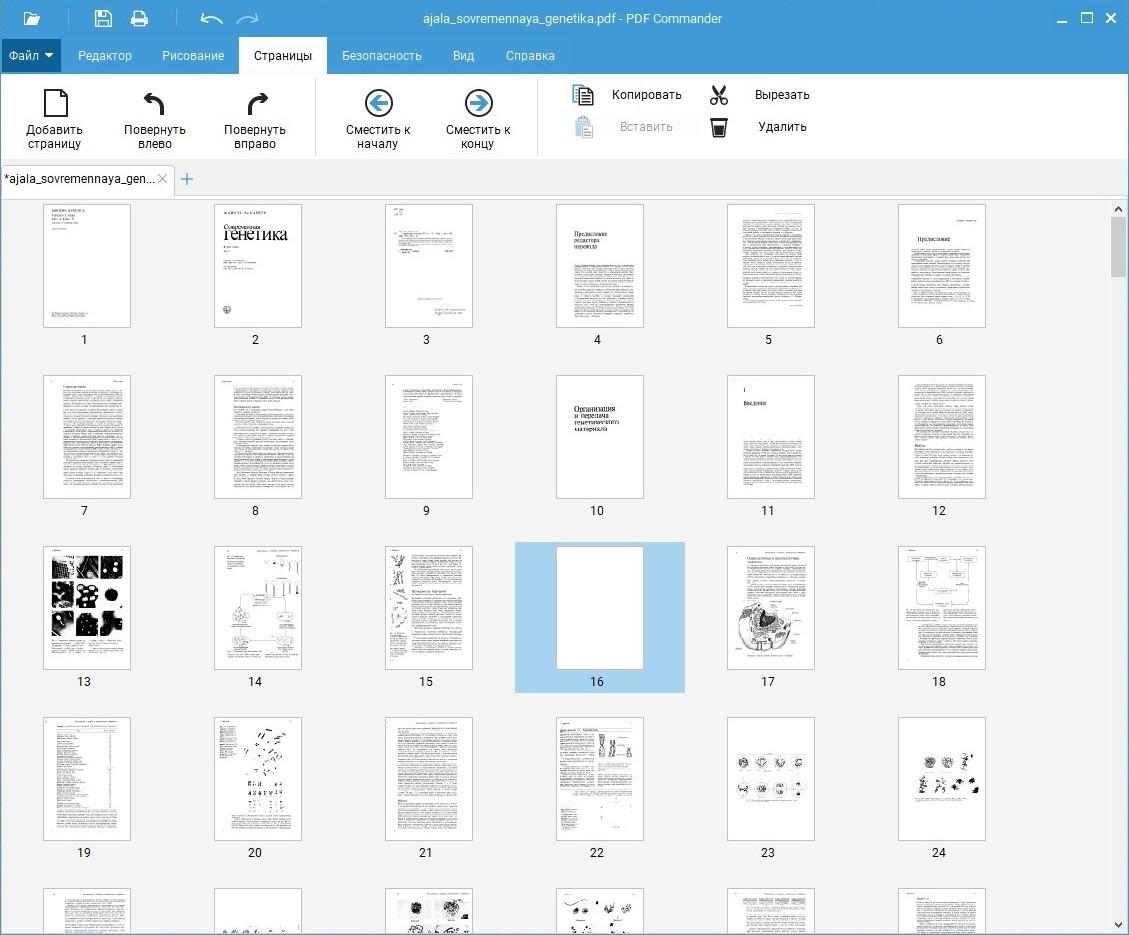
Для пакетной выгрузки откройте PDF в редакторе. Далее разверните меню «Файл», перейдите в «Инструменты» и выберите «Извлечь изображения». В окне сохранения установите параметры вывода и папку назначения. После окончания операции откройте каталог и проверьте полученный набор: число файлов, размеры, формат и отсутствие пустых изображений.
- Откройте исходный PDF и убедитесь, что нужные страницы отображаются правильно.
- Откройте «Файл» → «Инструменты» → «Извлечь изображения».
- Установите формат и каталог для итога в появившемся диалоге.
- Запустите извлечение и дождитесь окончания обработки.
- Откройте несколько файлов из начала, середины и конца набора; для небольшого документа просмотрите все изображения.
Пакетная команда в особенности полезна для каталогов, отчетов, методичек и презентационных PDF, где иллюстрации распределены по десяткам страниц. В рабочем проекте сразу создавайте отдельную папку итога с понятным наименованием. Тогда исходный PDF остается нетронутым, а дальнейшее кадрирование и цветокоррекция выполняются уже на копиях.
Как сохранить одну картинку
Когда необходима только одна иллюстрация, массовая выгрузка создает лишний набор файлов. Наведите указатель на нужное изображение, откройте контекстное меню правой кнопкой мыши и выберите «Сохранить изображение». После сохранения сопоставьте файл с объектом в документе. Особое внимание уделите пропорциям: растянутая картинка или неожиданная обрезка указывает, что на странице применялась более сложная композиция.
Единичное сохранение удобно в коммуникационной работе: к примеру, когда из готового пресс-релиза в PDF требуется получить одну фотографию спикера или одну диаграмму для внутренней презентации. При повторной публикации отдельно проверьте право на применение изображения и корректную атрибуцию. Сам факт наличия картинки в PDF не передает права на ее дальнейшее распространение.
Что делать, если PDF состоит из сканов
У скана логика другая: одна страница уже является изображением. На стартовом экране PDF Commander применяется «Конвертировать PDF», после чего выбирается графический формат PNG, GIF, JPG или BMP, папка вывода и разрешение. Такой путь не извлекает фотографию изнутри страницы, а растеризует лист целиком. Затем нужный участок кадрируют в графическом редакторе. Подробно последующую работу с визуальным объектом удобно сверять с материалом о том, как изменять картинки в PDF и после экспорта.
Для скана качество определяется исходным сканированием и настройкой вывода. Увеличение количества пикселей при конвертации не восстанавливает деталей, которых нет в исходнике. Если мелкий текст или тонкие линии уже размыты в документе, экспорт с огромным разрешением лишь создаст более тяжелый файл. Оценивайте реальную читаемость на масштабе 100% и при целевом размере публикации.
Как проверить итог в PDF Commander
- Откройте выгруженную картинку отдельно, а не только в миниатюре проводника.
- Сопоставьте соотношение сторон и видимые границы объекта с PDF.
- Проверьте пиксельные размеры; в особенности это важно для фотографий, предназначенных для сайта или рекламного макета.
- Посмотрите, сохранилась ли прозрачность у графики с вырезанным фоном.
- Для JPEG оцените мелкие контрастные детали и границы текста на предмет нового сжатия.
- Если ожидаемых объектов меньше, проверьте, не являются ли пропавшие элементы вектором, текстом или частью фонового растра.
Плюсы
- Отдельные сценарии для массового извлечения и сохранения одного объекта.
- Работа выполняется локально на компьютере.
- Для сканов доступна конвертация страницы в распространенные графические форматы.
- Подходит для ручной офисной работы без командной строки.
Минусы
- Сложная композиция страницы не превращается автоматически в один исходный файл.
- Для большого регулярного потока документов ручные действия уступают автоматизированным инструментам.
- Векторные элементы требуют отдельного подхода, когда необходим именно редактируемый вектор.
Кому подойдёт
PDF Commander удобен сотрудникам, которые работают с PDF ручным способом на рабочем компьютере: маркетологам, дизайнерам, редакторам, менеджерам, специалистам по PR и офисным документам. В особенности практичен сценарий, где из одного файла периодически требуется сохранить несколько иллюстраций, а затем продолжить редактирование или конвертацию в том же приложении.
Метод 2. Adobe Acrobat и Acrobat Reader: массовый экспорт и копирование одного объекта
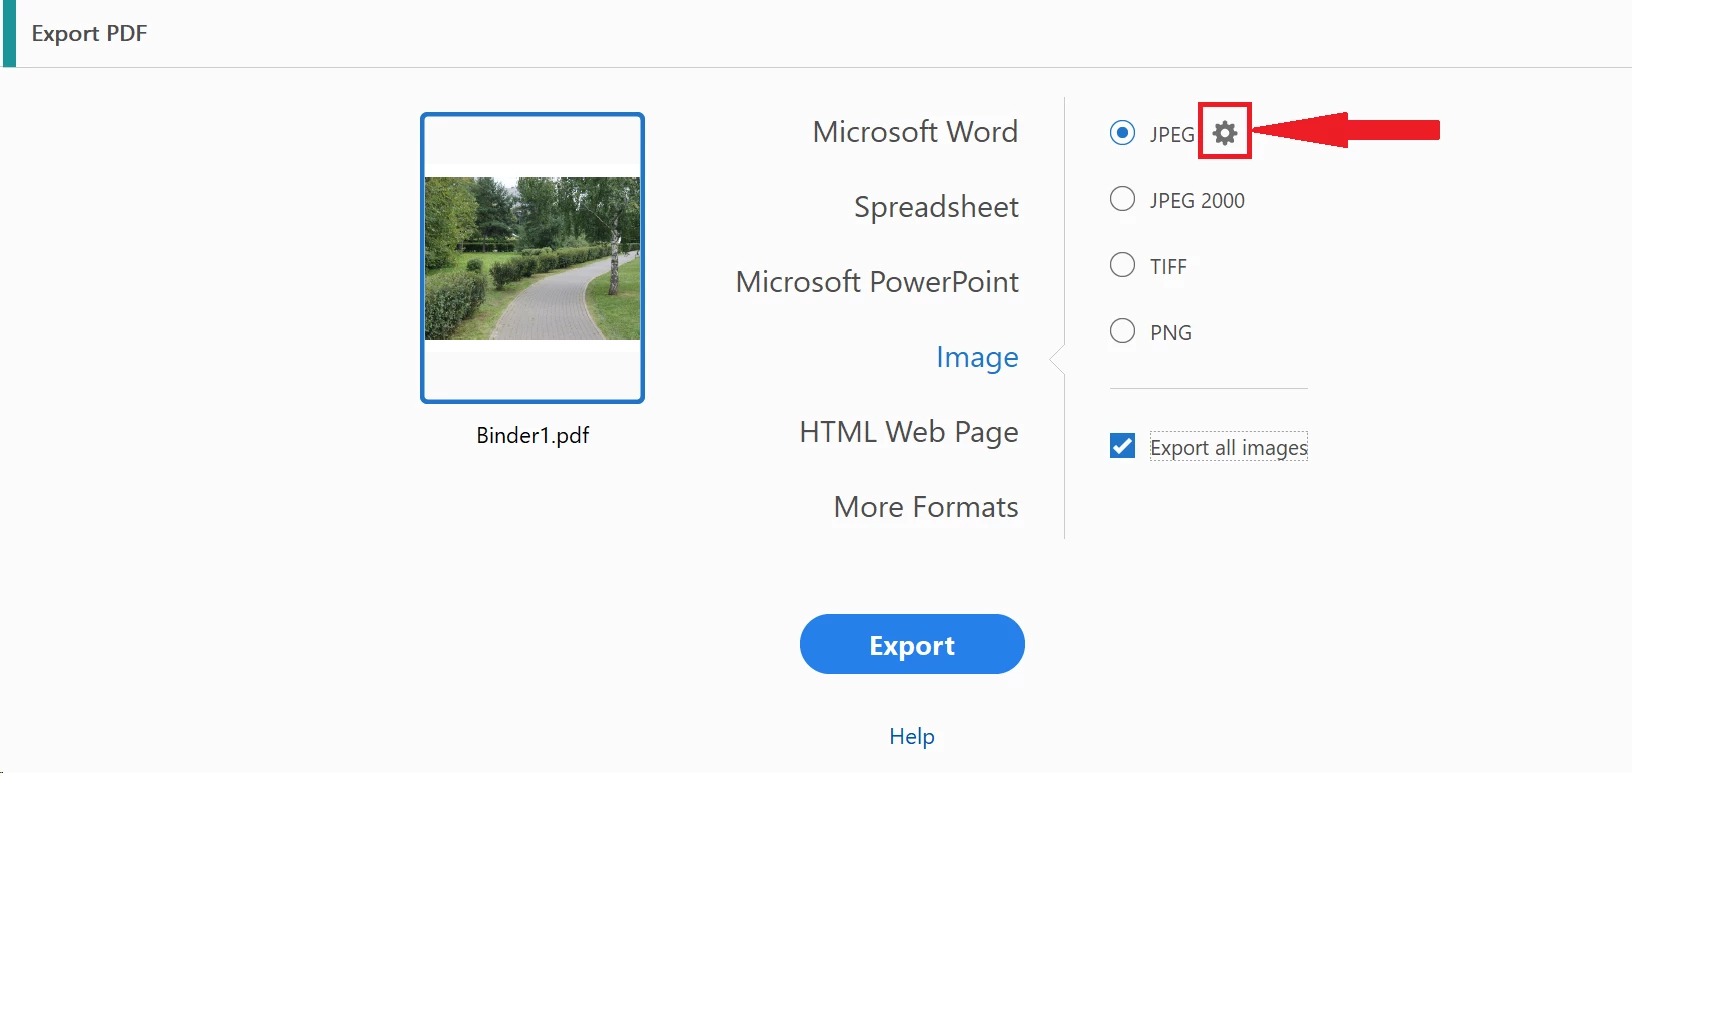
В Adobe Acrobat массовый экспорт встроенных растровых изображений отделен от конвертации страниц. В актуальном интерфейсе откройте PDF, выберите Convert либо All tools → Export a PDF, укажите графический формат и активируйте Export all Images. Важно: этот режим относится к растровым изображениям; векторные объекты в пакет не входят.
Как выгрузить все растровые изображения в Acrobat
- Откройте документ в Acrobat.
- Выберите Convert на верхней панели либо All tools → Export a PDF.
- В панели конвертации выберите формат изображения.
- Откройте параметры и включите Export all Images.
- При необходимости задайте порог Exclude images smaller than. Значение No Limit оставляет без фильтра все найденные растровые изображения.
- Запустите конвертацию и укажите папку сохранения.
Порог по размеру полезен для документов с множеством служебной графики: маленьких иконок, декоративных маркеров и фоновых элементов. Но фильтр применяйте осознанно. Небольшой по пикселям логотип или значок в отчете порой является именно тем объектом, который нужно получить. Для первой выгрузки надежнее сохранить весь набор, а затем отфильтровать лишнее уже по размеру и содержимому.
Отдельно различайте Export all Images и обычное сохранение PDF как JPEG или PNG. Без параметра массового извлечения Acrobat конвертирует страницы целиком. Это подходит для сканов, макетов и случаев, где необходим вид страницы, но не сохраняет отдельные картинки как самостоятельные исходные объекты.
Как получить одну картинку через Acrobat Reader
Для единичного объекта в Acrobat Reader применяется инструмент выделения. Откройте документ, активируйте Select Tool, выделите изображение и скопируйте его. Дальше содержимое вставляют в приложение, которое умеет сохранить графический файл. Этот путь полезен для единичной задачи, но требует добавочного сохранения из буфера обмена и по этой причине менее удобен для десятков объектов.
Копирование зависит от разрешений документа. Когда политика безопасности PDF запрещает копирование, Reader не дает выполнить операцию обычным методом. В корпоративной работе такой запрет трактуйте как ограничение владельца документа. Для повторного применения получите исходную графику или файл с нужными разрешениями.
Когда Acrobat не вернет то, что видно на странице
Главная причина — различие между растровым изображением и векторным объектом. Диаграмма, логотип или схема выглядят как картинка, но состоят из линий, заливок и текста. Массовый экспорт растров не включает такой объект. Вторая причина — композиция из нескольких слоев: фотография, маска, подпись и рамка хранятся отдельно. Третья — скан страницы, где все содержимое уже объединено в один растр.
Если необходим именно вид страницы с вектором, выполните растеризацию страницы в целевой формат и разрешение. Для PNG существует отдельный сценарий конвертации PDF в PNG. Этот прием дает предсказуемое пиксельное изображение, но его не следует описывать как сохранение исходного встроенного объекта.
Плюсы
- Есть отдельный режим Export all Images для массовой выгрузки растров.
- Настройки позволяют отсеивать мелкие изображения по размеру.
- Acrobat Reader подходит для копирования отдельного разрешенного объекта без пакетной обработки.
- Интерфейс четко разделяет экспорт объектов и конвертацию страниц.
Минусы
- Пакетный режим не выгружает векторные объекты как растровые изображения.
- В Reader массовое извлечение не заменяется удобным единичным копированием при больших объемах.
- Ограничения безопасности документа блокируют копирование там, где владелец запретил эту операцию.
Кому подойдёт
Acrobat рационален в командах, где этот редактор уже входит в стандартный набор рабочего ПО. Он удобен дизайнерам и специалистам по документообороту, которым требуется массово выгрузить растровые материалы и при необходимости отдельно обработать страницы, текст и структуру PDF.
Метод 3. PDF Candy: извлечение изображений в браузере
PDF Candy дает отдельный веб-инструмент Extract Images. Пользователь загружает PDF, сервис обрабатывает документ и после окончания предлагает сохранить изображения вместе либо по отдельности. Метод удобен на компьютере и телефоне, когда установка локального редактора не предусмотрена.
Порядок работы
- Откройте инструмент Extract Images в браузере.
- Добавьте PDF через область загрузки или перетащите файл в окно.
- Дождитесь автоматического анализа содержимого.
- Просмотрите найденные изображения.
- Сохраните весь набор либо только выбранные изображения.
- После получения итога удалите локальные промежуточные копии, которые больше не нужны рабочему процессу.
Браузерный формат в особенности удобен на чужом компьютере, в мобильной работе и для единичного несекретного документа. Он убирает этап установки и одинаково воспринимается на различных операционных системах. Вместе с этим поток данных принципиально отличается от локальных программ: исходный PDF передается внешнему сервису на обработку.
Когда онлайн-сервис не подходит
Для договоров, финансовой отчетности, документов с персональными данными, материалов до публичного запуска и клиентских файлов сперва сверяйтесь с политикой компании. Если правила запрещают внешнюю обработку, применяйте локальный PDF Commander, Acrobat, pdfimages или собственный скрипт на PyMuPDF. В таком процессе исходник остается в контролируемой среде.
Еще одно ограничение связано со структурой PDF. Веб-инструмент извлекает то, что распознает как изображения. Векторная графика, составные элементы и отдельные маски не обязаны совпасть с тем, что человек воспринимает как одну иллюстрацию. После обработки всегда просматривайте итог и сопоставляйте его с исходными страницами.
Как контролировать качество после PDF Candy
- Сопоставьте размеры файлов и пиксельные параметры с ожидаемыми объектами.
- Откройте фотографии на 100% и осмотрите тонкие линии, мелкий текст и контрастные границы.
- Проверьте прозрачность у PNG и фон вокруг логотипов.
- Убедитесь, что среди итогов нет миниатюр и служебной графики, случайно принятых за полезные изображения.
- Для пакета из десятков файлов отсортируйте итог по размеру: слишком маленькие элементы легче заметить и проверить отдельно.
Плюсы
- Работает из браузера без локальной установки.
- Подходит для компьютера и мобильного устройства.
- Позволяет получить весь набор или отдельные найденные изображения.
- Удобен для разовых несекретных документов.
Минусы
- PDF передается внешнему сервису, по этой причине конфиденциальные материалы требуют отдельного решения по политике компании.
- Автоматическое извлечение не решает задачу редактируемого вектора.
- При сложной структуре PDF итог требует ручной сверки со страницами.
Кому подойдёт
PDF Candy подходит специалистам, которым необходимо быстро получить изображения из одного обычного PDF в браузере: редакторам, маркетологам, студентам, контент-менеджерам и менеджерам проектов. Для регулярного корпоративного потока с закрытыми данными лучше выбирать локальную обработку.
Метод 4. pdfimages из Poppler: локальная массовая выгрузка из командной строки
Утилита pdfimages из Poppler ориентирована на техническую работу с растровыми объектами PDF. Она проходит по страницам и сохраняет найденные изображения по одному файлу. В отличие от снимка экрана, инструмент функционирует со встроенными объектами и умеет сохранять ряд кодированных форматов в исходном виде.
Базовые команды
Сперва полезно посмотреть список изображений без записи файлов. Команда pdfimages -list input.pdf выводит страницу, номер объекта, тип, ширину, высоту, цветовое пространство, кодирование и другие параметры. Это быстрый аудит документа перед массовой выгрузкой.
- pdfimages -list input.pdf — показать сведения о найденных изображениях без сохранения.
- pdfimages -all input.pdf img — сохранить JPEG, JPEG2000, JBIG2 и CCITT в нативном виде, CMYK — в TIFF, остальные изображения — в PNG.
- pdfimages -png input.pdf img — выводить обычные растровые изображения в PNG.
- pdfimages -f 2 -l 4 -png input.pdf img — обработать только страницы со второй по четвертую.
Аргумент image-root задает основу имени. Утилита добавляет номер и расширение автоматически. Для больших каталогов это удобно: файл сохраняет связь с порядком обнаружения, а внешний сценарий затем переименовывает итог по собственным правилам проекта.
Почему режим -all полезен для качества
Для JPEG параметр -j записывает файл, идентичный JPEG-данным, которые хранятся внутри PDF. Режим -all объединяет несколько нативных вариантов и выбирает PNG или TIFF для остальных случаев. Такой подход в особенности ценен в архивной задаче: он минимизирует лишнее перекодирование и сохраняет исходную структуру растрового объекта там, где формат PDF это допускает.
Вместе с этим «исходное изображение» не означает «исходный файл из фотокамеры». PDF уже хранит свою копию. До включения в документ картинку могли уменьшить, пересжать, обрезать или преобразовать по цвету. pdfimages возвращает то, что реально лежит в PDF, а не более ранний оригинал, которого в документе уже нет.
Маски прозрачности и повторяющиеся объекты
PDF хранит прозрачность не всегда внутри одного изображения. В выводе pdfimages отдельными объектами встречаются mask и smask. В списке они идут рядом с основным растром. По этой причине массовая папка порой содержит пару файлов, которые визуально относятся к одной картинке. Автоматический конвейер должен распознавать такие случаи, а не считать маску самостоятельной иллюстрацией для публикации.
Один и тот же логотип зачастую применяется на каждой странице отчета. PDF хранит его как ещё раз используемый объект либо как несколько ссылок на один ресурс. После выгрузки проверяйте дубликаты по контрольной сумме и размерам. Удаление повторов на этапе подготовки уменьшает ручную работу и уменьшает риск случайно загрузить одинаковые файлы в медиатеку.
Где pdfimages не поможет
Утилита извлекает растровые изображения. Векторные линии, текст и сложный вид страницы не превращаются автоматически в готовую картинку. Если маркетинговая диаграмма собрана из вектора и текста, итог массовой выгрузки окажется неполным. Для публикации вида страницы рендерите страницу в нужном размере иным инструментом; для редактирования ищите исходный дизайн-файл.
Плюсы
- Локальная обработка без передачи документа в веб-сервис.
- Удобная массовая работа и ограничение диапазона страниц.
- Режим -all сохраняет ряд встроенных форматов без лишнего перекодирования.
- Команда -list дает технические параметры изображений до выгрузки.
- Легко включается в повторяемые сценарии и серверную обработку.
Минусы
- Командная строка менее удобна для разовой ручной задачи.
- Маски прозрачности и служебные растры требуют добавочной логики.
- Векторные объекты и сложные композиции не превращаются в одну готовую картинку.
Кому подойдёт
pdfimages рационален разработчикам, техническим редакторам, специалистам по автоматизации и командам, которые систематически обрабатывают большие партии PDF. Он в особенности полезен, когда важна воспроизводимость: одна и та же команда одинаково проходит сотни файлов и формирует предсказуемый набор итогов.
Метод 5. PyMuPDF: извлечение изображений и автоматизация на Python
PyMuPDF дает программный доступ к объектам PDF. Для обычного корректного документа библиотека получает список изображений страницы через Page.get_images(), берет идентификатор xref и извлекает данные методом Document.extract_image(xref). Итог содержит байты изображения и расширение формата, которое затем применяется при записи файла.
Логика обработки без лишней сложности
Рабочий алгоритм состоит из пяти действий: открыть документ, пройти по страницам, получить список изображений, извлечь каждый новый xref и записать байты с расширением из поля ext. Важная деталь — один xref встречается на нескольких страницах, по этой причине его следует добавлять в множество уже обработанных идентификаторов. Так логотип в колонтитуле не сохраняется десятки раз.
- Откройте PDF через pymupdf.open().
- Для каждой страницы вызовите page.get_images(full=True).
- Возьмите xref из первого элемента записи изображения.
- Пропустите xref, который уже обрабатывался ранее.
- Вызовите doc.extract_image(xref), возьмите bytes из image и расширение из ext, потом запишите файл.
Преимущество такого подхода не в одной команде, а в возможности добавить правила проекта. К примеру, пропускать изображения меньше заданного размера, группировать итог по страницам, дописывать номер документа в имя, считать хеши, формировать журнал обработки и отправлять только прошедшие проверку файлы в следующую систему.
Как учитывать маски прозрачности
В PyMuPDF запись изображения содержит xref и smask. Положительный smask указывает на отдельную маску прозрачности. Документация описывает восстановление результирующего растра через Pixmap основного изображения и Pixmap маски. Это важно для логотипов, вырезанных объектов и графики с полупрозрачными краями: простая запись базового растра оставляет фон или теряет альфа-канал.
Не каждую маску следует публиковать как самостоятельное изображение. В производственном сценарии маска относится к основному объекту и применяется для реконструкции прозрачности. После сборки проверьте края на контрастном фоне: белый ореол, черные поля или рваная граница сразу показывают ошибку обработки альфа-канала.
Поврежденные PDF и обход по xref
Для поврежденных документов PyMuPDF предлагает более низкоуровневый вариант: пройти по таблице xref документа и попытаться вызвать extract_image() для каждого объекта. Пустой итог означает, что xref не является изображением. Такой подход необходим не для обычной повседневной выгрузки, а для технического восстановления, когда страницы читаются нестабильно.
Даже в этом режиме среди объектов встречаются трафаретные маски и другие служебные элементы. Автоматизация обязана фильтровать их. Любой скрипт, который просто записывает все непустые объекты и считает работу законченной, создает шум и требует добавочной ручной сортировки.
Как построить надежный конвейер
- Сохраняйте исходный PDF неизменным и пишите итог в отдельный каталог.
- Ведите множество обработанных xref, чтобы исключать повторные сохранения одного объекта.
- Проверяйте ширину и высоту до записи, если проекту не нужны иконки и миниатюры.
- Сохраняйте расширение, которое возвращает extract_image(), а не назначайте всем файлам .jpg.
- Для smask восстанавливайте прозрачность и проверяйте края итога.
- После выгрузки открывайте файлы библиотекой изображений и отбрасывайте поврежденные записи.
- Фиксируйте в журнале исходный PDF, страницу, xref, имя итога, размеры и хеш.
Плюсы
- Гибкая автоматизация отбора, именования и проверки изображений.
- Доступ к встроенным данным и расширению исходного растрового объекта.
- Есть механизмы работы с масками прозрачности и низкоуровневой таблицей xref.
- Подходит для интеграции с внутренними системами обработки документов.
Минусы
- Требуется Python и поддержка собственного кода.
- Неправильная обработка smask приводит к потере прозрачности или артефактам.
- Сложные векторные страницы требуют отдельного рендеринга, а не только extract_image().
Кому подойдёт
PyMuPDF необходим там, где ручная выгрузка уже не масштабируется: медиабазам, издательским системам, архивам, агентствам с большим потоком клиентских PDF и внутренним сервисам подготовки контента. Он дает основу для контролируемого процесса, где каждый файл проходит одинаковые проверки и получает предсказуемое имя.
Метод 6. Системный снимок области: резервный вариант для видимого фрагмента страницы
Системный снимок экрана не извлекает встроенный файл, а фиксирует пиксели, которые уже выведены на дисплей. По этой причине этот подход ставим последним. Он полезен для составной схемы, небольшого фрагмента скана, векторной композиции или разовой иллюстрации, когда необходим именно вид страницы. Применяйте его лишь для материалов, на которые у вас есть право доступа и повторного применения.
Windows: Snipping Tool
В Windows сочетание Windows + Shift + S открывает панель захвата. Для иллюстрации из PDF обычно выбирают прямоугольную область. Перед снимком увеличьте документ так, чтобы нужный объект занимал заметную часть экрана и полностью помещался в выбранной зоне. После захвата сохраните итог в графический файл и обрежьте лишние поля без повторного увеличения.
Качество снимка ограничено тем, что реально отрисовано на экране. Если картинка в PDF содержит 4000 пикселей по ширине, а на дисплее видна в области 1200 пикселей, снимок не вернет потерянные 2800 пикселей. Именно по этой причине системный захват остается запасным приемом, а не заменой извлечению объекта.
macOS: снимок выбранной области
В macOS для выбранной области применяется Shift + Command + 4. Курсор превращается в перекрестие, после чего область задается перетаскиванием. Для полного контроля интерфейс Screenshot открывается через Shift + Command + 5. Как и в Windows, итог зависит от размера отображения на экране, по этой причине сперва установите рабочий масштаб PDF.
Когда снимок оправдан
- Необходима составная инфографика вместе с подписями и линиями.
- PDF содержит скан, а требуется небольшой фрагмент страницы для внутренней презентации.
- Векторный объект необходим только как небольшой растр для веб-черновика.
- Необходимо быстро зафиксировать видимую область для комментария или согласования, а не получить архивный оригинал.
Не применяйте снимок для обхода запрета владельца на копирование. Если документ ограничивает повторное применение, правильный процесс начинается с получения разрешения или исходного материала. Техническая доступность отображения на экране не отменяет условия применения содержимого.
Плюсы
- Встроен в операционную систему и не требует отдельного PDF-инструмента.
- Сохраняет видимый итог сложной композиции целиком.
- Удобен для небольшого фрагмента скана и внутреннего согласования.
Минусы
- Не сохраняет исходные байты изображения из PDF.
- Разрешение ограничено отображением на экране и выбранным масштабом.
- Цветовой профиль, прозрачность и часть метаданных исходного объекта теряются.
- Не подходит для массовой выгрузки большого числа изображений.
Кому подойдёт
Снимок области подходит для разовой рабочей задачи, где важен вид фрагмента страницы, а не техническая идентичность исходному растровому объекту. Для публикации в крупном размере, печати и медиархива сперва применяйте методы извлечения встроенных данных.
Как не потерять качество при извлечении
Качество определяется не наименованием кнопки, а тем, что происходит с данными. Есть три принципиально различные операции: извлечение встроенного изображения, рендеринг страницы и снимок экрана. Первая берет объект из PDF, вторая заново вычисляет пиксельное представление страницы, третья фиксирует уже отрисованные пиксели дисплея. Чем дальше процесс уходит от исходного объекта, тем больше параметров приходится задавать заново.
Сохраняйте встроенный растр без повторного сжатия
Когда внутри PDF находится JPEG и инструмент умеет сохранить нативные JPEG-данные, это предпочтительный архивный вариант. Повторное сохранение JPEG через графический редактор запускает новое сжатие с потерями. На фотографиях деградация сперва заметна вокруг мелких контрастных деталей, текста и тонких границ. Несколько циклов пересохранения усиливают артефакты.
Для PNG ситуация другая: формат применяет сжатие без потерь и хорошо подходит для интерфейсов, схем, скриншотов и графики с прозрачностью. Но перевод JPEG-фотографии в PNG не восстанавливает уже потерянные детали; файл просто становится тяжелее. Формат выбирайте по типу изображения и дальнейшему применению, а не по представлению, что PNG автоматически повышает качество.
Различайте пиксельные размеры и DPI
Для веба основная характеристика — ширина и высота в пикселях. Картинка 2000 × 1200 пикселей содержит определенное количество деталей вне зависимости от числа DPI, записанного в метаданных. Для печати DPI связывает пиксельные размеры с физическим размером отпечатка. Изменение одной служебной цифры DPI без добавления реальных деталей не делает изображение резче.
Если исходный объект в PDF невелик, искусственное увеличение после выгрузки лишь интерполирует существующие пиксели. Для крупного баннера, печатного буклета или презентации на большом экране лучше отыскать исходную графику у автора материала. PDF зачастую содержит уже оптимизированную копию, специально уменьшенную для документа.
Следите за цветом и профилями
Деловые PDF встречаются как в RGB, так и в CMYK, а отдельные изображения содержат ICC-профили. При переводе в неподходящий формат или просмотре в приложении без корректного управления цветом насыщенность и оттенки меняются. Это в особенности заметно на фирменных цветах, фотографиях продукта и градиентах.
Для веб-публикации обычно необходим предсказуемый RGB-процесс. Для печати сохраняйте информацию о цветовом пространстве и передавайте файл дизайнеру без лишних преобразований. В pdfimages команда -list показывает цветовое пространство встроенного объекта, что помогает заблаговременно заметить CMYK и ICC Based.
Не путайте обрезку отображения с реальными пикселями
PDF умеет показывать только часть большого изображения через маску или область отсечения. При извлечении исходного объекта наружу порой появляется больше содержимого, чем видно на странице. Это не ошибка: документ просто применял фрагмент растра. Перед публикацией сопоставьте границы с макетом и кадрируйте копию итога, сохранив отдельный необрезанный оригинал.
Векторная графика, диаграммы и сложные композиции
Логотип, схема или диаграмма часто выглядят как единая картинка, но внутри PDF состоят из векторных путей, текста и нескольких объектов. Acrobat прямо отделяет такой случай от экспорта растров. pdfimages и extract_image() тоже ориентированы на изображения, а не на всю графическую модель страницы.
Для публикации в растровом формате надежный путь — рендерить нужную страницу или выбранную область с разрешением, соответствующим конечному размеру. Для редактирования элементов лучше искать исходный SVG, AI, EPS, презентацию или макет, из которого был создан PDF. Растеризация превращает вектор в пиксели и после этого точное изменение линий, шрифтов и отдельных фигур усложняется.
Диаграммы с текстовыми подписями требуют особой осторожности. Если вы извлекли только фон или рисунок без подписей, смысл меняется. В маркетинговом отчете такая ошибка опаснее небольшой потери резкости: читатель получает неполные данные. Сверяйте визуальный итог со страницей и сохраняйте подписи вместе с графикой там, где они являются частью сообщения.
Сканы: почему извлекается страница целиком
Сканирование обычно создает один растр на страницу, поверх которого порой добавляется невидимый текстовый слой после оптического распознавания. В такой структуре фотография внутри страницы не является отдельным объектом. Инструмент честно возвращает полный скан, потому что другого растра в PDF нет.
Дальше задача превращается в кадрирование. Сперва сохраните страницу в достаточном размере, затем выделите нужную область. Не делайте цепочку из нескольких пересохранений JPEG. Для документов с большим количеством фотографий сперва определите одинаковые правила кадрирования, чтобы серия выглядела единообразно.
Для старых сканов вдобавок проверьте перекос, фон бумаги и резкость. Эти дефекты уже встроены в растр. Извлечение их не исправляет. Коррекцию выполняйте на копии после сохранения, а исходный файл держите отдельно — это дает возможность вернуться к первоначальному состоянию при спорной обработке.
Как проверить итог: технический контроль перед применением
Извлечение заканчивается не в момент появления файлов в папке, а после проверки. Для одного изображения контроль занимает минуту; для сотен файлов его лучше автоматизировать. Ошибки чаще всего выглядят как отсутствующая прозрачность, слишком маленькая миниатюра, повторяющийся логотип, маска вместо картинки, неожиданное цветовое пространство или файл, который не открывается.
- Открываемость. Каждый файл должен правильно читаться стандартным просмотрщиком или библиотекой изображений.
- Размер. Зафиксируйте ширину и высоту в пикселях. Нулевые и подозрительно маленькие значения сразу отправляйте на проверку.
- Формат. Расширение должно соответствовать реальному содержимому файла.
- Пропорции. Сопоставьте соотношение сторон с объектом на странице.
- Прозрачность. Логотипы и вырезанные объекты проверяйте на светлом и темном фоне.
- Цвет. Сопоставьте фирменные оттенки и фотографии с PDF в приложении с корректным управлением цветом.
- Количество. Убедитесь, что выгружены все нужные иллюстрации и нет потери целых страниц или разделов.
- Дубликаты. Вычисляйте хеши для массового пакета и удаляйте повторяющиеся копии.
- Смысловая целостность. Проверьте, не потерялись ли подписи, легенда диаграммы или важная часть составной композиции.
- Права. До повторной публикации зафиксируйте автора, источник и основание применения.
В редакционном процессе полезно хранить рядом с картинкой простой журнал: имя PDF, номер страницы, метод получения, дата обработки, размеры, формат и назначение. Такая запись облегчает пересборку материала и помогает разобраться, откуда взялся конкретный файл через несколько месяцев.
Рабочие сценарии для маркетинга, PR, дизайна и контента
Отчет или исследование: взять диаграммы для презентации
Сперва определите, являются ли диаграммы отдельными растрами. Если да, массовый экспорт через Acrobat, pdfimages или PyMuPDF быстро собирает набор. Если диаграмма состоит из вектора и текста, рендерите страницу или нужную область. После получения обязательно сохраните подпись с наименованием показателя, периодом и единицами измерения: графика без контекста легко превращается в неверную интерпретацию.
Для внешней презентации отдельно проверьте разрешение. Диаграмма из отчета, которая хорошо выглядит на странице A4, на большом экране порой становится размытой из-за низкого исходного размера. В этом случае лучше применять векторный исходник или пересобрать график по разрешенным данным, а не растягивать маленький растр.
Каталог продукта: получить фотографии для сайта или карточек
В каталоге продуктовые фотографии часто лежат как самостоятельные JPEG. Тут выигрывают методы, которые сохраняют встроенные объекты. После выгрузки отсортируйте файлы по размеру, отделите иконки и декоративные элементы, потом сопоставьте фотографии с артикулами или страницами. Для большого каталога PyMuPDF удобен тем, что в имя файла сразу добавляется номер страницы.
Не считайте фотографию из каталога готовой карточкой товара. В PDF вокруг нее присутствуют текст, фон, тени и плашки, а исходный растр хранится отдельно. Для сайта чаще полезнее чистая фотография; для рекламного макета порой требуется вид страницы целиком. Формулируйте итог до начала выгрузки.
Пресс-кит: собрать изображения спикеров и логотипы
Фотографии спикеров обычно извлекаются как растры. Логотипы чаще оказываются векторными и не появляются в списке массового экспорта изображений. По этой причине пресс-кит практически всегда требует двух веток: фотографии забираются как встроенные файлы, а фирменная графика берется из исходного бренд-пакета или рендерится лишь для временного черновика.
Перед публикацией проверьте ограничения пресс-материалов: допустимое кадрирование, обязательную подпись, запрет на изменение фирменного знака. Технически извлеченный файл не отменяет редакционные и лицензионные условия.
Архив презентаций: автоматизированно собрать медиабазу
Когда в архиве сотни PDF-презентаций, ручной экспорт перестает быть управляемым. Тут подходит Poppler или PyMuPDF. Процесс строится пакетно: каждый документ получает собственную папку, изображения извлекаются, дубликаты отбрасываются, слишком маленькие элементы маркируются, а метаданные записываются в журнал.
Критерий успеха такого проекта — не число файлов, а доля изображений, которые можно отыскать и связать с исходным документом. Хорошая схема именования включает идентификатор PDF, страницу и порядковый номер объекта. Хеш помогает обнаруживать одинаковые логотипы и фоны, повторяющиеся во многих презентациях.
Социальные публикации и быстрые согласования
Для внутреннего согласования часто необходим небольшой фрагмент страницы с подписью. Тут снимок области быстрее сложного извлечения. Но перед финальной публикацией вернитесь к исходному объекту или рендерингу достаточного размера. Черновой снимок удобен для коммуникации, а не для мастер-файла.
Если визуал пойдет в несколько каналов, сохраните одну качественную мастер-копию и уже из нее делайте нужные размеры. Повторное извлечение и кадрирование под каждый формат увеличивает риск расхождения версий.
Сложные случаи и разбор причин
Изображение разбито на полосы или фрагменты
Некоторые PDF хранят большую картинку несколькими плитками. Такое встречается после оптимизации, экспорта из отдельных систем верстки или в больших сканах. Инструмент извлечения честно возвращает отдельные части. Если необходим единый вид страницы, удобнее выполнить рендеринг страницы; автоматическая склейка фрагментов требует знания их координат и трансформаций.
Вместо картинки сохранилась черно-белая маска
Это признак отдельного объекта прозрачности. В pdfimages маска отмечается как mask или smask. В PyMuPDF поле smask связывает основной растр с маской. Для обычной публикации маску не применяют самостоятельно — ее объединяют с базовым изображением, чтобы восстановить альфа-канал.
Один и тот же логотип выгружается много раз
Повтор связан с применением одного ресурса на нескольких страницах либо с дублированными объектами в самом PDF. Для ручной обработки оставьте одну нужную копию. Для автоматизации вычисляйте хеш содержимого и сохраняйте связь с номерами страниц отдельно от самого файла.
На странице видна схема, а инструмент ничего не отыскивает
Скорее всего, схема векторная или собрана из текста и линий. Массовое извлечение растров тут не применимо. Для пиксельной публикации рендерите страницу в требуемом размере. Для редактирования ищите исходный макет или векторный источник.
Полученный файл меньше видимого объекта
PDF умеет масштабировать маленький растр на странице. При извлечении возвращается фактическая ширина и высота встроенного изображения, а не размер его отображения. Если объект был увеличен при верстке, отдельный файл выглядит меньше и на 100% показывает реальный уровень детализации.
Полученный файл больше видимой области
Причина обычно в отсечении. В PDF находится полный растр, но страница показывает только его часть. Извлечение возвращает весь объект. Это полезно для архива, однако перед публикацией требуется воспроизвести нужное кадрирование на копии.
Документ ограничивает копирование
Не стройте процесс на техническом обходе. Получите исходный файл с нужными разрешениями либо отдельные изображения у владельца. В деловой среде это одновременно снижает юридический риск и повышает качество: исходник обычно имеет большее разрешение, чем версия, встроенная в PDF.
PDF поврежден или открывается с ошибками
Сперва сохраните резервную копию и попробуйте открыть документ другим совместимым просмотрщиком. Для технической диагностики PyMuPDF допускает обход xref, а Poppler возвращает коды ошибок. Но не перезаписывайте единственный исходник в ходе восстановления. После извлечения обязательно проверяйте каждый файл, потому что повреждение структуры PDF приводит к неполным объектам.
Типичные ошибки при извлечении картинок
- Снимать экран, когда доступно оригинальное изображение. Так теряются пиксели, профиль и прозрачность.
- Сохранять каждую страницу как JPG и считать это извлечением объектов. Конвертация страницы создает новый растр всего листа.
- Пересохранять JPEG несколько раз. Каждый новый цикл с потерями ухудшает мелкие детали.
- Назначать всем файлам одно расширение. Автоматизация должна учитывать реальный формат данных.
- Игнорировать smask. У прозрачной графики появляются фон, ореол или рваные края.
- Не фильтровать дубликаты. Повторяющийся логотип раздувает медиабазу и усложняет поиск.
- Отбрасывать маленькие изображения автоматически. Среди них встречаются важные логотипы, значки и миниатюры.
- Считать любое видимое изображение растровым. Вектор и текст не обязаны появляться в выгрузке растров.
- Загружать закрытый PDF в веб-сервис без проверки правил. Конфиденциальные документы требуют согласованного канала обработки.
- Не сопоставлять итог с исходной страницей. Потеря подписи или легенды меняет смысл диаграммы.
- Растягивать маленький файл после экспорта. Интерполяция не восстанавливает отсутствующие детали.
- Забывать о правах. Техническое извлечение не дает автоматического разрешения на публикацию.
Чек-лист перед публикацией извлеченного изображения
- Проверено основание для повторного применения изображения.
- Зафиксированы автор или правообладатель и источник.
- Файл открывается без ошибок и имеет ненулевой размер.
- Пиксельные размеры подходят для целевого канала.
- Соотношение сторон соответствует задумке и не искажено.
- Нет нового размытия, ступенчатых линий и заметных артефактов сжатия.
- Прозрачность восстановлена правильно, если она была необходима.
- Фирменные цвета и оттенки не изменились после преобразования.
- Кадрирование не убирает смысловую часть изображения.
- Диаграмма содержит нужные подписи, легенду и единицы измерения.
- В кадре нет служебных данных, которые не должны выходить за пределы команды.
- Для серии применены единые правила именования и размеров.
- Сохранена мастер-копия до дальнейшей оптимизации под сайт или презентацию.
- Alt-текст описывает содержимое, а не повторяет имя файла.
Метрики для процесса: как понять, что извлечение настроено хорошо
В единичной задаче достаточно визуального контроля. В регулярном потоке полезны измеримые показатели. Они показывают, где теряется время и почему сотрудники возвращаются к ручным снимкам экрана.
- Доля пригодных файлов. Количество изображений, прошедших проверку, делится на общее число выгруженных объектов.
- Доля ручной доработки. Сколько файлов пришлось дополнительно кадрировать, собирать из маски или восстанавливать иным методом.
- Количество дубликатов. Высокое значение указывает на необходимость хеширования и фильтра повторов.
- Время на один PDF. Для пакета сопоставляйте ручной редактор и автоматический конвейер на одинаковом наборе документов.
- Доля пропущенных визуалов. После сверки с PDF фиксируйте, сколько нужных объектов не попало в выгрузку из-за векторной или составной структуры.
- Число возвратов из дизайна. Причины вроде низкого разрешения, отсутствующей прозрачности и неправильного цвета показывают качество технического контроля.
Эти метрики не требуют сложной аналитической платформы. Для начала хватает журнала обработки и небольшой выборки документов. Когда видно, что большая часть времени уходит на маски и дубликаты, имеет смысл доработать автоматизацию. Если проблемой становятся векторные диаграммы, процесс надо разделить на растровую выгрузку и рендеринг страниц.
Как организовать папки и имена файлов
Хаотичные имена вроде image-001.jpg быстро перестают работать, когда источников много. Применяйте схему, которая связывает картинку с документом и страницей. К примеру: код_документа-p012-img03.jpg. Для PyMuPDF вдобавок храните xref в служебном журнале, но в публичном имени он обычно не нужен.
Внутри проекта удобно разделить каталоги на исходные PDF, необработанную выгрузку, проверенные мастер-файлы и версии для публикации. Мастер-файл не должен заменяться оптимизированной копией для сайта. Такое разделение позволяет изменить размер или формат позднее без нового извлечения из PDF.
- source-pdf/ — неизменные исходные документы.
- extracted-raw/ — итоги PDF Commander, Acrobat, pdfimages или PyMuPDF без косметической правки.
- masters/ — проверенные изображения после сборки масок и нужного кадрирования.
- publish/ — размеры и форматы под конкретные каналы.
- log/ — журнал страниц, имен, размеров, хешей и прав применения.
Частые вопросы
Почему сохраненная картинка выглядит хуже, чем ожидалось?
PDF хранит ту версию изображения, которую в него поместили при создании. Если перед версткой фотографию уменьшили или пересжали, извлечение вернет уже оптимизированный вариант. Снимок экрана снижает доступную детализацию еще сильнее, потому что фиксирует только пиксели дисплея.
Как получить изображение без повторного сжатия?
Применяйте извлечение встроенного объекта. В pdfimages режим -all сохраняет ряд нативных форматов, а для JPEG параметр -j записывает данные, идентичные JPEG внутри PDF. В PyMuPDF Document.extract_image() возвращает байты объекта и его расширение.
Почему pdfimages не отыскивает видимый логотип или диаграмму?
Объект на странице состоит из вектора, текста или нескольких элементов. pdfimages предназначен для растровых изображений. Для пиксельной версии такого визуала рендерят страницу или область; для редактирования ищут исходный векторный макет.
Можно ли получить картинки из PDF на телефоне?
Для обычного несекретного файла подходит браузерный инструмент PDF Candy. Когда документ содержит закрытые данные, применяйте одобренный компанией метод обработки и не передавайте файл внешнему сервису без согласования.
Как сохранить прозрачность?
Сперва применяйте метод, который извлекает исходный растр. Если PDF хранит прозрачность отдельной маской, основной объект и smask требуется объединить. В PyMuPDF для этого применяется Pixmap базового изображения и Pixmap маски.
Что делать, если копирование ограничено?
Не обходите установленное владельцем ограничение. Получите исходную графику или PDF с нужными разрешениями. Это корректнее и обычно дает более качественный мастер-файл, чем любые обходные приемы.
Почему после массовой выгрузки появляется много маленьких файлов?
PDF содержит иконки, маркеры, фоны и служебные растры. Перед удалением отсортируйте изображения по размерам и просмотрите пограничные значения: важный логотип тоже бывает небольшим.
Чем извлечение отличается от конвертации страницы в PNG?
Извлечение сохраняет отдельные растровые объекты, которые уже находятся внутри PDF. Конвертация заново рендерит всю страницу вместе с текстом, вектором и оформлением в один пиксельный файл. Это различные итоги и различные задачи.
Итоговый алгоритм
Для большинства рабочих задач достаточно последовательности из семи шагов. Она сохраняет качество, уменьшает количество лишних файлов и помогает воспроизвести итог позднее.
- Определите, необходим отдельный встроенный объект или вид страницы целиком.
- Проверьте тип содержимого: растр, скан, вектор или составная композиция.
- Для ручной локальной работы начните с PDF Commander; для Acrobat-процесса применяйте Export all Images; без установки — PDF Candy; для пакетной технической работы — pdfimages или PyMuPDF.
- Сохраняйте итог в отдельную папку и не меняйте исходный PDF.
- Проверьте размеры, формат, прозрачность, цвет, дубликаты и смысловую целостность.
- Зафиксируйте источник и право повторного применения.
- Создавайте версии под сайт, презентацию или печать уже из проверенной мастер-копии.
Главный принцип: сперва извлекайте данные в наиболее исходном доступном виде и только потом оптимизируйте под канал. PDF часто является последним сохранившимся контейнером с качественной графикой, по этой причине лишняя конвертация на первом шаге необратимо ухудшает материал. Для редких сложных случаев — вектора, масок, сканов и составных объектов — заблаговременно выбирайте отдельную ветку процесса вместо попытки решить все одним приемом.