
Синтез речи, или Text-to-Speech (TTS), превращает письменный текст в звуковой сигнал, который воспринимается как человеческая речь. Для бизнеса это не только голосовой ответ робота в телефонии: та же технология озвучивает интерфейсы, обучающие материалы, видео, презентации и длинные тексты, а также помогает делать цифровой контент доступнее. В этом материале разберём устройство TTS, практический цикл от сценария до готового файла, критерии выбора инструмента и методы контроля качества.
Что такое синтез речи простыми словами
В базовом понимании TTS получает последовательность символов и возвращает аудио. Между этими двумя точками находится многоступенчатая обработка: система должна понять, как произнести числа и сокращения, определить чтение спорных слов, расставить ударения и паузы, выбрать интонационный рисунок, а затем сформировать акустическое представление и звуковую волну. По этой причине хороший итог зависит не только от тембра голоса. Не менее важны подготовка текста, фонетические правила, просодия и итоговая проверка.
На Xeon Live есть отдельный разбор принципов синтеза речи и вариантов озвучки материалов. Тут акцент смещён на рабочий процесс для контента и бизнеса: что происходит внутри технологии, где появляются ошибки и как построить контроль так, чтобы синтезированная дорожка не требовала бесконечной ручной переделки.
TTS не равен распознаванию речи. Speech-to-Text (STT) решает обратную задачу: принимает аудио и превращает его в текст. Голосовое преобразование тоже является отдельной технологией: оно меняет характеристики уже существующей речи. Клонирование голоса относится к ещё более узкому классу задач и требует отдельного внимания к правам на голос, согласию диктора и правилам применения. В обычном синтезе достаточно выбрать доступный голос и подготовить текст.
Для редакционной и маркетинговой работы полезно мыслить не категориями «живой голос против синтетического», а категориями задачи. Короткое системное уведомление, массово обновляемая карточка продукта, обучающий экран и эмоциональный рекламный видеоролик требуют различной степени выразительности и различного контроля. TTS хорошо масштабирует повторяемые форматы, но не отменяет режиссуру текста и прослушивание итога.
Как система TTS превращает текст в звук
Архитектуры современных движков различаются, однако рабочую логику удобно представить как цепочку из нескольких стадий. Сперва текст приводится к форме, удобной для чтения. Затем система определяет произношение и просодию. После этого акустическая модель формирует промежуточное представление речи либо сразу звуковые параметры, а вокодер или другой генератор сигнала превращает их в аудиоволну. В некоторых новых моделях границы между стадиями отчасти объединены, но задачи нормализации, произношения и построения звука никуда не исчезают.
1. Нормализация текста
На этой стадии символы превращаются в то, что должно прозвучать. Число «2026» в зависимости от контекста читается как год, количество или часть идентификатора. Дефис может быть знаком соединения слов, диапазоном или частью обозначения. Сокращение способно читаться по буквам, как отдельное слово или в развёрнутой форме. Даты, единицы измерения, денежные обозначения и аббревиатуры требуют контекстного решения. Чем больше в исходнике служебной записи, тем выше риск, что звучание окажется формально допустимым, но неестественным.
Практический вывод прост: текст для озвучки лучше готовить как самостоятельный сценарий, а не копировать без правок из статьи или презентации. Длинные перечисления сокращают, символы раскрывают словами, спорные сокращения приводят к однозначной форме. Это не «упрощение для робота», а редактура под слуховое восприятие: читатель глазами легко возвращается к предыдущей строке, слушатель чаще воспринимает фразу только один раз.
2. Произношение, фонемы и ударения
После нормализации система определяет, какие звуки должны прозвучать. Для русского языка в особенности заметны ошибки в ударениях и омографах: одинаково написанные слова читаются по-разному в различных контекстах. Имена, фамилии, топонимы, наименования брендов, англоязычные термины и профессиональные сокращения тоже часто выходят за рамки базового словаря. По этой причине зрелый рабочий процесс обязательно содержит словарь произношений или хотя бы список проблемных единиц, который проверяется перед публикацией.
Стандарт Speech Synthesis Markup Language (SSML) описывает разметку для управления синтезом речи. Он позволяет устанавливать параметры произношения и другие характеристики, но конкретный движок поддерживает собственное подмножество элементов и атрибутов. Перенос готовой разметки между различными платформами без проверки приводит к ошибкам, по этой причине сценарий и разметку необходимо считать двумя различными слоями проекта.
3. Просодия: паузы, темп, высота тона и смысловые акценты
Просодия делает последовательность звуков фразой. Для слушателя важны не только правильные фонемы, но и место пауз, продолжительность фрагментов, интонация вопроса, завершённость утверждения, смысловое выделение слов. Знаки препинания помогают системе, однако одной пунктуации недостаточно: авторский текст зачастую содержит длинные предложения, скобки, тире и уточнения, которые хорошо читаются глазами, но перегружают слух.
В практической озвучке полезно разделять три уровня управления. Первый — редактура самого сценария: короткие синтаксические конструкции и ясный порядок мысли. Второй — средства движка: темп, голос, роль, паузы и доступная речевая разметка. Третий — монтаж готового аудио: удаление лишних пауз, выравнивание стыков, громкости и длины. Попытка компенсировать плохой сценарий только эффектами после синтеза практически всегда увеличивает время работы.
4. Акустическая модель и вокодер
Нейросетевые системы научились строить речь без ручной склейки большого набора заблаговременно записанных фрагментов. Один из известных этапов развития — WaveNet, опубликованный DeepMind в 2016 году: модель генерировала аудиосигнал на уровне отдельных отсчётов. В 2017 году исследователи представили Tacotron 2: сеть преобразовывала текст в мел-спектрограмму, а модифицированный WaveNet выполнял роль вокодера и создавал временной сигнал. Эти работы не описывают все современные TTS-системы, но хорошо показывают переход от жёстко заданных речевых блоков к обучаемой генерации акустики.
Сегодня конкретная внутренняя схема зависит от движка. Для редактора контента важнее понимать следствие: ошибка в финальном аудио не всегда исправляется одной настройкой «естественность». Неправильное произношение лечится на уровне текста или фонетики, неудачная пауза — редактурой либо разметкой, а артефакт сигнала — повторным синтезом или обработкой. Диагностика по слоям экономит больше времени, чем перебор голосов без причины.
Как менялись методы синтеза речи
История синтеза речи показывает, почему старые и новые голоса звучат по-разному. Ранние устройства моделировали работу речевого тракта или параметры акустического сигнала. В XX веке исследовались формантные методы и вокодеры; позднее широкое распространение получил конкатенативный синтез, в котором система собирала фразу из записанных единиц речи. На подготовленном материале такой подход способен звучать убедительно, но новые сочетания и стыки раскрывают ограниченность базы.
Конкатенативные системы развивались в сторону больших корпусов и алгоритмов выбора наиболее подходящих единиц. Система учитывала фонетическое окружение и искала фрагменты, которые лучше согласуются друг с другом. Цена качества — объём речевой базы, сложность её записи и ограниченная гибкость тембра. Изменить голос радикально без нового материала затруднительно, потому что сам голос буквально заложен в записи.
Статистический параметрический синтез отделил голос от набора конкретных фрагментов: модель предсказывала параметры речи, которые затем превращались в звук. Такой подход дал больше управляемости и компактности, но ранние реализации часто воспринимались менее естественно. Нейросетевые модели значительно улучшили акустическое моделирование и генерацию сигнала, а современные системы дополнительно применяют контекстные представления текста, более выразительную просодию и потоковую генерацию.
Для бизнеса из этой истории следует полезное правило: термин «нейросетевой голос» сам по себе не является гарантией нужного итога. В проекте оценивают конкретный язык, конкретный голос, устойчивость произношения на предметной лексике, задержку, доступные форматы, средства интеграции и качество на целевом канале. На короткой рекламной фразе и на длинной инструкции одна и та же система способна проявить различные сильные и слабые стороны.
Где синтез речи полезен в маркетинге, контенте и бизнесе
Озвучка видео, презентаций и обучающих материалов
В контентном производстве TTS в особенности ценен там, где сценарий систематически меняется. Карточки товара, обновляемые инструкции, внутренние курсы, экранные демонстрации и серии коротких видеороликов требуют много однотипной озвучки. Синтез сокращает технический цикл между правкой текста и новой звуковой версией: редактор меняет сценарий, ещё раз создаёт проблемный фрагмент и заменяет только нужный участок. Для полноценной работы с видеороликом пригодится отдельная инструкция Xeon Live о том, как подготовить озвучку для видео.
Сложность появляется на финальной сборке. Даже качественный TTS-файл должен совпасть с хронометражем кадра, не перекрывать важные звуки, выдерживать одинаковый уровень между сценами и сохранять естественные паузы. В презентационном видеоролике порой важнее не абсолютная натуральность тембра, а стабильный темп и одинаковое произношение терминов во всех версиях материала.
Аудиоверсии статей, инструкций и длинных материалов
Длинный текст предъявляет другие требования: слушатель быстро замечает повторяющуюся интонацию, слишком одинаковые паузы и усталость от высокой скорости. По этой причине большой материал разбивают на смысловые блоки, отдельно проверяют заголовки, списки, цитаты и числовые фрагменты, а после сборки слушают не только отдельные предложения, но и длинные отрезки подряд. Для проектов формата книги полезен разбор подготовки аудиокниги: требования к монтажу длинной записи во многом совпадают с постобработкой синтезированной речи.
Голосовые интерфейсы и автоматические уведомления
В голосовом интерфейсе синтез становится частью пользовательского опыта. Тут критичны задержка, понятность коротких сообщений и устойчивое чтение динамических данных: имён, дат, статусов, сумм, наименований услуг. Текст, который создаётся автоматически, необходимо проектировать как шаблон речи, а не как экранную строку. В одном предложении должно быть понятно, что произошло, что делать дальше и какая часть данных в самом деле необходима пользователю на слух.
Для контактных и сервисных сценариев полезен модульный подход: неизменяемые фрагменты получают заблаговременно утверждённую формулировку, динамические поля проходят нормализацию, а критические данные озвучиваются в форме, снижающей двусмысленность. После обновления движка или голоса контрольный набор фраз прогоняют заново, потому что изменение модели способно повлиять на ударения, темп и паузы даже без изменения текста.
Доступность цифрового продукта
Синтез речи является важной частью экранного чтения и других функций доступности. На Android системные настройки TTS позволяют выбрать движок, язык, скорость и высоту тона. Это показывает принципиальное отличие доступности от контентной озвучки: пользователь сам управляет частью параметров и слушает не заблаговременно подготовленный видеоролик, а элементы интерфейса в реальном времени. Значит, подписи, альтернативный текст и порядок элементов должны оставаться понятными без визуального контекста.
Рабочий процесс: от текста до готовой дорожки
Надёжный процесс синтеза строится как небольшой производственный конвейер. Он начинается до выбора голоса и заканчивается после прослушивания файла в реальном канале — на телефоне, в видеоролике, в интерфейсе или в обучающем модуле. Для межплатформенной задачи можно свериться с вариантами преобразования текста в аудио на разных устройствах, а потом выбрать один стабильный контур и зафиксировать правила внутри команды.
Шаг 1. Определите назначение аудио до написания сценария
Сценарий зависит от того, где прозвучит голос. Для короткого интерфейсного сообщения важны скорость и отсутствие лишних слов. В обучающем фрагменте необходимы логические паузы и более спокойный темп. В видеоролике текст должен совпадать с визуальным монтажом. В длинном аудиоматериале приоритет смещается к устойчивой интонации и минимальной утомляемости. Один универсальный темп и один стиль подачи не решают все задачи.
- Канал: видео, интерфейс, голосовое меню, аудиоверсия материала или обучение.
- Длина: отдельная реплика, серия фрагментов или длинная глава.
- Динамичность: фиксированный текст либо часто обновляемые данные.
- Требование к выразительности: нейтральное сообщение, объяснение, эмоциональная подача.
- Формат итога: отдельный аудиофайл, поток или дорожка для последующего монтажа.
Шаг 2. Перепишите текст для восприятия на слух
Уберите то, что держится лишь на визуальной структуре: громоздкие скобки, длинные цепочки через точку с запятой, ссылки, таблицеподобные перечисления. Числа и сокращения приведите к форме, которая должна прозвучать. Для сложных наименований заблаговременно зафиксируйте чтение. Фразы лучше заканчивать там, где естественно сделать вдох или смысловую паузу. Это уменьшает число ручных исправлений уже после синтеза.
- Одна фраза передаёт одну основную мысль.
- Числа и даты читаются однозначно в заданном контексте.
- Сокращения не оставляют системе несколько равноправных вариантов произношения.
- Имена, бренды и термины проверены отдельно.
- Списки преобразованы в последовательные речевые конструкции.
- В тексте нет служебных пометок, которые не должны прозвучать.
Шаг 3. Соберите контрольный набор фраз
До массовой генерации подготовьте небольшой набор, который специально нагружает слабые места: даты, большие числа, десятичные дроби, аббревиатуры, смешение кириллицы и латиницы, фамилии, наименования продуктов, омографы, вопросительные фразы, перечисления. Этот набор необходим не для демонстрации красивого тембра, а для сравнения движков и повторной проверки после изменений. Хорошая демофраза и хороший рабочий голос — не одно и то же.
Шаг 4. Настройте голос и речевую разметку
Сперва выберите голос, язык и базовый темп, затем исправляйте отдельные проблемные места. Не стоит разгонять скорость только ради сокращения хронометража: слишком плотная подача ухудшает разборчивость и усиливает ощущение синтетики. Паузы и акценты добавляют там, где они поддерживают смысл. Для платформ с SSML или собственной разметкой создайте небольшой внутренний набор проверенных шаблонов и не смешивайте несовместимые конструкции различных движков.
Шаг 5. Генерируйте небольшими смысловыми блоками
Крупный сценарий удобнее делить на фрагменты по абзацам или сценам. Так проще ещё раз создать только неудачный участок, сохранить одинаковые имена файлов и не потерять место правки. Размер блока выбирают по логике материала и ограничениям платформы. К примеру, в текущем веб-интерфейсе Yandex SpeechKit Playground текстовое поле принимает до 5000 символов, а синхронный режим SaluteSpeech ограничивает тело операции 4000 символами вместе с разметкой.
Шаг 6. Проведите языковую проверку до звуковой обработки
Первое прослушивание отвечает лишь на вопросы языка и подачи: правильно ли произнесены слова, естественны ли паузы, не потеряно ли окончание, не появился ли лишний акцент, не перепутан ли смысл. Ошибки этого уровня исправляют текстом и параметрами синтеза. Эквалайзер не исправляет неправильное ударение, а компрессор не делает перегруженное предложение понятнее.
Шаг 7. Выполните монтаж и постобработку
После языкового контроля можно обрезать технические хвосты, собрать фрагменты, выровнять переходы и громкость, подготовить нужный формат. Синтетическая речь обычно не требует агрессивной обработки: лишняя компрессия и сильный эквалайзер легко подчёркивают артефакты. Для базовых принципов пригодится материал Xeon Live про обработку аудио на компьютере.
Шаг 8. Проверьте материал в реальном контексте
Итоговая проверка выполняется там, где аудио будет жить. Дорожка для видеоролика слушается вместе с музыкой и монтажом. Голос интерфейса проверяется на устройстве и на типичных коротких репликах. Длинный материал слушается непрерывными отрезками, чтобы оценить утомляемость. Технически чистый файл не считается готовым, пока не подтверждена понятность в целевом сценарии.
Четыре практических варианта работы с синтезированной речью
Ниже — четыре различных контура: локальная постобработка готового TTS-файла, браузерный и API-синтез, российская речевая платформа и системный движок Android. Они не являются взаимозаменяемыми: каждый решает свою часть задачи. Для выбора сперва определите, необходим ли сам генератор речи, обработка итога или встроенное чтение на устройстве.
1. АудиоМАСТЕР — постобработка готовой TTS-дорожки
АудиоМАСТЕР в этой схеме применяется после синтеза: программа не превращает текст в речь, а редактирует уже созданный аудиофайл. Страница программы в каталоге Xeon Live описывает АудиоМАСТЕР как аудиоредактор и конвертер. В нём доступны обрезка и склейка, регулировка и нормализация громкости, эквалайзер, работа с темпом и экспорт в распространённые аудиоформаты. Для озвучки это полезно, когда синтез выполнен в отдельном сервисе, а итоговую дорожку необходимо привести к хронометражу видеоролика или собрать из нескольких фрагментов.
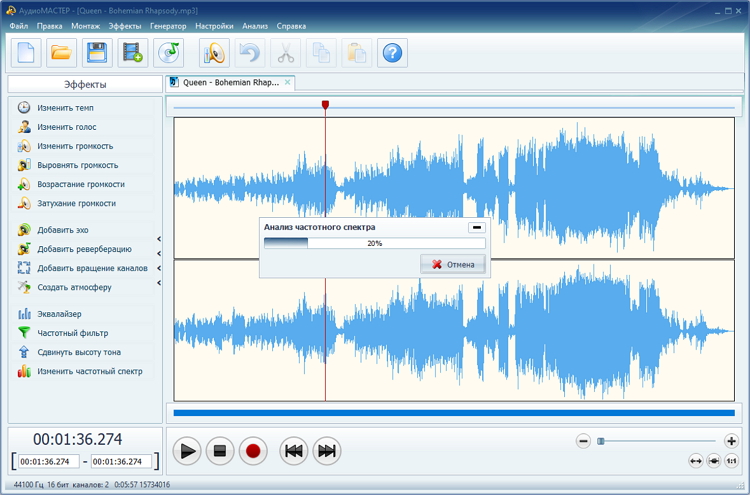
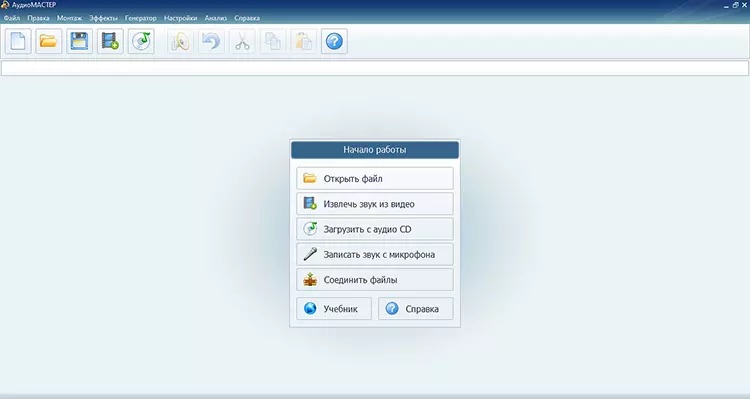
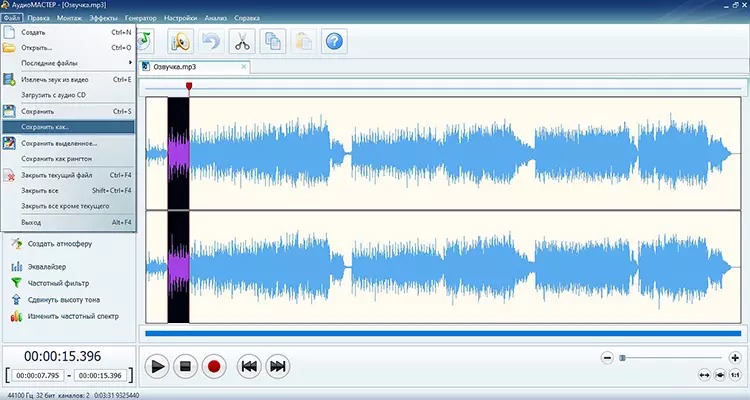
Практический порядок такой: создайте речь в выбранном TTS-движке, сохраните исходный файл без лишней перекодировки, откройте его в редакторе, удалите технические паузы в начале и конце, соберите нужные реплики, сопоставьте громкость между фрагментами и лишь после этого выполняйте итоговый экспорт. Эквалайзер и другие эффекты применяйте умеренно: цель постобработки — согласовать дорожку с проектом, а не скрыть дефект произношения.
Плюсы
- Локальная обработка уже созданных TTS-файлов без привязки к конкретному движку синтеза.
- Обрезка, склейка, регулировка громкости и базовая частотная обработка в одном рабочем окне.
- Подходит для подготовки отдельных реплик и длинных собранных дорожек к дальнейшему монтажу.
- Экспорт в распространённые аудиоформаты для передачи в видеоредактор или иную систему.
Минусы
- Программа не выполняет Text-to-Speech: голос сперва создаётся в другом инструменте.
- Аудиоредактор предназначен для Windows, по этой причине этот этап не является универсальным межплатформенным решением.
- Сильная обработка не исправляет фонетические ошибки и неудачную просодию исходного синтеза.
Кому подойдёт
Редакторам видео, авторам курсов, контент-командам и специалистам, которым TTS уже выдаёт приемлемую речь, но требуется аккуратно собрать фрагменты, подогнать хронометраж, выровнять уровень и подготовить единый итоговый файл.
2. Yandex SpeechKit — быстрый тест в Playground и интеграция через API
Yandex SpeechKit подходит для двух различных режимов: ручной проверки текста в Playground и программного синтеза в продукте. В текущем Playground можно ввести до 5000 символов, выбрать язык, голос и роль, настроить скорость и высоту тона, указать формат итога и применять инструменты для пауз, акцентов, ударений и фонем. Это удобно для редакционного прототипа: сперва добиться устойчивого чтения контрольных фраз в браузере, а уже затем переносить параметры в интеграцию.
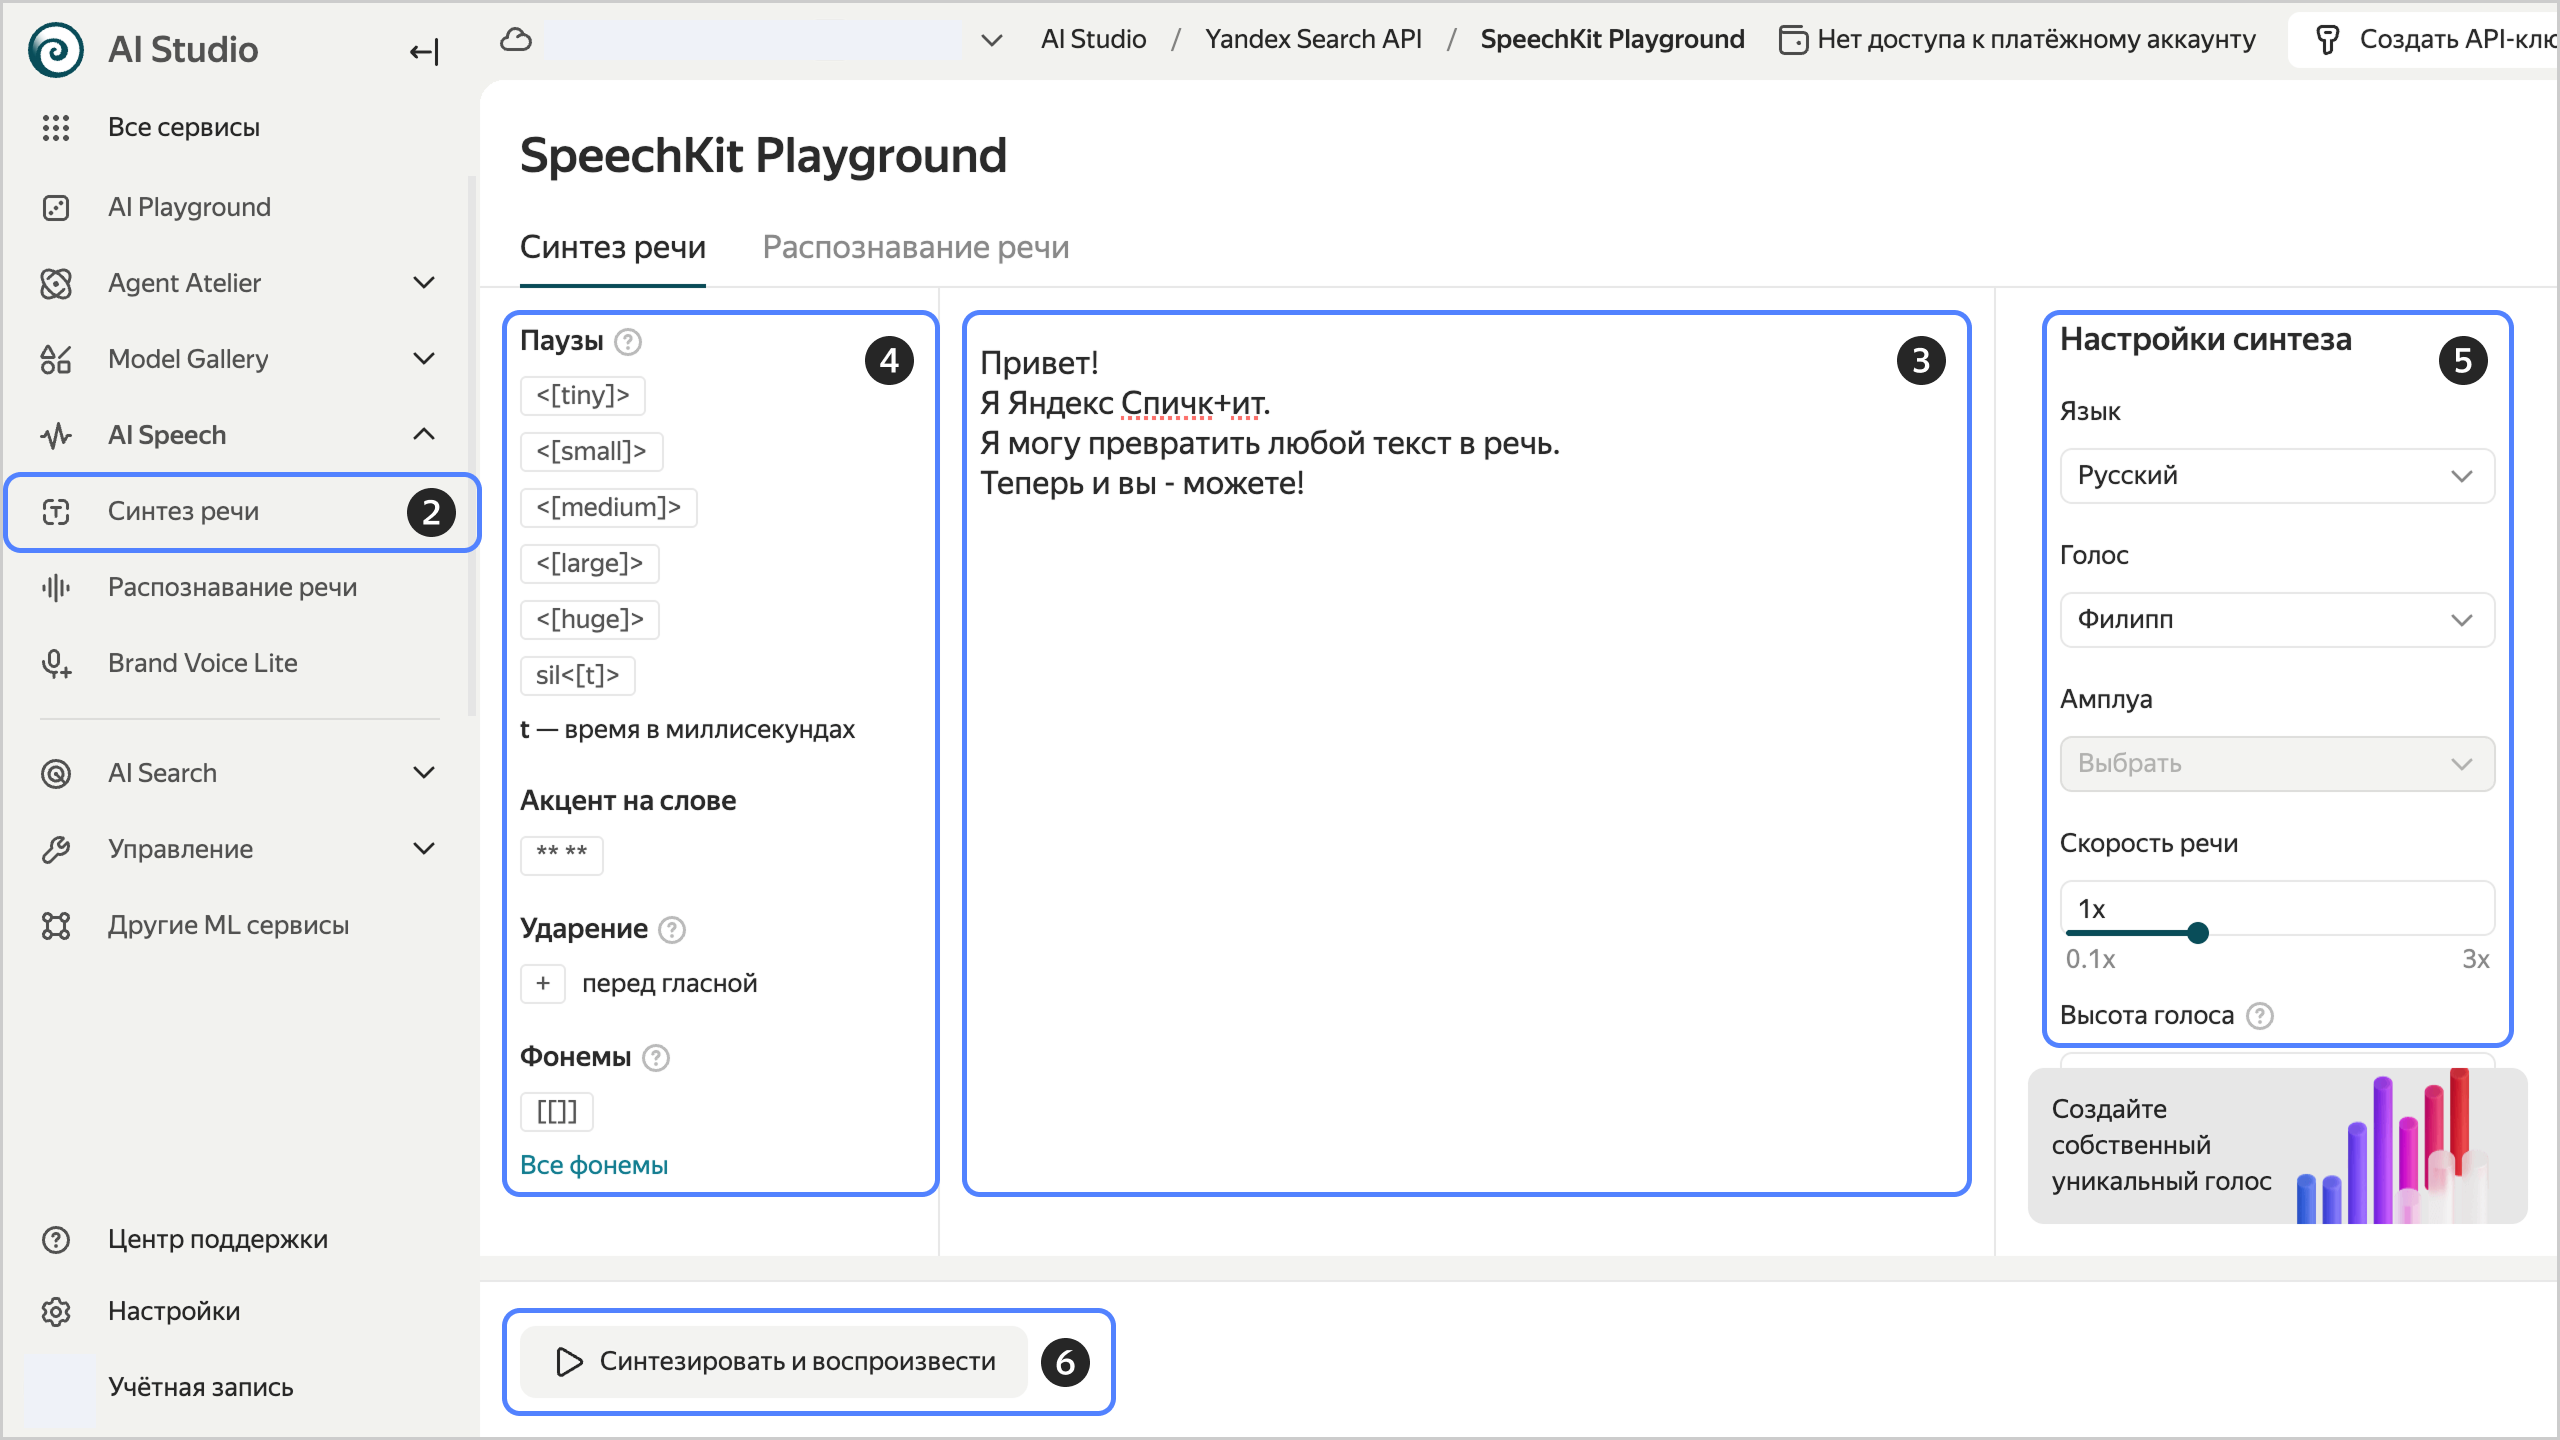
Для массовой автоматизации применяется API. При таком переходе важно не копировать настройки механически: формат разметки, параметры аудио, потоковый режим и обработка ошибок должны быть частью интеграции. Команда контента вместе с этим сохраняет собственный тестовый набор фраз и сопоставляет итог при изменении голоса или модели. Так редакционная проверка остаётся отделённой от инженерной реализации.
Плюсы
- Есть визуальный Playground для проверки текста и параметров до программной интеграции.
- Доступны речевые настройки, полезные для работы с ударениями, паузами и сложным произношением.
- API подходит для динамической генерации, когда текст создаётся или обновляется внутри продукта.
- Можно заблаговременно оценить итог на контрольных фразах и только затем переносить сценарий в рабочую систему.
Минусы
- Крупные тексты приходится делить на части с учётом лимитов конкретного режима.
- Автоматизация требует инженерной интеграции, хранения параметров и контроля ошибок.
- Разметка и поведение голосов требуют повторной проверки при переносе между режимами и при обновлениях.
Кому подойдёт
Командам цифровых продуктов, медиапроектам и разработчикам, которым необходима сперва ручная проверка произношения, а затем масштабируемый синтез для интерфейсов, динамических материалов или систематически обновляемого контента.
3. SaluteSpeech — синтез с речевой разметкой и API
SaluteSpeech предоставляет синтез речи через платформу и API. Синхронный режим принимает обычный UTF-8-текст или SSML-разметку; текущий лимит для такого режима составляет 4000 символов вместе с пробелами и разметкой. Для длинных материалов предусмотрен отдельный асинхронный контур. В рабочем проекте эти режимы стоит разделять: короткие интерактивные реплики и большие фоновые задачи имеют различные требования к задержке, длине текста и формату итога.
Для актуального планирования важно учитывать статус доступа. С 15 июля 2026 года подключение новых физических лиц к API прекращено, а документация продолжает описывать корпоративное применение и поддержку существующих клиентов. По этой причине в бизнес-материале SaluteSpeech рассматривается в первую очередь как корпоративный речевой сервис, а не как универсальный вариант для нового личного проекта.
Плюсы
- Поддержка обычного текста и SSML в синхронном синтезе.
- Разделение синхронного и асинхронного режима для различных объёмов и сценариев.
- Подходит для интеграции речевого вывода в корпоративные приложения и сервисные процессы.
- В документации отдельно раскрыты голоса, методы синтеза и программная интеграция.
Минусы
- В синхронном режиме действует ограничение на объём текста, по этой причине длинный материал требует сегментации или другого режима.
- Новые физические лица не подключаются к API с 15 июля 2026 года.
- Для рабочего внедрения требуется заблаговременно определить режим, формат аудио, правила авторизации и обработку технических ошибок.
Кому подойдёт
Корпоративным командам, которые внедряют синтез в сервисный контур, автоматические уведомления, голосовые интерфейсы или другие сценарии, где речевой вывод становится частью приложения и управляется программно.
4. Системный TTS Android — чтение текста на устройстве
Android предоставляет системные настройки Text-to-Speech, через которые пользователь выбирает предпочитаемый движок, язык, скорость речи и высоту тона. Конкретный набор движков зависит от устройства. Одним из распространённых вариантов является приложение Google Speech Recognition & Synthesis: оно предоставляет функции чтения текста вслух для системных и сторонних приложений. Это не инструмент для пакетной редакционной генерации файлов, а системный слой, который в особенности важен для функций доступности и приложений, использующих озвучивание на устройстве.
При проектировании Android-приложения важна устойчивость текста к различным пользовательским настройкам. Не стоит строить смысл на одной фиксированной скорости или конкретном тембре. Короткие подписи, ясная пунктуация и корректная семантика интерфейса дают более предсказуемый итог, чем попытка жёстко имитировать заблаговременно записанную дикторскую дорожку.
Плюсы
- Встроенная в платформу настройка движка, языка, скорости и высоты тона.
- Подходит для чтения интерфейса, книг и других текстов непосредственно на устройстве.
- Работает как общий системный слой, которым пользуются функции доступности и совместимые приложения.
- Пользователь сохраняет контроль над частью речевых параметров.
Минусы
- Набор доступных голосов и движков различается между устройствами.
- Системный TTS не заменяет редакционный конвейер генерации и постобработки готовых аудиофайлов.
- Продуктовый текст приходится проверять на различных настройках скорости и языка, а не только в одной конфигурации.
Кому подойдёт
Разработчикам Android-приложений, специалистам по доступности и продуктовым командам, которым необходимо воспроизводить текст на устройстве и уважать пользовательские настройки системного речевого движка.
Как выбрать TTS-движок для проекта
Выбор стоит начинать не с количества голосов, а с ограничений продукта. Для редакционной озвучки важны удобная ручная работа и быстрый пересинтез отдельных фраз. Для приложения — стабильный API и задержка. Для длинных материалов — поведение на больших текстах и метод сборки фрагментов. Для доступности — системная совместимость и предсказуемое чтение интерфейса. Отдельная подборка Xeon Live помогает сопоставить нейросетевые инструменты для озвучки текста голосом, но окончательное решение всё равно проверяется на собственном материале.
Критерий 1. Язык и предметная лексика
Проверьте не только наличие русского языка, но и чтение слов из вашей области. Финансовые сокращения, технические обозначения, фамилии, наименования продуктов и смешанные латинские элементы быстро показывают реальную устойчивость. Один голос способен хорошо читать обычный текст и ошибаться на профессиональной терминологии. Контрольный набор должен содержать именно те конструкции, которые встречаются в продукте ежедневно.
Критерий 2. Управление произношением
Необходимы инструменты, позволяющие исправить отдельное слово без переписывания всего текста. Это может быть фонетическая подсказка, ударение, словарь, собственная речевая разметка или поддержка SSML. Важна тоже повторяемость: исправление должно сохраняться для всех последующих материалов, иначе команда будет ручным способом чинить один и тот же термин в каждой публикации.
Критерий 3. Управление паузами и темпом
Базовый регулятор скорости решает только часть задачи. Для сложного контента необходима возможность управлять паузами и акцентами локально, не меняя темп всей записи. Вместе с этим чрезмерная разметка превращает сценарий в технический документ. Хорошая практика — сперва добиться естественного звучания обычной пунктуацией, а специальные команды применять только там, где текстовая редактура не даёт нужного итога.
Критерий 4. Режим интеграции и задержка
Готовый видеоролик можно генерировать пакетно: задержка в несколько секунд не мешает работе. Диалоговый интерфейс требует быстрого начала воспроизведения и устойчивой потоковой передачи. По этой причине «скорость синтеза» оценивается вместе со сценарием. Команда заблаговременно определяет допустимое время до первого звука, длину типичной реплики и поведение при сетевой ошибке, а затем проверяет эти параметры на реальной интеграции.
Критерий 5. Форматы и дальнейший монтаж
Для видео и архива полезен формат с достаточным запасом качества до итогового экспорта; для потока важны поддерживаемый кодек и совместимость с клиентом. Не стоит многократно перекодировать промежуточные файлы. Если синтез будет редактироваться, сохраните исходный итог и отдельно создавайте публикационную версию. Это облегчает повторный монтаж и сравнение после правок.
Критерий 6. Права, политика применения и данные
Перед внедрением проверьте, разрешено ли коммерческое применение выбранного голоса и какие условия действуют для кастомных голосов. Для материалов с чувствительными данными отдельно оценивают, где обрабатывается текст и какие условия хранения применяются. Эти вопросы относятся не к качеству тембра, а к допустимости производственного процесса. Их лучше закрыть до интеграции, а не после выпуска первых материалов.
Критерий 7. Стабильность на повторных версиях
TTS полезен именно тем, что позволяет быстро выпускать обновления. По этой причине тестируйте не одну идеальную демофразу, а серию версий одного сценария: замените дату, имя, число, порядок пунктов, добавьте новый термин. Хороший для проекта движок сохраняет качество при таких изменениях и не требует полной ручной перенастройки каждой реплики.
Как подготовить текст, чтобы голос звучал естественнее
Большая часть качества рождается до синтеза. Ниже — редакторские приёмы, которые не зависят от конкретного бренда движка и уменьшают количество неудачных дублей.
Делайте предложения короче, чем в письменной статье
Сложное письменное предложение с несколькими уточнениями можно понять глазами благодаря пунктуации и возможности перечитать начало. В аудио такая конструкция перегружает рабочую память. Разделите её на две или три законченные фразы. Это одновременно улучшает понимание и даёт модели более явные точки для пауз. Короткое предложение не означает примитивный стиль: оно означает ясную последовательность смыслов.
Разворачивайте числа в нужную речевую форму
Одно и то же числовое значение читается по-разному в зависимости от роли. Год, порядковый номер, диапазон, процент и обозначение модели требуют различной формы. Перед синтезом проверьте каждую группу чисел вслух. Для динамических данных правила разворачивания должны быть частью шаблона, иначе один и тот же тип сообщения будет звучать по-разному в различных случаях.
Не оставляйте неоднозначные сокращения
Сокращение, понятное внутри команды, может быть произнесено неожиданно. Зафиксируйте, должно ли оно читаться по буквам, как слово или в полной форме. Для корпоративного словаря полезно хранить не только написание, но и ожидаемое произношение. Это в особенности важно для наименований продуктов, подразделений и технических терминов, которые редко встречаются в общих корпусах речи.
Проверяйте букву «ё», ударения и омографы
В русском тексте отсутствие «ё» обычно не мешает человеку, но в синтезе добавочная определённость полезна. Слова с различным ударением в зависимости от смысла проверяются в контексте. Когда движок поддерживает явное ударение или фонетическую подсказку, исправление лучше сделать локально и потом сохранить как правило для команды. Ручное изменение написания допустимо только тогда, когда оно не попадает в иные системы и не ломает исходный текстовый контент.
Сокращайте визуальные конструкции
Скобки, косые черты, длинные тире, вложенные перечисления и ссылки часто требуют специальной речевой адаптации. Не заставляйте голос читать структуру страницы. Вместо «вариант A/B» лучше сформулировать «вариант A или вариант B», вместо длинной ремарки в скобках — отдельное предложение. Задача сценария — передать смысл без визуальной опоры.
Разделяйте технические пометки и произносимый текст
Комментарии редактора, обозначения сцен, маркеры времени и инструкции монтажёру должны храниться отдельно от текста, который передаётся движку. Иначе служебная строка однажды окажется в готовой озвучке. Удобно иметь два поля: «сценарий» и «производственная заметка». В больших проектах это простое разделение уменьшает риск случайных публикаций и облегчает автоматическую сборку.
Применяйте речевую разметку как точечный инструмент
SSML и собственная разметка платформ полезны для пауз, ударений, произношения и параметров речи, но не заменяют редактуру. Чем больше технических тегов, тем сложнее поддерживать сценарий и переносить его между движками. Сперва исправьте структуру обычного текста, потом добавьте только нужные команды и протестируйте их на текущей платформе.
Как проверять качество синтезированной речи
Качество лучше оценивать не одним общим впечатлением, а по нескольким измеримым группам. Это превращает спор «нравится — не нравится» в воспроизводимую редакционную процедуру. Для каждого выпуска фиксируется список дефектов, время ручной правки и итоговый статус контрольных фраз.
Разборчивость
Слушатель должен без усилий различать слова на целевой громкости и целевом устройстве. Проверьте наушники, обычный динамик ноутбука и смартфон, когда эти устройства соответствуют аудитории. Фраза, идеально звучащая в студийных наушниках, способна потерять согласные или стать слишком резкой на маленьком динамике. Разборчивость важнее эффектного низкого тембра.
Произношение
Заведите отдельный счётчик ошибок произношения: неверные ударения, имена, цифры, сокращения и иностранные слова. Для длинного материала удобно нормировать показатель на условную тысячу слов, чтобы сопоставлять выпуски различного объёма. Цель процесса — не только исправить текущую ошибку, но и добавить её в словарь или контрольный набор, чтобы она не возвращалась.
Просодия
Отметьте чрезмерно длинные и слишком короткие паузы, неестественные подъёмы тона, одинаковое окончание всех предложений, «провал» интонации в середине мысли. Эти дефекты хуже заметны на одной фразе, по этой причине слушайте последовательность из нескольких абзацев. Для обучающего и объяснительного контента в особенности важна логическая иерархия: заголовок, тезис и пояснение не должны звучать одинаково.
Стабильность между фрагментами
При сборке материала из отдельных синтезов сопоставляйте громкость, тембр, скорость и фон на стыках. Даже один и тот же голос способен звучать чуть иначе при различных параметрах или после изменения настроек. Храните пресет проекта и не меняйте параметры посреди серии без причины. Если голосовая модель обновилась, контрольный набор помогает понять, требуется ли пересборка уже готовых частей.
Субъективные оценки и MOS
Mean Opinion Score (MOS) — семейство субъективных оценок качества, терминология которого стандартизована ITU-T. В исследованиях синтеза этот показатель часто получают по оценкам слушателей, но сопоставлять числа из различных экспериментов напрямую некорректно без одинаковой методики, выборки и материала. Для внутренней команды полезнее воспроизводимый собственный тест: одни и те же фразы, одинаковые устройства, одинаковая шкала и зафиксированный состав критериев.
Операционные метрики для команды
- Доля пересинтезированных фрагментов. Показывает, сколько реплик пришлось создавать заново после первого прохода.
- Минуты ручной правки на минуту готового аудио. Помогают увидеть реальную стоимость процесса во времени команды.
- Ошибки произношения на единицу текста. Позволяют сопоставлять стабильность различных голосов и шаблонов.
- Доля правок после финального прослушивания. Высокое значение означает, что контроль происходит слишком поздно.
- Время от утверждения текста до готовой дорожки. Полезно для регулярных серий и обновляемого контента.
- Дефекты на стыках. Отдельно считайте скачки уровня, темпа и пауз после сборки нескольких фрагментов.
Типичные ошибки при внедрении TTS
Ошибка 1. Выбирать голос по одной красивой демофразе
Демонстрация обычно подобрана под сильные стороны голоса. Рабочий материал содержит числа, наименования, короткие команды, длинные предложения и нестандартные термины. Сопоставляйте движки на собственном тестовом наборе и обязательно включайте сложные примеры. Пять минут такого теста полезнее десятков случайных демонстраций.
Ошибка 2. Отправлять в синтез текст прямо из статьи
Письменный материал рассчитан на глаза. Он содержит длинные абзацы, ссылки, сложные списки, скобки и визуальные сокращения. Сценарий для слуха требует адаптации. Отдельный редакционный проход перед синтезом обычно сокращает число фонетических и ритмических правок на последующих этапах.
Ошибка 3. Исправлять произношение эквалайзером
Звуковая обработка меняет спектр, динамику и монтаж, но не переставляет ударение и не меняет фонемы. Неверно произнесённое слово необходимо исправлять в тексте, словаре или речевой разметке и синтезировать заново. Это базовое разделение обязанностей между TTS и аудиоредактором.
Ошибка 4. Делать весь длинный текст одним фрагментом
Один большой файл неудобно исправлять и собирать. При повторной генерации меняется чрезмерно большой кусок материала, а редактору сложнее локализовать ошибку. Сегментация по смысловым блокам делает процесс управляемым: каждому фрагменту присваивается понятное имя, правка затрагивает только нужную часть, а сборка выполняется в стабильном порядке.
Ошибка 5. Не хранить словарь произношений
Повторяющаяся ошибка без общей базы превращается в постоянные ручные затраты. Словарь должен включать спорное написание, ожидаемое произношение, контекст и метод исправления для текущего движка. При смене платформы сохраняется смысловая часть словаря, а техническая разметка адаптируется заново.
Ошибка 6. Не проверять громкость и стыки
Фразы, созданные в различные дни или с различными параметрами, могут отличаться по уровню и ритму. На стыке слушатель замечает скачок ранее, чем смысл следующего предложения. Сборка должна включать прослушивание переходов, одинаковые правила тишины в начале и конце фрагмента и единый подход к финальному уровню.
Ошибка 7. Игнорировать права на голос и коммерческий режим
Доступность голоса в интерфейсе не равна автоматическому разрешению на любое применение. Команда отдельно проверяет условия для коммерческого контента, кастомных голосов и брендовых голосовых моделей. Для голоса реального человека требуется ясное основание применения и согласованный объём прав. Эти сведения фиксируют вместе с остальными материалами проекта.
Безопасность, права на голос и ответственное применение
Современный синтез тесно соседствует с технологиями имитации и клонирования голоса, по этой причине производственный процесс должен различать обычный каталожный голос и модель, воспроизводящую конкретного человека. Для второго случая требуется явное согласие правообладателя голоса и ясная цель применения. Нельзя переносить разрешение на одну кампанию на другие каналы автоматически: объём прав должен соответствовать реальному применению.
Для корпоративной работы важна и конфиденциальность текста. В синтез не передают секретные данные просто ради удобства. Команда заблаговременно определяет, какие категории информации допустимы для внешнего облачного сервиса, кто имеет доступ к проекту и где хранится итоговое аудио. Для закрытых материалов выбирают архитектуру и договорные условия, соответствующие политике безопасности организации.
Отдельная мера — журналирование изменений. Достаточно хранить версию сценария, наименование голоса, основные параметры, дату генерации и автора правки. Это помогает пояснить, откуда взялся конкретный файл, воспроизвести удачную конфигурацию и быстро заменить ошибочный фрагмент. Для публичного контента такая дисциплина полезнее, чем попытка «узнать на слух», какой пресет применялся месяц назад.
Там, где синтетический характер голоса способен повлиять на доверие или понимание источника сообщения, редакционная политика должна прямо решать вопрос маркировки. Универсальной одной фразы для всех сценариев нет: сервисное уведомление, художественная озвучка и имитация конкретного человека имеют различный риск введения аудитории в заблуждение. Главное — не создавать ложное впечатление о личности говорящего.
Практическая матрица выбора без сложной таблицы
Ниже — короткая схема, которая помогает быстро сузить выбор. Она не заменяет тест, но показывает, какой тип решения проверять первым.
- Необходимо обработать уже готовый TTS-файл на Windows: применяйте аудиоредактор вроде АудиоМАСТЕРА для обрезки, склейки, уровня и экспорта.
- Необходимо ручным способом подобрать голос, а затем автоматизировать массовую генерацию: проверяйте платформу с Playground и API, к примеру Yandex SpeechKit.
- Необходим корпоративный речевой контур с синхронным и асинхронным режимом: рассматривайте SaluteSpeech с учётом текущих условий подключения.
- Необходимо чтение текста внутри Android и функций доступности: опирайтесь на системный TTS и пользовательские настройки движка.
- Необходим эмоциональный рекламный голос: сперва проведите слепое прослушивание на реальном сценарии и проверьте права на выбранный голос.
- Необходимы длинные материалы: уделите приоритет сегментации, стабильности тембра, утомляемости и удобству повторного синтеза отдельных блоков.
Чек-лист перед публикацией
- Сценарий адаптирован для слуха, а не скопирован из экранного текста без изменений.
- Все числа, даты, сокращения, имена, термины и смешанные написания прослушаны отдельно.
- Голос и темп зафиксированы как пресет проекта.
- Сложные слова добавлены в словарь произношений или исправлены доступной разметкой.
- Длинный материал разбит на смысловые фрагменты с понятными именами файлов.
- Повторная генерация затрагивает только проблемные части, а не весь материал.
- После синтеза проверены произношение, паузы, интонация и смысловые акценты.
- После монтажа проверены стыки, уровень, начало и конец каждого фрагмента.
- Итоговый файл прослушан на реальном устройстве и вместе с другими звуками проекта.
- Условия коммерческого применения голоса и права на кастомные модели подтверждены до публикации.
- Для чувствительного текста соблюдены внутренние правила безопасности и хранения данных.
- Сохранены версия сценария, параметры голоса и исходные аудиофайлы для повторной сборки.
Частые вопросы
Чем TTS отличается от STT?
TTS превращает текст в звук. STT решает обратную задачу и преобразует речь в текст. В голосовом интерфейсе обе технологии часто работают рядом, но качество и метрики у них различные.
Необходим ли SSML для хорошей озвучки?
Нет. Сперва важна редактура самого сценария. SSML и собственная разметка движка полезны для точечных пауз, произношения и других параметров там, где обычной пунктуации недостаточно.
Почему движок неправильно ставит ударение?
Причина обычно в неоднозначности слова, редком имени или предметной лексике. Исправление выполняют через контекст, словарь произношений, явное ударение или фонетическую подсказку, которую поддерживает выбранная платформа.
Когда необходима постобработка синтезированной речи?
Она необходима для монтажа, удаления технических пауз, выравнивания фрагментов, согласования громкости и подготовки формата. Постобработка не заменяет повторный синтез слова, которое произнесено неверно.
Можно ли оценивать качество только по естественности тембра?
Нет. В рабочем проекте отдельно оценивают разборчивость, произношение, просодию, стабильность между фрагментами, скорость исправления ошибок и качество на целевом устройстве.
Как сопоставить два TTS-инструмента без субъективного спора?
Применяйте одинаковый контрольный набор сложных фраз, одинаковые условия прослушивания и единый лист оценки. Считайте ошибки произношения, повторные генерации и время ручной правки. Так сравнение становится воспроизводимым.
Итог: TTS — это производственный процесс, а не одна кнопка
Синтез речи уже достаточно зрел, чтобы применять его в контенте, интерфейсах, обучении и сервисных сценариях, но качество определяется всей цепочкой. Подготовленный сценарий даёт системе однозначный текст; движок отвечает за произношение и акустику; редактор контролирует смысл и просодию; аудиомонтаж приводит фрагменты к единому итогу; финальное прослушивание подтверждает, что дорожка работает в реальном канале.
Самый практичный подход — начать с короткого контрольного набора, измерять не только впечатление от голоса, но и количество исправлений, а затем закрепить удачные правила в словаре и шаблонах. Так TTS перестаёт быть эффектной демонстрацией и становится предсказуемым инструментом производства аудиоконтента.