
Нейросетевая озвучка перестала быть отдельным экспериментальным эффектом и стала рабочим инструментом для видеороликов, презентаций, обучения, подкастов, интерфейсов и корпоративных коммуникаций. В основе большинства решений лежит синтез речи: текст преобразуется в аудиосигнал, а современные модели дополнительно учитывают контекст, паузы, темп и характер фразы. Для бизнеса важен не сам факт генерации, а повторяемость итога: голос должен одинаково произносить наименование продукта, укладываться в тайминг и оставаться разборчивым на телефоне, ноутбуке и внешней акустике.
В этом рейтинге собраны 21 программа, веб-сервис и облачная платформа. Мы разделили их по основному методу работы: сперва Windows-редактор, где голос сразу соединяется с видеорядом, затем браузерные и облачные решения. Такой порядок полезнее плоского списка: выбор между монтажной программой, веб-студией и API зависит от того, где заканчивается работа с голосом и начинается следующий производственный этап.
Как оценивать нейросеть для озвучки
Сопоставлять TTS только по приятности демо-голоса недостаточно. Для маркетинга и коммуникаций важны точность произношения, управление паузами, стабильность одной и той же подачи, скорость исправления отдельных реплик, удобство командного процесса, наличие API и место финального монтажа. Отдельный параметр — права на голос: клонированный или персональный голос применяют лишь при наличии понятного согласия владельца записи и правил доступа внутри команды.
- Разборчивость. Проверяйте речь на встроенном динамике смартфона, ноутбуке и наушниках; чрезмерно мягкий голос может хорошо звучать в студии и теряться в реальном просмотре.
- Произношение брендов и терминов. В тестовый текст добавьте наименования продуктов, фамилии, англоязычные слова, числа, даты и сокращения.
- Управление ритмом. Для видео важны паузы и продолжительность фраз; для голосового интерфейса — минимальная задержка; для аудиокниги — стабильность длинного повествования.
- Повторяемость. Один голос и одинаковые параметры должны давать сходную манеру в серии видеороликов, курсов или продуктовых сообщений.
- Редактируемость. Хороший процесс позволяет заменить одну неудачную реплику без повторной сборки всей дорожки.
- Интеграция. Веб-студия удобна редактору, API — продуктовой команде, а встроенный TTS в видеоредакторе сокращает число экспортов и импортов.
Практический тест: 10 реплик, которые стоит прогнать перед выбором
Перед внедрением подготовьте одинаковый тестовый набор для всех кандидатов. Так сравнение превращается из впечатления от демо в воспроизводимую проверку. Сохраняйте итоги с одинаковой громкостью и не сообщайте слушателям наименование сервиса до оценки — это снижает влияние бренда на восприятие.
- Короткое приветствие на 5–7 слов.
- Абзац из 3–4 предложений с нейтральной деловой интонацией.
- Наименование компании и продукта, включая латиницу.
- Дата, время, проценты и крупное число.
- Фраза с вопросом и фраза с восклицанием.
- Предложение со скобками, тире и перечислением.
- Иностранное имя или географическое наименование.
- Скороговорочный фрагмент для проверки артикуляции.
- Финальная рекламная реплика без завышенных обещаний.
- Абзац длиной около минуты для оценки стабильности тембра.
Рейтинг нейросетей и сервисов для озвучки текста
В рейтинге нет универсального победителя для всех задач. ВидеоМОНТАЖ удобнее, когда голос необходим внутри видеоролика; ElevenLabs и браузерные студии сильны в медийной подаче; SpeechKit, Azure, Google Cloud и Amazon Polly лучше вписываются в автоматизированные продукты. Остальные сервисы полезны как быстрые веб-инструменты, студии для конкретного формата или промежуточный слой между редактором и API.
Windows: озвучка сразу внутри видеопроекта
ВидеоМОНТАЖ
ВидеоМОНТАЖ ставим первым, поскольку он закрывает не только преобразование текста в речь, но и весь путь до готового видеоролика: текст превращается в голос, запись сразу попадает на отдельную звуковую дорожку, после чего ее синхронизируют с кадрами, музыкой и титрами. Такой подход в особенности удобен для рекламных видеороликов, презентаций, обучающих видео, карточек товаров и коротких публикаций, где голос не является самостоятельным конечным продуктом, а должен точно работать вместе с видеорядом. Интерфейс русскоязычный, а сам редактор ориентирован на Windows. Для более широкого производственного процесса пригодится практическую схему озвучки видео, где голос рассматривается вместе с монтажом, музыкой и синхронизацией.
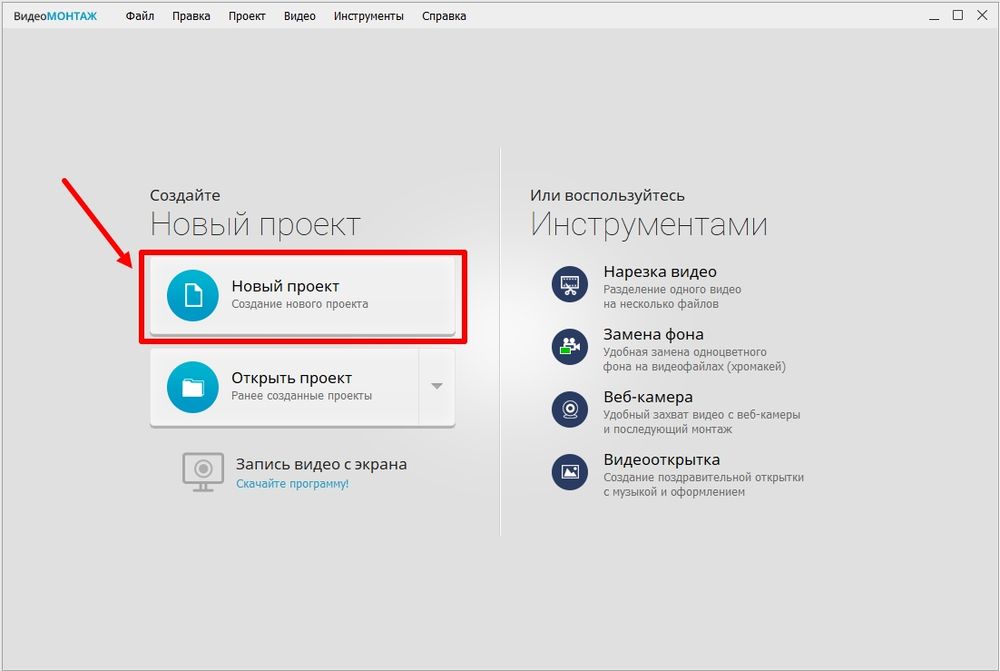
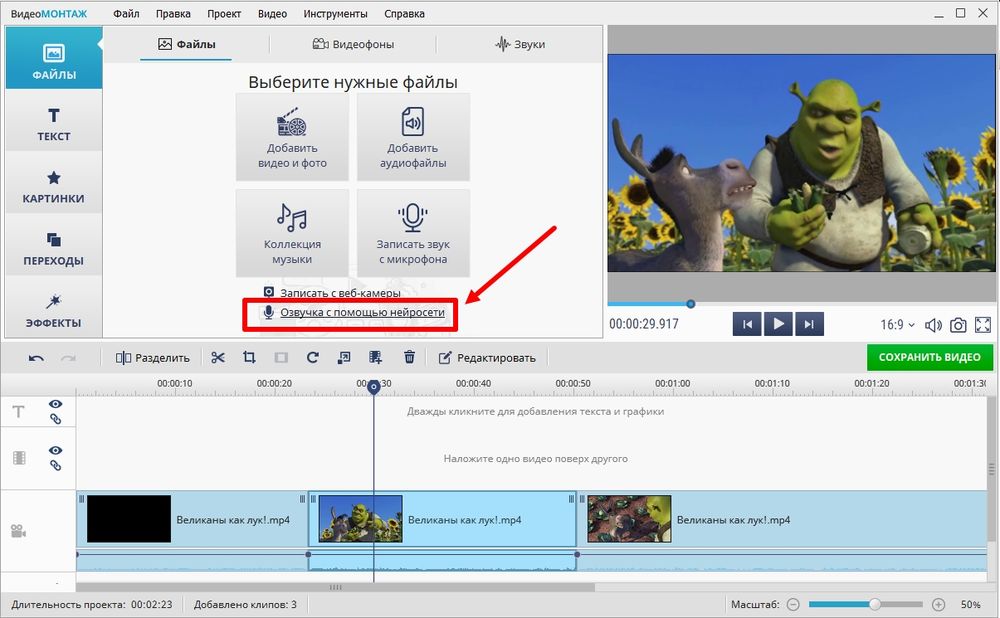

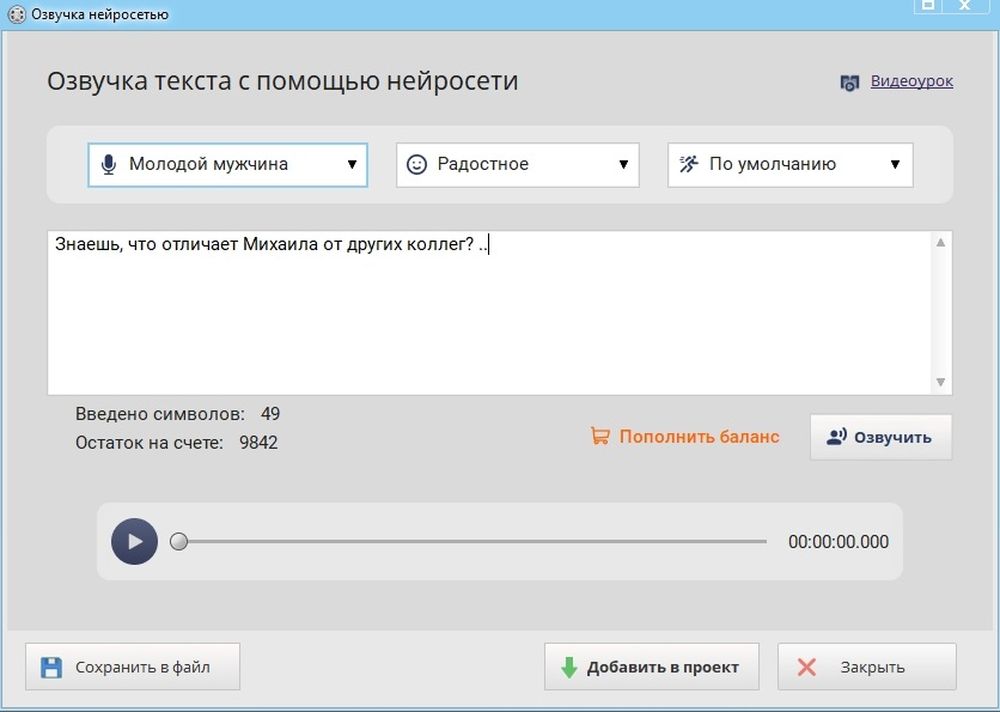
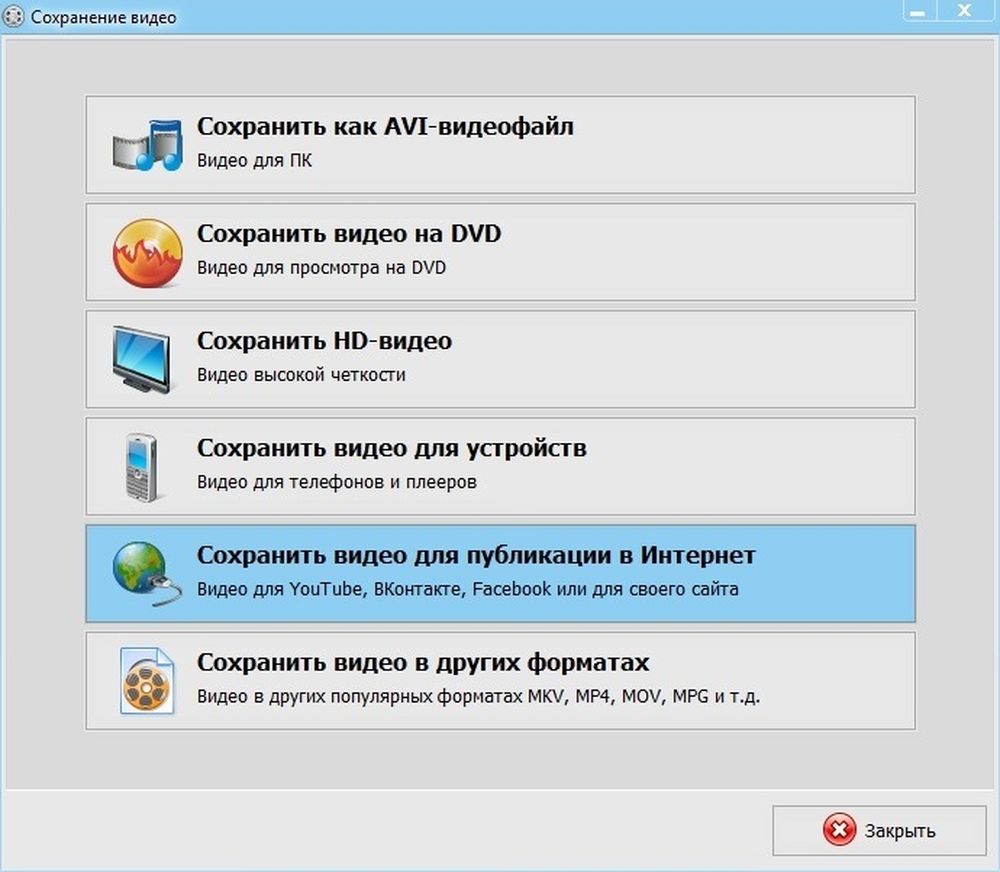
Практический сценарий строится так: создайте проект, добавьте видео или изображения, откройте инструмент нейросетевой озвучки, вставьте подготовленный текст, выберите голос и характер подачи, проверьте темп, потом добавьте итог на таймлайн. После этого выровняйте начало фраз относительно смены сцен, снизьте громкость фоновой музыки в местах речи и прослушайте видеоролик целиком до экспорта. Для маркетингового видео это важнее самой генерации: удачная синхронизация влияет на понятность сообщения сильнее, чем небольшая разница между двумя похожими голосами.
Плюсы
- Озвучка создается внутри монтажного проекта без отдельного этапа импорта аудио.
- Можно совмещать синтезированную речь, музыку, титры и видеоряд на одной монтажной шкале.
- Русскоязычный интерфейс упрощает работу командам, которым не нужен облачный API.
- Готовую голосовую дорожку удобно сразу проверять в контексте конкретного видеоролика.
Минусы
- Программа рассчитана на Windows, по этой причине она не заменяет браузерный сервис для смешанной инфраструктуры.
- Инструменты тонкой программной интеграции и массовой генерации уступают специализированным облачным API.
- Для длинных аудиокниг и потокового синтеза удобнее специализированные речевые платформы.
Кому подойдёт
Маркетологам, SMM-специалистам, небольшим редакциям, преподавателям и авторам видео, которым важен единый процесс от текста до смонтированного видеоролика без переключения между несколькими приложениями.
Браузер и облако: веб-студии и API
Основная часть рынка TTS работает в браузере или как облачная платформа. Тут разница в особенности заметна между редакторскими сервисами и инфраструктурными API. Первые дают понятный интерфейс и быстрый экспорт, вторые позволяют встроить голос в приложение, автоматически генерировать тысячи фраз и хранить параметры синтеза как часть продукта.
ElevenLabs
ElevenLabs ориентирован на естественную, эмоционально управляемую речь и подходит для задач, где голос должен не просто читать слова, а поддерживать драматургию текста. В сервисе применяют различные модели синтеза: одни оптимизированы под максимально выразительную подачу, другие — под низкую задержку. Русский язык поддерживается. Для контент-команд в особенности полезна возможность сохранить голосовой образ между несколькими материалами, а для разработчиков — подключать генерацию через API. При длинном повествовании полезно заблаговременно учитывать этапы создание аудиокниги: редактуру, обработку и финальную проверку дорожки.
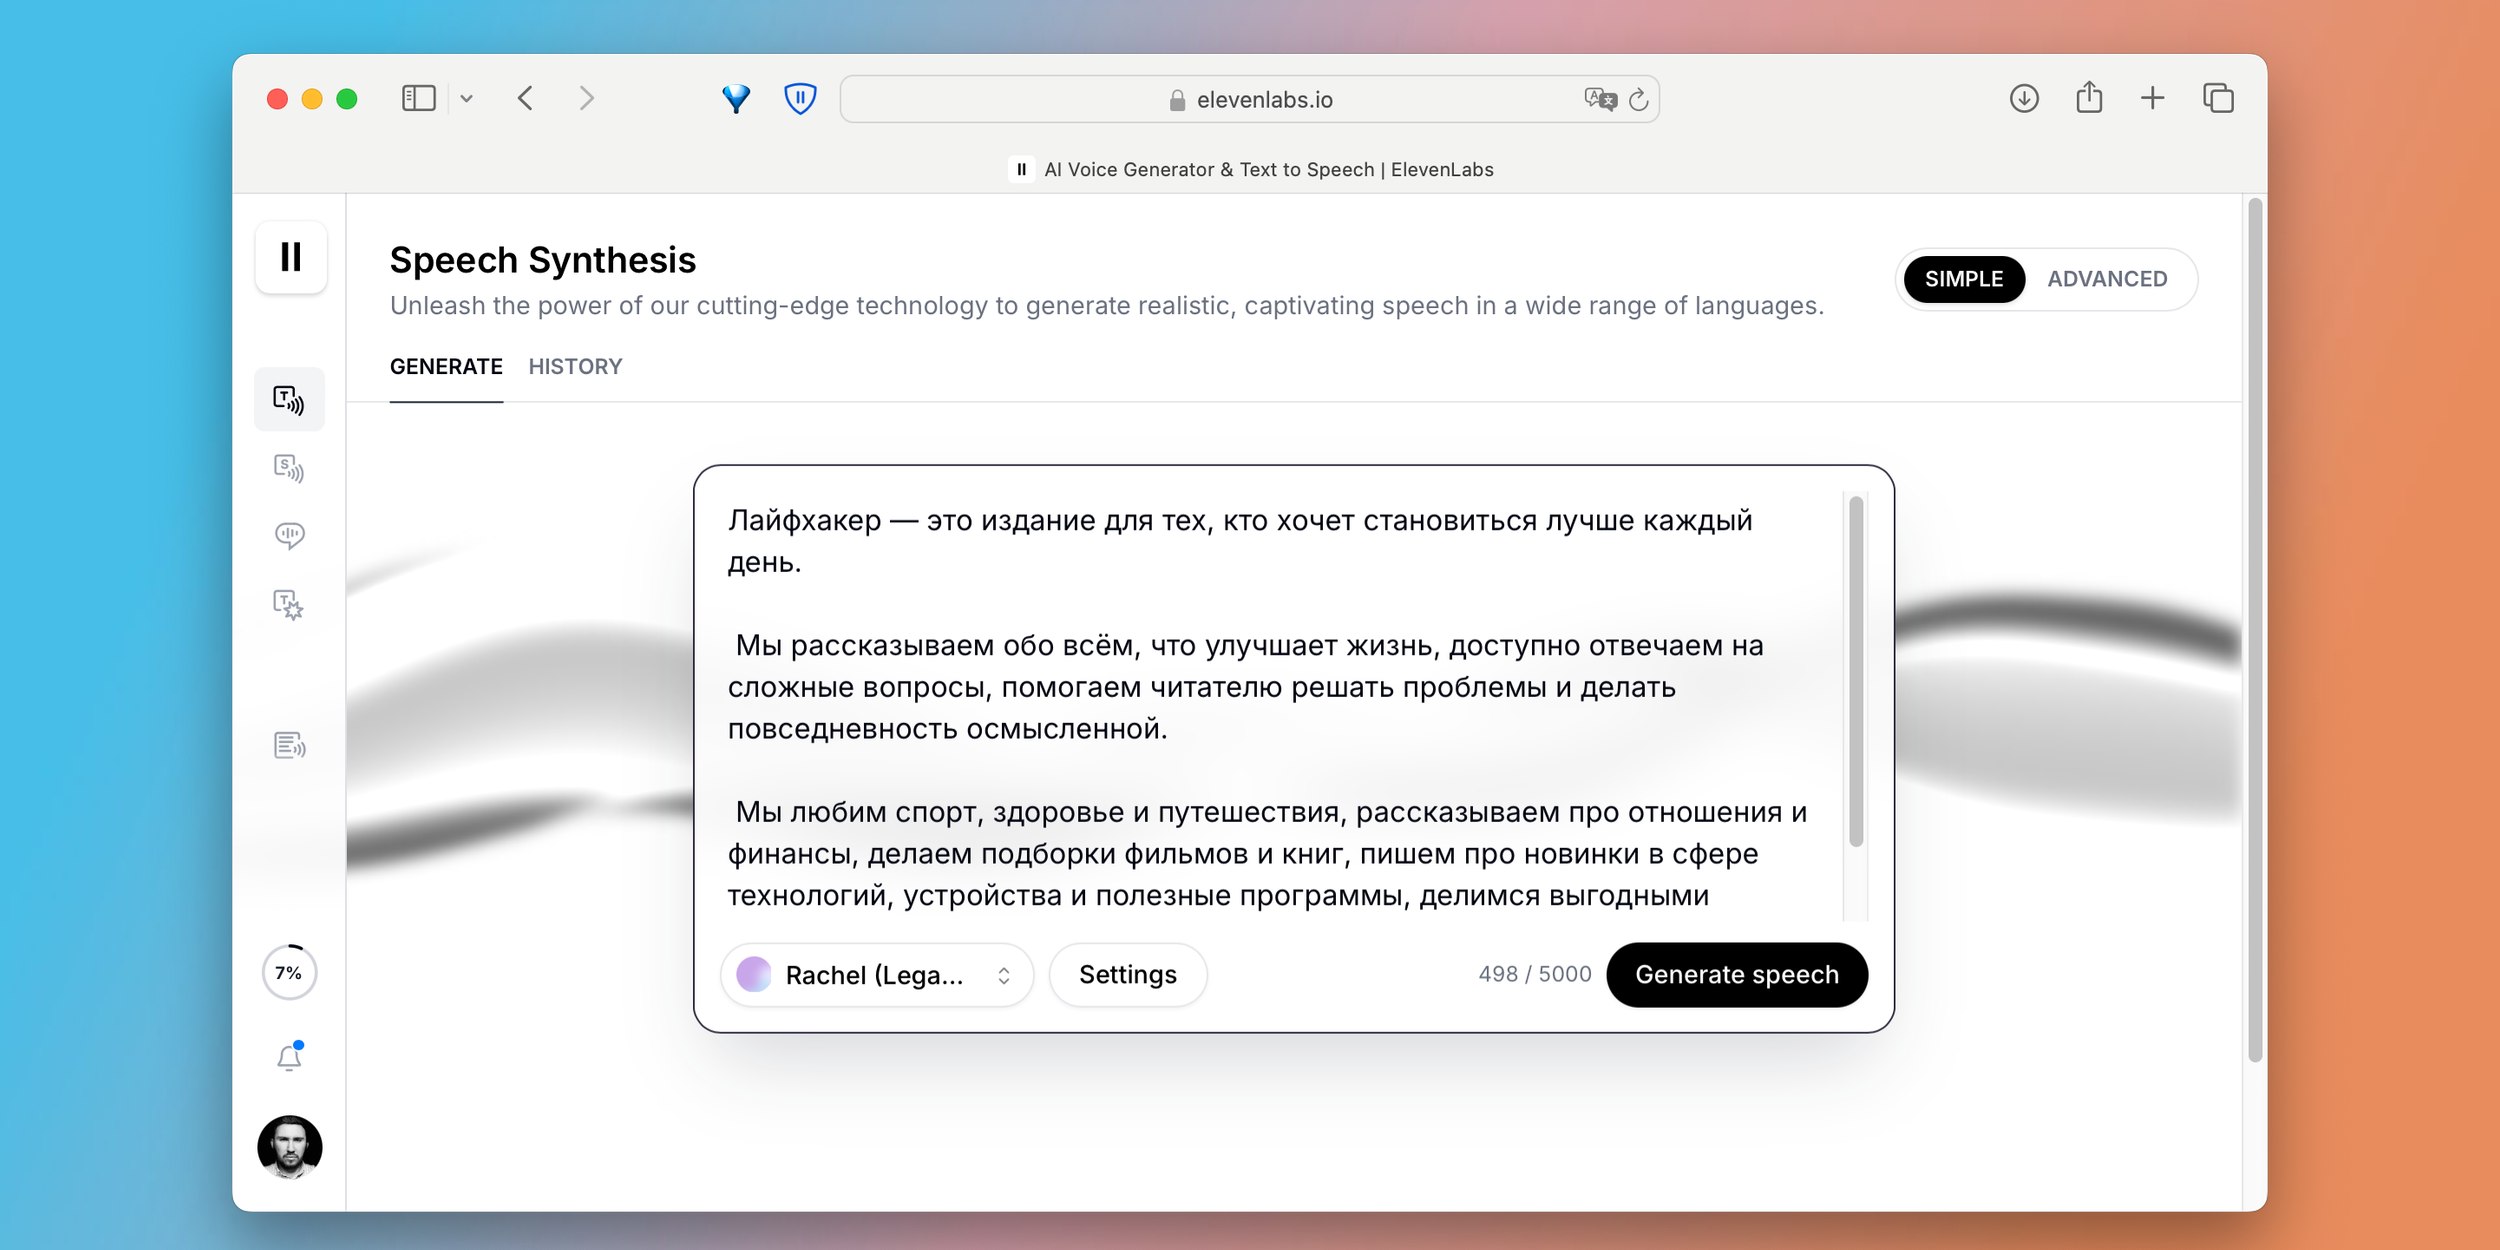
Для стабильного итога сперва разбейте сценарий на смысловые сцены, затем сгенерируйте короткие пробные фрагменты и проверьте ударения, имена, аббревиатуры и числа. После выбора голоса фиксируйте одинаковые параметры для всего цикла материалов. Длинный текст лучше озвучивать блоками: так проще пересобрать одну неудачную реплику и не трогать уже утвержденные части. В рекламной коммуникации полезно отдельно проверить начало и финальную фразу, потому что именно там чаще всего находится смысловой акцент.
Плюсы
- Выразительная интонация и хорошо различимые речевые характеры.
- Есть модели для качественной длинной речи и отдельные варианты для низкой задержки.
- Поддерживается русский язык и многоязычные проекты.
- Доступны API-сценарии для автоматизации выпуска контента.
Минусы
- Высокая выразительность требует аккуратно подготовленного текста: лишние знаки препинания заметно меняют подачу.
- Для корпоративного процесса нужно отдельно контролировать права на исходные голоса и записи.
- При больших объемах требуется заблаговременно продумать разбиение текста и контроль единообразия.
Кому подойдёт
Студиям локализации, авторам подкастов и аудиокниг, видеопродакшену, образовательным проектам и продуктовым командам, которым необходима выразительная речь и API.
Yandex SpeechKit
Yandex SpeechKit — облачная платформа синтеза речи с API и Playground. Для русскоязычных материалов важны разметка произношения, управление паузами, работа с ударениями, выбор темпа и формата вывода. Платформа подходит не только для файловой озвучки, но и для интеграции речи в сервисы, голосовые сценарии и автоматизированные коммуникации. В API v3 поддерживается потоковый синтез, а для ряда сценариев доступна TTS-разметка.
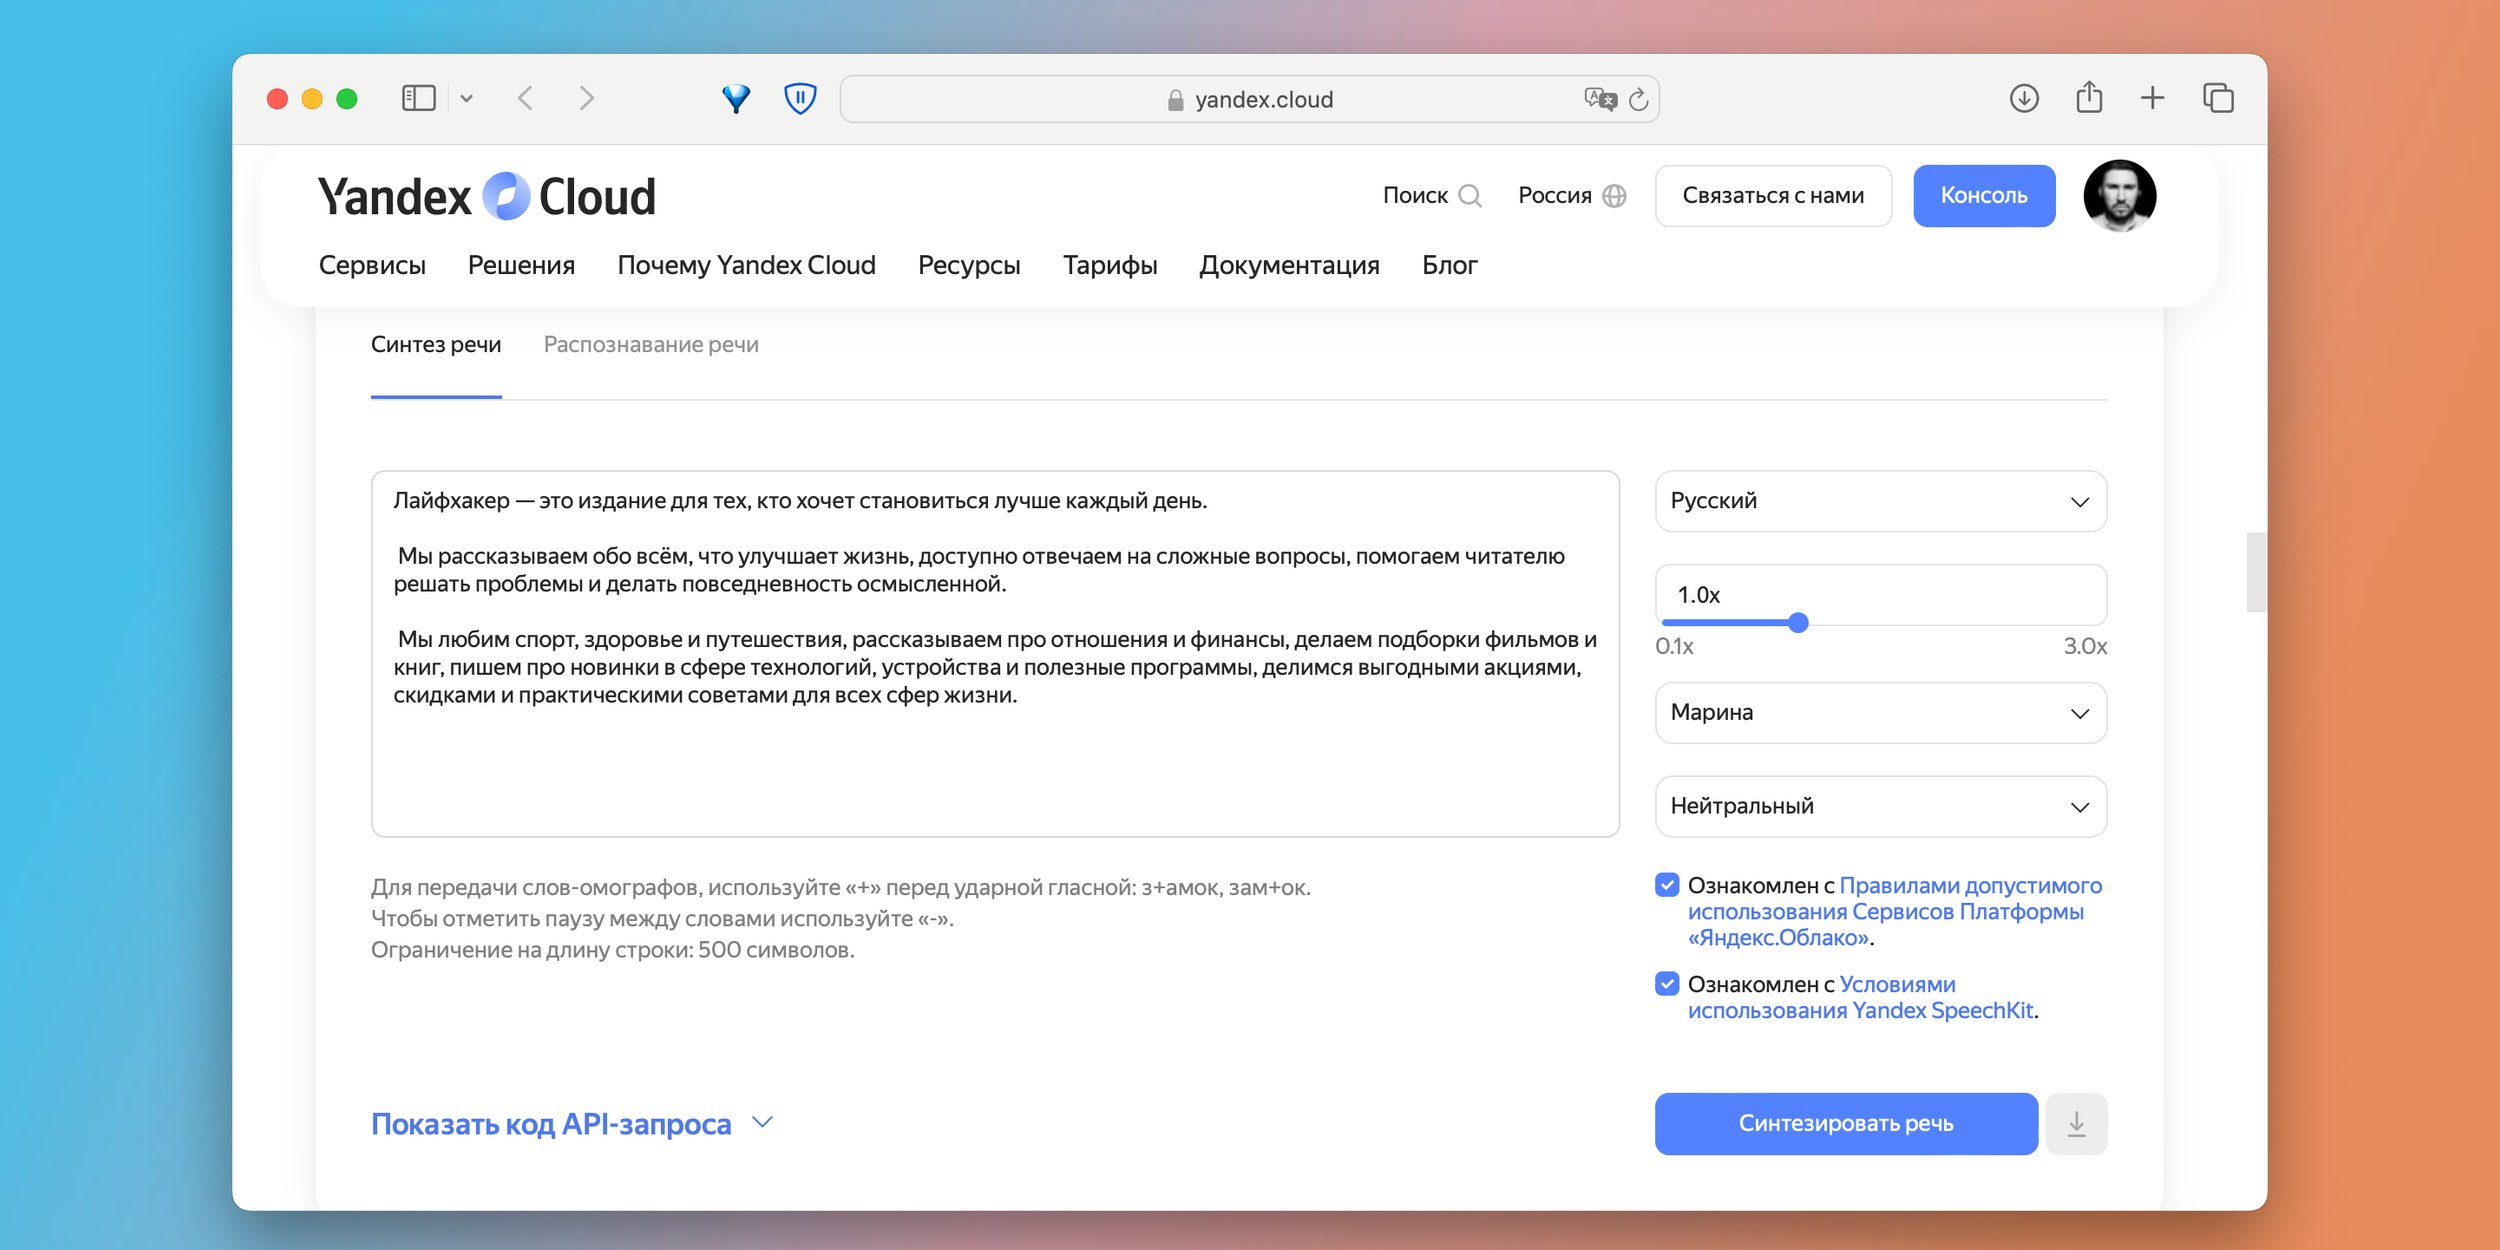
В маркетинговом проекте начните с словаря бренда: фамилии, наименования продуктов, иностранные термины, сокращения и даты. Отдельно подготовьте варианты произношения спорных слов и лишь после этого озвучивайте основной массив. Для контактных центров и продуктовых интерфейсов важна проверка коротких динамических фраз, для видеороликов — единый темп между абзацами. Контрольная прослушка проводится на реальных устройствах, где будет звучать материал, а не только в студийных наушниках.
Плюсы
- Глубокая работа с русским произношением и разметкой текста.
- Есть API и визуальная среда для проверки синтеза.
- Поддерживаются различные форматы аудио и сценарии автоматизации.
- Подходит для потоковой генерации и продуктовых интеграций.
Минусы
- Облачная архитектура требует настройки доступа и учетных данных проекта.
- Для простого разового видеоролика интерфейс облачной платформы избыточен в сравнении с готовой студией озвучки.
- При длинных материалах нужно заблаговременно продумать разбиение текста и словарь произношения.
Кому подойдёт
Российским продуктовым командам, разработчикам, контактным центрам, редакциям и сервисам, которым необходим управляемый русскоязычный TTS в облачной инфраструктуре.
Microsoft Azure AI Speech
Microsoft Azure AI Speech рассчитан на облачные продукты, корпоративные приложения и автоматизированную генерацию речи. Платформа поддерживает нейронные голоса и Speech Synthesis Markup Language — SSML, с помощью которой регулируют паузы, темп, громкость, произношение и переключение голосов. Такой уровень управления полезен для e-learning, цифровых помощников, голосовых интерфейсов и больших библиотек типовых реплик.
Сперва сформируйте шаблон SSML для типовых реплик: приветствие, объяснение, числовой блок, предупреждение, окончание. Потом проверяйте каждый тип данных отдельно — даты, проценты, валютные обозначения, сокращения и буквенно-цифровые коды. Для рекламного сценария полезно хранить текст и параметры синтеза вместе, чтобы повторная генерация через месяц не дала неожиданно другую структуру пауз.
Плюсы
- Развитые средства управления речью через SSML.
- Подходит для приложений, чат-ботов, обучения и больших корпоративных проектов.
- Есть программные интерфейсы и инфраструктурные средства Azure.
- Удобно стандартизировать повторяемые голосовые сценарии.
Минусы
- Для одиночной озвучки без интеграции облачная схема сложнее обычной веб-студии.
- Команде требуется дисциплина в хранении шаблонов и настроек синтеза.
- Набор возможностей различных голосов неодинаков, по этой причине профиль нужно проверять до массового выпуска.
Кому подойдёт
Корпоративным разработчикам, e-learning-командам, владельцам цифровых сервисов и контактным центрам, где важны API, контроль параметров и повторяемость.
Google Cloud Text-to-Speech
Google Cloud Text-to-Speech предлагает несколько семейств голосов для различных задач: от стандартной генерации до современных моделей, ориентированных на естественную разговорную подачу. В облачной схеме можно выбирать голос, формат аудио и метод синтеза, а для поддерживаемых моделей применять SSML и потоковую передачу текста. Это удобно для продуктов, где речь генерируется динамически из данных.
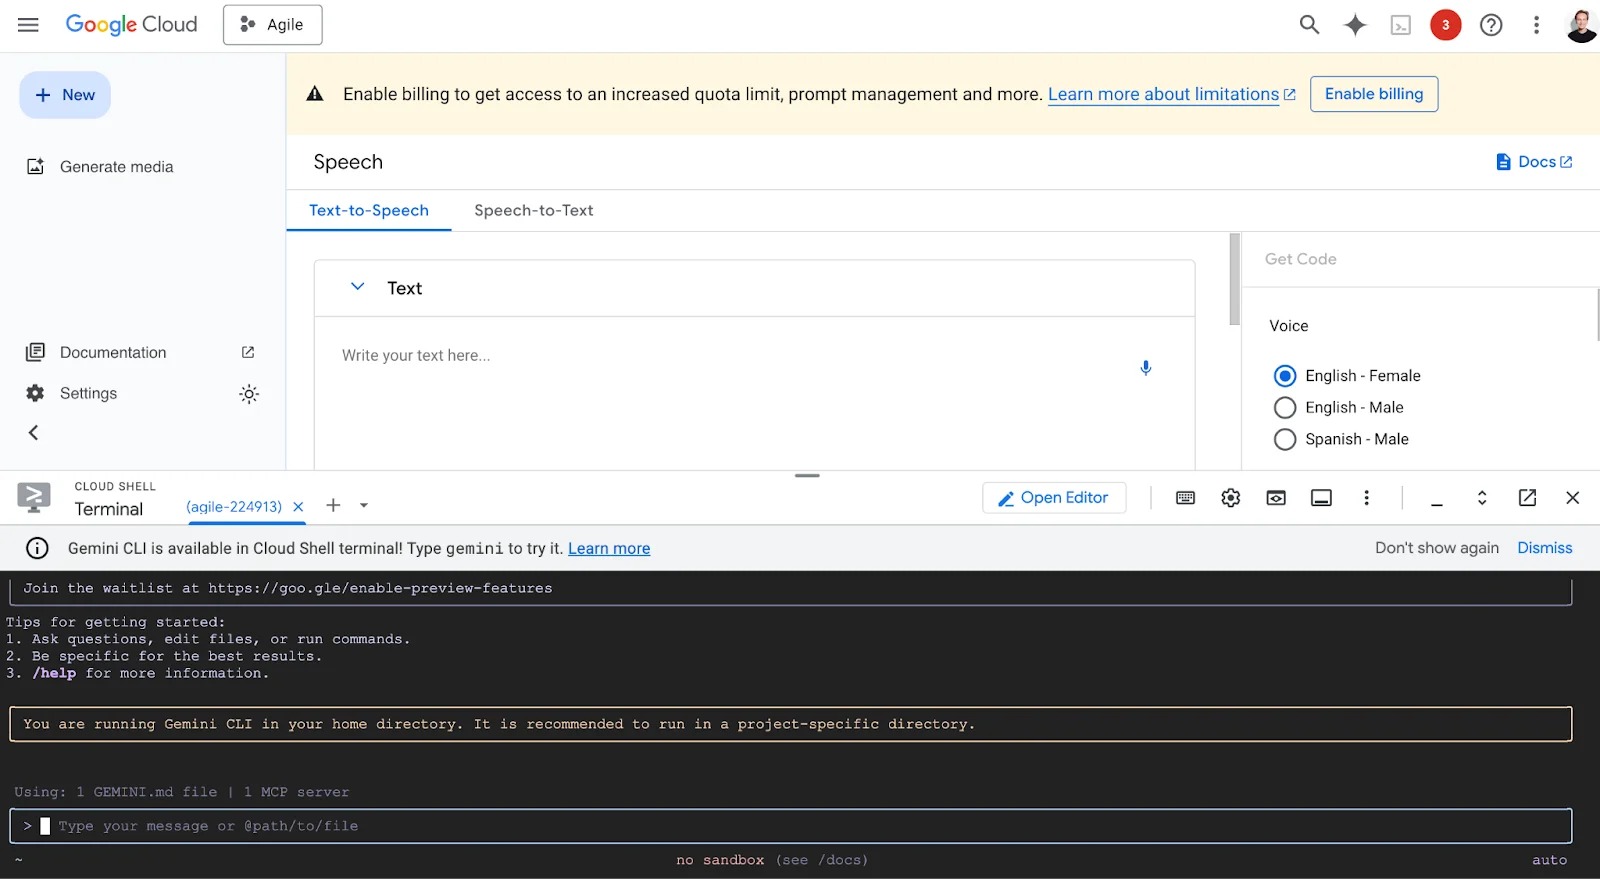
Для проекта сперва решите, что важнее: стабильная дикторская подача, разговорная естественность или минимальная задержка. После выбора семейства голосов сделайте одинаковый тестовый набор из десяти реплик: короткое объявление, длинный абзац, адресное обращение, число, дата, сокращение, бренд, вопрос, эмоциональная фраза и финальный призыв без рекламной гиперболы. Сопоставляйте не только приятность тембра, но и точность воспроизведения каждого типа данных.
Плюсы
- Несколько семейств голосов под различные сценарии.
- Есть программный доступ и потоковый синтез для интерактивных систем.
- Поддерживаются распространенные аудиоформаты.
- Хорошо вписывается в инфраструктуру Google Cloud.
Минусы
- Параметры управления отличаются между семействами голосов и требуют отдельной проверки.
- Инженерная интеграция сложнее визуальных сервисов для контент-менеджеров.
- Для небольшого видеоролика возможности облачной платформы часто избыточны.
Кому подойдёт
Разработчикам, сервисам с динамическим контентом, образовательным платформам и международным продуктам, уже работающим в Google Cloud.
Amazon Polly
Amazon Polly — облачный синтез речи в экосистеме AWS. Платформа предлагает стандартный, нейронный, long-form и generative-движки, по этой причине один сервис закрывает короткие системные реплики, длинное повествование и более разговорную генерацию. Текст передается как обычная строка или SSML, а итог возвращается в выбранном аудиоформате. Это удобный вариант для инфраструктуры, где остальная логика уже работает в AWS.
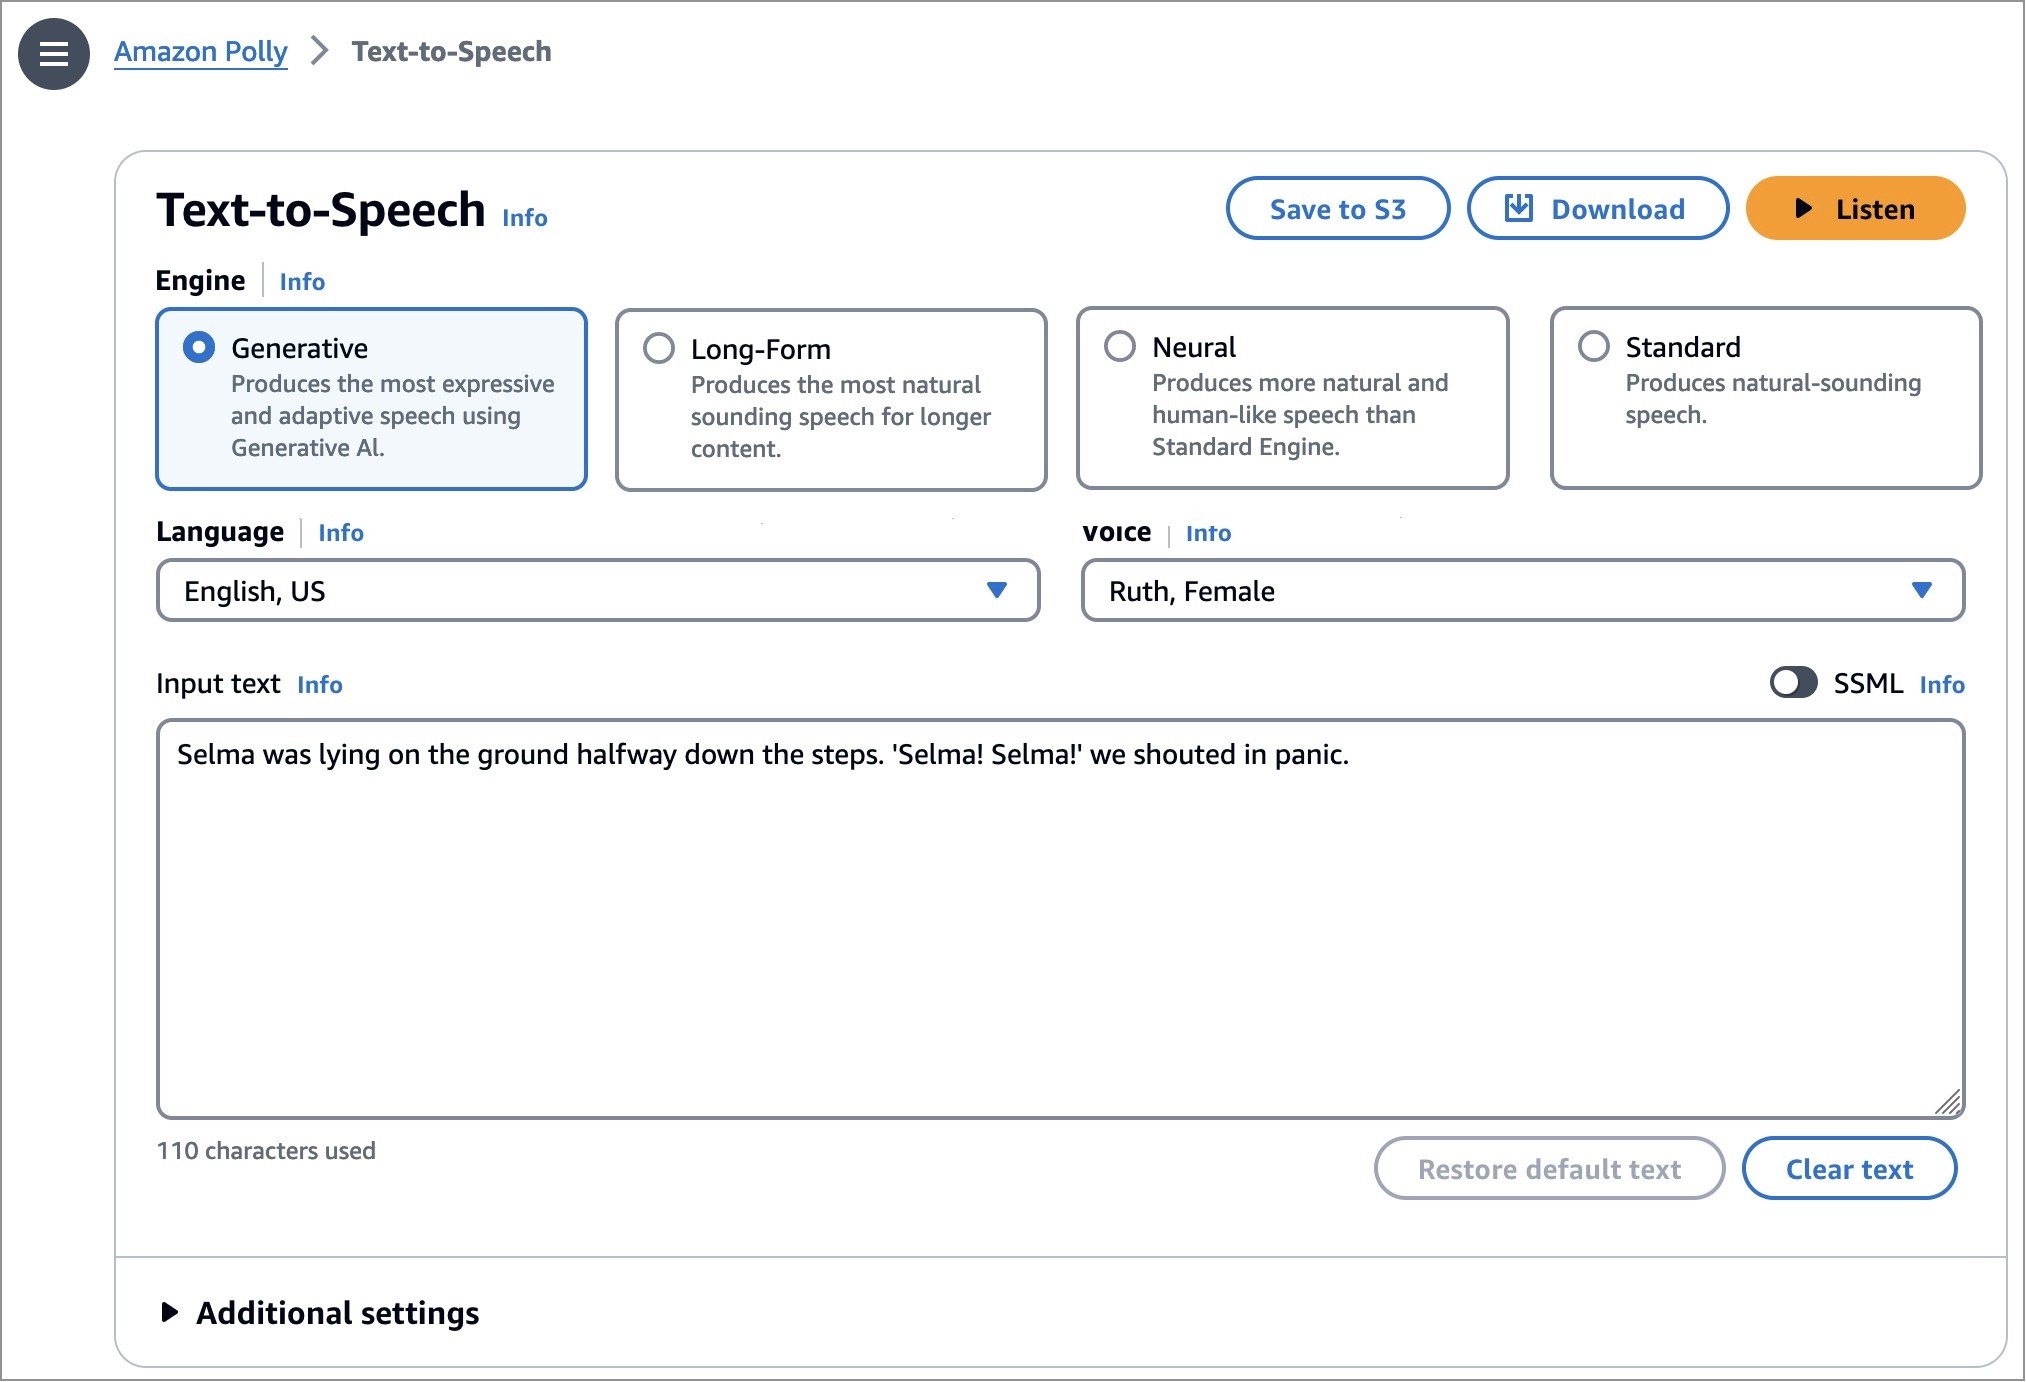
Перед запуском определите тип контента и применяйте для него один движок: не смешивайте различные режимы внутри одной серии без контрольного прослушивания. Создайте набор эталонных реплик с цифрами и наименованиями, проверьте темп и произношение, потом сохраните параметры рядом с кодом приложения. Для длинных программ и подкастов важно проверять стыки между частями, поскольку даже небольшое изменение тембра заметно при последовательном прослушивании.
Плюсы
- Несколько движков синтеза под различные типы речи.
- Поддерживается SSML и различные форматы вывода.
- Глубокая интеграция с сервисами AWS.
- Подходит для серверных и автоматизированных сценариев.
Минусы
- Контент-менеджеру без опыта AWS проще работать в визуальной студии.
- Набор голосов и движков различается по языкам и регионам.
- Для медийного монтажа понадобится отдельный редактор аудио или видео.
Кому подойдёт
Командам, использующим AWS, разработчикам голосовых функций, сервисам уведомлений и проектам с автоматической генерацией большого числа реплик.
Murf AI
Murf AI строится вокруг студийного рабочего процесса: текст разбивается на сцены или фрагменты, для каждого выбирают голос и параметры, после чего дорожка собирается в цельную озвучку. Такой формат понятен маркетинговым и обучающим командам, потому что напоминает редактор контента, а не облачную консоль разработчика. Сервис хорошо подходит для презентаций, демонстраций продукта и видеороликов с ровной дикторской подачей.
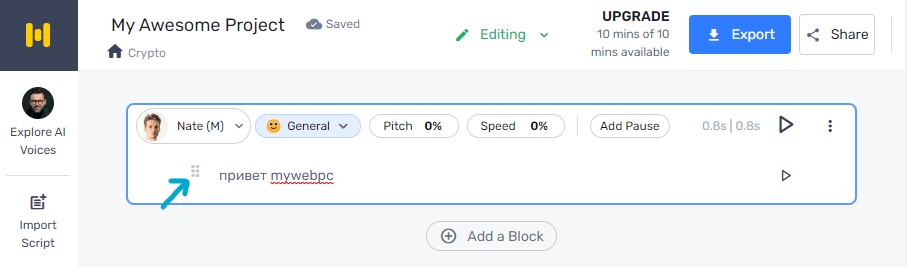
Работайте по сценам: одна мысль — один блок текста. Сперва выровняйте длину реплик по таймингу слайдов или кадров, потом подберите темп и лишь после этого доводите интонацию. При командной работе зафиксируйте выбранный голос и правила произношения наименований. Это снижает вероятность того, что два видеоролика одной кампании будут звучать как материалы различных брендов.
Плюсы
- Понятная студийная логика для контент-команд.
- Удобно собирать озвучку из отдельных сцен.
- Подходит для презентаций, объясняющих видеороликов и корпоративного обучения.
- Не требует отдельной облачной разработки для базовой работы.
Минусы
- Для потоковой серверной генерации облачные API-платформы гибче.
- Сложные эмоциональные сцены требуют больше ручной настройки и пробных генераций.
- Монтаж изображения и звука остается отдельной задачей, если проект выходит за рамки встроенной студии.
Кому подойдёт
Маркетологам, методистам, HR-командам, авторам презентаций и продуктовых видео, которым необходима студийная работа в браузере.
LOVO AI (Genny)
LOVO AI развивает Genny как среду для создания озвучки и видеоматериалов. Сервис полезен там, где текст, голос и визуальная часть проходят одну редакционную цепочку: рекламные объяснения, обучающие видеоролики, презентации, демо и социальный контент. Работа строится вокруг выбора голоса, разметки текста по сценам и последующей сборки материала.
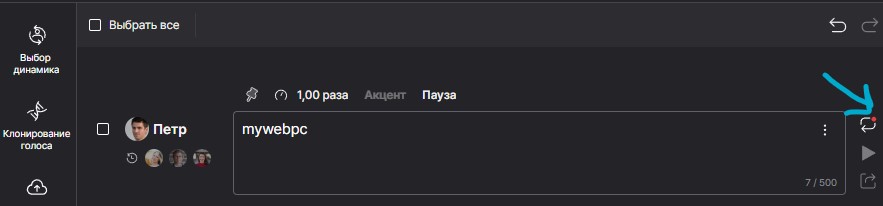
Начните с черновой озвучки всего сценария и проверьте продолжительность. Потом сократите длинные предложения, которые плохо совпадают с монтажным ритмом, и ещё раз сгенерируйте только измененные сцены. Для видеороликов с несколькими героями заблаговременно назначьте каждому персонажу один голос и не меняйте его в середине проекта. Проверка на телефоне обязательна: тонкие различия в тембре сильнее заметны в наушниках, а разборчивость — на встроенном динамике.
Плюсы
- Ориентирован на производство медиаконтента, а не только на выдачу аудиофайла.
- Удобно делить сценарий на сцены и персонажей.
- Подходит для объясняющих и обучающих видеороликов.
- Веб-формат не привязан к одному рабочему компьютеру.
Минусы
- Для разработчиков с полностью автоматизированным конвейером специализированные API проще масштабировать.
- Большой проект требует аккуратной структуры сцен и именования дублей.
- Для финального звукового мастеринга часто необходим отдельный редактор.
Кому подойдёт
Контент-студиям, дизайнерам презентаций, образовательным проектам и маркетинговым командам, которые собирают голос и визуал в одном рабочем процессе.
PlayAI
PlayAI, выросший из бренда PlayHT, сочетает веб-инструменты и API. Его удобно рассматривать как сервис для двух классов задач: ручной выпуск голосовых материалов и программное создание речи внутри продукта. Для редакции важны работа с длинным текстом и голоса под различные форматы, для разработчика — возможность встроить синтез в приложение и не собирать собственную TTS-инфраструктуру.
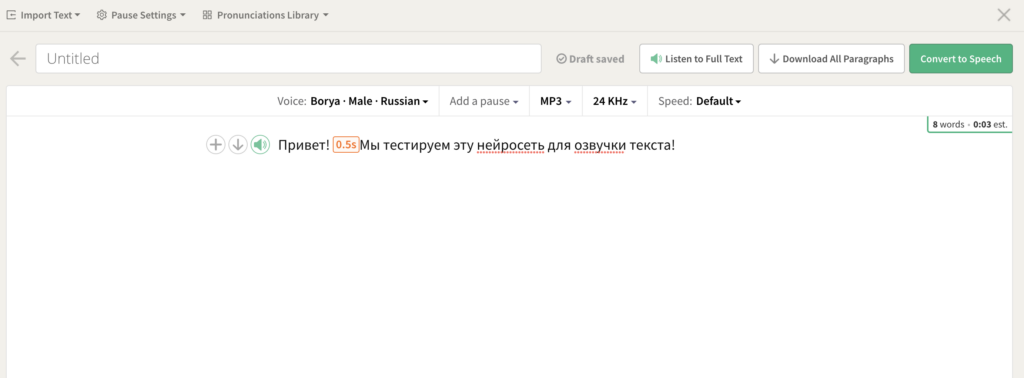
Сперва сделайте контрольный набор реплик в веб-интерфейсе и утвердите голос вместе с редактором. Лишь после этого переносите настройки в автоматизацию. Для продуктов с пользовательским текстом добавьте фильтрацию входных данных, ограничения длины и журналирование ошибок. Для видео храните исходный текст рядом с аудио: при изменении одной фразы команда быстро найдет, что именно требуется перегенерировать.
Плюсы
- Подходит и для ручной студийной работы, и для программной интеграции.
- Удобен для голосовых приложений и масштабируемых медиасценариев.
- Можно выстроить единый процесс от прототипа до API.
- Подходит для длинных материалов и серийного производства.
Минусы
- Команде необходимо заблаговременно определить единые настройки, иначе ручной и автоматический выпуск будут звучать по-разному.
- Финальная сборка видео обычно выполняется в отдельном редакторе.
- Для простых разовых задач функциональность API не дает практического преимущества.
Кому подойдёт
SaaS-командам, разработчикам голосовых агентов, медиа и продакшену, которым необходим путь от браузерного прототипа до автоматизации.
Speechify Studio
Speechify известен как экосистема для чтения текста вслух, а Studio переносит эту идею в производство озвучки. Сервис уместен для статей, учебных материалов, презентаций и видео, где приоритетом остается чистая, разборчивая подача. Контент-команда получает привычный браузерный процесс без настройки облачных учетных данных и программных библиотек.
Перед генерацией удалите из сценария технические пометки, ссылки и элементы, которые не должны звучать. Длинные предложения разделите на более короткие смысловые конструкции, а сложные имена вынесите в отдельный тест. После синтеза сопоставьте скорость речи с типом контента: обучающий материал обычно требует большего запаса пауз, чем динамичный короткий видеоролик.
Плюсы
- Простой браузерный рабочий процесс.
- Подходит для образовательного и информационного контента.
- Удобно быстро превращать готовые тексты в голосовые версии.
- Не требует навыков работы с облачной инфраструктурой.
Минусы
- Для сложных интеграций специализированные API дают больше инженерного контроля.
- Выразительность зависит от выбранного голоса и качества подготовки текста.
- Монтаж сложного саунд-дизайна выполняется вне основного сценария синтеза.
Кому подойдёт
Редакциям, авторам курсов, корпоративным коммуникациям и командам, которым необходимо систематически создавать понятную озвучку из уже готового текста.
NaturalReader
NaturalReader хорошо вписывается в задачи озвучивания документов и длинных информационных материалов. Его сильная сторона — простой сценарий: загрузить или вставить текст, выбрать голос и получить звуковую версию без сложной студийной подготовки. Это полезно для доступности контента, обучения, чернового прослушивания статей и проверки того, насколько естественно написан сценарий. Для отдельного аудиофайла полезен и преобразование текста в аудиофайл с разбором форматов и проверкой итога.
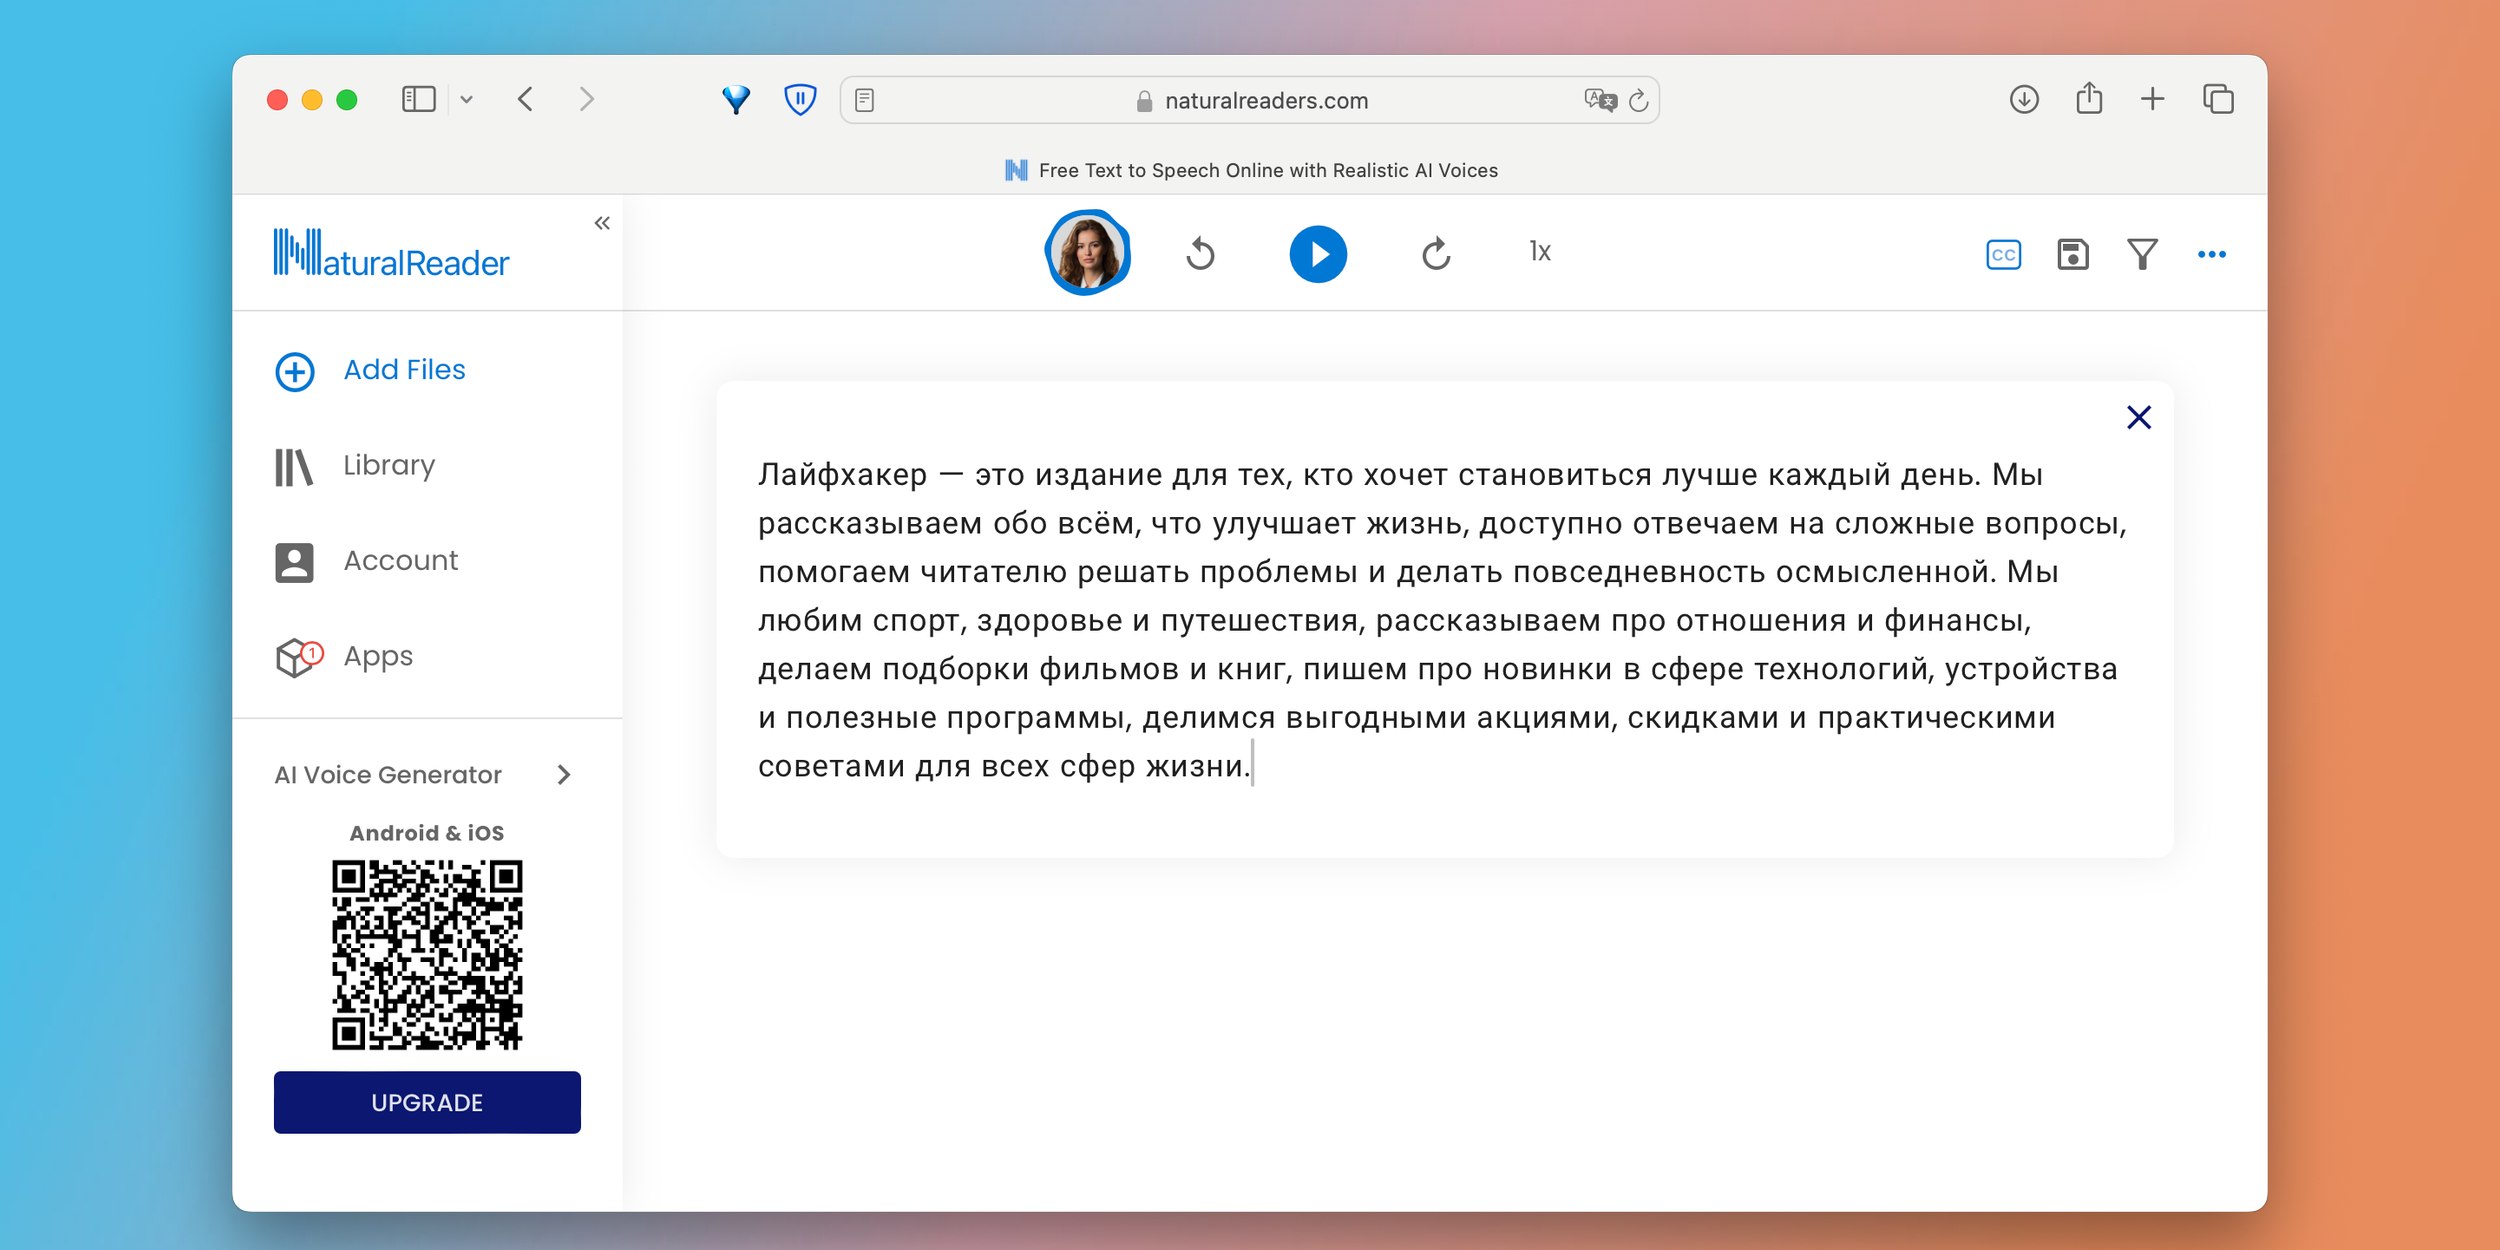
Применяйте NaturalReader как редакторский тест до финальной записи: прослушайте текст целиком и отметьте места, где синтезатор спотыкается или фраза звучит слишком длинно. Такие места часто трудны и для живого диктора. После правки повторите прослушивание, затем переносите утвержденную версию в финальный канал публикации.
Плюсы
- Быстрый переход от документа к озвученной версии.
- Удобен для длинных информационных материалов.
- Подходит для задач доступности и обучения.
- Низкий порог входа для редакторов и авторов.
Минусы
- Для рекламных видеороликов со сложной актерской подачей необходимы более гибкие инструменты.
- Финальная интеграция с монтажом выполняется отдельно.
- Сценарии масштабной автоматизации требуют отдельной инженерной оценки.
Кому подойдёт
Редакторам, преподавателям, авторам инструкций, командам доступности и всем, кто часто превращает документы и статьи в аудио.
Voicemaker
Voicemaker ориентирован на пользователей, которым важна ручная настройка итога без написания кода. В одном браузерном окне удобно работать с голосом, скоростью, паузами и форматом итога. Сервис подходит для коротких рекламных реплик, объяснений, закадрового текста и технических сообщений, где требуется быстро сопоставить несколько вариантов подачи.
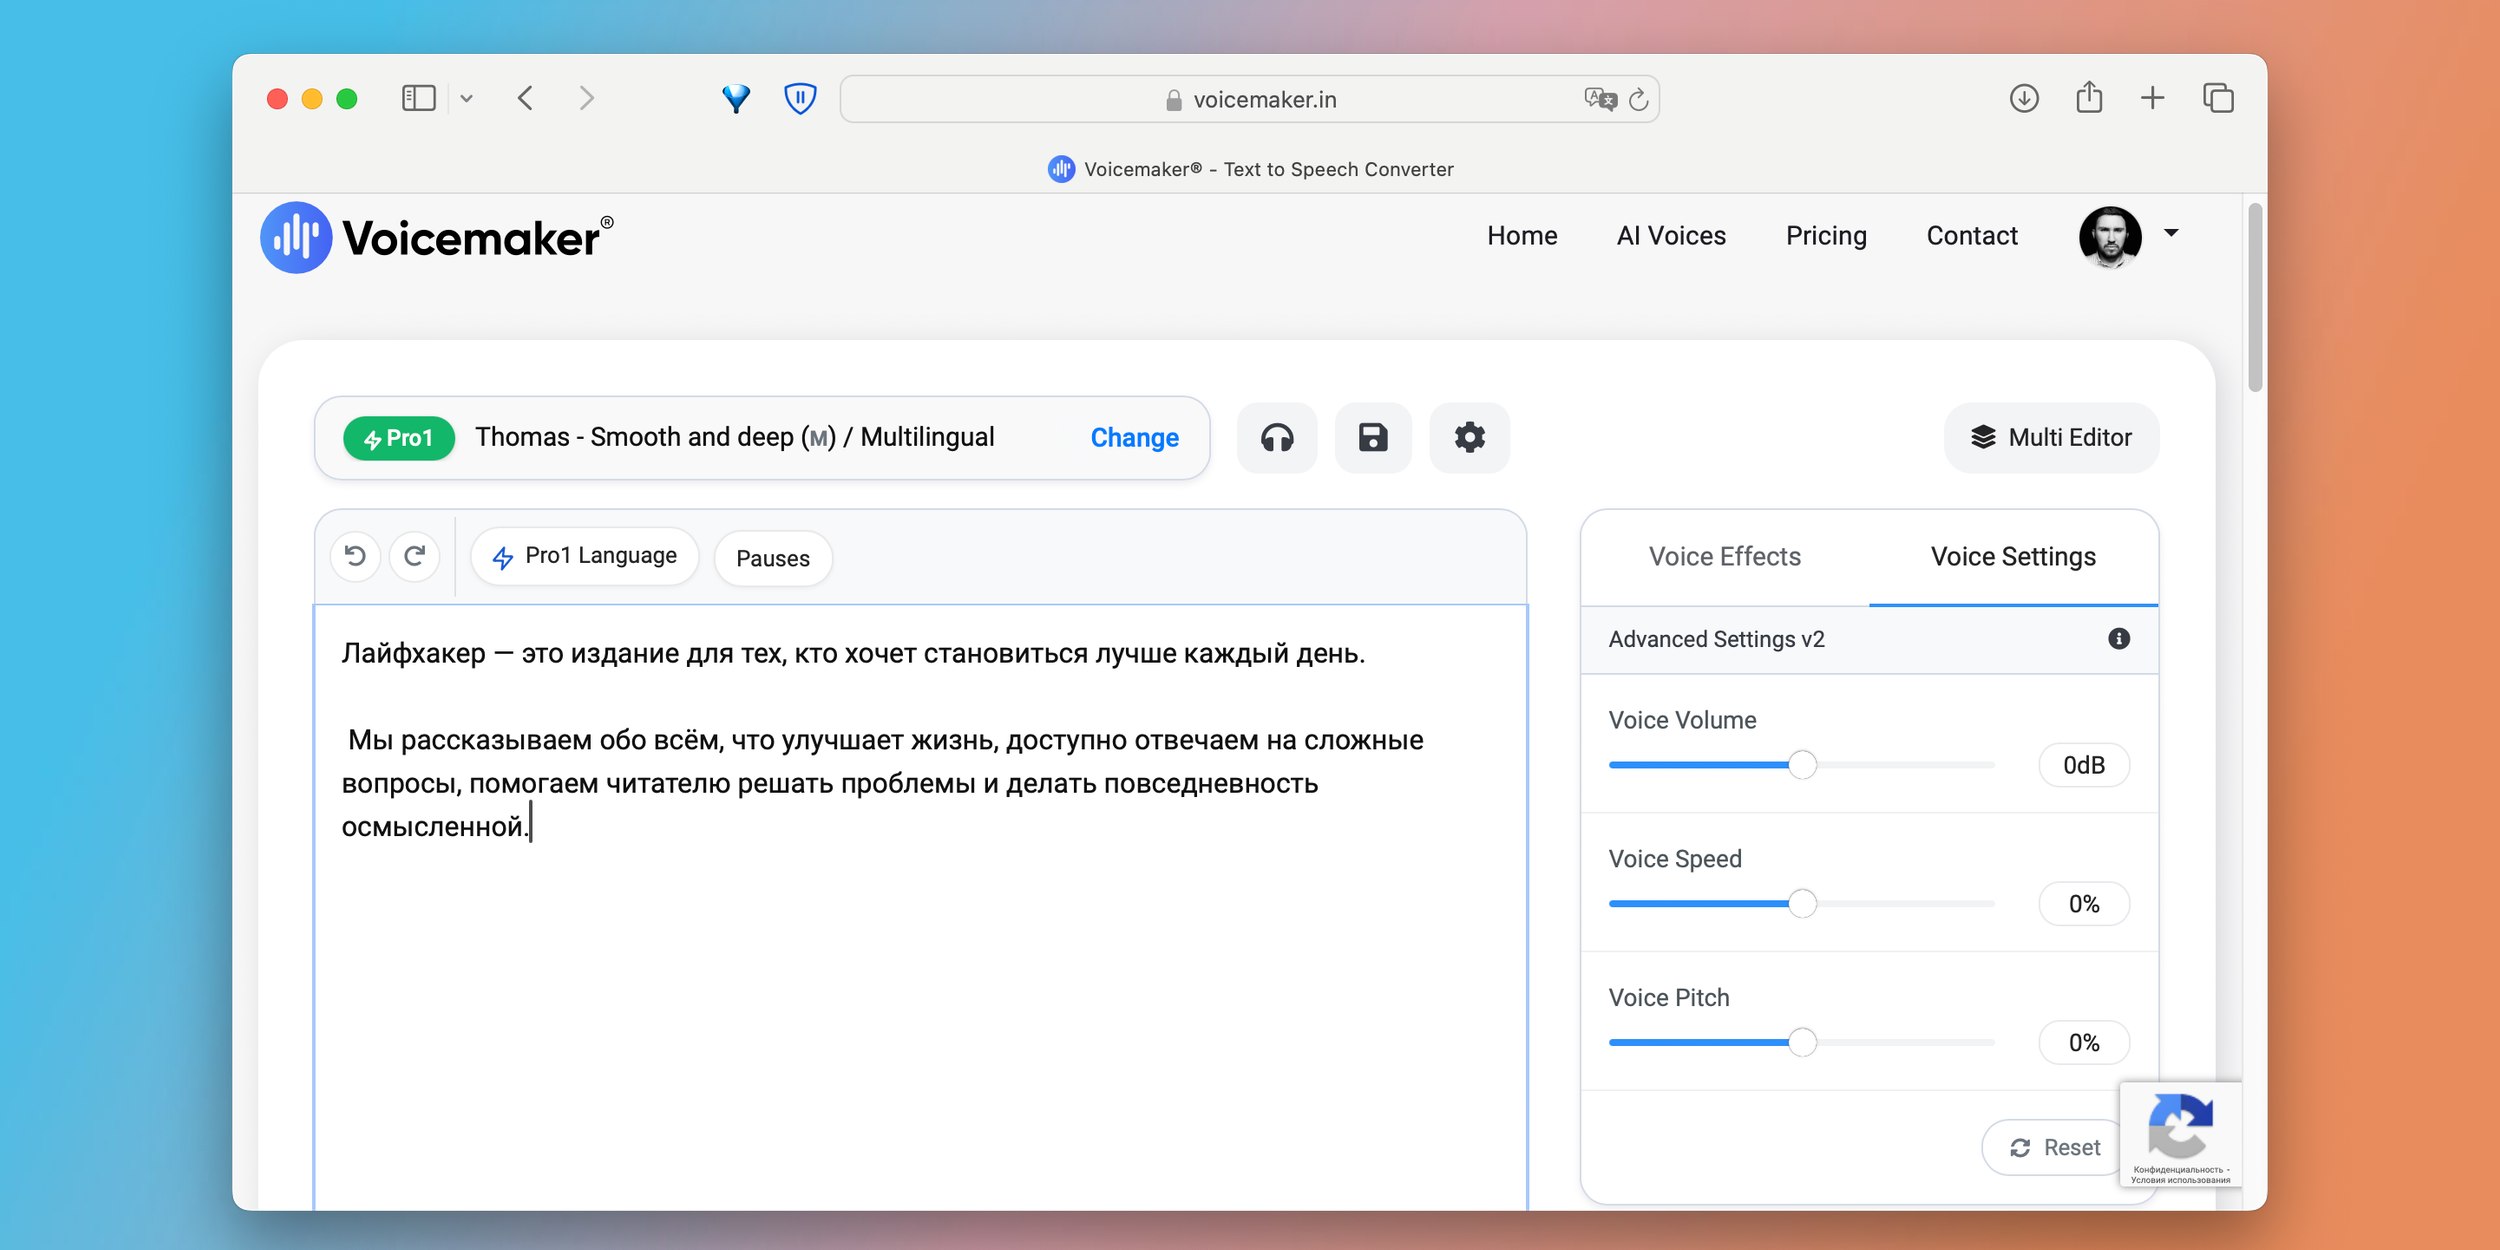
Не меняйте сразу все параметры. Сперва выберите голос и оставьте нейтральный темп, затем отрегулируйте паузы и лишь после этого корректируйте скорость. Так легче понять, какая настройка в самом деле улучшила речь. Для серии материалов сохраняйте текстовые шаблоны со знаками препинания: именно они часто сильнее влияют на ритм, чем небольшое изменение скорости.
Плюсы
- Много ручных настроек в браузерном интерфейсе.
- Удобно быстро сопоставлять варианты голоса и темпа.
- Подходит для коротких и средних по длине материалов.
- Не требует установки настольной программы.
Минусы
- Большое число настроек провоцирует избыточную ручную подстройку.
- Для командной работы необходимы внутренние правила, иначе каждый автор получает свой стиль речи.
- Монтаж с видео и музыкой выполняется в другом инструменте.
Кому подойдёт
Авторам видеороликов, специалистам по рекламе, редакторам и небольшим командам, которым важен гибкий ручной TTS без программирования.
Narakeet
Narakeet отличается фокусом на презентации и объясняющие видео. Сервис связывает текстовый сценарий с визуальными слайдами, по этой причине в особенности полезен для продуктовых демонстраций, инструкций, внутренних курсов и презентаций, которые необходимо быстро превратить в озвученный видеоролик. Такой подход уменьшает ручную синхронизацию между сменой слайда и репликой.
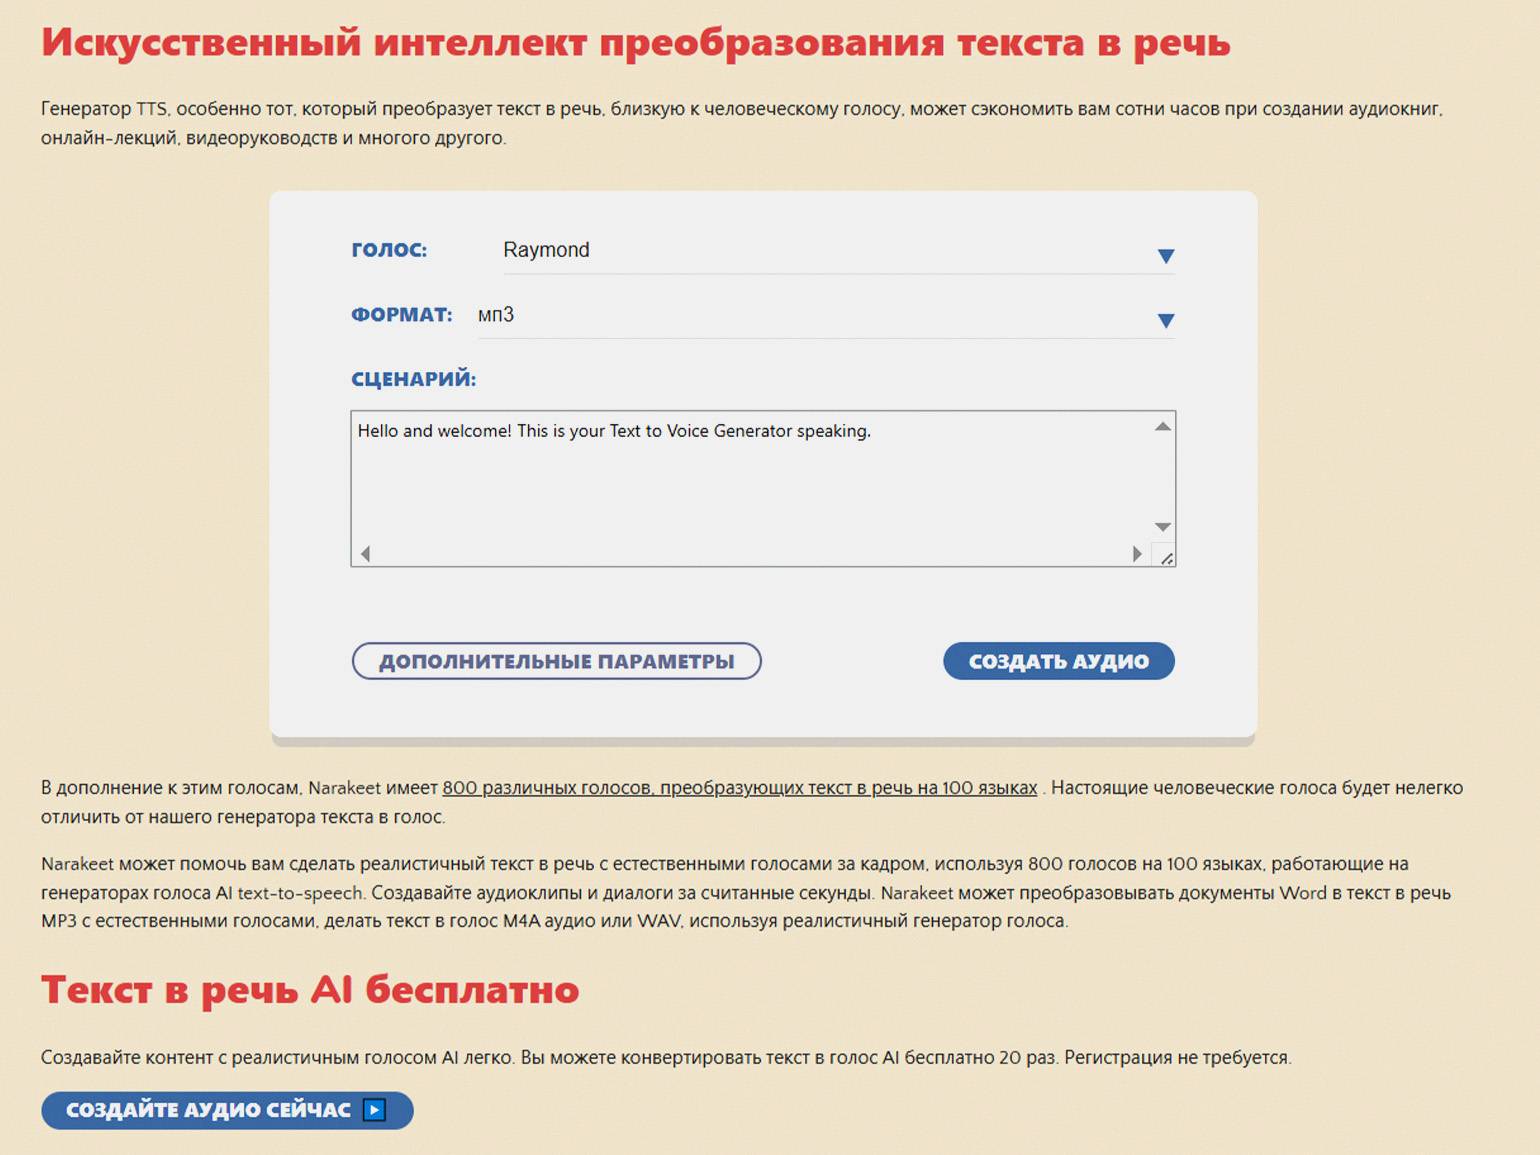
Пишите сценарий рядом со структурой презентации. Один слайд должен содержать одну смысловую мысль и одну связанную реплику. Если голос не успевает закончить фразу до смены визуала, сперва сокращайте текст, а не ускоряйте речь: избыточный темп ухудшает понимание учебного материала. После сборки проверьте первые две и последние две секунды каждого перехода.
Плюсы
- Удобная связка презентации, сценария и синтезированной речи.
- Подходит для инструкций, обучающих видеороликов и демонстраций продукта.
- Снижает объем ручной синхронизации слайдов и голоса.
- Работает в браузере.
Минусы
- Для художественной озвучки и актерских сцен формат слишком утилитарный.
- Сложный видеомонтаж потребует отдельного редактора.
- Качество материала сильно зависит от грамотной структуры слайдов и сценария.
Кому подойдёт
Методистам, продуктовым маркетологам, пресейл-командам и авторам инструкций, которые превращают презентации в озвученные видео.
Zvukogram
Zvukogram зачастую встречается в русскоязычных подборках благодаря простому онлайн-сценарию и ориентации на работу с текстом без отдельной установки. Он удобен для черновой озвучки видеороликов, поздравительных материалов, учебных текстов и коротких диалогов. Для российской редакции важен понятный интерфейс и возможность быстро проверить, как звучит конкретная фраза на русском.
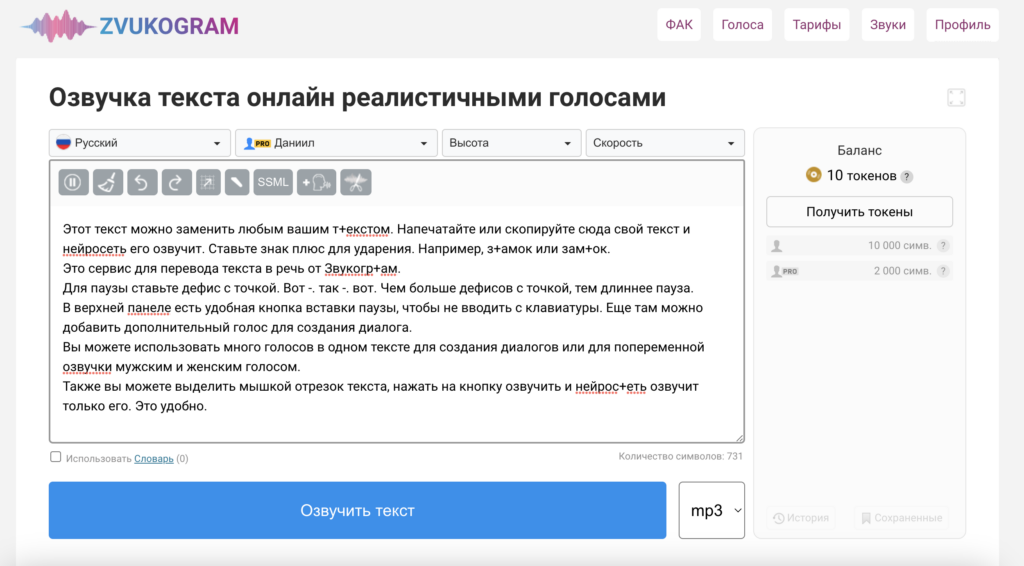
Сперва очистите текст от длинных скобок, маркированных перечислений и служебных пометок. Для диалога разделите реплики по ролям и соберите их отдельно. После генерации сведите дорожки в редакторе и проверьте громкость между голосами. Для рекламного видеоролика добавочный контроль — продолжительность финальной фразы: она должна укладываться в экран с брендовым сообщением без ускорения.
Плюсы
- Русскоязычный интерфейс и понятный сценарий работы.
- Удобно делать быстрые пробы отдельных реплик.
- Подходит для коротких видеороликов, учебных материалов и простых диалогов.
- Не требует установки программы.
Минусы
- Для крупных продуктовых интеграций облачные платформы дают больше инфраструктурных возможностей.
- Финальная обработка и монтаж звука выполняются отдельно.
- Стабильность стиля в большой серии требует фиксировать выбранные параметры ручным способом.
Кому подойдёт
Небольшим редакциям, авторам видеороликов и русскоязычным командам, которым необходим простой онлайн-инструмент без сложной настройки.
Robivox
Robivox рассчитан на прямой сценарий преобразования текста в речь. Это полезно, когда задача ограничена голосовой дорожкой и не требует сложной студии: короткая инструкция, объявление, фрагмент видеоролика, учебная вставка или черновой дикторский вариант. Сервис систематически встречается в независимых русскоязычных обзорах как один из простых методов быстро получить TTS-запись.
Делите материал на абзацы по 2–4 предложения и проверяйте каждый до объединения. Сразу отмечайте места с неправильным ударением и переписывайте их более однозначно. После сборки нормализуйте громкость уже в аудио- или видеоредакторе, чтобы отдельные куски не воспринимались как различные записи.
Плюсы
- Простой онлайн-сценарий без сложной подготовки.
- Подходит для быстрых черновиков и коротких голосовых вставок.
- Удобен для русскоязычных пользователей.
- Легко проверить несколько вариантов одной реплики.
Минусы
- Меньше возможностей для корпоративной автоматизации, чем у облачных API.
- Финальный монтаж и обработка остаются внешней задачей.
- Для сложной драматургии требуется больше ручных проб.
Кому подойдёт
Авторам коротких видео, преподавателям, малому бизнесу и редакторам, которым необходима быстрая голосовая дорожка из готового текста.
SteosVoice
SteosVoice известен как сервис с акцентом на разнообразные голосовые образы и контентные сценарии. Он подходит для видеороликов, игровых и развлекательных форматов, а также для обычного закадрового текста. В работе в особенности важно отделять стилизованный голос от нейтрального дикторского: выразительный персонаж помогает развлечению, но может мешать деловой презентации.
Сперва определите роль голоса: диктор, герой, комментатор или нейтральный помощник. Не выбирайте тембр только по эффектности демо. Сгенерируйте один и тот же абзац в двух-трех вариантах и дайте коллегам оценить разборчивость без подсказки, какой вариант вам нравится. Для брендового контента победителем должен стать голос, который лучше доносит смысл, а не самый необычный.
Плюсы
- Выразительные голосовые образы для развлекательного контента.
- Подходит для персонажей, видеороликов и творческих экспериментов.
- Можно за короткое время сопоставлять различные характеры речи.
- Не требует настольной установки для базового сценария.
Минусы
- Яркий голос легко становится отвлекающим элементом в деловом контенте.
- Для единого брендового звучания необходим строгий отбор и фиксация голоса.
- Финальное сведение выполняется в отдельном редакторе.
Кому подойдёт
Авторам развлекательных видео, игровых проектов, стримингового и персонажного контента, а также командам, которым необходимы заметные голосовые характеры.
Resemble AI
Resemble AI ориентирован на разработчиков и команды, которые рассматривают голос как часть продукта, а не только как разовый аудиофайл. Платформа поддерживает синтез речи и сценарии работы с пользовательскими голосовыми моделями. Это делает ее подходящей для интерактивных приложений, брендовых голосов и серийных материалов, где важна узнаваемость одного и того же голосового образа.
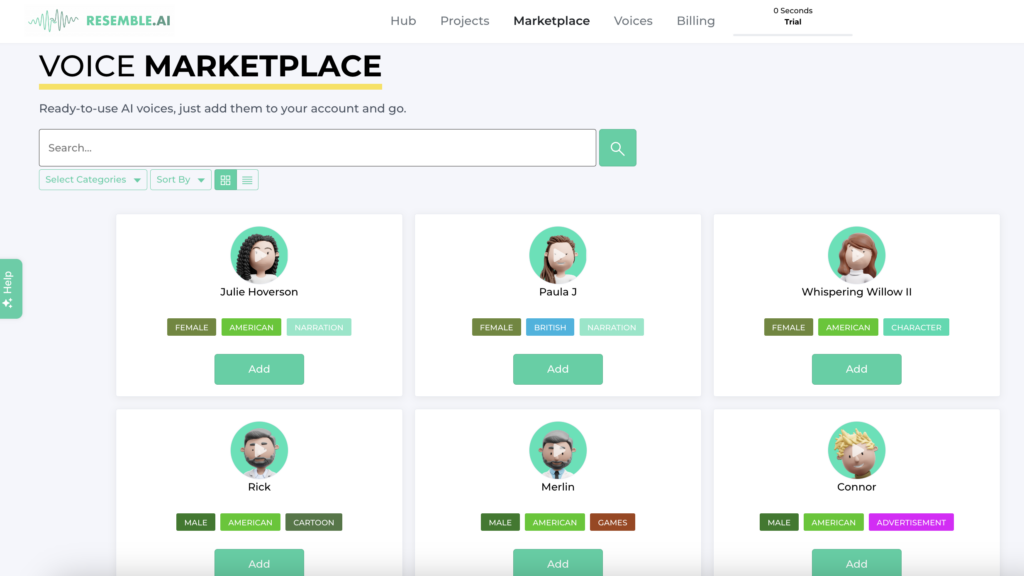
Перед созданием собственного голосового профиля оформите внутреннее согласие на применение записи и правила доступа к исходным данным. Отдельно ограничьте, кто может запускать генерацию и для каких форматов. Для контроля качества храните утвержденный набор тестовых реплик: новый релиз или настройка прогоняется на тех же фразах и сопоставляется с предыдущим итогом.
Плюсы
- Подходит для продуктовой интеграции и программного синтеза.
- Удобен для проектов с постоянным голосовым образом.
- Есть API-сценарии для автоматизации.
- Хорошо вписывается в персонализированные голосовые продукты.
Минусы
- Работа с пользовательскими голосами требует строгого управления согласием и правами.
- Для простого разового видеоролика функциональность платформы избыточна.
- Контентной команде без разработчика сложнее выстроить полный автоматизированный процесс.
Кому подойдёт
Продуктовым командам, разработчикам интерактивных сервисов, брендам с постоянным голосовым образом и проектам персонализированной коммуникации.
Podcastle
Podcastle объединяет работу с речью и подкастовым производством. Для маркетолога это полезно, когда синтезированный голос становится частью интервью, брендового подкаста, видеоподкаста или обучающего выпуска. В одной рабочей среде проще управлять текстовыми фрагментами, голосовыми дорожками и базовым редактированием, чем переносить каждый дубль между различными сервисами. Сценарий удобно сверять с материалом про подготовку подкаста от сценария до публикации.
Сперва соберите черновой выпуск с нейтральной озвучкой, затем решите, какие фрагменты в самом деле требуют синтетического голоса. В подкасте не стоит озвучивать нейросетью весь материал только ради технологии: заставки, рубрики, переходы и справочные вставки часто работают лучше. После сборки измерьте разницу громкости между живыми и синтетическими фрагментами и выровняйте ее до публикации.
Плюсы
- Ориентирован на разговорный и подкастовый рабочий процесс.
- Удобно сочетать синтетические и записанные голосовые фрагменты.
- Работает в браузере.
- Подходит для брендовых подкастов и образовательных выпусков.
Минусы
- Для сложного саунд-дизайна потребуется специализированный аудиоредактор.
- Не каждый подкаст выигрывает от большого количества синтетической речи.
- Для серверной генерации в продукте необходимы более специализированные API-инструменты.
Кому подойдёт
Подкаст-командам, PR-отделам, образовательным проектам и авторам разговорного контента, которым необходима единая веб-студия.
APIHost
APIHost занимает промежуточную позицию между простой онлайн-озвучкой и сервисом для разработчика. Такой формат удобен небольшим российским проектам: редактор проверяет голос в веб-интерфейсе, а затем команда переносит повторяемую генерацию в автоматизированный процесс. В независимых подборках сервис систематически упоминается как русскоязычный инструмент синтеза речи.
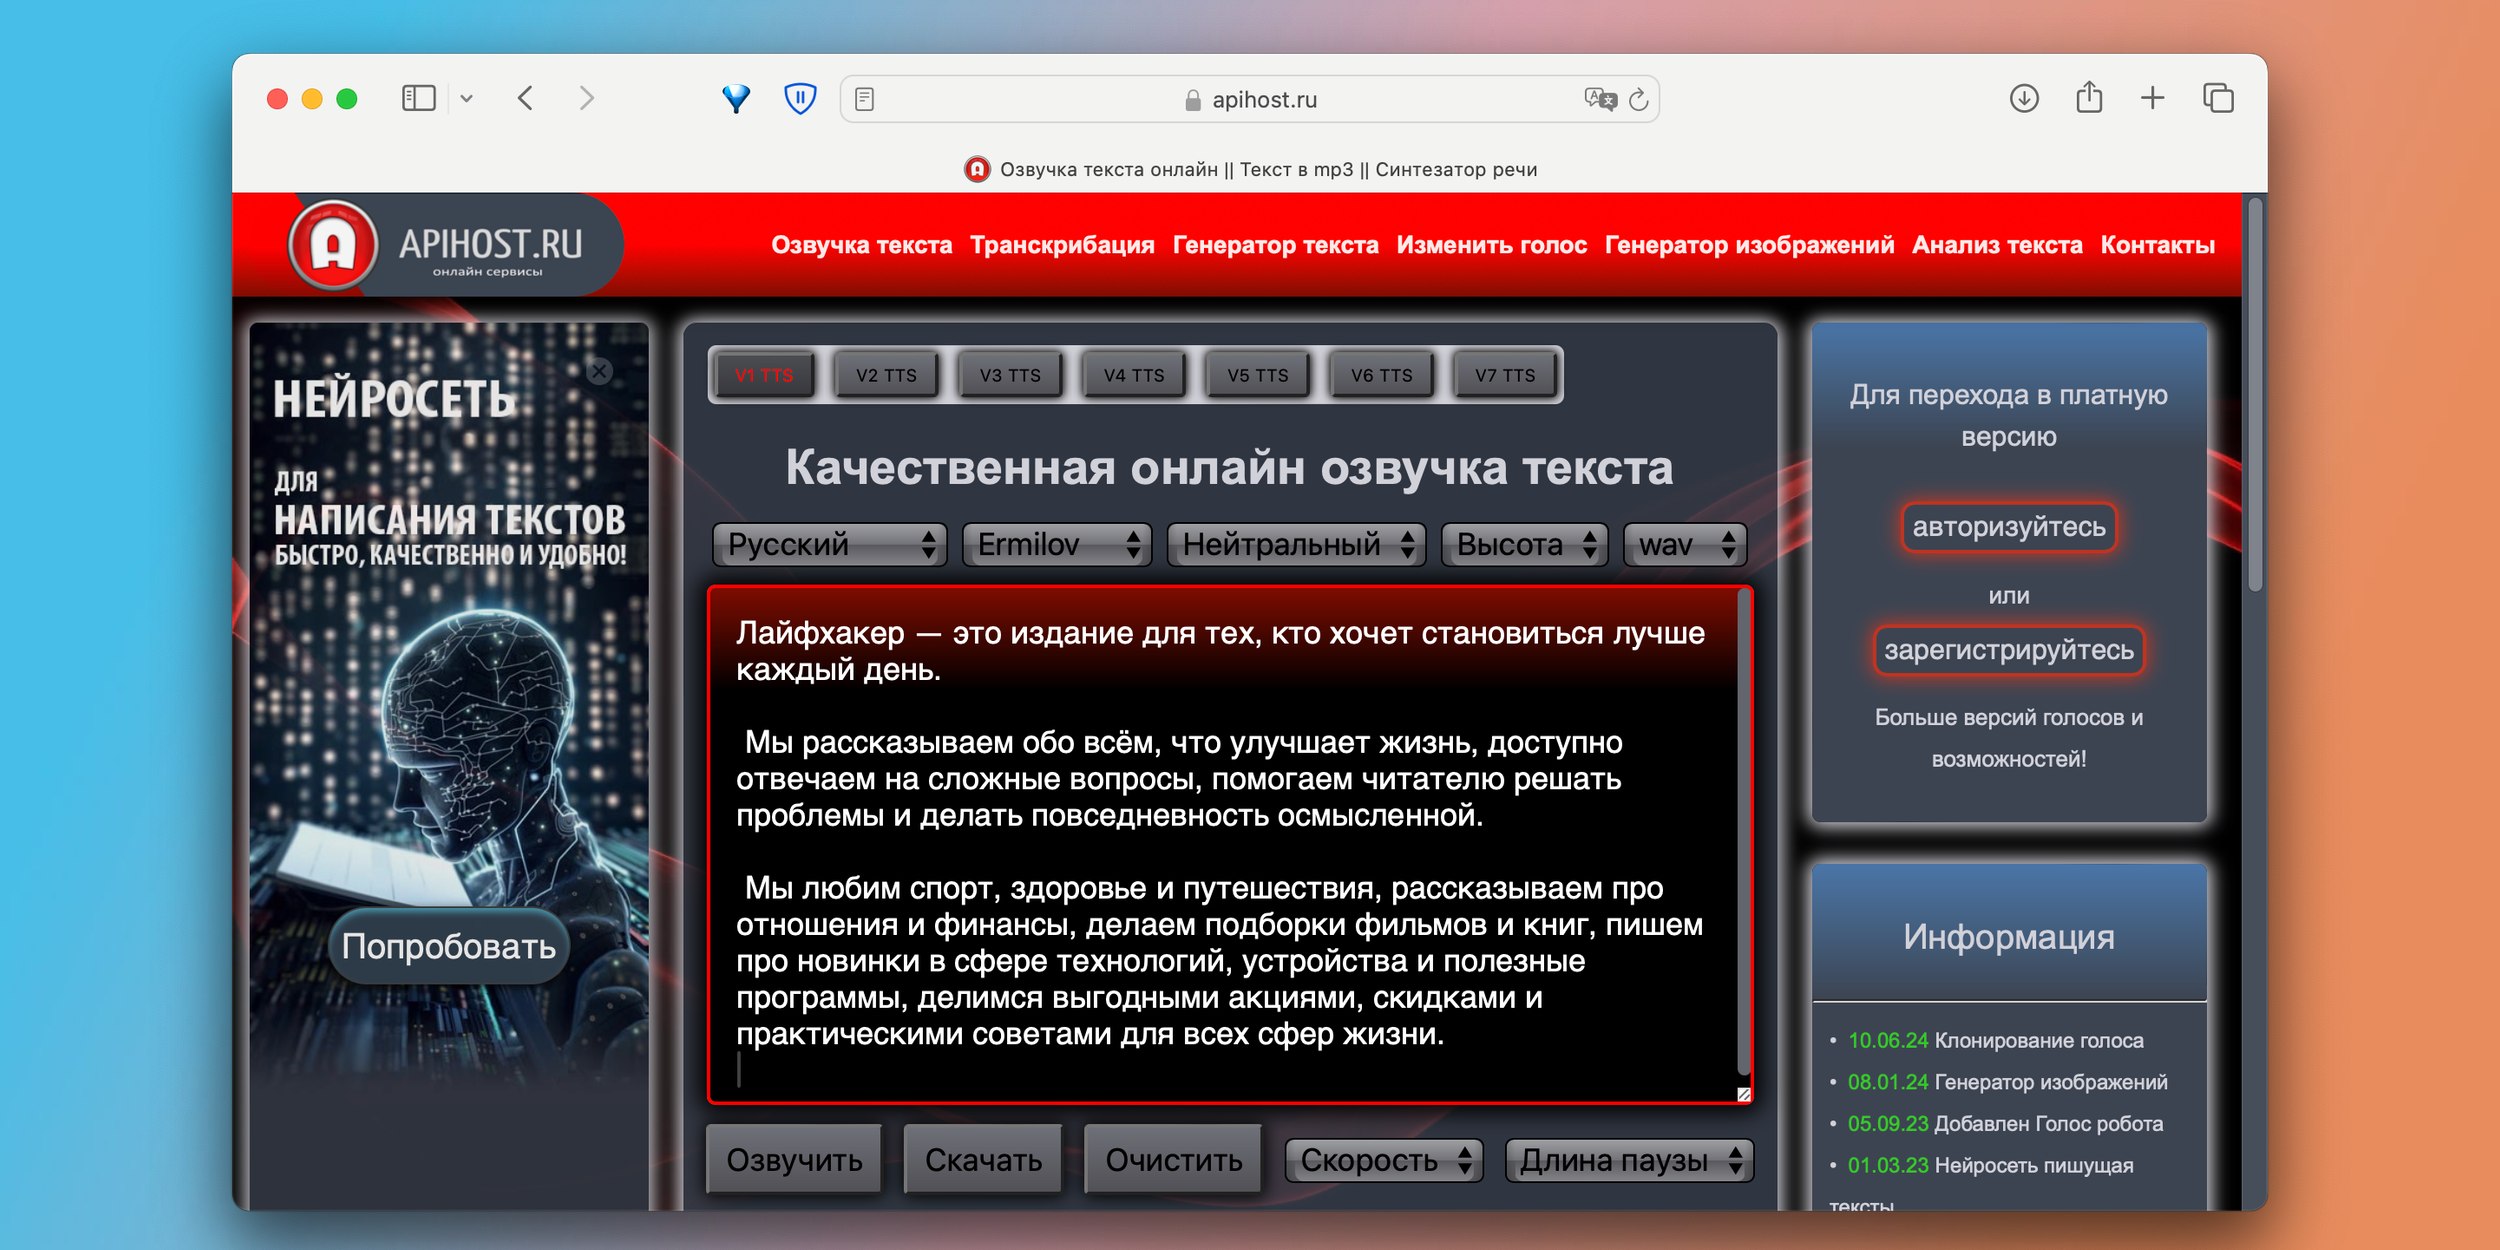
Начните с ручной проверки на реальном сценарии, а не с интеграции. Утвердите голос, темп и правила произношения, затем составьте технический шаблон для API. В логах сохраняйте текст, время генерации и идентификатор настроек. Это упрощает расследование ситуации, когда одна из реплик в большой серии получилась иначе, чем ожидалось.
Плюсы
- Сочетает веб-сценарий и программное подключение.
- Подходит для русскоязычных проектов и повторяемых задач.
- Можно начать ручным способом и перейти к автоматизации.
- Удобен для небольших продуктовых команд.
Минусы
- Перед масштабным внедрением требуется отдельно проверить стабильность на типовых текстах проекта.
- Для сложной студийной работы потребуется внешний редактор.
- Международным командам крупные облачные платформы дают более широкую инфраструктурную экосистему.
Кому подойдёт
Российским SaaS-проектам, небольшим продуктовым командам и редакциям, которым необходим русскоязычный TTS с возможностью дальнейшей автоматизации.
TTSMaker
TTSMaker подходит для ситуаций, когда необходимо быстро превратить небольшой текст в аудио без полноценной студии. Его разумно применять для прототипов, черновых видеороликов, теста сценария и вспомогательной озвучки. В большом медиапроизводстве ценность такого сервиса — скорость первой итерации: команда сразу слышит сценарий и понимает, где текст требует переписывания.
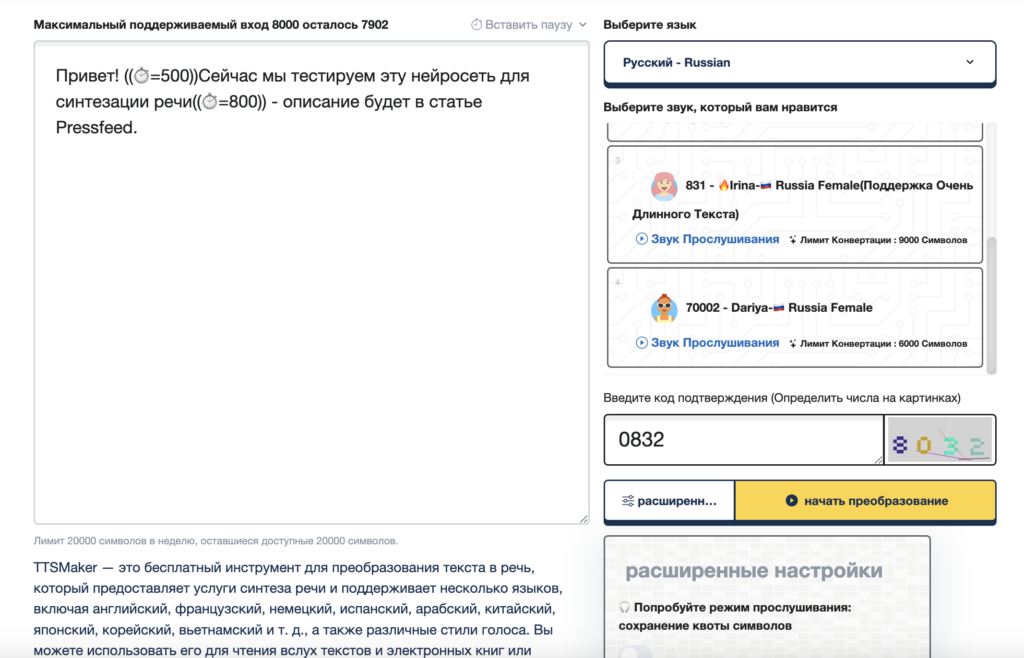
Сделайте первый черновик в нейтральном голосе и не тратьте время на тонкую настройку. Цель первой генерации — проверить структуру текста, продолжительность и ясность. После правок перенесите утвержденный сценарий в тот инструмент, который выбран для финального производства. Такой двухэтапный процесс экономит время на дорогих или сложных генерациях.
Плюсы
- Минимальный порог входа для разовой озвучки.
- Удобен для черновой проверки сценария.
- Работает в браузере.
- Позволяет быстро оценить примерную продолжительность речи.
Минусы
- Не заменяет полноценную студию для сложного брендового контента.
- Меньше возможностей для системной автоматизации и командного управления.
- Финальная обработка и монтаж выполняются отдельно.
Кому подойдёт
Авторам черновиков, небольшим командам и специалистам, которым необходим быстрый тест текста перед финальной озвучкой.
TextToSpeech.ru
TextToSpeech.ru закрывает базовый сценарий русскоязычной онлайн-озвучки: вставить текст, выбрать доступный вариант голоса и получить аудиорезультат. Это не полноценная медиастудия, зато такой формат удобен для коротких сообщений, учебных вставок, прототипов и быстрых проверок сценария, когда важнее скорость, чем сложная актерская настройка.
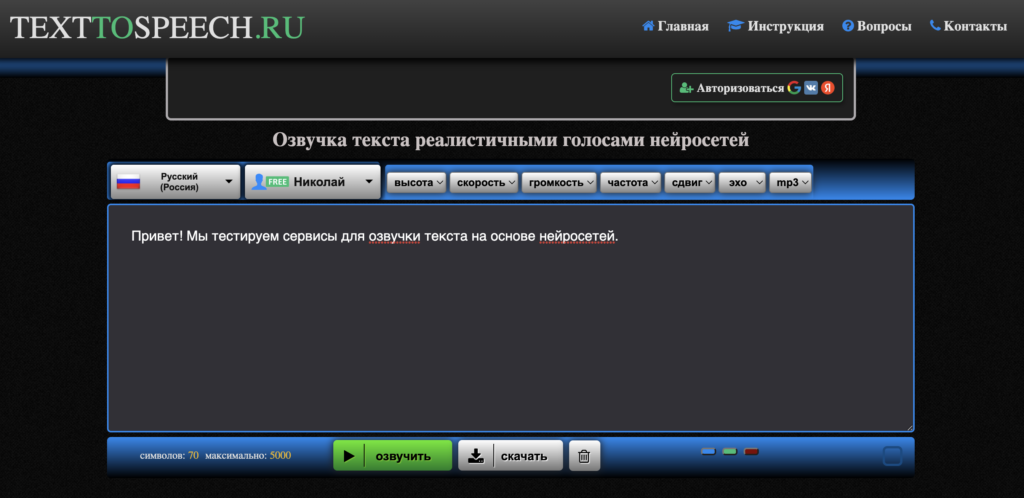
Применяйте короткие смысловые абзацы и сразу прослушивайте слова с неоднозначным ударением. Для чисел и сокращений пишите вариант, который должен звучать, а не тот, который удобнее читать глазами. После генерации проверьте начало и конец файла: случайная лишняя пауза там в особенности заметна при последующем монтаже.
Плюсы
- Простой русскоязычный веб-интерфейс.
- Подходит для быстрых и коротких озвучек.
- Не требует установки программы.
- Удобен для прототипов и учебных материалов.
Минусы
- Функциональность сосредоточена на базовом синтезе, а не на полноценном производстве.
- Для сложной эмоциональной подачи необходимы более развитые голосовые модели.
- Монтаж, сведение и пакетная автоматизация остаются внешними задачами.
Кому подойдёт
Пользователям, которым необходима простая русскоязычная озвучка небольшого текста без сложной настройки и интеграции.
Как выбрать сервис под бизнес-задачу
Выбор упрощается, когда начинать не с бренда сервиса, а с конечного артефакта. Для видеоролика важна синхронизация с монтажом, для приложения — API и задержка, для курса — длинная стабильная речь, для подкаста — удобное редактирование сцен, для доступности — читаемость документов. Сперва фиксируется производственный сценарий, затем из рейтинга остаются только решения, которые реально в него вписываются.
Рекламные видеоролики и социальный контент
Для короткого видео лучше выбирать инструмент, где легко перегенерировать одну реплику и сразу проверить ее рядом с кадром. ВидеоМОНТАЖ сокращает количество переходов между программами, а ElevenLabs, Murf, LOVO и PlayAI дают больше вариантов голосовой подачи. Рабочая метрика — не число голосов, а доля реплик, которые проходят утверждение без повторной генерации. Дополнительно измеряйте время от правки текста до готовой дорожки в проекте.
Презентации, обучение и внутренние коммуникации
В учебном материале важнее стабильная дикторская манера и понятные паузы. Narakeet в особенности логичен для презентаций, NaturalReader — для документов, Speechify Studio и Murf — для регулярных материалов. Проверяйте скорость понимания: дайте сотрудникам прослушать фрагмент без текста на экране и попросите пересказать три основных тезиса. Слишком быстрая или театральная подача снижает усвоение даже при хорошем тембре.
Продуктовые интерфейсы и автоматические уведомления
Тут приоритет смещается в сторону SpeechKit, Azure AI Speech, Google Cloud Text-to-Speech, Amazon Polly, PlayAI и Resemble AI. Команде необходимы API, понятная модель аутентификации, предсказуемая задержка и журналирование. Тестируйте не красивое демо, а реальные переменные: имя пользователя, дата, номер заказа, процент, код и несколько вариантов длины сообщения. Ошибка в одном динамическом поле важнее, чем небольшая разница в тембре.
Подкасты и длинные форматы
Для длинного выпуска критичны стабильность тембра и удобство точечного ремонта. ElevenLabs, Podcastle, Murf и специализированные облачные модели помогают построить такой процесс, но длинный текст все равно лучше делить на сцены. После сборки прогоните материал через обычную аудиообработку: выравнивание громкости, удаление лишней тишины и контроль пиков. Базовые приемы разобраны в основах обработки аудио.
Как измерять качество нейросетевой озвучки
Фраза «звучит естественно» слишком субъективна для производственного решения. Введите простую редакционную оценку и применяйте один и тот же набор критериев для всех кандидатов. Даже команда из трех человек получает более полезный итог, чем при свободном обсуждении без шкалы.
- Точность произношения, 0–5. Сколько терминов, имен, чисел и аббревиатур произнесены правильно с первой попытки.
- Разборчивость, 0–5. Насколько легко понять слова на обычном динамике смартфона.
- Естественность пауз, 0–5. Есть ли механические разрывы, неправильное дыхание между частями предложения или слишком равномерный ритм.
- Стабильность, 0–5. Сохраняется ли один и тот же голосовой характер между несколькими абзацами.
- Редактируемость, минуты. Сколько времени занимает заменить одну фразу и вернуть исправленный звук в проект.
- Доля повторных генераций, %. Какая часть реплик потребовала второй или третьей попытки перед утверждением.
- Время производства, минуты на минуту готового звука. Метрика показывает реальную экономию, а не впечатление от быстрого демо.
Типичные ошибки при озвучке текста нейросетью
- Сценарий написан как статья. Длинные предложения и сложные вводные конструкции трудно слушать. Текст для речи должен быть короче и ритмичнее.
- Нет словаря произношения. Бренд, фамилия или термин звучит по-разному в различных видеороликах, хотя голос выбран один.
- Сразу генерируется весь материал. Одна ошибка заставляет пересобирать длинную дорожку. Деление на сцены делает правки дешевле.
- Голос выбирают по эффектному демо. Демо не содержит ваших чисел, наименований и реальной длины фраз. Необходим собственный тестовый набор.
- Фоновая музыка маскирует согласные. Речь кажется мягкой и красивой в наушниках, но теряется на телефоне. Проверяйте микс на простых динамиках.
- Темп ускоряют вместо редактуры. Когда реплика не помещается в кадр, лучше сократить фразу, чем превращать голос в скороговорку.
- Не фиксируются настройки. Следующий видеоролик той же кампании звучит иначе. Храните голос, параметры и правила произношения вместе с текстом.
- Игнорируются права на голос. Клонирование и персональные голоса требуют согласия владельца записи и внутреннего контроля доступа.
Пошаговый процесс внедрения TTS в контент-команду
- 1. Выберите один формат. Начните с конкретной задачи: рекламный видеоролик, учебный модуль, подкастовый переход или системное сообщение.
- 2. Соберите эталонный текст. Добавьте термины, числа, имя бренда, эмоциональную фразу и длинный абзац.
- 3. Оставьте три кандидата. Не сопоставляйте двадцать сервисов до бесконечности; после первого теста достаточно трех различных подходов.
- 4. Проведите слепое прослушивание. Участники оценивают файлы без наименований сервисов по одной шкале.
- 5. Проверьте производственный путь. Измерьте время от правки текста до замены готовой дорожки в видео или продукте.
- 6. Зафиксируйте голосовой стандарт. Запишите выбранный голос, темп, произношение брендов, правила чисел и допустимый уровень эмоциональности.
- 7. Введите контроль качества. Перед публикацией один человек сверяет текст и звук, второй слушает итог без исходного сценария.
- 8. Пересматривайте выбор по данным. Доля повторных генераций и время производства показывают, в самом деле ли инструмент помогает команде.
Вывод
Для видео на Windows наиболее прямой процесс дает ВидеоМОНТАЖ: озвучка появляется внутри проекта и сразу проверяется рядом с кадрами. Для выразительной медийной речи сильный выбор — ElevenLabs и браузерные студии Murf, LOVO, PlayAI и Speechify. Для автоматизированных продуктов рациональнее SpeechKit, Azure AI Speech, Google Cloud Text-to-Speech и Amazon Polly. Простые сервисы вроде Zvukogram, Robivox, TTSMaker и TextToSpeech.ru удобны как быстрый метод получить дорожку или проверить сценарий. Решение стоит принимать по собственному тестовому тексту, скорости исправлений и доле реплик, которые проходят утверждение с первой генерации.
Нейросеть заменяет живого диктора во всех форматах?
Нет. Синтетическая речь хорошо закрывает серийные, информационные и быстро обновляемые материалы. Живой диктор остается сильнее там, где проект строится на индивидуальной актерской интерпретации, личном доверии спикера или сложной режиссуре.
Как проверить русское произношение до большого проекта?
Соберите тест из наименований брендов, фамилий, англоязычных терминов, дат, чисел, процентов и двух длинных предложений. Прогоните один и тот же текст во всех кандидатах и посчитайте ошибки первой генерации.
Что важнее: число голосов или настройки речи?
Для регулярного производства важнее стабильность выбранного голоса, точность произношения, управление паузами и скорость исправления одной реплики. Большая библиотека полезна на этапе поиска, но не заменяет воспроизводимый процесс.
Почему длинный текст лучше делить на сцены?
Сцены упрощают редактуру. Ошибка в одном слове не заставляет ещё раз генерировать весь материал, а монтажер может точнее синхронизировать фразы с кадрами, слайдами или разделами подкаста.
Как оценивать итог на практике?
Слушайте файл на смартфоне, ноутбуке и наушниках, сверяйте произношение с текстом, отмечайте число повторных генераций и измеряйте время замены одной фразы. Эти показатели лучше отражают рабочую ценность, чем субъективная оценка тембра.
Как безопасно работать с клонированием голоса?
Применяйте только записи, на которые есть понятное согласие владельца голоса. Ограничьте доступ к исходным файлам и профилю, зафиксируйте допустимые сценарии и назначьте ответственного за публикацию сгенерированных материалов.