
Синтез речи давно вышел за рамки функции «прочитать документ вслух». Одни инструменты превращают сценарий в готовую дорожку для видеоролика, другие помогают слушать книги и документы, третьи дают разработчикам облачную инфраструктуру для автоматической озвучки. Чтобы не смешивать эти сценарии, рейтинг разделён по платформам и назначению. Базовый принцип технологии и термин TTS — Text-to-Speech — подробно разобраны в материале Xeon Live о синтезе речи и преобразовании текста в голос.
При выборе важна не только субъективная приятность тембра. Для рабочих материалов сильнее влияют произношение имён и терминов, управление паузами, стабильность интонации на длинном тексте, скорость исправления фрагментов, поддерживаемые источники текста, формат готового аудио и правила применения конкретного голоса. Для маркетинга и коммуникаций отдельно имеет значение путь от согласованного сценария до итогового файла: чем меньше ручных переходов между редакторами, тем легче выпускать серии видеороликов, презентаций и обучающих материалов в одном стиле.
Как устроен рейтинг и что сопоставлять
Инструменты для озвучки логично делятся по рабочей задаче. NaturalReader, Balabolka, TextAloud и мобильные читалки сосредоточены на документах и книгах; ElevenLabs и Murf AI — на нейросетевой генерации голосовых дорожек; Yandex SpeechKit и Google Cloud Text-to-Speech — на облачной интеграции; ВидеоМОНТАЖ связывает синтез с видеопроектом. Эти категории решают различные задачи, по этой причине место в списке необходимо читать вместе с платформой и сценарием, а не как абсолютную оценку качества.
В карточках учитываются семь практических критериев. Первый — естественность фразовой интонации и управление темпом. Второй — работа с русским текстом, числами, сокращениями и именами. Третий — путь от текста к готовому аудио или сразу к видео. Четвёртый — поддержка документов, электронных книг, веб-страниц или структурированных сценариев. Пятый — методы корректировать произношение. Шестой — автономность либо зависимость от облака. Седьмой — пригодность для повторяемого рабочего процесса, когда один и тот же голос необходим в серии материалов.
- Для видео и рекламы: важны быстрые правки отдельных реплик, синхронизация с монтажом и понятный экспорт.
- Для статей, книг и документов: важнее импорт форматов, навигация по длинному тексту, закладки и комфортное прослушивание.
- Для локализации: проверяйте язык конкретного голоса, произношение собственных имён и одинаковость подачи в различных фрагментах.
- Для продукта и автоматизации: оценивайте программный интерфейс, разметку произношения, ограничения одного фрагмента и повторяемость итога.
- Для доступности: значение имеют удобное выделение читаемой строки, регулировка скорости и стабильная работа на нужном устройстве.
Короткая матрица выбора по рабочему сценарию
Если конечный итог — видеоролик, удобнее начинать с инструмента, где озвучка встроена в монтаж. Если необходимо систематически слушать документы на компьютере, полезнее настольная читалка с системными голосами и словарём произношения. Для брендированного контента и многовариантной подачи сильнее облачные генераторы с выбором голосов и параметров. Разработчикам подходят облачные платформы с программным интерфейсом, а для мобильного чтения — приложения, которые принимают документы, ссылки и отсканированные страницы.
- Видеоролики и короткие видео: ВидеоМОНТАЖ — когда голос должен сразу попасть на монтажную шкалу.
- Большие документы в Windows: Balabolka и TextAloud — когда важнее чтение файлов и гибкость системных голосов.
- Электронные книги: Icecream Ebook Reader, Voice Dream Reader и eReader Prestigio.
- Выразительная нейросетевая подача: ElevenLabs и Murf AI.
- Облачная интеграция в продукт: Yandex SpeechKit и Google Cloud Text-to-Speech.
- Сценарии с субтитрами: Narakeet.
- Чтение документов в браузере и на смартфоне: NaturalReader, Speechify и @Voice Aloud Reader.
Рейтинг программ и сервисов по платформам
Подборка межплатформенная, по этой причине позиции не смешаны в один плоский список. Сперва идут решения Windows, затем браузерные и облачные сервисы, после них — приложения для смартфонов. Один продукт размещён лишь в своей основной группе; добавочные поддерживаемые устройства указаны внутри карточки.
Windows: программы для монтажа, документов и длинного текста
Настольная группа полезна, когда материал уже хранится в локальных файлах или озвучка должна стать частью видеопроекта. Тут меньше зависимость от браузерной сессии, а у читалок можно применять установленные в Windows голосовые движки. Главное различие внутри группы — конечный итог: ВидеоМОНТАЖ работает вокруг готового видеоролика, Balabolka и TextAloud вокруг текста и аудиофайла, Icecream Ebook Reader вокруг комфортного чтения книг.
1. ВидеоМОНТАЖ — озвучка внутри видеопроекта
ВидеоМОНТАЖ стоит первым, потому что для бизнес-блога в особенности важен сценарий «текст → голос → готовый ролик» без отдельной сборки звука в ином редакторе. У программы есть встроенная нейросетевая озвучка: текст вводится в отдельное окно, выбираются голос и характер подачи, после синтеза итог можно добавить в проект. В отдельном обзоре Xeon Live собраны основные возможности видеоредактора ВидеоМОНТАЖ для Windows.
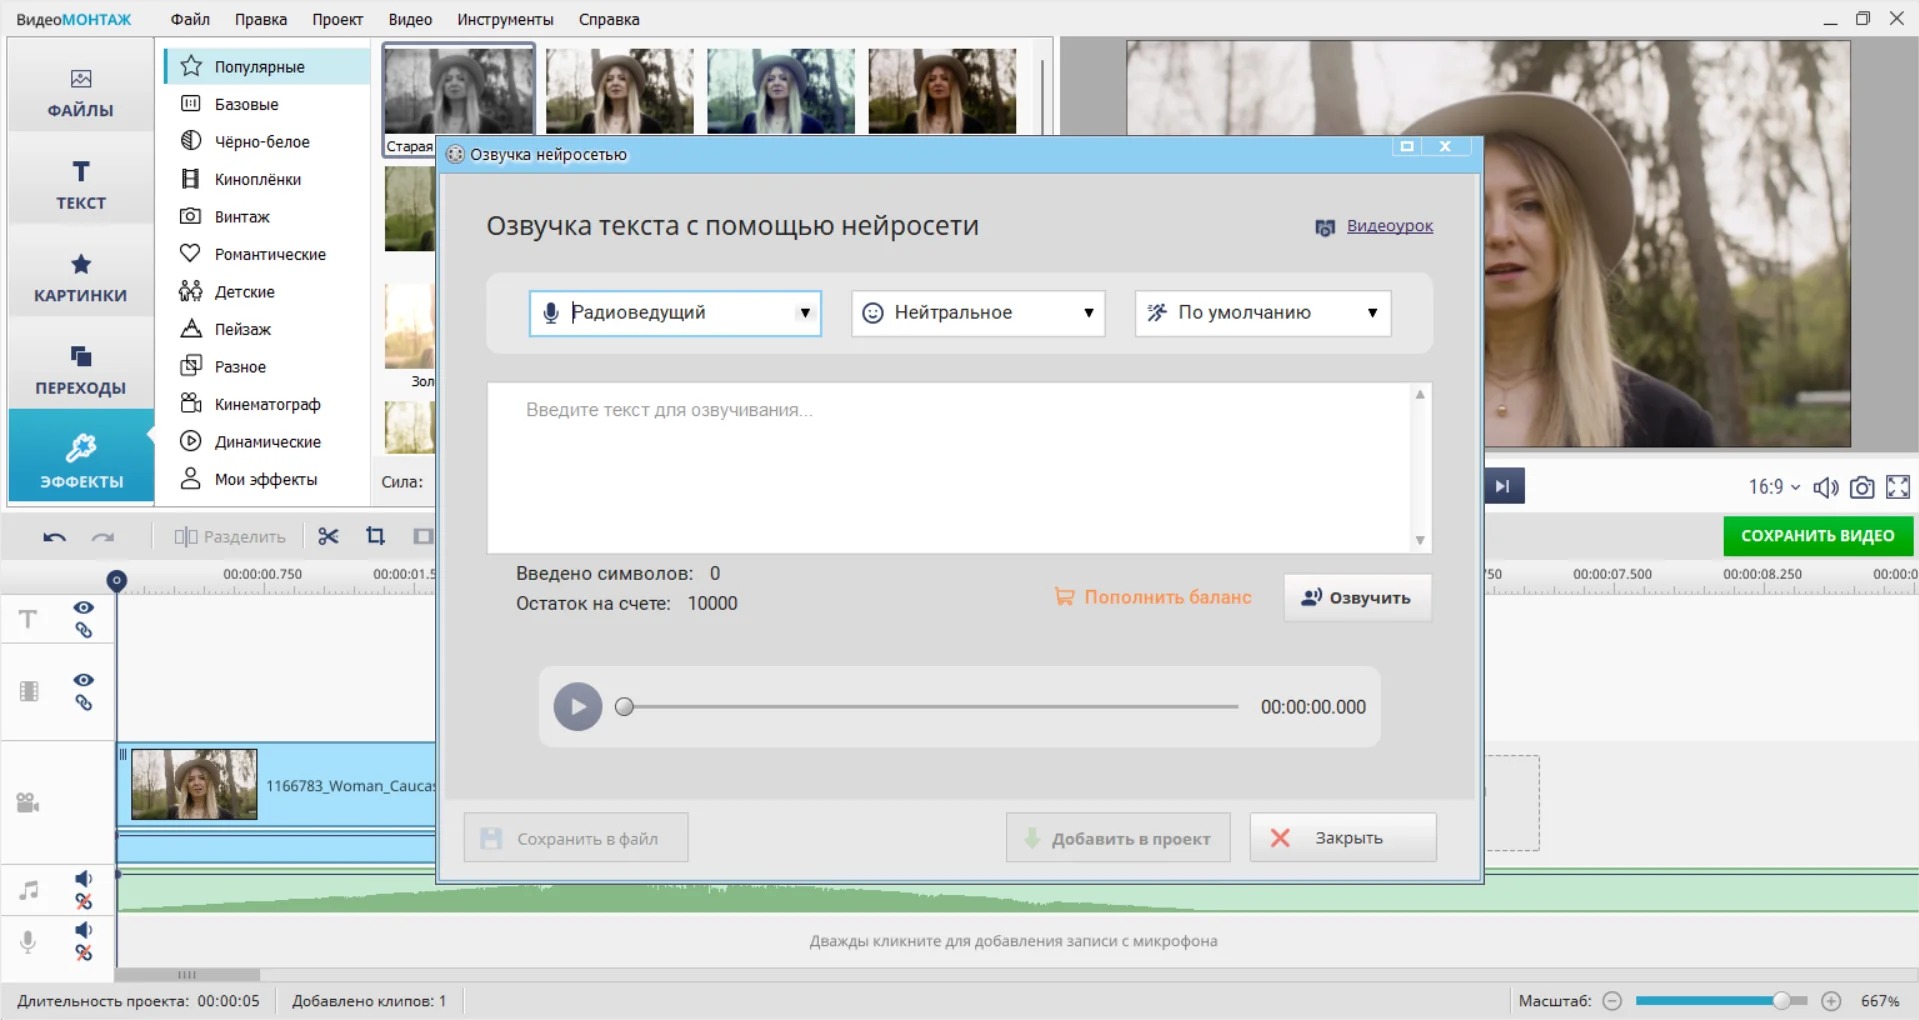
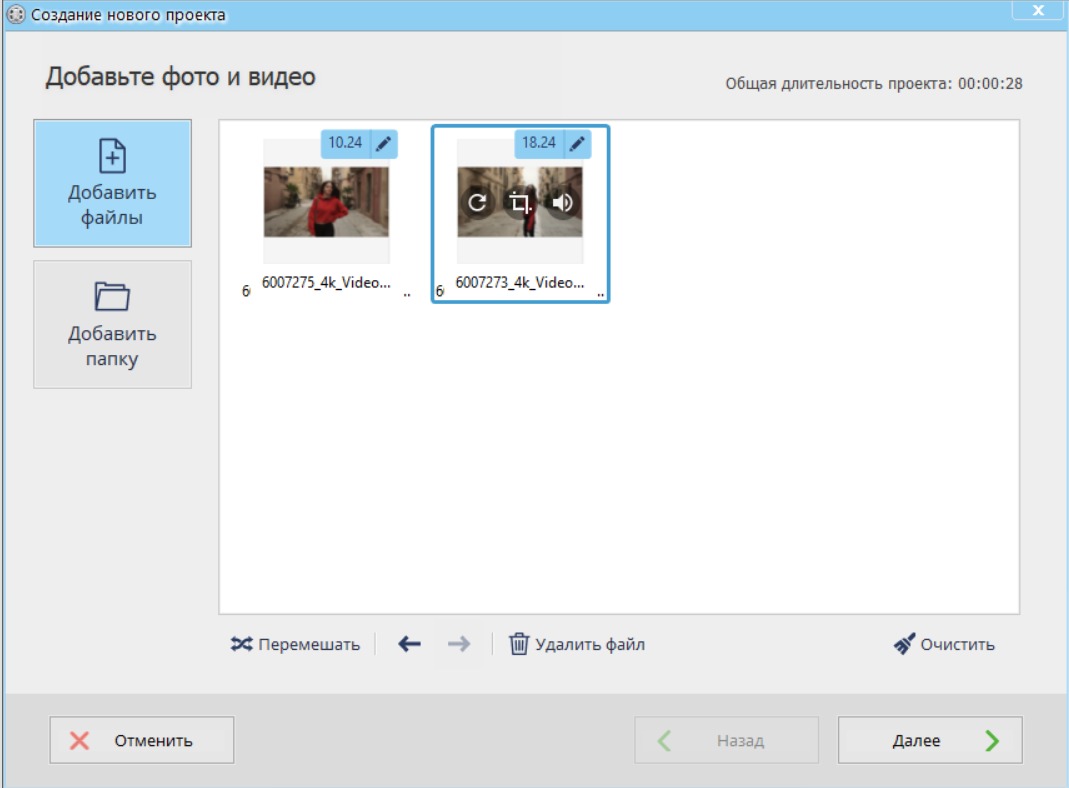

Практическое преимущество такого подхода проявляется на коротких рекламных и объясняющих видео. Сперва можно собрать черновой монтаж и оценить продолжительность сцен, затем озвучить уже утверждённые реплики и подрезать видеоряд под фактический темп речи. Когда меняется одно предложение, не требуется перестраивать внешний аудиопроект: правится нужный фрагмент и заново размещается на шкале. Для серийного производства это уменьшает число мест, где легко перепутать версии сценария и звуковой дорожки.
По охвату это не универсальная читалка документов и не разработческая облачная платформа. Сильная сторона — именно видео: клипы, титры, музыка, озвучка и экспорт находятся в одном проекте. Выбирать программу только ради прослушивания PDF или длинных книг нерационально; для таких задач удобнее Balabolka, NaturalReader или мобильные читалки. Перед публикацией видеоролика всё равно необходимо прослушать реплики целиком: фамилии, аббревиатуры, числа и иностранные наименования требуют отдельного контроля вне зависимости от движка.
Плюсы
- Озвучка создаётся прямо в видеоредакторе и сразу встраивается в монтажный проект.
- Русский интерфейс и понятный сценарий работы для видеороликов, презентационных видео и контента социальных площадок.
- Можно корректировать отдельные реплики после того, как продолжительность сцен уже понятна.
- В одном проекте совмещаются голос, музыка, титры и видеоряд.
Минусы
- Основная платформа — Windows; для мобильного чтения документов программа не предназначена.
- Набор задач шире озвучки, по этой причине для простой конвертации большого массива текста в аудио интерфейс избыточен.
- Для сложной автоматизации через программный интерфейс лучше подходят облачные платформы.
Кому подойдёт
Маркетологам, контент-командам, авторам обучающих материалов и небольшим видеостудиям, которым необходимо систематически выпускать видеоролики с синтетическим голосом и сразу доводить их до готового видео в Windows.
2. Balabolka — локальная читалка с системными голосами Windows
Balabolka — одна из самых функциональных настольных читалок в подборке. Программа применяет установленные в системе синтезаторы речи, читает содержимое буфера обмена и большой набор документов и электронных книг. Текст можно не только слушать, но и сохранять в аудиофайл. Отдельный словарь замен и правила на регулярных выражениях помогают исправлять произношение терминов, фамилий и нестандартных сокращений — это в особенности полезно при десятках страниц технического текста.
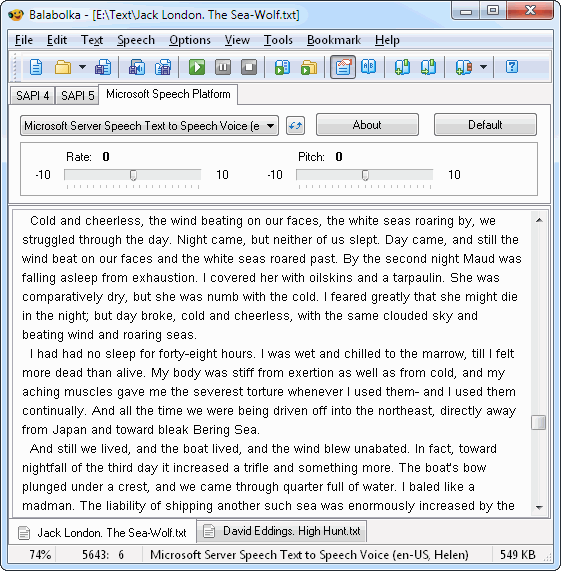
Качество голоса определяется не самой Balabolka, а выбранным голосовым движком. Это принципиальное отличие от ElevenLabs или Murf AI: программа служит оболочкой для системного синтеза. Такой подход удобен, когда необходим воспроизводимый локальный процесс и уже настроены подходящие голоса Windows. Он тоже позволяет держать исходный текст на компьютере. Вместе с этим естественность и эмоциональность зависят от конкретного установленного голоса и не становятся автоматически выше из-за большого числа настроек.
Balabolka в особенности полезна для длинных материалов: можно открыть документ, отредактировать проблемные слова, выбрать скорость и высоту тона, а затем сформировать аудиофайл. Для публичной озвучки вдобавок проверяется лицензия используемого голосового движка: статус самой программы и условия голоса — различные юридические слои. Для личного чтения этот вопрос проще, а для рекламной дорожки или курса права на голос должны быть понятны заблаговременно.
Плюсы
- Поддерживает широкий набор текстовых документов и форматов электронных книг.
- Работает с системными голосами Windows и позволяет менять скорость и высоту тона.
- Есть правила произношения и замены, полезные для терминологии и собственных имён.
- Подходит для локальной обработки больших текстов без обязательной браузерной сессии.
Минусы
- Естественность речи зависит от установленного голосового движка, а не от Balabolka как оболочки.
- Интерфейс ориентирован на функциональность и требует времени, чтобы освоить словари и добавочные настройки.
- Права на коммерческое применение необходимо проверять для выбранного голоса отдельно.
Кому подойдёт
Тем, кто систематически слушает или конвертирует большие документы в Windows, работает с техническими текстами и хочет детально управлять произношением без обязательного перехода в облачный сервис.
3. TextAloud — чтение статей и создание аудиофайлов
TextAloud строит работу вокруг набора текстовых статей: материал можно вставить в редактор, затем запустить чтение или перейти к созданию аудиофайла. Панель программы разделяет эти действия, а поддержка внешних голосов позволяет подобрать звучание под конкретный язык и задачу. Для длинной статьи удобно то, что текст остаётся редактируемым: перед синтезом можно расставить паузы, исправить написание сложных слов и разделить материал на логические части.
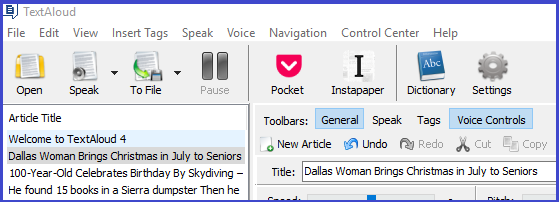
В рабочем процессе TextAloud полезен как промежуточный редактор между документом и аудиофайлом. В отличие от видеоредактора тут нет монтажной части, зато можно организовать несколько текстов, быстро переслушивать фрагменты и применять голосовые теги. Такой формат подходит для внутренних рассылок в аудиоформате, озвучивания инструкций или подготовки черновых дикторских дорожек, которые затем попадут в монтаж. Для художественной рекламы выразительность снова зависит в первую очередь от установленного голоса.
Отдельно стоит учитывать права на добавочные голосовые пакеты. Условия сторонних голосов могут различаться для личного прослушивания и распространения готового аудио. По этой причине команда должна фиксировать не только наименование приложения, но и конкретный голос, на котором построен выпуск. Такая дисциплина упрощает повторное производство спустя месяцы и уменьшает риск неожиданно сменить тембр в середине серии.
Плюсы
- Раздельные режимы чтения текста и создания аудиофайла.
- Подходит для организации нескольких материалов и последовательной работы с длинными статьями.
- Поддерживает внешние голоса и инструменты коррекции произношения.
- Удобен как текстовый этап перед последующим монтажом аудио или видео.
Минусы
- Качество и лицензирование итогового голоса зависят от выбранного внешнего движка.
- Интерфейс рассчитан в первую очередь на настольную работу, а не на мобильный сценарий.
- Для сложной нейросетевой выразительности облачные генераторы предлагают более специализированные средства.
Кому подойдёт
Редакторам, авторам длинных материалов и пользователям Windows, которым необходим управляемый процесс от текста к прослушиванию и аудиофайлу с возможностью подключать различные системные голоса.
4. Icecream Ebook Reader — озвучивание внутри электронной библиотеки
Icecream Ebook Reader ориентирован на чтение книг, а TTS встроен в привычную библиотеку. В настройках синтеза доступны выбор системного голоса, громкость, скорость и высота тона. Приложение работает с популярными форматами электронных книг и документами, по этой причине пользователь не строит отдельный проект озвучки: он открывает книгу, настраивает голос и продолжает чтение с нужного места.
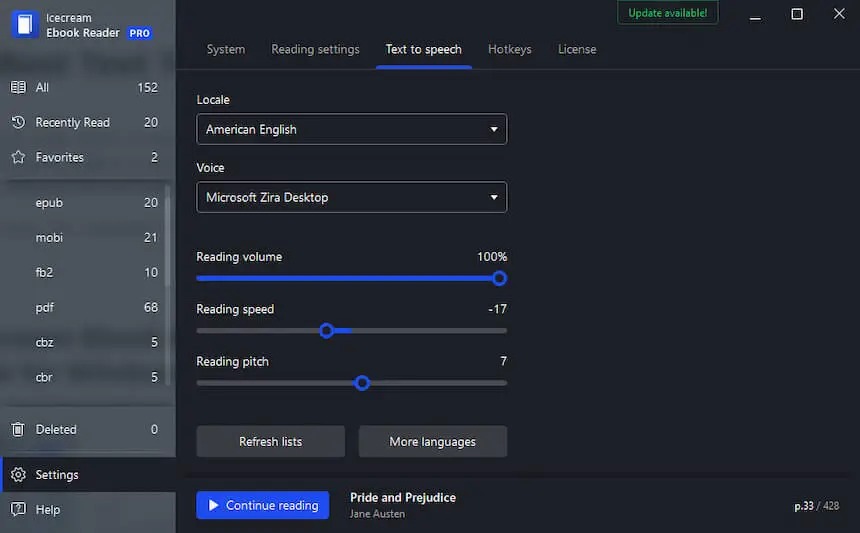
Для бизнеса это нишевый, но понятный инструмент. Он подходит для прослушивания длинных отраслевых документов, методичек и электронных книг сотрудниками, которым удобнее аудиоформат. Не требуется формировать отдельный файл ради обычного прослушивания. Вместе с тем это не студия для брендированной закадровой дорожки: нет сценарного монтажа, многодорожечного проекта и продвинутой работы с эмоциями голоса.
Так как читалка применяет доступные в системе голоса, логика выбора похожа на Balabolka: сперва оценивается сам голос, затем удобство оболочки. Icecream Ebook Reader выигрывает у утилитарных TTS-программ библиотекой и навигацией по книгам, но уступает им по глубине правил произношения и автоматизации. Это показывает, почему лучшая программа зависит от того, необходим ли файл для публикации или комфортное прослушивание материала.
Плюсы
- Озвучка встроена в электронную библиотеку и не требует отдельной подготовки проекта.
- Настраиваются громкость, скорость и высота тона системного голоса.
- Удобная навигация по длинным книгам и документам.
- Подходит для регулярного прослушивания учебных и справочных материалов.
Минусы
- Ориентирован на чтение, а не на производство коммерческой закадровой дорожки.
- Выразительность определяется доступными в Windows голосами.
- Меньше инструментов коррекции сложного произношения, чем у специализированных TTS-утилит.
Кому подойдёт
Пользователям Windows, которым необходима читалка электронных книг с голосовым воспроизведением, а не отдельная студия синтеза для рекламных или продуктовых видеороликов.
Онлайн и облако: нейросетевые голоса и интеграция в рабочий процесс
Облачная группа сильнее там, где важны выразительность, большой выбор голосов, совместная работа или программное подключение. Тут текст обрабатывается на стороне сервиса, по этой причине перед загрузкой внутренней информации необходимо учитывать правила хранения данных и корпоративную политику. Для публичного контента тоже важен тип лицензии: возможность прослушать голос в браузере не равна автоматическому разрешению применять любую дорожку в рекламе.
5. ElevenLabs — детальная настройка нейросетевой подачи
ElevenLabs в веб-интерфейсе разделяет работу на текст, выбор голоса, модель и параметры голоса. В документации подчёркивается, что итог зависит от сочетания голоса и модели; настройки стабильности, похожести и стиля уточняют подачу. Для редактора это полезная логика: сперва находится подходящий голос на тестовом фрагменте, затем фиксируются параметры и лишь после этого обрабатывается длинный сценарий.
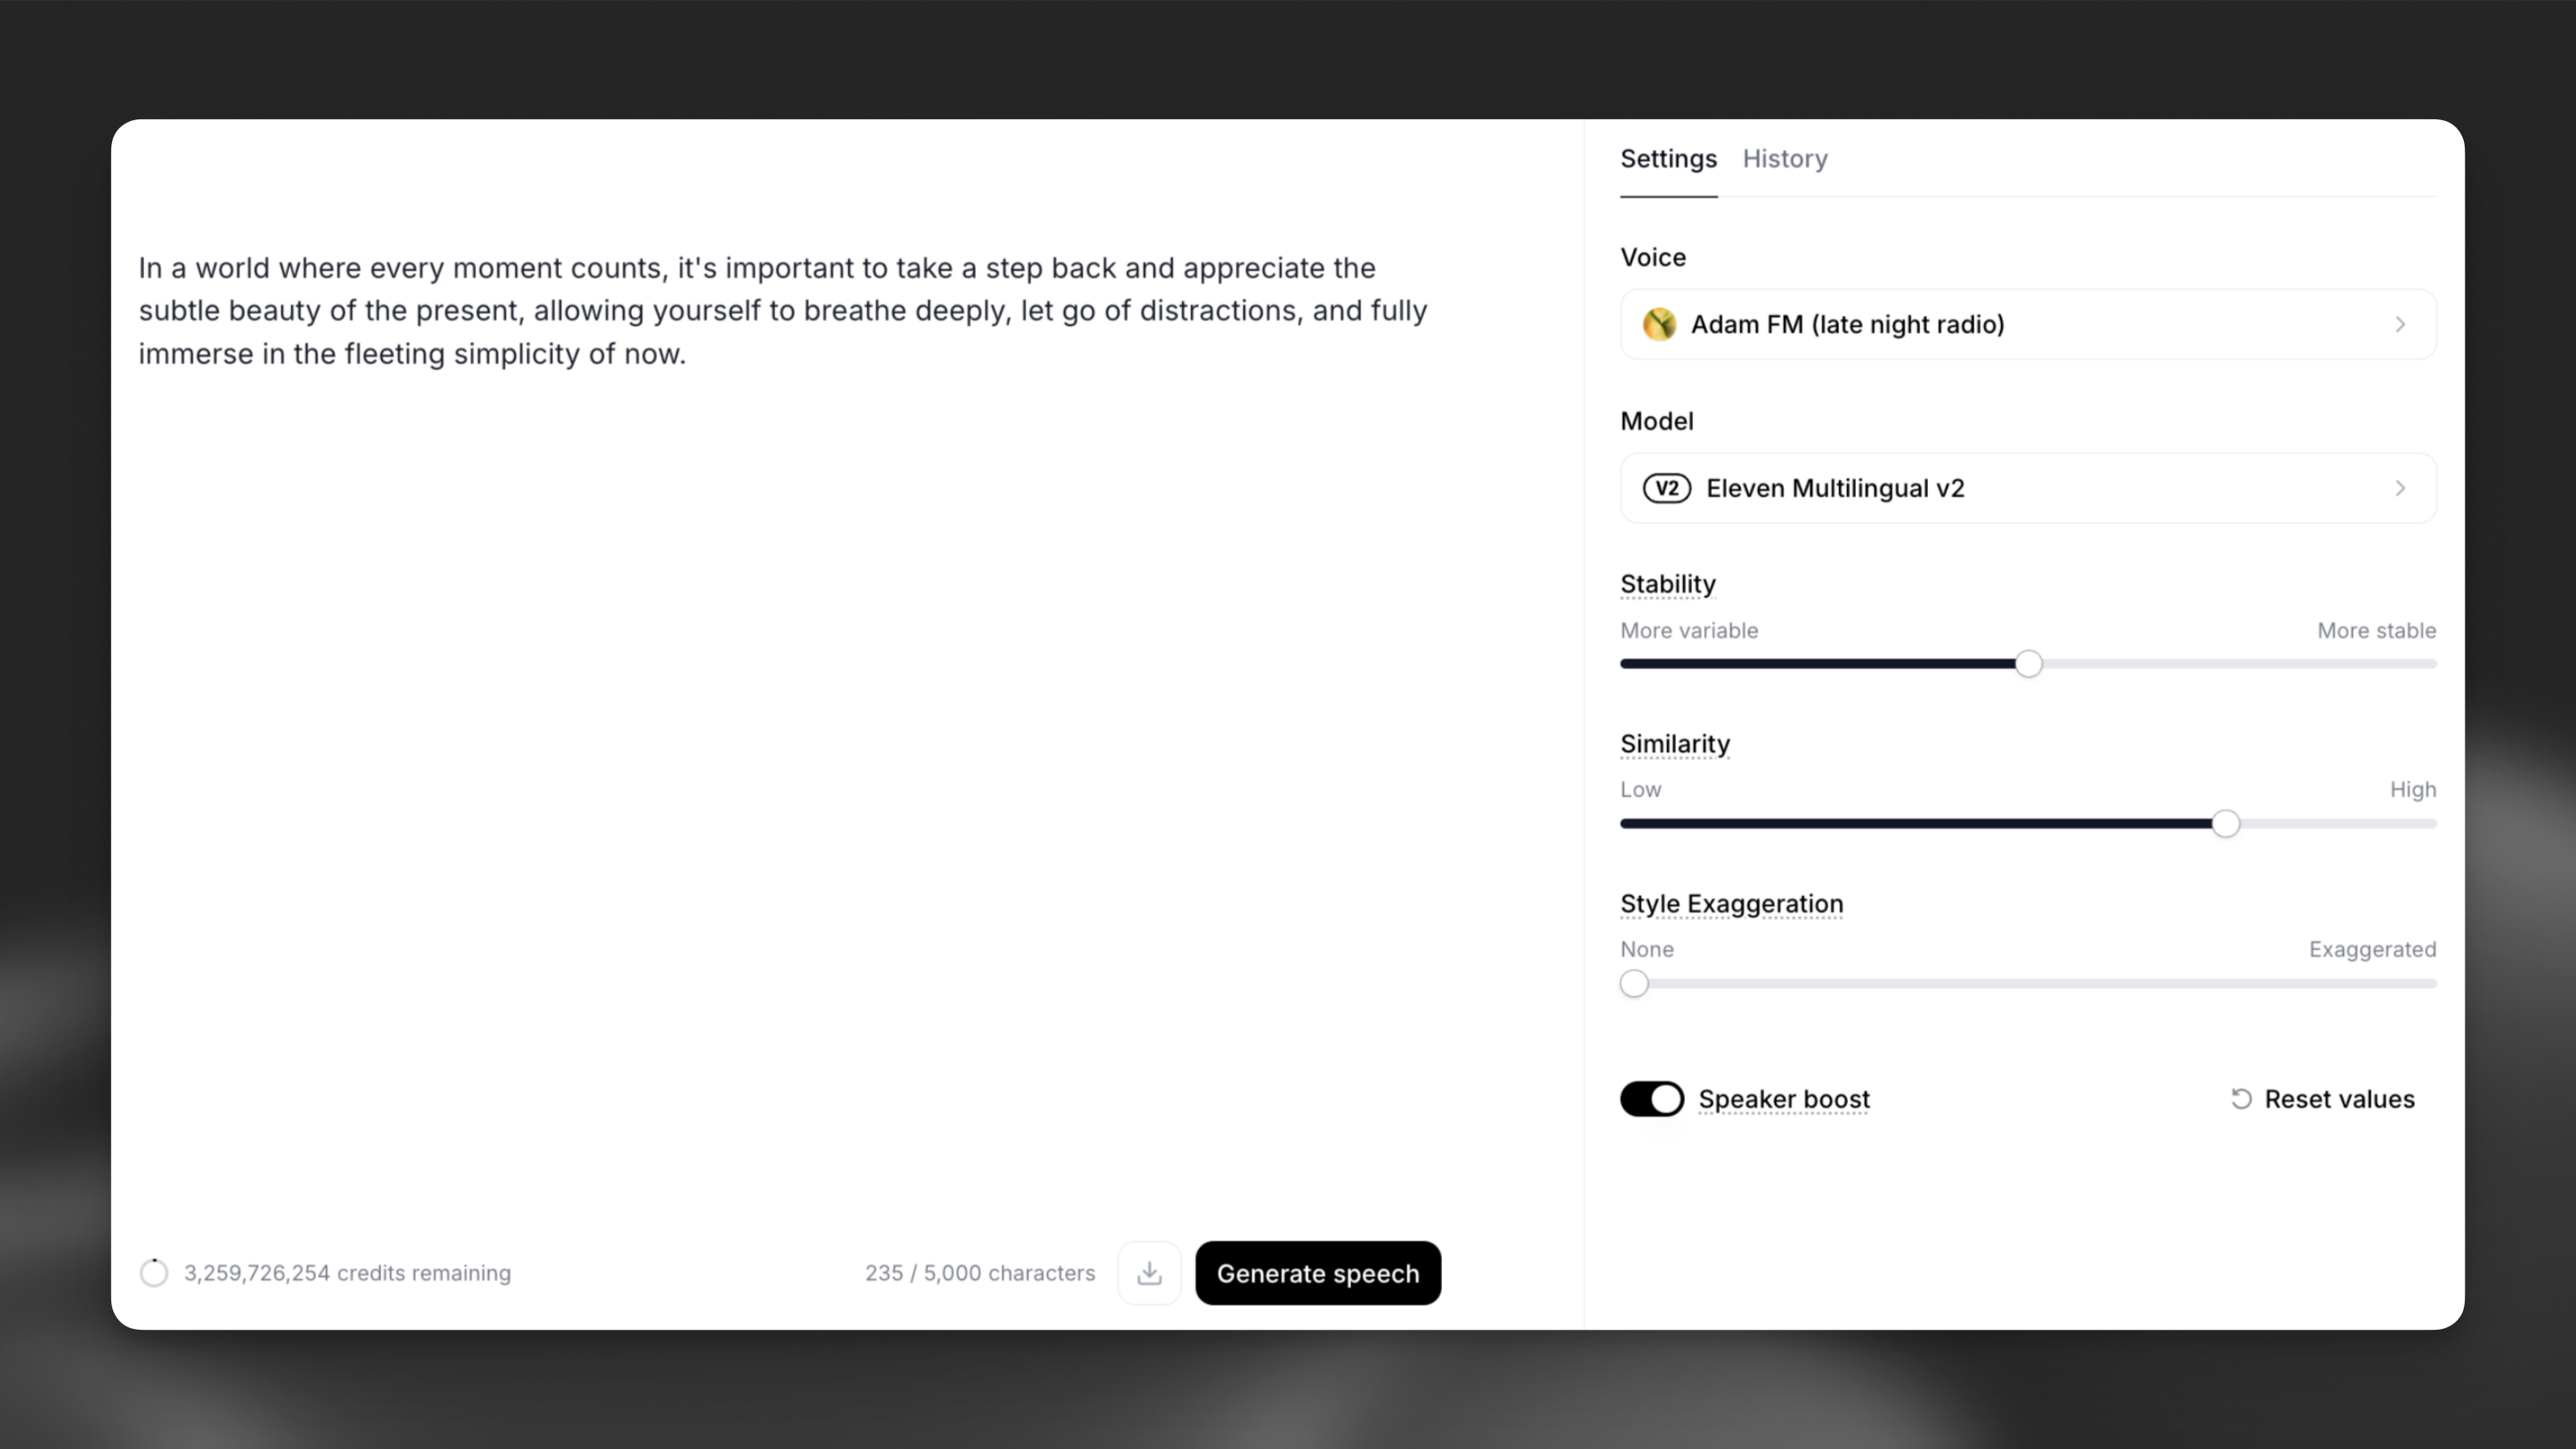
Сервис поддерживает управление скоростью, работу с паузами и подсказками для произношения; готовые генерации можно выводить в несколько распространённых аудиоформатов. Длинные материалы рациональнее разбивать на смысловые блоки: так проще исправить одно слово или неудачную интонацию, не меняя удачные части. При многосерийном проекте стоит хранить рядом с текстом наименование голоса, модели и настройки, иначе повторить звучание позднее будет сложнее.
ElevenLabs в особенности уместен там, где голос должен не просто читать, а поддерживать характер подачи: рекламный видеоролик, персонаж, подкастовая вставка, локализация. Вместе с этим команда обязана разграничивать личный эксперимент и публикацию: права на коммерческое применение зависят от условий аккаунта и конкретного голоса. Голосовое клонирование требует ещё более аккуратной работы с согласием человека и внутренними правилами бренда.
Плюсы
- Выбор голоса и модели отделён от параметров подачи, что удобно для воспроизводимой настройки.
- Есть средства управления скоростью, паузами и произношением.
- Подходит для выразительных голосовых дорожек, локализации и серийного контента.
- Готовое аудио можно получать в нескольких распространённых форматах.
Минусы
- Итог не полностью детерминирован, по этой причине отдельные фразы порой приходится генерировать ещё раз.
- Для длинного проекта необходима дисциплина версий: одинаковый голос без сохранённых настроек ещё не гарантирует одинаковую подачу.
- Условия публикации и права на конкретные голоса необходимо проверять до запуска коммерческой серии.
Кому подойдёт
Контент-командам, продюсерам, локализаторам и авторам рекламных или обучающих материалов, которым важнее выразительность и управляемая нейросетевая речь, чем локальная автономность.
6. Murf AI — студия для голосовых блоков, медиа и предпросмотра
Murf Studio соединяет редактор сценария, библиотеку голосов, голосовые настройки, медиаматериалы и временную шкалу. Текст разбивается на блоки, к каждому можно подобрать голос и параметры, затем весь проект прослушивается целиком. Это ближе к производственной студии, чем к простой кнопке чтения: структура удобна для презентаций, обучающих видеороликов, продуктовых демонстраций и корпоративных видео.
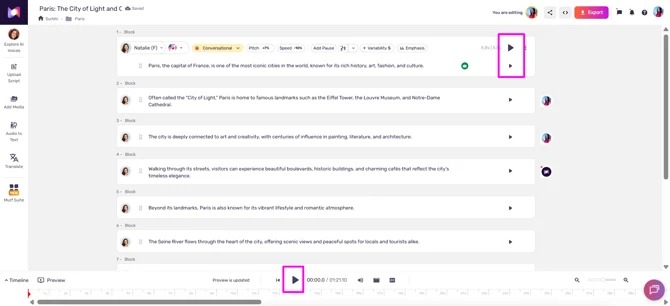
Преимущество блочного сценария проявляется при правках. Когда согласование затрагивает один абзац, меняется только соответствующий блок, а соседние реплики и медиаматериалы остаются на месте. Тоже проще сопоставлять варианты подачи: менять скорость, высоту тона, паузы и произношение на небольшом отрезке безопаснее, чем всякий раз пересобирать длинный файл. Для команды это уменьшает объём повторной ручной работы и делает контроль версий понятнее.
Murf AI работает в облаке и ориентирован на контент-производство, по этой причине его логично сопоставлять с ElevenLabs по выразительности и с видеоредакторами по сборке проекта. Однако полноценный монтаж сложного видео остаётся отдельной задачей: Murf удобнее как среда голосового производства с медиа, а не как универсальный нелинейный видеоредактор. Перед применением брендированных или клонированных голосов необходимо фиксировать права и согласия так же строго, как для любой другой синтетической речи.
Плюсы
- Блочный редактор сценария удобен для точечных правок и повторной генерации.
- Голосовые параметры, медиаматериалы и предпросмотр собраны в одном веб-проекте.
- Подходит для презентаций, e-learning, продуктовых демонстраций и маркетингового видео.
- Есть средства настройки темпа, высоты, пауз, произношения и характера подачи.
Минусы
- Работа зависит от облачной платформы и подключения к сети.
- Для сложного видеомонтажа понадобится отдельный специализированный редактор.
- Команде необходимо заблаговременно закрепить правила применения голосов и порядок хранения исходных сценариев.
Кому подойдёт
Маркетинговым и L&D-командам, которым необходим веб-инструмент для озвучивания презентаций, обучающих модулей, демонстраций продукта и видеороликов с частыми текстовыми правками.
7. Yandex SpeechKit — русскоязычный TTS для облачных сценариев
Yandex SpeechKit полезен в первую очередь как облачная инфраструктура синтеза речи. В SpeechKit Playground можно ввести текст, выбрать русский язык и голос, настроить скорость и прослушать итог. Такой стенд подходит для первичной оценки, а для системного применения доступны более гибкие настройки через программный интерфейс. Команда может сперва согласовать звучание на коротком тексте, а потом переносить параметры в продуктовый процесс.
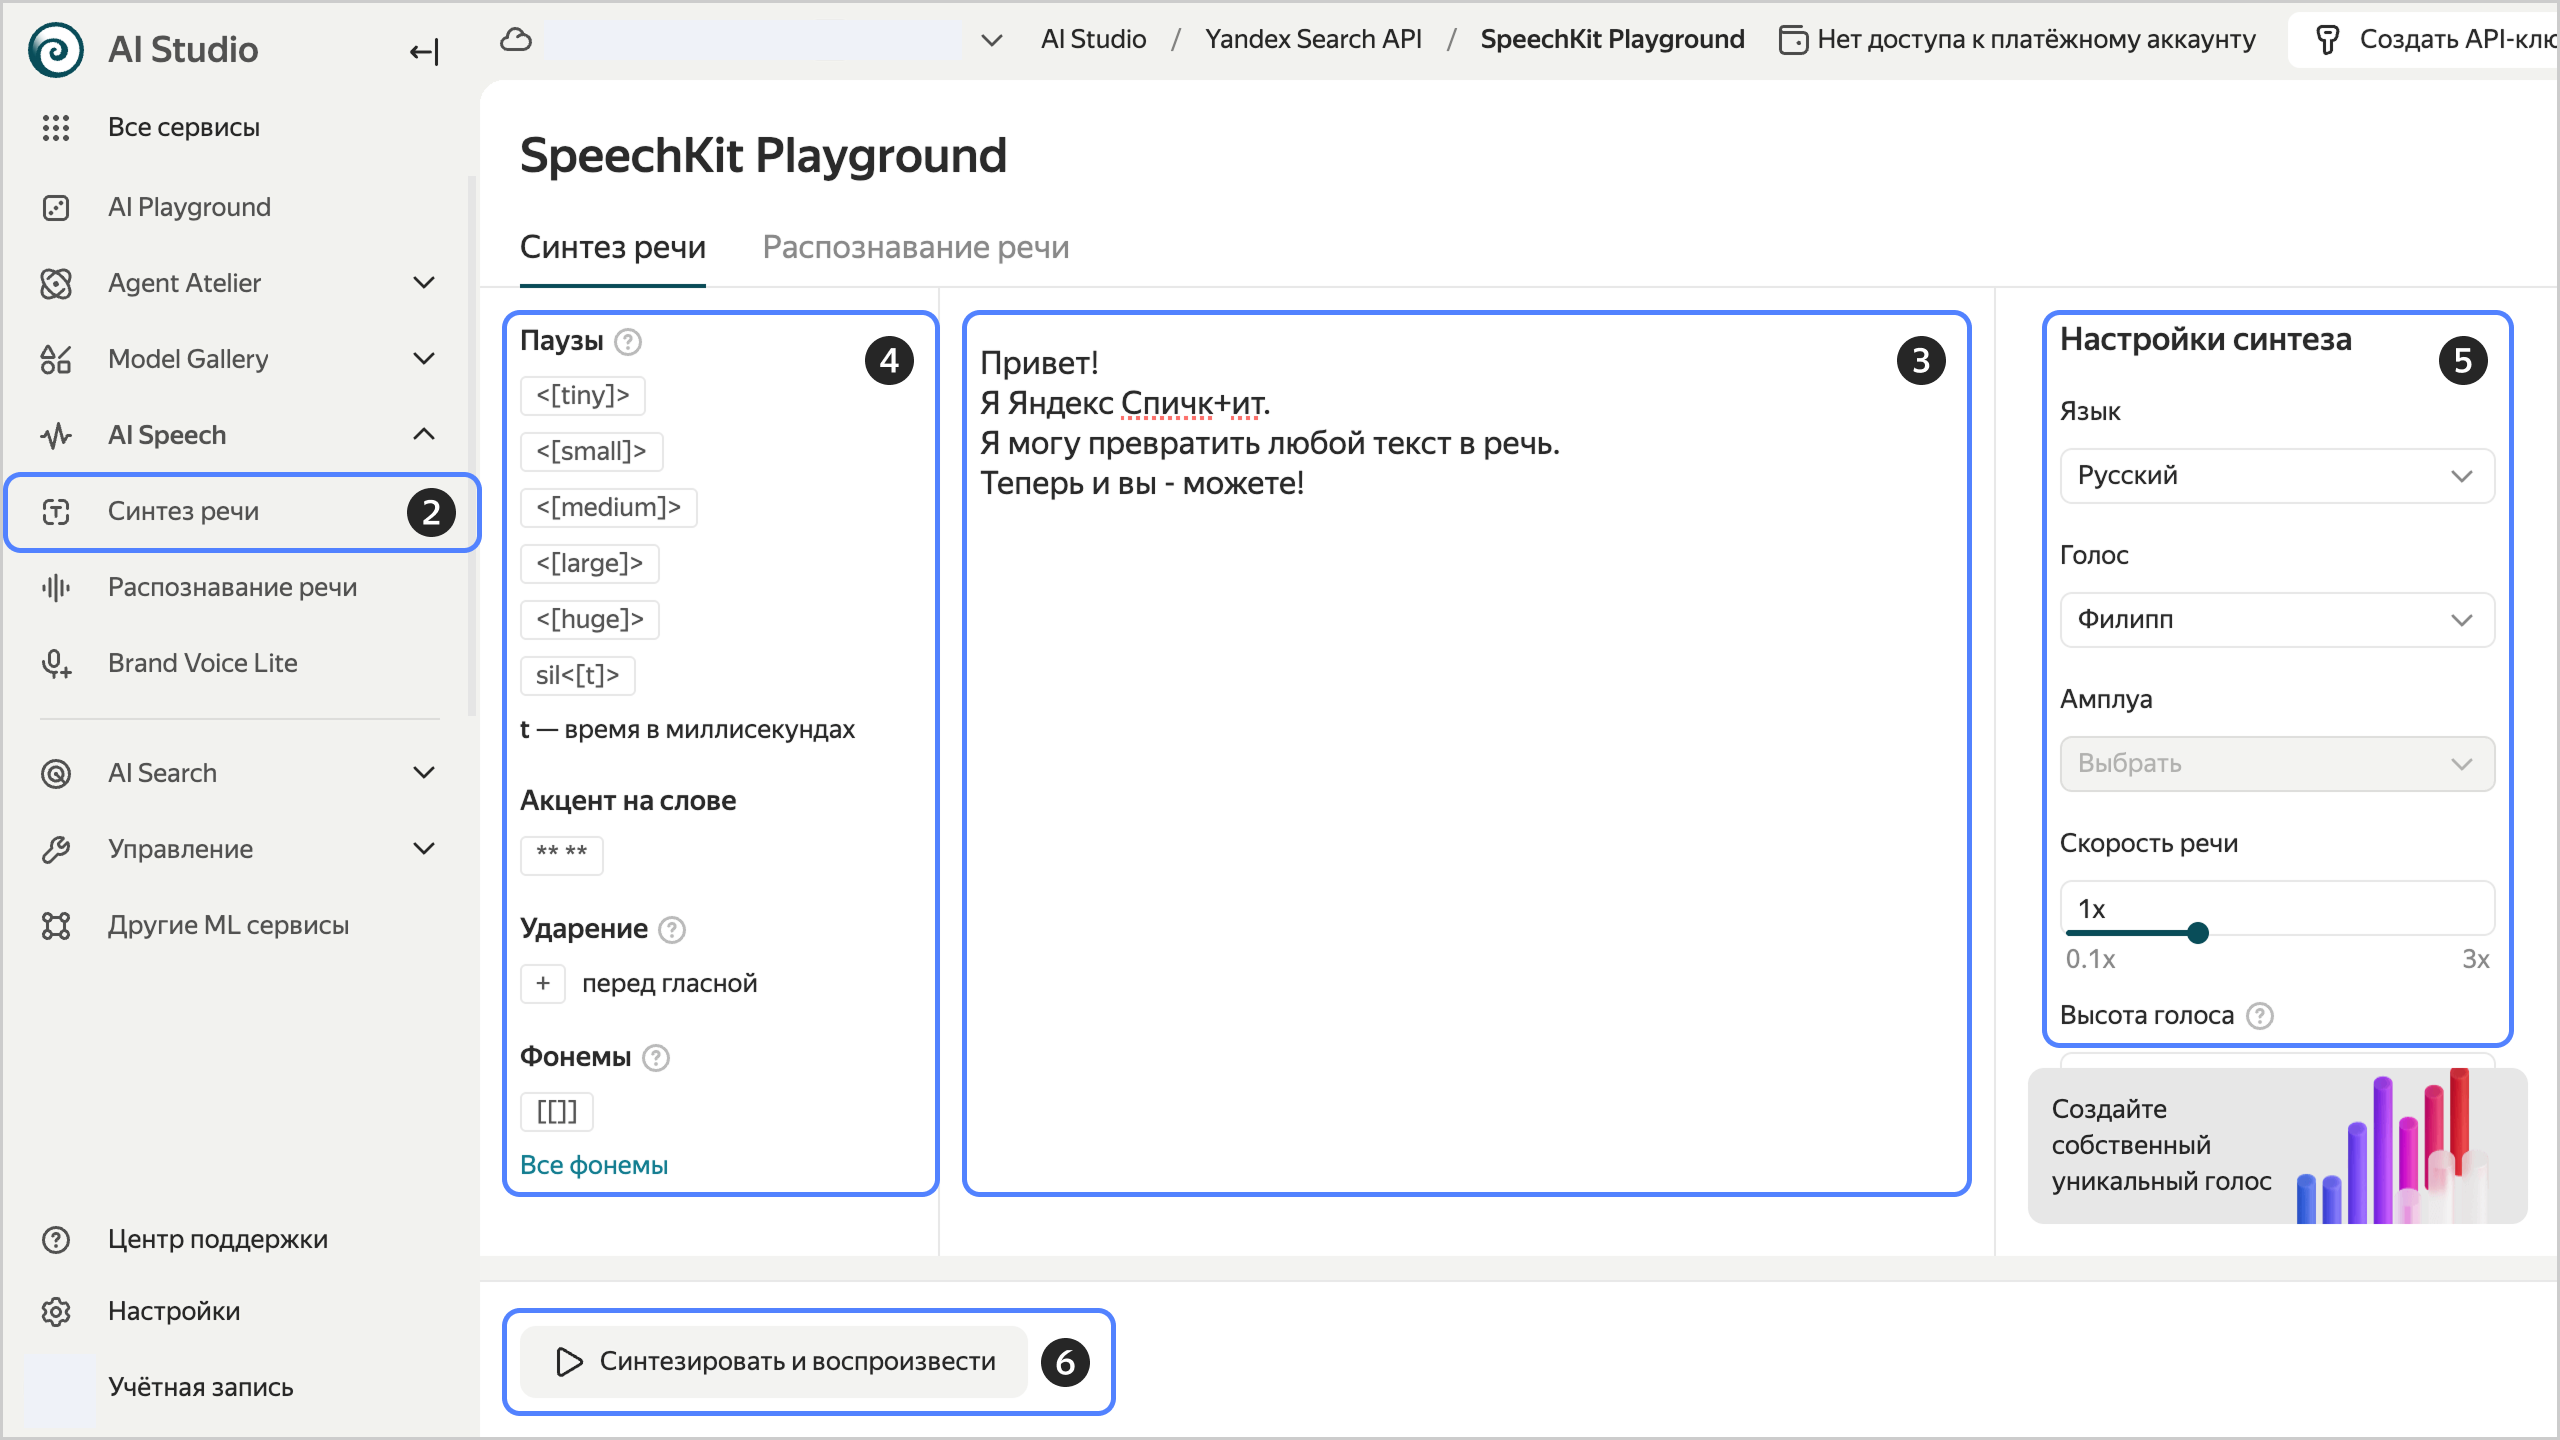
Для русского контента ценность SpeechKit в том, что сервис рассчитан на локальные языковые сценарии и даёт инструменты для управления синтезом. При подготовке голосового интерфейса, уведомлений или массовой озвучки лучше заблаговременно составить тестовый набор из дат, чисел, фамилий, сокращений, брендов и единиц измерения. Это выявляет проблемы ранее, чем они попадут в сотни автоматически созданных фрагментов.
SpeechKit меньше подходит пользователю, которому необходима готовая читалка с библиотекой книг. Его сильная зона — системное подключение: приложение, сайт, внутренний сервис или автоматизированная линия контента. Такое решение требует технической настройки и контроля облачных учётных данных, зато даёт предсказуемую архитектуру для повторяемого синтеза. Для разовой озвучки видеоролика проще воспользоваться редактором или веб-студией.
Плюсы
- Есть отдельный Playground для проверки голоса и базовых параметров до интеграции.
- Подходит для русскоязычных продуктовых сценариев и автоматического синтеза.
- Программный интерфейс позволяет встроить голос в сайт, приложение или внутренний сервис.
- Параметры можно закрепить централизованно для большого количества однотипных материалов.
Минусы
- Для полноценной интеграции необходимы разработка и настройка облачной инфраструктуры.
- Это не читалка электронных книг и не видеоредактор.
- При массовом синтезе нужен отдельный процесс контроля произношения и расходования облачного ресурса.
Кому подойдёт
Продуктовым командам, разработчикам и компаниям, которым необходим русский синтез речи внутри собственного сервиса, приложения, голосового интерфейса или автоматизированного контент-процесса.
8. Google Cloud Text-to-Speech — облачный синтез с текстом и SSML
Google Cloud Text-to-Speech предоставляет консольный интерфейс для синтеза и программное подключение. В консоли можно ввести обычный текст или SSML — Speech Synthesis Markup Language, язык разметки синтеза речи, — выбрать язык и голос, а затем настроить дополнительные параметры. SSML полезен, когда простой пунктуации недостаточно: в сценарии можно формализовать паузы и особенности чтения отдельных фрагментов.
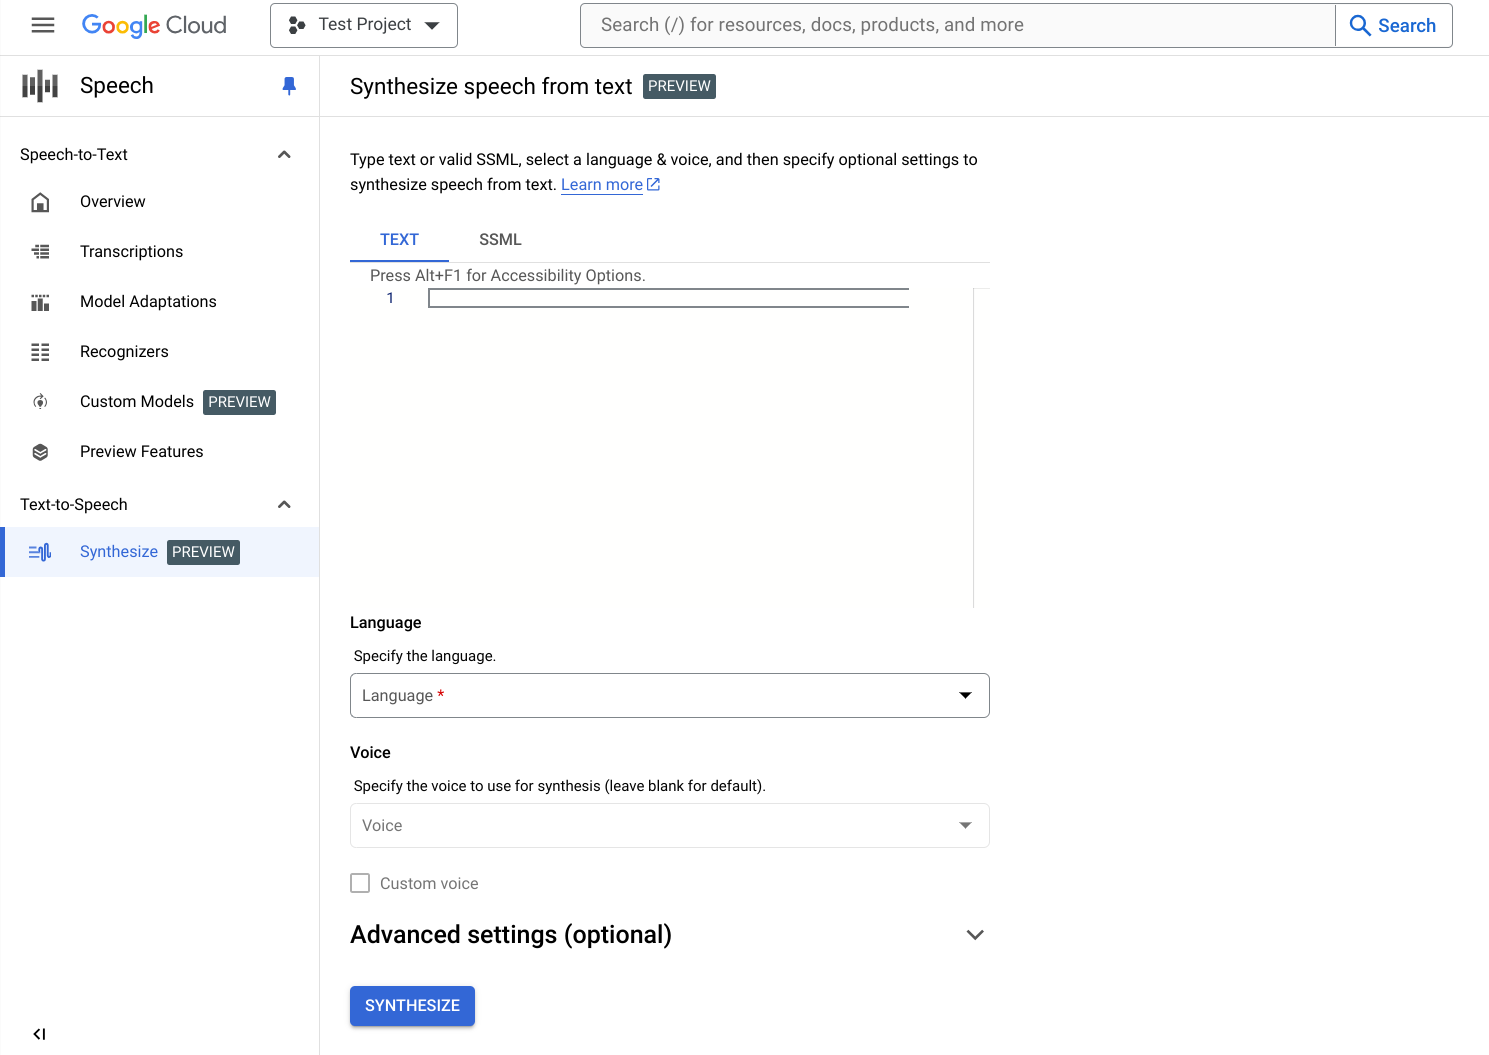
Google Cloud documentation, CC BY 4.0
Облачная модель подходит для продукта, который генерирует много однотипных сообщений: голосовые уведомления, чтение статей, справочные ответы, образовательные карточки. Сценарий лучше строить не как один гигантский текст, а как набор логических единиц. Тогда система может пересоздать только изменившуюся часть, а редактор — проверить её отдельно. Такой подход облегчает журналирование версий и сопоставление текста с готовым аудио.
Главное ограничение для редакционной команды — технический характер платформы. В ней нет библиотечной оболочки NaturalReader и нет монтажной шкалы ВидеоМОНТАЖ. Зато она удобна там, где синтез становится компонентом продукта. Документация Google Cloud распространяется по лицензии CC BY 4.0, по этой причине использованный в статье скриншот сопровождается требуемой атрибуцией в служебных данных пакета.
Плюсы
- Поддерживает обычный текст и SSML для формального управления синтезом.
- Подходит для программного подключения к приложениям и сервисам.
- Консоль помогает проверить язык, голос и параметры до разработки интеграции.
- Удобен для повторяемого массового синтеза небольших структурированных сообщений.
Минусы
- Для редактора без технической поддержки платформа сложнее готовых веб-студий.
- Нет встроенного видеомонтажа или библиотечной навигации по книгам.
- Качество нужно проверять на собственном языковом наборе, в особенности для имён и отраслевой терминологии.
Кому подойдёт
Разработчикам, продуктовым командам и компаниям, которые рассматривают синтез речи как часть приложения или автоматизированного сервиса и хотят управлять подачей через структурированную разметку.
9. Narakeet — озвучка сценариев и субтитров
Narakeet выделяется поддержкой сценариев, документов и файлов субтитров. В инструменте Text to audio можно загрузить SRT или VTT, выбрать язык и голос, прослушать предварительный итог и сформировать аудиодорожку. Для видео это практично: текст уже разбит по временным репликам, по этой причине не приходится ручным способом переносить каждую фразу из файла субтитров в отдельный синтезатор.
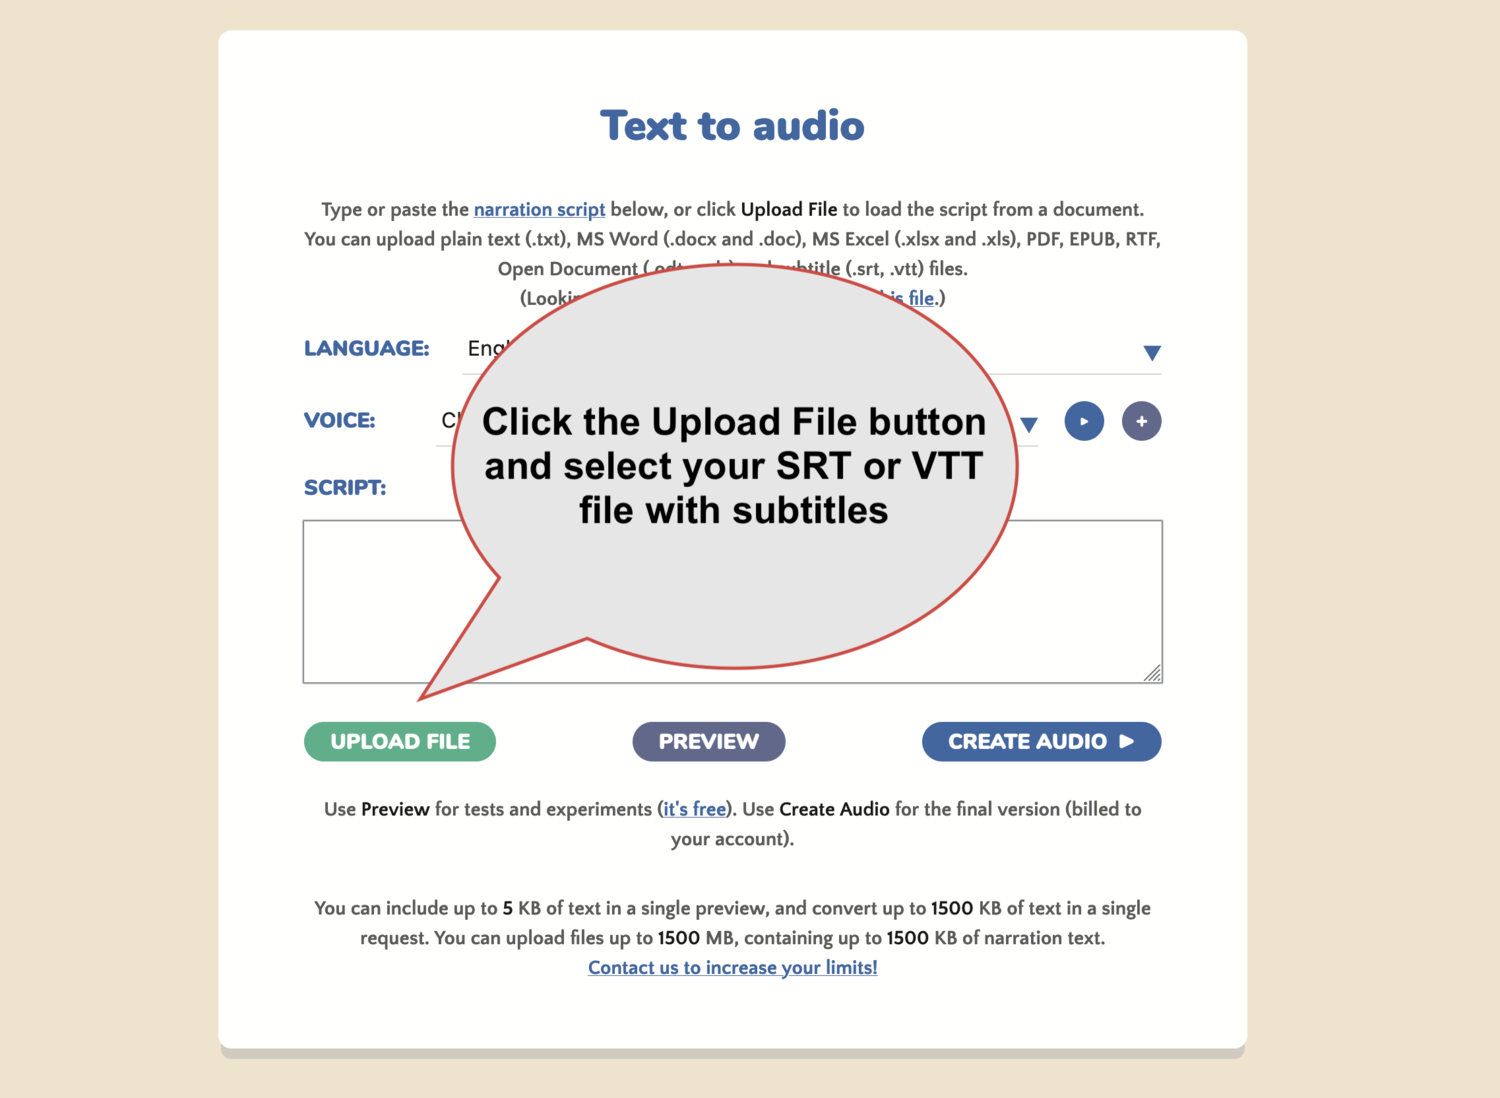
Сервис уместен при локализации обучающих видеороликов, демонстраций продукта и презентаций, где текстовая структура уже подготовлена. Отдельные реплики легче корректировать, чем длинный монолог, а синхронизацию можно оценивать по тайм-кодам исходных субтитров. Автоматическая озвучка не отменяет финального монтажа: продолжительность синтетической фразы может отличаться от оригинала, и часть сцен потребуется растянуть, сократить или переозвучить с другим темпом.
Narakeet стоит выбирать за документно-сценарный процесс, а не только за тембр голосов. Если команда постоянно получает SRT из видеоредактора или системы локализации, сервис сокращает ручной перенос текста. Если задача — читать книги или строить голосовой интерфейс приложения, другие варианты из рейтинга соответствуют процессу лучше. Отдельное достоинство структуры субтитров — возможность сохранять связь между репликой и моментом в видео.
Плюсы
- Работает с SRT и VTT, что удобно для локализации видео и обучающих материалов.
- Поддерживает сценарный подход и предварительное прослушивание итога.
- Сокращает ручной перенос реплик между системой субтитров и синтезом речи.
- Подходит для потоковой работы с большим числом коротких фрагментов.
Минусы
- После синтеза всё равно необходим контроль продолжительности реплик относительно видеоряда.
- Для интерактивного продукта программная инфраструктура специализированных облачных TTS может быть удобнее.
- Для чтения книг нет библиотечной организации уровня мобильных читалок.
Кому подойдёт
Командам локализации, авторам курсов и видеопродюсерам, которые уже работают с субтитрами и хотят быстро превращать структурированный сценарий в голосовую дорожку.
10. NaturalReader — веб-читалка документов с отдельным коммерческим продуктом
NaturalReader объединяет веб-приложение, мобильные версии и расширение браузера. Основной сценарий — открыть документ или веб-материал и слушать его с синхронным выделением. Поддерживаются распространённые офисные документы, PDF и электронные книги; для отсканированных материалов предусмотрено распознавание текста. Для пользователя это в первую очередь читалка, а не монтажная студия.
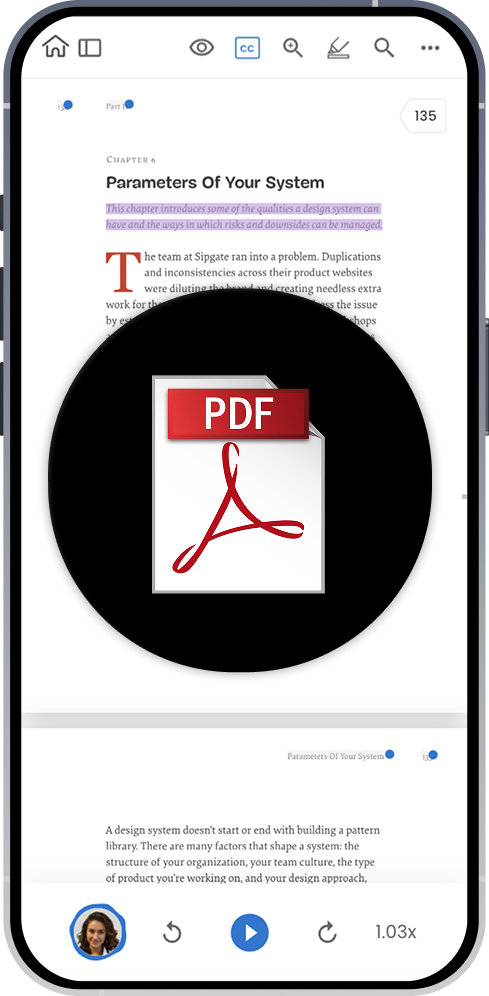
Важное практическое различие NaturalReader — разделение личного и коммерческого продукта. Личная читалка предназначена для собственного прослушивания, тогда как публичные голосовые материалы требуют режима и условий, предназначенных для коммерческого применения. Для маркетинговой команды это полезный ориентир: нельзя переносить привычку «я могу прослушать этот текст» на право публиковать полученную дорожку в рекламе или на сайте.
NaturalReader удобен для сотрудников, которые перерабатывают много текстовой информации: отчёты, статьи, PDF, учебные материалы. Возможность продолжать работу на различных устройствах делает его практичнее локальной Windows-утилиты для чтения. Но если цель — получить строгую сценарную структуру с десятками голосовых блоков и затем собрать видеоролик, Murf AI, Narakeet или ВидеоМОНТАЖ дают более прямой производственный путь.
Плюсы
- Читает документы и веб-материалы, включая сценарии с распознаванием отсканированного текста.
- Доступен в браузере и на мобильных устройствах.
- Подходит для регулярного прослушивания длинных материалов и обучения.
- Коммерческий продукт отделён от личной читалки, что помогает не смешивать режимы применения.
Минусы
- Личный продукт нельзя автоматически считать инструментом для публичной коммерческой озвучки.
- Для сложной сборки видео и точной синхронизации реплик потребуется иной редактор.
- Веб-сценарий зависит от облачной обработки и учётной записи.
Кому подойдёт
Тем, кто много читает документы и веб-страницы, хочет слушать их на различных устройствах и готов отдельно выбирать коммерческий режим, когда голосовая дорожка предназначена для публичного контента.
iPhone и Android: чтение документов и материалов в дороге
Мобильные приложения решают другую задачу: быстро превратить в аудио файл, ссылку, отсканированную страницу или книгу, когда пользователь не сидит за рабочим компьютером. В этой группе в особенности важны импорт источников, синхронное выделение, работа гарнитуры, регулировка скорости и возможность продолжать чтение с нужного места. Для студийной закадровой дорожки смартфон обычно остаётся вспомогательным устройством.
11. Speechify — мобильный импорт файлов, ссылок и сканов
Speechify на Android и iOS строится вокруг импорта источников: можно добавить файл, текст, ссылку, облачный документ или отсканировать страницу камерой. После этого материал попадает в библиотеку прослушивания. Для пользователя, который чередует статьи, документы и книги, такой подход удобнее ручного копирования текста в генератор всякий раз. Мобильный интерфейс превращает приложение скорее в универсальную читалку, чем в студию производства голосовых файлов.
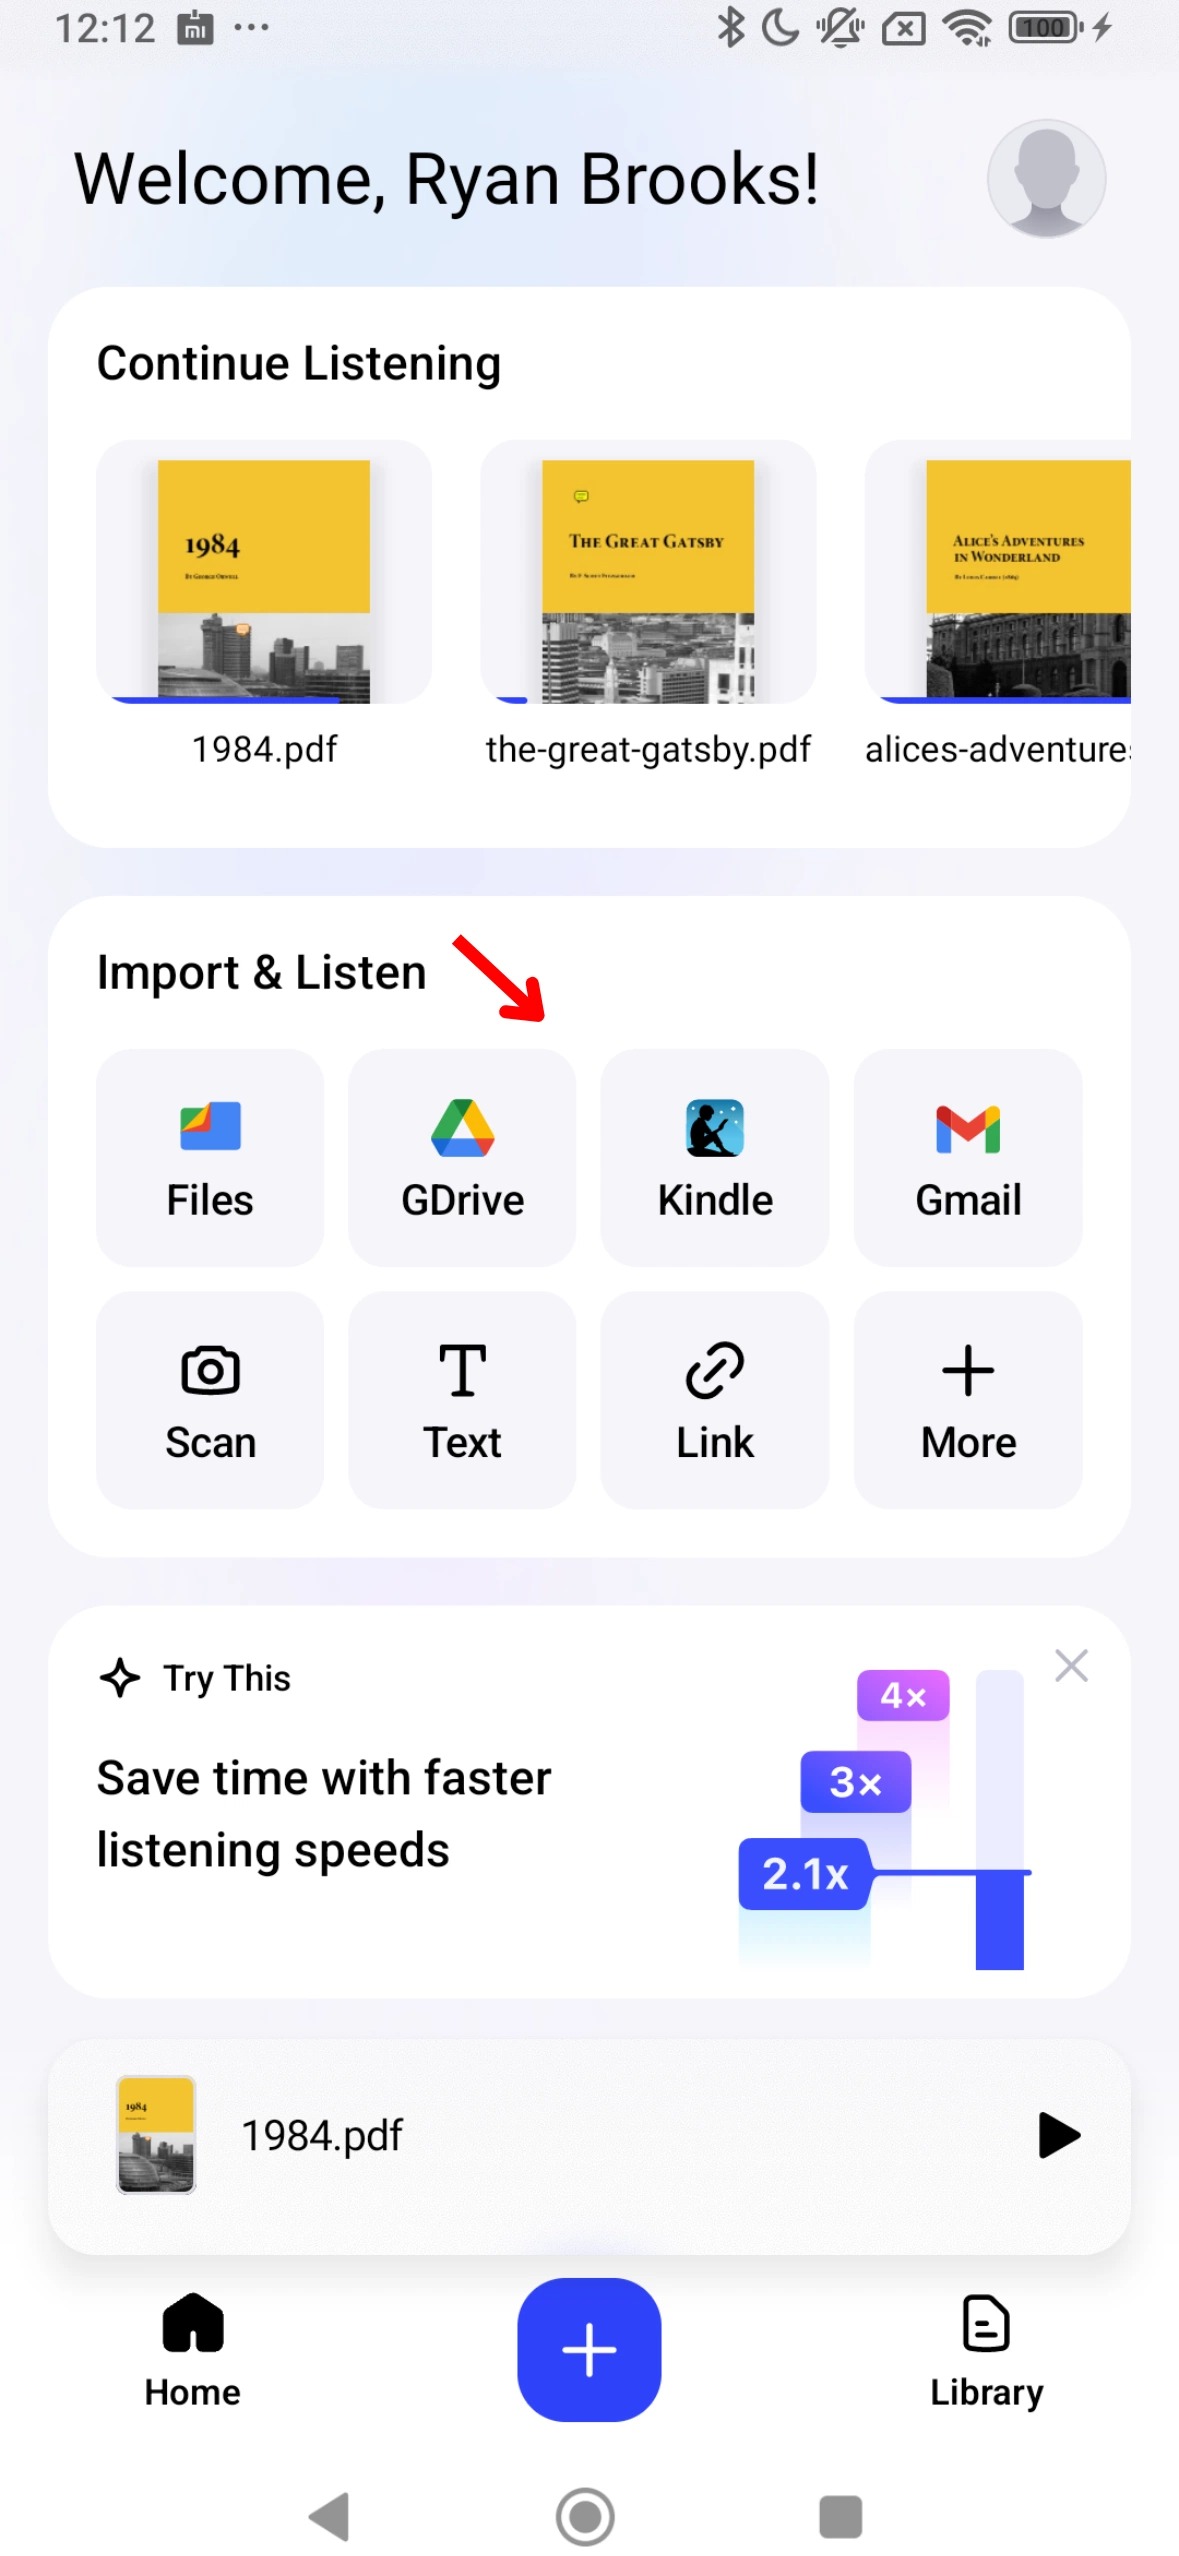
Отдельная ценность приложения — управление скоростью чтения. Это полезно не для рекламной озвучки, а для личной продуктивности: знакомый отчёт можно слушать быстрее, сложный учебный материал — медленнее. При подготовке контента Speechify тоже подходит как второе ухо: автор может прослушать собственный текст и заметить тяжёлые предложения, повторы или странную пунктуацию до публикации.
Для финального публичного голоса необходимо отдельно смотреть условия конкретного режима продукта. Мобильная читалка и коммерческая генерация — различные сценарии. По этой причине в рабочей коммуникации Speechify рационально применять в первую очередь как средство чтения, проверки текста и доступности, а студийную голосовую дорожку выпускать в инструменте с явно подходящими правами и форматом экспорта.
Плюсы
- Импортирует файлы, текст, ссылки, облачные документы и материалы со сканера.
- Удобен для личного прослушивания рабочих документов и обучения на смартфоне.
- Регулировка скорости помогает подстроить чтение под сложность материала.
- Подходит для аудиопроверки собственного текста перед публикацией.
Минусы
- Мобильный сценарий не заменяет полноценную студию монтажа закадровой дорожки.
- Условия публичного применения готового голоса необходимо отделять от личного чтения.
- Для сложных слов и брендовой терминологии требуется предварительная проверка произношения.
Кому подойдёт
Сотрудникам, студентам, редакторам и менеджерам, которым необходимо слушать документы, статьи и отсканированные материалы на смартфоне и быстро переключаться между различными источниками.
12. @Voice Aloud Reader — Android-читалка с широким импортом
@Voice Aloud Reader для Android читает текст, которым делятся иные приложения, веб-страницы и локальные документы. В карточке приложения заявлена поддержка PDF, EPUB, документов Word, HTML и обычного текста; доступно сохранение синтезированной речи в аудиофайл с применением установленного TTS-движка. Как и Balabolka, приложение во многом зависит от голоса, установленного на устройстве.
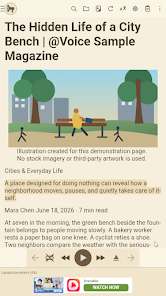
Сильная сторона @Voice — интеграция с повседневным Android-процессом. Пользователь может передать статью из браузера, документ из файлового менеджера или текст из иного приложения и продолжить слушать его без отдельной подготовки. Для длинного чтения это снижает трение: не нужно постоянно переносить материал в облачную студию. Есть правила произношения, по этой причине часто встречающиеся наименования можно исправить один раз и применять дальше.
Для маркетинговой озвучки приложение ограничено качеством мобильного TTS и отсутствием полноценной студийной среды. Оно полезно как читалка, проверка текста и средство доступности. Если необходим один и тот же фирменный голос в десятках видеороликов, лучше применять сервис, где голос, модель и параметры фиксируются централизованно, а итоговый файл проходит отдельный редакторский контроль.
Плюсы
- Работает с текстом и документами, переданными из других Android-приложений.
- Поддерживает несколько распространённых форматов книг и офисных документов.
- Есть правила произношения и сохранение речи через доступный TTS-движок.
- Удобно применять как универсальную читалку на Android.
Минусы
- Качество напрямую зависит от установленного на устройстве голосового движка.
- Не предназначен для сложного монтажного проекта или командной студийной работы.
- Коммерческие права определяются не только приложением, но и выбранным голосом.
Кому подойдёт
Пользователям Android, которым необходима гибкая локальная читалка для статей, PDF, электронных книг и текстов из других приложений с возможностью настроить произношение.
13. Voice Dream Reader — доступное чтение на устройствах Apple
Voice Dream Reader рассчитан на iPhone, iPad и Mac и делает акцент на доступности и работе с документами. В приложение можно добавлять материалы из файлов, веб-страниц, буфера обмена и сканера. Поддерживаются распространённые форматы документов и электронных книг, а чтение сопровождается визуальной навигацией по тексту. Такой подход делает приложение удобным не только для книг, но и для регулярной работы с длинными профессиональными материалами.
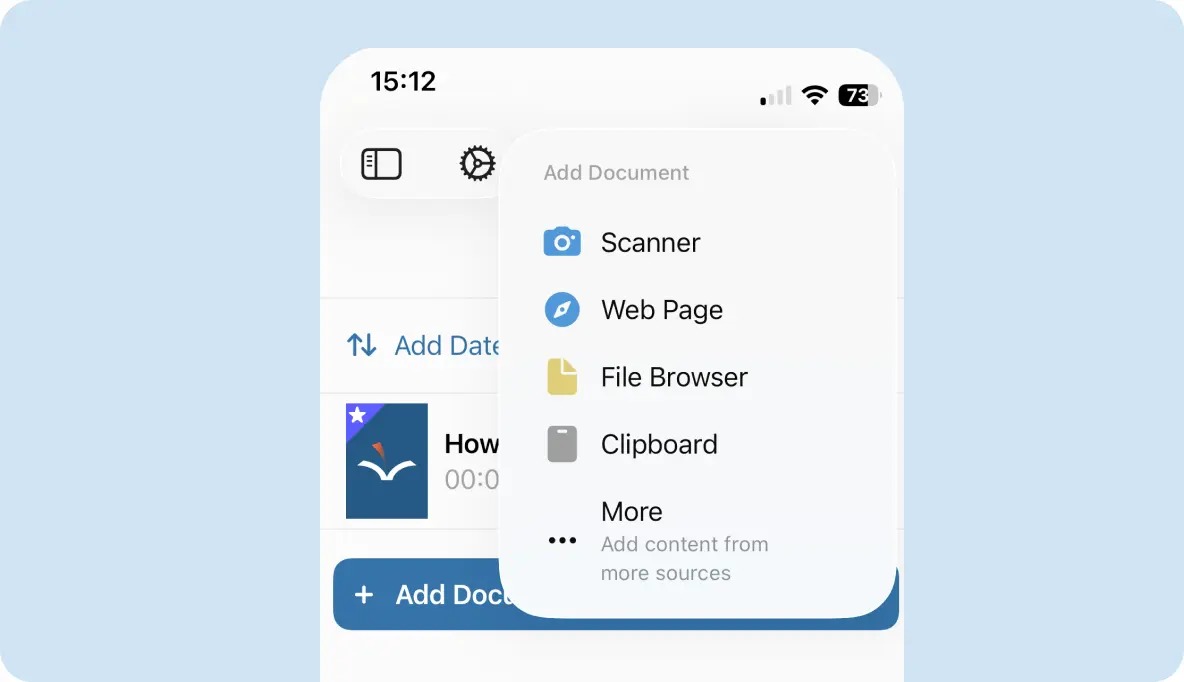
Для профессиональной среды важна не только озвучка, но и связка с задачами чтения: выделение, заметки, навигация и продолжение работы на устройстве. Voice Dream Reader полезен сотрудникам, которым необходимо быстро обрабатывать большой объём материалов без постоянного обращения к экрану. Поддержка системных функций доступности Apple делает приложение в особенности уместным в сценариях инклюзивного доступа к документам.
Как и другие читалки, Voice Dream Reader не стоит оценивать по критериям рекламной студии. Его задача — сделать текст доступным и удобным для прослушивания. Для публикации брендовой закадровой дорожки важнее сервисы с явным управлением коммерческими голосами, экспортом и повторяемыми параметрами. Тут же главным итогом остаётся комфортное чтение, а не законченный медиапродукт.
Плюсы
- Поддерживает iPhone, iPad и Mac и принимает документы из различных источников.
- Сильный акцент на доступности, навигации и удобстве чтения.
- Подходит для PDF, электронных книг, веб-материалов и рабочих документов.
- Позволяет совмещать прослушивание с заметками и работой над текстом.
Минусы
- Это в первую очередь читалка, а не студия коммерческой голосовой генерации.
- Для сложной синхронизации с видео требуется отдельный монтажный процесс.
- Финальное качество зависит от выбранного голоса и настроек платформы.
Кому подойдёт
Пользователям экосистемы Apple, которым важно доступное и комфортное чтение документов, статей и книг с возможностью работать с материалом параллельно с прослушиванием.
14. eReader Prestigio — Android-библиотека с TTS
eReader Prestigio объединяет книжную библиотеку и функцию чтения вслух на Android. В карточке приложения заявлены FB2, EPUB, PDF, DJVU, MOBI, HTML, DOC, RTF и TXT, а также интеграции с облачными хранилищами. Это делает приложение удобным для пользователя, у которого книги и документы разбросаны по различным источникам, но необходим единый интерфейс библиотеки и возможность слушать материал в дороге.
В отличие от Speechify, который строит опыт вокруг импорта любого контента, eReader Prestigio заметнее ориентирован на электронные книги. Для продолжительного прослушивания это плюс: библиотека, обложки, навигация и продолжение чтения находятся в одном месте. В рабочих сценариях приложение можно применять для методичек, отраслевой литературы и внутренних документов, когда требуется именно мобильное чтение, а не производство готового медиаматериала.
Для публичной озвучки возможности ограничены: голос определяется доступным синтезатором, а студийной работы с эмоциями, блоками сценария и синхронизацией с видео нет. По этой причине eReader Prestigio заканчивает рейтинг как удобная мобильная читалка, но не конкурирует напрямую с ElevenLabs, Murf AI или ВидеоМОНТАЖ в производстве голосового контента. Его сильная сторона — библиотечный контекст и повседневное прослушивание.
Плюсы
- Поддерживает большой набор форматов электронных книг и документов.
- Объединяет библиотеку, навигацию и чтение вслух в одном Android-приложении.
- Подходит для продолжительного прослушивания книг и методических материалов.
- Работает с контентом из облачных источников и локального хранилища.
Минусы
- Меньше средств управления выразительностью, чем у специализированных нейросетевых студий.
- Не предназначен для монтажа рекламной или продуктовой закадровой дорожки.
- Качество речи зависит от используемого мобильного TTS-движка.
Кому подойдёт
Пользователям Android, которым необходима привычная электронная библиотека с голосовым чтением книг и документов, а не отдельный сервис производства озвучки.
Как подготовить текст, чтобы синтез речи звучал естественнее
Даже сильный голос плохо спасает неготовый сценарий. Текст для чтения глазами и текст для произнесения устроены по-разному: длинная фраза, которая нормально выглядит на странице, может звучать тяжело; сокращение, понятное специалисту, синтезатор может прочитать по буквам; плотное перечисление чисел превращается в монотонный поток. Практический процесс лучше начинать с речевой редакции текста, а уже затем выбирать голос. Базовые методы преобразования материала в аудио собраны в отдельной инструкции Xeon Live о том, как конвертировать текст в аудио на разных платформах.
Сокращайте синтаксическую длину, а не смысл
Фразы на двадцать пять–тридцать слов легко теряют естественный ритм, в особенности когда внутри есть перечисления и вставные конструкции. Для озвучки полезнее разбить такую фразу на две или три самостоятельные. Это не означает делать речь рубленой: соседние предложения должны сохранять логическую связь. Хороший ориентир — одна завершённая мысль на один речевой отрезок. Тогда и нейросетевой голос, и системный синтезатор реже ставят паузу в неожиданном месте и меньше перегружают слушателя.
После редактуры полезно прочитать текст вслух собственным голосом. Места, где приходится возвращаться глазами назад, практически всегда требуют упрощения. Этот приём не оценивает качество конкретного синтезатора, но быстро выявляет проблемы самого сценария: перегруженные определения, слишком ранние местоимения, повтор одинаковых слов, тяжёлые цифровые конструкции. Чем чище исходная фраза, тем меньше времени потом уходит на повторную генерацию и монтаж.
Прописывайте числа так, как они должны прозвучать
Дата, номер модели, процент и диапазон могут читаться по-разному в зависимости от контекста. Автоматическая нормализация помогает, но не заменяет редакторское решение. Когда конкретное чтение влияет на смысл, число лучше записать словами или перестроить фразу. В особенности внимательно проверяются годы, порядковые числительные, дроби и сочетания цифр с латинскими буквами. Для продуктового видео ошибка в наименовании модели заметнее, чем небольшая разница в тембре.
Для длинной серии необходимо единое правило. Если номер модели всегда произносится по отдельным цифрам, это фиксируется в редакционной памятке. Тогда различные авторы не будут готовить один и тот же бренд по-разному, а синтез не придётся исправлять ручным способом в каждом выпуске. Памятка тоже необходима для сокращений подразделений, обозначений единиц измерения и регулярных формулировок юридического характера.
Фамилии, бренды и отраслевые термины проверяйте отдельным тестом
Самая дорогая ошибка — обнаружить неверное ударение после монтажа десятка сцен. До основной генерации стоит собрать небольшой словарь всех имён, брендов, городов, аббревиатур и профессиональных терминов. Сперва синтезируется только этот список, затем выбирается устойчивое написание и фиксируется рабочий вариант. В Balabolka и некоторых облачных системах можно применять словари или специальные правила; в других сервисах помогают фонетическое написание, альтернативная орфография или SSML.
Не следует менять метод записи слова между фрагментами без причины. Если наименование продукта однажды пришлось записать фонетически, эту форму необходимо хранить рядом со сценарием. Это уменьшает число случайных различий между видеороликами и упрощает работу новому редактору, который подключится позднее. Для большого проекта такой словарь становится частью производственной документации наряду со списком голосов и правилами экспорта.
Паузы должны отражать смысловую структуру
Запятая, тире, двоеточие и новая строка по-разному влияют на паузу. В нейросетевых сервисах часть ритма определяется моделью, но пунктуация всё равно остаётся сильным сигналом. Не стоит добавлять многоточия повсюду ради эмоциональности: это часто делает подачу неестественно медленной. Сперва исправляется синтаксис, затем точечно применяются настройки пауз или разметка, когда платформа её поддерживает.
Для рекламного видеоролика паузы сверяются с монтажными точками. Короткая остановка перед наименованием продукта может усилить смысл, а случайная пауза внутри фразы разрушает темп. По этой причине окончательная продолжительность реплики определяется не только текстом, но и кадром, музыкой и соседней сценой. Проверять необходимо готовый видеоролик, а не только аудиофайл в окне синтезатора.
Разделяйте текст на редактируемые блоки
Длинная генерация экономит несколько действий, но усложняет правки. Гораздо практичнее делить материал по абзацам, слайдам, сценам или смысловым репликам. Тогда неудачное слово пересоздаётся локально, а одобренные части остаются неизменными. Такой принцип одинаково работает в Murf AI, Narakeet, видеоредакторе и собственной облачной интеграции. Он же упрощает согласование: редактору можно отправить конкретную реплику, а не ещё раз слушать всю дорожку.
Для каждого блока стоит хранить исходный текст и понятный идентификатор сцены. Финальный аудиофайл должен однозначно сопоставляться с версией сценария. В командной работе это важнее красоты имени файла: через несколько месяцев необходимо без повторного прослушивания понять, какая реплика относится к какому кадру и какая редакция текста была использована. Чем длиннее цикл производства, тем ценнее эта дисциплина.
Практические сценарии для маркетинга, контента и бизнеса
Рекламные и продуктовые видеоролики
Для короткого видео сперва определяют продолжительность сцены и роль голоса: объяснять, убеждать, перечислять особенности или сопровождать демонстрацию интерфейса. Затем сценарий делят на реплики, чтобы каждую можно было заменить независимо. Если необходим единый цикл производства в Windows, удобен ВидеоМОНТАЖ; если приоритет — выразительный облачный голос, дорожку можно подготовить в ElevenLabs или Murf AI и затем синхронизировать с видеорядом. Детальный порядок работы разобран в гайде Xeon Live о самостоятельной озвучке видео.
Проверка итога выполняется на готовом видеоролике. Голос может звучать естественно отдельно, но конфликтовать с музыкой, заставлять зрителя одновременно читать титры и слушать другую формулировку или не попадать в смену планов. Финальный просмотр идёт в реальном темпе публикации, желательно на обычных ноутбучных динамиках и смартфоне, а не только в студийных наушниках. Так обнаруживаются реальные проблемы разборчивости, а не абстрактное качество тембра.
Презентации, e-learning и внутреннее обучение
В обучающих материалах важнее стабильность и разборчивость, чем максимальная эмоциональность. Текст лучше привязать к слайдам и смысловым блокам: один голосовой фрагмент — одна завершённая мысль. Murf AI удобен такой структурой прямо в веб-проекте, а Narakeet — когда сценарий уже оформлен как субтитры или последовательность реплик. Для внутреннего курса в особенности полезно хранить произношение наименований продуктов, должностей и профессиональных сокращений в общей памятке.
Измерять качество стоит не реакцией «звучит хорошо», а количеством исправлений на модуль. Если после первого согласования приходится пересоздавать десять из пятнадцати фрагментов, проблема может быть не в голосе, а в неподготовленном тексте. Отдельно считаются ошибки произношения, нарушения темпа и содержательные правки — это различные причины и для каждой необходим свой метод улучшения процесса. Такой учёт быстро показывает, где команда теряет время.
Аудиоверсии статей, инструкций и книг
Для длинного текста решающими становятся навигация и устойчивость. NaturalReader, Balabolka, Speechify и Voice Dream Reader удобны для прослушивания документов; если аудиоверсия пойдёт в публикацию, необходим отдельный производственный процесс с правами на голос, редактированием и финальным мастер-файлом. В материале Xeon Live о том, как сделать аудиокнигу самостоятельно, подробно разобраны подготовка текста, работа с голосом и финальная сборка.
Большой материал обязательно делят на главы и логические части. Это уменьшает риск потерять уже удачную генерацию и упрощает повторную работу после редакторской правки. Тоже стоит нормализовать громкость между частями и проверить начало и конец каждого файла: случайно обрезанная пауза или слишком резкий стык в особенности заметны при последовательном прослушивании. Для многочасового материала стабильность важнее единичных эффектных фраз.
Локализация видео и мультиязычные версии
Локализация — это не механическая замена языка. Переведённая фраза часто меняет длину, по этой причине исходный монтаж перестаёт совпадать с речью. Лучше работать от сцен и субтитров: Narakeet удобен для SRT/VTT, а облачные генераторы — для выбора подходящего голоса и характера подачи. После синтеза сверяются смысл, произношение имён, длина реплики и то, не заходит ли голос в следующую сцену. Порой корректнее изменить монтаж, а не ускорять речь до неестественного темпа.
Для бренда полезно заблаговременно определить голосовую политику: один тип голоса для всех языков либо локально подходящий голос для каждой страны. Второй подход может звучать естественнее, но усложняет управление. В любом случае локализацию нельзя оценивать только по тембру: правильность перевода и культурная уместность важнее технической гладкости синтеза. Необходим отдельный языковой просмотр человеком, который понимает целевой язык и контекст.
Голосовые функции сайта и приложения
Когда синтез становится частью продукта, ручная веб-студия перестаёт быть центром процесса. Тут уместны Yandex SpeechKit или Google Cloud Text-to-Speech: текст передаётся программно, параметры задаются централизованно, а итог применяется приложением. Архитектура должна учитывать повторные попытки, кэширование готовых фрагментов, журналирование версии текста и защиту облачных учётных данных. Для часто повторяющихся сообщений выгоднее хранить уже готовый аудиорезультат, чем пересоздавать его всякий раз.
Редакционная команда всё равно остаётся частью процесса. Она готовит тестовый набор, на котором проверяются голоса после изменения модели или настроек. В него включают обычные фразы, длинные предложения, числа, даты, аббревиатуры, имена и сообщения об ошибках. Так изменение качества обнаруживается до того, как его услышат реальные пользователи. Технический мониторинг и редакционный контроль дополняют друг друга, но решают различные задачи.
Как объективно сопоставить два голоса на одном тексте
Сравнение должно начинаться с одинакового материала. Если один сервис получает короткую рекламную фразу, а второй — длинный абзац с числами, вывод будет случайным. Подготовьте тестовый текст приблизительно на одну–две минуты речи и включите в него типовые элементы проекта: наименование бренда, имена, дату, процент, перечисление, длинное предложение и несколько терминов. Все кандидаты должны читать одну и ту же редакцию текста с максимально близкими настройками темпа.
- Произношение: сколько слов потребовали ручной коррекции на тысячу знаков текста.
- Ритм: сколько пауз пришлось исправить или дополнительно размечать.
- Стабильность: насколько одинаково голос ведёт себя в соседних фрагментах и после повторной генерации.
- Редакторская трудоёмкость: сколько минут заняла подготовка одной минуты финального аудио после первого синтеза.
- Совместимость с процессом: можно ли заменить одну реплику без пересборки всего материала.
- Контроль прав: понятны ли условия применения выбранного голоса для нужного типа публикации.
- Экспорт: подходит ли получаемый формат для дальнейшего монтажа, архива и публикационной цепочки.
Оценки лучше фиксировать непосредственно после прослушивания, не пытаясь вывести идеальный балл до теста. Для команды достаточно шкалы от одного до пяти по каждому критерию и короткого комментария, что именно не устроило. Тогда видно, что один голос выигрывает по естественности, но требует много ручной коррекции терминов, а другой чуть менее эмоционален, зато стабилен и быстрее в производстве. Для регулярного контента второй вариант часто оказывается практичнее.
Состав тестового фрагмента
Тест должен отражать реальный контент, а не специально подобранные лёгкие предложения. Для бренда достаточно нескольких блоков: короткое вступление, предложение с наименованием продукта, фраза с числом и датой, перечисление из трёх пунктов, предложение с профессиональным термином, вопрос и спокойное заключение. Если в работе систематически встречаются англоязычные наименования, их тоже включают. Такой набор быстро показывает, насколько голос подходит именно вашему языковому окружению.
Один и тот же тестовый материал полезно хранить между сменами сервисов. Тогда новый инструмент сопоставляется с предыдущим на стабильной основе, а впечатление не зависит от случайного демо. При значительном изменении контента тест обновляют: к примеру, команда начала выпускать больше финансовых видеороликов и добавила много чисел, либо перешла к техническим презентациям с англоязычными наименованиями. Набор должен следовать за реальной работой.
Метрики, по которым видно, что процесс озвучки стал лучше
После внедрения синтеза речи итог стоит измерять не только временем генерации. Сервис способен создать звук за секунды, но редактор может потратить заметно больше времени на исправление ударений и монтаж. Необходима метрика всего процесса — от утверждённого текста до принятого аудиофайла. Тогда видно, в самом деле ли новый инструмент ускорил выпуск или только перенёс ручную работу в другое место. Для управленческого решения это гораздо полезнее субъективного впечатления от голоса.
- Время до готовой дорожки: от статуса «текст утверждён» до файла, принятого редактором без замечаний.
- Число коррекций произношения: количество слов и фраз, которые пришлось переписать или разметить на тысячу знаков.
- Повторные генерации: сколько попыток в среднем требуется на одну финальную реплику.
- Монтажные вмешательства: сколько раз приходится ручным способом резать, растягивать или сдвигать голос после синтеза.
- Возвраты после согласования: сколько готовых фрагментов переделываются из-за голоса, а не из-за изменения текста.
- Стабильность серии: количество заметных различий тембра или темпа между выпусками с одинаковыми настройками.
- Доступность исходников: можно ли спустя несколько месяцев восстановить, каким голосом и с какими параметрами была сделана конкретная реплика.
Собирать все показатели бессрочно не нужно. Достаточно двух–трёх контрольных проектов до внедрения и нескольких после. Если время снизилось, а число переделок не выросло, инструмент в самом деле улучшил процесс. Если генерация стала быстрой, но редакторская доводка выросла вдвое, стоит менять голос, подготовку текста или сам сервис. Эта же логика помогает сопоставлять внутреннее производство и работу подрядчика без абстрактных оценок.
Как считать трудоёмкость без сложной аналитики
Для небольшого отдела достаточно простой отметки времени в задаче и трёх причин переделки: содержание, произношение, монтаж. На каждый выпуск фиксируется момент утверждения текста и момент принятия дорожки. Дополнительно отмечается число пересозданных реплик. Через несколько недель уже видно, какая доля времени уходит именно на TTS и где появляется основная потеря. Такой учёт не требует отдельной аналитической системы и вместе с этим даёт основу для выбора инструмента.
Сопоставлять необходимо проекты похожего типа. Аудиокнига, пятнадцатисекундный видеоролик и голосовой интерфейс имеют различную структуру труда. Лучше собрать собственные эталоны: короткий рекламный видеоролик, презентационный модуль и длинная статья. Тогда решение о смене сервиса опирается на повторяемые сценарии, а не на случайно лёгкий или сложный материал.
Как довести синтетическую дорожку перед публикацией
Синтезированный файл нечасто существует в вакууме: его необходимо сочетать с музыкой, звуковыми эффектами, видео или другими голосами. Перед публикацией проверяются уровень громкости, отсутствие резких стыков между фрагментами и фоновые паузы. Если дорожки генерировались отдельными блоками, их начала и окончания могут различаться по тишине — это заметно в наушниках и при монтаже. Важна и общая динамика: тихая реплика после громкой создаёт ощущение случайной склейки.
Базовые операции — обрезка лишней тишины, выравнивание громкости, аккуратная эквализация и контроль пиков — выполняются в аудиоредакторе. Для понимания этих этапов подходит материал Xeon Live об основах обработки аудио на компьютере. Синтетический голос не стоит перегружать обработкой без причины: чрезмерная компрессия и яркий эквалайзер быстро делают речь утомительной и подчёркивают артефакты.
Формат хранения зависит от этапа. Для промежуточного монтажа удобен несжатый или качественный исходник, а для доставки платформа может требовать другой контейнер или кодек. Разницу между MP3, WAV, FLAC, AAC и другими вариантами стоит понимать до экспорта; обзор основных аудиоформатов помогает выбрать вариант без лишнего повторного кодирования. Хранить мастер и публикационную копию лучше раздельно.
Типичные ошибки при выборе программы для озвучки текста
- Выбирать только по одному красивому демо. Проверяйте собственный текст с вашей терминологией, числами и именами.
- Смешивать читалку и студию. Приложение для комфортного прослушивания PDF не обязано быть удобным для рекламной дорожки.
- Игнорировать права на голос. Возможность воспроизвести текст не означает автоматического права публиковать готовое аудио в коммерческом материале.
- Генерировать весь сценарий одним фрагментом. Любая поздняя правка тогда заставляет ещё раз обрабатывать чрезмерно большой объём.
- Не фиксировать параметры. Без наименования голоса, модели и настроек трудно выдержать одинаковое звучание в серии.
- Оценивать звук отдельно от видео. Идеальная дорожка может не работать с музыкой, титрами и темпом монтажа.
- Отдавать в синтез текст, написанный лишь для чтения глазами. Сложный синтаксис и плотные перечисления практически всегда требуют речевой редактуры.
- Не проводить финальный просмотр на обычном устройстве. Речь должна оставаться разборчивой не только в студийных наушниках.
Ещё одна распространённая ошибка — менять инструмент слишком рано. Если проблема сосредоточена в двух фамилиях и одной аббревиатуре, замена всей платформы может добавить больше работы, чем исправление словаря произношения. И наоборот, если каждая вторая реплика требует ручного монтажа, бессмысленно бесконечно полировать текст: рабочий процесс или выбранный голос не соответствуют задаче. Диагностика должна отделять проблемы сценария от проблем синтеза.
Контрольный чек-лист перед выпуском
- Все собственные имена, бренды, географические наименования и термины произнесены одинаково во всех фрагментах.
- Числа, даты, единицы измерения и сокращения читаются в нужном смысле.
- Паузы совпадают с логикой фразы и не ломают темп видеоролика или презентации.
- Нет случайной смены голоса, темпа или характера подачи между соседними сценами.
- Музыка не маскирует согласные и окончания слов, а голос не перегружен обработкой.
- Итоговый файл соответствует техническому процессу монтажа и публикационной площадке.
- У команды сохранены текст, наименование голоса, основные параметры и версия готового аудио.
- Проверены условия применения голоса для конкретного типа публикации и аудитории.
- Готовый материал полностью прослушан после последнего экспорта, а не только в окне синтезатора.
Контроль лучше выполнять в два прохода. Сперва редактор слушает только речь и отмечает произношение, паузы, темп и содержательные расхождения. Затем материал проверяется в финальном контексте — с музыкой, видео, титрами и реальным уровнем громкости. Разделение проходов помогает не пропустить словесную ошибку из-за яркого визуального ряда и одновременно не принять хорошую отдельную дорожку, которая плохо работает внутри готового видеоролика.
Частые вопросы и ограничения
Что важнее: нейросетевая естественность или точность произношения?
Для регулярного рабочего контента точность и повторяемость обычно важнее единично эффектной интонации. Красивый голос, который постоянно ошибается в наименованиях и требует ручной доводки, увеличивает трудоёмкость производства. Оптимальный вариант даёт достаточную естественность при предсказуемой работе на вашей терминологии.
Необходим ли SSML для обычной озвучки?
Нет. Большинство коротких видеороликов можно подготовить с хорошей пунктуацией и настройками самого сервиса. SSML полезен там, где необходимо формально управлять паузами и другими элементами синтеза в поддерживающей его платформе, в особенности в автоматизированном процессе.
Можно ли применять любой полученный голос в рекламе?
Нет. Права зависят от продукта, режима применения, конкретного голосового набора и условий правообладателя. Отдельно проверяются клонированные голоса и голоса третьих сторон. Коммерческий сценарий необходимо определить до производства, а не после готового монтажа.
Как избежать ошибок в фамилиях и аббревиатурах?
Соберите их в отдельный тестовый список до основной генерации. Зафиксируйте рабочее написание, словарное правило или разметку произношения и применяйте один вариант во всей серии. Такой словарь полезнее повторных ручных исправлений в каждом видеоролике.
Когда локальная программа лучше облачного сервиса?
Когда важны локальные документы, привычные системные голоса, автономность и отсутствие необходимости передавать текст в облако. Для выразительной брендовой озвучки, совместной работы и масштабной интеграции облачные инструменты обычно дают более прямой рабочий процесс.
Почему финальный материал необходимо переслушивать целиком?
Синтезатор обрабатывает фрагменты, а зритель слышит последовательность. Только полный просмотр показывает резкие стыки, случайную смену темпа, конфликт с музыкой, неудачные паузы и несоответствие речи монтажу.
Что выбрать в итоге
Для видеороликов в Windows наиболее цельный процесс даёт ВидеоМОНТАЖ: текст превращается в голос внутри того же проекта, где собирается видео. Для длинных локальных документов сильнее Balabolka и TextAloud, для книжного чтения — Icecream Ebook Reader. Среди облачных инструментов ElevenLabs и Murf AI удобнее для выразительной контентной озвучки, а Yandex SpeechKit и Google Cloud Text-to-Speech — когда синтез должен стать частью приложения или автоматизированной системы. Narakeet в особенности уместен для субтитров и локализации. На смартфонах Speechify, @Voice Aloud Reader, Voice Dream Reader и eReader Prestigio закрывают чтение документов и книг.
Универсального победителя для всех задач нет, но есть универсальный метод выбора: взять реальный фрагмент собственного материала, проверить произношение и ритм, оценить число ручных исправлений, затем пройти весь путь до готового файла. Инструмент, который стабильно сокращает редакторскую и монтажную работу при понятных правах на голос, и будет лучшим для конкретного процесса. Такой подход защищает от выбора по эффектному демо и связывает технологию с измеримым итогом.